5 desafíos de producción en sistemas multiagente y cómo los resolvió Deep Insight
5 production challenges in multi-agent systems and how Deep Insight solved them
Yoonseo Kim
Crear un sistema multiagente ahora es bastante sencillo. Llevarlo a la producción es donde comienzan los verdaderos desafíos. Gracias a los marcos de código abierto y a los servicios en la nube, puede configurar un agente en cuestión de días. Unas cuantas llamadas a las herramientas, unas pocas líneas de aviso y tendrá algo que se ve impresionante. Sin embargo, en el momento en que los equipos intentan ir más allá de un proyecto piloto y pasar a aplicaciones empresariales reales, se topan con un muro conocido. Si alguna vez ha intentado poner a un agente en producción, estas frustraciones le resultarán familiares
:
¿Por qué el agente no sigue nuestra lógica empresarial, se salta los pasos de validación o no detecta casos extremos?
Modificas el mensaje, agregas más ejemplos y cambias el modelo. Los mismos problemas siguen apareciendo. Esto se debe a que los agentes no siguen una secuencia fija de instrucciones. Emiten sus propios juicios basándose en el contexto. Las instrucciones por sí solas no son suficientes. Debes diseñar cómo piensa el agente, cuándo verifica y qué hace cuando las cosas van mal. Precisamente por eso es fundamental ir más allá de la ingeniería rápida y diseñar toda la arquitectura cognitiva y el flujo de ejecución del agente
.
Para abordar estos desafíos de manera frontal, el equipo de arquitectura de soluciones de AWS creó Deep Insight, un sistema multiagente de nivel de producción. En esta serie de publicaciones, compartimos lo que el equipo aprendió de primera mano mientras desarrollaba Deep Insight en tres publicaciones. Explicaremos cómo aplicamos las técnicas de ingeniería de contexto propuestas por Anthropic (arquitectura multiagente, toma de notas estructurada, experiencia humana al día, etc.) en un entorno de producción real. También analizaremos las ventajas y desventajas que encontramos a lo largo del proceso (con el código) y los conocimientos operativos que obtuvimos al implementar y ejecutar este agente
en AWS.
Descripción general de la serie de blogs
Parte 1:5 desafíos de producción en sistemas multiagente y cómo los resolvió Deep Insight.
Parte 2: Más allá de la ventana contextual: las técnicas de ingeniería de contexto y cómo las aplicó Deep Insight.
Parte 3: Aprovechar la ingeniería en la práctica: trasladar Deep Insight del desarrollo a la producción.
Deep Insight es un sistema multiagente que convierte el análisis de datos complejos en información automatizada. Con un archivo CSV y un mensaje en lenguaje natural, una jerarquía de agentes especializados (coordinador, planificador, supervisor, codificador, validador, reportero y rastreador) colabora en el análisis. Juntos cargan los datos, realizan análisis, generan gráficos, validan los cálculos y producen un informe profesional
(.docx) con citas.
Exploraremos la arquitectura en detalle más adelante. En primer lugar, veamos cómo funciona. Para la demostración, incluimos los datos publicitarios de una empresa alimentaria ficticia, Yummy Food (yummy-food-market.csv), con un archivo de definiciones de columnas (column_definitions.json) y proporcionamos el siguiente mensaje: analice esto desde una perspectiva de ventas y marketing, genere gráficos e información y elabore un informe en formato.docx. Deep Insight genera un plan de análisis, lo presenta al usuario para su aprobación y, una vez aprobado, ejecuta el
análisis.
Contenido
Entrada
Archivo de datos CSV (yummy-food-market.csv) + Archivo de definiciones de columnas (column_definitions.json)
Ejemplo de mensaje
«Analice esto desde una perspectiva de ventas y marketing, genere gráficos e información y elabore un informe en formato.docx».
Salida
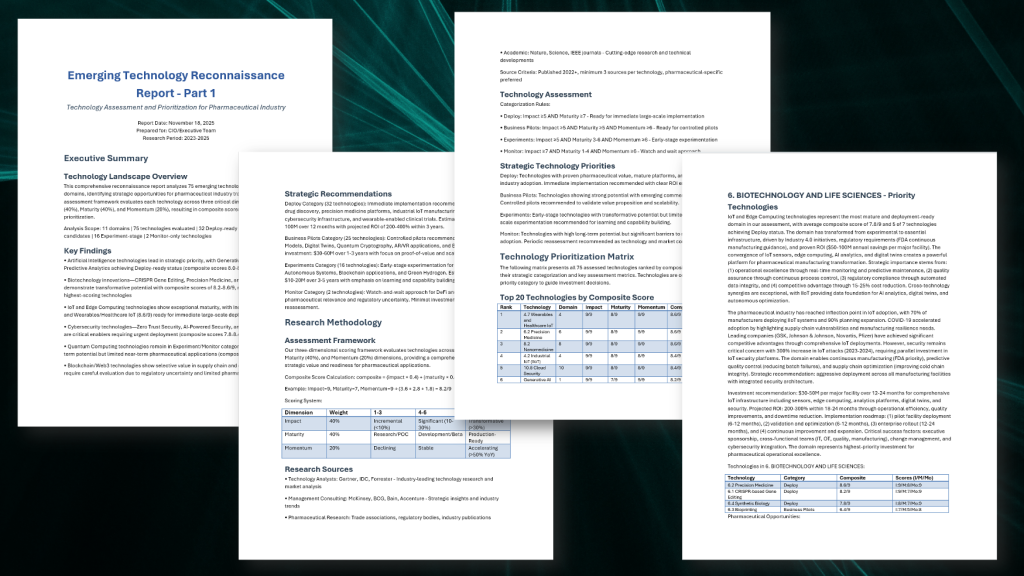
Informe DOCX (dos versiones, una con citas y otra sin ellas) más gráficos gráficos (PNG)
El siguiente vídeo de demostración web de Deep Insight muestra el flujo de trabajo completo, desde la carga de datos y la revisión del plan de análisis hasta la transmisión en tiempo real y la descarga del informe final.
¿Cómo puedo probarlo?
Deep Insight es de código abierto en GitHub con una guía de configuración completa y ofrece tres opciones de implementación que van desde el desarrollo hasta la producción.
La primera es la versión autohospedada, que se ejecuta localmente a través de la CLI. Está optimizada para una iteración rápida con acceso total a nivel de código a todos los agentes, solicitudes y flujos de trabajo. Se configura en unos 10 minutos, lo que lo hace ideal para el desarrollo. (Hay un vídeo de demostración autohospedado disponible en YouTube).
La segunda es la versión web, una interfaz de usuario basada en un navegador para cargar datos, revisar los planes de análisis (Human-in-the-Loop o HITL) y descargar informes, todo ello sin necesidad de escribir código, por lo que es accesible para quienes no son desarrolladores. (El vídeo de demostración anterior muestra la
versión web en acción).
La tercera es la versión Managed AgentCore, una opción de implementación en producción impulsada por Amazon Bedrock AgentCore, una plataforma para crear, conectar y optimizar agentes a escala, con cualquier marco o modelo. Esta versión implementa los agentes en AgentCore Runtime, una funcionalidad de Amazon Bedrock AgentCore. El sistema se ejecuta en su totalidad en una nube privada virtual (VPC) privada, con un intérprete de código personalizado alojado por separado en AWS Fargate, y los agentes se ejecutan simultáneamente en entornos aislados por usuario. Es la elección correcta cuando necesita aislar la sesión e implementar una VPC privada. La parte 3 describe en detalle su implementación y sus operaciones
.
Los tres comparten la misma arquitectura multiagente, por lo que un agente validado durante el desarrollo se implementa en la producción tal cual.
Descripción general de la solución
La
creación de un sistema multiagente de producción requiere más que buenas indicaciones. Necesita la infraestructura y la tecnología adecuadas para abordar la forma en que los agentes colaboran, cómo razonan, cómo los implementan, dónde ejecutan el código de forma segura y cómo se monitorea el estado operativo. Deep Insight resuelve problemas en estas cinco áreas clave. Como los agentes generan tanto el código como el contenido de los informes, también abordamos los controles de IA responsables para la producción en el detalle de la solución 2.
Desafío
Tecnología
Enfoque
«¿Cómo controlamos el flujo de ejecución entre varios agentes?»
SDK de agentes de Strands
Usa el patrón Graph de Strand para definir el orden de ejecución entre los agentes e implementar la bifurcación automática. Utilice el patrón Agents as Tools de Strand para que el supervisor pueda invocar agentes especializados (Coder, Validator, Reporter,
Tracker) como herramientas cuando lo necesite.
«¿Qué modelo de lenguaje extenso (LLM) debe usar cada agente?»
Amazon Bedrock
Seleccione el modelo de Claude adecuado para cada función: Haiku para el enrutamiento básico, Opus para la planificación y Sonnet para la ejecución.
«¿Cómo operamos de manera confiable un agente terminado en producción?»
Amazon Bedrock AgentCore
Tiempo de ejecución gestionado con supervisión, aislamiento de sesiones e implementación de VPC privadas.
«¿Cómo mitigamos los problemas de seguridad derivados de la ejecución de código generado por IA?»
AWS Fargate + Application Load Balancer (ALB)
Contenedores de espacio aislado efímeros por sesión para la ejecución aislada de código mediante un intérprete de código personalizado.
Panel de administración y sistema de alertas de fallos.
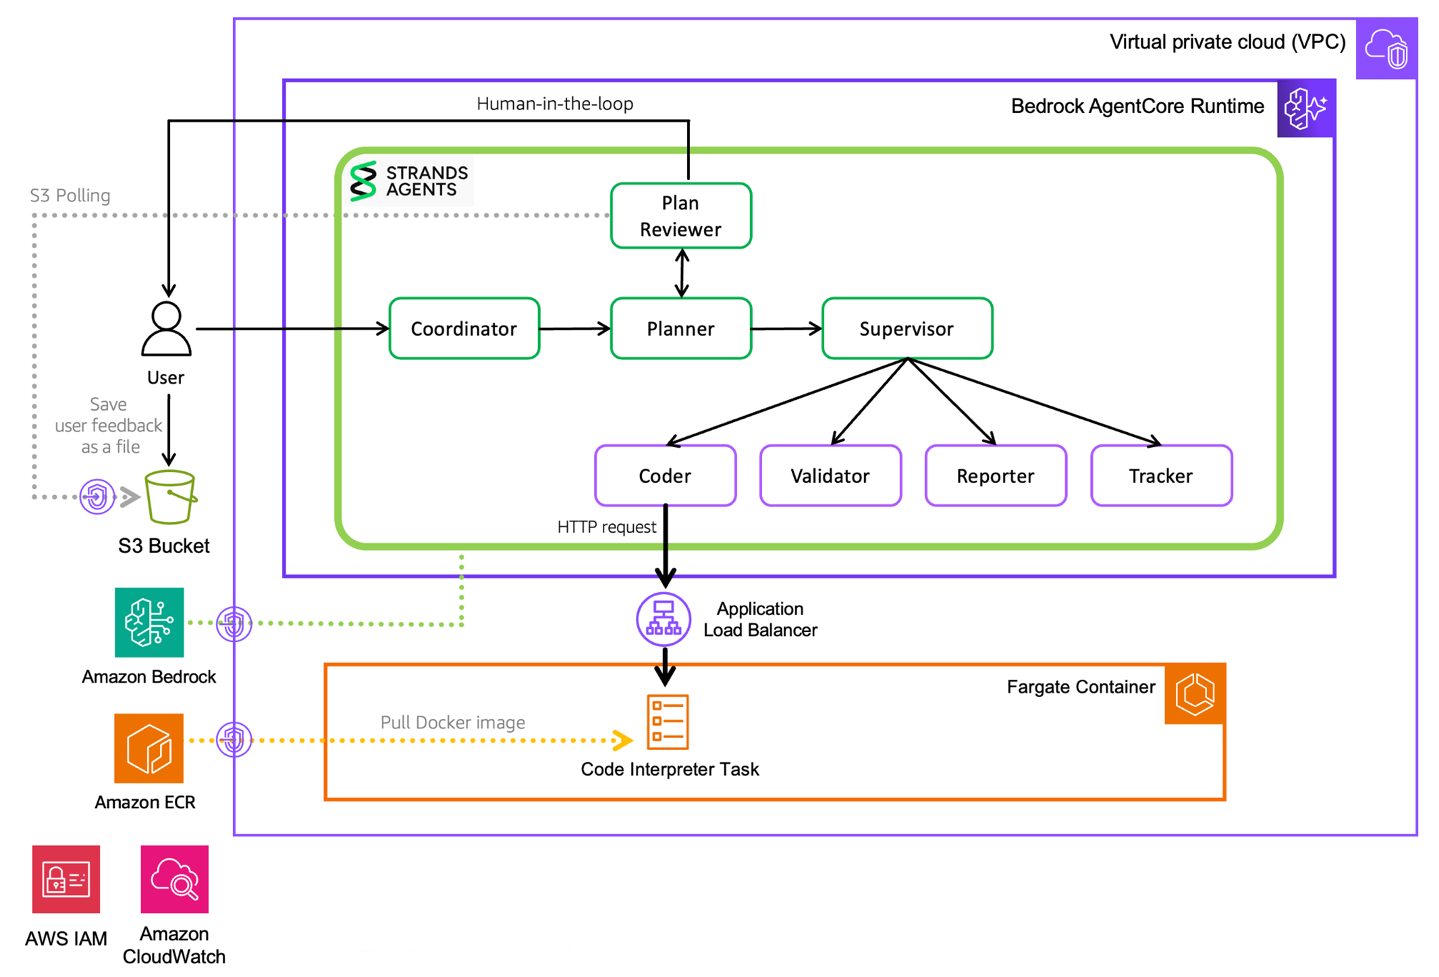
El siguiente diagrama de arquitectura (figura 1) ilustra esto de un vistazo. Los recuadros verdes representan la estructura multiagente de Strands Agents, que aborda los desafíos 1 y 2 de la tabla anterior. Trataremos este tema en detalle en la próxima sección Detalle de la solución 1: Diseño de sistemas multiagente. Los demás componentes de la infraestructura que se muestran en el diagrama abordan los desafíos 3, 4 y 5, que analizaremos en el detalle 2 de la solución: implementación y operaciones de producción
.
Figura 1: Arquitectura de la solución
Detalle de la solución 1: Diseño del sistema con múltiples agentes
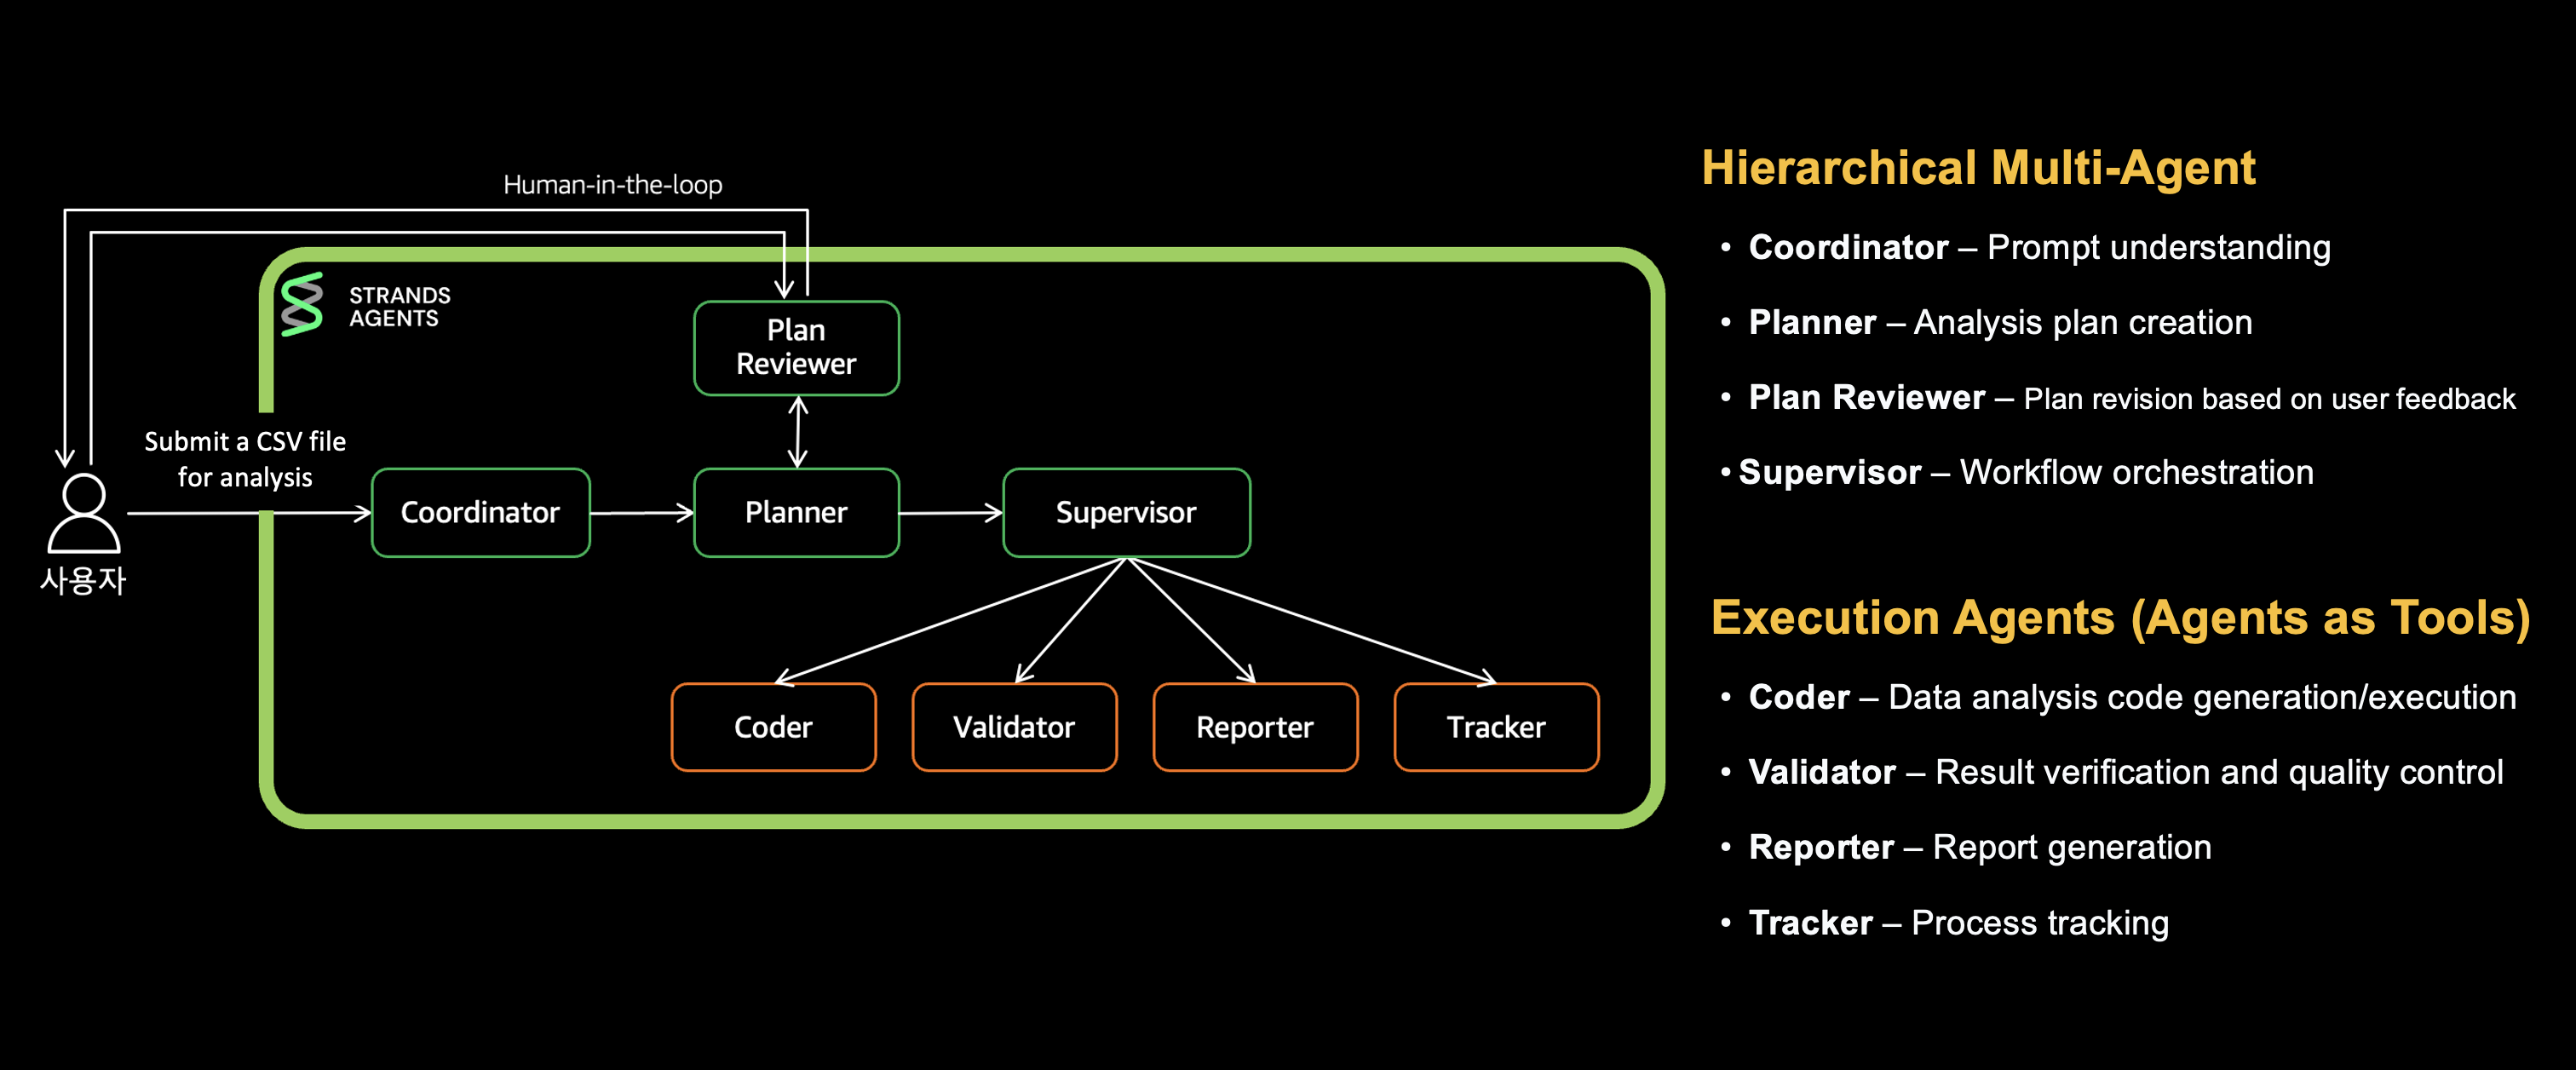
Deep Insight utiliza una arquitectura multiagente en la que ocho agentes colaboran para producir un producto de alta calidad. Cada agente trabaja en su propio contexto independiente, solo realiza sus tareas especializadas y solo transmite los resultados comprimidos
.
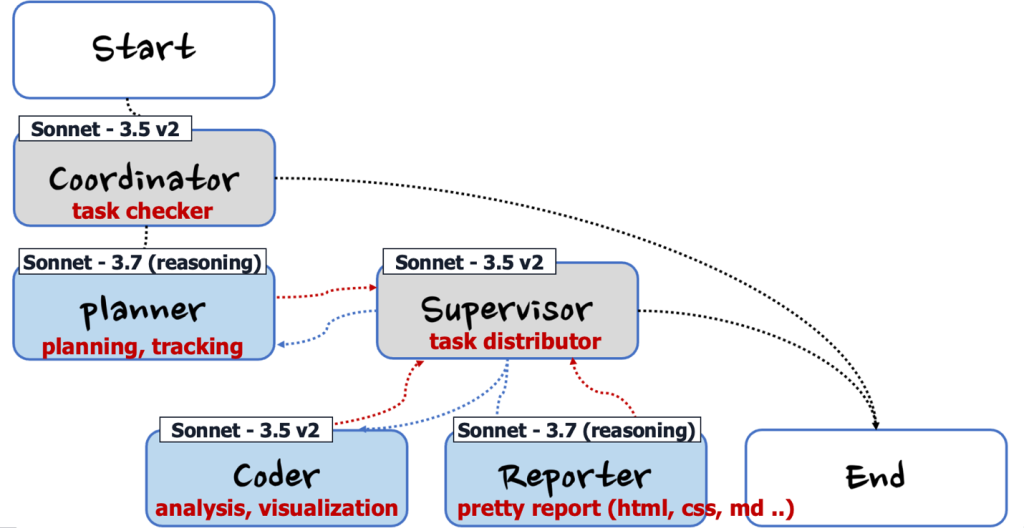
Figura 2: Estructura multiagente
El coordinador canaliza las solicitudes de los usuarios, el planificador divide las tareas en pasos discretos, el revisor del plan recopila los comentarios de los usuarios y el supervisor invoca a los agentes especializados apropiados de acuerdo con el plan. El codificador escribe y ejecuta el código de análisis de datos, el validador verifica los cálculos, el informador genera el informe final y el rastreador hace un seguimiento del progreso. Vamos a explicar esto en tres niveles
:
[Primera capa] Del coordinador al planificador y al revisor del plan: solicite el análisis y la creación del plan de ejecución.
[Segunda capa] Supervisor: orquestación de agentes especializados.
[Tercera capa] Codificador, validador, reportero, rastreador: ejecución de tareas especializadas.
Se
combinan dos patrones clave del SDK de Strands Agents para controlar el flujo de ejecución entre estos agentes. En primer lugar, el patrón Graph define el orden de ejecución y el flujo de los agentes como un gráfico dirigido. El coordinador del flujo de solicitudes, el planificador, el revisor del plan y luego el supervisor, con una rama condicional que regresa al planificador en caso de solicitudes de revisión. Determinar el siguiente paso por condición facilita los flujos de trabajo complejos, como el HITL, y la gestión de errores. En segundo lugar, el patrón de agentes como herramientas permite al supervisor invocar a agentes especializados (codificadores, validadores, reporteros, rastreadores) como herramientas solo cuando es necesario. Cada uno funciona en un contexto independiente y solo arroja resultados, lo que minimiza el uso del contexto y preserva la experiencia en el campo
.
En esta sección se muestra cómo la arquitectura resuelve el enrutamiento, la planificación y la orquestación.
[Primera capa] Del coordinador al planificador y al revisor de la planificación
Esta capa convierte la solicitud de un usuario en un plan de ejecución aprobado.
1.1 Coordinador (enrutamiento): no todas las solicitudes necesitan una organización costosa
El coordinador es el punto de entrada para las solicitudes de los usuarios. Gestiona directamente los saludos básicos y dirige las tareas complejas, como el análisis de datos, al planificador con un marcador handoff_to_planner
.
La decisión clave en cuanto al diseño es la selección del modelo: dado que el coordinador solo clasifica, utiliza el ligero Claude Haiku, lo que evita los costes del Opus en saludos básicos y ofrece respuestas rápidas.
# builder.py: bordes condicionales para las decisiones de enrutamiento
builder.set_entry_point («coordinador»)
builder.add_edge
Las condiciones de enrutamiento provienen del aviso del coordinador: cualquier solicitud que necesite herramientas, razonamiento o ideas en varios pasos va dirigida al planificador.
1.2 Planificador (creación del plan): los análisis complejos deben descomponerse antes de ejecutarse
En la estructura multiagente de Deep Insight, el agente Planner desempeña el papel fundamental de distribuir las tareas entre los agentes. Antes de comenzar el trabajo sustantivo, divide las tareas grandes en pasos más pequeños y cada agente especializado las ejecuta de una en una, manteniendo el contexto de cada agente
reducido.
El planificador utiliza un modelo de Claude Opus con el pensamiento extendido activado para desarrollar el plan de análisis. Organiza el plan en un formato de lista de verificación [] que especifica las tareas concretas asignadas a cada agente, almacenadas en una variable full_plan. Divide la solicitud en 5 a 10 pasos claros, como se muestra en el siguiente ejemplo:
## título
Informe de análisis de los patrones de compra de los consumidores de Yummy Food y la eficacia de la publicidad

## pasos

### 1. Coder: análisis integral de datos y generación de información
- [] Cargue todos los archivos de datos desde '. /data/ *' ruta y comprensión de la estructura
- [] Analice el historial de compras de los consumidores (patrones, preferencias, segmentos de clientes)
- [] Analice los datos publicitarios por canal (costo, efectividad, comparación de canales)
- [] Análisis a nivel de categoría (alimentos frescos, alimentos precocinados, alimentos saludables y eficacia)
- [] Calcule las métricas empresariales clave (tasa de conversión, CPA, ROAS, etc.)
- [] Genere visualizaciones (más de 5 gráficos, gráficos de segmentos de consumidores)
- [] Obtenga información estratégica de marketing
- [] Generar metadatos de cálculo (para su validación)

### 2. Validador: verificación de cálculos y generación de metadatos de citas
- [] Identifique los objetivos de verificación y extraiga los cálculos de los filtros
- [] Cargue los archivos de datos directamente y realice nuevos cálculos
- [] Verifique la precisión de las métricas de rendimiento por canal
- [] Valide la coherencia de los datos de las imágenes y los gráficos
- [] Genere metadatos de citas (números de referencia para elementos verificados)

### 3. Reportero: Generación de informes de análisis de marketing
- [] Escriba la descripción general del informe
- [] Cree un informe estructurado utilizando resultados de análisis verificados
- [] Inserte secciones de visualización y análisis
- [] Presente recomendaciones de estrategias de marketing y propuestas de mejora
- [] Genere un informe de marketing profesional en formato DOCX
1.3 Revisor del plan
El revisor del plan es un nodo de HITL que presenta el plan al usuario y recopila los comentarios sobre la aprobación o la revisión. Si hay comentarios, se envían al planificador para revisar el plan. Si se aprueba, transfiere la tarea al supervisor. Se establece un recuento máximo de revisiones (MAX_PLAN_REVISIONS) para evitar bucles
infinitos.
# builder.py: Planifique los bordes condicionales bidireccionales del revisor
builder.add_edge («plan_reviewer», «planner», condition=should_revise_plan)
builder.add_edge («plan_reviewer», «supervisor», condition=should_proceed_to_supervisor)
builder.set_max_node_executions (
25)
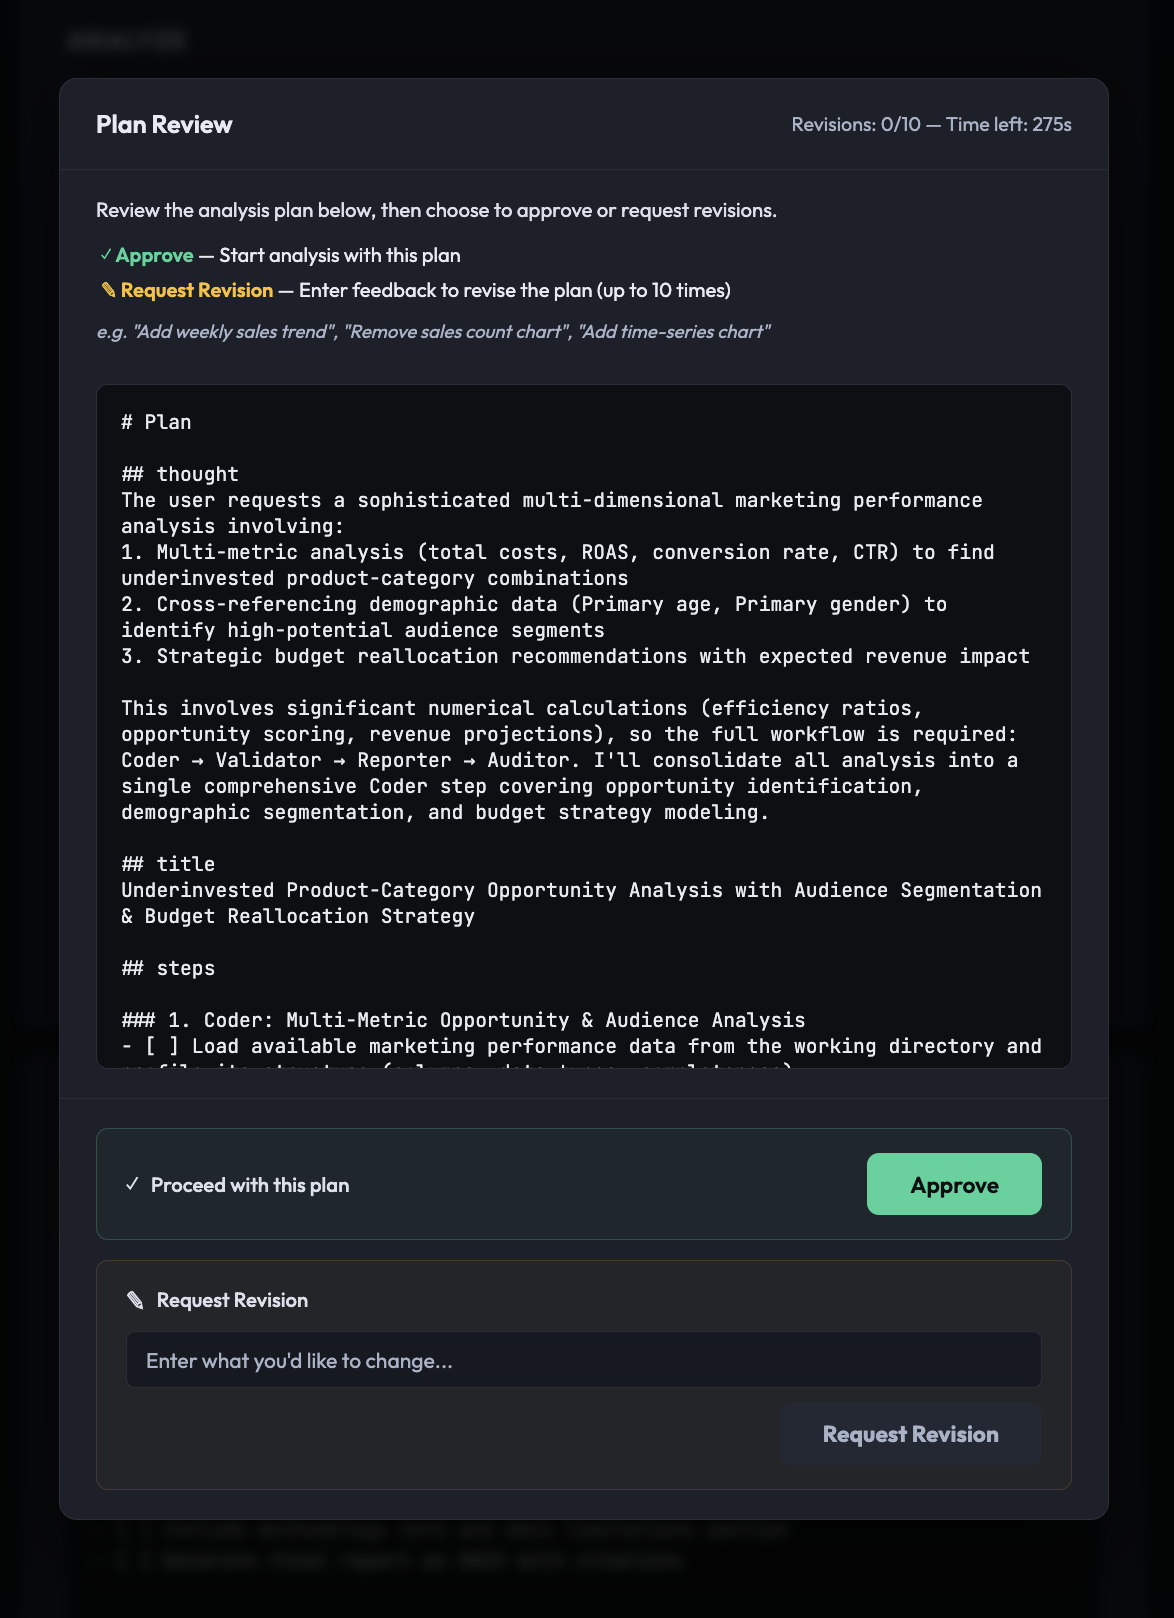
En la versión web, el revisor del plan muestra un modo de navegador en el que el usuario lee el plan y lo aprueba o introduce comentarios sobre la revisión. Una cuenta regresiva de 300 segundos aprueba automáticamente el plan si no recibe respuesta
.
Figura 3: Planear la ejecución del agente Reviewer en la interfaz de usuario web
Si no se planifica, el agente decide todo en tiempo de ejecución, una corrección intermedia invalida el trabajo anterior y los usuarios no pueden ver el progreso. Con el planificador y el revisor del plan, el usuario puede revisar y revisar el plan, supervisar el progreso en tiempo real y volver a ejecutar solo un
paso fallido.
Supervisor (orquestador) [de segunda capa]: Los agentes especializados necesitan un director
El supervisor ejecuta el plan completo del planificador en orden e invoca a los agentes de la capa 3 (Coder, Validator, Reporter, Tracker) como herramientas registradas en él mediante Tool Use.
# nodes.py: registro de subagentes como herramientas en el Supervisor
agent = strands_utils.get_agent (
 agent_name="supervisor»,
 system_prompts=apply_prompt_template (prompt_name="supervisor», prompt_context= {}),
 model_id=os.getenv («SUPERVISOR_MODEL_ID», os.getenv («DEFAULT_MODEL_ID»)),
 prompt_cache_info =( Verdadero, «predeterminado»),
 tool_cache=verdadero,
 tools= [coder_agent_tool, reporter_agent_tool, tracker_agent_tool, validator_agent_tool],
 Streaming=verdadero,
)
El indicador del sistema del supervisor define reglas estrictas de flujo de trabajo:
Orden de ejecución obligatoria: Coder, Tracker, Validator, Tracker, Reporter, Tracker: después de ejecutar cada agente, se invoca a Tracker para rastrear el progreso, lo que permite al supervisor administrar el estado general de la tarea.
Regla de finalización de secciones: el supervisor no pasa al siguiente agente hasta que todos los elementos de la lista de verificación del agente actual estén marcados con [x].
Preservación del contexto: el supervisor envía las pistas y las variables del plan completo a cada agente de la herramienta, manteniendo el contexto completo y evitando la pérdida de información.
[Tercera capa] Codificador, validador, reportero, rastreador: la división del trabajo impulsa la calidad
Cada agente de capa 3 (Coder, Validator, Reporter, Tracker) está empaquetado como una PythonAgentTool y recibe las llamadas del supervisor para usar la herramienta. Cada uno se crea como una instancia independiente de Agent () en el SDK de Strands con su propia
línea de comandos de sistema, ID de modelo y conjunto de herramientas.
Agente
Rol
Herramientas
Salida clave
Codificador
Análisis de datos, generación de gráficos, obtención de información
Actualizaciones del estado de progreso de la lista de verificación
Ninguna (solo para el razonamiento del LLM)
Full_plan actualizado
El supervisor invoca las llamadas de uso de herramientas en este orden, según la lista de verificación del planificador:
Codificador: carga datos, escribe y ejecuta código de análisis, produce gráficos PNG, acumula los resultados en all_results.txt y deja calculation_metadata.json para su verificación.
Rastreador (primera pasada): actualiza los elementos completados de la lista de verificación de [] a [x], y el supervisor los utiliza para decidir si continuar o no.
Validador: vuelve a realizar cada cálculo en calculation_metadata.json a partir de los datos de origen. Las coincidencias no superan los 0,01 pases y se marcan las discrepancias. Los cálculos verificados van a citations.json para
que el reportero los cite.
Rastreador (segunda pasada): refleja el estado de finalización del validador en la lista de verificación.
Reporter: lee all_results.txt y citations.json para generar el informe DOCX final en dos versiones, con y sin citas.
Rastreador (tercera pasada): refleja el estado final de finalización de todas las tareas.
El
rastreador se ejecuta detrás de cada agente para que el supervisor pueda hacer un seguimiento del progreso y hacer cumplir la regla de finalización (no continuar hasta que todos los elementos estén [x]). Como actualiza la lista de verificación con el razonamiento del LLM y sin herramientas, supone pocos gastos generales
.
Configuración del modelo LLM por agente
Deep Insight adapta el modelo y la configuración a la función de cada agente. No se trata de una selección de modelos. Es una decisión arquitectónica para optimizar el costo y la calidad.
Agente
Modelo
Pensamiento extendido
Almacenamiento en caché rápido
Rol
Coordinadora
Haiku
Discapacitado
No
Enrutamiento rápido: minimización de costos
Planificador
Opus
Habilitado (~8.192 fichas)
No
Pensamiento profundo: planificación de alta calidad
Supervisor
Soneto
Discapacitado
Sí
Orquestación de la ejecución: almacenamiento en caché para ahorrar costos
Codificador
Soneto
Discapacitado
Sí
Generación/ejecución de código: almacenamiento en caché efectivo para llamadas repetidas
Validador
Soneto
Discapacitado
No
Verificación numérica: datos diferentes cada vez, no es necesario almacenarlos en caché
Periodista
Soneto
Discapacitado
Sí
Generación de informes: almacenamiento en caché eficaz para solicitudes largas
rastreador
Soneto
Discapacitado
No
Actualizaciones de estado: tareas ligeras, almacenamiento en caché innecesario
Los agentes de Supervisor, Coder y Reporter utilizan Prompt Caching para almacenar en caché las indicaciones del sistema y las definiciones de las herramientas, lo que reduce los costos de los tokens de entrada hasta en un 90 por ciento en las llamadas repetidas. El coordinador se ejecuta solo una vez, y el validador y el rastreador se ejecutan en contextos diferentes cada vez, por lo que el almacenamiento en caché no es efectivo para ellos y permanece desactivado. Esta estrategia de almacenamiento en caché selectivo es una
compensación deliberada entre coste y rendimiento.
Detalle de la solución 2: implementación y operaciones de producción
Si el detalle de la solución 1 definió lo que hace el sistema, en esta sección se define dónde y cómo se ejecuta de forma segura. A partir de ahora, todo abarca las decisiones de infraestructura para las operaciones de producción. En concreto, en esta sección se aborda el entorno de ejecución seguro del código generado por el LLM y la visibilidad operativa del equipo
.
1. Ejecución de código: el código generado por LLM necesita un entorno de ejecución seguro
El agente Coder escribe y ejecuta Python para el análisis de datos. En la versión autohospedada, se ejecuta localmente a través de subprocess.run (), pero en producción (AgentCore) la seguridad y el aislamiento son esenciales. Ejecutar código generado por LLM directamente en un servidor de producción es arriesgado: el modelo puede eliminar los archivos del sistema, agotar los recursos en un bucle infinito o acceder a los datos de análisis de otros usuarios. Deep Insight resuelve este problema con contenedores efímeros por sesión en AWS Fargate y ALB. Estos componentes no se ejecutan de forma aislada. Como se muestra en la figura 1, las tareas de AgentCore Runtime, ALB y Fargate se ejecutan todas dentro de la misma VPC privada. Los puntos de enlace de la VPC las conectan a Amazon Simple Storage Service (Amazon S3), Amazon Bedrock y Amazon Elastic Container Registry (Amazon ECR) sin tener que pasar por la Internet pública. Los grupos de seguridad restringen los componentes que pueden llegar a los contenedores del intérprete de código. Las funciones de AWS Identity and Access Management (IAM) limitan cada componente a los recursos de AWS que necesita. Amazon CloudWatch recopila los registros de contenedores y los datos de observabilidad de AgentCore Observability, una funcionalidad de Amazon Bedrock AgentCore
.
Imagen de Docker de contenedor personalizada: un entorno limitado preoptimizado con fuentes, bibliotecas del sistema y paquetes de Python para el sistema multiagente.
Aislamiento de contenedores: cada sesión de análisis obtiene un contenedor de Fargate independiente en una subred de VPC privada sin acceso directo a Internet.
Ejecución en dos pasos: el código generado por LLM se codifica en base64, se envía a través de HTTP, se escribe en un archivo (paso 1) y luego se ejecuta mediante un subproceso (paso 2).
Afinidad de sesión: las cookies de sesión fijas de ALB devuelven a un agente al mismo contenedor, incluso cuando ejecuta código varias veces.
Gestión de artefactos: los gráficos, los informes y los registros se cargan en Amazon S3 cuando finaliza el análisis. Los contenedores finalizan automáticamente al cabo de una hora.
El
aislamiento de contenedores protege la infraestructura, pero no controla lo que generan los agentes. El agente validador vuelve a verificar los cálculos. No detecta las instrucciones de inserción rápida ocultas en los datos cargados ni filtra el texto generado por LLM en busca de contenido dañino o infundado. En el caso de las implementaciones de producción, recomendamos añadir Amazon Bedrock Guardrails como control de inteligencia artificial responsable: aplicar filtros de contenido y detectar rápidamente los ataques a las solicitudes de los usuarios y a los datos cargados, y aplicar comprobaciones contextuales a los resultados de los agentes para que el texto del informe se mantenga centrado en los datos de origen y en los cálculos
verificados.
2. Operaciones y monitoreo: los equipos necesitan visibilidad
Un sistema de producción no está completo solo con código. El equipo debe evaluar el estado del sistema, diagnosticar los problemas y revisar los resultados, por lo que Deep Insight proporciona una interfaz de usuario web y un panel de operaciones.
Interfaz de usuario web (deep insight-web)
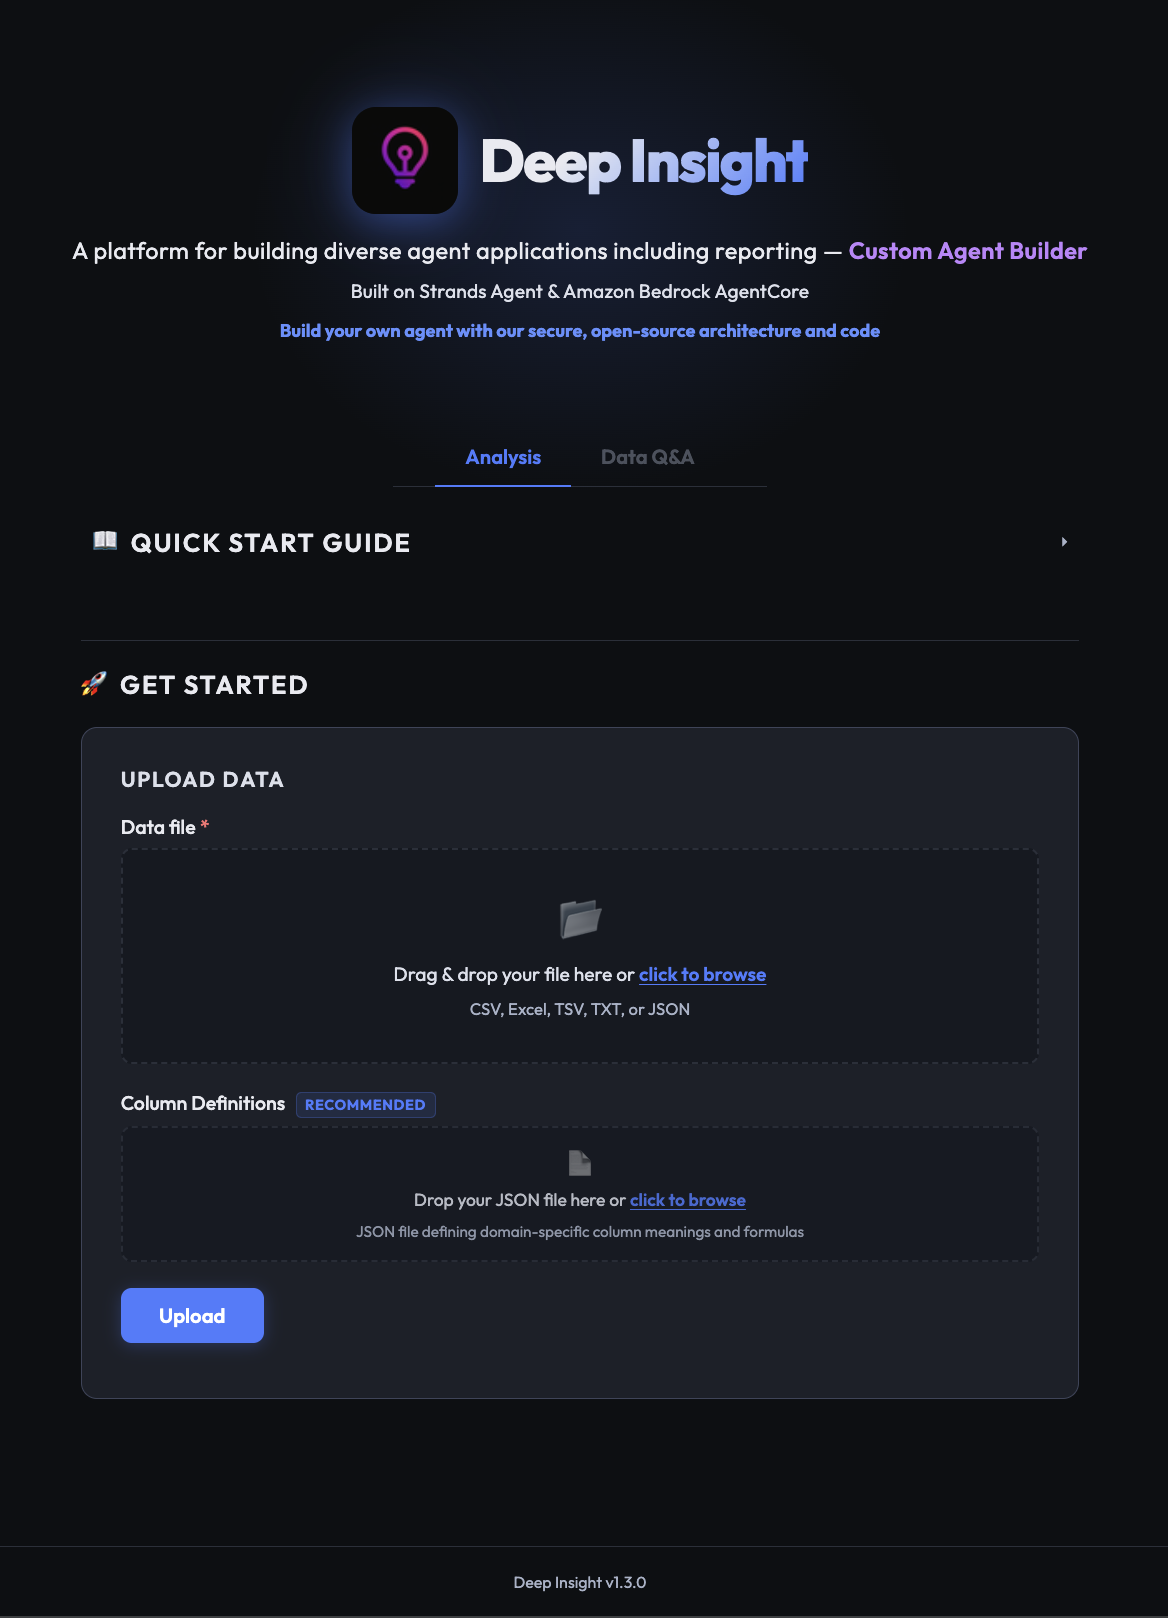
Una interfaz web basada en FastAPI que se comunica con el backend a través del protocolo nativo de AgentCore (boto3.invoke_agent_runtime ()). Los usuarios cargan datos e introducen un mensaje y, a continuación, supervisan el progreso mediante la transmisión de eventos enviados por el servidor (SSE). Cuando se genera el plan, un modal permite al usuario aprobarlo o enviar comentarios sobre la revisión (HITL). El informe terminado se puede descargar directamente. Se admiten tanto el coreano como el inglés.
Figura 4: Captura de pantalla de la versión web de Deep Insight
Panel de operaciones (deep-insight-web/ops)
El panel de operaciones es opcional. Deep Insight funciona bien sin él, pero añade estas funciones para los equipos que las necesitan:
Seguimiento de tareas: todas las métricas de las tareas de análisis, incluidos el estado, el uso de los tokens y el tiempo transcurrido, se registran en Amazon DynamoDB.
Alerta de errores: cuando se produce un error en un análisis, se envía inmediatamente un correo electrónico a los administradores a través de Amazon SNS.
Panel de administración: un panel de administración dedicado está protegido mediante la autenticación JSON Web Token (JWT) a través de Amazon Cognito para una supervisión segura de las tareas.
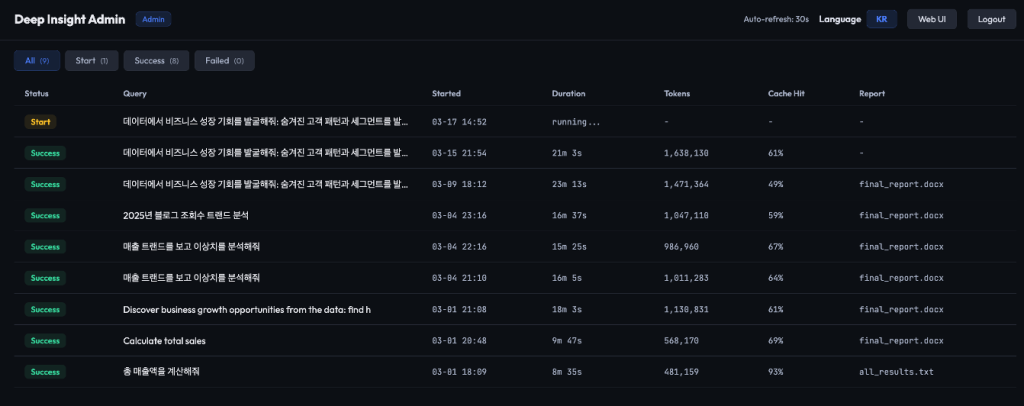
Figura 5: Captura de pantalla del panel de Deep Insight Ops
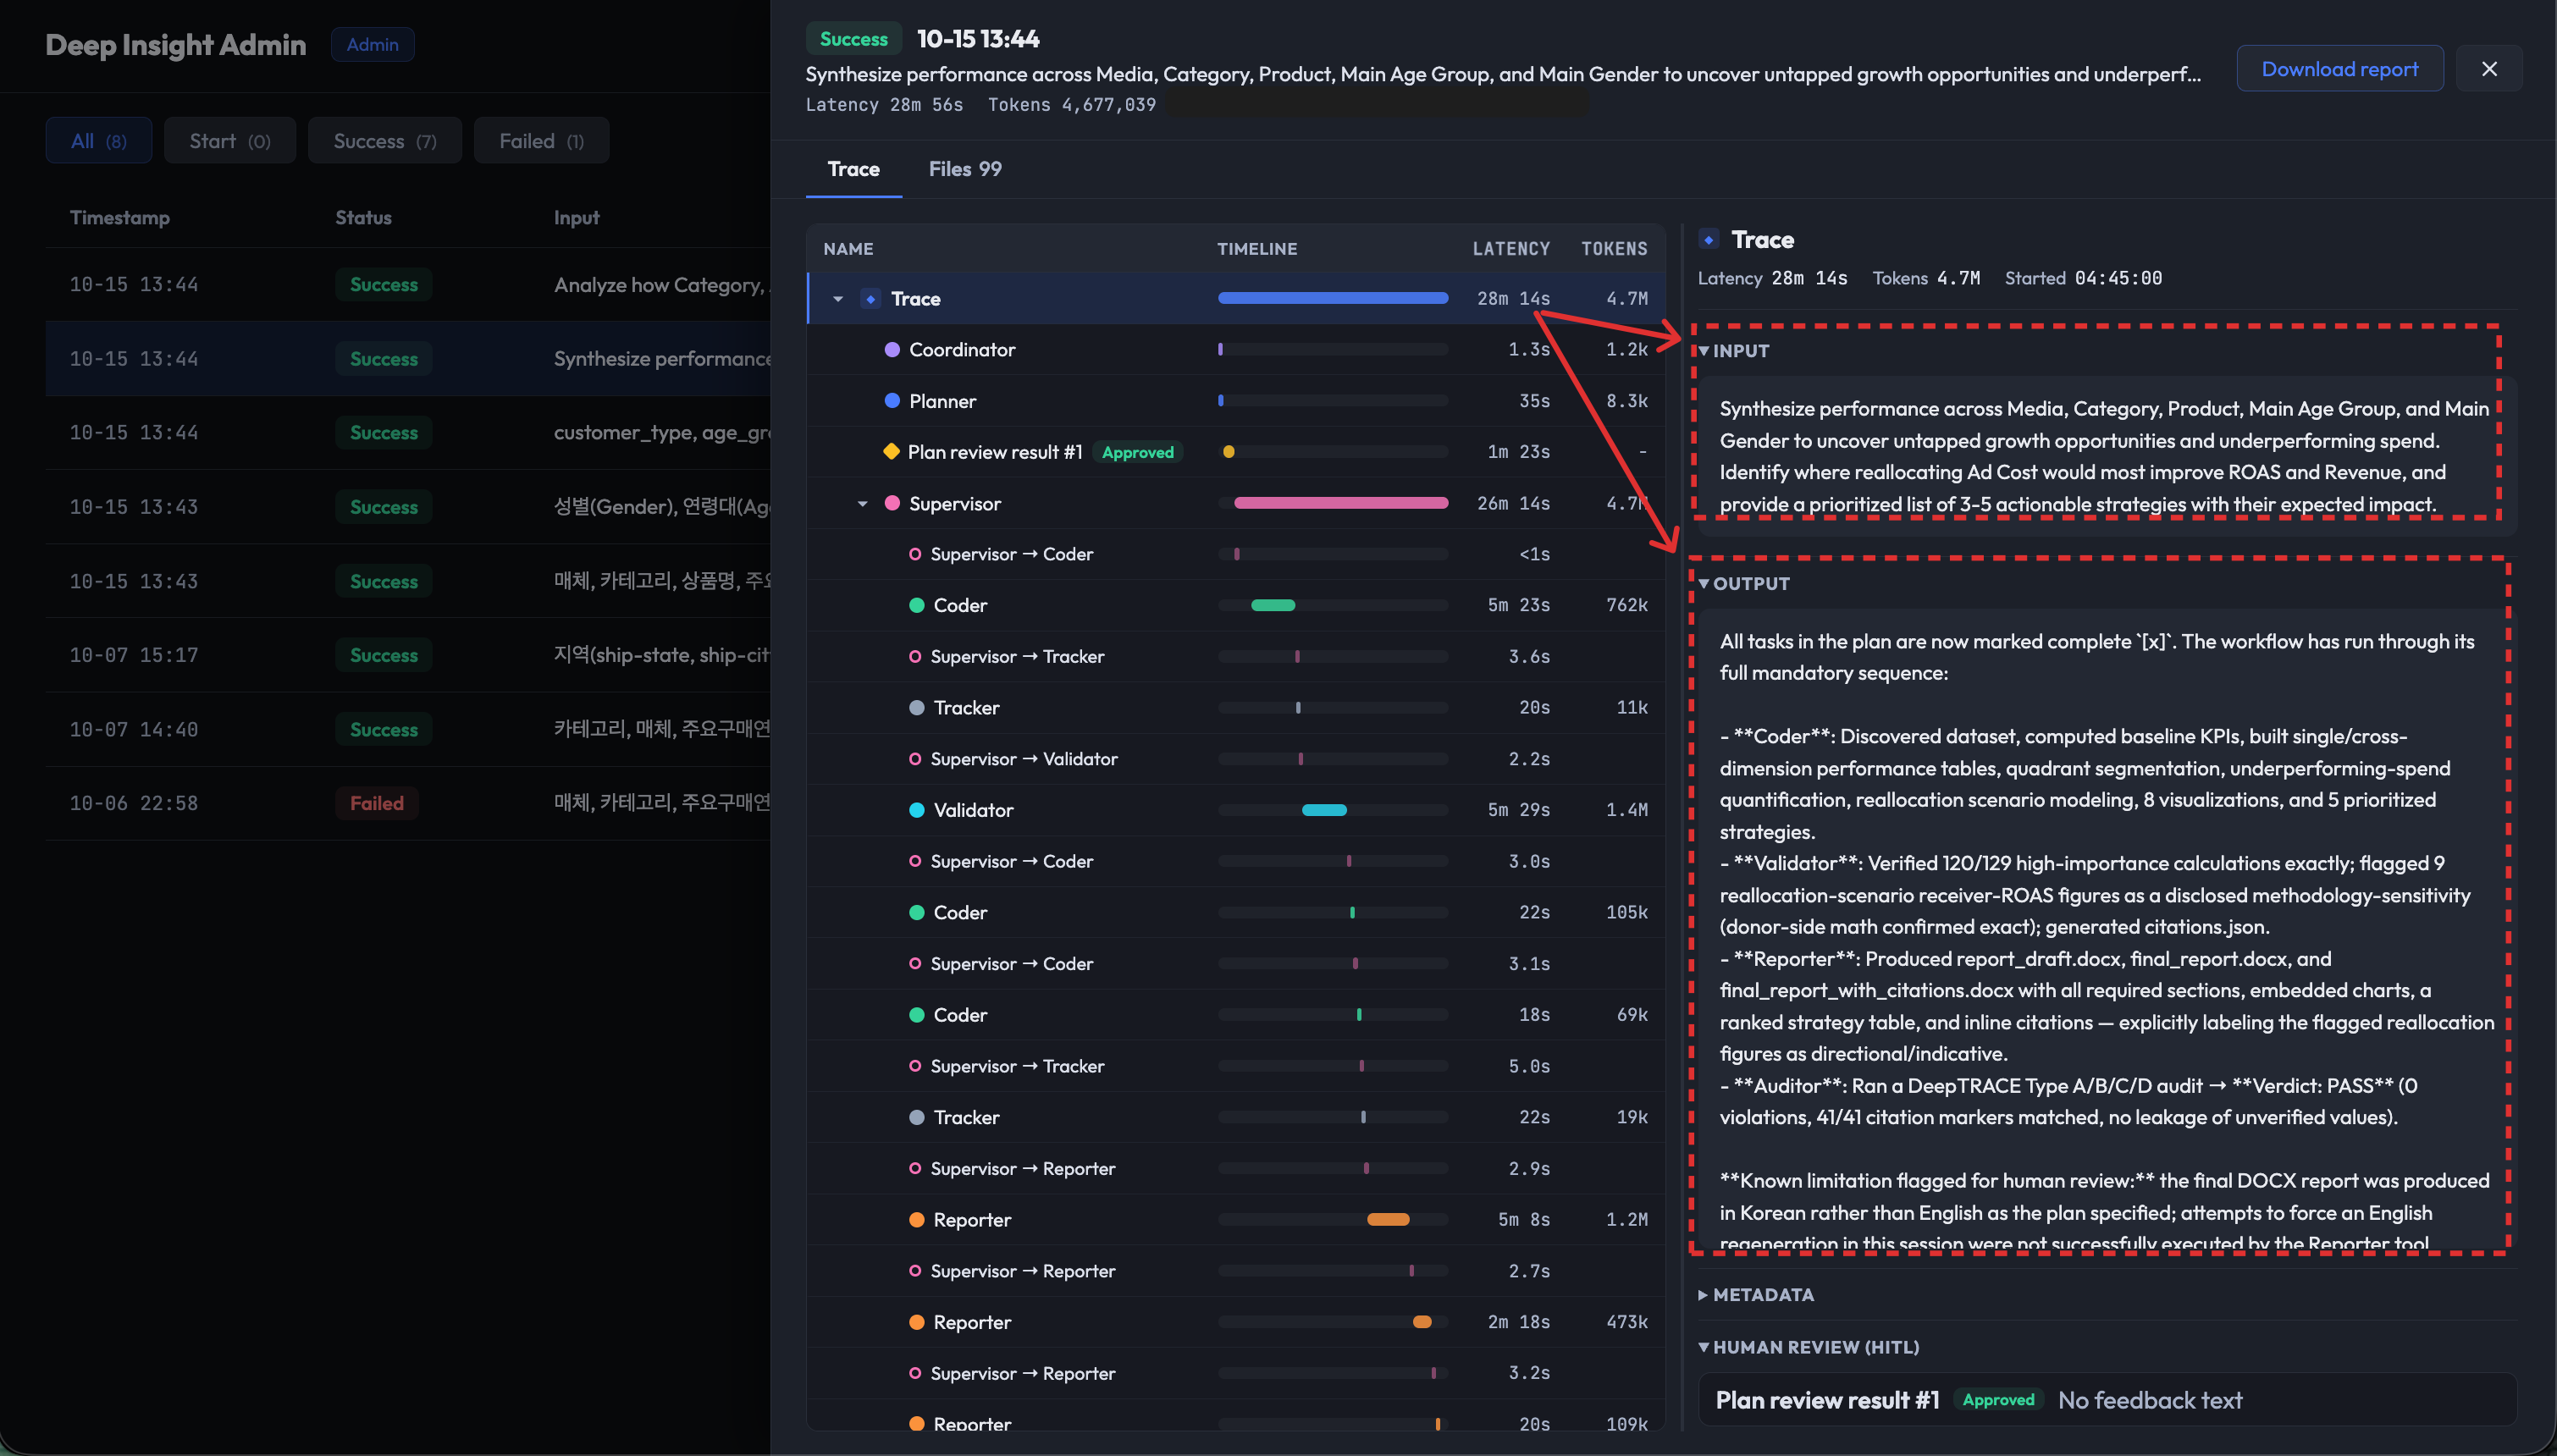
Figura 6: Vista detallada del panel de Deep Insight Ops
Ampliación de la arquitectura de Deep Insight
La
arquitectura multiagente de Deep Insight no se limita al dominio único de la generación de informes de análisis de datos. Los dos ejemplos siguientes demuestran que los principios de diseño de la orquestación jerárquica siguen siendo efectivos en ámbitos completamente diferentes
.
Caso 1: LG Electronics: sistema de extracción de información de marketing impulsado por la inteligencia artificial de Agentic
La
división de ventas de LG Electronics en Corea creó ChatInsight con la misma arquitectura multiagente que Deep Insight, en la que las solicitudes de análisis de datos tardaban entre 2 y 3 semanas y perdían el interés entre los especialistas en marketing y los científicos de datos. El coordinador clasifica según su complejidad, el planificador hace un seguimiento de las tareas y el supervisor organiza el codificador y el reportero. El estado entre los agentes se transfiere de forma acumulativa a través de un archivo all_results.txt. Los análisis que tardaban 3 días ahora tardan 30 minutos, lo que supone una mejora de la productividad 288 veces mayor. Los profesionales del marketing que no conozcan SQL pueden dejar que el agente explore los datos y proponga estrategias (consulte el sistema de extracción de información mediante IA de LG Electronics Agentic en el blog técnico de AWS
).
Figura 7: Arquitectura del sistema de información de marketing de IA de LG Electronics Agentic
Caso 2: TechRecon: agente de reconocimiento tecnológico impulsado por inteligencia artificial (re:Invent 2025)
Presentado en AWS re:Invent 2025 (sesión SNR203), TechRecon aplica la arquitectura de Deep Insight a la estrategia tecnológica. Para una empresa y un sector, el investigador recopila las tendencias tecnológicas, el programador las analiza, el validador las verifica y el reportero elabora un análisis del panorama y un documento de posición técnica. La arquitectura es prácticamente idéntica a la de Deep Insight, creada con el patrón Graph del SDK de Strands Agents y con Extended Thinking y Prompt Caching, y Researcher sustituyó a Coder como principal agente de ejecución. Esto demuestra que el diseño sigue un patrón de uso general: si se intercambian las funciones y las instrucciones de los agentes, la misma estructura de orquestación resuelve problemas completamente diferentes
Crear un agente que funcione en la producción no es una cuestión de capacidad del modelo. Es una cuestión de arquitectura. Deep Insight ofrece una respuesta comprobada:
Gestión del flujo de trabajo: el patrón gráfico del Strands Agents SDK define el orden de ejecución entre los agentes e implementa la bifurcación de HITL, mientras que el patrón Agents-as-Tools permite al supervisor invocar agentes especializados solo cuando es necesario.
Motor de razonamiento: asignamos los modelos Claude de Amazon Bedrock por rol (Haiku, luego Opus y luego Sonnet) para optimizar los costos y la calidad.
Implementación: Amazon Bedrock AgentCore proporciona un tiempo de ejecución administrado con aislamiento de sesiones, implementación de VPC privadas y capacidad de observación de OpenTelemetry.
Ejecución de código: Application Load Balancer y Amazon Elastic Container Service (Amazon ECS) en Fargate aíslan la ejecución del código generado por LLM en contenedores aislados efímeros por sesión, lo que evita problemas de seguridad como el acceso a los archivos del sistema, el agotamiento de los recursos y la divulgación no intencionada de datos.
Operaciones: la transmisión de SSE de la interfaz de usuario web y el panel de operaciones (DynamoDB, Cognito y SNS) proporcionan visibilidad a todo el equipo.
El sistema de información de marketing de LG Electronics y el caso TechRecon en re:Invent 2025 validaron estos principios de diseño.
En la parte 2, examinamos cuatro niveles de técnicas de ingeniería de contexto para superar los límites de las ventanas contextuales en esta arquitectura, desde el aislamiento a nivel de arquitectura hasta el diseño rápido, la optimización de las herramientas y las salvaguardias de verificación, comparando nuestro enfoque con la investigación de ingeniería de Anthropic.
Deep Insight es de código abierto. Explore el código y amplíelo para su propio dominio.
Building a multi-agent system is now pretty straightforward. Taking it to production is where the real challenges begin. Thanks to open source frameworks and cloud services, you can set up an agent in a matter of days. A few tool calls, a few lines of prompt, and you have something that looks impressive. But the moment teams try to move beyond a pilot and into real business applications, they hit a familiar wall. If you’ve ever tried to put an agent into production, these frustrations will sound familiar:
Why doesn’t the agent follow our business logic, skip validation steps, or catch edge cases?
You tweak the prompt, add more examples, swap out the model. The same problems keep coming back. That’s because agents don’t follow a fixed sequence of instructions. They make their own judgments based on context. Instructions alone aren’t enough. You need to design how the agent thinks, when it verifies, and what it does when things go wrong. This is exactly why it’s become critical to go beyond prompt engineering alone and design the agent’s entire cognitive architecture and execution flow.
To tackle these challenges head-on, the AWS Solutions Architecture team built Deep Insight, a production-grade multi-agent system. In this post series, we share what the team learned firsthand while building Deep Insight across three posts. We will walk through how we applied Context Engineering techniques proposed by Anthropic (multi-agent architecture, structured note-taking, human-in-the-loop, and more) in a real production environment. We also cover the trade-offs we encountered along the way (with code) and the operational insights we gained from deploying and running this agent on AWS.
Blog series overview
Part 1: 5 production challenges in multi-agent systems and how Deep Insight solved them.
Part 2: Beyond the context window: Context Engineering techniques and how Deep Insight applied them.
Part 3: Harness engineering in practice: moving Deep Insight from dev to production.
Deep Insight is a multi-agent system that turns complex data analysis into automated insights. Given a CSV file and a natural-language prompt, a hierarchy of specialized agents (Coordinator, Planner, Supervisor, Coder, Validator, Reporter, and Tracker) collaborates on the analysis. Together they load the data, run analyses, generate charts, validate calculations, and produce a professional report (.docx) with citations.
We will explore the architecture in detail later. First, let’s see it in action. For the demo, we feed advertising data from a fictional food company, Yummy Food (yummy-food-market.csv) with a column definitions file (column_definitions.json), and provide the prompt: Analyze this from a sales and marketing perspective, generate charts and insights, and produce a .docx report. Deep Insight generates an analysis plan, presents it to the user for approval, and, once approved, executes the analysis.
Content
Input
CSV data file (yummy-food-market.csv) + Column definitions file (column_definitions.json)
Example prompt
“Analyze this from a sales and marketing perspective, generate charts and insights, and produce a .docx report.”
Output
DOCX report (two versions, one with citations and one without) plus chart graphics (PNG)
The Deep Insight web demo video that follows shows the full workflow, from uploading data and reviewing the analysis plan to real-time streaming and downloading the finished report.
How can I try it?
Deep Insight is open sourced on GitHub with a full setup guide, and offers three deployment options spanning development to production.
The first is the Self-Hosted version, which runs locally through the CLI. It’s optimized for rapid iteration with full code-level access to every agent, prompt, and workflow. It sets up in about 10 minutes, which makes it well suited to development. (A Self-Hosted demo video is available on YouTube.)
The second is the Web version, a browser-based UI for uploading data, reviewing analysis plans (Human-in-the-Loop, or HITL), and downloading reports, all without writing code, making it accessible for non-developers. (The preceding demo video shows the Web version in action.)
The third is the Managed AgentCore version, a production deployment option powered by Amazon Bedrock AgentCore, a platform to build, connect, and optimize agents at scale, with any framework or model. This version deploys the agents on AgentCore runtime, a capability of Amazon Bedrock AgentCore. The system runs entirely within a private virtual private cloud (VPC), with a custom Code Interpreter hosted separately on AWS Fargate, and agents run concurrently in isolated per-user environments. It’s the right choice when you need session isolation and private VPC deployment. Part 3 covers its deployment and operations in detail.
All three share the same multi-agent architecture, so an agent validated in development deploys to production as-is.
Solution overview
Building a production multi-agent system takes more than good prompts. You need the right technology stack and infrastructure to address how agents collaborate, how they reason, how you deploy them, where they safely execute code, and how you monitor operational health. Deep Insight solves problems across these five key areas. Because the agents generate both code and report content, we also cover responsible AI controls for production in Solution detail 2.
Challenge
Technology
Approach
“How do we control execution flow across multiple agents?”
Strands Agents SDK
Use Strands’ Graph pattern to define execution order between agents and implement human-in-the-loop branching. Use Strands’ Agents as Tools pattern so the Supervisor can invoke specialized agents (Coder, Validator, Reporter, Tracker) as tools on demand.
“Which large language model (LLM) should each agent use?”
Amazon Bedrock
Select the right Claude model for each role: Haiku for basic routing, Opus for planning, Sonnet for execution.
“How do we reliably operate a finished agent in production?”
Amazon Bedrock AgentCore
Managed runtime with monitoring, session isolation, and private VPC deployment.
“How do we mitigate the security issues of executing AI-generated code?”
AWS Fargate + Application Load Balancer (ALB)
Per-session ephemeral sandbox containers for isolated code execution through a custom Code Interpreter.
The following architecture diagram (Figure 1) illustrates this at a glance. The green boxes represent the Strands Agents multi-agent structure, which addresses challenges 1 and 2 from the preceding table. We will cover this in detail in the upcoming Solution detail 1: Multi-agent system design section. The remaining infrastructure components shown in the diagram address challenges 3, 4, and 5, which we will walk through in Solution detail 2: Production deployment and operations.
Figure 1: Solution architecture
Solution detail 1: Multi-agent system design
Deep Insight uses a multi-agent architecture in which eight agents collaborate to produce one high-quality deliverable. Each agent works in its own independent context, performs only its specialized tasks, and passes only compressed results onward.
Figure 2: Multi-agent structure
The Coordinator routes user requests, the Planner breaks tasks into discrete steps, the Plan Reviewer collects user feedback, and the Supervisor invokes the appropriate specialized agents according to the plan. The Coder writes and executes data analysis code, the Validator verifies calculations, the Reporter generates the final report, and the Tracker tracks progress. We will explain this across three layers:
[1st Layer] Coordinator to Planner to Plan Reviewer: Request analysis and execution plan creation.
Two key patterns from the Strands Agents SDK are combined to control execution flow across these agents. First, the Graph pattern defines the execution order and flow of agents as a directed graph. Requests flow Coordinator, Planner, Plan Reviewer, then Supervisor, with a conditional branch looping back to the Planner on revision requests. Determining the next step by condition makes complex workflows like HITL and error handling straightforward. Second, the Agents-as-Tools pattern lets the Supervisor invoke specialized agents (Coder, Validator, Reporter, Tracker) as tools only when needed. Each works in an independent context and returns only results, minimizing context usage while preserving domain expertise.
This section shows how the architecture solves routing, planning, and orchestration.
[1st Layer] Coordinator to Planner to Plan Reviewer
This layer turns a user request into an approved execution plan.
1.1 Coordinator (routing): Not every request needs expensive orchestration
The Coordinator is the entry point for user requests. It handles basic greetings directly and routes complex tasks like data analysis to the Planner with a handoff_to_planner marker.
The key design decision is model selection: because the Coordinator only classifies, it uses the lightweight Claude Haiku, avoiding Opus-level costs on basic greetings and delivering fast responses.
Routing conditions come from the Coordinator’s prompt: any request needing tools, reasoning, or multi-step thinking goes to the Planner.
1.2 Planner (plan creation): Complex analyses need decomposition before execution
In Deep Insight’s multi-agent structure, the Planner agent plays the critical role of distributing tasks across agents. Before substantive work begins, it breaks large tasks into smaller steps, and each specialized agent executes them one at a time, keeping each agent’s context small.
The Planner uses a Claude Opus model with Extended Thinking turned on to develop the analysis plan. It organizes the plan into a [ ] checklist format that specifies concrete tasks assigned to each agent, stored in a full_plan variable. It breaks the request into 5–10 clear steps, as shown in the following example:
## title
Yummy Food Consumer Purchase Patterns and Advertising Effectiveness Analysis Report

## steps

### 1. Coder: Comprehensive Data Analysis and Insight Generation
- [ ] Load all data files from './data/*' path and understand structure
- [ ] Analyze consumer purchase history (patterns, preferences, customer segments)
- [ ] Analyze advertising data by channel (cost, effectiveness, channel comparison)
- [ ] Category-level analysis (fresh food, convenience food, health food ad effectiveness)
- [ ] Calculate key business metrics (conversion rate, CPA, ROAS, etc.)
- [ ] Generate visualizations (5+ charts, consumer segment charts)
- [ ] Derive strategic marketing insights
- [ ] Generate calculation metadata (for validation)

### 2. Validator: Calculation Verification and Citation Metadata Generation
- [ ] Identify verification targets and extract filter calculations
- [ ] Load data files directly and perform recalculations
- [ ] Verify accuracy of per-channel performance metrics
- [ ] Validate data consistency of visuals and graphs
- [ ] Generate citation metadata (reference numbers for verified items)

### 3. Reporter: Marketing Analysis Report Generation
- [ ] Write report overview
- [ ] Create structured report using verified analysis results
- [ ] Insert visualizations and analysis sections
- [ ] Present marketing strategy recommendations and improvement proposals
- [ ] Generate professional marketing report in DOCX format
1.3 Plan Reviewer
The Plan Reviewer is a HITL node that presents the plan to the user and collects approval or revision feedback. If there is feedback, it loops back to the Planner to revise the plan. If approved, it hands the task off to the Supervisor. A maximum revision count (MAX_PLAN_REVISIONS) is set to prevent infinite loops.
In the Web version, the Plan Reviewer shows a browser modal where the user reads the plan and approves it or enters revision feedback. A 300-second countdown auto-approves the plan if no response arrives.
Figure 3: Plan Reviewer agent execution in the web UI
Without planning, the agent decides everything at runtime, a mid-course correction invalidates previous work, and users have no visibility into progress. With the Planner and Plan Reviewer, the user can review and revise the plan, monitor progress in real time, and re-execute only a failed step.
[2nd Layer] Supervisor (orchestrator): Specialized agents need a conductor
The Supervisor executes the Planner’s full_plan in order, invoking the Layer 3 agents (Coder, Validator, Reporter, Tracker) as tools registered on it through Tool Use.
# nodes.py: registering sub-agents as tools on the Supervisor
agent = strands_utils.get_agent(
    agent_name="supervisor",
    system_prompts=apply_prompt_template(prompt_name="supervisor", prompt_context={}),
    model_id=os.getenv("SUPERVISOR_MODEL_ID", os.getenv("DEFAULT_MODEL_ID")),
    prompt_cache_info=(True, "default"),
    tool_cache=True,
    tools=[coder_agent_tool, reporter_agent_tool, tracker_agent_tool, validator_agent_tool],
    streaming=True,
)
The Supervisor’s system prompt defines strict workflow rules:
Mandatory execution order: Coder, Tracker, Validator, Tracker, Reporter, Tracker: after each agent runs, Tracker is invoked to track progress, letting the Supervisor manage overall task state.
Section completion rule: The Supervisor does not move to the next agent until all checklist items for the current agent are marked [x].
Context preservation: The Supervisor passes clues and full_plan variables to each tool agent, maintaining full context and preventing information loss.
Each Layer 3 agent (Coder, Validator, Reporter, Tracker) is wrapped as a PythonAgentTool and receives Tool Use calls from the Supervisor. Each is created as an independent Agent() instance in the Strands SDK with its own system prompt, model ID, and toolset.
Agent
Role
Tools
Key Output
Coder
Data analysis, chart generation, insight derivation
The Supervisor invokes Tool Use calls in this order, based on the Planner’s checklist:
Coder – Loads data, writes and runs analysis code, produces PNG charts, accumulates results in all_results.txt, and leaves calculation_metadata.json for verification.
Tracker (1st pass) – Updates completed checklist items from [ ] to [x], which the Supervisor uses to decide whether to proceed.
Validator – Re-performs each calculation in calculation_metadata.json from the source data. Matches within 0.01 pass, mismatches are flagged. Verified calculations go to citations.json for the Reporter to cite.
Tracker (2nd pass) – Reflects the Validator’s completion status in the checklist.
Reporter – Reads all_results.txt and citations.json to generate the final DOCX report in two versions, with and without citations.
Tracker (3rd pass) – Reflects the final completion status of all tasks.
Tracker runs after every agent so the Supervisor can track progress and enforce the completion rule (no moving on until all items are [x]). Because it updates the checklist with LLM reasoning and no tools, it adds little overhead.
Per-agent LLM model configuration
Deep Insight tailors the model and settings to each agent’s role. This isn’t a model selection. It’s an architectural decision to optimize cost and quality.
Agent
Model
Extended Thinking
Prompt Caching
Role
Coordinator
Haiku
Disabled
No
Fast routing: cost minimization
Planner
Opus
Enabled (~8,192 tokens)
No
Deep thinking: high-quality planning
Supervisor
Sonnet
Disabled
Yes
Execution orchestration: caching for cost savings
Coder
Sonnet
Disabled
Yes
Code generation/execution: caching effective for repeated calls
Validator
Sonnet
Disabled
No
Numerical verification: different data each time, caching unnecessary
Reporter
Sonnet
Disabled
Yes
Report generation: caching effective for long prompts
Tracker
Sonnet
Disabled
No
Status updates: lightweight tasks, caching unnecessary
The Supervisor, Coder, and Reporter agents use Prompt Caching to cache their system prompts and tool definitions, reducing input token costs by up to 90 percent on repeated calls. The Coordinator runs only once, and the Validator and Tracker run with different contexts each time, so caching is ineffective for them and stays disabled. This selective caching strategy is a deliberate cost/performance trade-off.
Solution detail 2: Production deployment and operations
If Solution detail 1 defined what the system does, this section defines where and how it runs safely. Everything from here on covers infrastructure decisions for production operations. Specifically, this section covers the secure execution environment for LLM-generated code, and operational visibility for the team.
1. Code execution: LLM-generated code needs a secure execution environment
The Coder agent writes and runs Python for data analysis. In the Self-Hosted version it runs locally through subprocess.run(), but in production (AgentCore) security and isolation are essential. Running LLM-generated code directly on a production server is risky: the model might delete system files, exhaust resources in an infinite loop, or reach other users’ analysis data. Deep Insight solves this with per-session ephemeral containers on AWS Fargate and ALB. These components don’t run in isolation. As shown in Figure 1, AgentCore runtime, the ALB, and the Fargate tasks all run inside the same private VPC. VPC endpoints connect them to Amazon Simple Storage Service (Amazon S3), Amazon Bedrock, and Amazon Elastic Container Registry (Amazon ECR) without traversing the public internet. Security groups restrict which components can reach the Code Interpreter containers. AWS Identity and Access Management (IAM) roles scope each component to only the AWS resources it needs. Amazon CloudWatch collects container logs and observability data from AgentCore Observability, a capability of Amazon Bedrock AgentCore.
Custom container Docker image: A pre-optimized sandbox with fonts, system libraries, and Python packages for the multi-agent system.
Container isolation: Each analysis session gets an independent Fargate container in a private VPC subnet with no direct internet access.
2-step execution: LLM-generated code is base64-encoded, sent over HTTP, written to a file (Step 1), then executed through subprocess (Step 2).
Session affinity: ALB sticky session cookies route an agent back to the same container even when it executes code multiple times.
Artifact management: Charts, reports, and logs upload to Amazon S3 when analysis completes. Containers terminate automatically after one hour.
Container isolation protects the infrastructure, but it doesn’t govern what the agents generate. The Validator agent re-verifies calculations. It doesn’t detect prompt-injection instructions hidden in uploaded data or screen LLM-generated text for harmful or ungrounded content. For production deployments, we recommend adding Amazon Bedrock Guardrails as a responsible AI control: apply content filters and prompt attack detection to user prompts and uploaded data, and apply contextual grounding checks to agent outputs so that report text stays grounded in the source data and verified calculations.
2. Operations and monitoring: Teams need visibility
A production system isn’t complete with code alone. The team must assess system health, diagnose issues, and review results, so Deep Insight provides a Web UI and an Ops dashboard.
Web UI (deep-insight-web)
A FastAPI-based web interface that communicates with the backend through the AgentCore Native Protocol (boto3.invoke_agent_runtime()). Users upload data and enter a prompt, then monitor progress through Server-Sent Events (SSE) streaming. When the plan is generated, a modal lets the user approve or give revision feedback (HITL). The finished report can be downloaded directly. Both Korean and English are supported.
Figure 4: Deep Insight web version screenshot
Ops dashboard (deep-insight-web/ops)
The Ops dashboard is optional. Deep Insight works fine without it, but it adds these features for teams that need them:
Task tracking: All analysis task metrics, including status, token usage, and elapsed time, are recorded in Amazon DynamoDB.
Failure alerting: When an analysis fails, an email is immediately sent to administrators through Amazon SNS.
Admin dashboard: A dedicated admin dashboard is protected by JSON Web Token (JWT) authentication through Amazon Cognito for secure task monitoring.
Figure 5: Deep Insight Ops dashboard screenshot
Figure 6: Deep Insight Ops dashboard detail view
Extending the Deep Insight architecture
Deep Insight’s multi-agent architecture isn’t confined to the single domain of data analysis report generation. The following two examples demonstrate that the hierarchical orchestration design principles remain effective in entirely different domains.
Case 1: LG Electronics: Agentic AI-powered marketing insight extraction system
LG Electronics’ Korea Sales Division built ChatInsight on the same multi-agent architecture as Deep Insight, where data analysis requests had taken 2–3 weeks and lost intent between marketers and data scientists. The Coordinator routes by complexity, the Planner tracks tasks, and the Supervisor orchestrates the Coder and Reporter, with inter-agent state passed cumulatively through an all_results.txt file. Analysis that took 3 days now takes 30 minutes, a 288x productivity improvement. Marketers who don’t know SQL can let the agent explore data and propose strategies (see the LG Electronics Agentic AI Insight Extraction System on the AWS Tech Blog).
Figure 7: LG Electronics Agentic AI marketing insight system architecture
Case 2: TechRecon: AI-powered technology reconnaissance agent (re:Invent 2025)
Presented at AWS re:Invent 2025 (session SNR203), TechRecon applies Deep Insight’s architecture to technology strategy. Given a company and sector, a Researcher gathers technology trends, the Coder analyzes, the Validator verifies, and the Reporter produces a Landscape Analysis and a Technical Position Paper. The architecture is nearly identical to Deep Insight, built with the Strands Agents SDK Graph pattern and Extended Thinking and Prompt Caching, with Researcher replacing Coder as the primary execution agent. It shows the design is a general-purpose pattern: swap the agents’ roles and prompts, and the same orchestration structure solves entirely different problems.
Building an agent that works in production is not a matter of model capability. It’s a matter of architecture. Deep Insight offers a proven answer:
Workflow management: The Strands Agents SDK’s Graph pattern defines execution order between agents and implements HITL branching, while the Agents-as-Tools pattern lets the Supervisor invoke specialized agents only when needed.
Reasoning engine: We assign Claude models from Amazon Bedrock by role (Haiku, then Opus, then Sonnet) to optimize cost and quality.
Deployment: Amazon Bedrock AgentCore provides a managed runtime with session isolation, private VPC deployment, and OpenTelemetry observability.
Code execution: Application Load Balancer plus Amazon Elastic Container Service (Amazon ECS) on Fargate isolates LLM-generated code execution in per-session ephemeral sandbox containers, preventing security issues such as system file access, resource exhaustion, and unintended data disclosure.
Operations: The Web UI’s SSE streaming and the Ops dashboard (DynamoDB + Cognito + SNS) provide visibility across the entire team.
LG Electronics’ marketing insight system and the TechRecon case at re:Invent 2025 validated these design principles.
In Part 2, we examine four layers of Context Engineering techniques for overcoming context-window limits on top of this architecture, from architecture-level isolation to prompt design, tool optimization, and verification safeguards, comparing our approach with Anthropic’s engineering research.
Deep Insight is open source. Explore the code and extend it for your own domain.