Ingeniería de inteligencia agente con Amazon Nova Multimodal Embeddings y Amazon Bedrock AgentCore
Agentic engineering intelligence with Amazon Nova Multimodal Embeddings and Amazon Bedrock AgentCore
Aishwarya Gavili
Cuando un componente aeroespacial calificado se vuelve obsoleto o tiene un tiempo de entrega largo, un ingeniero pasa días haciendo referencias cruzadas de especificaciones en hojas de datos de proveedores, documentos de control de interfaz (ICDs) y registros de calificación antes de documentar una justificación de sustitución para revisión. Una sustitución incorrecta en un componente crítico para el vuelo puede causar un fallo en la misión, sin embargo, la pista de evidencia detrás de cada decisión a menudo se encuentra dispersa en correos electrónicos y conocimiento institucional no documentado, por lo que no hay un paquete formal y repetible para que un revisor lo verifique.
Una publicación anterior, Manufacturing intelligence with Amazon Nova Multimodal Embeddings, mostró cómo el modelo recupera respuestas bloqueadas dentro de diagramas de ingeniería, tramas térmicas y gráficos de hojas de datos que los pipelines de solo texto pasan por alto. Esta publicación continúa donde dejó el trabajo de recuperación, poniendo esas capacidades dentro de un sistema de múltiples agentes que ensambla la evidencia de sustitución, desde la recuperación hasta una evaluación redactada.
En esta publicación, mostramos cómo construir un asistente de ingeniería de múltiples agentes que reduce la referencia cruzada manual detrás de la evaluación de sustitución de partes utilizando Amazon Bedrock AgentCore, Amazon Nova Multimodal Embeddings y el kit de desarrollo de software de código abierto Strands Agents SDK. Un planificador enruta el trabajo a través de tres agentes especializados que buscan en una base de conocimiento multimodal, puntúan a los candidatos contra reglas de tolerancia deterministas, comparan fotos de partes y basan las reclamaciones de ciclo de vida en datos web en vivo. El ingeniero sigue siendo el responsable de la toma de decisiones en todo momento, porque el sistema ensambla la evidencia y redacta documentos sin aprobar nunca una sustitución por sí mismo.
Visión general de la solución
El asistente se construye alrededor de una regla de diseño, que es que el ingeniero toma todas las decisiones y el sistema ensambla la evidencia para ello. Esa regla determina dónde usamos modelos de lenguaje grande (LLM) y dónde usamos código determinista en su lugar.
Tres pilares definen la arquitectura:
Evaluación de especificaciones determinista – El código de reglas de tolerancia escrito en Python califica cada parte candidata con respecto a la parte de referencia y los requisitos establecidos por el ingeniero. Dado que las mismas entradas producen consistentemente los mismos veredictos de aprobación/marca, los resultados pueden incorporarse en una revisión formal de ingeniería.
Orquestación de multi-agente – Un planificador ligero enruta cada consulta a uno o más de tres agentes especializados (Catálogo, Evaluación, Conocimiento), y un supervisor sintetiza sus hallazgos solo cuando más de un especialista contribuyó. Preguntas complejas como “Verificar si esta rueda está llegando al final de su vida útil, encontrar alternativas y calificarlas” encadenan a los tres especialistas en secuencia.
Decisión con intervención humana – El sistema redacta memorandos de justificación y Evaluaciones de Impacto de Integración para revisión de ingeniería, pero no recomienda ni aprueba una sustitución. Cada evaluación también escribe una entrada de auditoría alineada con las secciones 8.4 y 8.5.6 de AS9100.
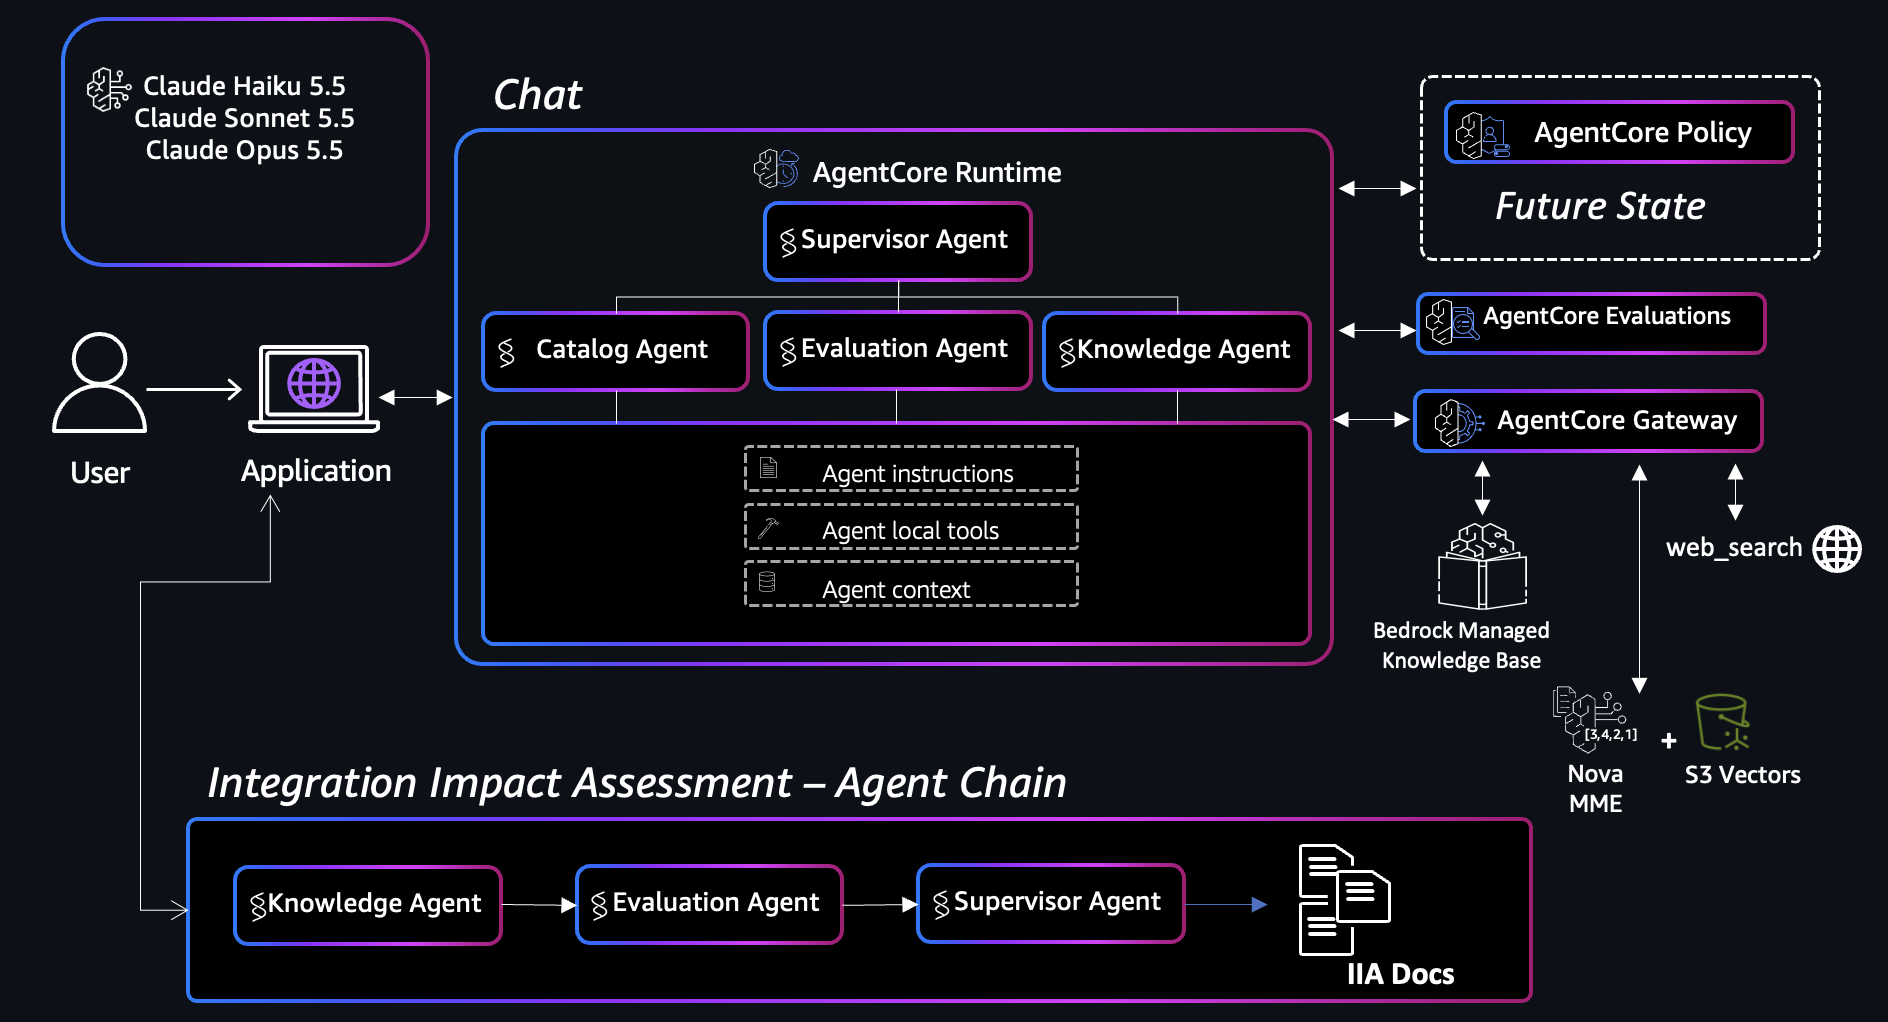
El siguiente diagrama muestra la arquitectura.
Figura 1: Arquitectura del asistente de ingeniería de multi-agente en Amazon Bedrock AgentCore
Amazon Bedrock AgentCore es una plataforma para construir, conectar y optimizar agentes a gran escala, con cualquier framework o modelo. En esta solución, las solicitudes de chat desde la aplicación del ingeniero fluyen hacia un grafo de multiagente alojado en el runtime de AgentCore: un planificador (Claude Haiku 5.5) produce un plan de enrutamiento, los especialistas (Claude Sonnet 5.5) ejecutan sus herramientas y un supervisor (Claude Opus 5.5) sintetiza sus resultados cuando más de un especialista se ejecuta. Los especialistas recuperan desde una base de conocimiento administrada que creamos con Amazon Bedrock Managed Knowledge Bases utilizando Amazon Nova Multimodal Embeddings, enrutados a través de un Gateway de AgentCore, una capacidad de Amazon Bedrock AgentCore, junto con el conector de búsqueda web para datos web en vivo. Para la consulta de imagen (subir un gráfico para identificar una parte), el agente llama directamente a un índice de vectores de Amazon S3, porque la API de recuperación de la base de conocimiento administrada no acepta entrada de imagen. Amazon S3 Vectors es una capacidad del Servicio de almacenamiento simple de Amazon (Amazon S3). Una cadena fija separada (Conocimiento, luego Evaluación, luego Supervisor) produce el documento formal de Evaluación de Impacto de Integración (IIA).
Amazon Nova Multimodal Embeddings aparece en dos roles distintos:
Recuperación multimodal – Las hojas de datos, los ICD y las gráficas de rendimiento se incrustan con Amazon Nova Multimodal Embeddings para que el contenido de texto y visual compartan un espacio semántico. Un ingeniero puede ingresar “curva de torque para la rueda de 0,06 Nms” o subir una imagen de gráfico, y la recuperación devuelve el diagrama coincidente con la atribución de fuente.
Puntuación de similitud visual – Cuando se comparan dos partes candidatas, Amazon Nova Multimodal Embeddings produce una similitud cosina cuantitativa entre sus fotos, y Claude analiza las diferencias físicas específicas (patrón de montaje, colocación del conector, geometría del alojamiento). La puntuación agrega evidencia de apoyo a la comparación de especificaciones determinista, en la que se basa el veredicto de ajuste.
Requisitos previos
Para seguir adelante, necesitas:
Una cuenta de AWS con acceso a Amazon Bedrock en la región de AWS US East (N. Virginia).
Acceso a modelos a Amazon Nova Multimodal Embeddings, Claude Haiku 5.5, Claude Sonnet 5.5 y Claude Opus 5.5 en Amazon Bedrock. Para obtener información sobre la disponibilidad de modelos por región, consulte Soporte de modelos por región de AWS en Amazon Bedrock.
Una base de conocimientos administrada creada con Amazon Bedrock Managed Knowledge Bases, utilizando Amazon Nova Multimodal Embeddings sobre su corpus de partes (hojas de datos, ICD, descripciones) para recuperación de texto y documentos.
Un índice de vectores de Amazon S3 sobre sus fotos de partes y recortes de gráficos de hojas de datos, para el camino de consulta de imagen.
Un gateway de Amazon Bedrock AgentCore con el conector de búsqueda web y un objetivo de base de conocimientos administrada.
Python 3.10 o posterior y Jupyter para ejecutar los cuadernos.
Docker, si adapta la receta de implementación en la notebook 03 para hospedar el agente en el runtime de AgentCore.
Las siguientes secciones describen cada parte del sistema en el orden en que se utiliza una consulta. Comenzamos con el corpus de partes y los agentes especializados, luego cubrimos la routificación, la puntuación determinista, las dos formas en que el asistente utiliza Nova Multimodal Embeddings, la cadena fija que produce documentos formales y la implementación en el runtime de AgentCore.
El ejemplo de código completo es un conjunto de cinco cuadernos de Jupyter en el repositorio de GitHub, y cada cuaderno se ejecuta de forma independiente. Los cuadernos importan desde mei_core, una copia autocontenida de los módulos de agente y herramientas en la misma carpeta, e incluyen sus propios datos de partes, recortes de gráficos y conjunto de consultas de evaluación. Puede ejecutar cada fragmento de este mensaje desde los cuadernos sin otro código de aplicación.
Estructurar el corpus de partes
El conjunto de datos de ejemplo consta de siete ruedas de reacción de un fabricante ficticio (AnyCompany) que abarcan 0,003-5,0 Nms de almacenamiento de momento. Cada parte es una carpeta que empareja datos estructurados con los documentos de origen que un ingeniero lee en realidad, y esta mezcla es lo que hace que el corpus sea multimodal. El archivo specs.json contiene los campos legibles por máquina que impulsan la puntuación determinista, mientras que el ICD, la foto del producto y la página de hoja de datos renderizada llevan el detalle visual y narrativo que dejan fuera los campos estructurados.
El archivo specs.json captura tanto las especificaciones de ingeniería como un perfil de ciclo de vida, lo que permite al asistente marcar la obsolescencia y el riesgo de tiempo de entrega junto con la coincidencia de especificaciones.
El campo vendor se establece explícitamente para cada parte. Debido a que los IDs de carpetas de catálogo y los nombres de archivo se reutilizan en varios conjuntos de datos, cada prompt especializado trata el valor vendor estructurado devuelto por get_part_specs como autorizado y no está permitido adivinar un fabricante a partir de un ID, un nombre de archivo, una foto o un resultado de búsqueda web. Tomar el fabricante de los datos estructurados evita que el asistente atribuya una parte al proveedor incorrecto porque el modelo piensa que reconoce el hardware.
Cada carpeta de parte también lleva dos activos que la indexación de solo texto no puede utilizar. La foto del producto alimenta la puntuación de similitud visual, y la página de hoja de datos renderizada lleva tramas de caja de torque y curva de torque que responden a preguntas de rendimiento que no captura ninguna capa de texto OCR. Las incrustaciones multimodales de Amazon Nova incrustan ambos en el mismo espacio vectorial que el texto, por lo que una consulta puede coincidir con un valor de especificación, un párrafo o una trama.
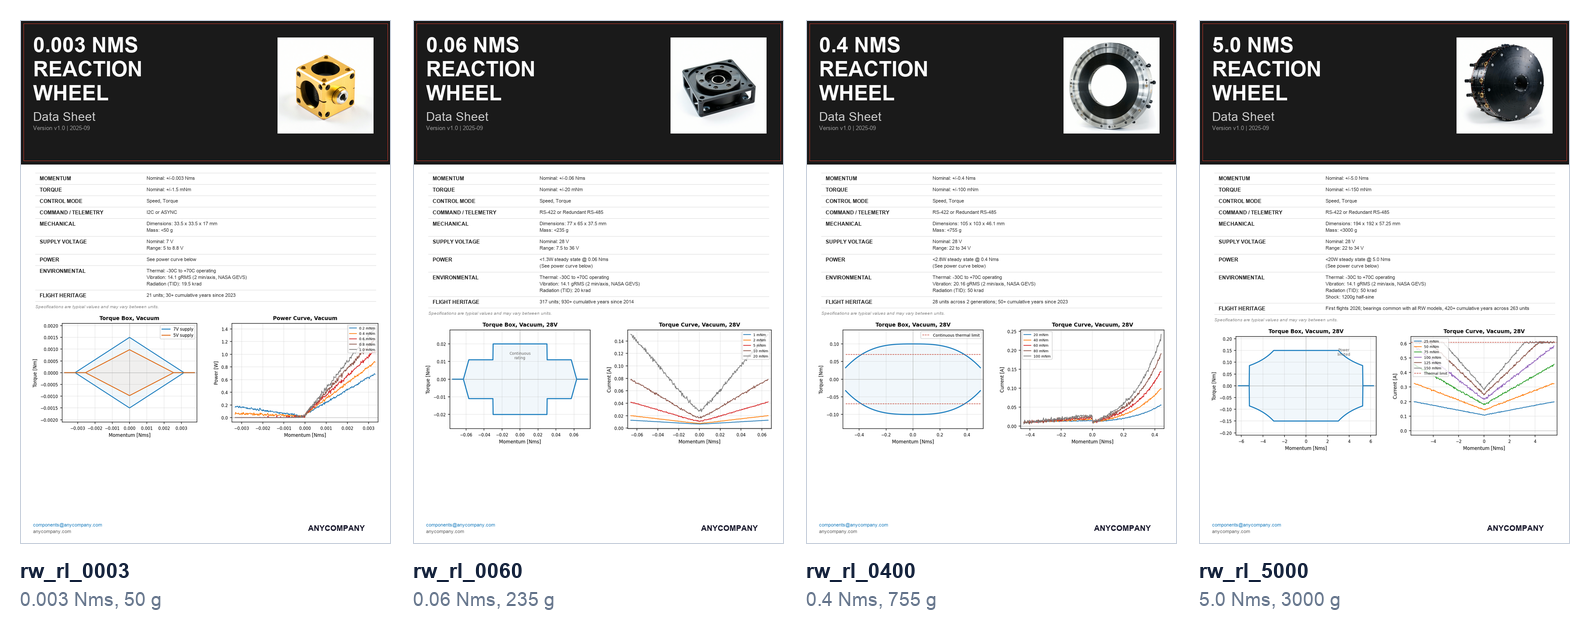
La siguiente muestra muestra cuatro páginas de hoja de datos del corpus, que abarcan tres órdenes de magnitud de almacenamiento de momento.
Figura 2: Cuatro páginas de hoja de datos del corpus de partes, que abarcan tres órdenes de magnitud de almacenamiento de momento
La plantilla se repite en toda la familia, pero la foto del producto y el par de tramas de rendimiento cambian con cada parte. Estas regiones muestran la geometría del alojamiento, el patrón de montaje, el sobre de torque y la potencia de extracción, que los campos de especificaciones no establecen directamente, por lo que los incrustamos junto con el texto.
Definir especialistas con herramientas con ámbito
Cada especialista es un agente Strands con un prompt estrecho y solo las herramientas que necesita. Limitar las herramientas por especialista mantiene un comportamiento predecible, porque el especialista en conocimiento no tiene acceso a las herramientas de descubrimiento de catálogo y el especialista en catálogo no tiene acceso a las herramientas de evaluación. El siguiente código crea el especialista en evaluación.
from strands import Agent

def create_evaluation_specialist() -> Agent:
    """Evaluation Specialist: deterministic spec-by-spec comparison and scoring."""
    return Agent(
        name="evaluation_specialist",
        system_prompt="""You are the Evaluation Specialist. Your job is to run
deterministic, spec-driven comparisons between parts.
...
RULES:
- Your comparisons are deterministic (code, not opinion)
- NEVER recommend or approve --- present evidence and flags; the engineer decides
- Always include the disclaimer that this is evidence only""",
        tools=[score_substitution_fit, compare_parts, visual_similarity_score,
               check_qualification_status, generate_substitution_memo],
        model="us.anthropic.claude-sonnet-5-5",
    )
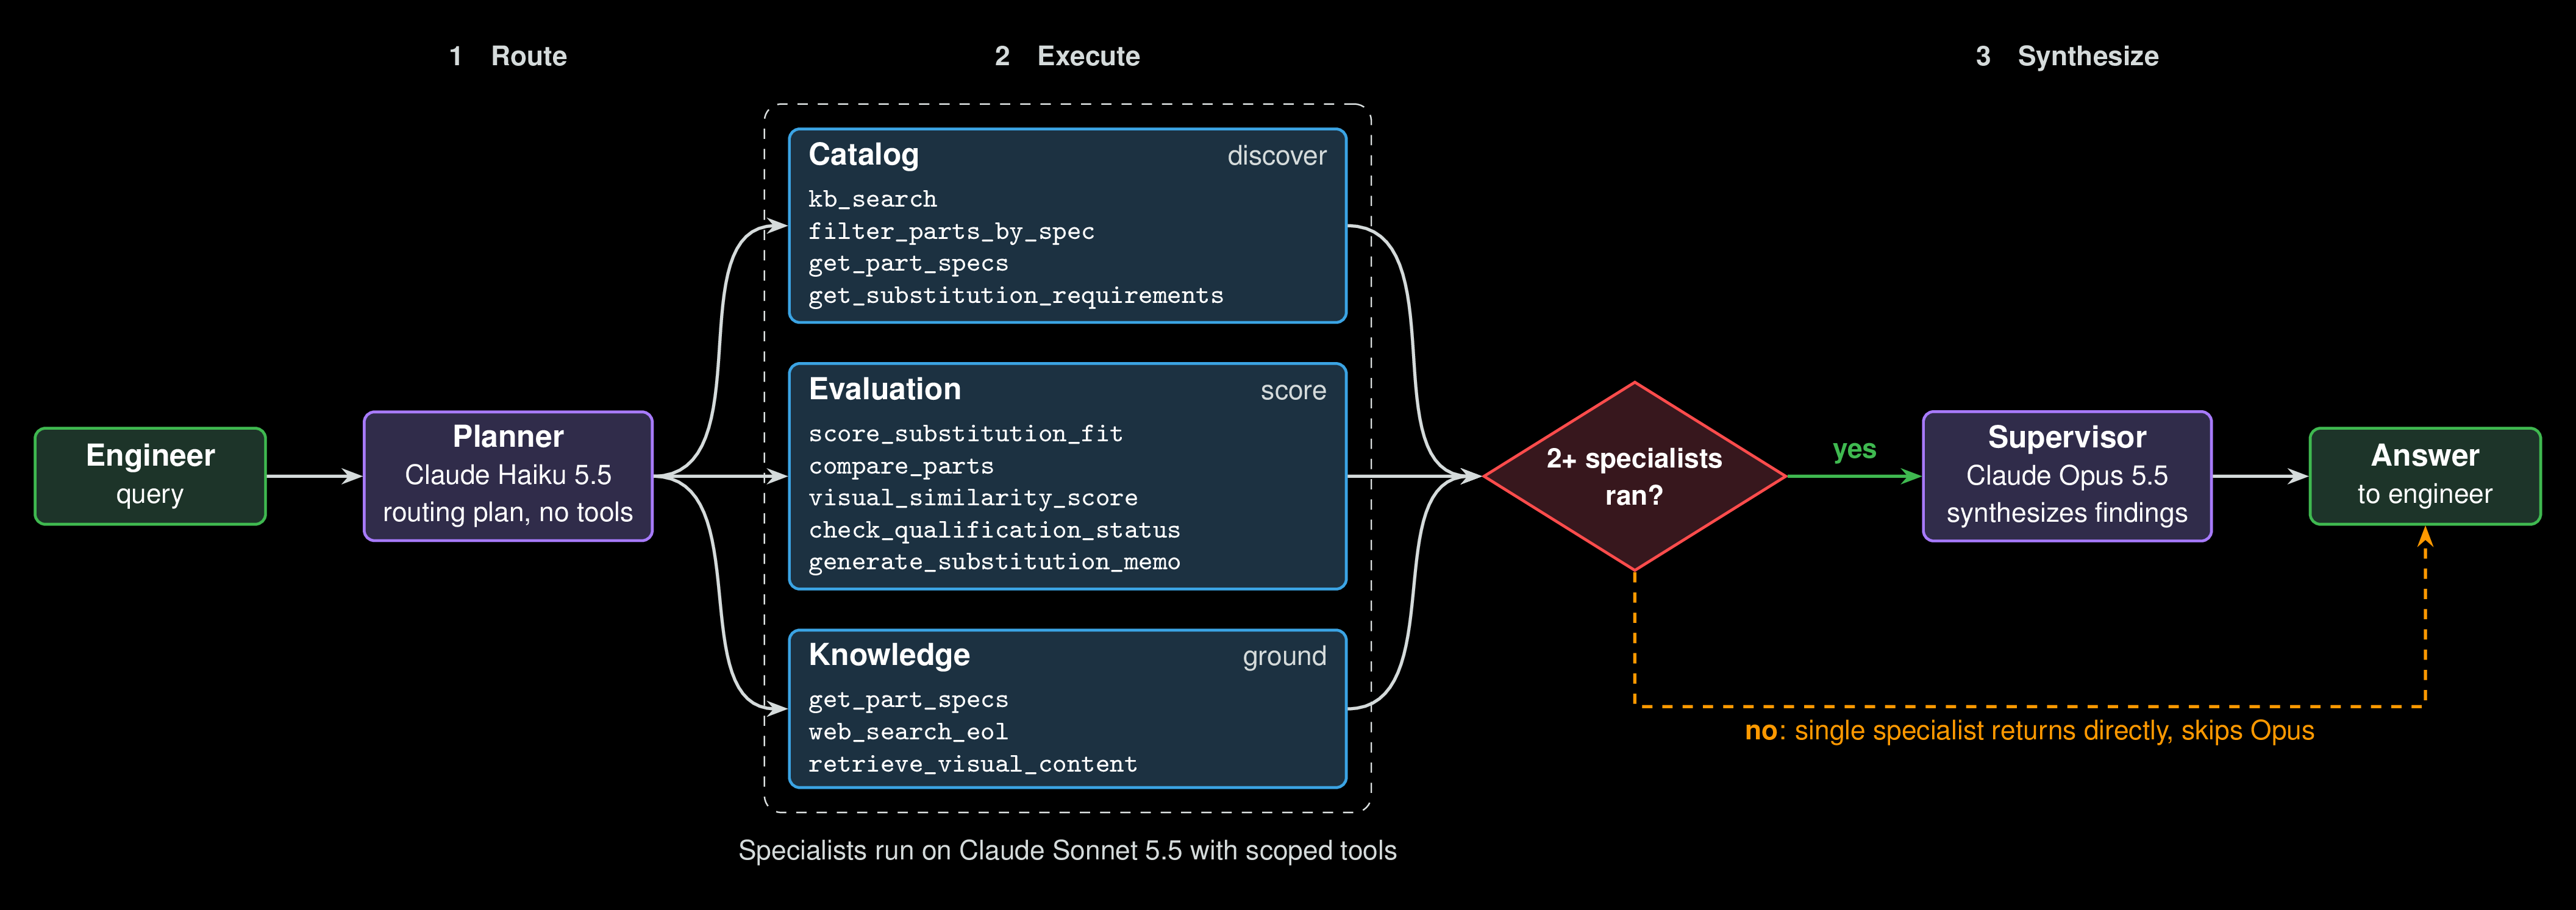
El siguiente diagrama muestra cómo el planificador enruta una consulta a los especialistas y cuándo el supervisor sintetiza sus resultados. La lista después describe qué hace cada especialista.
Figura 3: Cómo el planificador enruta consultas a especialistas y el supervisor sintetiza resultados
Catálogo – Descubre partes a través de la búsqueda de la base de conocimientos y el filtrado exhaustivo de especificaciones (kb_search, filter_parts_by_spec, get_part_specs, get_substitution_requirements).
Evaluación – Puntuación de candidatos de manera determinista y comparación visual de partes (score_substitution_fit, compare_parts, visual_similarity_score, check_qualification_status, generate_substitution_memo).
Conocimiento – Responde preguntas de hojas de datos y ICD, verifica el estado de fin de vida en vivo y recupera contenido visual (get_part_specs, web_search_eol, retrieve_visual_content).
Utilice un modelo pequeño para la ruta y un modelo grande para la síntesis
La ruta es una tarea de clasificación sin llamadas a herramientas, por lo que no necesita un modelo de razonamiento grande. Un planificador basado en Haiku devuelve un plan de ruta numerado en un par de segundos. El supervisor Opus solo se ejecuta cuando dos o más especialistas contribuyeron, porque sintetizar la respuesta ya completa de un solo especialista agrega alrededor de 8 segundos de latencia sin ganancia de calidad.
# Step 1: Planner (fast model) plans the routing (may be multi-step).
plan_response = planner(planning_prompt)
ordered_specialists = _parse_specialist_plan(str(plan_response))

# Step 2: Execute specialists in sequence, passing context forward
accumulated_context = ""
for spec_name in ordered_specialists:
    specialist = specialists[spec_name]
    specialist_response = specialist(spec_prompt)
    accumulated_context += f"\n[{spec_name.upper()}]: {specialist_response}\n"

# Step 3: Synthesize only when 2+ specialists ran.
if len(ordered_specialists) == 1:
    final_text = steps[0]["response"]
else:
    final_text = str(supervisor(synthesis_prompt))
Dividir el trabajo en tres niveles de modelo coincide con el costo y la latencia de cada etapa. Haiku clasifica la consulta, Sonnet ejecuta las herramientas y Opus escribe la respuesta combinada, que es el paso donde la calidad de la respuesta es más importante.
Mantenga la puntuación determinista
La evaluación de ajuste de especificaciones se ejecuta como código Python ordinario contra un esquema de requisitos escrito a mano. El esquema define las especificaciones críticas y las reglas de tolerancia para cada categoría de componentes, y score_substitution_fit compara cada especificación, cuenta los pases y las banderas, y muestra el riesgo del ciclo de vida. Como el veredicto debe ser reproducible para un paquete de revisión de ingeniería, no se involucra a LLM en este paso.
La herramienta devuelve un veredicto estructurado con un aviso explícito:
return {
    "spec_results": results,  # per-spec pass/flag/review status
    "counts": counts,
    "out_of_tolerance": out_of_tolerance,
    "lifecycle": {...},  # obsolescence and lead-time flags
    "summary": summary,
    "disclaimer": "Evidence only. This tool does not recommend or approve "
                  "a substitution; the engineer decides.",
}
El especialista presenta esta tabla y explica las banderas, pero no puede cambiar un veredicto. El registro de auditoría sigue la misma división de trabajo. Después de cada evaluación, la capa de orquestación lee el historial de llamadas de herramientas del especialista y escribe la entrada de auditoría en sí misma, por lo que la registración no depende de que el modelo recuerde hacerlo.
Calificar la similitud visual con Amazon Nova Multimodal Embeddings
El factor de forma es importante cuando un sustituto debe ajustarse a un soporte existente. La herramienta visual_similarity_score incrusta ambas fotos de piezas con Nova Multimodal Embeddings y calcula la similitud del coseno, luego le pide a Claude que describa las diferencias observables específicas.
def embed_image(image_bytes):
    """Embed one image with Nova MME (IMAGE_RETRIEVAL) -> 1024-d vector."""
    b64 = base64.b64encode(image_bytes).decode('utf-8')
    fmt = 'png' if image_bytes[:8] == b'\x89PNG\r\n\x1a\n' else 'jpeg'
    body = {
        'taskType': 'SINGLE_EMBEDDING',
        'singleEmbeddingParams': {
            'embeddingPurpose': 'IMAGE_RETRIEVAL',
            'embeddingDimension': 1024,
            'image': {'detailLevel': 'STANDARD_IMAGE', 'format': fmt,
                      'source': {'bytes': b64}},
        },
    }
    resp = bedrock.invoke_model(
        modelId='amazon.nova-2-multimodal-embeddings-v1:0',
        body=json.dumps(body), accept='application/json',
        contentType='application/json',
    )
    result = json.loads(resp['body'].read())
    return np.array(result['embeddings'][0]['embedding'])

# cosine similarity of the two photo embeddings
emb_a, emb_b = embed_image(photo_a_bytes), embed_image(photo_b_bytes)
similarity = float(np.dot(emb_a, emb_b) /
                   (np.linalg.norm(emb_a) * np.linalg.norm(emb_b)))
La similitud de incrustación es determinista y reproducible, devolviendo alrededor de 0,84 para dos ruedas de la misma familia de productos y 0,40 para ruedas de diferentes clases. El análisis de visión de Claude explica entonces qué impulsa la diferencia, por ejemplo, observando que una carcasa es aproximadamente el doble del diámetro de la otra y tiene un patrón de montaje de seis agujeros donde la otra tiene cuatro.
Recuperar gráficos y diagramas con dos rutas de recuperación
Las consultas de texto y documento pasan por la base de conocimientos administrada respaldada por Amazon Nova Multimodal Embeddings, enrutada a través de la puerta de enlace AgentCore. La imagen como consulta (subir un gráfico o foto para encontrar contenido coincidente) utiliza un índice de vectores nativo de Amazon S3 llamado directamente desde el agente, porque la API de recuperación de la base de conocimientos administrada no acepta entrada de imagen.
Herramienta retrieve_visual_content del especialista en conocimientos proporciona una interfaz para ambas rutas. Un ingeniero puede pegar una curva de rendimiento de un documento de requisitos en el chat y preguntar qué pieza coincide con ella, o describir el gráfico en una consulta de texto en su lugar.
# Image-as-query: embed the uploaded image with Nova MME, exactly as the
# datasheet crops and photos were embedded at indexing time.
def embed_query_image(image_bytes):
    b64 = base64.b64encode(image_bytes).decode('utf-8')
    fmt = 'png' if image_bytes[:8] == b'\x89PNG\r\n\x1a\n' else 'jpeg'
    body = {'taskType': 'SINGLE_EMBEDDING', 'singleEmbeddingParams': {
        'embeddingPurpose': 'IMAGE_RETRIEVAL', 'embeddingDimension': 1024,
        'image': {'detailLevel': 'STANDARD_IMAGE', 'format': fmt,
                  'source': {'bytes': b64}}}}
    r = bedrock.invoke_model(modelId=NOVA_MME_MODEL_ID, body=json.dumps(body),
                             accept='application/json', contentType='application/json')
    return json.loads(r['body'].read())['embeddings'][0]['embedding']
En la ruta de imagen, la carga se incrusta con Nova Multimodal Embeddings en 1.024 dimensiones utilizando el propósito IMAGE_RETRIEVAL, luego se empareja con el índice de vectores S3:
# Query the native S3 Vectors index and collapse to the best vector per part.
emb = embed_query_image(image_bytes)
s3v = boto3.client('s3vectors', region_name=REGION)
fetch_k = max(top_k * 6, 12)  # each part has several vectors; dedupe below
resp = s3v.query_vectors(
    vectorBucketName=S3_VECTOR_BUCKET, indexName=S3_VECTOR_INDEX,
    queryVector={'float32': emb}, topK=fetch_k,
    returnDistance=True, returnMetadata=True,
)

best = {}
for v in resp.get('vectors', []):
    meta = v.get('metadata', {}) or {}
    pid = meta.get('part_id', '')
    if not pid:
        continue
    sim = 1.0 - v.get('distance', 1.0)  # cosine distance -> similarity
    if pid not in best or sim > best[pid]['score']:
        best[pid] = {'part_id': pid, 'score': sim}
ranked = sorted(best.values(), key=lambda r: r["score"], reverse=True)[:top_k]
Como una pieza contribuye con varios vectores (su foto, la página completa de la hoja de datos y cada región de gráfico recortada), los resultados se deduplican al vector con la mejor puntuación por pieza antes de que lleguen al modelo.
Aprendimos tres lecciones prácticas mientras construíamos las rutas de recuperación:
Recortar los gráficos antes de indexarlos – Las páginas completas de hojas de datos hacen malas entradas de índice, porque aproximadamente el 90 por ciento de una página (encabezado, tabla de especificaciones, pie de página) es contenido estándar que cada parte comparte, y ese contenido compartido domina la incrustación. Indexar regiones de gráficos recortados junto con la página completa resolvió este problema. En nuestras pruebas, la coincidencia de subida de gráficos pasó de 3 de 7 partes correctas con indexación de página completa a 7 de 7 con recortes de banda de gráficos. Definimos las regiones de recorte como fracciones de la página, lo que mantiene su corrección en todas las resoluciones de hojas de datos.
Filtrar resultados cuando el ingeniero nombra una parte – La similitud de texto a imagen entre modos cruzados por sí sola no devuelve de manera confiable el gráfico correcto de la parte, porque una imagen de curva de torque no contiene un nombre de parte visible. Cuando el ingeniero nombra una parte específica, la herramienta mantiene solo los resultados del contenido indexado de esa parte, que identifica analizando la carpeta de la parte de la URI de S3 de cada resultado. Como el filtro se ejecuta en la herramienta, funciona sin metadatos personalizados en el índice.
Registrar cada fallback en la ruta de la imagen – La ruta de la imagen devuelve None en caso de errores y pasa a la recuperación de texto. Ese fallback es razonable, pero significa que una falta de permiso s3vectors:QueryVectors en el rol de ejecución del runtime de AgentCore no genera un error. La imagen como consulta deja de funcionar sin advertencia, y el modelo nombra una parte incorrecta con alta confianza aparente. El problema es fácil de pasar por alto durante el desarrollo, porque las credenciales de desarrollador local suelen tener permisos más amplios que el rol de runtime. La herramienta ahora registra una advertencia explícita S3 Vectors image query FAILED con el bucket, índice y región cada vez que esa ruta pasa a un fallback. Instrumentar cada fallback silencioso en una ruta de recuperación, porque un fallo duro es mucho más fácil de diagnosticar que uno silencioso.
Producir documentos formales con una cadena de especialistas fija
Chat utiliza enrutamiento dinámico porque los especialistas adecuados para una pregunta de forma libre no se pueden conocer de antemano. La Evaluación de Impacto de Integración funciona de manera diferente. Cuando un ingeniero solicita una evaluación de impacto para un par de referencia y candidato, la secuencia requerida ya se conoce, por lo que el servicio compone las mismas funciones de fábrica de especialistas en un orden fijo con una llamada de síntesis con propósito específico.
# 1. Knowledge Specialist --- ICD/datasheet interface detail for both parts
knowledge_text = str(knowledge(knowledge_prompt))

# 2. Evaluation Specialist --- structured field delta + qualification check
evaluation_text = str(evaluation(evaluation_prompt))

# Deterministic structured delta for exact summary stats
comparison = compare_parts(reference_id, candidate_id)

# 3. Supervisor --- synthesize into the six-section IIA document
markdown = str(supervisor(synthesis_prompt))
El documento resultante cubre cambios de interfaz, integración mecánica, integración eléctrica, integración térmica, delta de calificación y impacto de la cadena de suministro. Las secciones narrativas necesitan síntesis de LLM, porque los detalles de pinout y protocolo deben extraerse de la prosa de ICD. Las estadísticas resumidas (coincidencias, diferencias, campos totales) se calculan directamente a partir de la salida de compare_parts, por lo que los números mostrados junto a la narrativa son exactos.
Reclamos de ciclo de vida en datos web en vivo a través de la puerta de enlace de AgentCore
Los datos del catálogo se vuelven obsoletos, por lo que la herramienta web_search_eol del especialista en conocimiento verifica los avisos de fin de vida actuales, los anuncios de los proveedores y los tiempos de entrega a través de una puerta de enlace de AgentCore con el conector de búsqueda web. La puerta de enlace expone el conector como un punto final de protocolo de contexto de modelo (MCP) gobernado. Como la puerta de enlace también maneja la recuperación de la base de conocimientos administrada, puede adjuntar la política y la observabilidad tanto al acceso a datos externos como internos en un solo lugar.
Implementar en tiempo de ejecución de AgentCore
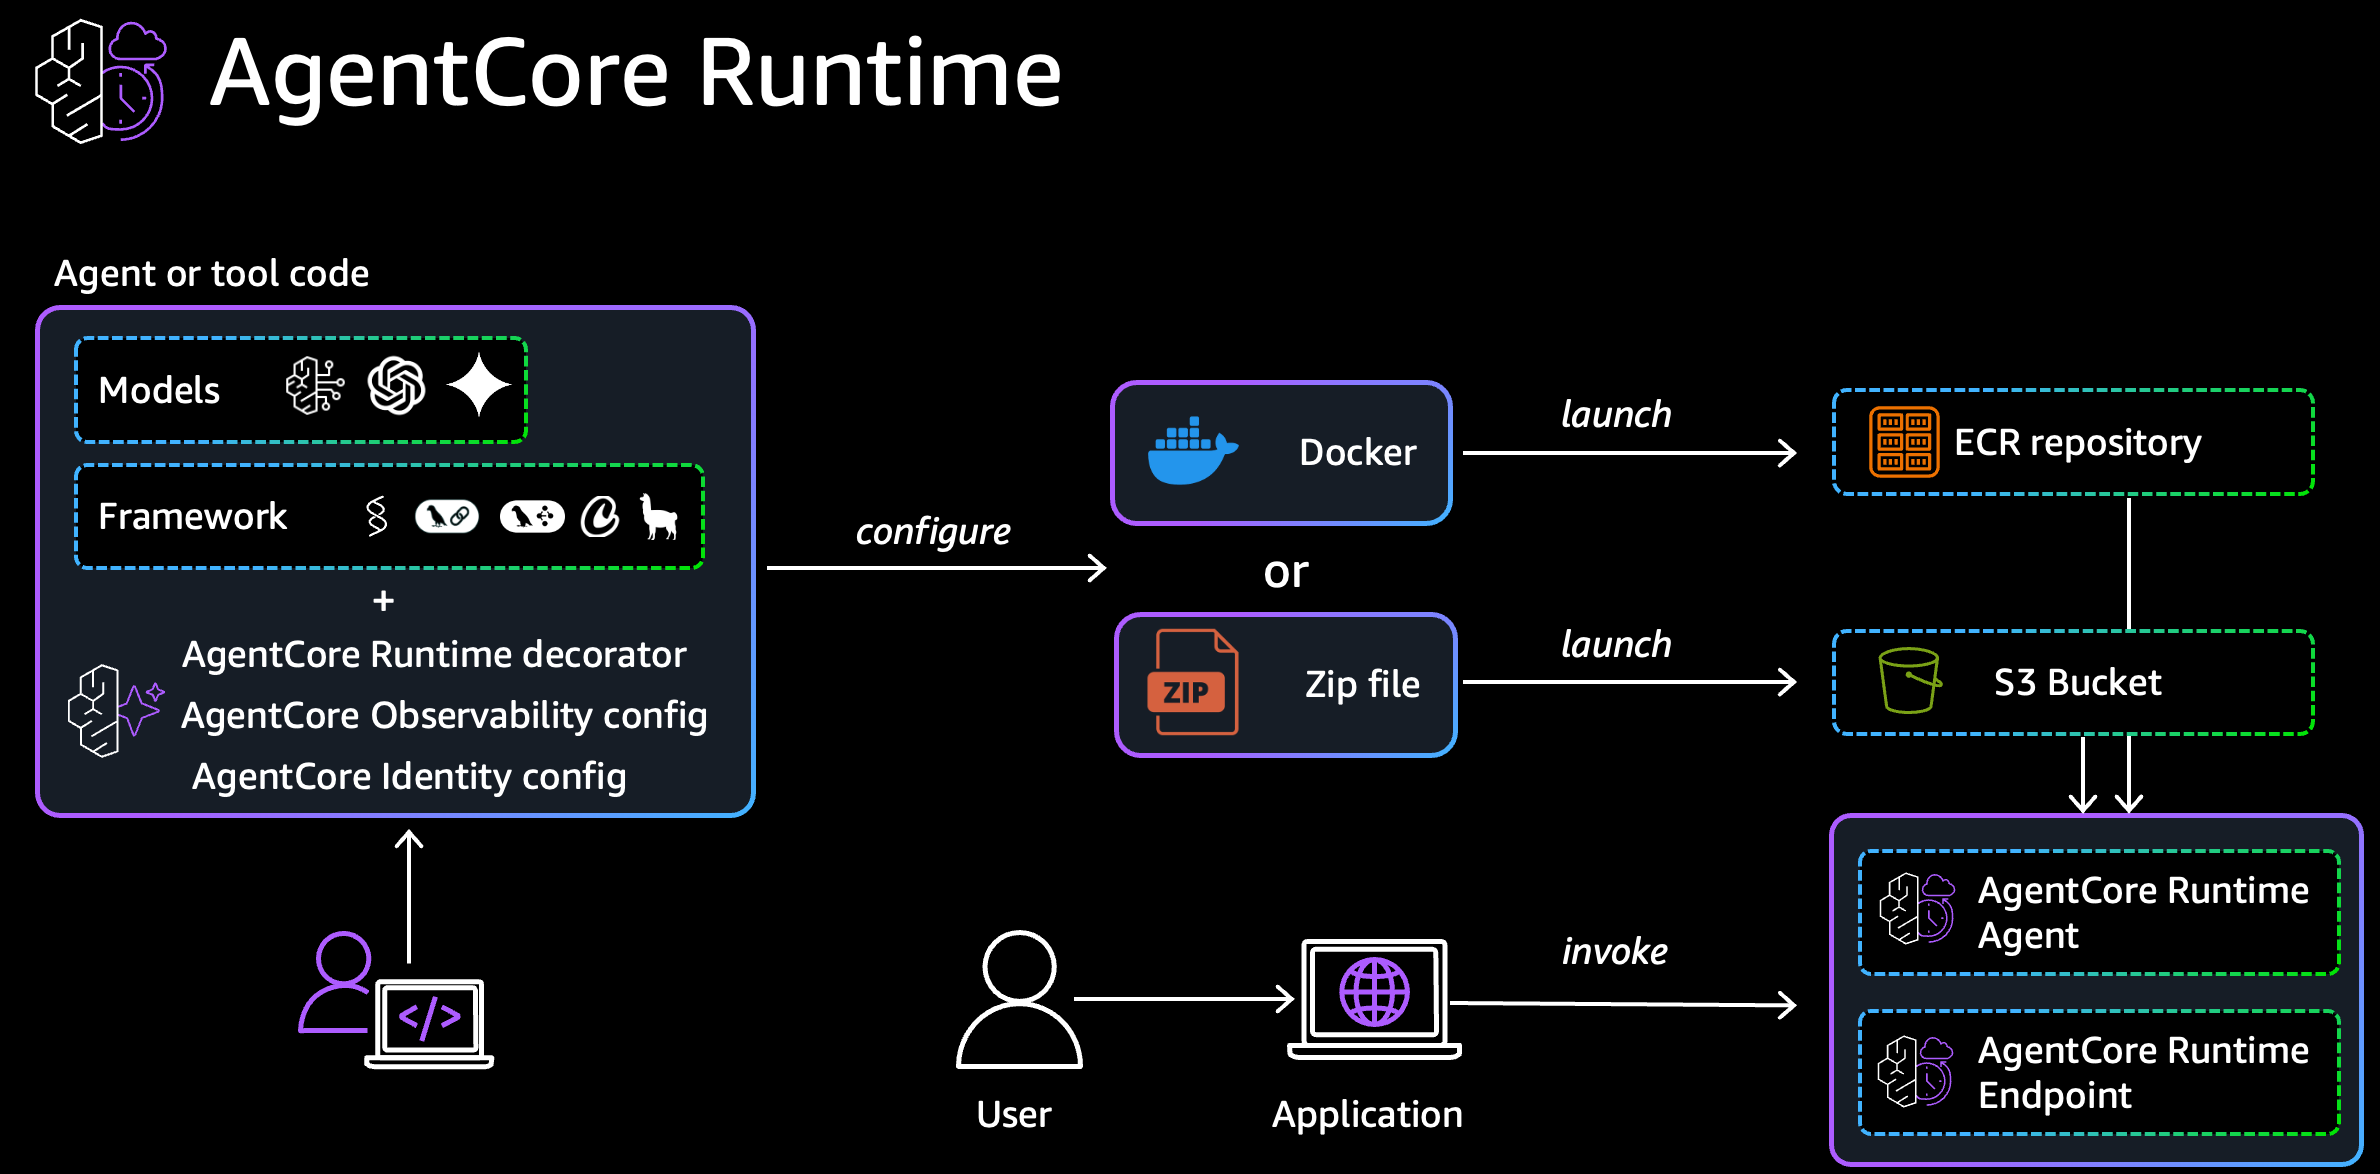
Para producción, se empaqueta el agente como un contenedor ARM64, se lo envía a Amazon Elastic Container Registry (Amazon ECR) y el tiempo de ejecución de AgentCore lo hospeda de forma serverless con aislamiento de sesión y escalado automático. La libreta 03 en el repositorio de GitHub muestra este proceso de implementación como una receta de referencia, cubriendo el Dockerfile, los comandos de compilación y envío, los permisos de ejecución de roles y la política de Cedar. La libreta muestra estos pasos sin ejecutarlos. Su Dockerfile empaqueta código de aplicación que va más allá del ejemplo, así que adapte el layout de su propia aplicación antes de compilar. El siguiente diagrama muestra la ruta de implementación desde el código del agente hasta un punto final de tiempo de ejecución de AgentCore hospedado.
Figura 4: Ruta de implementación desde el código del agente hasta un punto final de tiempo de ejecución de AgentCore hospedado
export TAG=mei-$(date +%Y%m%d-%H%M%S)
export ACCOUNT=<your-account-id>
export ECR=${ACCOUNT}.dkr.ecr.us-east-1.amazonaws.com/mfg-engineering-intelligence

# Build the container for ARM64 (required by AgentCore Runtime)
docker buildx build --platform linux/arm64 -f agentcore/Dockerfile \
  -t mfg-engineering-intelligence:${TAG} --load .

# Push the immutable tag to Amazon ECR
aws ecr get-login-password --region us-east-1 \
  | docker login --username AWS --password-stdin ${ACCOUNT}.dkr.ecr.us-east-1.amazonaws.com
docker tag mfg-engineering-intelligence:${TAG} ${ECR}:${TAG}
docker push ${ECR}:${TAG}
Asigne a cada imagen una etiqueta inmutable. Un tiempo de ejecución que ya ha resuelto el resumen detrás de una etiqueta :latest en movimiento sigue sirviendo la imagen antigua después de enviar una nueva. Los cambios de prompt, router y herramienta requieren una nueva imagen y una nueva versión de tiempo de ejecución para surtir efecto.
El rol de tiempo de ejecución necesita bedrock:InvokeModel, bedrock:Retrieve, bedrock-agentcore:InvokeGateway y s3vectors:QueryVectors para la ruta de consulta de imagen. La política de Cedar mostrada en la libreta 03 codifica las reglas de bucle humano, que requieren una evaluación previa antes de los memorandos y una entrada de registro de auditoría en cada decisión de sustitución. La aplicación hace cumplir estas reglas en su propia lógica hoy en día, y adjuntar la política a un motor de autorización de Cedar es el próximo paso.
Amazon Nova Multimodal Embeddings ahora está disponible en AWS GovCloud (US), lo que es importante para los programas de defensa y aerospaciales sujetos a requisitos de residencia de datos, ITAR y FedRAMP que gobiernan dónde se puede ejecutar una carga de trabajo. Las capacidades de recuperación multimodal y similitud visual en las que depende esta publicación están accesibles dentro de un límite de AWS GovCloud (US). La disponibilidad de Amazon Nova Multimodal Embeddings y las características de Amazon Bedrock AgentCore varía según la región de AWS, así que consulte Servicios de AWS por región antes de planificar una implementación.
Evaluando el asistente
Medimos la calidad de dos maneras, con puntuación en línea continua a través de Evaluaciones de AgentCore, una capacidad de Amazon Bedrock AgentCore, y validación fuera de línea contra conjuntos de consultas curados.
Evaluación en línea de AgentCore
Evaluaciones de Amazon Bedrock AgentCore, disponibles en general desde marzo de 2026, puntuación de trazas de agente utilizando técnicas de LLM-as-a-judge. Lee las trazas de OpenTelemetry que los agentes de Strands ya emiten, por lo que un agente instrumentado no necesita cambios de aplicación para ser evaluado. El servicio ofrece dos modos. La evaluación en línea muestrea continuamente sesiones de producción en vivo, y la evaluación bajo demanda ejecuta pruebas programáticas que se ajustan a una pipeline de integración y entrega continuas (CI/CD).
Usamos la evaluación en línea, con resultados publicados en Amazon CloudWatch para paneles y alarmas. La libreta 05 en el repositorio de GitHub crea una configuración de evaluación en línea y envía consultas de prueba a la runtime implementada para generar sesiones para puntuación.
Trece evaluadores integrados se envían con el servicio, junto con el soporte para evaluadores personalizados definidos por una llamada o alojados como una función de AWS Lambda. Habilitamos siete, abarcando los tres niveles de puntuación:
Nivel
Evaluador
Qué puntuación
Sesión
Tasa de éxito de objetivo
¿La conversación logró el objetivo del usuario de principio a fin?
Trazado
Corrección
¿La información es factualmente precisa?
Trazado
Utilidad
¿La respuesta es útil y valiosa?
Rastreo
Fidelidad
¿La respuesta es fiel al contexto recuperado?
Rastreo
Pertinencia de la respuesta
¿La respuesta aborda la consulta real del usuario?
Llamada a la herramienta
Precisión de la selección de la herramienta
¿El agente seleccionó la herramienta correcta?
Llamada a la herramienta
Precisión de los parámetros de la herramienta
¿El agente extrajo los parámetros correctamente?
El conjunto de consultas curadas contiene 36 consultas en seis categorías: descubrimiento de catálogos (8), recuperación de conocimientos y CIE (8), cadenas de especialistas múltiples (6), evaluación determinista (5), recuperación de texto a visual (5) y rechazos de seguridad con intervención humana (4) que afirman que el agente se niega a recomendar o aprobar. Cada consulta lleva sus identificadores de partes de catálogo esperados, excepto las consultas de seguridad, donde el resultado esperado es un rechazo.
AgentCore muestrea sesiones en vivo de forma continua, por lo que la puntuación de cada evaluador es un agregado en movimiento que cambia a medida que se acumula el tráfico y el agente cambia. Los siguientes números son una instantánea de la ejecución del conjunto de datos sintéticos. Úselos como línea de base para establecer umbrales de alarmas de CloudWatch y espere que los números de sus propias ejecuciones difieran.
Nivel
Evaluador
Puntuación (promedio de 30 días)
Sesión
Tasa de éxito de objetivo
0.892
Rastreo
Corrección
0.968
Rastreo
Utilidad
0.956
Rastreo
Fidelidad
0.981
Rastreo
Pertinencia de la respuesta
0.968
Llamada a la herramienta
Precisión de la selección de la herramienta
0.861
Llamada a la herramienta
Precisión de los parámetros de la herramienta
0.980
Todas las métricas de calidad de nivel de rastreo obtuvieron una puntuación de 0,95 o superior, y la extracción de parámetros de herramientas estuvo casi perfecta con 0,980. La mejora más notable entre las ejecuciones de evaluación fue la precisión de la selección de herramientas, que aumentó de 0,809 a 0,861. Tres cambios impulsaron el aumento: la consolidación a una sola base de conocimientos administrada, la corrección de un permiso que faltaba en la ruta de consulta de imagen que había causado un fallback silencioso a la búsqueda de texto, y el ajuste de la ruta del planificador para evitar la cadena de especialistas innecesarios.
La tasa de éxito de los objetivos es menor, en 0.892, debido a cómo se diseñó el conjunto de consultas. El conjunto de consultas incluye instrucciones de categoría de seguridad que solicitan al agente que recomiende o apruebe una sustitución. El agente se niega correctamente, pero el evaluador califica una negativa correcta como un objetivo no cumplido. Esperamos este resultado, porque en un sistema con intervención humana el agente no debe aprobar una sustitución por su cuenta.
Adaptar el patrón a su propio catálogo
El código es un patrón reutilizable que funciona para otras categorías de partes, más allá de las ruedas de reacción. Cambiar de dominio requiere tres cambios: reemplazar los datos de las partes (un specs.json, descripción, ICD, página de hoja de datos y foto por parte), editar el esquema de requisitos para definir las especificaciones críticas y reglas de tolerancia de su categoría, y apuntar la base de conocimientos a su corpus de S3. Los agentes, herramientas y motor de puntuación se transfieren sin cambios. Debido a que las herramientas determinísticas en mei_core son funciones de Python simples, una integración de PLM o ERP puede llamar a score_substitution_fit directamente, sin agente en el bucle.
Limpieza
Para evitar cargos continuos, elimine los recursos que creó:
Elimine el bucket de S3 que contiene el corpus de partes.
Conclusión
En esta publicación, mostramos cómo construir un asistente de ingeniería de multiagente que reemplaza la investigación manual de sustitución de partes con la ensambladura automatizada de evidencia. La arquitectura empareja Amazon Nova Multimodal Embeddings, que maneja la puntuación de similitud visual y la recuperación de gráficos que los sistemas de solo texto pasan por alto, con Amazon Bedrock AgentCore, que proporciona el andamiaje de producción de hosting de runtime, recuperación gobernada por Gateway y búsqueda web, y evaluaciones de calidad. Tres opciones de diseño son las más importantes. El código determinista produce cada veredicto de aprobado/reprobado, cada tarea se ejecuta en el nivel de modelo más pequeño de los tres que lo maneja bien, y solo el ingeniero puede aprobar una sustitución.
When a qualified aerospace component goes obsolete or hits a long lead time, an engineer spends days cross-referencing specifications across vendor datasheets, interface control documents (ICDs), and qualification records before documenting a substitution justification for review. An incorrect substitution on a flight-critical component can cause mission failure, yet the evidence trail behind each decision is often spread across email and undocumented institutional knowledge, so there is no formal, repeatable package for a reviewer to check.
A previous post, Manufacturing intelligence with Amazon Nova Multimodal Embeddings, showed how the model retrieves answers locked inside engineering diagrams, thermal plots, and datasheet charts that text-only pipelines miss. This post picks up where that retrieval work left off, putting those capabilities inside a multi-agent system that assembles substitution evidence, from retrieval to a drafted assessment.
In this post, we show how to build a multi-agent engineering assistant that cuts the manual cross-referencing behind part substitution evaluation using Amazon Bedrock AgentCore, Amazon Nova Multimodal Embeddings, and the open source Strands Agents SDK. A planner routes work across three specialist agents that search a multimodal knowledge base, score candidates against deterministic tolerance rules, compare part photos, and ground lifecycle claims in live web data. The engineer remains the decision-maker throughout, because the system assembles evidence and drafts documents without ever approving a substitution on its own.
Solution overview
The assistant is built around one design rule, which is that the engineer makes every decision and the system assembles the evidence for it. That rule determines where we use large language models (LLMs) and where we use deterministic code instead.
Three pillars define the architecture:
Deterministic spec-fit evaluation – Tolerance-rule code written in Python scores each candidate part against the reference part and the engineer’s stated requirements. Because the same inputs consistently produce the same pass/flag verdicts, the results can go into a formal engineering review.
Multi-agent orchestration – A lightweight planner routes each query to one or more of three specialist agents (Catalog, Evaluation, Knowledge), and a supervisor synthesizes their findings only when more than one specialist contributed. Complex questions such as “Check if this wheel is going end-of-life, find alternatives, and score them” chain all three specialists in sequence.
Human-in-the-loop decision – The system drafts justification memos and Integration Impact Assessments for engineering review, but it doesn’t recommend or approve a substitution. Every evaluation also writes an audit trail entry aligned with AS9100 sections 8.4 and 8.5.6.
The following diagram shows the architecture.
Figure 1: Architecture of the multi-agent engineering assistant on Amazon Bedrock AgentCore
Amazon Bedrock AgentCore is a platform to build, connect, and optimize agents at scale, with any framework or model. In this solution, chat requests from the engineer’s application flow into a multi-agent graph hosted on AgentCore runtime: a planner (Claude Haiku 5.5) produces a routing plan, specialists (Claude Sonnet 5.5) execute their tools, and a supervisor (Claude Opus 5.5) synthesizes their results when more than one specialist ran. The specialists retrieve from a managed knowledge base that we created with Amazon Bedrock Managed Knowledge Bases using Amazon Nova Multimodal Embeddings, routed through an AgentCore Gateway, a capability of Amazon Bedrock AgentCore, alongside the Web Search connector for live web data. For image-as-query (uploading a chart to identify a part), the agent calls a native Amazon S3 Vectors index directly, because the managed knowledge base retrieval API doesn’t accept image input. Amazon S3 Vectors is a capability of Amazon Simple Storage Service (Amazon S3). A separate fixed chain (Knowledge, then Evaluation, then Supervisor) produces the formal Integration Impact Assessment (IIA) document.
Amazon Nova Multimodal Embeddings appears in two distinct roles:
Multimodal retrieval – Datasheets, ICDs, and performance charts are embedded with Nova Multimodal Embeddings so text and visual content share one semantic space. An engineer can enter “torque curve for the 0.06 Nms wheel” or upload a chart image, and retrieval returns the matching diagram with source attribution.
Visual similarity scoring – When two candidate parts are compared, Nova Multimodal Embeddings produces a quantitative cosine similarity between their photos, and Claude analyzes the specific physical differences (mounting pattern, connector placement, housing geometry). The score adds supporting evidence to the deterministic spec comparison, which is what the fit verdict is based on.
Prerequisites
To follow along, you need:
An AWS account with access to Amazon Bedrock in the US East (N. Virginia) AWS Region.
Model access to Amazon Nova Multimodal Embeddings, Claude Haiku 5.5, Claude Sonnet 5.5, and Claude Opus 5.5 in Amazon Bedrock. For model availability by Region, see Model support by AWS Region in Amazon Bedrock.
A managed knowledge base created with Amazon Bedrock Managed Knowledge Bases, using Amazon Nova Multimodal Embeddings over your parts corpus (datasheets, ICDs, descriptions) for text and document retrieval.
An Amazon S3 Vectors index over your part photos and datasheet chart crops, for the image-as-query path.
An Amazon Bedrock AgentCore Gateway with the Web Search connector and a managed knowledge base target.
Python 3.10 or later and Jupyter for running the notebooks.
Docker, if you adapt the deployment recipe in notebook 03 to host the agent on AgentCore runtime.
The following sections describe each part of the system in the order a query uses it. We start with the parts corpus and the specialist agents, then cover routing, deterministic scoring, the two ways the assistant uses Nova Multimodal Embeddings, the fixed chain that produces formal documents, and deployment to AgentCore runtime.
The complete code sample is a set of five Jupyter notebooks in the GitHub repository, and each notebook runs on its own. The notebooks import from mei_core, a self-contained copy of the agent and tool modules in the same folder, and they include their own parts data, chart crops, and evaluation query set. You can run every snippet in this post from the notebooks without other application code.
Structure the parts corpus
The sample dataset is seven reaction wheels from a fictional manufacturer (AnyCompany) spanning 0.003–5.0 Nms of momentum storage. Each part is a folder that pairs structured data with the source documents an engineer actually reads, and this mix is what makes the corpus multimodal. The specs.json file holds the machine-readable fields that drive deterministic scoring, while the ICD, product photo, and rendered datasheet page carry the visual and narrative detail that structured fields leave out.
The specs.json file captures both the engineering specifications and a lifecycle profile, which is what lets the assistant flag obsolescence and lead-time risk alongside spec fit.
The vendor field is stated explicitly for every part. Because catalog folder IDs and file names are reused across datasets, every specialist prompt treats the structured vendor value returned by get_part_specs as authoritative and is forbidden from guessing a manufacturer from an ID, a file name, a photo, or a web search result. Taking the manufacturer from structured data keeps the assistant from attributing a part to the wrong supplier because the model thinks it recognizes the hardware.
Each part folder also carries two assets that text-only indexing cannot use. The product photo feeds visual similarity scoring, and the rendered datasheet page carries torque-box and torque-curve plots that answer performance questions no OCR text layer captures. Amazon Nova Multimodal Embeddings embeds both into the same vector space as the text, so a query can match a spec value, a paragraph, or a plot.
The following sample shows four datasheet pages from the corpus, spanning three orders of magnitude of momentum storage.
Figure 2: Four datasheet pages from the parts corpus, spanning three orders of magnitude of momentum storage
The template repeats across the family, but the product photo and the pair of performance plots change with every part. These Regions show the housing geometry, mounting pattern, torque envelope, and power draw, which the spec fields don’t state directly, so we embed them alongside the text.
Define specialists with scoped tools
Each specialist is a Strands agent with a narrow prompt and only the tools it needs. Scoping tools per specialist keeps behavior predictable, because the Knowledge specialist has no access to the catalog discovery tools and the Catalog specialist has no access to the evaluation tools. The following code creates the Evaluation specialist.
from strands import Agent

def create_evaluation_specialist() -> Agent:
    """Evaluation Specialist: deterministic spec-by-spec comparison and scoring."""
    return Agent(
        name="evaluation_specialist",
        system_prompt="""You are the Evaluation Specialist. Your job is to run
deterministic, spec-driven comparisons between parts.
...
RULES:
- Your comparisons are deterministic (code, not opinion)
- NEVER recommend or approve --- present evidence and flags; the engineer decides
- Always include the disclaimer that this is evidence only""",
        tools=[score_substitution_fit, compare_parts, visual_similarity_score,
               check_qualification_status, generate_substitution_memo],
        model="us.anthropic.claude-sonnet-5-5",
    )
The following diagram shows how the planner routes a query to the specialists and when the supervisor synthesizes their results. The list after it describes what each specialist does.
Figure 3: How the planner routes queries to specialists and when the supervisor synthesizes results
Catalog – Discovers parts through knowledge base search and exhaustive spec filtering (kb_search, filter_parts_by_spec, get_part_specs, get_substitution_requirements).
Evaluation – Scores candidates deterministically and compares parts visually (score_substitution_fit, compare_parts, visual_similarity_score, check_qualification_status, generate_substitution_memo).
Knowledge – Answers questions from datasheets and ICDs, checks live end-of-life status, and retrieves visual content (get_part_specs, web_search_eol, retrieve_visual_content).
Use a small model for routing and a large model for synthesis
Routing is a classification task with no tool calls, so it doesn’t need a large reasoning model. A Haiku-based planner returns a numbered routing plan in a couple of seconds. The Opus supervisor runs only when two or more specialists contributed, because synthesizing a single specialist’s already-complete answer adds about 8 seconds of latency with no quality gain.
# Step 1: Planner (fast model) plans the routing (may be multi-step).
plan_response = planner(planning_prompt)
ordered_specialists = _parse_specialist_plan(str(plan_response))

# Step 2: Execute specialists in sequence, passing context forward
accumulated_context = ""
for spec_name in ordered_specialists:
    specialist = specialists[spec_name]
    specialist_response = specialist(spec_prompt)
    accumulated_context += f"\n[{spec_name.upper()}]: {specialist_response}\n"

# Step 3: Synthesize only when 2+ specialists ran.
if len(ordered_specialists) == 1:
    final_text = steps[0]["response"]
else:
    final_text = str(supervisor(synthesis_prompt))
Splitting the work across three model tiers matches cost and latency to each stage. Haiku classifies the query, Sonnet runs the tools, and Opus writes the combined answer, which is the step where response quality matters most.
Keep the scoring deterministic
The spec-fit evaluation runs as ordinary Python code against a hand-written requirements schema. The schema defines the critical specs and tolerance rules for each component category, and score_substitution_fit compares each spec, counts passes and flags, and surfaces lifecycle risk. Because the verdict must be reproducible for an engineering review package, no LLM is involved in this step.
The tool returns a structured verdict with an explicit disclaimer:
return {
    "spec_results": results,  # per-spec pass/flag/review status
    "counts": counts,
    "out_of_tolerance": out_of_tolerance,
    "lifecycle": {...},  # obsolescence and lead-time flags
    "summary": summary,
    "disclaimer": "Evidence only. This tool does not recommend or approve "
                  "a substitution; the engineer decides.",
}
The specialist presents this table and explains the flags, but it can’t change a verdict. The audit trail follows the same division of work. After every evaluation, the orchestration layer reads the specialist’s tool-call history and writes the audit entry itself, so logging doesn’t depend on the model remembering to do it.
Score visual similarity with Amazon Nova Multimodal Embeddings
Form factor matters when a substitute must fit an existing bracket. The visual_similarity_score tool embeds both part photos with Nova Multimodal Embeddings and computes cosine similarity, then asks Claude to describe the specific observable differences.
def embed_image(image_bytes):
    """Embed one image with Nova MME (IMAGE_RETRIEVAL) -> 1024-d vector."""
    b64 = base64.b64encode(image_bytes).decode('utf-8')
    fmt = 'png' if image_bytes[:8] == b'\x89PNG\r\n\x1a\n' else 'jpeg'
    body = {
        'taskType': 'SINGLE_EMBEDDING',
        'singleEmbeddingParams': {
            'embeddingPurpose': 'IMAGE_RETRIEVAL',
            'embeddingDimension': 1024,
            'image': {'detailLevel': 'STANDARD_IMAGE', 'format': fmt,
                      'source': {'bytes': b64}},
        },
    }
    resp = bedrock.invoke_model(
        modelId='amazon.nova-2-multimodal-embeddings-v1:0',
        body=json.dumps(body), accept='application/json',
        contentType='application/json',
    )
    result = json.loads(resp['body'].read())
    return np.array(result['embeddings'][0]['embedding'])

# cosine similarity of the two photo embeddings
emb_a, emb_b = embed_image(photo_a_bytes), embed_image(photo_b_bytes)
similarity = float(np.dot(emb_a, emb_b) /
                   (np.linalg.norm(emb_a) * np.linalg.norm(emb_b)))
The embedding similarity is deterministic and reproducible, returning around 0.84 for two wheels of the same product family and 0.40 for wheels of different classes. Claude’s vision analysis then explains what drives the difference, for example noting that one housing is roughly twice the diameter of the other and has a six-hole mounting pattern where the other has four.
Retrieve charts and diagrams with two retrieval paths
Text and document queries go through the managed knowledge base backed by Amazon Nova Multimodal Embeddings, routed through the AgentCore Gateway. Image-as-query (uploading a chart or photo to find matching content) uses a native Amazon S3 Vectors index called directly from the agent, because the managed knowledge base retrieval API doesn’t accept image input.
The Knowledge specialist’s retrieve_visual_content tool provides one interface for both paths. An engineer can paste a performance curve from a requirements document into the chat and ask which part matches it, or describe the chart in a text query instead.
# Image-as-query: embed the uploaded image with Nova MME, exactly as the
# datasheet crops and photos were embedded at indexing time.
def embed_query_image(image_bytes):
    b64 = base64.b64encode(image_bytes).decode('utf-8')
    fmt = 'png' if image_bytes[:8] == b'\x89PNG\r\n\x1a\n' else 'jpeg'
    body = {'taskType': 'SINGLE_EMBEDDING', 'singleEmbeddingParams': {
        'embeddingPurpose': 'IMAGE_RETRIEVAL', 'embeddingDimension': 1024,
        'image': {'detailLevel': 'STANDARD_IMAGE', 'format': fmt,
                  'source': {'bytes': b64}}}}
    r = bedrock.invoke_model(modelId=NOVA_MME_MODEL_ID, body=json.dumps(body),
                             accept='application/json', contentType='application/json')
    return json.loads(r['body'].read())['embeddings'][0]['embedding']
On the image path, the upload is embedded with Nova Multimodal Embeddings at 1,024 dimensions using the IMAGE_RETRIEVAL purpose, then matched against the S3 Vectors index:
# Query the native S3 Vectors index and collapse to the best vector per part.
emb = embed_query_image(image_bytes)
s3v = boto3.client('s3vectors', region_name=REGION)
fetch_k = max(top_k * 6, 12)  # each part has several vectors; dedupe below
resp = s3v.query_vectors(
    vectorBucketName=S3_VECTOR_BUCKET, indexName=S3_VECTOR_INDEX,
    queryVector={'float32': emb}, topK=fetch_k,
    returnDistance=True, returnMetadata=True,
)

best = {}
for v in resp.get('vectors', []):
    meta = v.get('metadata', {}) or {}
    pid = meta.get('part_id', '')
    if not pid:
        continue
    sim = 1.0 - v.get('distance', 1.0)  # cosine distance -> similarity
    if pid not in best or sim > best[pid]['score']:
        best[pid] = {'part_id': pid, 'score': sim}
ranked = sorted(best.values(), key=lambda r: r["score"], reverse=True)[:top_k]
Because one part contributes several vectors (its photo, the whole datasheet page, and each cropped chart region), results are deduped to the best-scoring vector per part before they reach the model.
We learned three practical lessons while building the retrieval paths:
Crop the charts before indexing them – Whole datasheet pages make poor index entries, because roughly 90 percent of a page (header, spec table, footer) is boilerplate that every part shares, and that shared content dominates the embedding. Indexing cropped chart regions alongside the full page solved this. In our testing, chart-upload matching went from 3 of 7 parts correct with whole-page indexing to 7 of 7 with chart-band crops. We define the crop Regions as fractions of the page, which keeps them correct across datasheet resolutions.
Filter results when the engineer names a part – Cross-modal text-to-image similarity alone doesn’t reliably return the right part’s chart, because a torque curve image contains no visible part name. When the engineer names a specific part, the tool keeps only results from that part’s indexed content, which it identifies by parsing the part folder out of each result’s S3 URI. Because the filter runs in the tool, it works without custom metadata in the index.
Log every fallback on the image path – The image path returns None on errors and falls through to text retrieval. That fallback is reasonable, but it means a missing s3vectors:QueryVectors permission on the AgentCore runtime execution role doesn’t raise an error. Image-as-query stops working without warning, and the model then names a wrong part with high apparent confidence. The problem is easy to miss during development, because local developer credentials usually have broader permissions than the runtime role. The tool now logs an explicit S3 Vectors image query FAILED warning with the bucket, index, and Region whenever that path falls back. Instrument every silent fallback in a retrieval path, because a hard failure is much easier to diagnose than a quiet one.
Produce formal documents with a fixed specialist chain
Chat uses dynamic routing because the right specialists for a freeform question can’t be known in advance. The Integration Impact Assessment works differently. When an engineer requests an impact assessment for a reference and candidate pair, the required sequence is already known, so the service composes the same specialist factory functions in a fixed order with a purpose-built synthesis prompt.
# 1. Knowledge Specialist --- ICD/datasheet interface detail for both parts
knowledge_text = str(knowledge(knowledge_prompt))

# 2. Evaluation Specialist --- structured field delta + qualification check
evaluation_text = str(evaluation(evaluation_prompt))

# Deterministic structured delta for exact summary stats
comparison = compare_parts(reference_id, candidate_id)

# 3. Supervisor --- synthesize into the six-section IIA document
markdown = str(supervisor(synthesis_prompt))
The resulting document covers interface changes, mechanical integration, electrical integration, thermal integration, qualification delta, and supply chain impact. The narrative sections need LLM synthesis, because the pinout and protocol details must be extracted from ICD prose. The summary statistics (matches, differences, total fields) are computed directly from compare_parts output, so the numbers shown alongside the narrative are exact.
Ground lifecycle claims in live web data through AgentCore Gateway
Catalog data goes out of date, so the Knowledge specialist’s web_search_eol tool checks current end-of-life notices, vendor announcements, and lead times through an AgentCore Gateway with the Web Search connector. The Gateway exposes the connector as a governed Model Context Protocol (MCP) endpoint. Because the Gateway also handles managed knowledge base retrieval, you can attach policy and observability to both external and internal data access in one place.
Deploy to AgentCore runtime
For production, you package the agent as an ARM64 container, push it to Amazon Elastic Container Registry (Amazon ECR), and AgentCore runtime hosts it serverlessly with session isolation and auto scaling. Notebook 03 in the GitHub repository walks through this deployment as a reference recipe, covering the Dockerfile, the build and push commands, the execution-role permissions, and the Cedar policy. The notebook shows these steps without running them. Its Dockerfile packages application code that goes beyond the sample, so adapt it to your own application layout before you build. The following diagram shows the deployment path from agent code to a hosted AgentCore runtime endpoint.
Figure 4: Deployment path from agent code to a hosted AgentCore runtime endpoint
export TAG=mei-$(date +%Y%m%d-%H%M%S)
export ACCOUNT=<your-account-id>
export ECR=${ACCOUNT}.dkr.ecr.us-east-1.amazonaws.com/mfg-engineering-intelligence

# Build the container for ARM64 (required by AgentCore Runtime)
docker buildx build --platform linux/arm64 -f agentcore/Dockerfile \
  -t mfg-engineering-intelligence:${TAG} --load .

# Push the immutable tag to Amazon ECR
aws ecr get-login-password --region us-east-1 \
  | docker login --username AWS --password-stdin ${ACCOUNT}.dkr.ecr.us-east-1.amazonaws.com
docker tag mfg-engineering-intelligence:${TAG} ${ECR}:${TAG}
docker push ${ECR}:${TAG}
Give each image an immutable tag. A runtime that has already resolved the digest behind a moving :latest tag keeps serving the old image after you push a new one. Prompt, router, and tool changes all require a new image and a new runtime version to take effect.
The runtime role needs bedrock:InvokeModel, bedrock:Retrieve, bedrock-agentcore:InvokeGateway, and s3vectors:QueryVectors for the image-as-query path. The Cedar policy shown in notebook 03 encodes the human-in-the-loop rules, requiring a prior evaluation before memos and an audit log entry on every substitution decision. The application enforces these rules in its own logic today, and attaching the policy to a Cedar authorization engine is the next step.
Amazon Nova Multimodal Embeddings is now available in AWS GovCloud (US), which matters for aerospace and defense programs subject to data residency, ITAR, and FedRAMP requirements that govern where a workload can run. The multimodal retrieval and visual similarity capabilities this post depends on are reachable inside an AWS GovCloud (US) boundary. Availability of Amazon Nova Multimodal Embeddings and Amazon Bedrock AgentCore features varies by AWS Region, so check AWS Services by Region before you plan a deployment.
Evaluating the assistant
We measure quality in two ways, with continuous online scoring through AgentCore Evaluations, a capability of Amazon Bedrock AgentCore, and offline validation against curated query sets.
AgentCore online evaluation
Amazon Bedrock AgentCore Evaluations, generally available since March 2026, scores agent traces using LLM-as-a-judge techniques. It reads the OpenTelemetry traces that Strands agents already emit, so an instrumented agent needs no application changes to be evaluated. The service offers two modes. Online evaluation continuously samples live production sessions, and on-demand evaluation runs programmatic tests that fit into a continuous integration and continuous delivery (CI/CD) pipeline.
We use online evaluation, with results published to Amazon CloudWatch for dashboards and alarms. Notebook 05 in the GitHub repository creates an online evaluation configuration and sends test queries to the deployed runtime to generate sessions for scoring.
Thirteen built-in evaluators ship with the service, alongside support for custom evaluators defined by a prompt or hosted as an AWS Lambda function. We enable seven, spanning all three scoring levels:
Level
Evaluator
What it scores
Session
Goal Success Rate
Did the conversation achieve the user’s goal end to end?
Trace
Correctness
Is the information factually accurate?
Trace
Helpfulness
Is the response useful and valuable?
Trace
Faithfulness
Is the response faithful to the retrieved context?
Trace
Response Relevance
Does the response address the user’s actual query?
Tool call
Tool Selection Accuracy
Did the agent pick the right tool?
Tool call
Tool Parameter Accuracy
Did the agent extract parameters correctly?
The curated query set holds 36 queries across six categories: catalog discovery (8), Knowledge and ICD retrieval (8), multi-specialist chains (6), deterministic evaluation (5), text-to-visual retrieval (5), and human-in-the-loop safety refusals (4) that assert the agent refuses to recommend or approve. Each query carries its expected catalog part IDs, except the safety queries, where the expected outcome is a refusal.
AgentCore samples live sessions on an ongoing basis, so each evaluator’s score is a moving aggregate that shifts as traffic accumulates and as the agent changes. The following numbers are a snapshot from the synthetic dataset run. Use them as a baseline for setting CloudWatch alarm thresholds, and expect the numbers from your own runs to differ.
Level
Evaluator
Score (30-day avg)
Session
Goal Success Rate
0.892
Trace
Correctness
0.968
Trace
Helpfulness
0.956
Trace
Faithfulness
0.981
Trace
Response Relevance
0.968
Tool call
Tool Selection Accuracy
0.861
Tool call
Tool Parameter Accuracy
0.980
All trace-level quality metrics scored at or above 0.95, and tool parameter extraction was near-perfect at 0.980. The most notable improvement between evaluation runs was Tool Selection Accuracy, which rose from 0.809 to 0.861. Three changes drove the gain: consolidating to a single managed knowledge base, fixing a missing permission on the image-as-query path that had caused silent fallback to text search, and tightening the planner’s routing to avoid chaining unnecessary specialists.
Goal Success Rate is lower, at 0.892, because of how the query set is designed. The query set includes safety-category prompts that ask the agent to recommend or approve a substitution. The agent correctly refuses, but the evaluator scores a correct refusal as an unmet goal. We expect this result, because in a human-in-the-loop system the agent must not approve a substitution on its own.
Adapt the pattern to your own catalog
The code is a reusable pattern that works for other part categories, beyond reaction wheels. Swapping domains requires three changes: replace the parts data (a specs.json, description, ICD, datasheet page, and photo per part), edit the requirements schema to define your category’s critical specs and tolerance rules, and point the knowledge base at your S3 corpus. The agents, tools, and scoring engine carry over unchanged. Because the deterministic tools in mei_core are plain Python functions, a PLM or ERP integration can call score_substitution_fit directly, with no agent in the loop.
Clean up
To avoid ongoing charges, delete the resources you created:
In this post, we showed how to build a multi-agent engineering assistant that replaces manual part substitution research with automated evidence assembly. The architecture pairs Amazon Nova Multimodal Embeddings, which handles visual similarity scoring and chart retrieval that text-only systems miss, with Amazon Bedrock AgentCore, which provides the production scaffolding of runtime hosting, Gateway-governed retrieval and web search, and quality evaluations. Three design choices matter most. Deterministic code produces every pass/fail verdict, each task runs on the smallest of the three model tiers that handles it well, and only the engineer can approve a substitution.