Anunciando imágenes con índice SOCI para trabajos de SageMaker AI más rápidos
Announcing SOCI-indexed images for faster SageMaker AI jobs
Kanwaljit Khurmi
Cada minuto que su imagen de contenedor de aprendizaje profundo pasa descargando es un minuto que paga y un minuto que su equipo espera. La descarga de la imagen del contenedor es un overhead puro: tiempo de trabajo facturable que no produce ningún progreso en el modelo. Para las imágenes de aprendizaje profundo modernas, ese overhead es de varios minutos en cada trabajo. Hoy, estamos emocionados de anunciar indexación de Seekable OCI (SOCI) para Amazon SageMaker AI Training y trabajos de procesamiento de Amazon SageMaker AI, que elimina la descarga completa de la imagen del contenedor del camino crítico de cada trabajo.
Con la indexación de SOCI, SageMaker AI carga de forma diferida su imagen de contenedor. Sólo fetcha los archivos necesarios para iniciar el contenedor y transmite el resto en segundo plano mientras su código se ejecuta, por lo que su trabajo comienza en segundos en lugar de minutos. Puede adoptarlo apuntando a un contenedor de aprendizaje profundo de AWS (DLC) pre-indexado o agregando un índice a su propia imagen. Ninguno de los enfoques requiere cambios en la definición de su trabajo, punto de entrada o canales de datos. El resultado es un inicio de trabajo más rápido, un costo de trabajo más bajo y más tiempo dedicado a la creación de modelos en lugar de esperar a la infraestructura.
Las imágenes indexadas con SOCI inician contenedores de entrenamiento de Amazon SageMaker AI en segundos, sin impacto en el rendimiento del entrenamiento. Como se muestra en la sección Lo que medimos, esto redujo el tiempo de inactividad de la GPU durante las extracciones de imágenes hasta en un 90 por ciento en nuestras pruebas de referencia.
Esta publicación muestra cómo adoptar la indexación de SOCI: qué es, los resultados que medimos y cómo activarla para sus propios trabajos.
El desafío
Los trabajos de entrenamiento y procesamiento de SageMaker AI se ejecutan dentro de imágenes de contenedor almacenadas en Amazon Elastic Container Registry (Amazon ECR). Antes de que un trabajo pueda ejecutar su código, el servicio descarga la imagen completa en la instancia. Descomprime y escribe cada capa en el disco.
Para imágenes pequeñas, esto tarda segundos. Pero las imágenes de aprendizaje profundo suelen superar los 10 GB o más. Esa descarga agrega minutos a cada trabajo, y usted paga por ella como tiempo de trabajo. El impacto es mayor exactamente donde la velocidad de iteración es más importante: barridos de ajuste de hiperparámetros para cientos de trabajos, experimentos rápidos y trabajos de procesamiento cortos, donde la descarga de la imagen puede dominar el tiempo de ejecución total.
Cómo funciona la indexación de SOCI
Seekable OCI (SOCI) es una tecnología de código abierto que carga de forma diferida las imágenes de contenedor. En lugar de descargar la imagen completa antes de iniciar, el runtime utiliza un índice de SOCI para fetchar solo los archivos necesarios para lanzar el contenedor de inmediato. Luego, transmite el resto en segundo plano mientras su código accede a él.
Un índice de SOCI es metadatos que asigna cada archivo dentro de su imagen. Lo almacena en Amazon ECR como un artifacto compatible con OCI vinculado a su imagen original. Debido a que el índice es un artifacto separado, su resumen de imagen y cualquier firma existente siguen siendo válidos.
SageMaker AI busca un índice automáticamente
Cuando crea un trabajo de entrenamiento o procesamiento, SageMaker AI verifica si la imagen que especificó tiene un índice SOCI y se comporta en consecuencia:
Escenario
Qué sucede
La imagen incluye un índice SOCI
SageMaker AI carga la imagen de forma diferida y comienza su contenedor antes de que se complete la descarga completa
La imagen no tiene un índice SOCI
Descarga estándar, sin cambios en el comportamiento
No se puede leer el índice o la carga diferida no tiene éxito
El trabajo vuelve a una descarga estándar y continúa ejecutándose
Como los trabajos siempre vuelven a una descarga estándar cuando es necesario, agregar un índice SOCI nunca impide que su trabajo se ejecute. Solo obtiene una inicialización más rápida. Nunca se arriesga a romper un flujo de trabajo existente.
Lo que medimos
Extraimos las mismas imágenes de contenedores de dos maneras en trabajos de entrenamiento de SageMaker AI reales: descarga estándar y carga diferida con índice SOCI. Luego, ejecutamos trabajos de entrenamiento completos desde ambos para medir el efecto en la velocidad de entrenamiento.
Configuración
Ocho imágenes, 1.8–35.4 GB comprimidas.
Instancias GPU y CPU ml.g4dn, ml.g5, ml.g6, ml.g6e, ml.g7, ml.g7e, ml.p4d, ml.p5, y ml.m7i, desde xlarge hasta 48xlarge, en la región oeste de EE. UU. (Oregon) (us-west-2) y la región este de EE. UU. (N. Virginia) (us-east-1).
Tiempo de descarga medido desde el inicio de la extracción de la imagen hasta que el contenedor esté listo para ejecutarse. Todas las cifras son medianas de ejecuciones repetidas.
Resultado 1: El tiempo de descarga disminuye de minutos a segundos en todos los tamaños de imagen
Tamaño de la imagen (comprimida)
Descarga estándar
Carga diferida
Mejora
1.8 GB
48 s
3-11 s
~8x
13.2 GB
3 min 42 s
~6 s
~34x
35.4 GB
7 min 17 s
3-11 s
~38x
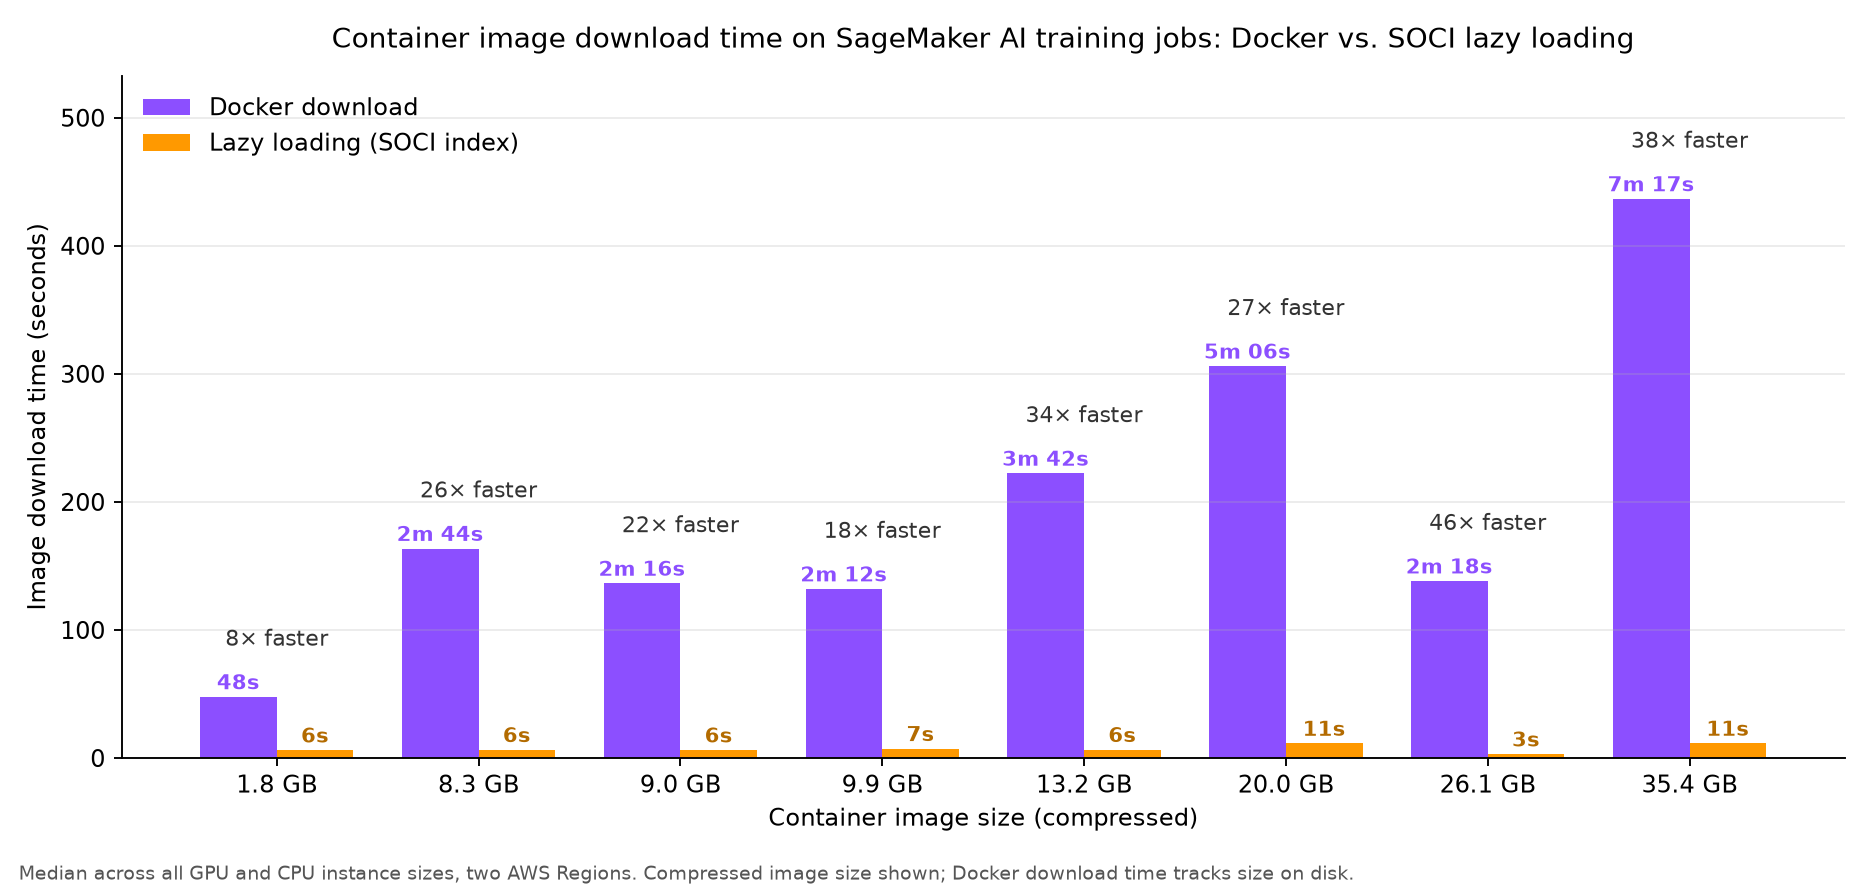
El siguiente gráfico compara el tiempo de descarga de la imagen del contenedor para una extracción de Docker estándar frente a la carga diferida de SOCI en ocho tamaños de imagen, desde 1.8 GB hasta 35.4 GB.
Cada tamaño de imagen muestra dos barras. La barra del tiempo de descarga de Docker (azul) crece constantemente con el tamaño de la imagen, desde 48 segundos en 1.8 GB hasta 7 minutos 17 segundos en 35.4 GB.
Una etiqueta de aceleración sobre cada par muestra la relación entre el tiempo de Docker y el tiempo de SOCI. Las aceleraciones van desde aproximadamente 10x para la imagen más pequeña hasta más de 35x para la más grande.
Figura 1: Tiempo de descarga de imagen de contenedor, Docker pull estándar en comparación con SOCI lazy loading, en ocho tamaños de imagen
El tiempo de descarga estándar aumenta con el tamaño de la imagen porque cada archivo se descomprime y escribe. La carga diferida se mantuvo en 3–11 segundos independientemente del tamaño, una mejora de 8x–46x. Cuanto mayor es la imagen, más minutos ahorras.
Resultado 2: El ahorro se mantiene en cada tipo y tamaño de instancia
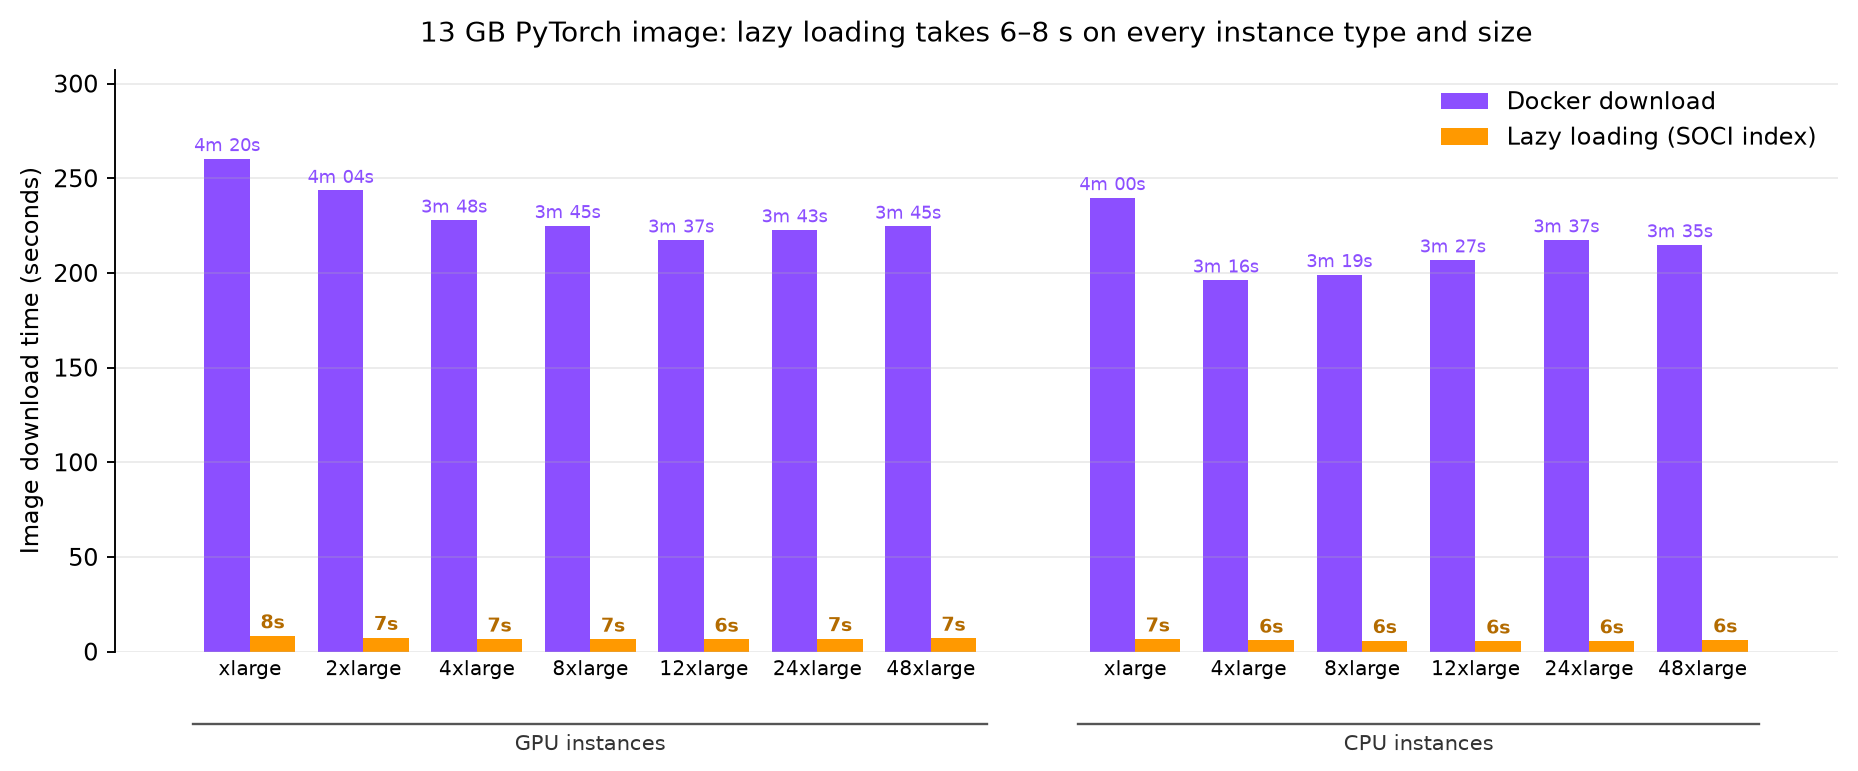
Al ejecutar la imagen de 13,2 GB en 13 combinaciones de tipo y tamaño de instancia, el tiempo de descarga estándar varió desde 3 min 16 s hasta 4 min 20 s, mientras que la carga diferida se mantuvo en 6-8 s. Eso es aproximadamente 34x más rápido en cada configuración. No necesitas cambiar el tipo o tamaño de la instancia para beneficiarte.
Figura 2: Tiempo de descarga para una imagen de 13,2 GB en 13 combinaciones de tipo y tamaño de instancia
Resultado 3: El rendimiento del entrenamiento no se ve afectado más allá de una penalización en la primera época
Ejecutamos dos tipos de trabajos de entrenamiento completos desde la imagen extraída con Docker y desde la imagen indexada con SOCI y comparamos cada época:
Clasificación de imágenes en ResNet-50 en Imagenette (9,469 imágenes)
Imágenes de contenedor: PyTorch (13,2 GB DLC) y TensorFlow (9,9 GB DLC)
Instancias: ml.p5.48xlarge, ml.p4d.24xlarge, ml.g7e.48xlarge, ml.g7.48xlarge, ml.g6e.12xlarge, ml.g6e.24xlarge, y ml.g6e.48xlarge.
Ajuste fino de modelo de lenguaje grande (LLM): ajuste fino supervisado de parámetros completos (SFT) de Qwen2.5-0.5B en alpaca-cleaned (51,760 ejemplos) con el Hugging Face Trainer.
Imagen del contenedor: 9.4 GB Hugging Face PyTorch DLC.
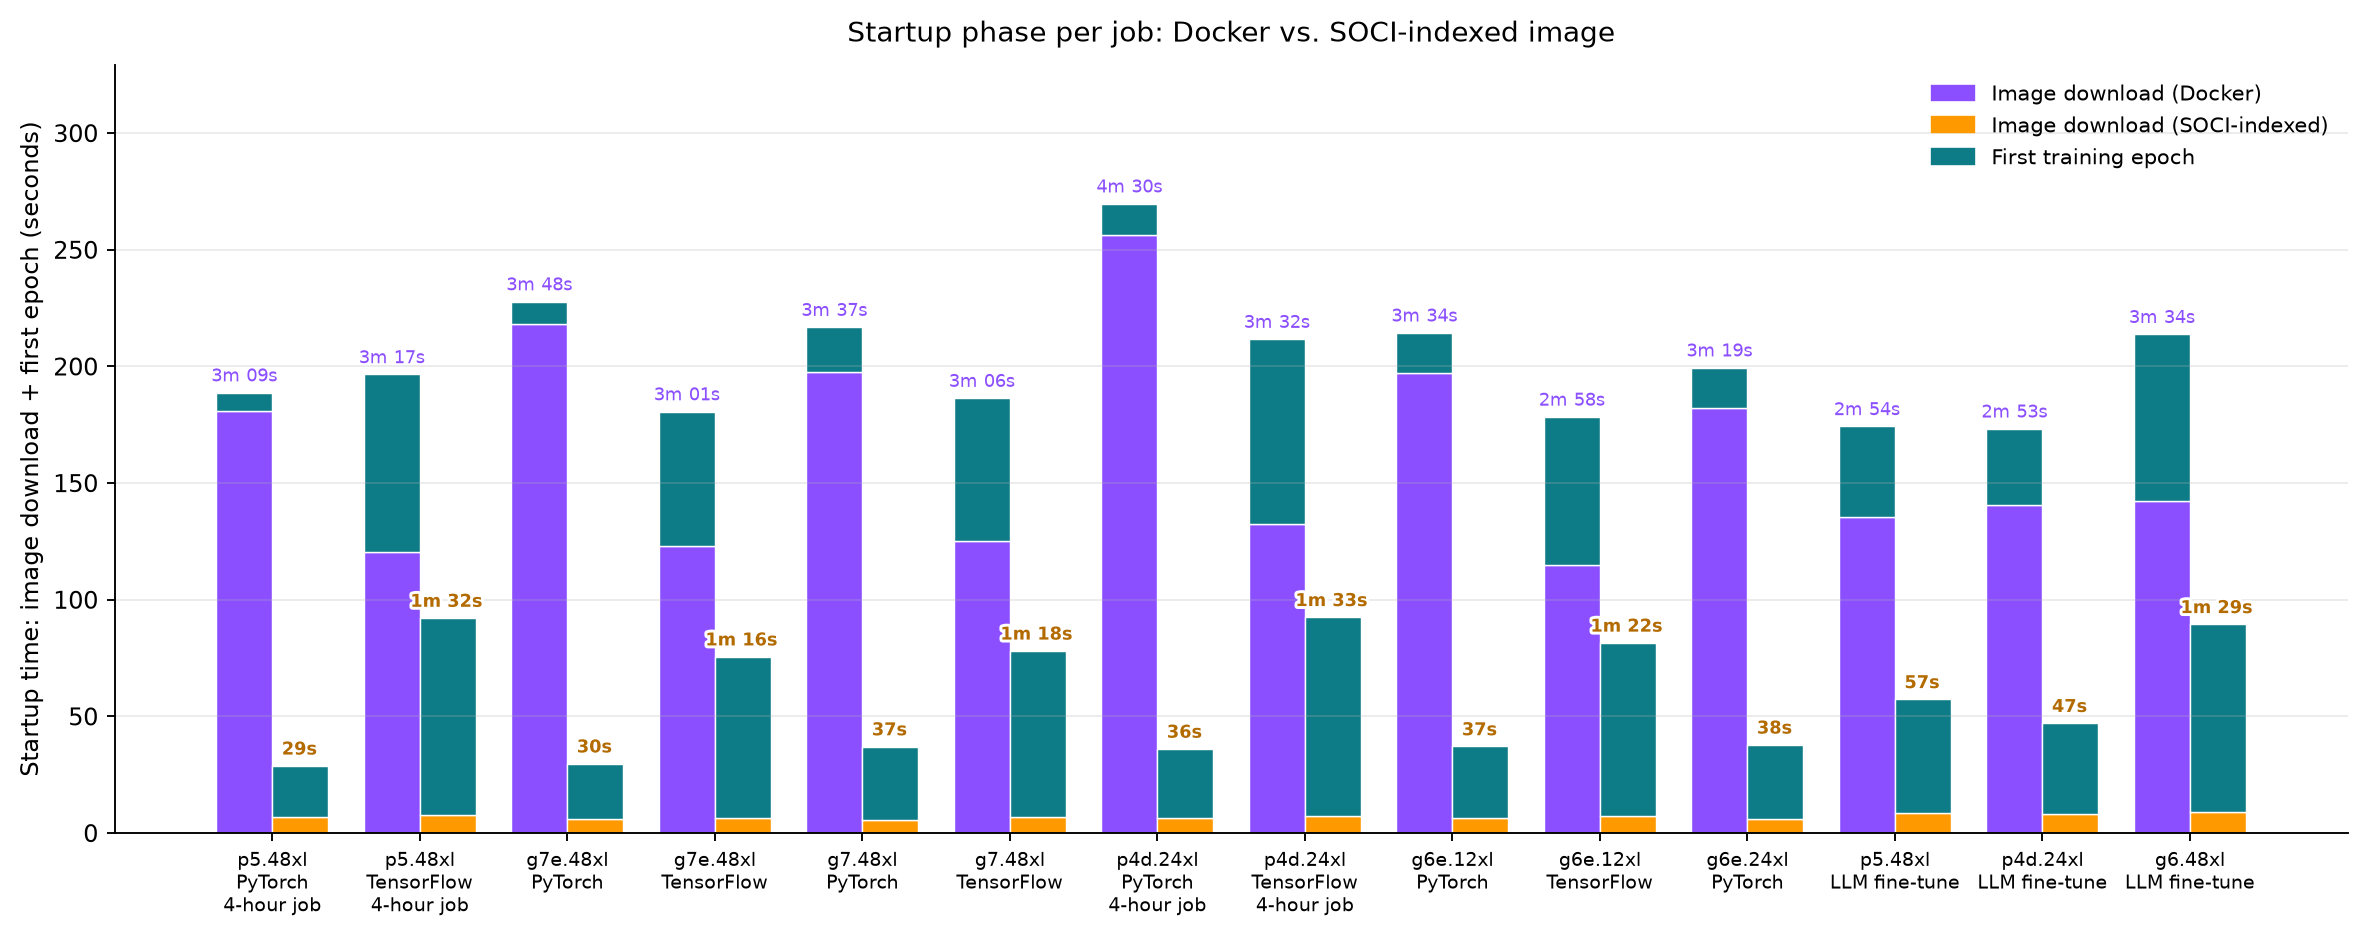
La siguiente gráfica divide la inicialización del trabajo en tiempo de descarga de imagen y tiempo de la primera época de entrenamiento, comparando una extracción estándar de Docker con una imagen indexada por SOCI en configuraciones de GPU y CPU para ambas cargas de trabajo.
Figura 3: Inicialización del trabajo dividida en tiempo de descarga de imagen y tiempo de la primera época de entrenamiento, extracción estándar de Docker comparada con una imagen indexada por SOCI
Desde la segunda época en adelante, el tiempo por época es el mismo (dentro de la variación de ejecución a ejecución) en cada instancia, para ambas cargas de trabajo.
Net: cada trabajo finalizó 1-6 min antes. Ese es el ahorro de descarga menos el costo de la primera época de una sola vez, un ahorro fijo por trabajo.
Prueba esto en tu propia carga de trabajo
Estos números son de las dos cargas de trabajo descritas anteriormente. El costo de la primera época depende de tu imagen y de lo que tu código toca al inicio:
La carga diferida gana cuando el primer paso de entrenamiento solo necesita una fracción de la imagen, el resto se transmite mientras se entrena.
Si tu punto de entrada lee la mayor parte de la imagen antes de que comience el entrenamiento (por ejemplo, escaneando, verificando la suma de comprobación o precargando su contenido), la primera época espera aproximadamente los mismos bytes que una extracción completa habría recuperado. La mejora neta sería pequeña.
Los inicios con carga previa todavía salieron adelante en nuestras pruebas:
torch.compile y una extensión CUDA construida justo a tiempo (JIT) agregaron 7-15 s a la primera época (ahorro neto todavía 3 min 25 s–3 min 56 s)
Un modelo de 6 GB horneado en la imagen transmitió sus pesos en el momento de la carga, agregando 2-3.5 min, pero el trabajo general todavía finalizó 2-2.5 min antes en la imagen indexada.
Empezar
Puedes adoptar el indexado SOCI de dos maneras: usar un contenedor de aprendizaje profundo de AWS preindexado o crear un índice para tu propia imagen personalizada.
Opción 1: Usar un contenedor de aprendizaje profundo de AWS preindexado
AWS publica variantes indexadas por SOCI de varios contenedores de aprendizaje profundo populares, identificados por el sufijo -soci en la etiqueta de la imagen:
Las variantes preindexadas están disponibles para PyTorch Training, TensorFlow Training, vLLM y SGLang, incluyendo variantes arm64 para algunos frameworks. Para adoptar la carga diferida, actualiza la etiqueta de la imagen en tu definición de trabajo a la variante -soci. Explora la lista completa en la Galería de contenedores de aprendizaje profundo de AWS.
Nota: Si creas tu propia imagen A PARTIR DE una imagen base de DLC, debes crear un índice SOCI para tu imagen final. El índice de la imagen base no se transfiere a las imágenes derivadas.
Opción 2: Crear un índice SOCI para tu propia imagen
Para indexar una imagen personalizada, necesitas un host Linux (como una instancia de Amazon Elastic Compute Cloud (Amazon EC2) que ejecuta Amazon Linux 2023) con containerd, el snapshooter SOCI, y either Finch o nerdctl instalado.
Esto crea dos artefactos en tu repositorio: el índice SOCI y un manifiesto de índice de imagen compatible con OCI que enlaza tu imagen con el índice. Tu imagen original y su resumen permanecen sin cambios.
Automatiza la creación de índices en CI/CD
Para generar índices automáticamente en cada push, implemente el CFN ECR SOCI Index Builder. Utiliza una regla de Amazon EventBridge para detectar eventos de push de imágenes de Amazon ECR y construir el índice. No se requieren cambios en su pipeline de compilación.
Usar la imagen indexada en su trabajo de SageMaker AI
Haga referencia a su imagen indexada con SOCI exactamente como haría con cualquier otra imagen. No se necesitan cambios en la API. Solo difiere la etiqueta.
Ejemplo de entrenamiento (SDK de Python de SageMaker)
from sagemaker.train import ModelTrainer
from sagemaker.train.configs import Compute

trainer = ModelTrainer(
    training_image="111122223333.dkr.ecr.us-east-1.amazonaws.com/my-training-image:v1.0-soci",
    role="arn:aws:iam::111122223333:role/SageMakerExecutionRole",
    compute=Compute(
        instance_type="ml.g5.12xlarge",
        instance_count=2,
    ),
)

trainer.train()
Verificar que su imagen incluye un índice de SOCI
Antes de lanzar, confirme que su etiqueta se resuelve en una imagen indexada:
Busque un manifiesto secundario cuyo artifactType comience con application/vnd.amazon.soci.index. junto con su manifiesto de plataforma. Si no está allí, la etiqueta no apunta a una imagen indexada.
Cosas que tener en cuenta
Solo repositorios privados de Amazon ECR. Las imágenes en otros registros o extraídas a través de un registro privado de Docker (TrainingRepositoryAccessMode establecido en Vpc) no son elegibles para la carga diferida.
La mejora se escala con el tamaño de la imagen. Las imágenes más pequeñas que aproximadamente 4 GB ven mejoras relativamente pequeñas.
Revisar suposiciones específicas de Docker. Las imágenes indexadas con SOCI se ejecutan en un runtime basado en containerd. Revise los puntos de entrada y los scripts de configuración para el código que llama a la CLI de Docker, lee /var/run/docker.sock o deriva identificadores de rutas de cgroup. SageMaker AI monta un marcador /.dockerenv para la compatibilidad hacia atrás, pero evite agregar nuevas dependencias en él.
La indexación de SOCI para trabajos de SageMaker AI está disponible en todas las regiones de AWS.
Conclusión
Con la indexación de SOCI, puede minimizar el tiempo de descarga de la imagen del contenedor desde sus trabajos de entrenamiento y procesamiento de SageMaker AI. Agregue un índice de SOCI a sus imágenes o cambie a un contenedor preindexado de AWS Deep Learning. De cualquier manera, reduce el tiempo de inicio de minutos a segundos, reduce el costo total del trabajo y acelera su ciclo de iteración de aprendizaje automático (ML). Y sus definiciones de trabajo existentes, llamadas a la API y pipelines de datos siguen siendo exactamente los mismos.
Para obtener más información sobre Amazon SageMaker AI y comenzar a usar la indexación de SOCI, explore los siguientes recursos:
Automatiza el indexado en tu pipeline de CI/CD. Despliega el CFN ECR SOCI Index Builder para generar índices automáticamente en cada push de imagen. No se requieren cambios en la pipeline.
Prueba localmente con Finch. Utiliza el tutorial de carga diferida de Finch para validar tu imagen en un runtime basado en containerd antes de enviar un trabajo.
Un inicio de contenedor más rápido está solo a un tag de imagen de distancia. Pruébalo en tu próximo trabajo de AI de SageMaker y observa la diferencia.
Acerca de los autores
Every minute your deep learning container image spends downloading is a minute you pay for and a minute your team waits. Container image download is pure overhead: billable job time that produces no model progress. For modern deep learning images, that overhead is several minutes on every single job. Today, we’re excited to announce Seekable OCI (SOCI) indexing for Amazon SageMaker AI Training and Amazon SageMaker AI processing jobs, which takes full container image download off the critical path of every job.
With SOCI indexing, SageMaker AI lazy-loads your container image. It fetches only the files needed to start the container and streams the rest in the background as your code runs, so your job begins in seconds instead of minutes. You adopt it by pointing to a pre-indexed AWS Deep Learning Container (DLC) or adding an index to your own image. Neither approach requires changes to your job definition, entry point, or data channels. The result is faster job starts, lower job cost, and more time spent building models rather than waiting on infrastructure.
SOCI-indexed images start Amazon SageMaker AI training containers in seconds, with no impact on training performance. As we show in the What we measured section, this reduced GPU idle time during image pulls by up to 90 percent in our benchmarks.
This post shows how to adopt SOCI indexing: what it is, the results we measured, and how to turn it on for your own jobs.
The challenge
SageMaker AI training and processing jobs run inside container images stored in Amazon Elastic Container Registry (Amazon ECR). Before a job can execute your code, the service downloads the entire image to the instance. It decompresses and writes every layer to disk.
For small images this takes seconds. But deep learning images routinely exceed 10 GB or more. That download adds minutes to every job, and you pay for it as job time. The impact is largest exactly where iteration speed matters most: hyperparameter tuning sweeps for hundreds of jobs, quick experiments, and short processing jobs, where image download can dominate total runtime.
How SOCI indexing works
Seekable OCI (SOCI) is an open source technology that lazy loads container images. Instead of downloading the whole image before starting, the runtime uses a SOCI index to fetch only the files needed to launch the container immediately. It then streams the rest in the background as your code accesses it.
A SOCI index is metadata that maps every file inside your image. You store it in Amazon ECR as an OCI-compliant artifact linked to your original image. Because the index is a separate artifact, your image digest and any existing signatures remain valid.
SageMaker AI checks for an index automatically
When you create a training or processing job, SageMaker AI checks whether the image you specified has a SOCI index and behaves accordingly:
Scenario
What happens
The image includes a SOCI index
SageMaker AI lazy-loads the image and starts your container before the full download completes
The image has no SOCI index
Standard download, no change in behavior
The index can’t be read, or lazy loading doesn’t succeed
The job falls back to a standard download and continues running
Because jobs always fall back to a standard download when needed, adding a SOCI index never prevents your job from running. You only gain faster startup. You never risk breaking an existing workflow.
What we measured
We pulled the same container images two ways on real SageMaker AI training jobs: standard download and SOCI-indexed lazy loading. We then ran full training jobs from both to measure the effect on training speed.
Setup
Eight images, 1.8–35.4 GB compressed.
GPU and CPU instances ml.g4dn, ml.g5, ml.g6, ml.g6e, ml.g7, ml.g7e, ml.p4d, ml.p5, and ml.m7i, from xlarge to 48xlarge, in the US West (Oregon) Region (us-west-2) and the US East (N. Virginia) Region (us-east-1).
Download time measured from the start of the image pull until the container is ready to run. All figures are medians of repeated runs.
Result 1: Download time drops from minutes to seconds at every image size
Image size (compressed)
Standard download
Lazy loading
Improvement
1.8 GB
48 s
3-11 s
~8x
13.2 GB
3 min 42 s
~6 s
~34x
35.4 GB
7 min 17 s
3-11 s
~38x
The following chart compares container image download time for a standard Docker pull against SOCI lazy loading across eight image sizes, from 1.8 GB to 35.4 GB.
Each image size shows two bars. The Docker download time bar (blue) grows steadily with image size, from 48 seconds at 1.8 GB to 7 minutes 17 seconds at 35.4 GB.
A speedup label above each pair shows the ratio of Docker time to SOCI time. Speedups range from approximately 10x for the smallest image to over 35x for the largest.
Figure 1: Container image download time, standard Docker pull compared to SOCI lazy loading, across eight image sizes
Standard download time grows with image size because every file is decompressed and written. Lazy loading stayed at 3–11 seconds regardless of size, an 8x–46x improvement. The bigger the image, the more minutes you save.
Result 2: The saving holds on every instance type and size
Running the 13.2 GB image across 13 instance type/size combinations, standard download ranged from 3 min 16 s to 4 min 20 s, while lazy loading held at 6-8 s. That is about 34x faster on every configuration. You don’t need to change instance type or size to benefit.
Figure 2: Download time for a 13.2 GB image across 13 instance type and size combinations
Result 3: Training performance is unaffected beyond a first-epoch penalty
We ran two kinds of full training jobs from the Docker-pulled and from the SOCI-indexed image and compared every epoch:
Image classification on ResNet-50 on Imagenette (9,469 images)
Instances: ml.p5.48xlarge, ml.p4d.24xlarge, ml.g7e.48xlarge, ml.g7.48xlarge, ml.g6e.12xlarge, ml.g6e.24xlarge, and ml.g6e.48xlarge.
Large language model (LLM) fine-tuning: full-parameter supervised fine-tuning (SFT) of Qwen2.5-0.5B on alpaca-cleaned (51,760 examples) with the Hugging Face Trainer.
The following chart breaks job startup into image download time and first training epoch time, comparing a standard Docker pull with a SOCI-indexed image across GPU and CPU configurations for both workloads.
Figure 3: Job startup split into image download time and first training epoch time, standard Docker pull compared to a SOCI-indexed image
From the second epoch on, time per epoch is the same (within run-to-run variation) on every instance, for both workloads.
The first epoch takes 3–16 s longer from the lazy-loaded image, while files the framework touches for the first time are fetched. This first-epoch cost is the same on every instance size.
Net: each job finished 1-6 min sooner. That is the download saving minus the one-time first-epoch cost, a fixed saving per job.
Test this on your own workload
These numbers are from the two workloads described earlier. The first-epoch cost depends on your image and what your code touches at startup:
Lazy loading wins when the first training step needs only a fraction of the image, the rest streams in while you train.
If your entry point reads most of the image before training starts (for example, scanning, checksumming, or preloading its contents), the first epoch waits for roughly the same bytes a full pull would have fetched. The net improvement would be small.
Front-loaded starts still came out ahead in our tests:
torch.compile and a just-in-time (JIT) built CUDA extension added 7-15 s to the first epoch (net saving still 3 min 25 s–3 min 56 s)
A 6 GB model baked into the image streamed its weights at load time, adding 2-3.5 min, but the overall job still finished 2-2.5 mins sooner on the indexed image.
Getting started
You can adopt SOCI indexing two ways: use a pre-indexed AWS Deep Learning Container or create an index for your own custom image.
Option 1: Use a pre-indexed AWS Deep Learning Container
AWS publishes SOCI-indexed variants of several popular Deep Learning Containers, identified by the -soci suffix on the image tag:
Pre-indexed variants are available for PyTorch Training, TensorFlow Training, vLLM, and SGLang, including arm64 variants for some frameworks. To adopt lazy loading, update the image tag in your job definition to the -soci variant. Browse the full list in the AWS Deep Learning Containers Gallery.
Note: If you build your own image FROM a DLC base image, you must create a SOCI index for your final image. The index from the base image does not carry forward to derived images.
Option 2: Create a SOCI index for your own image
To index a custom image, you need a Linux host (such as an Amazon Elastic Compute Cloud (Amazon EC2) instance running Amazon Linux 2023) with containerd, the SOCI snapshotter, and either Finch or nerdctl installed.
This creates two artifacts in your repository: the SOCI index and an OCI-compliant image index manifest linking your image to the index. Your original image and its digest remain unchanged.
Automate index creation in CI/CD
To generate indexes automatically on every push, deploy the CFN ECR SOCI Index Builder. It uses an Amazon EventBridge rule to detect Amazon ECR image push events and build the index. No changes to your build pipeline are required.
Use the indexed image in your SageMaker AI job
Reference your SOCI-indexed image exactly as you would any other image. No API changes are needed. Only the tag differs.
Training example (SageMaker Python SDK)
from sagemaker.train import ModelTrainer
from sagemaker.train.configs import Compute

trainer = ModelTrainer(
    training_image="111122223333.dkr.ecr.us-east-1.amazonaws.com/my-training-image:v1.0-soci",
    role="arn:aws:iam::111122223333:role/SageMakerExecutionRole",
    compute=Compute(
        instance_type="ml.g5.12xlarge",
        instance_count=2,
    ),
)

trainer.train()
Verify that your image includes a SOCI index
Before launching, confirm your tag resolves to an indexed image:
Look for a child manifest whose artifactType begins with application/vnd.amazon.soci.index. alongside your platform manifest. If it isn’t there, the tag does not point to an indexed image.
Things to keep in mind
Amazon ECR private repositories only. Images in other registries, or pulled through a private Docker registry (TrainingRepositoryAccessMode set to Vpc), are not eligible for lazy loading.
Improvement scales with image size. Images smaller than roughly 4 GB see relatively small improvements.
Check for Docker-specific assumptions. SOCI-indexed images run on a containerd-based runtime. Review entry points and setup scripts for code that calls the Docker CLI, reads /var/run/docker.sock, or derives identifiers from cgroup paths. SageMaker AI mounts a /.dockerenv marker for backward compatibility, but avoid adding new dependencies on it.
SOCI indexing for SageMaker AI jobs is available across all AWS Regions.
Conclusion
With SOCI indexing, you can minimize container image download time from your SageMaker AI training and processing jobs. Add a SOCI index to your images, or switch to a pre-indexed AWS Deep Learning Container. Either way, you cut startup time from minutes to seconds, reduce total job cost, and accelerate your machine learning (ML) iteration cycle. And your existing job definitions, API calls, and data pipelines stay exactly the same.
To learn more about Amazon SageMaker AI and start using SOCI indexing, explore the following resources:
Automate indexing in your CI/CD pipeline. Deploy the CFN ECR SOCI Index Builder to generate indexes automatically on every image push. No pipeline changes are required.
Test locally with Finch. Use the Finch lazy-loading walkthrough to validate your image on a containerd-based runtime before you submit a job.