Arquitecturas de patrones para una inicialización rápida de sesión en Amazon Bedrock AgentCore runtime
Architecture patterns for fast session startup on Amazon Bedrock AgentCore runtime
Evandro Franco
Los agentes hoy revisan el código, procesan reclamos y se ejecutan sin supervisión durante horas. Muchos también se encuentran detrás de experiencias interactivas donde una persona espera la primera respuesta. Amazon Bedrock AgentCore runtime proporciona a estos agentes un entorno completamente administrado y sin servidor: cada sesión se ejecuta en su propia microVM aislada, la plataforma se escala a cero cuando no hay trabajo y solo paga por los recursos que consumen sus sesiones.
AgentCore runtime con platformVersion establecido en “V2” cambia la forma en que comienzan las sesiones. En lugar de inicializar su contenedor para cada sesión, prepara su entorno una vez, crea una instantánea de él y restaura esa instantánea para cada nueva sesión. Los tiempos de inicio de sesión son más rápidos y consistentes. V2 también recupera la memoria que sus sesiones no utilizan, por lo que su factura sigue lo que su agente utiliza.
Para la mayoría de los agentes, cambiar a V2 es todo lo que se necesita. Algunos agentes necesitan reestructuración para obtener el beneficio completo, y para experiencias de chat y voz, incluso 2 segundos es demasiado lento. Esta publicación explica cómo V2 inicia una sesión, cómo medir el tiempo de inicio de sesión y cómo mantener el trabajo fuera de la primera solicitud, incluidos los ganchos de compilación, que AgentCore runtime ahora admite. Cubrimos cuatro patrones, desde cambios en el código de su agente hasta iniciar sesiones antes de que los usuarios las necesiten.
¿Qué patrón necesita?
Su situación
Qué hacer
Sección
Una nueva sesión en aproximadamente 2 segundos es aceptable
Cambie a V2 y realice toda la inicialización antes de app.run()
Mantener el trabajo fuera de la primera solicitud
Su agente necesita archivos grandes, una CLI o un navegador al principio y no puede mantenerlos en su proceso
Agregue un gancho de compilación para cargarlos y prepararlos mientras se crea la instantánea
Trabajando con ganchos
Necesita subsegundos y los usuarios se involucran antes de enviar su primera solicitud (abrir la aplicación o una ventana de chat)
Inicie la sesión en segundo plano cuando el usuario se involucre
Pre-calentar en la participación del usuario
Cómo V2 inicia una sesión
AgentCore runtime ejecuta cada sesión en una nueva microVM. En V1, AgentCore extrae la imagen del contenedor de Amazon Elastic Container Registry (Amazon ECR), inicia el contenedor y ejecuta su código de inicialización antes de que pueda procesar la primera solicitud. La extracción de la imagen domina, por lo que el inicio en frío crece con el tamaño de la imagen.
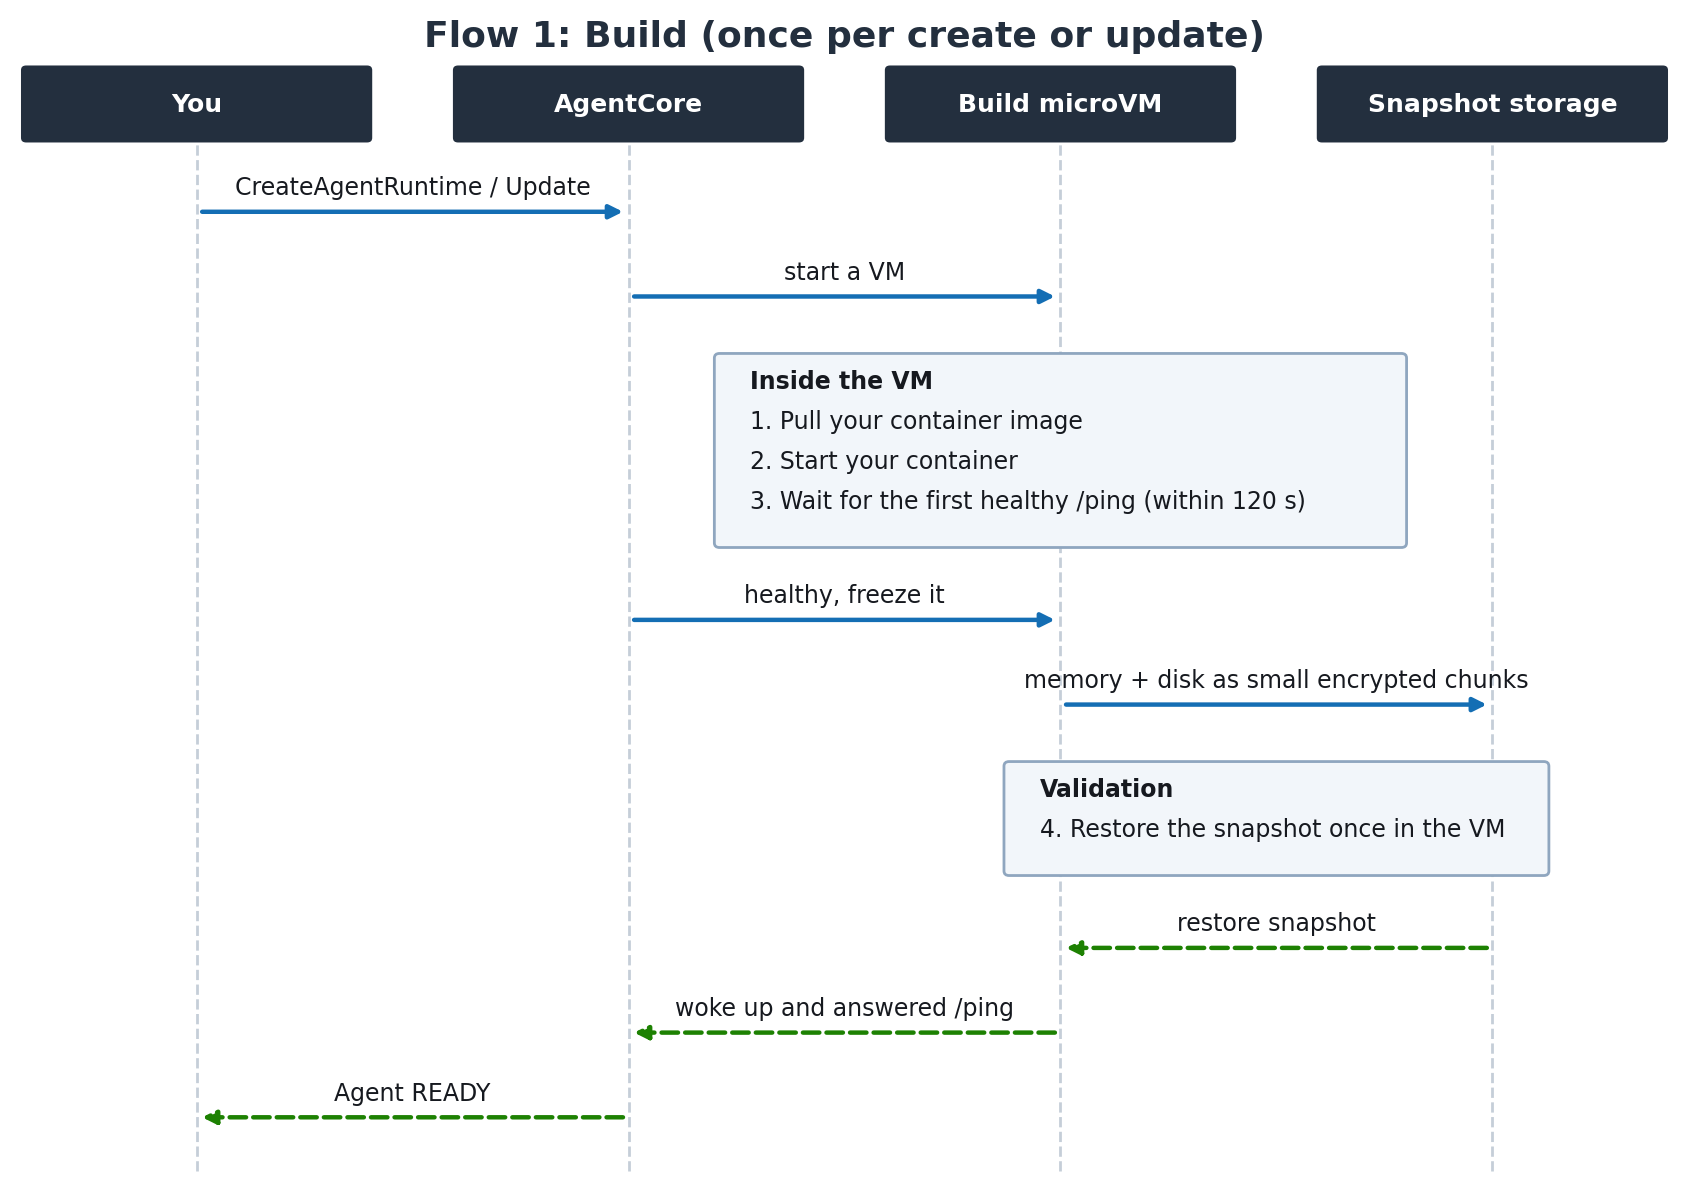
V2 realiza ese trabajo una sola vez. Cuando crea o actualiza un runtime, el runtime de AgentCore inicia su contenedor en una microVM fresca y espera el primer ping saludable (GET /ping), que debe llegar dentro de 120 segundos. Luego, limpia la caché de archivos del sistema operativo para mantener la instantánea pequeña, congela la microVM y almacena su memoria y disco como una instantánea.
Este es un cambio con respecto a V1: cada creación o actualización ahora lleva unos minutos mientras se construye la instantánea.
En esta publicación, init se refiere a todo lo que su agente hace antes de que /ping informe que está saludable. Con el SDK de Python de AgentCore, eso es todo antes de app.run(). Si ejecuta su propio servidor HTTP, en Node.js o en otro lenguaje, informe que está saludable solo después de que termine su inicialización.
Figura 1: Compilación, una vez por creación o actualización
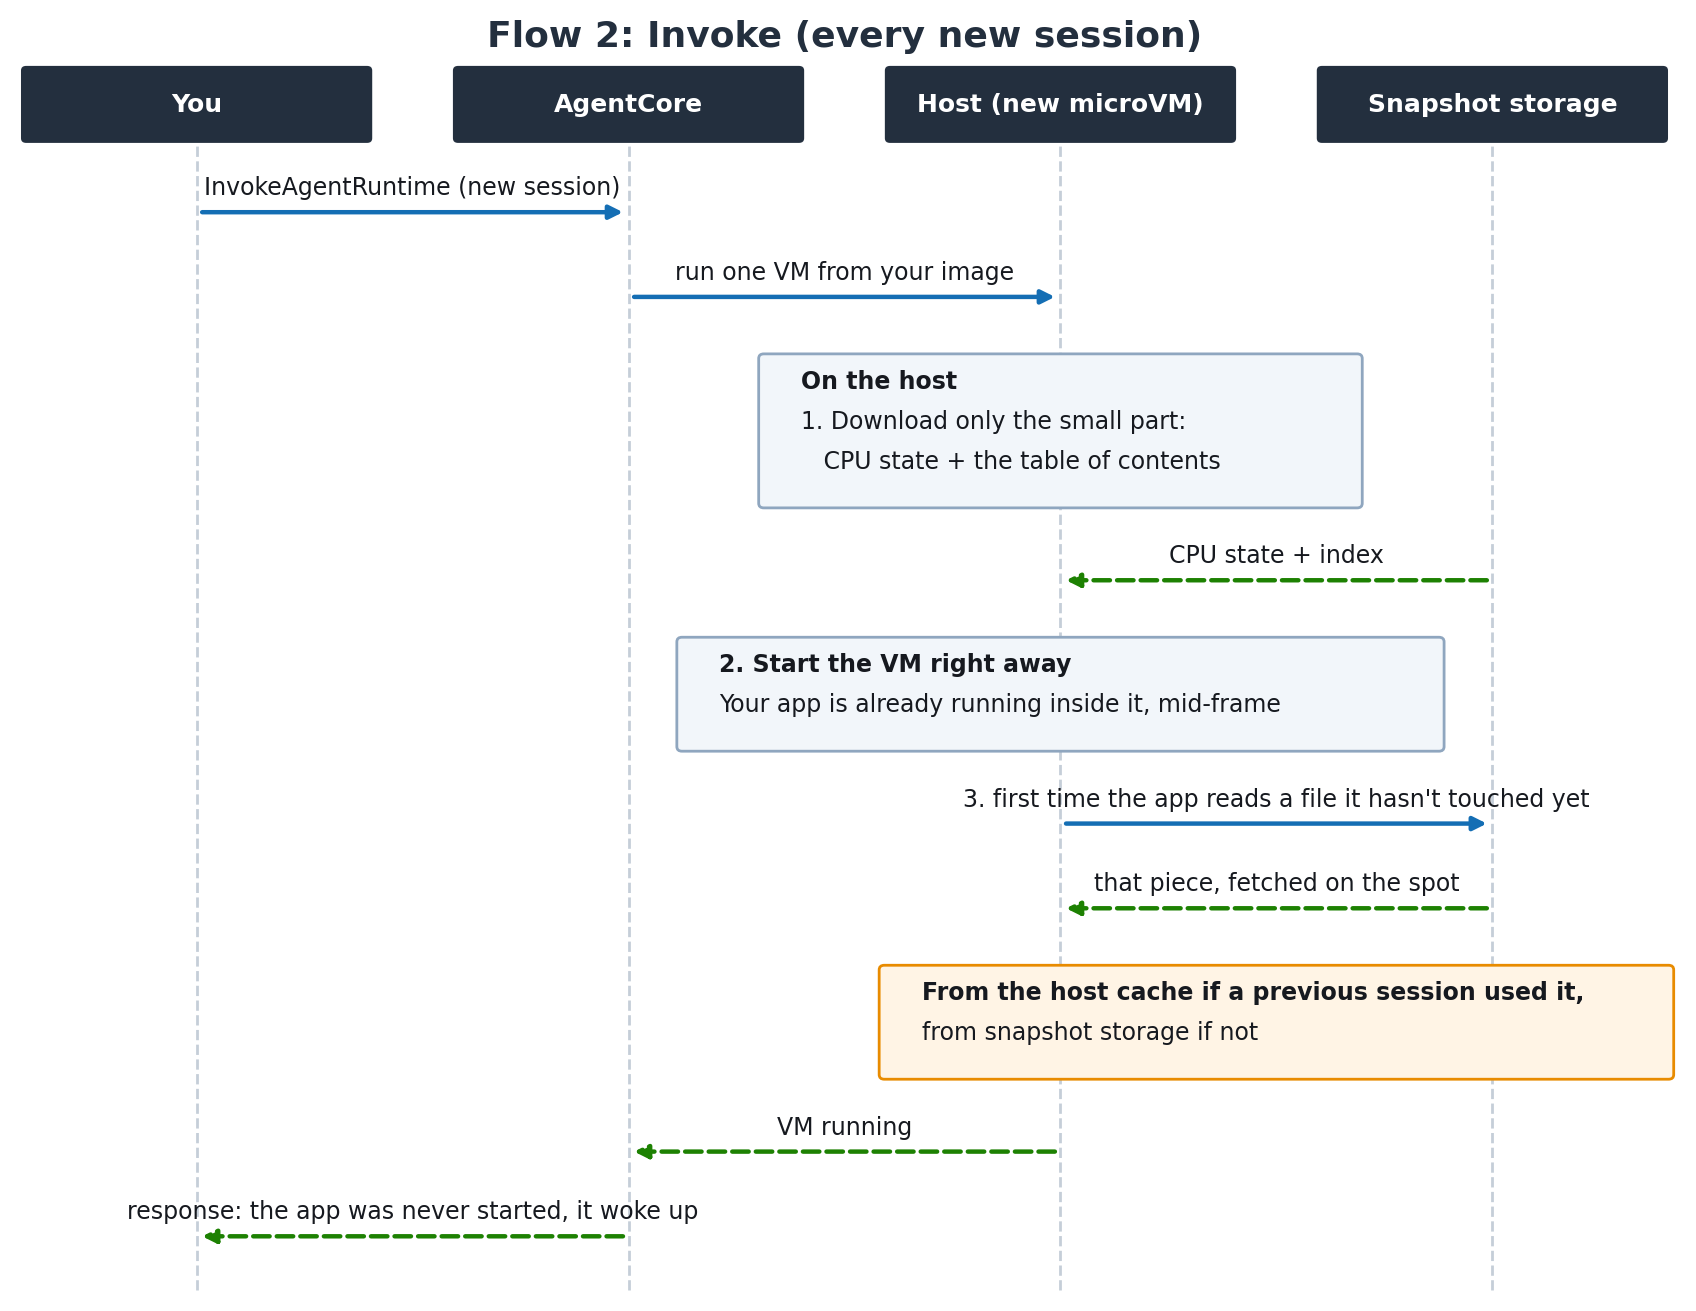
Cuando llega una nueva sesión, AgentCore restaura la instantánea en una nueva microVM. Su proceso se reanuda exactamente donde se congeló, con sus importaciones, objetos y clientes en su lugar. Los archivos de su imagen se cargan de forma diferida: cada bloque se recupera la primera vez que una sesión lo lee.
Figura 2: Invocación, cada nueva sesión
Tres hechos se derivan de estos flujos, y el resto de esta publicación se basa en ellos:
La memoria vuelve completa. Cualquier cosa que su proceso mantuviera en el momento de la instantánea, y cualquier cosa en un sistema de archivos con respaldo de RAM como /dev/shm, está disponible a velocidad de memoria desde el primer acceso.
Las lecturas de archivos no se transfieren. La caché de archivos se limpia antes de la congelación, por lo que leer un archivo durante la inicialización no lo hace rápido en una sesión restaurada.
Los archivos de la imagen se recuperan al leerlos por primera vez. La primera lectura de un bloque proviene del almacenamiento de la instantánea y luego se almacena en caché más cerca del host.
La siguiente tabla muestra lo que esto significa para el trabajo que realiza un agente típico, dependiendo de dónde lo realice:
Trabajo
Realizado durante la inicialización
Realizado en el controlador
Importar bibliotecas
En memoria cuando comienza la sesión
Leído desde la imagen en cada nueva sesión
Crear clientes (por ejemplo, boto3)
Restaurado con resolución de endpoint y credenciales realizada. Los sockets se reconectan en el primer uso
Construido desde cero en cada nueva sesión
Abrir conexiones de red
Caducado después de la restauración. Cerrarlos antes de la instantánea
Abrir fresco
Cargar datos estáticos desde la imagen y mantenerlos en un objeto
En memoria cuando comienza la sesión
Leído desde la imagen en cada nueva sesión
Leer un archivo desde la imagen sin mantener los datos
Ningún efecto, porque la caché de archivos se borra
Leído desde la imagen en cada nueva sesión
Si conoce AWS Lambda SnapStart, esto le resultará familiar. La publicación de Marc Brooker sobre cómo SnapStart carga instantáneas y la publicación de estrategias de preparación de SnapStart son útiles como fondo.
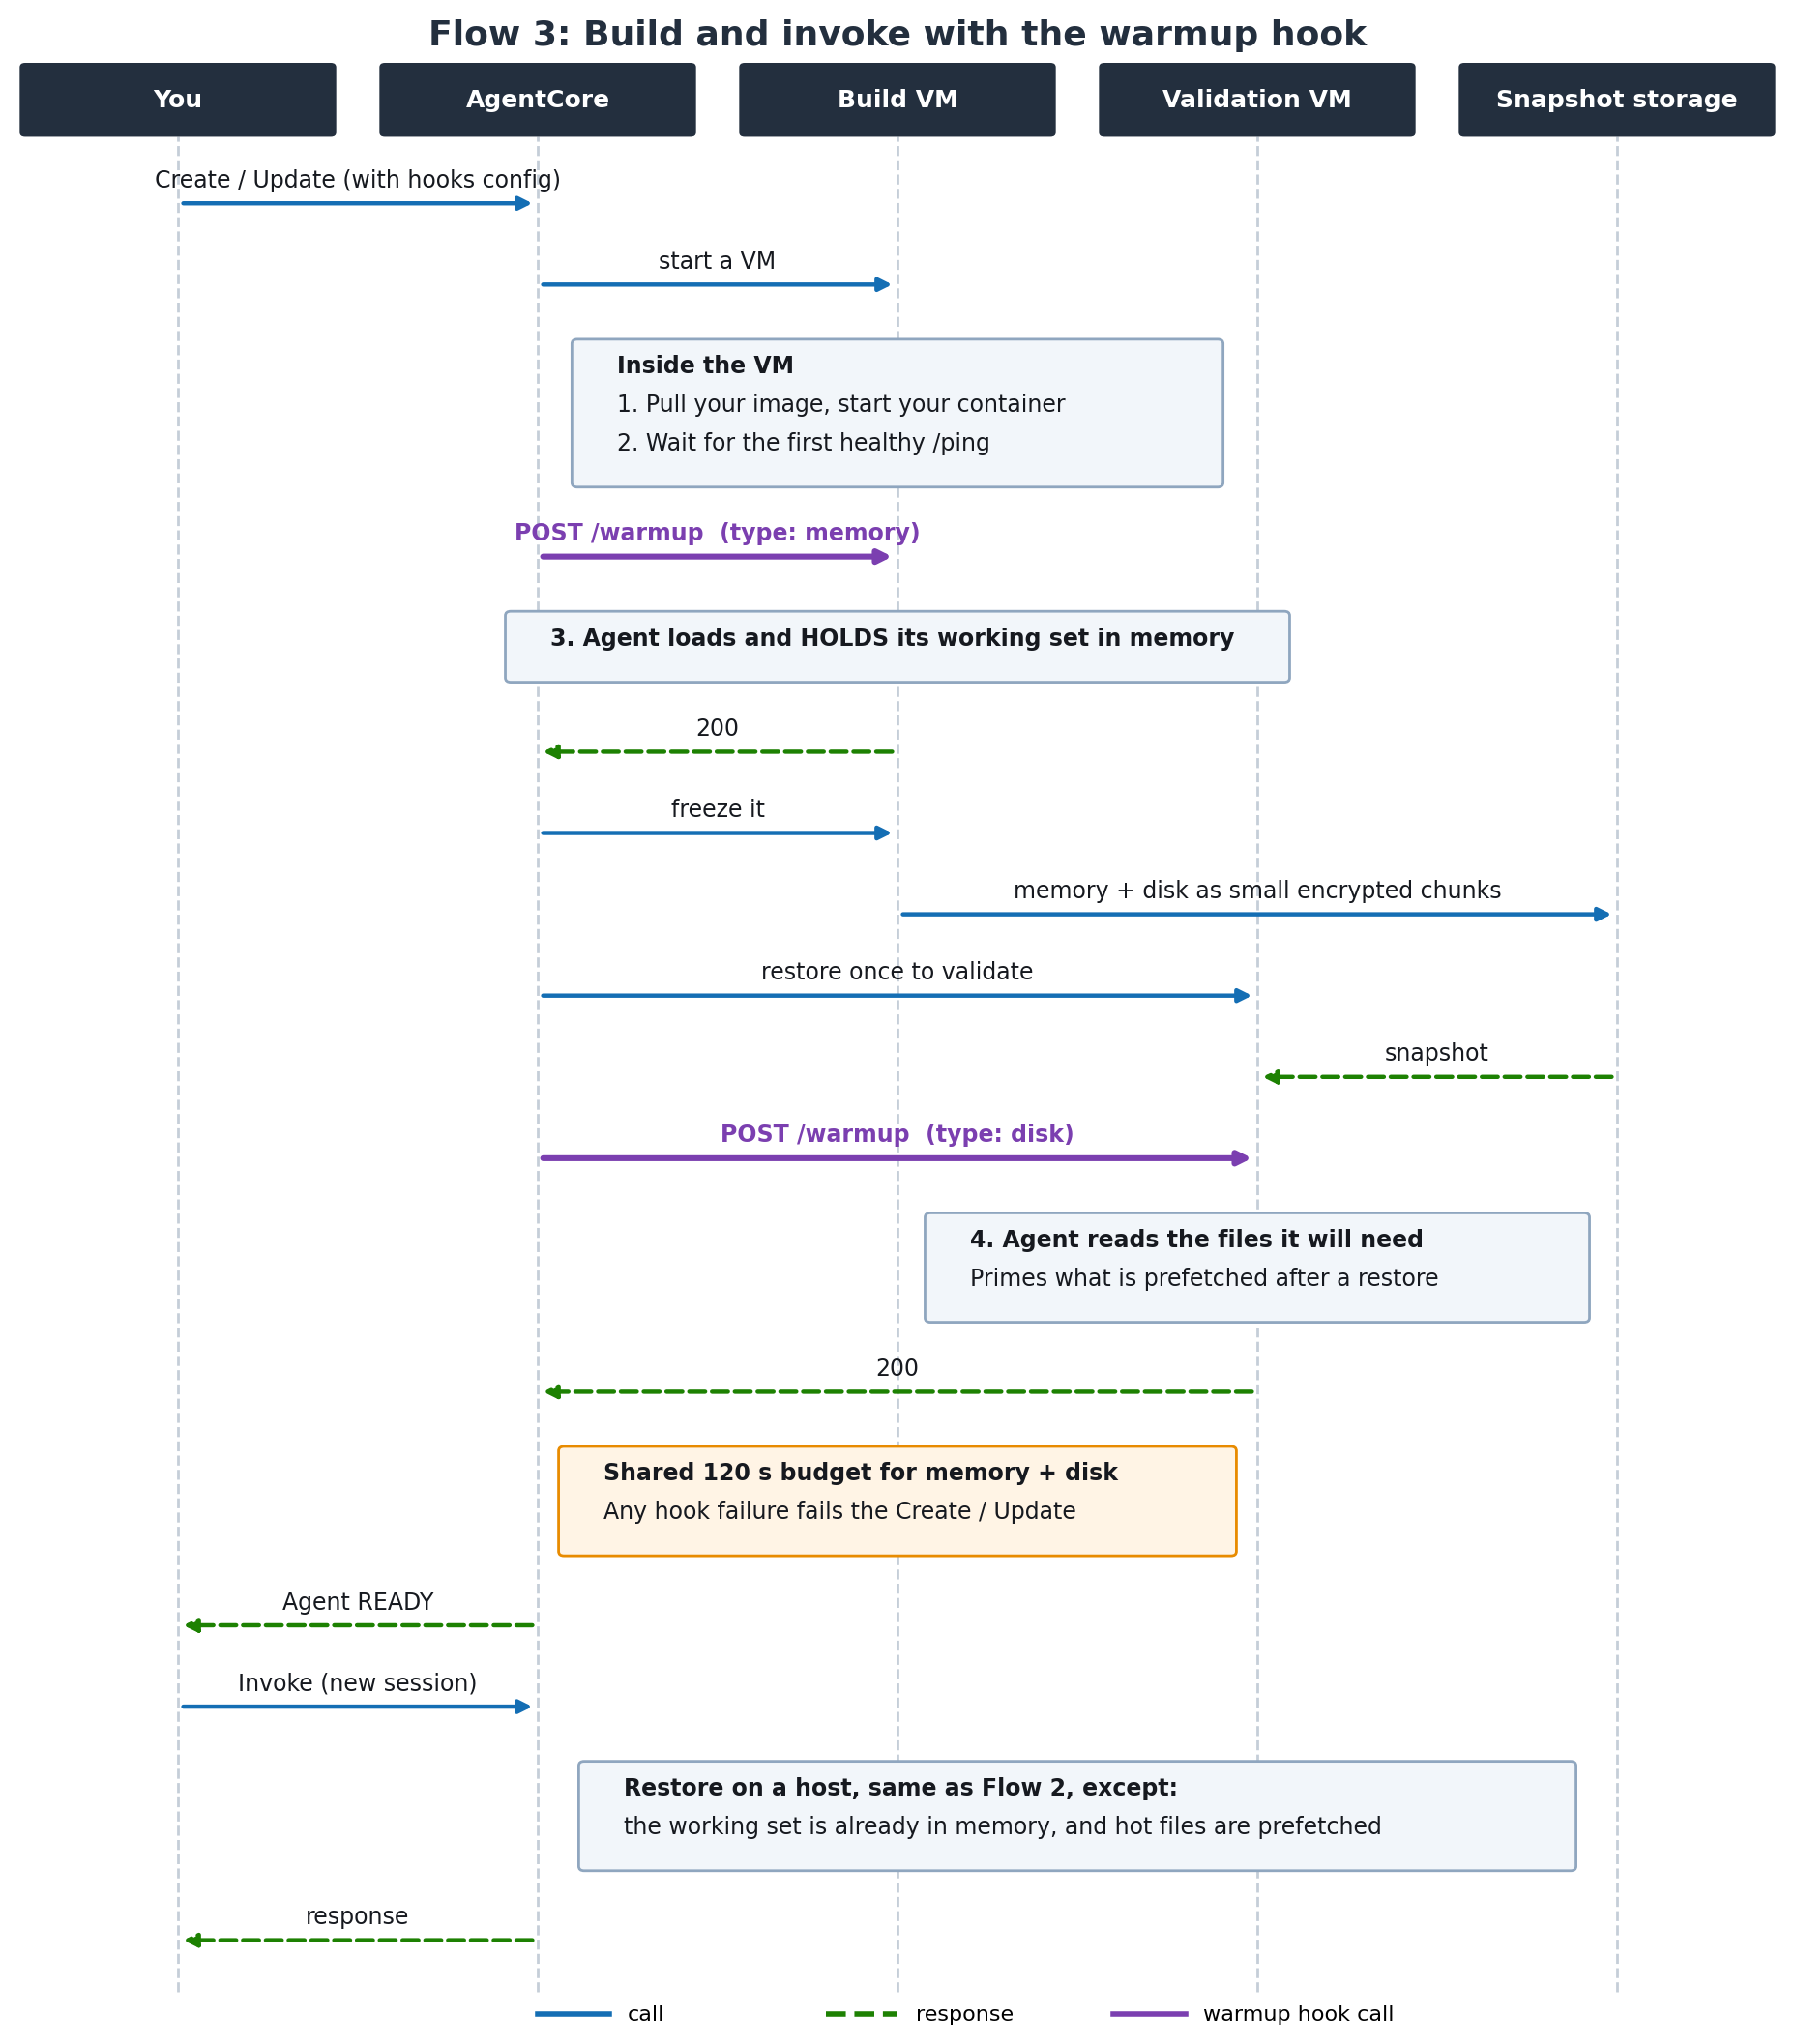
Todo en la tabla asume que su agente puede mantener lo que necesita en su propio proceso. Eso no siempre es posible. Una CLI que se ejecuta como un proceso separado y sale, o un binario del navegador, se lee durante la inicialización y luego se va, así que una sesión restaurada lo recupera de la imagen nuevamente. Para estos casos, puede agregar un hook de compilación, cubierto en “Trabajar con hooks”. La Figura 3 muestra dónde se ejecuta.
Figura 3: Compilación e invocación con hooks
Mida antes de optimizar
La latencia en una aplicación agente no es un solo número. Una solicitud pasa tiempo en el runtime de AgentCore preparando una sesión para ejecutar su código, luego en su código: llamadas de modelo, llamadas de herramientas, subagentes y transmisión de la respuesta. Usted soluciona estos de diferentes maneras, así que comience encontrando cuál es el que domina.
AgentCore runtime publica tanto como métricas de Amazon CloudWatch en el espacio de nombres AWS/Bedrock-AgentCore. Latency es el tiempo hasta el primer byte. OverheadLatency es la parte que pertenece a la plataforma, como iniciar el microVM y restaurar la instantánea en una nueva sesión.
Lo que deseas
Cómo obtenerlo
TTFB (Tiempo hasta el primer byte)
Latency
Tiempo de runtime
OverheadLatency
Tiempo de tu código
Latency − OverheadLatency
Tiempo de inicialización
Medido en tu código al inicio (ver el siguiente ejemplo). No es parte de ninguna solicitud en V2
Init no aparece en estas métricas porque en V2 se ejecuta una vez, mientras se construye la instantánea, y no en cada sesión. Agrega a cuánto tiempo tarda una creación o actualización en alcanzar READY, no a la latencia de la solicitud. Para ver cuánto tiempo tarda, registrelo una vez antes de app.run(). La línea aparece en los registros de compilación de tu runtime:
import time
INIT_START = time.time()  # first line of your module
# imports, clients, data loading ...
print(f"init_ms={round((time.time() - INIT_START) * 1000)}")
app.run()
Cómo leer la división:
Alto OverheadLatency en nuevas sesiones: el tiempo está en el inicio de la sesión. Utilice los patrones más adelante en esta publicación para iniciar sesiones antes de que los usuarios las necesiten.
El tiempo de tu código es mucho mayor en la primera solicitud que en la segunda en la misma sesión: el trabajo que pertenece a init se está ejecutando en tu controlador. Agregue spans personalizados en AgentCore Observability (una capacidad de Amazon Bedrock AgentCore) alrededor de la configuración de herramientas, cargas de archivos y importaciones tardías para encontrarlo, luego muévalo a init.
Informe percentiles como P90 y P99, o medias recortadas como TM90, que promedian las solicitudes más rápidas del 90% y descartan la cola más lenta. Un promedio simple oculta las solicitudes lentas. OverheadLatency cubre solicitudes a sesiones en ejecución, así como nuevas, por lo que su distribución depende de cuántas de tus solicitudes inician una nueva sesión. Compare corridas con una mezcla similar.
Pruebe a la tasa de nuevas sesiones que espera en producción, no con un puñado de sesiones después de una implementación.
Para incluir el tiempo de red desde tu cliente, mida en el cliente también. Cronometre la llamada a invoke, haga que su controlador devuelva cuánto tiempo se ejecutó y reste. Ambas marcas de tiempo provienen de la misma máquina, por lo que las diferencias de reloj entre el cliente y el microVM no importan. Si transmite, los eventos muy pequeños pueden retrasarse hasta que se acumulen unos pocos cientos de bytes de salida, por lo que el tiempo hasta el primer evento puede leer más alto que el inicio de la sesión.
Mantenga el trabajo fuera de la primera solicitud
El consejo habitual para el arranque en frío es importar de forma diferida y mantener la inicialización pequeña. En V2, haz lo contrario: la inicialización se ejecuta una vez, cuando se crea la instantánea, y el trabajo diferido al controlador se paga con cada nueva sesión. Esto se aplica al trabajo estático: importaciones, clientes y datos de tu imagen. Los datos dinámicos no se pueden capturar en una instantánea. La siguiente sección cubre esto.
Los agentes que más notan son aquellos que leen archivos grandes desde su imagen en el momento de la solicitud: pesos para un modelo local pequeño, incrustaciones, conjuntos de datos, bibliotecas grandes, un binario de navegador para automatización o una cadena de herramientas de línea de comandos que un agente de codificación ejecuta como subprocessos. Leer muchos archivos pequeños, como compilar un proyecto de TypeScript, tiene el mismo efecto. Un agente que importa unas pocas bibliotecas y llama a un modelo alojado principalmente necesita obtener sus importaciones y clientes correctos.
Cómo reestructurar tu agente
Crea objetos durante la inicialización, no solo importaciones. Crear un objeto carga los módulos de los que depende y los mantiene en memoria activa. Inicializa herramientas locales que utilizan bibliotecas externas durante la inicialización también, no cuando el agente las llama por primera vez.
Crea tus clientes durante la inicialización. La resolución de puntos de conexión, la resolución de credenciales y los módulos del cliente regresan con la instantánea. Los sockets no, pero los clientes boto3 se reconectan limpiamente en la primera llamada. Algunos otros clientes de red intentan primero el socket obsoleto, lo que agrega cientos de milisegundos, así que cierra sus conexiones antes de la instantánea.
Mantén los datos estáticos en memoria, como las solicitudes, la materia frontal de habilidades, la configuración y los índices pequeños. Mantén los datos en un objeto, no solo una lectura de ellos:
INDEX = pathlib.Path("/opt/data/index.bin").read_bytes() # during init: keep the bytes
Mantén las herramientas en ejecución en lugar de iniciarlas por solicitud. Un subprocesso lanzado en el controlador lee su binario y bibliotecas desde la imagen en cada nueva sesión. Un ayudante de larga duración iniciado durante la inicialización, como un servidor de lenguaje o un proceso de trabajo con sus importaciones realizadas, regresa como parte de la memoria del proceso. Habla con él a través de una tubería o socket.
Copia archivos que no puedas mantener en memoria a un disco con respaldo de RAM. Las cadenas de herramientas como tsc se ejecutan como programas separados que leen sus propios archivos. Cópialos a /dev/shm o una montura ramfs durante la inicialización para que sus lecturas provengan de la memoria.
Envía bytecode compilado.uv pip install no se compila de forma predeterminada, así que las importaciones tardías también se compilan desde el origen. Establece UV_COMPILE_BYTECODE=1 o usa pip install --compile.
El ejemplo a continuación crea el agente, su modelo y sus clientes durante la inicialización, por lo que cada sesión hereda de ellos:
import json, pathlib
import boto3
import pandas as pd  # import during init, including rarely used libraries
from strands import Agent
from strands.models import BedrockModel
from bedrock_agentcore.runtime import BedrockAgentCoreApp

MODEL_ID = "us.anthropic.claude-haiku-5-5"

# Init: runs once, before the snapshot. Every new session inherits these objects.
PROMPTS = json.loads(pathlib.Path("prompts.json").read_text())
ddb = boto3.client("dynamodb")
agent = Agent(model=BedrockModel(model_id=MODEL_ID), system_prompt=PROMPTS["system"])

app = BedrockAgentCoreApp()

@app.entrypoint
def invoke(payload):
    return agent(payload["prompt"])

app.run()  # /ping answers only after this line
La compensación: el tiempo hasta el primer byte en una nueva sesión es el tiempo para iniciar el microVM y restaurar la instantánea, más el tiempo que tarda su controlador. Mover el trabajo a init acorta el controlador, pero cualquier cosa que mantenga en memoria hace que la instantánea sea más grande. También paga por la memoria mantenida en cada sesión. Mida el inicio de sesión de extremo a extremo antes y después del cambio, para que sepa que ha reducido la latencia y no solo la ha movido del controlador a la restauración.
Tarjeta de referencia
Datos
Enfoque
Archivos grandes que la primera solicitud necesita, como un modelo, una CLI o un navegador
Manténgalos en memoria durante init, o prepárelos con un gancho de compilación
Datos de referencia grandes leídos selectivamente
Monte Amazon S3 Files o Amazon Elastic File System (Amazon EFS) durante init, a través de un punto de acceso (requiere modo de nube privada virtual (VPC))
Archivos que el agente lee raramente
Déjelos en la imagen, o muévalos a Amazon Simple Storage Service (Amazon S3), S3 Files o Amazon EFS
Archivos que la sesión crea
No se necesita ningún cambio
Trabajando con ganchos
Un gancho de compilación se construye en init y no lo reemplaza. Haga lo que pueda en init y use el gancho para lo que init no puede cubrir. Exponga un punto final HTTP en su contenedor, y AgentCore runtime le envía una solicitud POST dos veces mientras construye su runtime:
Antes de la instantánea. En el microVM de compilación, después de que su agente informa que está sano y antes de la congelación. Cualquier cosa que su agente cargue aquí y mantenga en memoria es parte de la instantánea, por lo que cada sesión comienza con ella.
Después de una restauración de prueba. En un microVM separado que restaura la instantánea para comprobarla. Nada de esta llamada se captura en la instantánea. Úsela para leer los archivos que sus sesiones necesitarán, lo que da forma a lo que las sesiones restauradas recuperan primero.
El encabezado X-Amzn-Bedrock-AgentCore-Runtime-Warmup-Type le indica a su agente qué llamada está manejando: memory para la primera, disk para la segunda. Las dos llamadas comparten 120 segundos, por lo que la llamada disk obtiene el tiempo que la llamada memory deja. Devuelva una respuesta 2xx solo después de que se complete el trabajo. Cualquier otra respuesta, una conexión fallida o agotamiento de tiempo provoca que la creación o actualización falle, y AgentCore runtime no vuelve a intentarlo. Las secuencias build-logs- en el grupo de registros de su runtime muestran qué llamada falló y por qué.
Los ganchos están disponibles en runtimes V2. Configúrelos con hooksConfiguration cuando cree o actualice el runtime:
El puerto es opcional y se establece de forma predeterminada en el puerto de servicio de su agente. Si lo establece, use un puerto desde 8000 hasta 12000 que no esté reservado por la plataforma. La ruta no puede coincidir con una ruta que AgentCore runtime ya utilice en ese puerto, como POST /invocations o GET /ping. UpdateAgentRuntime reemplaza toda la configuración del hook, así que incluya hooksConfiguration en cada actualización donde desee mantener el hook.
En el agente, maneje ambos tipos de llamadas en el mismo endpoint:
import asyncio
from fastapi import FastAPI, Request, Response

app = FastAPI()

# Files that each session reads when it starts.
STARTUP_FILES = ["/app/models/tokenizer.json", "/app/config/agent.json"]

def load_shared_state():
    # Load what every session needs into memory, such as heavy imports,
    # model weights, and caches.
    ...

def read_startup_files():
    # Read the files that a session reads when it starts, so that new
    # sessions can use them faster.
    for path in STARTUP_FILES:
        with open(path, "rb") as f:
            while f.read(1024 * 1024):
                pass

@app.get("/ping")
def ping():
    return {"status": "Healthy"}

@app.post("/warmup")
async def warmup(request: Request):
    # Header lookup in Starlette and FastAPI is case-insensitive.
    warmup_type = request.headers.get(
        "X-Amzn-Bedrock-AgentCore-Runtime-Warmup-Type", ""
    ).lower()
    # Run the work in a worker thread so that /ping keeps answering.
    if warmup_type == "memory":
        await asyncio.to_thread(load_shared_state)
    elif warmup_type == "disk":
        await asyncio.to_thread(read_startup_files)
    # Respond only after the work is done.
    return Response(status_code=200)

@app.post("/invocations")
async def invoke(request: Request):
    payload = await request.json()
    # Per-request work runs here on every session.
    return {"response": payload.get("prompt", "")}
Peligros de la instantánea: qué debe permanecer en el controlador
Todo lo creado durante la inicialización se congela en la instantánea hasta su próxima implementación, y cada sesión comienza con la misma copia. Para la mayoría de los objetos, ese es el punto. Para los valores a continuación, es un error, y para los valores aleatorios, un problema de seguridad.
Cargue datos dinámicos en el controlador, una vez por sesión. Los catálogos de herramientas de AgentCore Gateway (una capacidad de Amazon Bedrock AgentCore), las banderas de características y las listas de precios cambian después de implementar. Cárguelos en el controlador y almacénelos a nivel de módulo, para que cada sesión los recupere una vez. Las sesiones pueden durar hasta 8 horas, así que déle una fecha de caducidad a la caché:
_tools, _loaded_at = None, 0.0

def get_tools():
    global _tools, _loaded_at
    if _tools is None or time.time() - _loaded_at > 300:  # wall clock: refresh after 5 minutes
        _tools, _loaded_at = load_gateway_tools(), time.time()
    return _tools
Llame a get_tools() desde el controlador y pase el resultado al agente que creó durante la inicialización.
Cree valores por sesión en el controlador.
Valor
Dónde crearlo
Por qué
Valores aleatorios, nonces, secretos, claves
En el controlador, con secrets, os.urandom() o uuid.uuid4()
El estado aleatorio de la biblioteca (Python's random, NumPy) creado durante la inicialización es idéntico en cada sesión. Los valores del sistema operativo son únicos
Tiempo actual y transcurrido
En el controlador, con time.time()
Una marca de tiempo de inicialización es fija en el momento de la instantánea, y time.monotonic() no cuenta el tiempo que la instantánea pasó almacenada
Temporizadores, limitadores de velocidad, cachés TTL
Utilice el tiempo de reloj de pared o réstelos en la primera solicitud
Cualquier cosa que mida el tiempo transcurrido con un reloj monótono ve casi no hay brecha en la restauración
Credenciales y tokens que obtienes tú mismo
Renúncialos cuando expiren
Los valores cargados durante la inicialización pueden expirar antes de que comience una sesión
Conoce los límites. Una sesión termina cuando su tiempo de inactividad expira (idleRuntimeSessionTimeout: 15 minutos por defecto, desde 60 segundos hasta 8 horas), cuando alcanza su tiempo de vida máximo (maxLifetime: 8 horas por defecto y como máximo), o cuando la detienes.
Sub-segundo: Inicia la sesión antes de que el usuario la necesite
Supongamos que tu nueva sesión tarda alrededor de 2 segundos en iniciarse, incluyendo todo el desglose de temporización cubierto en las secciones anteriores. Una sesión que ya está en ejecución responde en aproximadamente 200 ms. Para una experiencia de chat o voz, la forma de lograr un tiempo de respuesta sub-segundo es asegurarse de que la sesión haya iniciado antes de que llegue la primera solicitud del usuario. Hay dos formas de hacerlo.
Pre-calentamiento en la interacción del usuario
La mayoría de las aplicaciones interactivas reciben una señaligen antes del primer mensaje: el usuario abre la aplicación, una ventana de chat o una página de soporte. Úsala. Genera un ID de sesión, envía una solicitud de pre-calentamiento al agente en segundo plano y mantén el ID de sesión con la conversación. Para cuando el usuario haya escrito su primer mensaje, la sesión ya está en ejecución.
# Backend, when the user opens the chat (don't block the UI on it)
session_id = f"chat-{uuid.uuid4().hex}"  # session IDs need at least 33 characters
agentcore.invoke_agent_runtime(agentRuntimeArn=ARN, runtimeSessionId=session_id,
                               payload=json.dumps({"action": "prime"}).encode())
save_conversation(user_id, session_id)  # every later turn reuses this session ID

# Agent handler: answer the warm-up before any model call
@app.entrypoint
def invoke(payload):
    if payload.get("action") == "prime":
        return {"primed": True}
    return agent(payload["prompt"])
Este patrón no requiere infraestructura adicional y oculta completamente el inicio de la sesión siempre que los usuarios tardan más de aproximadamente 2 segundos en enviar su primer mensaje. Cuesta una sesión por cada usuario que se compromete pero nunca envía una solicitud. Un tiempo de inactividad corto mantiene eso pequeño.
Conclusión
En V2, AgentCore runtime mueve la mayor parte del trabajo de inicio de una sesión al momento de la implementación. Tu contenedor se inicia una vez, y cada nueva sesión restaura el resultado: la memoria vuelve completa, y los archivos se recuperan en la primera lectura.
Para mantener el tiempo de inicio de la sesión cerca de 2 segundos, realiza tu trabajo estático durante la inicialización, mantén los datos que la primera solicitud necesita en memoria, y mantén los valores dinámicos y por sesión en el controlador. Para los archivos que tu proceso no puede mantener, agrega un hook de compilación. Para obtener un tiempo de respuesta inferior a un segundo, inicia la sesión antes de que el usuario la necesite: en la interacción del usuario cuando recibes una señaligen.
Para empezar, establece platformVersion en V2 cuando crees o actualices un runtime, luego revisa Optimiza tu agente para AgentCore runtime V2. Para preguntas sobre tu carga de trabajo, comunícate con tu equipo de cuenta de AWS.
Acerca del autor
Agents today review code, process claims, and run unattended for hours. Many also sit behind interactive experiences where a person waits for the first response. Amazon Bedrock AgentCore runtime gives these agents a fully managed, serverless environment: each session runs in its own isolated microVM, the platform scales to zero when there’s no work, and you only pay for the resources your sessions consume.
AgentCore runtime with platformVersion set to “V2” changes how sessions start. Instead of initializing your container for every session, it prepares your environment once, snapshots it, and restores that snapshot for each new session. Session start times are faster and more consistent. V2 also reclaims memory your sessions don’t use, so your bill tracks what your agent uses.
For most agents, switching to V2 is all it takes. Some agents need restructuring to get the full benefit, and for chat and voice experiences even 2 seconds is too slow. This post explains how V2 starts a session, how to measure session start time, and how to keep work off the first request, including build hooks, which AgentCore runtime now supports. We cover four patterns, from changes to your agent’s code to starting sessions before users need them.
Which pattern do you need?
Your situation
What to do
Section
A new session in about 2 seconds is fine
Switch to V2 and do all initialization before app.run()
Keep work off the first request
Your agent needs large files, a CLI, or a browser early, and can’t hold them in its process
Add a build hook to load and prime them while the snapshot is built
Working with hooks
You need sub-second, and users engage before they send their first request (opening the app or a chat window)
Start the session in the background when the user engages
Pre-warm on user engagement
How V2 starts a session
AgentCore runtime runs each session in a new microVM. On V1, AgentCore pulls your container image from Amazon Elastic Container Registry (Amazon ECR), starts the container, and runs your initialization code before it can process the first request. The image pull dominates, so cold start grows with image size.
V2 does that work once. When you create or update a runtime, AgentCore runtime starts your container in a fresh microVM and waits for the first healthy ping (GET /ping), which must arrive within 120 seconds. It then clears the operating system’s file cache, to keep the snapshot small, freezes the microVM, and stores its memory and disk as a snapshot.
This is a change from V1: Every create or update now takes a few minutes while the snapshot is built.
In this post, init means everything your agent does before /ping reports healthy. With the AgentCore Python SDK, that’s everything before app.run(). If you run your own HTTP server, in Node.js or another language, report healthy only after your initialization finishes.
Figure 1: Build, once per create or update
When a new session arrives, AgentCore restores the snapshot into a new microVM. Your process resumes exactly where it was frozen, with its imports, objects, and clients in place. Files from your image are loaded lazily: each block is fetched the first time a session reads it.
Figure 2: Invoke, every new session
Three facts follow from these flows, and the rest of this post builds on them:
Memory comes back whole. Anything your process held at snapshot time, and anything in a RAM-backed file system such as /dev/shm, is available at memory speed from the first access.
File reads don’t carry over. The file cache is cleared before the freeze, so reading a file during init doesn’t make it fast in a restored session.
Image files are fetched on first read. The first read of a block comes from snapshot storage and is then cached closer to the host.
The following table shows what that means for the work a typical agent does, depending on where it does it:
Work
Done during init
Done in the handler
Import libraries
In memory when the session starts
Read from the image in every new session
Create clients (for example, boto3)
Restored with endpoint and credential resolution done. Sockets reconnect on first use
Built from scratch in every new session
Open network connections
Stale after the restore. Close them before the snapshot
Opened fresh
Load static data from the image and keep it in an object
In memory when the session starts
Read from the image in every new session
Read a file from the image without keeping the data
No effect, because the file cache is cleared
Read from the image in every new session
If you know AWS Lambda SnapStart, this will feel familiar. Marc Brooker’s post on how SnapStart loads snapshots and the SnapStart priming strategies post are useful background.
Everything in the table assumes your agent can keep what it needs in its own process. That isn’t always possible. A CLI that runs as a separate process and exits, or a browser binary, is read during init and then gone, so a restored session fetches it from the image again. For these cases, you can add a build hook, covered in “Working with hooks.” Figure 3 shows where it runs.
Figure 3: Build and invoke with hooks
Measure before you optimize
Latency in an agentic application isn’t one number. A request spends time in AgentCore runtime getting a session ready to run your code, then in your code: model calls, tool calls, sub-agents, and streaming the response back. You fix these in different ways, so start by finding out which one dominates.
AgentCore runtime publishes both as Amazon CloudWatch metrics in the AWS/Bedrock-AgentCore namespace. Latency is the time to first byte. OverheadLatency is the part that belongs to the platform, such as starting the microVM and restoring the snapshot on a new session.
What you want
How to get it
TTFB (Time to first byte)
Latency
Runtime time
OverheadLatency
Your code’s time
Latency − OverheadLatency
Init time
Measured in your code at startup (see the following example). It isn’t part of any request on V2
Init doesn’t appear in these metrics because on V2 it runs once, while the snapshot is built, and not in each session. It adds to how long a create or update takes to reach READY, not to request latency. To see how long it takes, log it once before app.run(). The line appears in your runtime’s build logs:
import time
INIT_START = time.time()  # first line of your module
# imports, clients, data loading ...
print(f"init_ms={round((time.time() - INIT_START) * 1000)}")
app.run()
How to read the split:
High OverheadLatency on new sessions: the time is in session start. Use the patterns later in this post to start sessions before users need them.
Your code’s time is much higher on the first request than on the second in the same session: work that belongs in init is running in your handler. Add custom spans in AgentCore Observability (a capability of Amazon Bedrock AgentCore) around tool setup, file loads, and late imports to find it, then move it into init.
Report percentiles such as P90 and P99, or trimmed means such as TM90, which averages the fastest 90% of requests and drops the slowest tail. A plain average hides the slow requests. OverheadLatency covers requests to running sessions as well as new ones, so its distribution depends on how many of your requests start a new session. Compare runs with a similar mix.
Test at the rate of new sessions you expect in production, not with a handful of sessions after a deploy.
To include network time from your client, measure on the client as well. Time the invoke call, have your handler return how long it ran, and subtract. Both timestamps come from the same machine, so clock differences between the client and the microVM don’t matter. If you stream, very small events can be held back until a few hundred bytes of output build up, so time to first event can read higher than session start.
Keep work off the first request
The usual cold start advice is to import lazily and keep initialization small. On V2, do the opposite: init runs once, when the snapshot is built, and work deferred to the handler is paid by every new session. This applies to static work: imports, clients, and data from your image. Dynamic data can’t be snapshotted. The next section covers it.
The agents that notice most are the ones that read large files from their image at request time: weights for a small local model, embeddings, datasets, large libraries, a browser binary for automation, or a CLI toolchain that a coding agent runs as subprocesses. Reading many small files, as compiling a TypeScript project does, has the same effect. An agent that imports a few libraries and calls a hosted model mostly needs to get its imports and clients right.
How to restructure your agent
Create objects during init, not only imports. Creating an object loads the modules it depends on and keeps them in active memory. Initialize local tools that use external libraries during init too, not when the agent first calls them.
Create your clients during init. Endpoint resolution, credential resolution, and the client’s modules all come back with the snapshot. Sockets don’t, but boto3 clients reconnect cleanly on the first call. Some other network clients first try the stale socket, which adds hundreds of milliseconds, so close their connections before the snapshot.
Keep static data in memory, such as prompts, skill front matter, configuration, and small indexes. Hold the data in an object, not only a read of it:
INDEX = pathlib.Path("/opt/data/index.bin").read_bytes() # during init: keep the bytes
Keep tools running instead of starting them per request. A subprocess launched in the handler reads its binary and libraries from the image in every new session. A long-running helper started during init, such as a language server or a worker process with its imports done, comes back as part of process memory. Talk to it over a pipe or socket.
Copy files you can’t hold in memory to a RAM-backed disk. Toolchains like tsc run as separate programs that read their own files. Copy them to /dev/shm or a ramfs mount during init so their reads come from memory.
Ship compiled bytecode.uv pip install doesn’t compile by default, so late imports also compile from source. Set UV_COMPILE_BYTECODE=1 or use pip install --compile.
The example below builds the agent, its model, and its clients during init, so every session inherits them:
import json, pathlib
import boto3
import pandas as pd  # import during init, including rarely used libraries
from strands import Agent
from strands.models import BedrockModel
from bedrock_agentcore.runtime import BedrockAgentCoreApp

MODEL_ID = "us.anthropic.claude-haiku-5-5"

# Init: runs once, before the snapshot. Every new session inherits these objects.
PROMPTS = json.loads(pathlib.Path("prompts.json").read_text())
ddb = boto3.client("dynamodb")
agent = Agent(model=BedrockModel(model_id=MODEL_ID), system_prompt=PROMPTS["system"])

app = BedrockAgentCoreApp()

@app.entrypoint
def invoke(payload):
    return agent(payload["prompt"])

app.run()  # /ping answers only after this line
The trade-off: time to first byte on a new session is the time to start the microVM and restore the snapshot, plus the time your handler takes. Moving work into init shortens the handler, but anything you hold in memory makes the snapshot larger. You also pay for that held memory in every session. Measure end-to-end session start before and after the change, so you know you’ve reduced latency and not only moved it from the handler to the restore.
Reference card
Data
Approach
Large files the first request needs, such as a model, a CLI, or a browser
Hold them in memory during init, or prime them with a build hook
Large reference data read selectively
Mount Amazon S3 Files or Amazon Elastic File System (Amazon EFS) during init, through an access point (requires virtual private cloud (VPC) mode)
Files the agent rarely reads
Leave them on the image, or move them to Amazon Simple Storage Service (Amazon S3), S3 Files, or Amazon EFS
Files the session creates
No change needed
Working with hooks
A build hook builds on init and doesn’t replace it. Do what you can in init and use the hook for what init can’t cover. You expose an HTTP endpoint in your container, and AgentCore runtime sends it a POST request twice while it builds your runtime:
Before the snapshot. On the build microVM, after your agent reports healthy and before the freeze. Anything your agent loads here and keeps in memory is part of the snapshot, so every session starts with it.
After a test restore. On a separate microVM that restores the snapshot to check it. Nothing from this call is snapshotted. Use it to read the files your sessions will need, which shapes what restored sessions fetch first.
The X-Amzn-Bedrock-AgentCore-Runtime-Warmup-Type header tells your agent which call it’s handling: memory for the first, disk for the second. The two calls share 120 seconds, so the disk call gets whatever time the memory call leaves. Return a 2xx response only after the work is done. Any other response, a failed connection, or running out of time fails the create or update, and AgentCore runtime doesn’t retry. The build-logs- streams in your runtime’s log group show which call failed and why.
Hooks are available on V2 runtimes. Configure them with hooksConfiguration when you create or update the runtime:
The port is optional and defaults to your agent’s serving port. If you set it, use a port from 8000 to 12000 that isn’t reserved by the platform. The path can’t match a route AgentCore runtime already uses on that port, such as POST /invocations or GET /ping. UpdateAgentRuntime replaces the whole hook configuration, so include hooksConfiguration in every update where you want to keep the hook.
In the agent, handle both call types on the same endpoint:
import asyncio
from fastapi import FastAPI, Request, Response

app = FastAPI()

# Files that each session reads when it starts.
STARTUP_FILES = ["/app/models/tokenizer.json", "/app/config/agent.json"]

def load_shared_state():
    # Load what every session needs into memory, such as heavy imports,
    # model weights, and caches.
    ...

def read_startup_files():
    # Read the files that a session reads when it starts, so that new
    # sessions can use them faster.
    for path in STARTUP_FILES:
        with open(path, "rb") as f:
            while f.read(1024 * 1024):
                pass

@app.get("/ping")
def ping():
    return {"status": "Healthy"}

@app.post("/warmup")
async def warmup(request: Request):
    # Header lookup in Starlette and FastAPI is case-insensitive.
    warmup_type = request.headers.get(
        "X-Amzn-Bedrock-AgentCore-Runtime-Warmup-Type", ""
    ).lower()
    # Run the work in a worker thread so that /ping keeps answering.
    if warmup_type == "memory":
        await asyncio.to_thread(load_shared_state)
    elif warmup_type == "disk":
        await asyncio.to_thread(read_startup_files)
    # Respond only after the work is done.
    return Response(status_code=200)

@app.post("/invocations")
async def invoke(request: Request):
    payload = await request.json()
    # Per-request work runs here on every session.
    return {"response": payload.get("prompt", "")}
Everything created during init is frozen into the snapshot until your next deploy, and every session starts with the same copy. For most objects that’s the point. For the values below, it’s a bug, and for random values, a security issue.
Load dynamic data in the handler, once per session. Tool catalogs from AgentCore Gateway (a capability of Amazon Bedrock AgentCore), feature flags, and price lists change after you deploy. Load them in the handler and cache them at module level, so each session fetches them once. Sessions can last up to 8 hours, so give the cache an expiry:
_tools, _loaded_at = None, 0.0

def get_tools():
    global _tools, _loaded_at
    if _tools is None or time.time() - _loaded_at > 300:  # wall clock: refresh after 5 minutes
        _tools, _loaded_at = load_gateway_tools(), time.time()
    return _tools
Call get_tools() from the handler and pass the result to the agent you created during init.
Create per-session values in the handler.
Value
Where to create it
Why
Random values, nonces, secrets, keys
In the handler, with secrets, os.urandom(), or uuid.uuid4()
Library random state (Python’s random, NumPy) created during init is identical in every session. Values from the operating system are unique
Current and elapsed time
In the handler, with time.time()
An init timestamp is fixed at snapshot time, and time.monotonic() doesn’t count the time the snapshot spent stored
Timers, rate limiters, TTL caches
Use wall-clock time, or reset them on the first request
Anything measuring elapsed time with a monotonic clock sees almost no gap across the restore
Credentials and tokens you fetch yourself
Refresh them when they expire
Values loaded during init can expire before a session starts
Know the limits. A session ends when its idle timeout expires (idleRuntimeSessionTimeout: 15 minutes by default, from 60 seconds up to 8 hours), when it reaches its maximum lifetime (maxLifetime: 8 hours by default and at most), or when you stop it.
Sub-second: Start the session before the user needs it
Suppose your new session takes about 2 seconds to start, including all the timing breakdown covered in the preceding sections. A session that’s already running answers in about 200 ms. For a chat or voice experience, the way to sub-second is to make sure the session has started before the user’s first request arrives. There are two ways to do that.
Pre-warm on user engagement
Most interactive applications get a signal before the first prompt: the user opens the app, a chat window, or a support page. Use it. Generate a session ID, send the agent a warm-up request in the background, and keep the session ID with the conversation. By the time the user has typed their first message, the session is running.
# Backend, when the user opens the chat (don't block the UI on it)
session_id = f"chat-{uuid.uuid4().hex}"  # session IDs need at least 33 characters
agentcore.invoke_agent_runtime(agentRuntimeArn=ARN, runtimeSessionId=session_id,
                               payload=json.dumps({"action": "prime"}).encode())
save_conversation(user_id, session_id)  # every later turn reuses this session ID

# Agent handler: answer the warm-up before any model call
@app.entrypoint
def invoke(payload):
    if payload.get("action") == "prime":
        return {"primed": True}
    return agent(payload["prompt"])
This pattern needs no extra infrastructure and fully hides session start whenever users take more than about 2 seconds to send their first message. It costs a session for each user who engages but never sends a prompt. A short idle timeout keeps that small.
Conclusion
On V2, AgentCore runtime moves most of the work of starting a session to deployment time. Your container starts once, and every new session restores the result: memory comes back whole, and files are fetched on first read.
To keep session startup time near 2 seconds, do your static work during init, hold the data the first request needs in memory, and keep dynamic and per-session values in the handler. For files your process can’t hold, add a build hook. To get under a second, start the session before the user needs it: on user engagement when you get a signal.
To get started, set platformVersion to V2 when you create or update a runtime, then review Optimize your agent for AgentCore runtime V2. For questions about your workload, reach out to your AWS account team.
About the author
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.