
La mayoría de los modelos de lenguaje de gran tamaño (LLM) utilizan arquitecturas transformadoras con la máxima atención. Durante la inferencia, su caché de valores clave (KV) aumenta con el contexto de la conversación o del documento. Esto puede reducir la concurrencia, aumentar los costos de servicio y obligar a las aplicaciones de las agencias a descartar el historial útil.
i14 diseñó el Laplace 3B como una alternativa de atención lineal. Su estado recurrente se mantiene en 29,5 MB por secuencia, independientemente de la longitud del contexto. Al trabajar con AWS, i14 utilizó el soporte nativo de PyTorch a través de TorchNeuron Native para llevar esta arquitectura personalizada a AWS Trainium2. Esto preservó su diseño Gated Linear Attention (GLA) y su optimizador Muon
.En una instancia de trn2.48xlarge, Laplace 3B entrenó con alrededor de 120 000 fichas por segundo. El modelo generaba 11.544 fichas de salida por segundo en 1280 secuencias simultáneas. En esta publicación se explica el diseño del modelo, los cambios que i14 realizó en Trainium2 y los resultados
del entrenamiento y la inferencia.Acerca de i14
i14 es una empresa de investigación y tecnología de inteligencia artificial que desarrolla arquitecturas, componentes y tiempos de ejecución de modelos. Su trabajo se basa en la inteligencia artificial, la ciencia cognitiva computacional y la investigación sobre cómo los sistemas biológicos aprenden a lo largo del tiempo. i14 aplica estas ideas a modelos que pueden mantener un contexto a largo plazo sin permitir que el estado de servicio crezca con
cada paso del tiempo.¿Por qué modelos de atención lineal?
Transformer softmax attention compara los tokens en todo el contexto. Durante el entrenamiento, este cálculo crece cuadráticamente con la longitud de la secuencia. Durante la inferencia, la caché de KV crece a medida que el modelo procesa más
tokens. Laatención lineal reorganiza el cálculo en torno a un estado recurrente que se actualiza para cada token. Laplace 3B usa el GLA para comprimir el contexto anterior en un estado matricial de tamaño fijo. Esto cambia la atención del entrenamiento de O (T 2) a O (T) y mantiene el estado de inferencia fijo en
29,5 MB por secuencia.| Consideración | Transformer softmax attention | Laplace 3B con GLA |
| Atención formativa | Genera puntuaciones simbólicas por pares con la escala O (T 2) | Actualiza el estado recurrente fragmentado con la escala O (T) |
| Memoria de inferencia | La caché de KV crece con el contexto | El estado recurrente mantiene un tamaño fijo |
| Contextos más largos | Cada secuencia consume más memoria del acelerador | La longitud del contexto no aumenta la asignación de estados recurrentes |
| Implementación | Utiliza núcleos de atención ampliamente optimizados | Requiere núcleos y ajustes del compilador específicos para cada arquitectura |
atención lineal comprime la historia en lugar de retener cada clave y valor. Por lo tanto, debe evaluar la calidad de recuperación de sus cargas de trabajo. El estado fijo puede beneficiar a los agentes de larga duración, al análisis de documentos de gran tamaño y a las aplicaciones que necesitan memoria persistente con
requisitos de servicio predecibles.Cómo i14 adaptó Laplace 3B para AWS Trainium2
La implementación original de Laplace 3B utilizaba núcleos Triton optimizados para la GPU. El equipo del Centro de innovación en IA generativa de AWS (GenaIIC) reescribió por primera vez el kernel GLA con operadores PyTorch estándar para Trainium2. Tras comparar ambos enfoques, el equipo eligió la versión beta de TorchNeuron Native, el backend nativo de PyTorch para AWS Trainium,
porque ofrecía un mejor rendimiento.La implementación requirió tres cambios:
- Uso de PyTorch nativo para el núcleo de atención de GLA. El equipo sustituyó el núcleo Triton fused_chunk_simple_gla específico de la GPU por operadores PyTorch estándar, utilizando 16 fragmentos de 128 fichas para hacer coincidir las 128 particiones del búfer integrado en el chip de NeuronCore.
- Rediseñando la forma en que Muon se comunica. Dos colectivos multifuncionales de MuonFSDP2 redujeron 24 veces el tráfico por rango y aumentaron el rendimiento 1,63 veces.
- Compilación de la pasada secuencial hacia atrás. El equipo desglosó estáticamente los 16 pasos de la repetición del GLA para ajustarlos al tamaño del gráfico y a los límites de memoria en chip del compilador .
La sección de desafíos de ingeniería describe cada cambio en detalle.
¿Por qué elegir los aceleradores AWS Trainium?
AWS Trainium es una familia de aceleradores de aprendizaje automático (ML) de AWS diseñados para el entrenamiento y la inferencia de modelos. Una instancia trn2.48xlarge combina 16 chips Trainium2, 64 núcleos neuronales lógicos, memoria de gran ancho de banda y conectividad NeuronLink-v3. Estos recursos son compatibles con las configuraciones distribuidas de entrenamiento e inferencia que
se describen en esta publicación.Tres propiedades de Trainium2 dieron forma a la implementación: memoria integrada en chip gestionada por software (desafío 1), una interconexión rápida de chip a chip (desafío 2) y un compilador estático (desafío 3). El compilador traza la recurrencia del GLA en forma de un gráfico fijo.
Memoria integrada en chip gestionada por software. Cada NeuronCore tiene un búfer de estado (SBUF) de 28 MiB con 128 particiones y un búfer de suma parcial (PSUM) de 2 MiB. El PSUM está conectado a un motor tensor sistólico de 128 × 128, junto con unidades vectoriales y escalares independientes. El SBUF no es una caché: el compilador programa cada transferencia de HBM a SBUF con antelación, de modo que los datos están listos sin desalojos ni errores (figura 1
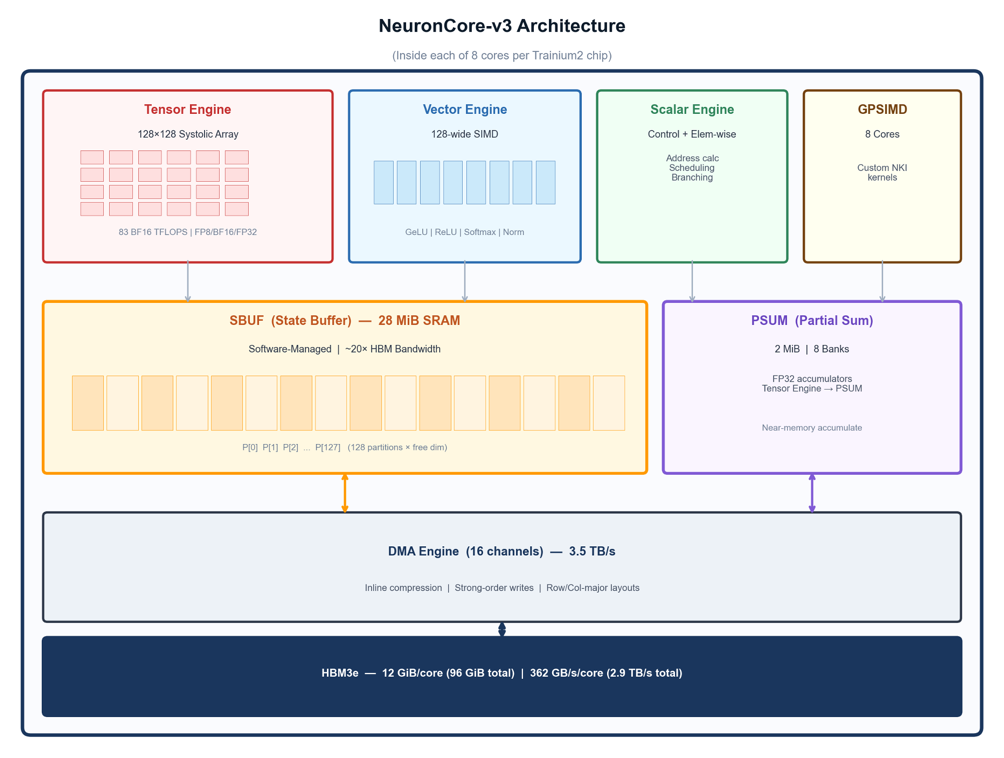
Figura 1: Arquitectura interna de Neuroncore-v3. Núcleos SBUF (28 MiB, 128 particiones), Tensor Engine (matriz sistólica de 128 × 128), Vector Engine, Scalar Engine y GPSIMD administrados por software
.i14 y la arquitectura Laplace 3B
ElLaplace 3B es el decodificador i14 de 24 capas, en el que cada capa reemplaza la atención de softmax por Simple GLA. La figura 2 muestra una capa desde la entrada x t en la parte superior hasta la salida x t + 1 en la parte inferior. En esta sección se explica cada módulo: la normalización y la convolución, la proyección QKVG, el mezclador GLA y el mezclador de canales con alimentación
directa.Normalización y convolución. El vector de flujo residual de cada token, x t ⇒ D (D = 3, 072), pasa por una LayerNorm y por una conv1D causal profunda de ancho k = 4 con sILU. Esto proporciona a cada posición un resumen de 4 gramos antes del mezclador. A continuación, el mezclador GLA realiza una recuperación basada en el contenido de toda la historia a lo largo de su estado
de descomposición.Proyección QKVG. La salida posconv pasa por una matriz fusionada W q k v g ⇒ 9, 216 × 3, 072, donde 9, 216 = H × (2 d k + 2 d v). Se divide en cuatro flujos por token: consultas q t, claves k t, valores v t y una puerta g t (H = 16, d k = 96, d v = 192). La puerta se usa después del mezclador
.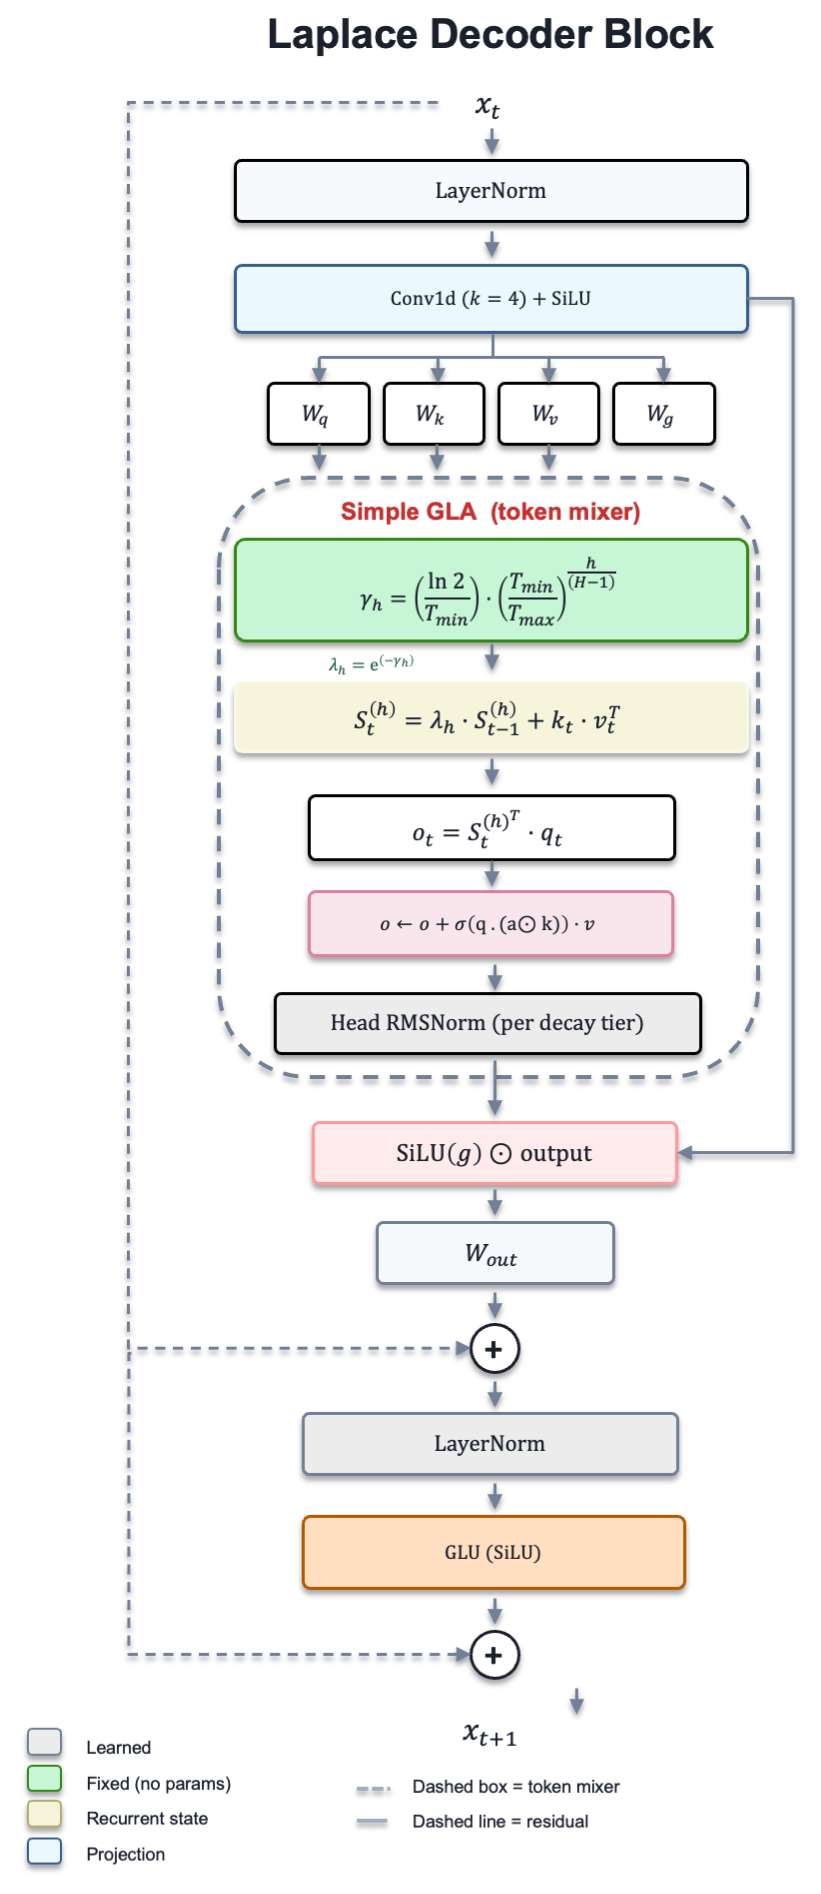
Figura 2: Arquitectura de capas descodificadoras de Laplace. Verde = fijo (sin parámetros), gris = aprendido, amarillo = estado recurrente, azul =
proyección.Mezclador GLA. Cada cabezal h mantiene un estado matricial S t (h) de tamaño d k × d v (96 × 192), un registro comprimido y decadente de los pares clave-valor del pasado. En cada token, se actualiza de la siguiente manera
: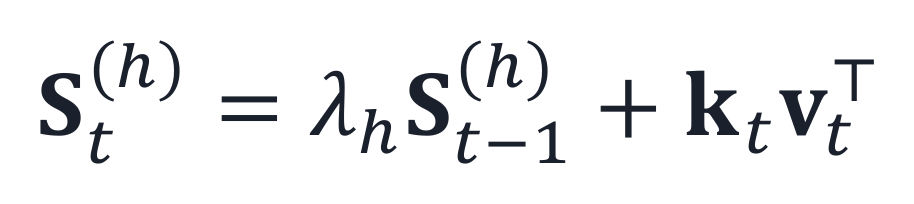
Ecuación de actualización de estado recurrente de GLA
Aquí λ h es el decaimiento fijo por habitante, y k t v t es el producto externo de rango 1 que escribe el par clave-valor actual en el estado. La lectura consulta el estado:
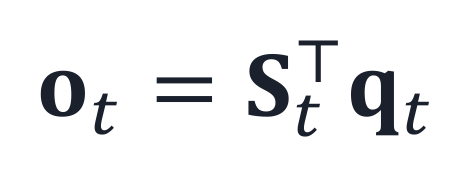
Ecuación de lectura del estado de GLA
A continuación, un paso de autoaumento agrega una copia cerrada del valor a la salida de cada cabezal:
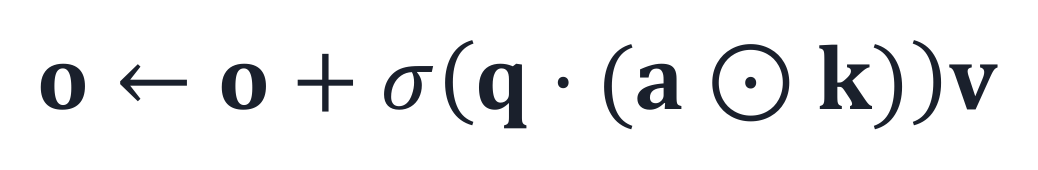
Ecuación de autoaumento de GLA
Aquí π es el sigmoide y es el producto por elementos. La puerta es la consulta salpicada de un cambio de escala de la clave aprendido por canal, donde a es la escala aprendida (aug_balance). En el momento de la inicialización, a = 0, lo que da como resultado una diferencia de la mitad del valor. Las salidas por cabezal pasan por una norma RMS principal dentro de cada nivel de decaimiento, se concatenan y se clasifican por S i L U (g t) y proyectado por W o hasta D × D de vuelta a la corriente residual.
Calendario de decaimiento. La tasa de decaimiento por cabeza λ h controla la rapidez con la que una cabeza olvida las fichas del pasado. Se fija en el momento de la inicialización (no se aprende) y se establece mediante un cronograma geométrico.
El cronograma proporciona a las 16 cabezas una distribución de la longitud de la memoria y define la tasa de decaimiento logarítmico de cada cabecera γh: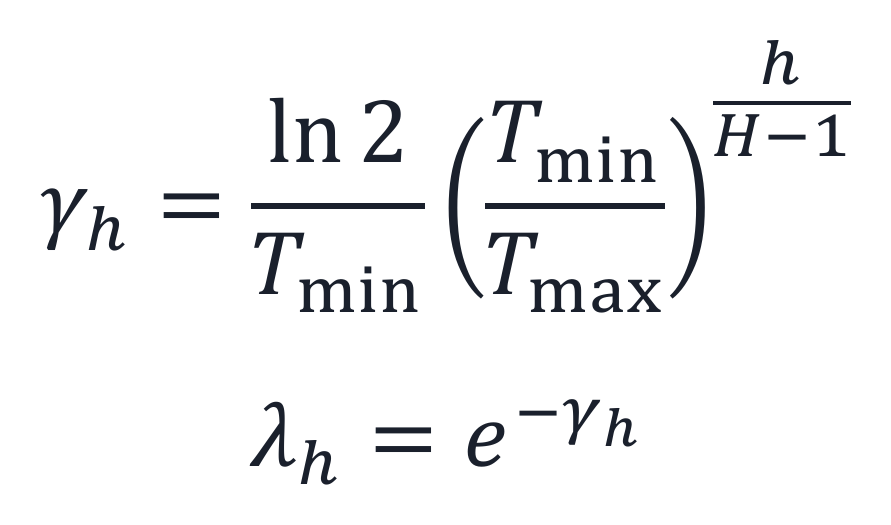
Ecuaciones del programa de decaimiento del GLA
El alcance del calendario de decaimiento. Para este modelo, T min = 1 y T máx = 2.048. Por lo tanto, la cabeza 0 tiene λ 0 = 0.5 (vida media de una ficha), y la cabeza 15 tiene λ 15 ≈ 0,9997 (vida media de 2.048 fichas). Los cabezales se agrupan en niveles, cada uno de los cuales comparte una norma RMS.
Mezclador de canales (FFN). Tras el bloqueo de atención y su residuo, un segundo LayerNorm alimenta un FFN de GLU (SiLU) con una dimensión interior de 8.192. Sus tres matrices son dos proyecciones ascendentes W 1, W 2 ⇒ 8, 192 × D y una proyección descendente W 3 ⇒ D × 8, 192.
Sigue un segundo residuo.El estado S (h) se fija en d k × d v = 96 × 192 por cabeza, independientemente de la longitud de la secuencia. Como resultado, la inferencia es O (1) por ficha y el entrenamiento es O (T) en lugar de O (T 2)
.| Parámetro | Valor |
| Parámetros | 3.028 B en total (2.718 B de muones + 309,6 millones de Adams) |
| Capas | 24 capas de decodificador, D = 3, 072 atenuaciones ocultas |
| Cabezas | 16 cabezales, d k = 96 (Q/K de ancho medio), d v = 192 (V de ancho completo) |
| Mezclador | GLA simple con decaimiento geométrico fijo (T min = 1, T max = 2, 048) |
| Conv | Conv1d causal en profundidad, ancho de núcleo 4, sILU |
| FFN | GLU (SiLu), diámetro interior 8.192 |
| Norma | LayerNorm antes de recibir atención + Head RMSNorm (por nivel) + LayerNorm antes de FFN |
| Vocabulario | 50.304 (con un múltiplo de 64) |
| Secuencia | 2.048 |
| Datos de entrenamiento | 100 mil millones de tokens, FineWeb-edu |
| Optimizador | Muon para matrices de peso 2D; AdamW para incrustaciones y normas |
| Tamaño del lote | 524.288 tokens/paso, coseno LR, calentamiento de 3.815 pasos |
Desafíos de ingeniería
Cada uno de los tres cambios planteó su propio desafío de ingeniería.
Desafío 1: Uso de PyTorch nativo en Trainium para GLA
En la GPU, GLA se ejecuta como el núcleo fused_chunk_simple_gla fusionado de Triton de la biblioteca flash-linear-attention. El equipo de GenaIIC lo reexpresó con operadores PyTorch estándar ejecutados mediante TorchNeuron Native, en forma de bucles explícitos en fragmentos de tamaño fijo. El recuento de fragmentos es fijo en el momento de la compilación y establece la profundidad de desenrollamiento hacia atrás.
El equipo usa fla_num_chunks = 16, por lo que cada fragmento contiene C = 128 fichas.Dentro de cada fragmento c, la salida entre fragmentos se oculta de forma lineal, y el estado de ejecución S añade un contexto anterior:
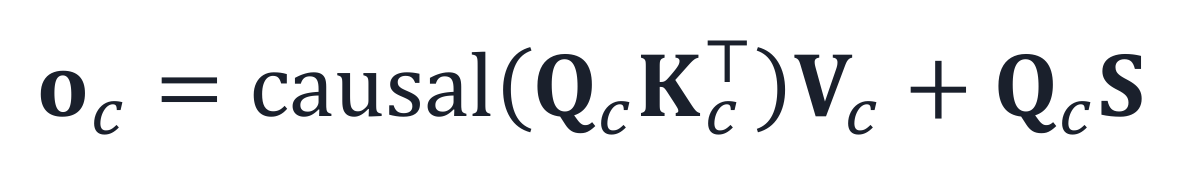
Salida intracunta de GLA fragmentada
A continuación, el estado avanza al siguiente fragmento:
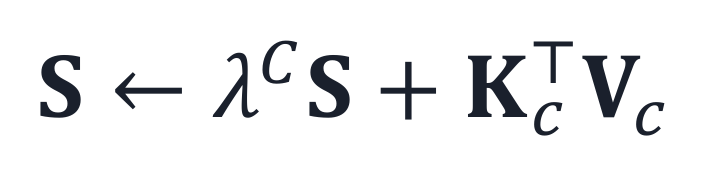
Actualización de estado de GLA fragmentada
Aquí λ C es la disminución por habitante acumulada sobre el trozo. Los 16 cálculos entre fragmentos se ejecutan en paralelo y solo la actualización del estado es secuencial
(figura 3).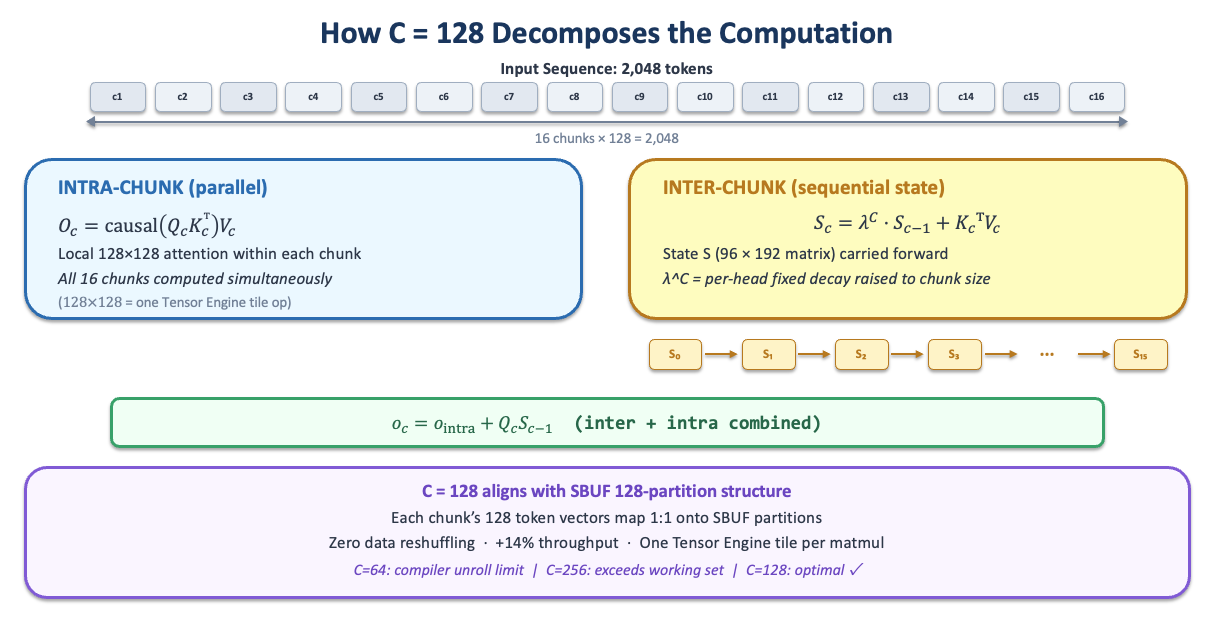
Figura 3: Recurrencia fragmentada del GLA con atención paralela dentro del fragmento y una cadena de estados secuencial.
Como el SBUF tiene 128 particiones, cada fragmento de 128 fichas asigna una ficha por partición, sin relleno ni movimiento entre particiones. Esta alineación aumentó el rendimiento medido en un 14 por
ciento (figura 4).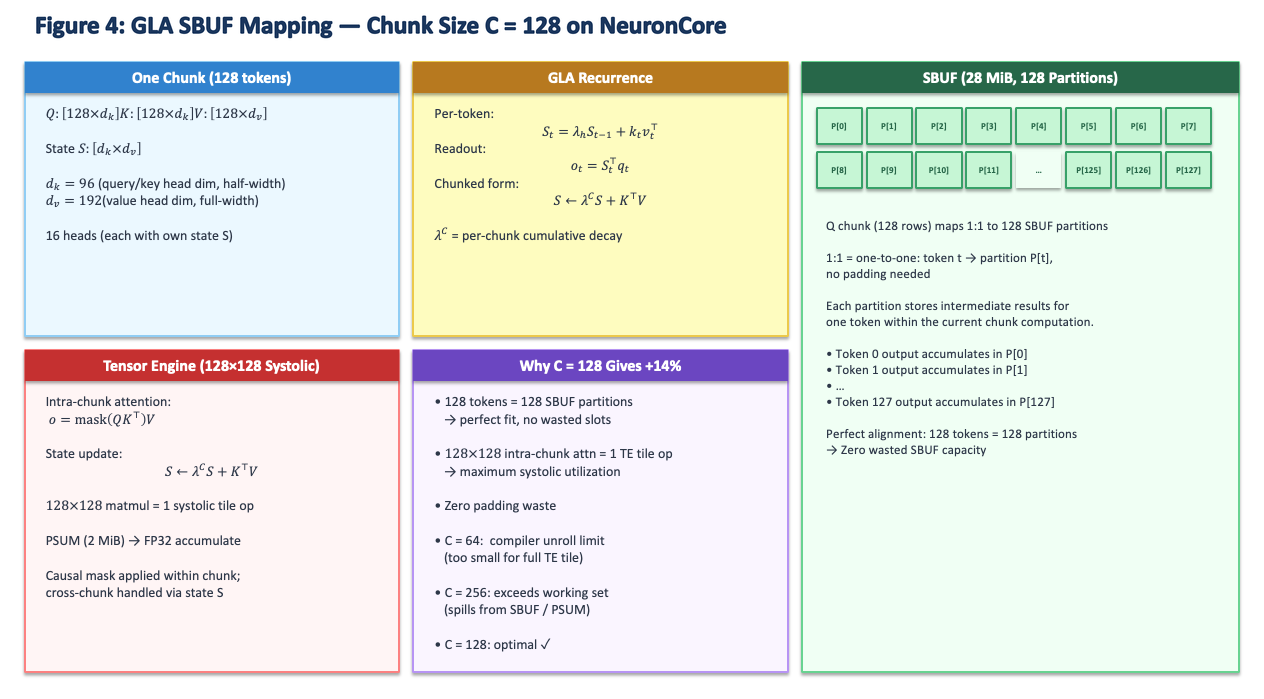
Figura 4: El tamaño de fragmento C = 128 se asigna uno a uno a las 128 particiones SBUF.
Desafío 2: Ortogonalización distribuida de muones bajo FSDP2
Muon ortogonaliza cada gradiente antes de la actualización. Para cada una de las 96 matrices de ponderación bidimensionales (2.718 millones de parámetros), ejecuta cinco iteraciones de Newton-Schulz
(algoritmo 1).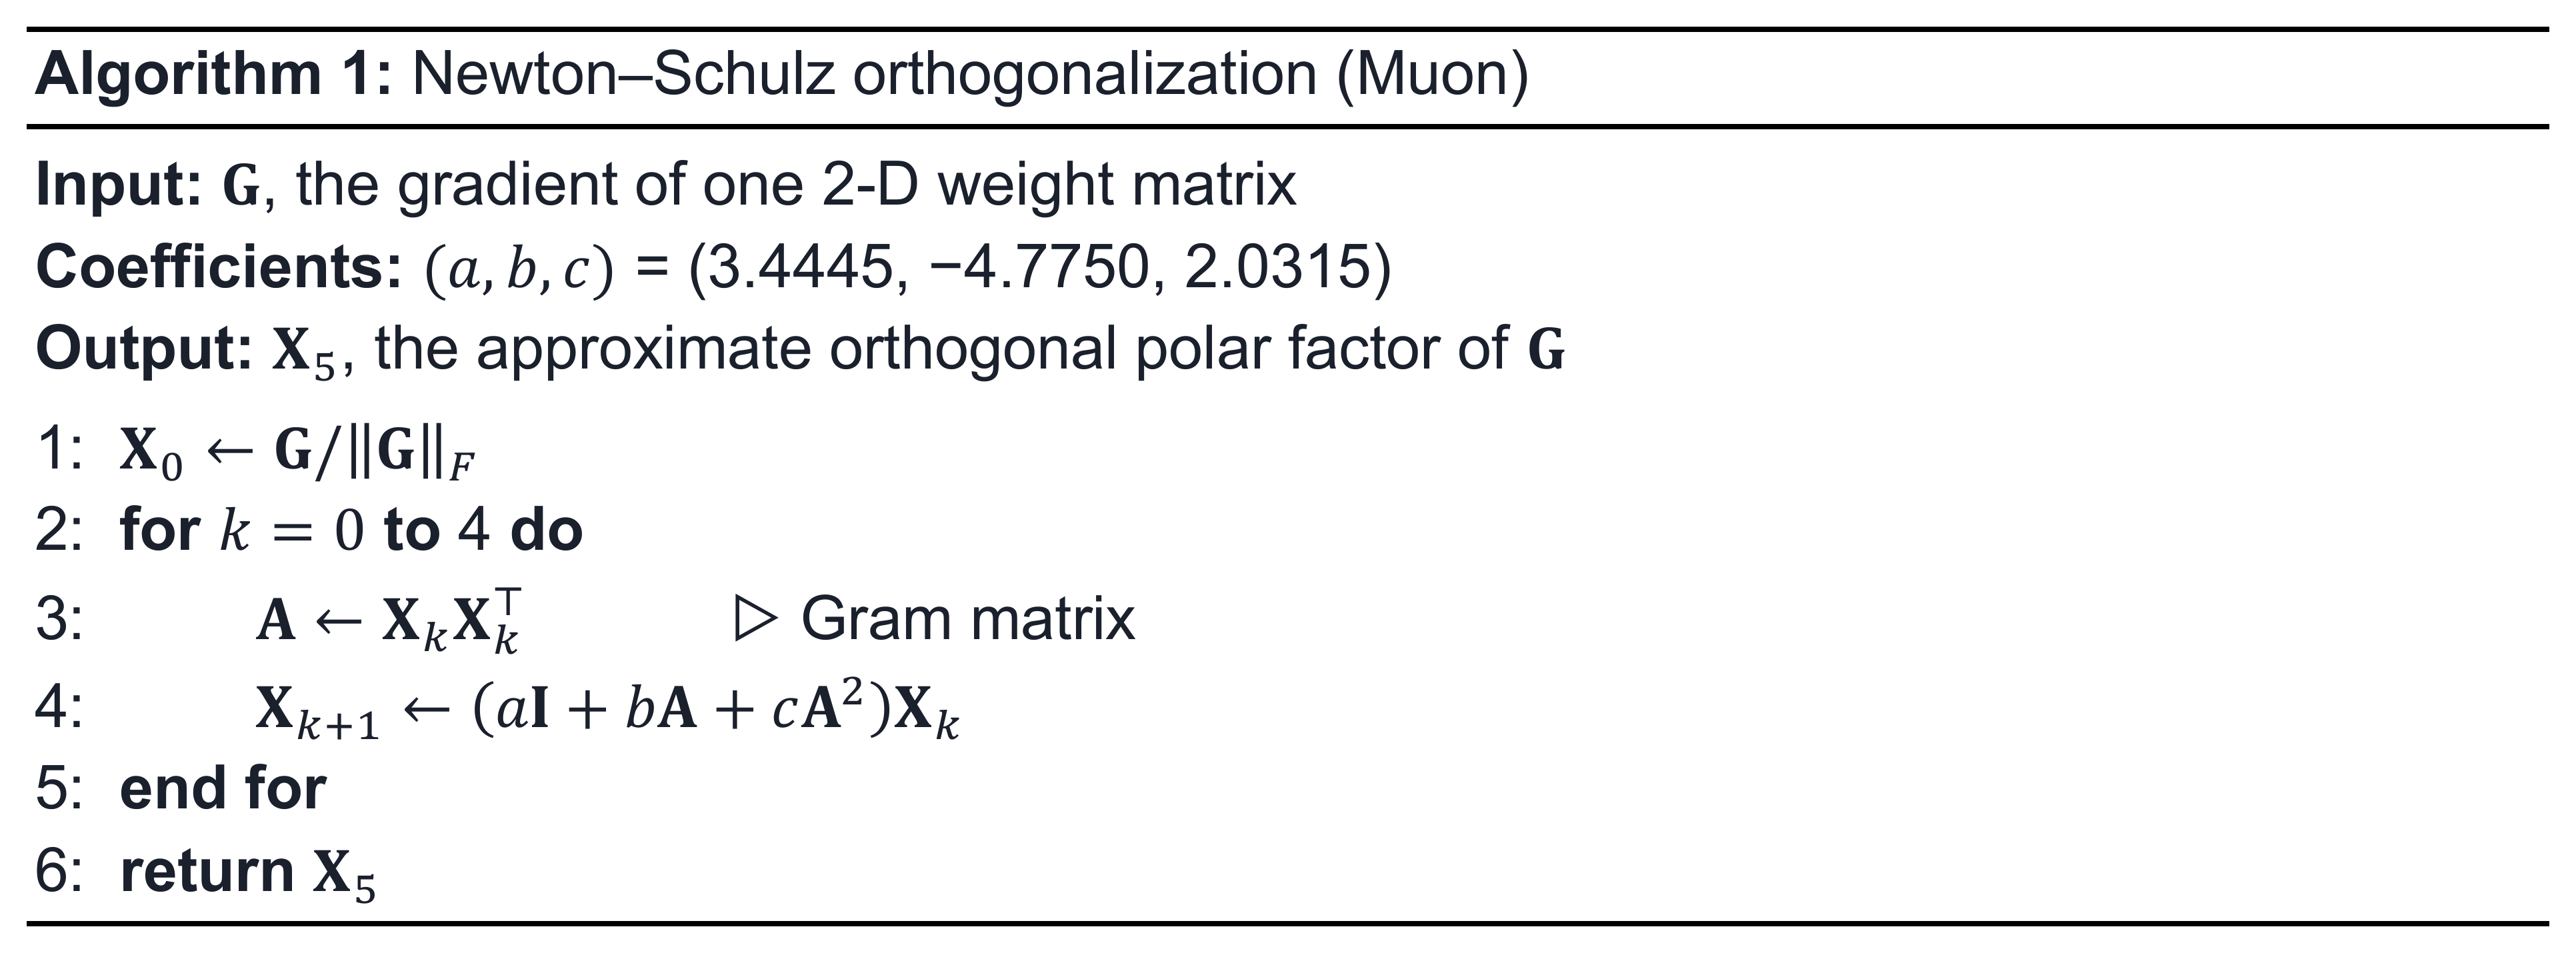
El algoritmo Newton-Schulz
El problema distribuido. La matriz de Gram A = X X correlaciona cada fila del peso con todas las demás filas. En Fully Sharded Data Parallel (FSDP2), cada uno de los 64 rangos contiene solo 1/64 de las filas.
Por lo tanto, una X X local de fragmentos produce solo un bloque diagonal y elimina todos los términos de la partición en forma de cruz (figura 5).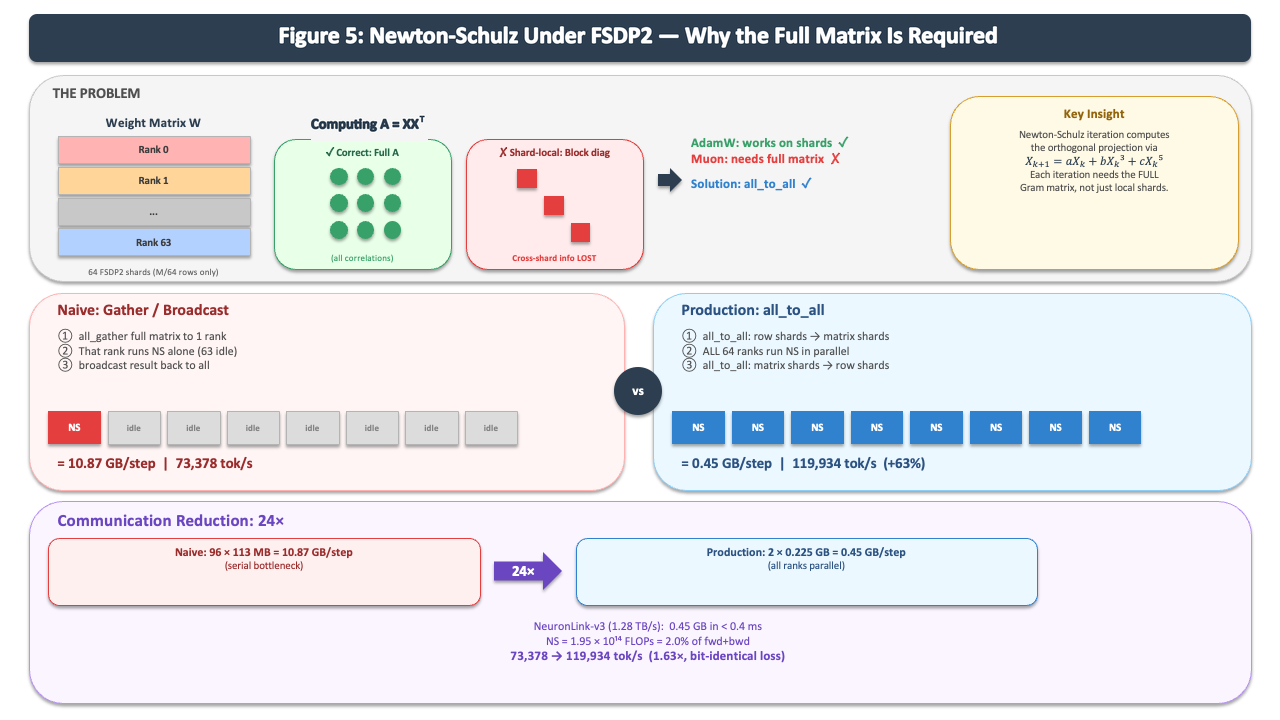
Figura 5: Newton—Schulz bajo la FSDP2: el bloque Gram local y la recopilación/transmisión en comparación con all_to_all.
Enfoque ingenuo: reunir y transmitir. Cada rango reúne el gradiente completo (5,44 GB), un rango usa Newton—Schulz y emite el resultado. Esto mueve 10,87 GB por escalón
mientras los 63 rangos restantes esperan.Enfoque de producción: transposición de todos a todos. En MuonFSDP2, un sistema all_to_all da a cada rango unas cuantas matrices completas, los 64 rangos ejecutan Newton—Schulz en paralelo y un segundo all_to_all devuelve los resultados. El tráfico por rango se reduce a 0,45 GB, 24 veces menos. El rendimiento pasa de 73 378 a 119 934 tokens por segundo, 1,63 veces más, con una curva de pérdidas idéntica a la de los bits
(figura 6).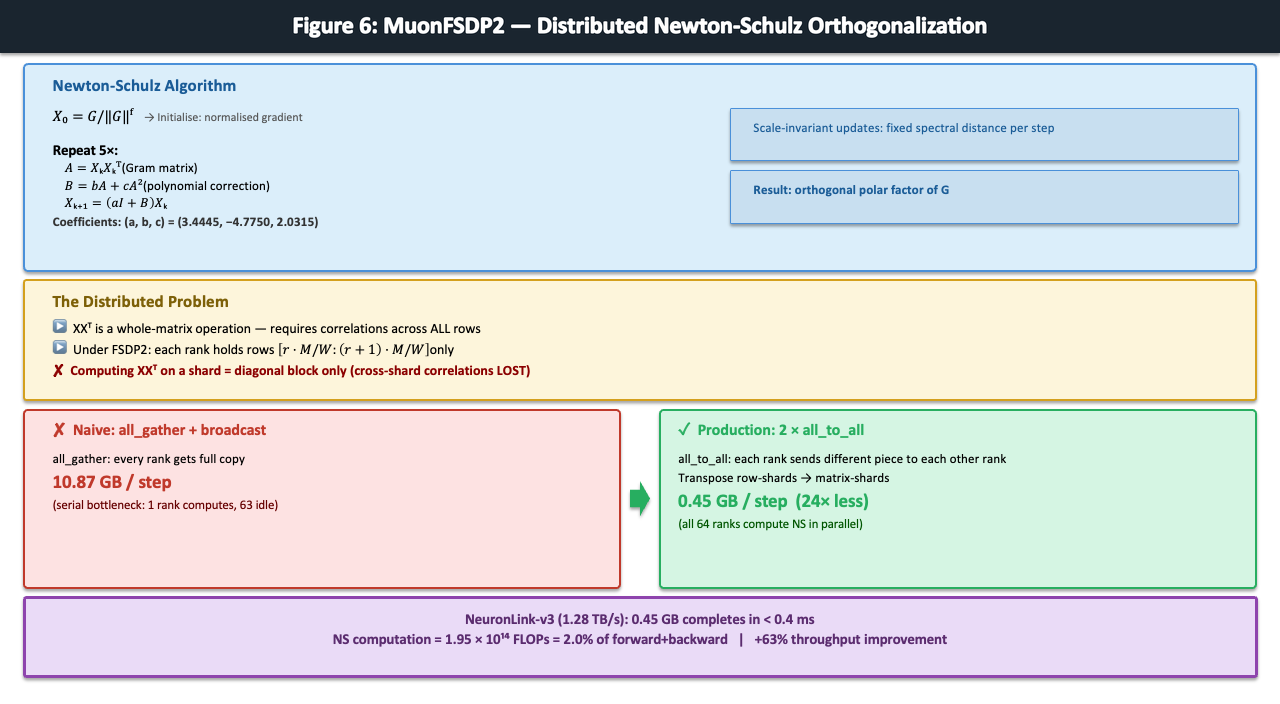
Figura 6: Volumen de comunicación por paso: 10,87 GB con all_gather en comparación con 0,45 GB con all_to_all.
Coste de comunicación. Newton—Schulz representa solo alrededor del 2 por ciento de los FLOP en una etapa de entrenamiento (1,95 × 10 14 de 9,53 × 10 15), por lo que la comunicación fue el obstáculo. Con NeurOnLink-v3 a 1,28 TB/s, el intercambio de 0,45 GB tarda menos
de 0,4 ms en un intervalo de aproximadamente 4,4 segundos.Desafío 3: Se desbloquea el pase hacia atrás para que se repita de forma secuencial
El pase hacia atrás se diferencia entre las 16 actualizaciones de estado secuenciales. En la GPU, Autograd crea este gráfico en tiempo de ejecución. En Trainium2, el compilador debe ver por adelantado todo el gráfico desenrollado de 16 pasos
, lo que crea tres restricciones.La profundidad del gráfico aumenta con el número de fragmentos: con 32 fragmentos (C = 64), el gráfico desborda el planificador. La memoria por fragmento aumenta con el tamaño de los fragmentos: con 8 fragmentos (C = 256), los intermedios se transfieren a HBM. Todas las formas son fijas en el momento del rastreo, por lo que cada intermedio del bucle
necesita su propia asignación estática.Dieciséis fragmentos (C = 128) satisfacen las tres: el desenrollado se ajusta al planificador, los intermedios permanecen en el chip y las fichas se alinean con las 128 particiones SBUF.
Resultados del entrenamiento
El equipo de GenaIIC entrenó a Laplace 3B en una instancia de trn2.48xlarge utilizando los 64 NeuronCores lógicos y la ruta Muon completa. La receta completa consta de 190 735 pasos (100 mil millones de fichas de FineWeb-EDU). Los siguientes resultados corresponden al paso 84 210
, unos 44 mil millones de fichas.Rendimiento. Tras el calentamiento de la compilación, el rendimiento se sitúa en aproximadamente 120 000 fichas por segundo y se mantiene
así hasta el paso 84 210.Estabilidad de pérdidas y gradientes. La pérdida (figura 7a) cae suavemente de aproximadamente 11,4 a 2,3729 en la etapa 84 210. La norma de gradiente (figura 7b) muestra el pico inicial esperado y luego un descenso constante hasta aproximadamente el 0,05, sin picos, divergencias ni valores de NaN/INF posteriores al calentamiento
.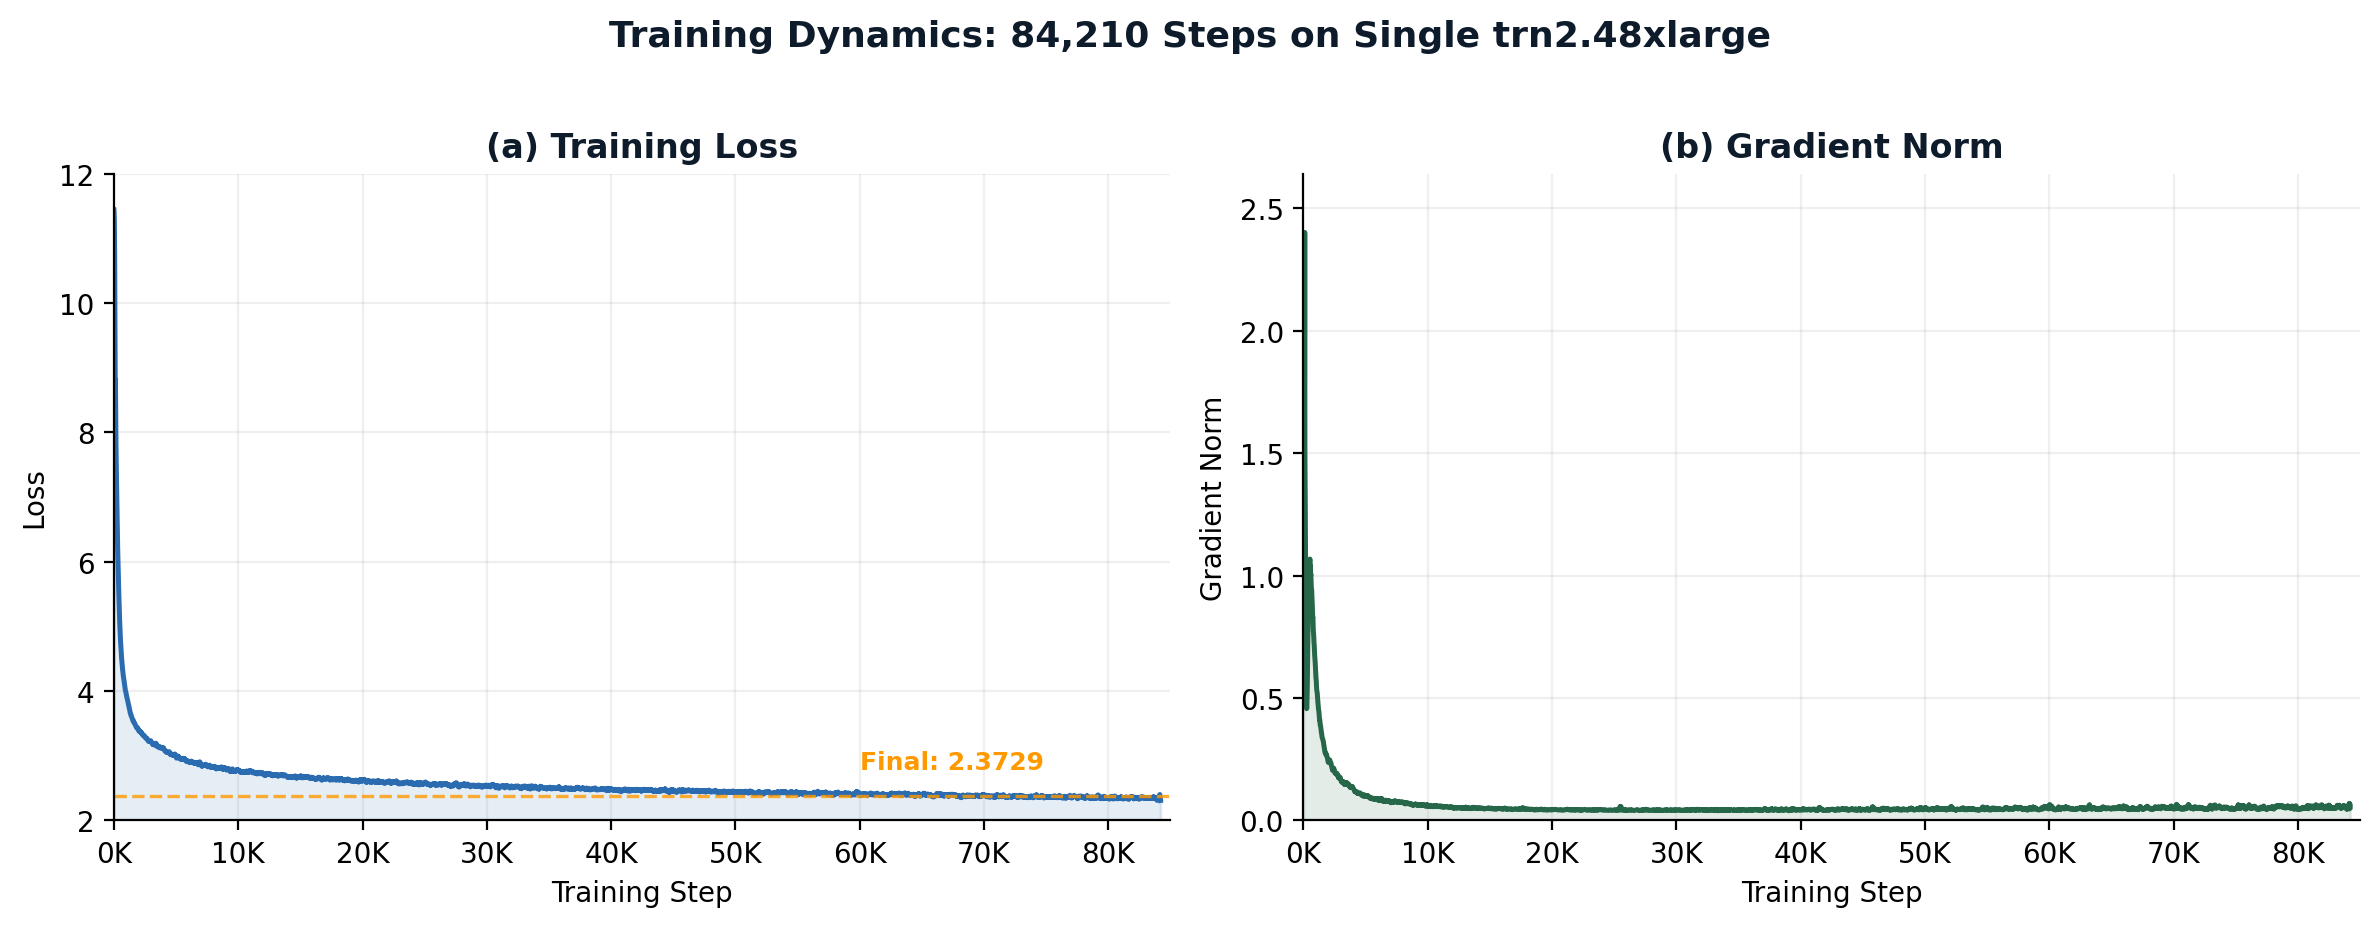
Figura 7: Dinámica de entrenamiento. (a) Pérdida 11.4 → 2.3729. (b) Norma de gradiente a partir
de datos de TensorBoard.Optimización de inferencias en Trainium2
Gracias a un motor vLLM sin modificar, el equipo de GenaIIC distribuyó 11.544 fichas de salida por segundo a 1280 secuencias simultáneas en una instancia de trn2.48xlarge.
Estado de servicio constante. El estado recurrente de 29,5 MB por secuencia es aproximadamente 82 veces más pequeño que el de una caché KV comparable, con 8.192 tokens. Al aumentar el indicador de 2.048 a 8.192 tokens, solo se aumentó un 0,5% el coste por token de salida
.VLLM sin modificar. Un contenedor reemplaza un atributo por capa de decodificación, el mezclador de fichas, para leer y escribir el estado recurrente en el pool de vLLM. Como el modelo se declara libre de atención, vLLM asigna una página fija por secuencia. Los resultados coincidían con el token de referencia del i14 para el token (48/48
pasos en las solicitudes de 3/3 en BF16).Encontrando el cuello de botella.
Un ajuste lineal del tiempo de decodificación con el número de capas L del decodificador da como resultado: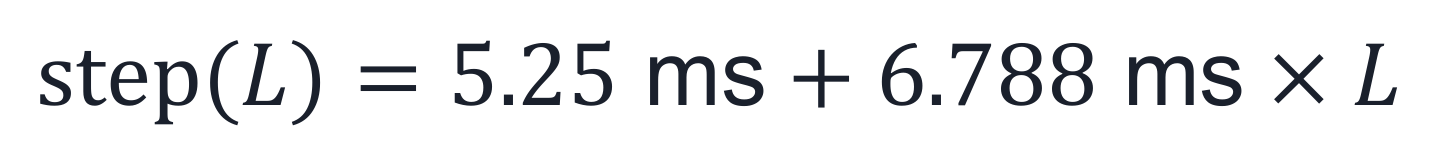
En L = 24, es decir, 168,1 ms por paso, el 96,9 por ciento dentro de las capas del decodificador. Las proyecciones de gran tamaño cuestan 13,27 ms, cerca del límite de 12 ms de streaming de HBM. La mayor parte del tiempo se destinó a pequeños operadores, despachados uno por uno bajo la ávida de PyTorch.
Escalar a una instancia completa. Sin paralelismo tensorial, el rendimiento se amplía a través de réplicas, con un motor y 20 secuencias por NeuronCore lógico. El rendimiento esperado pasó de 133 tokens de salida por segundo en una réplica a 6.772 en 64, donde el uso de la CPU del host alcanzó el 82 por ciento. Al compilar el paso de decodificación, se eliminaron los envíos por operador y se aumentó el rendimiento 1,7 veces, hasta alcanzar los 11 544 (figura 8
).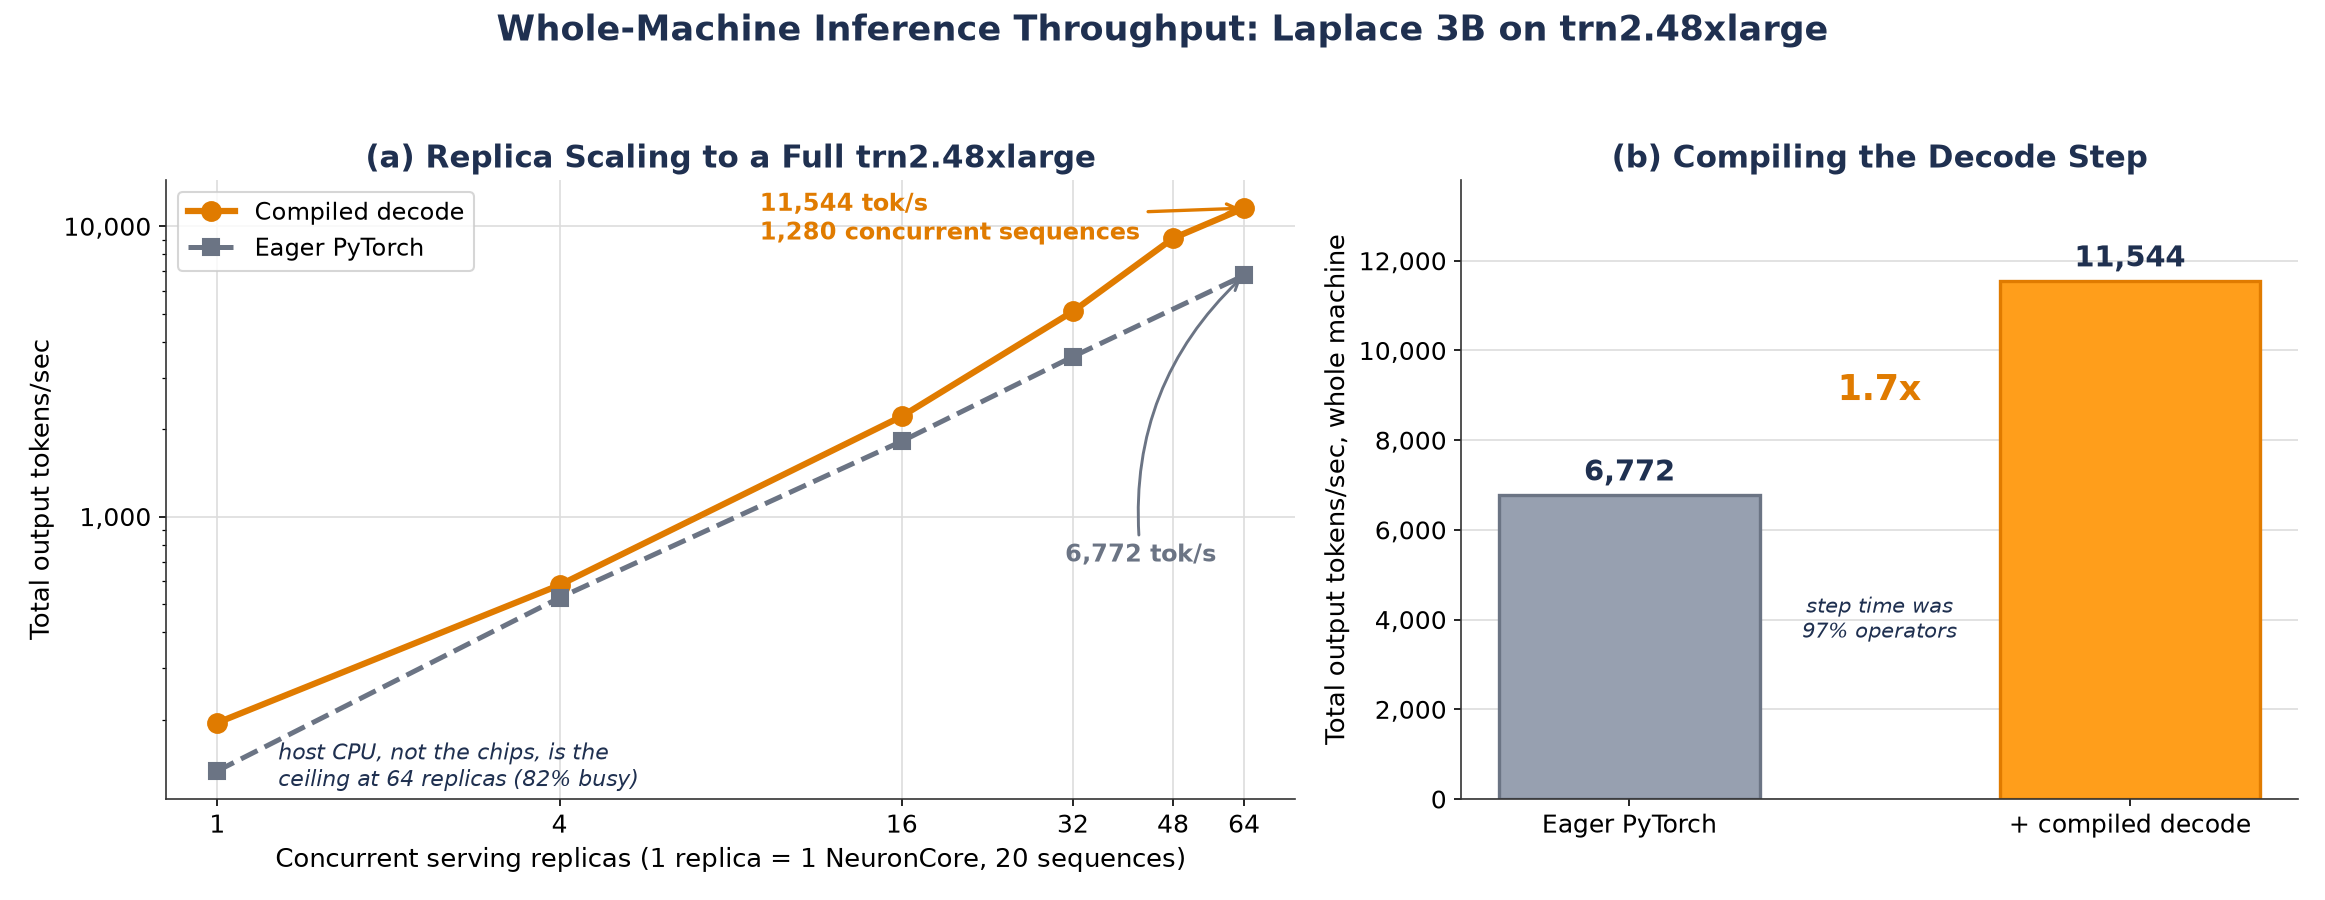
Figura 8: Rendimiento de inferencia de toda la instancia. (a) Escalado de réplicas mediante decodificación compilada y ansiosa. (b) La decodificación compilada aumenta el rendimiento de 6.772 a 11.544 tokens de salida
por segundo.Lo que ocultan los puntos de referencia de lotes fijos. En condiciones de tráfico real, cada nuevo ancho de lote de decodificación es una forma compilada por separado cuyo primer uso cuesta unos 11 segundos. Estos pasos representaron solo el 1,1 por ciento del total, pero consumieron el 47,5 por ciento del tiempo de decodificación. Al utilizar anchuras fijas, se eliminó este coste y se obtuvieron resultados muy exactos. Luego, la decodificación compilada mejoró el rendimiento por réplica 3,52 veces en las llegadas escalonadas, en comparación con 1,46 veces en los lotes fijos. Dado que la reasociación entre BF16 hace que la salida compilada difiera ligeramente de la generada con ansias, utilice la decodificación rápida cuando la reproducibilidad
exacta sea importante.Conclusiones clave
El proyecto produjo lecciones sobre la formación y la inferencia:
- PyTorch nativo puede admitir arquitecturas personalizadas en Trainium2. i14 conservó la arquitectura GLA y usó TorchNeuron Native para la implementación final . El diseño de la comunicación es importante para los optimizadores personalizados.
- El diseño all_to_all de Muon redujo 24 veces el tráfico por rango y aumentó 1,63 veces el rendimiento del entrenamiento.
- El estado fijo hace que la memoria de inferencia sea predecible. Cada secuencia utiliza 29,5 MB, independientemente de la longitud del contexto .
- Perfil antes de compilar. La mayor parte del tiempo de decodificación correspondió al despacho del operador, y no al ancho de banda aritmético o de HBM .
- Compare patrones de llegada realistas. Los lotes fijos ocultaban el costo de compilar nuevas formas para cambiar el ancho de los lotes .
Conclusión
Laplace 3B demuestra que AWS Trainium2 puede admitir arquitecturas de modelos más allá de los transformadores estándar. Con PyTorch nativo, TorchNeuron Native y el AWS Neuron SDK, i14 entrenó y utilizó su modelo basado en GLA,
conservando un estado recurrente fijo. Enel caso de los sistemas de agentes, esto cambia una restricción básica de servicio. Los historiales más largos no requieren un estado mayor por secuencia, lo que puede ayudar a los equipos a retener más contexto y, al mismo tiempo
, a mantener un uso de la memoria predecible.Si el contexto creciente está aumentando los costos de servicio, reduciendo la simultaneidad o limitando la memoria de los agentes, pruebe el i14 o póngase en contacto con su equipo de cuentas de AWS para evaluar Laplace 3B en AWS Trainium2.
Recursos
- Prueba i14
- AWS Trainium y Trainium2
- Documentación del SDK de AWS Neuron
- Soporte nativo de PyTorch en AWS Trainium con TorchNeuron Native
- Transformadores de atención lineales cerrados con formación eficiente en el uso del hardware
- Implementación de referencia del optimizador de muones
- Centro de innovación de IA generativa de AWS