Construya agentes de inteligencia artificial conscientes de la memoria con Agentic Retrieve en la Base de conocimientos administrada Amazon Bedrock
Build memory-aware AI agents with Agentic Retrieve on Amazon Bedrock Managed Knowledge Base
Peng Yang
Los usuarios de una aplicación basada en conocimientos esperan que los recuerde, no solo que busque bien. Hacen preguntas de seguimiento que solo tienen sentido en el contexto de la conversación anterior. Esperan que una respuesta sobre una política o procedimiento refleje lo que le dijeron a la aplicación sobre sí mismos el mes pasado. Y todavía esperan que cada respuesta esté basada en los documentos que están autorizados a leer, con citas. Ya sea que la aplicación sea un asistente de soporte al cliente, un chat de documentos dentro de un producto SaaS o un asistente interno sobre políticas de la empresa, la expectativa es la misma.
Cumplir con esa expectativa es difícil, porque el contexto que agudizaría una búsqueda vive fuera de la base de conocimientos. La ubicación, el rol o el nivel de producto de un usuario a menudo se mencionaron en una conversación no relacionada hace semanas. Para utilizarlo, la aplicación tiene que almacenar cada conversación, extraer hechos duraderos de ella, decidir qué hechos son importantes para la pregunta actual y injectarlos en la solicitud. Cuando muchos usuarios comparten la aplicación, cada uno de esos pasos también tiene que estar aislado por usuario, y lo mismo sucede con cada documento.
Amazon Bedrock Managed Knowledge Base y Amazon Bedrock AgentCore memory, una capacidad de Amazon Bedrock AgentCore, ahora se encargan de esos pasos: almacenar cada conversación, extraer hechos de ella y traer los hechos relevantes a la búsqueda. Activas esto agregando un memoryConfiguration a la solicitud AgenticRetrieveStream, lo que hace que la memoria de AgentCore sea una fuente de recuperación junto con su base de conocimientos. Dentro de la misma llamada, el servicio restaura la conversación y el planificador decide por sí mismo cuándo un hecho sobre el usuario sería útil. Recupera ese hecho de la memoria a largo plazo y lo utiliza para componer las subconsultas que envía a la base de conocimientos. Después de generar la respuesta, el servicio guarda la conversación de nuevo en la memoria. La misma solicitud lleva un userContext, por lo que la base de conocimientos devuelve solo los documentos que las listas de control de acceso (ACL) del usuario permiten. La integración es opt-in y compatible con versiones anteriores. Su aplicación solo mantiene lo que genuinamente es suyo: autenticar al usuario y pasar quién es.
Esta publicación muestra cómo construir un asistente de este tipo para muchos usuarios que comparten una base de conocimientos y un recurso de memoria. Cada usuario solo ve los documentos que puede leer, y la memoria de cada usuario permanece privada. El ejemplo en ejecución es un asistente interno para empleados de AnyCompany, una empresa ficticia. Los empleados iniciaron sesión con Amazon Cognito y hacen preguntas sobre políticas de recursos humanos, guías de TI, libros de ingeniería y planes de ventas. Mostramos cómo leer la identidad del usuario desde el token de ID de Cognito, cómo pasarla a AgenticRetrieveStream para ACLs de documentos y para memoria, cómo diseñar espacios de nombres de memoria para muchos usuarios y cómo leer el registro para ver cuándo el planificador utilizó la memoria. Finalmente, hacemos que AWS Identity and Access Management (IAM) haga cumplir el aislamiento de memoria por usuario incluso cuando el código de la aplicación lo hace incorrectamente. Si implementó la aplicación desde Build multi-tenant agentic chat applications on enterprise data with Amazon Bedrock Managed Knowledge Base, esta publicación reemplaza su paso "persistir el historial de conversación usted mismo".
Visión general de la solución
AnyCompany mantiene sus documentos en Amazon Simple Storage Service (Amazon S3). Una base de conocimientos administrada sincroniza los documentos a través de una fuente de datos de Amazon S3 habilitada para ACL. Un archivo de ACL global en el mismo bucket indica qué empleados pueden leer cada carpeta: todos leen Recursos Humanos y TI, solo los ingenieros leen los libros de ingeniería y solo los vendedores leen el plan de comisiones. Un recurso de memoria de AgentCore es compartido por cada empleado. Amazon Cognito autentica a los empleados, y su token de ID suministra dos reclamaciones: el sub (ID de usuario) identifica la memoria del usuario, y el email verificado identifica al usuario al filtro de ACL de la base de conocimientos. Tres usuarios de prueba se conectan: dos ingenieros, Maya y Liam, y un vendedor, Sofia. Los extractos de registro en esta publicación se tomaron de una ejecución de la aplicación de ejemplo en el repositorio de GitHub.
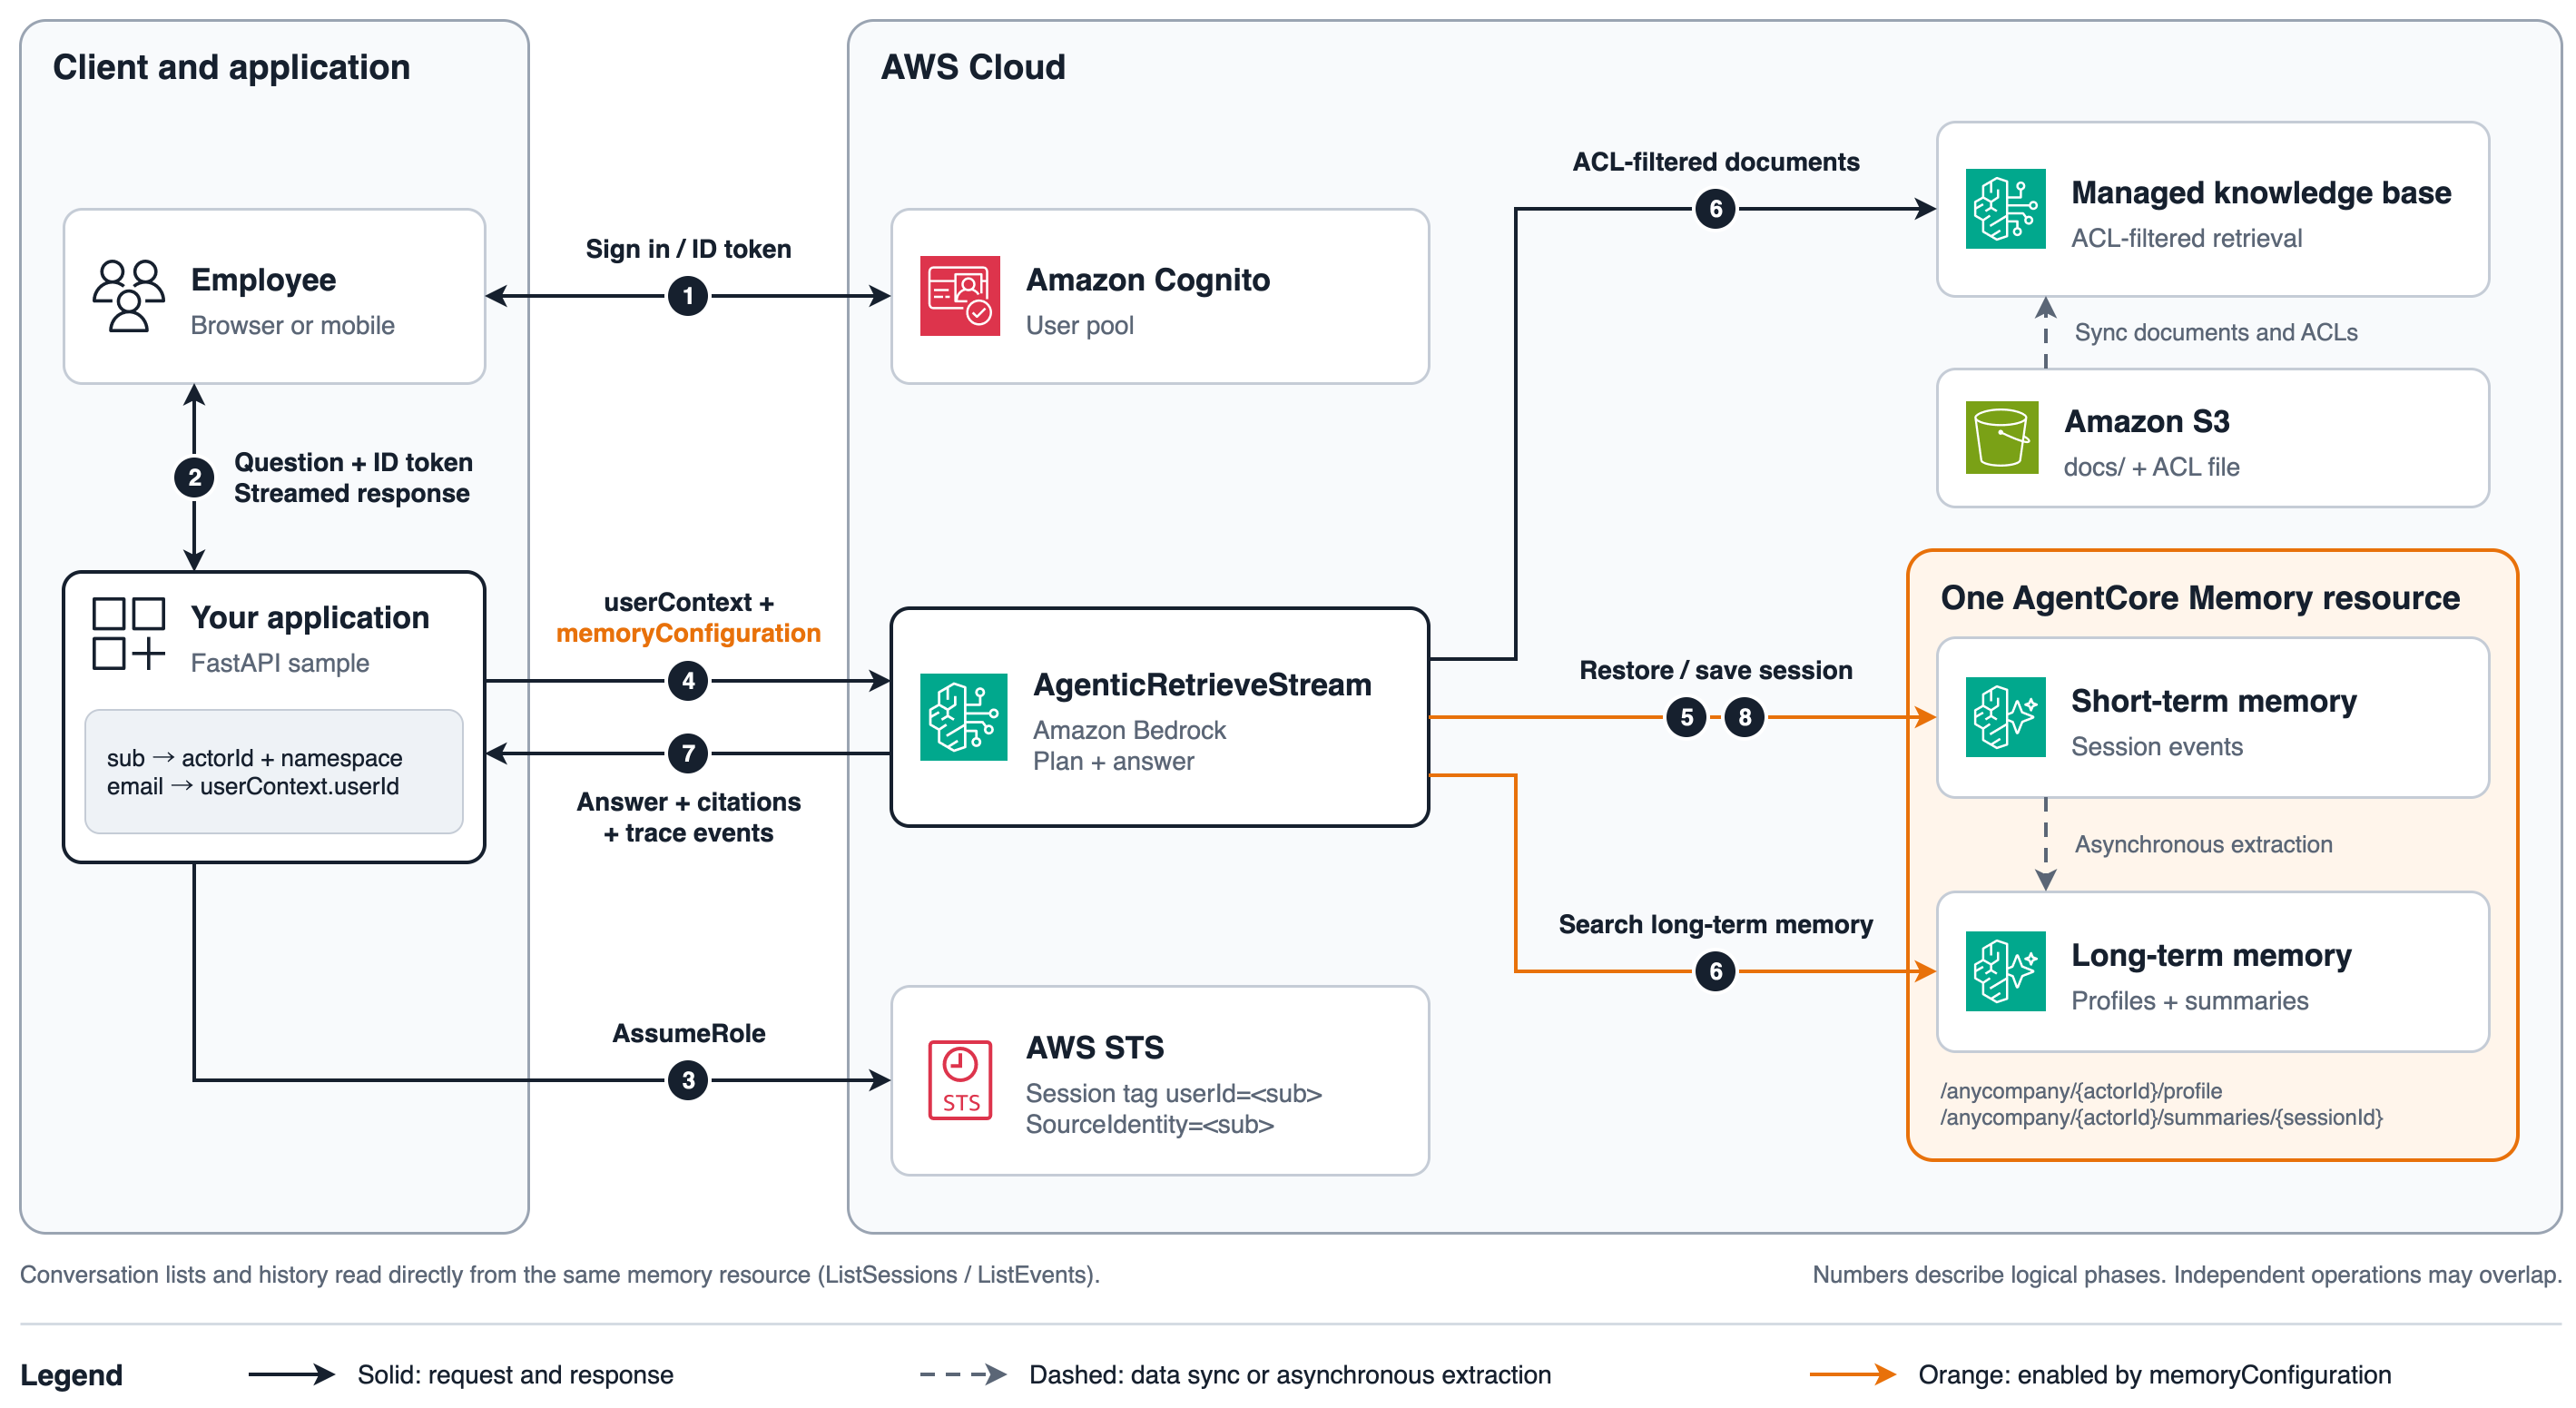
Figura 1: Arquitectura del asistente de empleado con conciencia de memoria. La aplicación autentica al usuario y construye la solicitud (pasos 1–4). Amazon Bedrock Managed Knowledge Base restaura la sesión, recupera información, devuelve una respuesta y guarda el intercambio en la memoria de AgentCore (pasos 5–8). Los eventos de corto plazo y los registros de largo plazo pertenecen al mismo recurso de memoria.
El empleado inicia sesión con Cognito y recibe un token de ID, un token JSON Web (JWT) firmado por el grupo de usuarios.
La API de la aplicación valida el token — un autorizador JWT de Amazon API Gateway en producción, un pequeño servicio FastAPI en la muestra. Las solicitudes no autenticadas no llegan al controlador.
El controlador lee dos reclamaciones del token verificado: sub se convierte en la memoria actorId y espacio de nombres, y email se convierte en el userContext.userId. El cuerpo del cliente solo lleva { question, sessionId? }. Luego, el controlador asume el rol de IAM de la aplicación para este usuario, con la etiqueta de sesión userId=<sub>.
El controlador llama a AgenticRetrieveStream con la base de conocimientos como recuperador, userContext, y un memoryConfiguration vinculado a este usuario.
Managed Knowledge Base restaura el historial de conversación desde la memoria de corto plazo (STM) en la memoria de AgentCore para el actor y la sesión identificados por sessionBinding.
Managed Knowledge Base recupera de la base de conocimientos con filtrado ACL basado en userContext. También puede recuperar la memoria de largo plazo configurada del usuario a través de recuperación especulativa o búsquedas de memoria seleccionadas por el planificador.
Managed Knowledge Base transmite una respuesta citada y eventos de seguimiento de regreso al controlador. El controlador registra los seguimientos con un ID de correlación y reenvía la respuesta y la información de seguimiento a la UI.
Con persistenceMode: DEFAULT, el servicio guarda la pregunta y la respuesta generada en la sesión. La memoria de AgentCore extrae los registros de largo plazo de forma asíncrona según las estrategias configuradas.
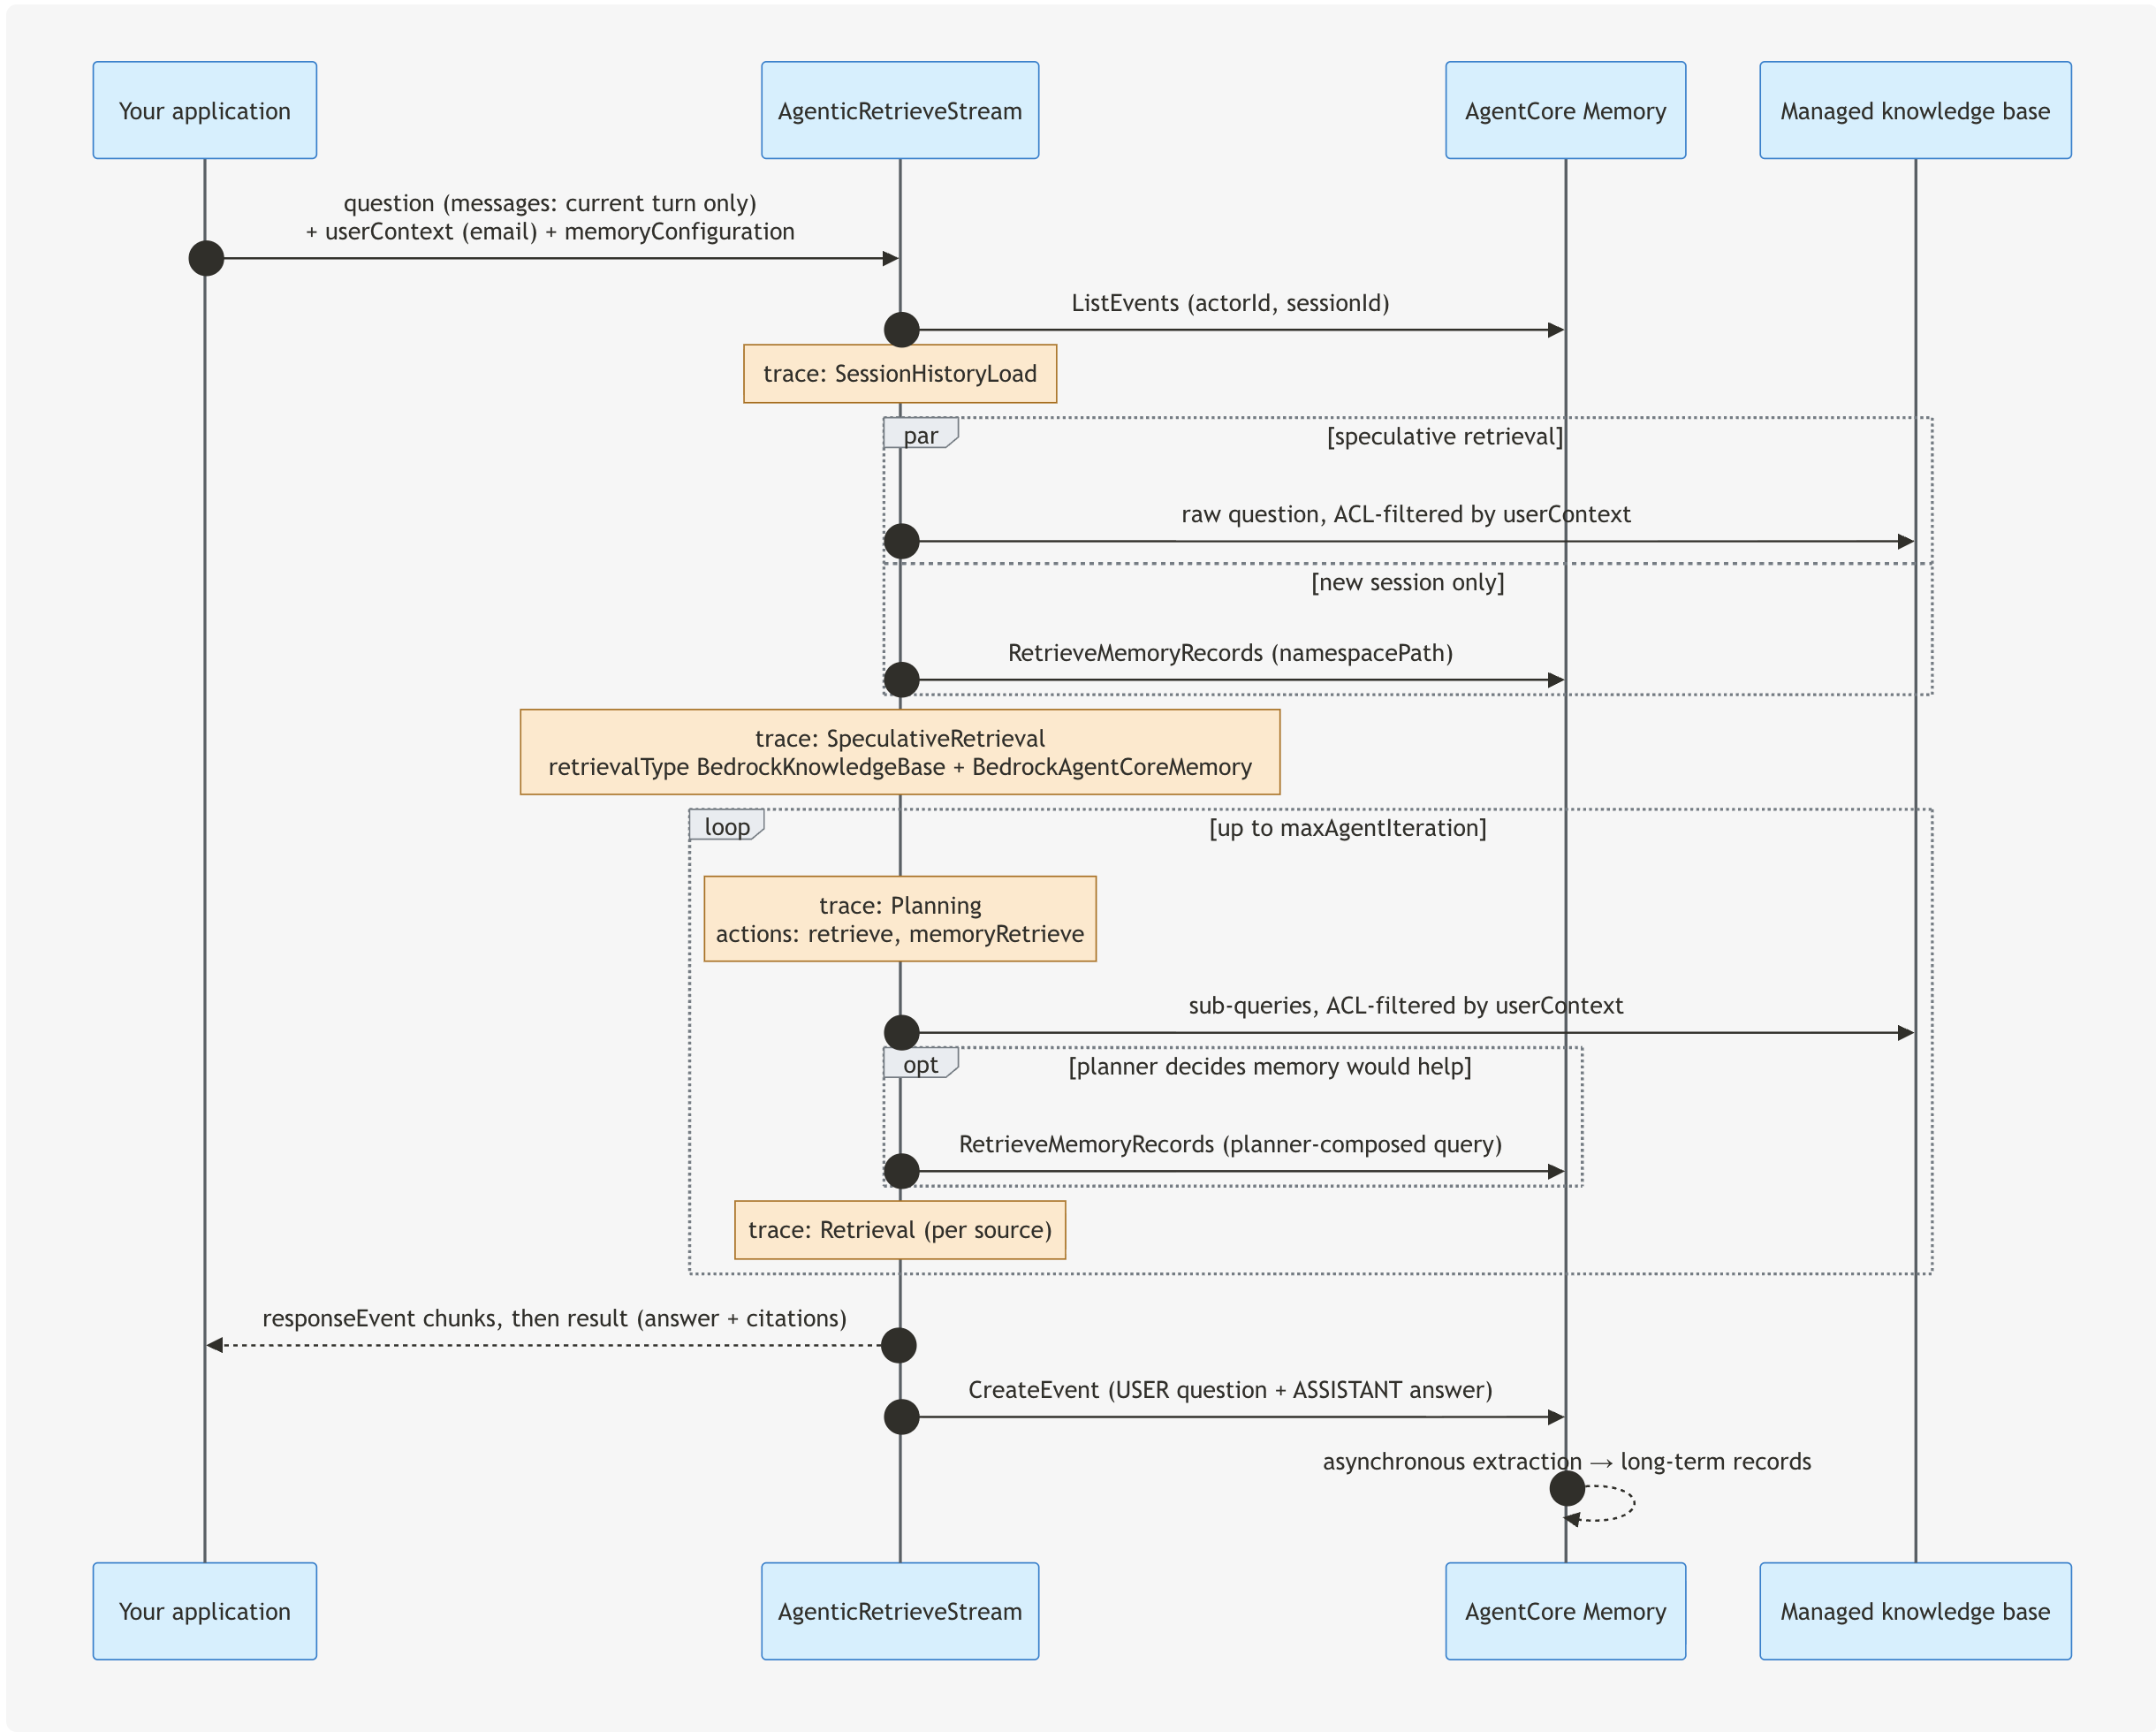
Figura 2: Un AgenticRetrieveStream turno con userContext y memoryConfiguration. Todo lo que está entre la primera y la última flecha es el trabajo del servicio.
La Base de Conocimientos Administrada es propietaria de la ingesta, el filtrado de ACL, el indexado, el ranking, la planificación, la recuperación y la generación. Con memoryConfiguration, también es propietaria de la restauración de sesión, la búsqueda de memoria y la persistencia. La memoria de AgentCore es propietaria del almacenamiento, la retención, el cifrado y la extracción. Su aplicación es propietaria de la autenticación, la interfaz de usuario y la lectura de la identidad del usuario desde el token. No hay una tabla de conversación: cuando la interfaz de usuario lista o vuelve a abrir una conversación, lee el mismo recurso de memoria.
Cómo la identidad se asigna a la solicitud
Cada valor se deriva de la aplicación desde el token de ID verificado. Ninguno proviene del cuerpo de la solicitud.
Campo de solicitud
Derivado de
Qué limita
Asegurado por
userContext.userId
Token de ID email (verificado, inmutable en el grupo)
Qué documentos se pueden recuperar
Filtrado de ACL de la base de conocimientos
memoryConfiguration.sessionBinding.actorId
Token de ID sub
De quién se restaura y escribe la memoria a corto plazo, y el {actorId} en espacios de nombres a largo plazo
Clave de memoria de AgentCore, más una condición de IAM
memoryConfiguration.sessionBinding.sessionId
Generado por la aplicación para una nueva conversación. Enumerado con ListSessions
Qué registros a largo plazo puede buscar el planificador
Condición de IAM
Dos reclamos diferentes realizan dos trabajos diferentes. La base de conocimiento identifica a los usuarios por correo electrónico, porque eso es lo que registra la fuente de datos conectada en sus ACL. La memoria necesita un actorId que nunca cambia y nunca se reutiliza. El sub de Cognito es ambos. Una dirección de correo electrónico se puede cambiar o reasignar a un nuevo empleado después de que alguien se vaya, y esa persona heredaría la memoria antigua. Puedes utilizar otro ID de usuario estable de tu propia tienda de usuarios como el actorId. Lo que importa es que nunca se mueve a una persona diferente.
Requisitos previos
documentación de recuperación de agentic, el recurso de memoria utilizado con esta integración debe estar en la misma cuenta de AWS que la base de conocimiento y en el estado ACTIVE.
Python 3.10 o posterior y Boto3 1.43.72 o posterior.
Permiso para crear un bucket de S3, una piscina de usuarios de Cognito, roles de IAM, una base de conocimiento y un recurso de memoria. El infra/setup.py de la muestra crea todos estos recursos de forma idempotente.
Guía de solución
Los siguientes pasos crean la base de conocimiento y su fuente de datos, configuran el recurso de memoria y Amazon Cognito, construyen la solicitud y leen la traza para confirmar el resultado.
Paso 1: Crear la base de conocimiento con una fuente de datos habilitada para ACL
Una base de conocimiento administrada no necesita un almacén de vectores:
Los documentos viven en el bucket bajo docs/<folder>/. Amazon S3 no tiene un sistema de permisos propio para rastrear, así que proporcionas las ACL en un archivo de ACL global en el mismo bucket. Cada entrada asigna un prefijo de S3 a los correos electrónicos que pueden leerlo:
El archivo de la muestra también da a todos docs/it/. Luego crea la fuente de datos. Para una base de conocimiento administrada, cada conector tiene el tipo MANAGED_KNOWLEDGE_BASE_CONNECTOR, y connectorParameters.type selecciona la fuente:
aclEnabled no se puede cambiar después de que se crea la fuente de datos. CreateDataSource es asíncrono, así que espere el estado AVAILABLE. Luego llame a StartIngestionJob y espere COMPLETE. La sincronización lee los documentos y el archivo ACL e indexa cada documento con su ACL. En el ejemplo, se escanearon y indexaron los 11 documentos con 0 fallos. Un documento que no está cubierto por ninguna entrada de ACL no se ingesta, y un usuario cuyo correo electrónico no coincide con ninguna entrada no recibe resultados de esta fuente de datos.
El mismo modelo se aplica a los conectores que rastrean permisos desde el sistema de origen, como Microsoft SharePoint, Google Drive y Atlassian Confluence. Allí, los permisos provienen de la fuente, los grupos se resuelven desde la fuente y la base de conocimientos también verifica cada resultado contra la fuente en tiempo real. Su código de aplicación no cambia: todavía pasa el correo electrónico del usuario en userContext. Para ver la lista completa, consulte Habilitación de la conciencia de listas de control de acceso.
Paso 2: Crear el recurso de memoria y diseñar espacios de nombres
Un recurso de memoria sirve a todos los usuarios. La separación por usuario proviene de {actorId} en las plantillas de namespace, que AgentCore memoria resuelve desde cada evento en el momento de la extracción. Dos opciones importan.
Estrategias. Las dos estrategias extraen cosas diferentes. La estrategia de resumen resume cada conversación, por lo que captura hechos que un usuario menciona de pasada, como “Estoy en una Mac en la oficina de Frankfurt”. Esos hechos son lo que personalizan una respuesta posterior sobre, por ejemplo, PTO. La estrategia de preferencia del usuario extrae preferencias declaradas en registros estructurados (“Prefiere respuestas en puntos breves sin tablas”, “Siempre implementa en eu-central-1 primero”) y no trata las menciones incidentales como preferencias. Los resúmenes le dan “lo que discutimos”. Las preferencias le dan “cómo esta persona quiere ser respondida”. Utilice ambos.
Disposición. retrievalConfigs acepta una entrada, por lo que una sola namespacePath debe llegar a todo lo que el planificador debe ver para un usuario. Coloque {actorId} directamente debajo de la raíz: namespacePath: "/anycompany/<sub>" luego cubre el perfil y cada resumen de conversación. Una disposición como /anycompany/profile/{actorId} y /anycompany/summaries/{actorId} permitiría que una entrada llegue solo a uno de ellos.
Espere a que la memoria alcance ACTIVE. La creación de la memoria no requiere un usuario o actorId, por lo que el orden del Paso 2 y el Paso 3 no importa. Nada se provisiona por usuario: un nuevo usuario de Cognito se convierte en un nuevo actor la primera vez que hace una pregunta.
Paso 3: Configurar Cognito y otorgar permisos a la aplicación
Crear un grupo de usuarios y un cliente de aplicación sin secreto de cliente. El correo electrónico decide qué documentos puede leer un usuario, así que asegúrese de que sea obligatorio, verificado y no modificable por el usuario:
Mutable no se puede cambiar después de que se crea el grupo. Con un correo electrónico mutable, un usuario conectado podría cambiar su correo electrónico a la dirección de un colega. Si sus usuarios se federan desde Okta o Microsoft Entra ID, asigne el correo electrónico del IdP a este atributo para que coincida con el correo electrónico en las ACL de su fuente de datos.
La muestra habilita USER_PASSWORD_AUTH para que la interfaz de usuario local y las pruebas puedan iniciar sesión directamente. Las aplicaciones de producción suelen utilizar el inicio de sesión administrado por Cognito o AWS Amplify.
Configurar un rol de IAM para la aplicación. El backend asume uno por usuario, con la etiqueta de sesión userId=<sub>, y cada declaración de memoria está condicionada a esa etiqueta. Esta es la política completa con la que se ejecuta la muestra:
ListEvents es obligatorio con sessionBinding, RetrieveMemoryRecords con retrievalConfigs, y CreateEvent cuando persistenceMode es DEFAULT. ListSessions y ListMemoryRecords son para las lecturas propias de la aplicación (lista de conversaciones y la vista "qué sabe la memoria sobre usted"), no para AgenticRetrieveStream. La política de confianza del rol permite sts:AssumeRole, sts:TagSession y sts:SetSourceIdentity desde la identidad propia del backend (un rol de ejecución de AWS Lambda o un rol de tarea de Amazon Elastic Container Service (Amazon ECS) en producción). Si la memoria utiliza una clave administrada por el cliente, agregue kms:Decrypt en esa clave.
Paso 4: Leer al usuario desde el token, luego construir la solicitud
Verificar el token de ID y leer las dos reclamaciones. Solo el token de ID lleva email. El token de acceso no:
@dataclasses.dataclass(frozen=True)
class Principal:
    sub: str     # -> memory actorId and namespace
    email: str   # -> userContext.userId (document ACLs)

    def namespace_path(self, root: str) -> str:
        return f"{root}/{self.sub}"       # resolved literal, e.g. /anycompany/a8e1b390-...


def verify(id_token: str) -> Principal:
    key = jwks.get_signing_key_from_jwt(id_token)   # public keys from {issuer}/.well-known/jwks.json
    claims = jwt.decode(id_token, key.key, algorithms=["RS256"], issuer=ISSUER, audience=CLIENT_ID)
    if claims.get("token_use") != "id" or claims.get("email_verified") is not True:
        raise PermissionError("a verified ID token is required")
    return Principal(sub=claims["sub"], email=claims["email"].lower())
jwt.decode verifica la firma, el emisor (su grupo de usuarios), la fecha de vencimiento y la audiencia (su cliente de aplicación). Para obtener detalles de las reclamaciones, consulte Comprender el token de identidad (ID). Con API Gateway, un autorizador JWT realiza las mismas comprobaciones y pasa las reclamaciones a su controlador.
A continuación, obtener las credenciales de AWS del usuario. El backend asume el rol de la aplicación para este usuario y almacena la sesión en caché hasta poco antes de que expire:
Cada llamada para este usuario, incluyendo las llamadas de memoria que la recuperación agente hace en nombre del llamador, ahora se ejecuta como assumed-role/anycompany-assistant-app-role/user-<sub> y lleva la etiqueta que la política en el Paso 3 verifica.
Decida el sessionId. Para una nueva conversación, la aplicación genera uno, como "conv-" + uuid4().hex, y lo devuelve al cliente. Para continuar una conversación, el cliente lo envía de vuelta. Para mostrar al usuario sus conversaciones, llame a ListSessions con el actorId del usuario:
def list_conversations(principal):
    try:
        resp = memory.list_sessions(memoryId=MEMORY_ID, actorId=principal.sub, maxResults=50)
    except memory.exceptions.ResourceNotFoundException:
        return []   # the user has not asked anything yet, so there is no actor
    return [{"sessionId": s["sessionId"], "createdAt": s["createdAt"].isoformat()} for s in resp["sessionSummaries"]]
No necesita su propia tabla que mapee usuarios a sesiones. Aceptar un sessionId del cliente es seguro porque la memoria a corto plazo está claveada por (memoryId, actorId, sessionId), y el actorId proviene del token. Si Liam envía el sessionId de Maya, nombra una sesión dentro del propio espacio de Liam, que está vacío. La recuperación agente en sí no verifica que el actorId, sessionId o espacio de nombres que proporcione pertenezcan al usuario que está preguntando, por lo que nunca deben provenir del cliente. Mantenga su propia tabla de sesiones solo si necesita datos que la memoria no contenga, como títulos de conversación.
Luego, construya la solicitud:
def build_request(principal, question, session_id):
    return {
        # With sessionBinding, messages carries ONLY the current question.
        "messages": [{"role": "user", "content": {"text": question}}],
        "retrievers": [{"configuration": {"knowledgeBase": {"knowledgeBaseId": KB_ID}},
                        "description": KB_DESCRIPTION}],
        # Document ACLs: only documents this email may read are retrieved.
        "userContext": {"userId": principal.email},
        "agenticRetrieveConfiguration": {
            "foundationModelType": "MANAGED",
            "rerankingModelType": "MANAGED",
            "maxAgentIteration": 3,
        },
        "generateResponse": True,
        "memoryConfiguration": {
            "memoryId": MEMORY_ID,
            "sessionBinding": {"actorId": principal.sub, "sessionId": session_id},
            "persistenceMode": "DEFAULT",
            "retrievalConfigs": [{"namespacePath": principal.namespace_path("/anycompany")}],
        },
    }
Sin userContext, un origen de datos habilitado para ACL no devuelve resultados en absoluto. Compare la solicitud con el controlador sin estado que reemplaza:
La consulta antes de la llamada y la escritura después de ella han desaparecido, y messages tiene un elemento. Tres reglas vienen con sessionBinding, y cada una se aplica con un ValidationException específico. Primero, messages solo lleva la pregunta actual, por lo que elige una fuente de historial por solicitud. Segundo, persistenceMode: DEFAULT (el predeterminado) escribe la pregunta y la respuesta generada como un solo evento, por lo que requiere generateResponse: true. Tercero, memoryId solo es inválido. persistenceMode: NONE restaura el historial y no escribe nada, para vistas de auditoría o reproducción.
Paso 5: Actualice el contrato del cliente y renderice el historial
El cliente envía { question, sessionId? }. En una nueva conversación, la aplicación genera un sessionId y lo devuelve como el primer marco transmitido. El cliente lo repite en giros posteriores y lo omite para empezar de nuevo.
Como el recurso de memoria es suyo, la aplicación lo lee directamente para renderizar una conversación:
def conversation_history(principal, session_id):
    resp = memory.list_events(memoryId=MEMORY_ID, actorId=principal.sub, sessionId=session_id,
                              includePayloads=True, maxResults=100)
    return [{"role": p["conversational"]["role"].lower(), "text": p["conversational"]["content"]["text"]}
            for ev in sorted(resp["events"], key=lambda e: e["eventTimestamp"])
            for p in ev["payload"] if "conversational" in p]
Cada turno persistente es exactamente un evento con dos cargas útiles: la pregunta del usuario y la respuesta final. Por lo tanto, el historial se renderiza como una transcripción limpia y sigue siendo utilizable por otros clientes de memoria de AgentCore.
Paso 6: Verifique desde la traza
La traza le dice, por turno, qué hicieron la base de conocimiento y la memoria:
Evento de seguimiento
Cuándo aparece
Qué examinar
SessionHistoryLoad
Primer evento, siempre que sessionBinding esté establecido
_memory_event_count y _memory_message_count, ambos 0 en una nueva sesión
SpeculativeRetrieval
Antes de la planificación
En una nueva sesión, retrievalMetadata también enumera BedrockAgentCoreMemory. Los elementos de memoria llevan metadatos _memory_* y no texto. Los elementos de la base de conocimiento llevan _source_uri
Planning
Cada iteración
actions[].memoryRetrieve significa que el planificador eligió buscar en la memoria, con una consulta que compuso
Retrieval con retrievalType: BedrockAgentCoreMemory
Por acción de memoria planificada
_memory_record_count. Un recuento de 0 es un resultado normal
Un evento de memoria con status: FAILED
Memoria no disponible o acceso denegado
failures[].message. La memoria es de mejor esfuerzo: la solicitud continúa y la respuesta se genera desde la base de conocimiento
Las siguientes ejecuciones muestran el comportamiento. Los extractos son textuales, recortados para longitud.
ACLs de documento: Maya y Sofia, misma pregunta. “¿Cuál es la asignación semanal de llamada?” La guía de llamada está en docs/engineering/. La recuperación de Maya incluyó docs/engineering/oncall.md, y la respuesta fue “500 USD o 450 EUR por semana”. La recuperación especulativa de Sofia y la subconsulta de seguimiento del planificador solo devolvieron fragmentos de RRHH y ventas:
Su respuesta dijo que no hay asignación de llamada documentada en las fuentes a las que puede acceder. La aplicación no tomó ninguna decisión de acceso. Pasó userContext.userId: "sofia@example.com", y la base de conocimiento hizo el filtrado. Lo contrario es válido para el plan de comisiones: Sofia obtiene el acelerador del 12% y la recuperación de Maya no contiene docs/sales/.
Torneo 1: Maya, conversación nueva. “¿Cómo configuro la VPN en mi laptop? Estoy en una Mac en la oficina de Frankfurt”.
La respuesta da la puerta de enlace de Frankfurt (vpn-fra.anycompany.example) y los pasos de macOS. Después, ListEvents en la sesión muestra un evento con dos cargas.
Torneo 2: Maya, misma conversación. “Se desconecta cada pocos minutos. ¿Qué debo intentar?” La solicitud solo llevaba esa oración:
El planificador envió retrieve("VPN disconnects every few minutes troubleshooting") y retrieve("Cisco Secure Client macOS frequent disconnect fix"). La respuesta resolvió “eso” y señaló iCloud Private Relay, la causa específica de macOS en la guía. En una sesión continuada, SpeculativeRetrieval solo consulta la base de conocimientos. La búsqueda de memoria a largo plazo en ese paso ocurre en nuevas sesiones.
Turno 3: Maya, una nueva conversación, más tarde. “¿Cuántos días de PTO obtengo por año y se llevan los días no utilizados?” Su oficina decide la respuesta, y ella nunca la mencionó en esta conversación. La recuperación especulativa buscó en la memoria a largo plazo con la pregunta cruda y encontró un registro:
{"step": "SpeculativeRetrieval",
 "retrievalMetadata": [{"identifier": "JQUFTMTNZV", "retrievalType": "BedrockKnowledgeBase"},
                       {"identifier": "anycompany_assistant_memory-5llXYu8f2i", "retrievalType": "BedrockAgentCoreMemory"}],
 "retrievalResponse": [
   {"content": {"mimeType": "text/plain", "text": "# AnyCompany Paid Time Off (PTO) Policy ..."},
    "metadata": {"_document_title": "pto-policy.md", "_data_source_type": "S3",
                 "_source_uri": "https://.../docs/hr/pto-policy.md"},
    "sourceRetriever": {"identifier": "JQUFTMTNZV"}},
   {"content": {"mimeType": "text/plain"},
    "metadata": {"_memory_strategy_id": "ConversationSummaries-JFDHQVB4VU",
                 "_memory_query": "How many days of PTO do I get per year, and do unused days carry over?",
                 "_memory_namespace_path": "/anycompany/a8e1b390-10f1-70d9-ee85-b68b610ee0c4",
                 "_memory_record_count": 1},
    "sourceRetriever": {"identifier": "anycompany_assistant_memory-5llXYu8f2i"}}]}
Los elementos de la base de conocimientos y la memoria comparten un retrievalResponse. Distinguirlos por sourceRetriever.identifier o por las claves _memory_*. El registro fue el resumen de su conversación sobre VPN. Eso fue suficiente: el planificador fue directamente a la respuesta, que decía “Dado que su memoria indica que está basado en la oficina de Frankfurt... obtiene 30 días de PTO por año, otorgados en su totalidad el 1 de enero, y los días no utilizados deben usarse antes del 31 de marzo del año siguiente”. Un hecho de una conversación de IT personalizó una respuesta de RRHH.
Turno 4: Liam, nueva conversación, pregunta idéntica. Same handler, misma recurso de memoria, un token diferente. La recuperación especulativa no encontró nada sobre él, así que el planificador decidió buscar en la memoria con su propia consulta:
Liam recibió la tabla de las tres oficinas y una solicitud para decir a cuál pertenece. La aplicación elige dónde el planificador puede buscar. El planificador decide si buscar y qué preguntar: una acción memoryRetrieve aparece solo cuando el planificador decide que otra búsqueda de memoria ayudaría. Leer la sessionId de Maya a través del endpoint de historia con el token de Liam devolvió una lista vacía.
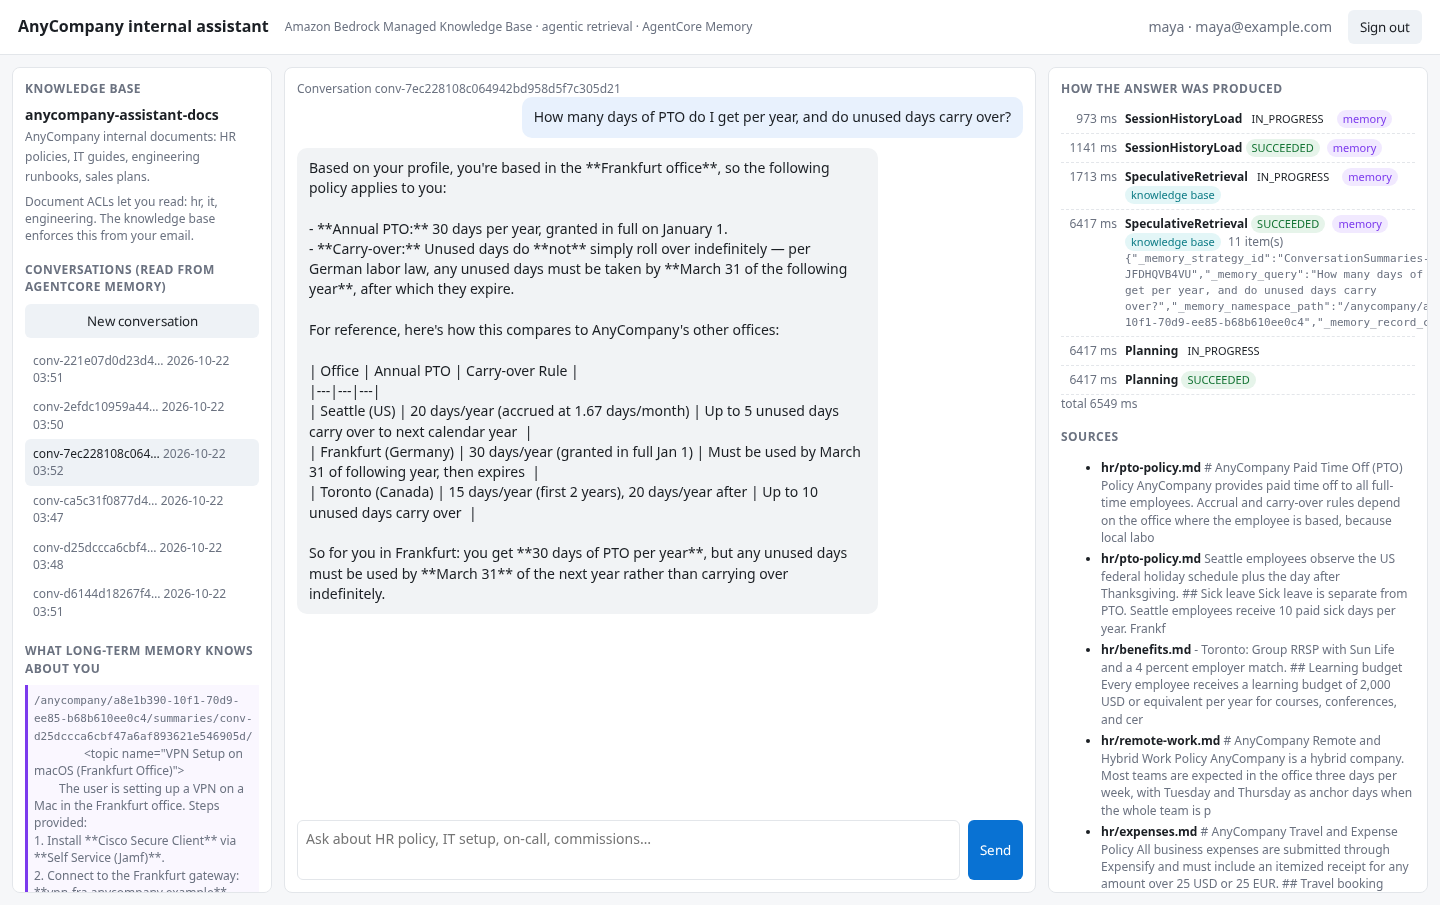
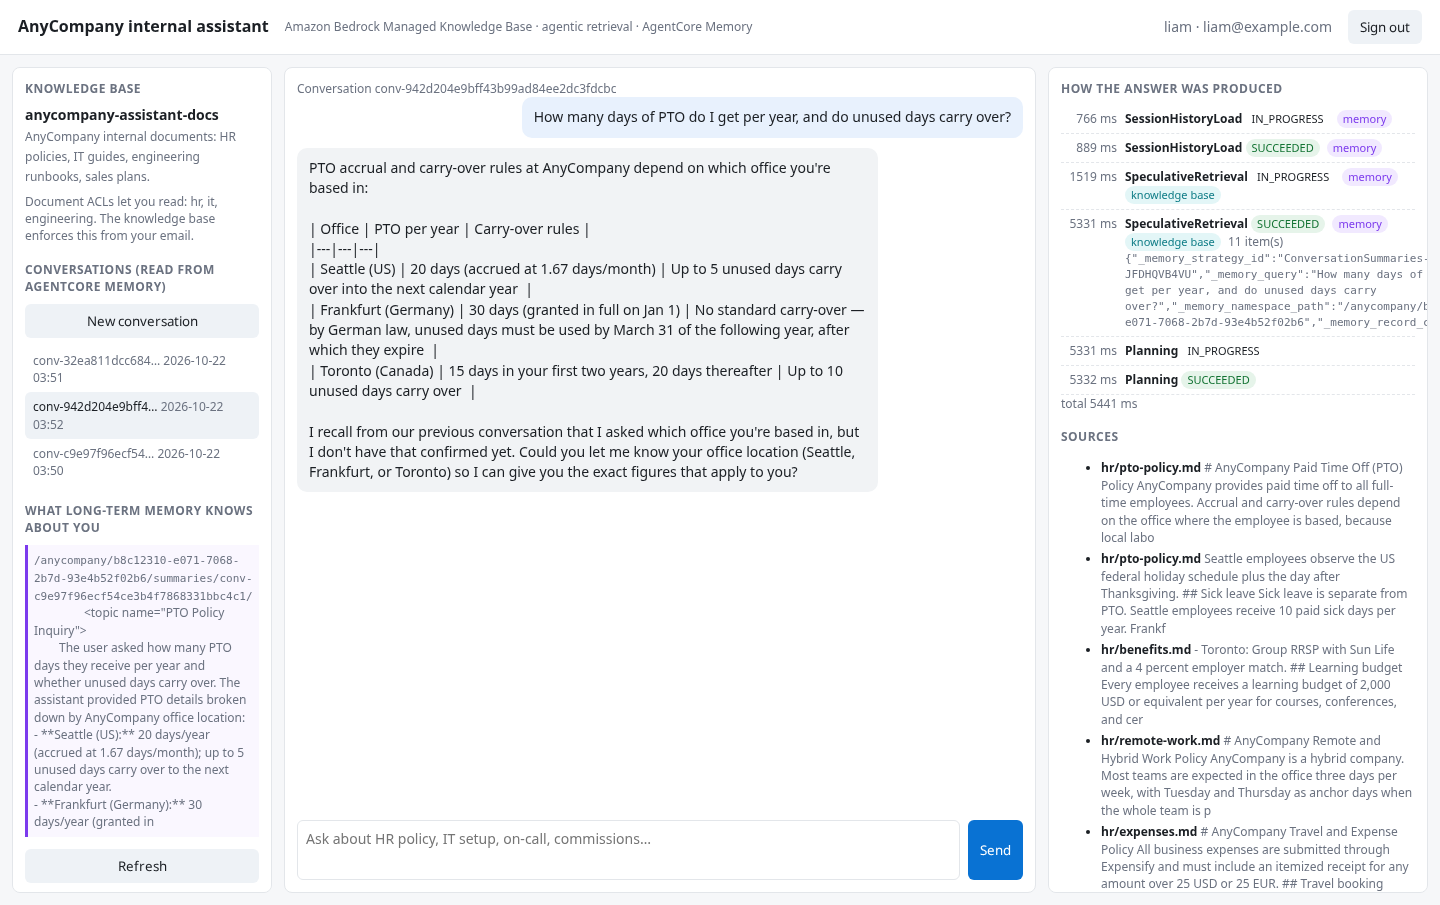
Figura 3: La misma pregunta de dos usuarios. La traza de Maya muestra un acierto de memoria y una respuesta específica de Frankfurt. La traza de Liam muestra cero registros de memoria y la tabla genérica.
La extracción a largo plazo es asíncrona y se ejecuta después de que se persista el turno. En nuestra ejecución, el primer registro apareció 81 segundos después del turno 2, pero el tiempo no es un compromiso. Diseñe para la disponibilidad eventual. Un hecho establecido en esta conversación no está garantizado para ser recuperable en la siguiente de inmediato. La muestra de sondeos ListMemoryRecords antes de ejecutar el turno 3.
Seguridad y aislamiento multiusuario
En este recorrido, la aplicación autentica. La base de conocimientos filtra. La recuperación consciente de ACL es filtrado, no autorización. Tome el correo electrónico solo de un token de ID verificado con email_verified: true, hágalo inmutable en el grupo y maneje el reuso de correo electrónico: si una dirección se reasigna a una persona diferente, esa persona obtiene el acceso al documento del antiguo propietario. La base de conocimientos falla cerrada: un documento sin ACL, o un error de ACL, significa menos resultados, no más. Si faltan resultados, verifique que el correo electrónico coincida con la entrada de ACL.
La identidad proviene del token (Paso 4) para la memoria también: actorId y el espacio de nombres provienen del token de sub verificado, nunca del cliente.
Claves de condición de IAM, como defensa en profundidad. La memoria de AgentCore expone bedrock-agentcore:actorId en ListEvents, CreateEvent y ListSessions, y bedrock-agentcore:namespacePath en RetrieveMemoryRecords y ListMemoryRecords. Las llamadas a memoria que realiza la recuperación agente durante una solicitud están autorizadas contra la identidad de llamada. Es por eso que la política del llamador debe conceder esas acciones, y por eso las condiciones en el Paso 3 se aplican a ellas. Con la sesión asumida para Maya, una solicitud vinculada a la actorId de Maya procede con normalidad. Una solicitud que vincula la actorId de Liam es el error que esta política protege contra, y es denegada en cada operación de memoria:
SessionHistoryLoad/FAILED      failures: ["AccessDeniedException"]
SpeculativeRetrieval/SUCCEEDED failures: ["AccessDeniedException"]   # memory leg denied, KB leg answered
Nada se escribió en la memoria de Liam: su recuento de sesión se mantuvo en 0. La respuesta todavía se generó a partir de la base de conocimientos. Debido a que cada usuario tiene su propia sesión de rol, AWS también ve a qué usuario se dirige cada llamada: el llamador es assumed-role/anycompany-assistant-app-role/user-<sub> con SourceIdentity=<sub>, que el titular de la sesión no puede cambiar.
Dos puntos adicionales. La memoria es un recurso propiedad del cliente que otros sistemas en su cuenta también pueden escribir. Trate su contenido como entrada y adjunte una barrera de guardia de Amazon Bedrock a la solicitud a través de policyConfiguration. Y planifique el ciclo de vida de los datos. Los eventos sin procesar caducan según eventExpiryDuration, pero los registros extraídos no. Un flujo de trabajo de eliminación de usuario cubre por lo tanto DeleteEvent para las sesiones del actor y DeleteMemoryRecord bajo el espacio de nombres del actor.
Observabilidad y comportamiento de falla
Registre la traza completa con un ID de correlación por turno. Las subconsultas del planificador son tan dignas de auditoría como sus resultados finales. AWS/Bedrock/KnowledgeBases informa Invocations, ClientErrors, y TotalIterationCount para Operation=AgenticRetrieveStream. AWS/Bedrock-AgentCore informa Invocations, Latency, Errors, y UserErrors por operación de memoria, y InputTokenUsage/OutputTokenUsage por estrategia de extracción. Con Amazon CloudWatch Transaction Search habilitado, AgentCore Observability, una capacidad de Amazon Bedrock AgentCore, muestra las trazas de un turno de principio a fin.
Las operaciones de memoria son de mejor esfuerzo por diseño. Si una llamada a memoria falla o es denegada, la solicitud no falla. La traza lleva un evento de memoria FAILED con el mensaje de falla, y el turno continúa sin esa memoria. La respuesta se genera desde la base de conocimiento. Decida si su UI muestra ese estado degradado.
Consideraciones
Utilice un sessionId estable durante la vida de una conversación. La API acepta un ID fresco por solicitud, pero un ID fresco rompe silenciosamente la continuidad y produce un registro de resumen por turno.
Utilice namespacePath para acceder a todos los registros a largo plazo de un usuario. retrievalConfigs acepta una entrada con hasta cinco metadataFilters. namespace coincide por prefijo y namespacePath coincide por jerarquía, por lo que namespacePath se ajusta a los IDs por usuario bajo la raíz. Proporcione espacios de nombres completamente resueltos, porque una plantilla como /anycompany/{actorId} es rechazada.
Espere que solo se restauren los eventos de conversación USER y ASSISTANT. Los eventos con el rol TOOL o OTHER que otros sistemas escriben se omiten.
Continúe enviando messages en lugar de sessionBinding cuando su aplicación necesite controlar exactamente qué historia lleva cada solicitud. Por ejemplo, su tienda de historia existente puede ser el sistema de registro para conversaciones, o puede editar o tachar la historia antes de enviarla. Con sessionBinding, el servicio restaura y persiste la conversación por usted. No puede combinar los dos en una solicitud.
Una solicitud puede llevar hasta cinco bases de conocimiento. Con más de un recuperador, el planificador enruta cada subconsulta según la base de conocimiento description, así que escríbala con cuidado.
Planee la latencia y el costo. La restauración de la sesión agrega del orden de 200 milisegundos. En nuestras ejecuciones, un turno completo con una base de conocimiento, ACL y memoria tomó 4-10 segundos con el modelo administrado. Las iteraciones de planificación impulsan ese tiempo, no la memoria. Estas son cifras observadas, no compromisos de servicio. La recuperación agente se factura por llamada más recuperaciones subyacentes, y las operaciones de memoria realizadas durante la llamada se facturan como uso de memoria de AgentCore. Para obtener más detalles, consulte precios de Amazon Bedrock y precios de Amazon Bedrock AgentCore.
Limpieza
Ejecute python infra/teardown.py en la muestra para eliminar la base de conocimiento, el bucket de S3 y sus objetos, el recurso de memoria (incluida la historia de conversación y los registros a largo plazo), la piscina de usuarios de Cognito y los roles de IAM.
Conclusión
Amazon Bedrock Managed Knowledge Base ya le dio la pila de recuperación como servicio. Esa pila cubre la ingesta, los ACL de documento, el indexado, el ranking y el bucle de planificación en AgenticRetrieveStream que convierte una pregunta difícil en una respuesta citada. Con memoryConfiguration, la misma llamada ahora lleva la conversación y el historial del usuario. Para una aplicación multiusuario, eso eliminó la tienda de conversación, la reproducción de historial y la pipeline de extracción. Lo que quedó fue una breve lista de responsabilidades. Autenticar al usuario y leer dos reclamaciones del token de ID: pasar el correo electrónico verificado como userContext para que la base de conocimientos filtre los documentos, y usar el sub como el actorId para un recurso de memoria con espacios de nombres con raíz {actorId}. Usar claves de condición de IAM en una sesión de rol por usuario como segunda línea de defensa que se mantiene a lo largo del camino agente.
Users of a knowledge-grounded application expect it to remember them, not only to search well. They ask follow-up questions that make sense only in the context of the previous turn. They expect an answer about a policy or a procedure to reflect what they told the application about themselves last month. And they still expect every answer to be grounded in the documents they are allowed to read, with citations. Whether the application is a customer support assistant, a document chat inside a SaaS product, or an internal assistant over company policies, the expectation is the same.
Meeting that expectation is hard, because the context that would sharpen a search lives outside the knowledge base. A user’s location, role, or product tier was often mentioned in an unrelated conversation weeks ago. To use it, the application has to store every conversation, extract durable facts from it, decide which facts matter for the current question, and inject them into the request. When many users share the application, every one of those steps also has to be isolated per user, and so does every document.
Amazon Bedrock Managed Knowledge Base and Amazon Bedrock AgentCore memory, a capability of Amazon Bedrock AgentCore, now take over these steps: storing each conversation, extracting facts from it, and bringing the relevant facts into the search. You turn this on by adding a memoryConfiguration to the AgenticRetrieveStream request, which makes AgentCore memory a retrieval source alongside your knowledge base. Within the same call, the service restores the conversation, and the planner decides on its own when a fact about the user would help. It retrieves that fact from long-term memory and uses it to compose the sub-queries it sends to the knowledge base. After generating the answer, the service saves the turn back to memory. The same request carries a userContext, so the knowledge base returns only the documents that the user’s access control lists (ACLs) allow. The integration is opt-in and backward compatible. Your application keeps only what is genuinely yours: authenticating the user and passing who they are.
This post shows how to build such an assistant for many users who share one knowledge base and one memory resource. Each user sees only the documents they may read, and each user’s memory stays private. The running example is an internal employee assistant for AnyCompany, a fictional company. Employees sign in with Amazon Cognito and ask questions over HR policies, IT guides, engineering runbooks, and sales plans. We show how to read the user’s identity from the Cognito ID token, how to pass it to AgenticRetrieveStream for document ACLs and for memory, how to design memory namespaces for many users, and how to read the trace to see when the planner used memory. Finally, we make AWS Identity and Access Management (IAM) enforce per-user memory isolation even when application code gets it wrong. If you deployed the application from Build multi-tenant agentic chat applications on enterprise data with Amazon Bedrock Managed Knowledge Base, this post replaces its “persist conversation history yourself” step.
Solution overview
AnyCompany keeps its documents in Amazon Simple Storage Service (Amazon S3). One managed knowledge base syncs them through an ACL-enabled Amazon S3 data source. A global ACL file in the same bucket says which employees may read each folder: everyone reads HR and IT, only engineers read the engineering runbooks, and only salespeople read the commission plan. One AgentCore memory resource is shared by every employee. Amazon Cognito authenticates employees, and its ID token supplies two claims: the sub (user ID) identifies the user’s memory, and the verified email identifies the user to the knowledge base’s ACL filter. Three test users sign in: two engineers, Maya and Liam, and one salesperson, Sofia. The trace excerpts in this post are taken from a run of the sample application in the GitHub repository.
Figure 1: Architecture of the memory-aware employee assistant. The application authenticates the user and constructs the request (steps 1–4). Amazon Bedrock Managed Knowledge Base restores the session, retrieves information, returns an answer, and saves the exchange to AgentCore memory (steps 5–8). Short-term events and long-term records belong to the same memory resource.
The employee signs in with Cognito and receives an ID token, a JSON Web Token (JWT) signed by the user pool.
The application’s API validates the token — an Amazon API Gateway JWT authorizer in production, a small FastAPI service in the sample. Unauthenticated requests do not reach the handler.
The handler reads two claims from the verified token: sub becomes the memory actorId and namespace, and email becomes the userContext.userId. The client body carries only { question, sessionId? }. The handler then assumes the application’s IAM role for this user, with the session tag userId=<sub>.
The handler calls AgenticRetrieveStream with the knowledge base as the retriever, userContext, and a memoryConfiguration bound to this user.
Managed Knowledge Base restores the conversation history from short-term memory (STM) in AgentCore memory for the actor and session identified by sessionBinding.
Managed Knowledge Base retrieves from the knowledge base with ACL filtering based on userContext. It can also retrieve the user’s configured long-term memory through speculative retrieval or memory searches selected by the planner.
Managed Knowledge Base streams a cited answer and trace events back to the handler. The handler records the traces with a correlation ID and forwards the answer and trace information to the UI.
With persistenceMode: DEFAULT, the service saves the question and generated answer to the session. AgentCore memory then extracts long-term records asynchronously according to the configured strategies.
Figure 2: One AgenticRetrieveStream turn with userContext and memoryConfiguration. Everything between the first and last arrow is the service’s work.
Managed Knowledge Base owns ingestion, ACL filtering, indexing, ranking, planning, retrieval, and generation. With memoryConfiguration, it also owns session restore, memory search, and persistence. AgentCore memory owns storage, retention, encryption, and extraction. Your application owns authentication, the UI, and reading the user’s identity from the token. There is no conversation table: when the UI lists or reopens a conversation, it reads the same memory resource.
How identity maps to the request
Every value is derived by the application from the verified ID token. None comes from the request body.
Request field
Derived from
What it scopes
Enforced by
userContext.userId
ID token email (verified, immutable in the pool)
Which documents can be retrieved
Knowledge base ACL filtering
memoryConfiguration.sessionBinding.actorId
ID token sub
Whose short-term memory is restored and written, and the {actorId} in long-term namespaces
AgentCore memory keying, plus an IAM condition
memoryConfiguration.sessionBinding.sessionId
Generated by the application for a new conversation. Listed with ListSessions
Two different claims do two different jobs. The knowledge base identifies users by email, because that is what the connected data source records in its ACLs. Memory needs an actorId that never changes and is never reused. The Cognito sub is both. An email address can be changed, or reassigned to a new employee after someone leaves, and that person would then inherit the old memory. You can use another stable user ID from your own user store as the actorId. What matters is that it never moves to a different person.
Prerequisites
This walkthrough uses a managed knowledge base and an AgentCore memory resource in the US West (Oregon) Region (us-west-2). As described in the agentic retrieval documentation, the memory resource used with this integration must be in the same AWS account as the knowledge base and in the ACTIVE state.
Python 3.10 or later and Boto3 1.43.72 or later.
Permission to create an S3 bucket, a Cognito user pool, IAM roles, a knowledge base, and a memory resource. The sample’s infra/setup.py creates all of these resources idempotently.
Solution walkthrough
The following steps create the knowledge base and its data source, set up the memory resource and Amazon Cognito, build the request, and read the trace to confirm the result.
Step 1: Create the knowledge base with an ACL-enabled data source
Documents live in the bucket under docs/<folder>/. Amazon S3 has no permission system of its own to crawl, so you supply the ACLs in a global ACL file in the same bucket. Each entry maps an S3 prefix to the emails that may read it:
The sample’s file also gives everyone docs/it/. Then create the data source. For a managed knowledge base, every connector has the type MANAGED_KNOWLEDGE_BASE_CONNECTOR, and connectorParameters.type picks the source:
aclEnabled cannot be changed after the data source is created. CreateDataSource is asynchronous, so wait for the status AVAILABLE. Then call StartIngestionJob and wait for COMPLETE. The sync reads the documents and the ACL file and indexes each document with its ACL. In the sample, all 11 documents were scanned and indexed with 0 failures. A document that no ACL entry covers is not ingested, and a user whose email matches no entry receives no results from this data source.
The same model applies to connectors that crawl permissions from the source system, such as Microsoft SharePoint, Google Drive, and Atlassian Confluence. There, the permissions come from the source, groups are resolved from the source, and the knowledge base also checks each result against the source in real time. Your application code does not change: it still passes the user’s email in userContext. For the full list, see Access Control Lists awareness enablement.
Step 2: Create the memory resource and design namespaces
One memory resource serves every user. Per-user separation comes from {actorId} in the namespace templates, which AgentCore memory resolves from each event at extraction time. Two choices matter.
Strategies. The two strategies extract different things. The summary strategy summarizes each conversation, so it captures facts that a user mentions in passing, such as “I’m on a Mac in the Frankfurt office.” Those facts are what personalize a later answer about, say, PTO. The user-preference strategy extracts stated preferences into structured records (“Prefers short bullet-point answers without tables”, “Always deploys to eu-central-1 first”) and does not treat incidental mentions as preferences. Summaries give you “what we discussed.” Preferences give you “how this person wants to be answered.” Use both.
Layout. retrievalConfigs accepts one entry, so a single namespacePath must reach everything the planner should see for a user. Put {actorId} directly under the root: namespacePath: "/anycompany/<sub>" then covers the profile and every conversation summary. A layout such as /anycompany/profile/{actorId} and /anycompany/summaries/{actorId} would let one entry reach only one of them.
Wait for the memory to reach ACTIVE. Creating the memory does not need a user or actorId, so the order of Step 2 and Step 3 does not matter. Nothing is provisioned per user: a new Cognito user becomes a new actor the first time they ask a question.
Step 3: Set up Cognito and grant the application permissions
Create a user pool and an app client without a client secret. The email decides which documents a user may read, so make it required, verified, and not changeable by the user:
Mutable cannot be changed after the pool is created. With a mutable email, a signed-in user could change their email to a colleague’s address. If your users federate from Okta or Microsoft Entra ID, map the IdP’s email to this attribute so that it matches the email in your data source’s ACLs.
The sample enables USER_PASSWORD_AUTH so the local UI and tests can sign in directly. Production applications typically use Cognito managed login or AWS Amplify.
Set up an IAM role for the application. The backend assumes it once per user, with the session tag userId=<sub>, and every memory statement is conditioned on that tag. This is the complete policy the sample runs with:
ListEvents is required with sessionBinding, RetrieveMemoryRecords with retrievalConfigs, and CreateEvent when persistenceMode is DEFAULT. ListSessions and ListMemoryRecords are for the application’s own reads (conversation list and the “what memory knows about you” view), not for AgenticRetrieveStream. The role’s trust policy allows sts:AssumeRole, sts:TagSession, and sts:SetSourceIdentity from the backend’s own identity (an AWS Lambda execution role or an Amazon Elastic Container Service (Amazon ECS) task role in production). If the memory uses a customer managed key, add kms:Decrypt on that key.
Step 4: Read the user from the token, then build the request
Verify the ID token and read the two claims. Only the ID token carries email. The access token does not:
@dataclasses.dataclass(frozen=True)
class Principal:
    sub: str     # -> memory actorId and namespace
    email: str   # -> userContext.userId (document ACLs)

    def namespace_path(self, root: str) -> str:
        return f"{root}/{self.sub}"       # resolved literal, e.g. /anycompany/a8e1b390-...


def verify(id_token: str) -> Principal:
    key = jwks.get_signing_key_from_jwt(id_token)   # public keys from {issuer}/.well-known/jwks.json
    claims = jwt.decode(id_token, key.key, algorithms=["RS256"], issuer=ISSUER, audience=CLIENT_ID)
    if claims.get("token_use") != "id" or claims.get("email_verified") is not True:
        raise PermissionError("a verified ID token is required")
    return Principal(sub=claims["sub"], email=claims["email"].lower())
jwt.decode checks the signature, the issuer (your user pool), the expiry, and the audience (your app client). For details of the claims, see Understanding the identity (ID) token. With API Gateway, a JWT authorizer does the same checks and passes the claims to your handler.
Next, get the user’s AWS credentials. The backend assumes the application role for this user and caches the session until shortly before it expires:
Every call for this user, including the memory calls that agentic retrieval makes on the caller’s behalf, now runs as assumed-role/anycompany-assistant-app-role/user-<sub> and carries the tag that the policy in Step 3 checks.
Decide the sessionId. For a new conversation, the application generates one, such as "conv-" + uuid4().hex, and returns it to the client. To continue a conversation, the client sends it back. To show a user their conversations, call ListSessions with the user’s actorId:
def list_conversations(principal):
    try:
        resp = memory.list_sessions(memoryId=MEMORY_ID, actorId=principal.sub, maxResults=50)
    except memory.exceptions.ResourceNotFoundException:
        return []   # the user has not asked anything yet, so there is no actor
    return [{"sessionId": s["sessionId"], "createdAt": s["createdAt"].isoformat()} for s in resp["sessionSummaries"]]
You do not need your own table that maps users to sessions. Accepting a sessionId from the client is safe because short-term memory is keyed by (memoryId, actorId, sessionId), and the actorId comes from the token. If Liam sends Maya’s sessionId, it names a session inside Liam’s own space, which is empty. Agentic retrieval itself does not verify that the actorId, sessionId, or namespace you supply belong to the user who is asking, so they must never come from the client. Keep your own session table only if you need data that memory does not hold, such as conversation titles.
Then build the request:
def build_request(principal, question, session_id):
    return {
        # With sessionBinding, messages carries ONLY the current question.
        "messages": [{"role": "user", "content": {"text": question}}],
        "retrievers": [{"configuration": {"knowledgeBase": {"knowledgeBaseId": KB_ID}},
                        "description": KB_DESCRIPTION}],
        # Document ACLs: only documents this email may read are retrieved.
        "userContext": {"userId": principal.email},
        "agenticRetrieveConfiguration": {
            "foundationModelType": "MANAGED",
            "rerankingModelType": "MANAGED",
            "maxAgentIteration": 3,
        },
        "generateResponse": True,
        "memoryConfiguration": {
            "memoryId": MEMORY_ID,
            "sessionBinding": {"actorId": principal.sub, "sessionId": session_id},
            "persistenceMode": "DEFAULT",
            "retrievalConfigs": [{"namespacePath": principal.namespace_path("/anycompany")}],
        },
    }
Without userContext, an ACL-enabled data source returns no results at all. Compare the request with the stateless handler it replaces:
The query before the call and the write after it are gone, and messages has one element. Three rules come with sessionBinding, and each is enforced with a specific ValidationException. First, messages carries only the current question, so you choose one history source per request. Second, persistenceMode: DEFAULT (the default) writes the question and the generated answer as one event, so it requires generateResponse: true. Third, memoryId alone is invalid. persistenceMode: NONE restores history and writes nothing, for audit or replay views.
Step 5: Update the client contract and render history
The client sends { question, sessionId? }. On a new conversation, the application generates a sessionId and returns it as the first streamed frame. The client echoes it on later turns and omits it to start over.
Because the memory resource is yours, the application reads it directly to render a conversation:
def conversation_history(principal, session_id):
    resp = memory.list_events(memoryId=MEMORY_ID, actorId=principal.sub, sessionId=session_id,
                              includePayloads=True, maxResults=100)
    return [{"role": p["conversational"]["role"].lower(), "text": p["conversational"]["content"]["text"]}
            for ev in sorted(resp["events"], key=lambda e: e["eventTimestamp"])
            for p in ev["payload"] if "conversational" in p]
Each persisted turn is exactly one event with two payloads: the user’s question and the final answer. The history therefore renders as a clean transcript and remains usable by other AgentCore memory clients.
Step 6: Verify from the trace
The trace tells you, per turn, what the knowledge base and memory did:
Trace event
When it appears
What to look at
SessionHistoryLoad
First event, whenever sessionBinding is set
_memory_event_count and _memory_message_count, both 0 on a new session
SpeculativeRetrieval
Before planning
On a new session, retrievalMetadata also lists BedrockAgentCoreMemory. Memory items carry _memory_* metadata and no text. Knowledge base items carry _source_uri
Planning
Each iteration
actions[].memoryRetrieve means the planner chose to search memory, with a query it composed
Retrieval with retrievalType: BedrockAgentCoreMemory
Per planned memory action
_memory_record_count. A count of 0 is a normal result
A memory event with status: FAILED
Memory unavailable or access denied
failures[].message. Memory is best-effort: the request continues and the answer is generated from the knowledge base
The following runs show the behavior. Excerpts are verbatim, trimmed for length.
Document ACLs: Maya and Sofia, same question. “What is the weekly on-call stipend?” The on-call guide is in docs/engineering/. Maya’s retrieval included docs/engineering/oncall.md, and the answer was “500 USD or 450 EUR per week.” Sofia’s speculative retrieval and the planner’s follow-up sub-query returned only HR and sales chunks:
Her answer said that no on-call stipend is documented in the sources she can access. The application made no access decision. It passed userContext.userId: "sofia@example.com", and the knowledge base did the filtering. The reverse holds for the commission plan: Sofia gets the 12% accelerator, and Maya’s retrieval does not contain docs/sales/.
Turn 1: Maya, new conversation. “How do I set up the VPN on my laptop? I’m on a Mac in the Frankfurt office.”
The answer gives the Frankfurt gateway (vpn-fra.anycompany.example) and the macOS steps. Afterwards, ListEvents on the session shows one event with two payloads.
Turn 2: Maya, same conversation. “It keeps disconnecting every few minutes. What should I try?” The request carried only that sentence:
The planner sent retrieve("VPN disconnects every few minutes troubleshooting") and retrieve("Cisco Secure Client macOS frequent disconnect fix"). The answer resolved “it” and pointed at iCloud Private Relay, the macOS-specific cause in the guide. On a continued session, SpeculativeRetrieval queries only the knowledge base. The long-term memory lookup in that step happens on new sessions.
Turn 3: Maya, a new conversation, later. “How many days of PTO do I get per year, and do unused days carry over?” Her office decides the answer, and she never mentioned it in this conversation. Speculative retrieval searched long-term memory with the raw question and found one record:
{"step": "SpeculativeRetrieval",
 "retrievalMetadata": [{"identifier": "JQUFTMTNZV", "retrievalType": "BedrockKnowledgeBase"},
                       {"identifier": "anycompany_assistant_memory-5llXYu8f2i", "retrievalType": "BedrockAgentCoreMemory"}],
 "retrievalResponse": [
   {"content": {"mimeType": "text/plain", "text": "# AnyCompany Paid Time Off (PTO) Policy ..."},
    "metadata": {"_document_title": "pto-policy.md", "_data_source_type": "S3",
                 "_source_uri": "https://.../docs/hr/pto-policy.md"},
    "sourceRetriever": {"identifier": "JQUFTMTNZV"}},
   {"content": {"mimeType": "text/plain"},
    "metadata": {"_memory_strategy_id": "ConversationSummaries-JFDHQVB4VU",
                 "_memory_query": "How many days of PTO do I get per year, and do unused days carry over?",
                 "_memory_namespace_path": "/anycompany/a8e1b390-10f1-70d9-ee85-b68b610ee0c4",
                 "_memory_record_count": 1},
    "sourceRetriever": {"identifier": "anycompany_assistant_memory-5llXYu8f2i"}}]}
Knowledge base and memory items share one retrievalResponse. Tell them apart by sourceRetriever.identifier or by the _memory_* keys. The record was the summary of her VPN conversation. That was enough: the planner went straight to the answer, which said “Since your memory indicates you’re based in the Frankfurt office … you get 30 days of PTO per year, granted in full on January 1, and any unused days must be used by March 31 of the following year.” A fact from an IT conversation personalized an HR answer.
Turn 4: Liam, new conversation, identical question. Same handler, same memory resource, a different token. Speculative retrieval found nothing about him, so the planner decided to search memory with its own query:
Liam received the table of all three offices and a request to say which one he is in. The application chooses where the planner may look. The planner decides whether to look and what to ask: a memoryRetrieve action appears only when the planner decides that another memory search would help. Reading Maya’s sessionId through the history endpoint with Liam’s token returned an empty list.
Figure 3: The same question from two users. Maya’s trace shows a memory hit and a Frankfurt-specific answer. Liam’s trace shows zero memory records and the generic table.
Long-term extraction is asynchronous and runs after the turn is persisted. In our run, the first record appeared 81 seconds after turn 2, but the timing is not a commitment. Design for eventual availability. A fact stated in this conversation is not guaranteed to be retrievable in the next one immediately. The sample polls ListMemoryRecords before running turn 3.
Security and multi-user isolation
In this walkthrough, the application authenticates. The knowledge base filters. ACL-aware retrieval is filtering, not authorization. Take the email only from a verified ID token with email_verified: true, make it immutable in the pool, and handle email reuse: if an address is reassigned to a different person, that person gets the old owner’s document access. The knowledge base fails closed: a document with no ACL, or an ACL error, means fewer results, not extra ones. If results are missing, check that the email matches the ACL entry.
Identity comes from the token (Step 4) for memory too: actorId and namespace come from the verified sub, never from the client.
IAM condition keys, as defense in depth. AgentCore memory exposes bedrock-agentcore:actorId on ListEvents, CreateEvent, and ListSessions, and bedrock-agentcore:namespacePath on RetrieveMemoryRecords and ListMemoryRecords. The memory calls that agentic retrieval makes during a request are authorized against the calling identity. That is why the caller’s policy must grant those actions, and why the conditions in Step 3 apply to them. With the session assumed for Maya, a request bound to Maya’s actorId proceeds normally. A request that binds Liam’s actorId is the bug that this policy guards against, and it is denied at every memory operation:
SessionHistoryLoad/FAILED      failures: ["AccessDeniedException"]
SpeculativeRetrieval/SUCCEEDED failures: ["AccessDeniedException"]   # memory leg denied, KB leg answered
Nothing was written to Liam’s memory: his session count stayed at 0. The answer was still generated from the knowledge base. Because each user has their own role session, AWS also sees which user each call is for: the caller is assumed-role/anycompany-assistant-app-role/user-<sub> with SourceIdentity=<sub>, which the session holder cannot change.
Two further points. The memory is a customer-owned resource that other systems in your account may also write to. Treat its contents as input, and attach an Amazon Bedrock guardrail to the request through policyConfiguration. And plan the data lifecycle. Raw events expire per eventExpiryDuration, but extracted records do not. A user-deletion workflow therefore covers DeleteEvent for the actor’s sessions and DeleteMemoryRecord under the actor’s namespace.
Observability and failure behavior
Log the full trace with a correlation ID per turn. The planner’s sub-queries are as worth auditing as its final results. AWS/Bedrock/KnowledgeBases reports Invocations, ClientErrors, and TotalIterationCount for Operation=AgenticRetrieveStream. AWS/Bedrock-AgentCore reports Invocations, Latency, Errors, and UserErrors per memory operation, and InputTokenUsage/OutputTokenUsage per strategy for extraction. With Amazon CloudWatch Transaction Search enabled, AgentCore Observability, a capability of Amazon Bedrock AgentCore, shows a turn’s spans end to end.
Memory operations are best-effort by design. If a memory call fails or is denied, the request does not fail. The trace carries a FAILED memory event with the failure message, and the turn continues without that memory. The answer is generated from the knowledge base. Decide whether your UI surfaces that degraded state.
Considerations
Use a stable sessionId for the life of a conversation. The API accepts a fresh ID per request, but a fresh ID silently breaks continuity and produces one summary record per turn.
Use namespacePath to reach all of a user’s long-term records. retrievalConfigs accepts one entry with up to five metadataFilters. namespace matches by prefix and namespacePath matches by hierarchy, so namespacePath fits per-user IDs under the root. Supply namespaces fully resolved, because a template such as /anycompany/{actorId} is rejected.
Expect only USER and ASSISTANT conversational events to be restored. Events with the TOOL or OTHER role that other systems write are skipped.
Keep sending messages instead of sessionBinding when your application needs to control exactly which history each request carries. For example, your existing history store may be the system of record for conversations, or you may edit or redact history before sending it. With sessionBinding, the service restores and persists the conversation for you. You can’t combine the two in one request.
A request can carry up to five knowledge bases. With more than one retriever, the planner routes each sub-query based on the knowledge base description, so write it carefully.
Plan for latency and cost. The session restore adds on the order of 200 milliseconds. In our runs, a full turn with one knowledge base, ACLs, and memory took 4–10 seconds with the managed model. Planning iterations drive that time, not memory. These are observed figures, not service commitments. Agentic retrieval is priced per call plus underlying retrievals, and the memory operations made during the call are billed as AgentCore memory usage. For details, see Amazon Bedrock pricing and Amazon Bedrock AgentCore pricing.
Clean up
Run python infra/teardown.py in the sample to delete the knowledge base, the S3 bucket and its objects, the memory resource (including conversation history and long-term records), the Cognito user pool, and the IAM roles.
Conclusion
Amazon Bedrock Managed Knowledge Base already gave you the retrieval stack as a service. That stack covers ingestion, document ACLs, indexing, ranking, and the planning loop in AgenticRetrieveStream that turns a hard question into a cited answer. With memoryConfiguration, the same call now carries the conversation and the user’s history. For a multi-user application, that removed the conversation store, the history replay, and the extraction pipeline. What remained was a short list of responsibilities. Authenticate the user and read two claims from the ID token: pass the verified email as userContext so that the knowledge base filters documents, and use the sub as the actorId for one memory resource with {actorId}-rooted namespaces. Use IAM condition keys on a per-user role session as a second line of defense that holds through the agentic path.