Creación de un asistente de IA sensible al contexto en AgentCore y OpenClaw
Building a context-aware AI assistant on AgentCore and OpenClaw
Thiago Verney
Los asistentes de IA estándar responden bien a las preguntas individuales, pero se quedan cortos en un eje diferente: la continuidad. Pregúntale a un asistente apátrida sobre tu huerto hoy y no tendrá ni idea de que mencionaste que hace tres semanas mencionaste que tus canteros elevados se drenaban rápidamente, que solo utilizabas fertilizantes orgánicos o que tus petunias estaban pasando apuros por una ola de calor. Cada conversación comienza desde cero, y la carga de volver a explicar el contexto recae
en el usuario.
El problema no es la calidad de las respuestas, sino que el asistente no recuerda nada de ti. En este artículo se muestra cómo crear un asistente personal que acumule contexto mediante OpenClaw, un sistema de agencia de código abierto que funciona con AgentCore Runtime, una funcionalidad de Amazon Bedrock AgentCore. La memoria AgentCore, una capacidad de Amazon Bedrock AgentCore, convierte los chats desechables en conocimiento duradero. También aprenderá a etiquetar esos recuerdos con metadatos estructurados para recuperar los registros relevantes para la pregunta en cuestión
.
Nuestro ejemplo habitual es Sprout, un asistente de jardinería, pero la arquitectura es independiente del dominio. Cambie la personalidad por la que se manifiesten sus habilidades y obtendrá el mismo flujo de trabajo para un robot de apoyo, un preparador físico o un servicio de asistencia interno. Todo el sistema se encuentra en una única plantilla de AWS CloudFormation, se implementa con un solo comando y se ejecuta según un modelo basado en el consumo que cuesta unos pocos dólares al mes para un uso personal ligero. Además, compartimos las directrices de diseño que puede aplicar a los asistentes que cree a partir de
esta pila.
Descripción general de la solución
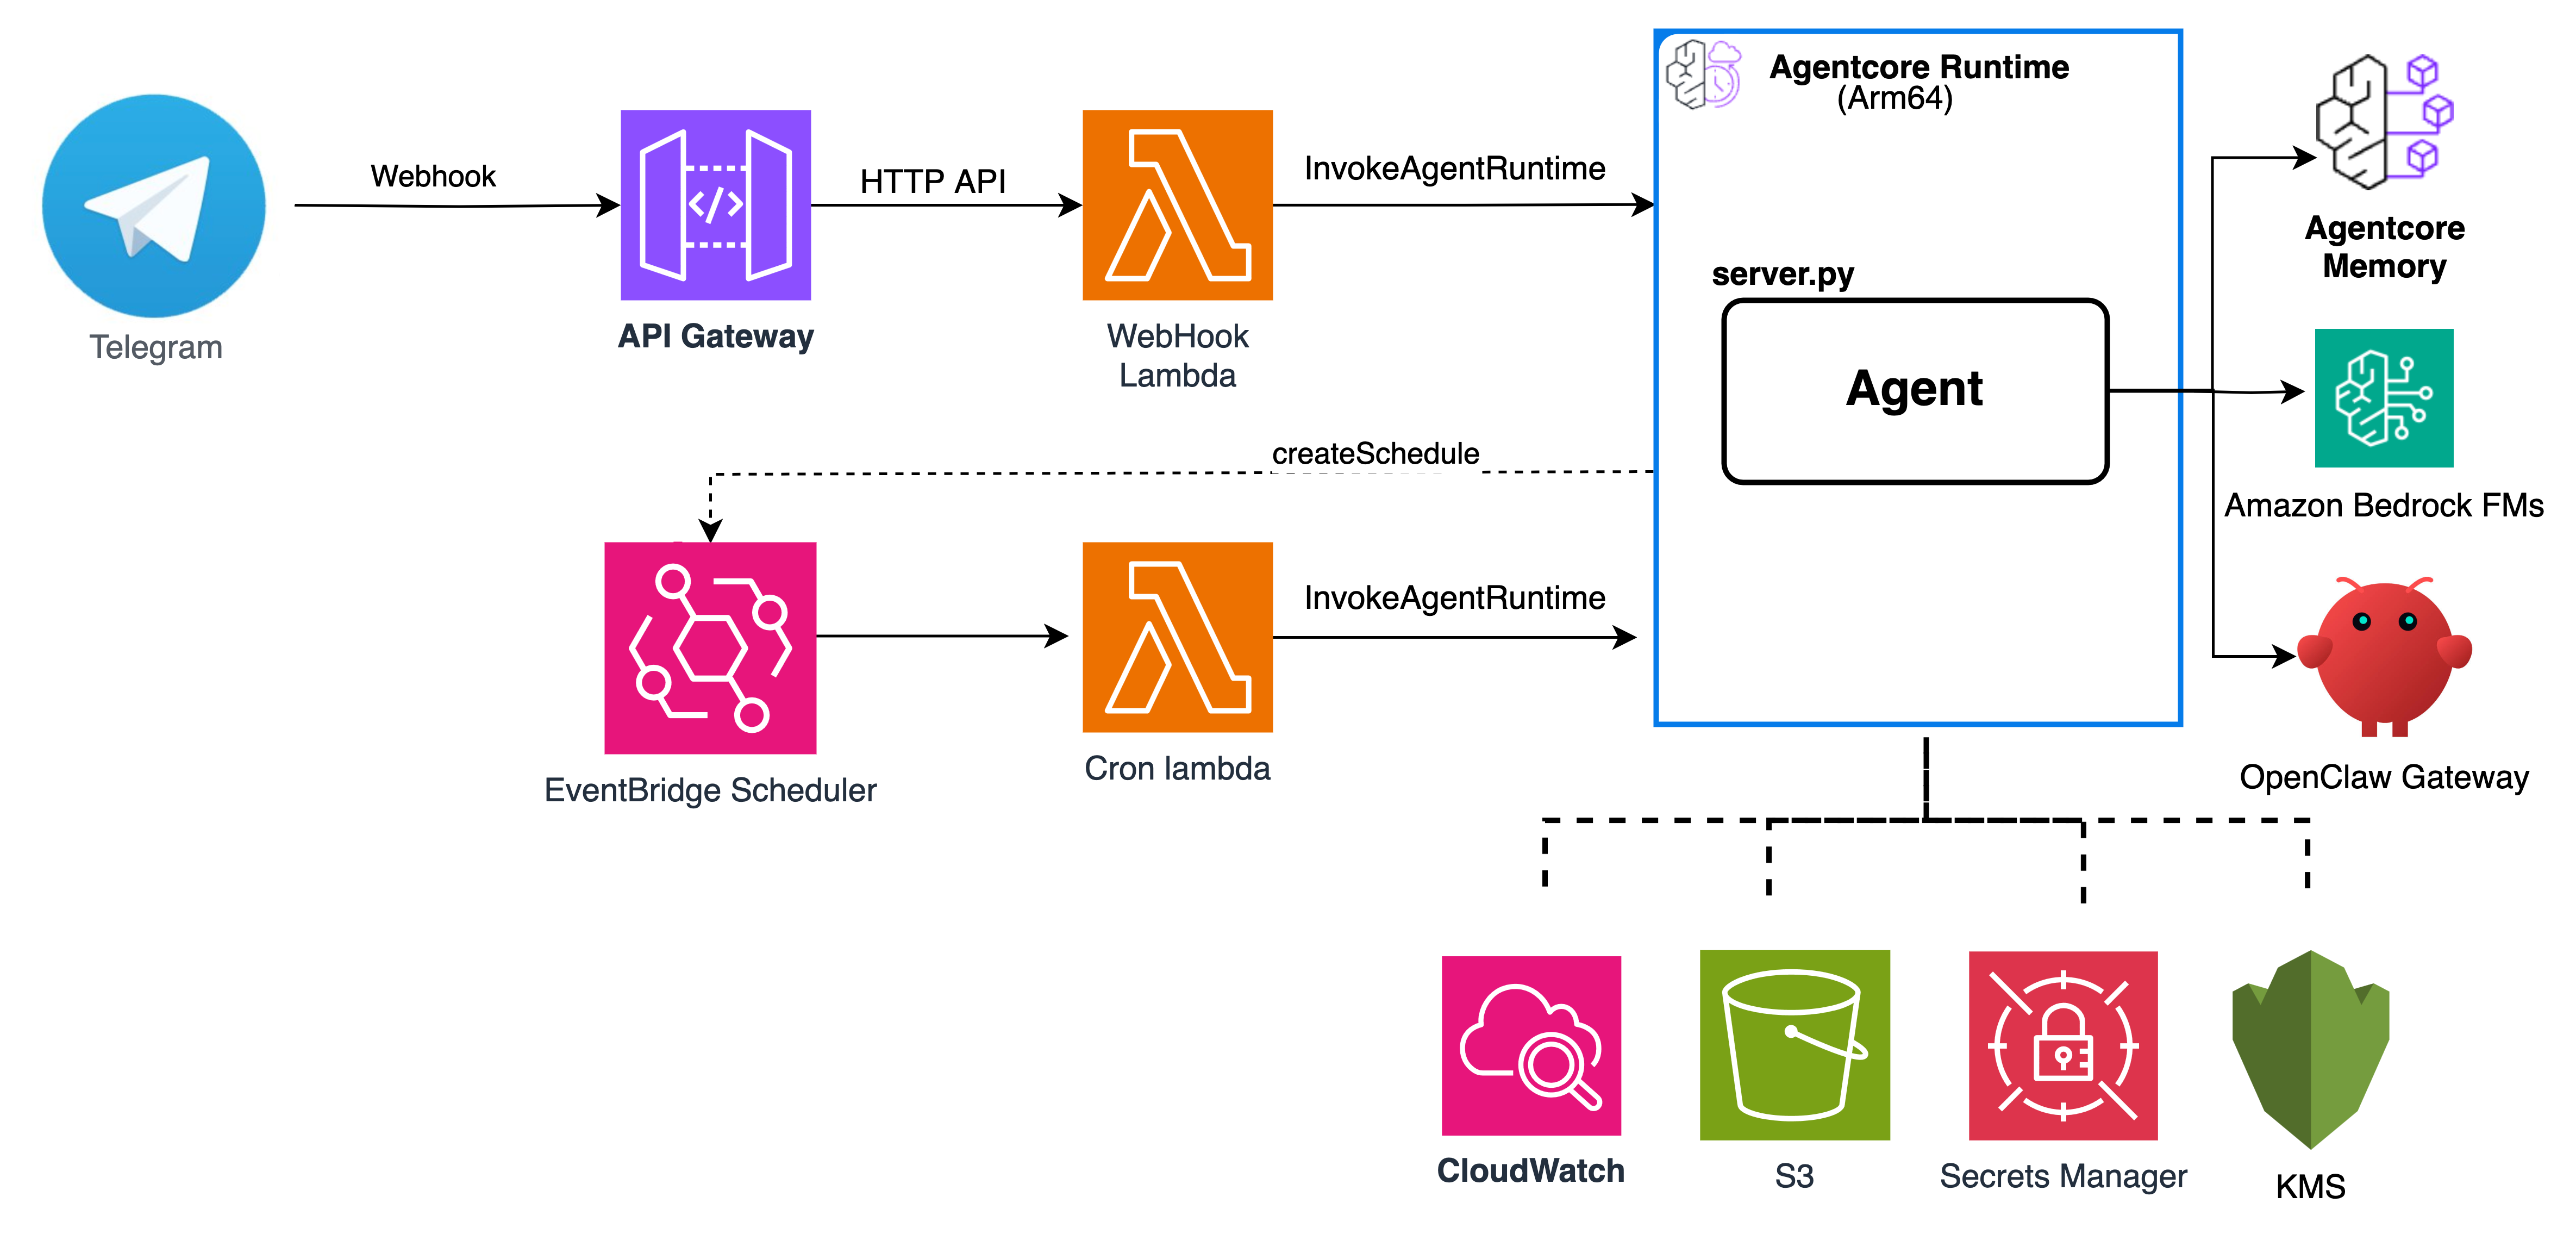
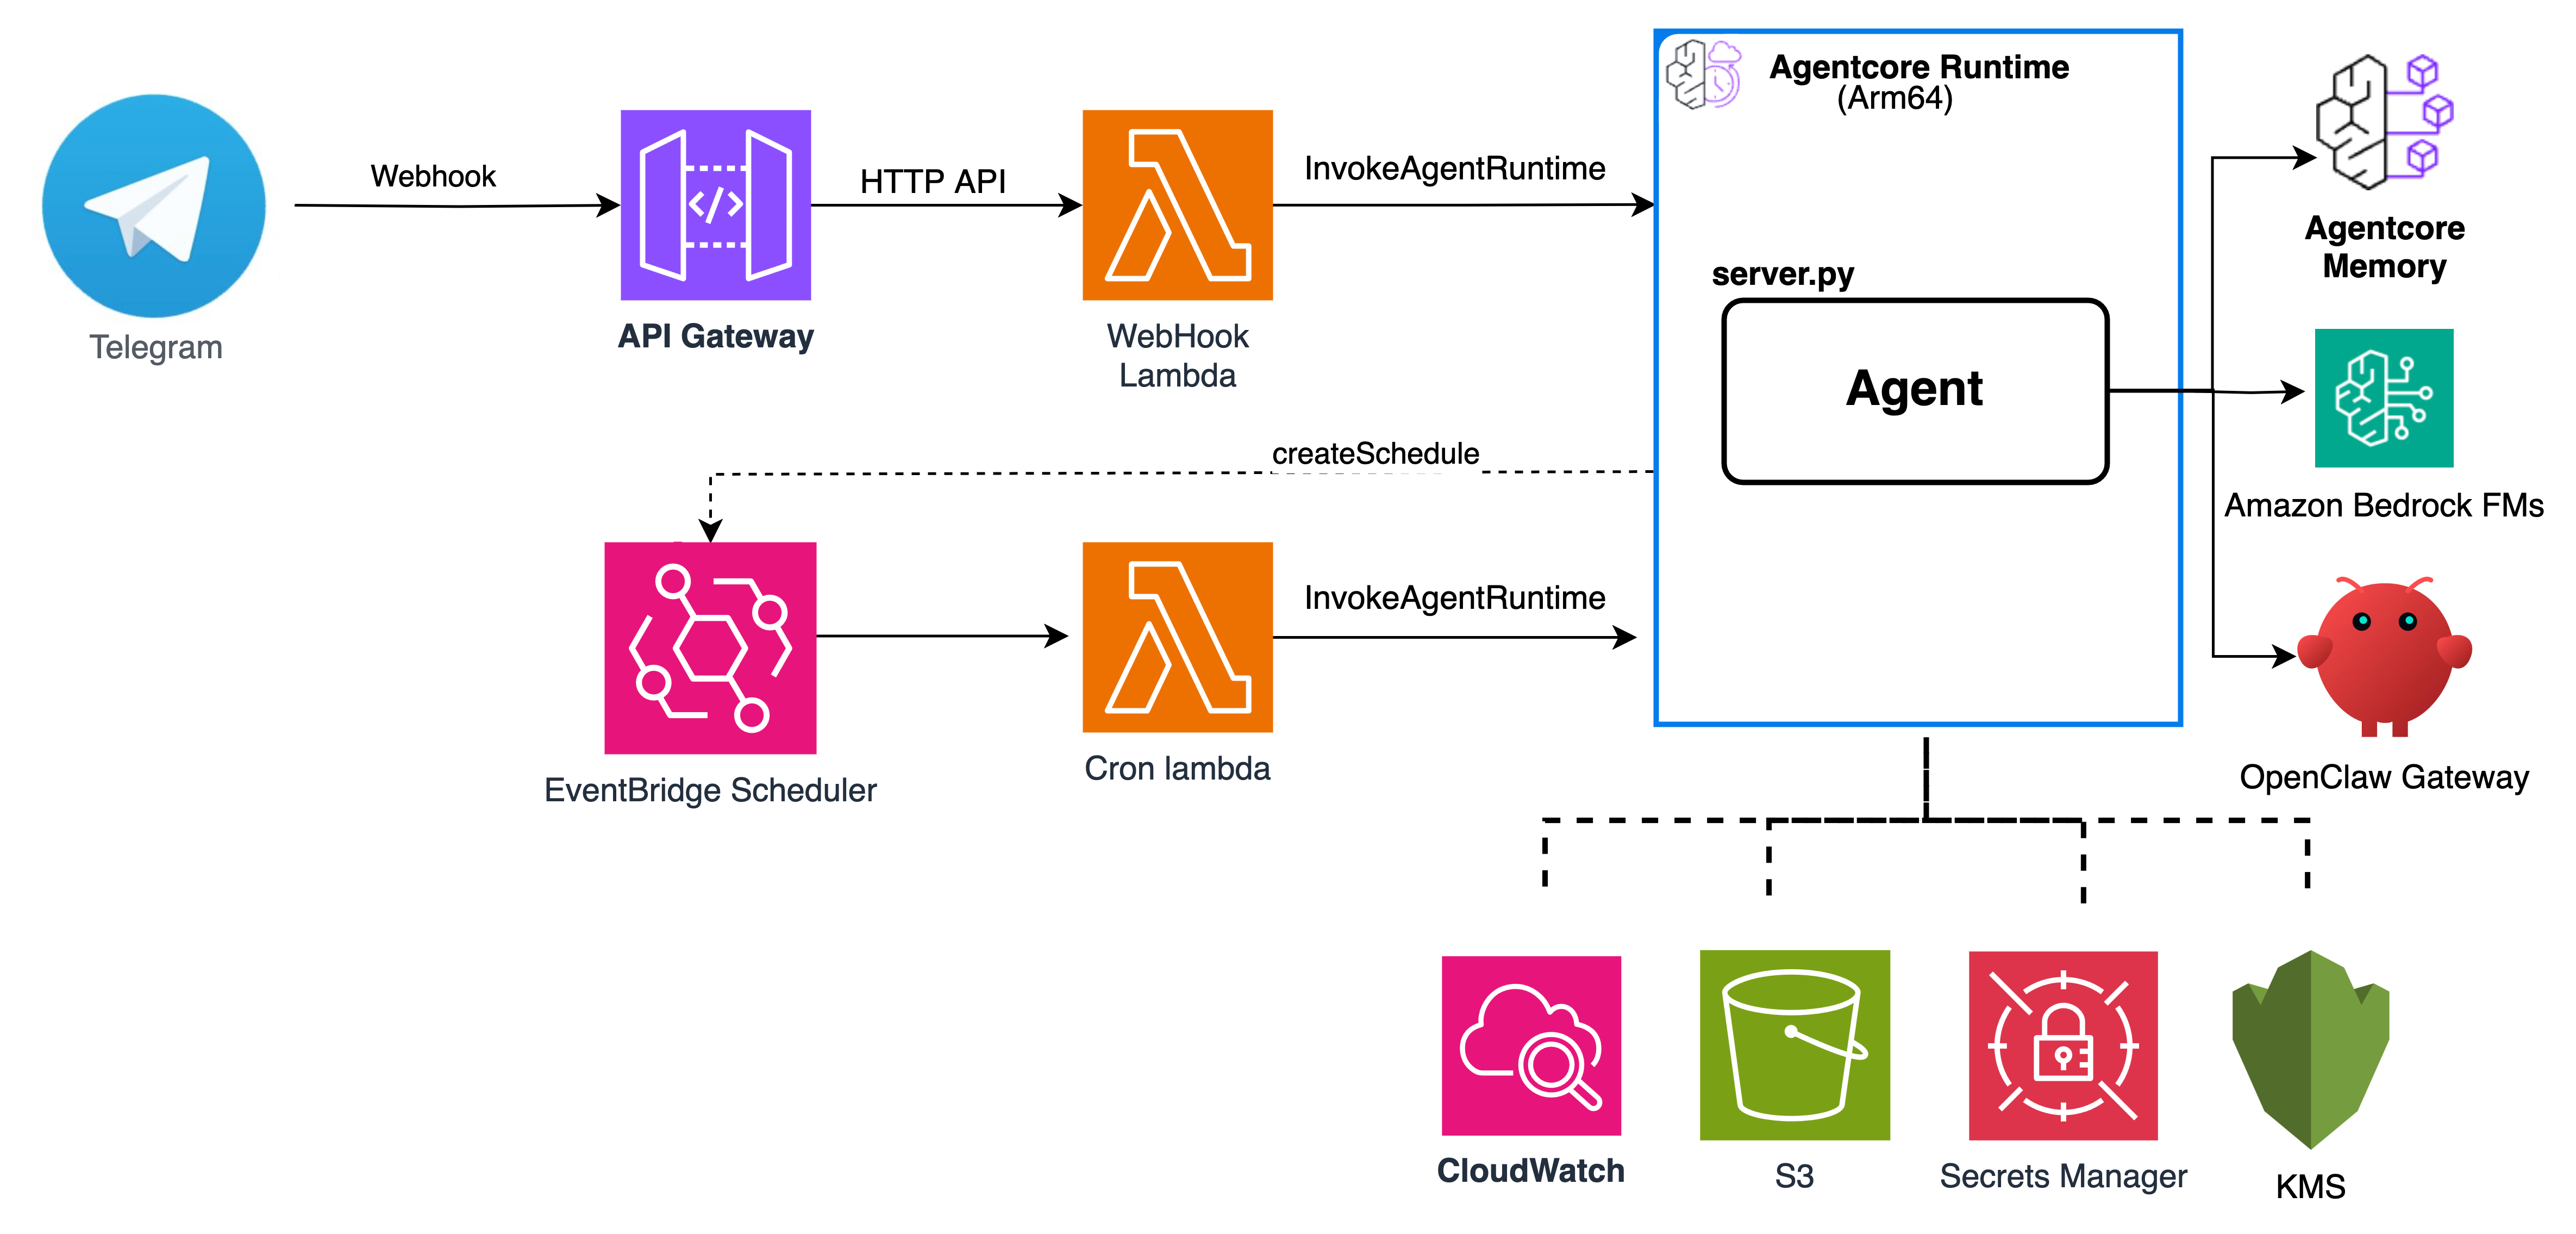
AgentCore es una plataforma para crear, conectar y optimizar agentes a escala, con cualquier marco o modelo. El siguiente diagrama muestra el flujo de solicitudes de principio a fin, desde un webhook entrante de Telegram hasta el motor de ejecución de AgentCore
y sus servicios de AWS compatibles.
Figura 1: Los webhooks de Telegram y las programaciones de Amazon EventBridge invocan el mismo agente de ejecución de AgentCore, que coordina la puerta de enlace de OpenClaw, la memoria de AgentCore y Amazon Bedrock
Dos puntos de entrada convergen en un agente. Los mensajes de Telegram llegan a través de Amazon API Gateway y una función Webhook de AWS Lambda, mientras que las tareas programadas, como los recordatorios de agua por la mañana, llegan a través de Amazon EventBridge Scheduler y una función cronjob Lambda. Ambas utilizan la API InvokeAgentRuntime en el entorno de ejecución de AgentCore, donde un proceso server.py ligero coordina la puerta de enlace de OpenClaw, la memoria de AgentCore y la API Amazon Bedrock Converse. Amazon Simple Storage Service (Amazon S3) proporciona almacenamiento en el espacio de trabajo, AWS Key Management Service (AWS KMS) gestiona el cifrado, AWS Secrets Manager almacena el token del bot y Amazon CloudWatch captura
los registros y las métricas.
Requisitos previos
Para implementar su propia versión con el botón Launch Stack o con scripts/ deploy.sh (descrito en la sección Haga crecer su propia versión), necesitará:
Acceso a Amazon Bedrock AgentCore, incluido el tiempo de ejecución de AgentCore y la memoria de AgentCore.
Se concede acceso a los modelos a los que tiene pensado enviar una ruta: Claude Haiku 4.5 para texto y Claude Sonnet 4.5 para visión (o los modelos equivalentes disponibles en su cuenta).
Docker compatible con la compilación de linux/arm64, además de la interfaz de línea de comandos de AWS (CLI de AWS) configurada. Esto solo es necesario si tiene previsto crear y publicar su
propia imagen.
Un token de bot de Telegram (de BotFather) que sirva de puerta de entrada al asistente.
Familiaridad básica con los conceptos de orquestación de agentes y CloudFormation.
La arquitectura: un agente sin servidor en tiempo de ejecución de AgentCore
Todos los componentes se encuentran en una única plantilla de CloudFormation y no se necesitan herramientas de compilación para lanzarlos. En las siguientes secciones se describen las decisiones que implican una carga
.
Tiempo de ejecución de AgentCore: pague solo por el procesamiento activo
El agente reside en un contenedor en AgentCore Runtime, que utiliza precios basados en el consumo. Se le factura por los recursos informáticos que consume activamente su agente, no por el tiempo de actividad habitual, y no paga por el tiempo de espera de la E/S, por ejemplo, de la respuesta del modelo. En el caso de un asistente personal que se utiliza en ráfagas breves, esa es la diferencia entre un valor base de aproximadamente 1 a 2 dólares al mes y una instancia de Amazon Elastic Compute Cloud (Amazon EC2) siempre activa de aproximadamente 35 dólares al mes. Estas cifras son estimaciones para un uso personal ligero en julio de 2026. Consulte los precios de AgentCore para conocer las tarifas actuales
.
El motor de ejecución impone un contrato de contenedor mínimo: escucha en el puerto 8080 y expone GET /ping para el estado y POST /invocations como punto de entrada del agente. Nuestro contenedor es linux/arm64, creado en varias etapas
a partir de la imagen oficial de OpenClaw más una capa de Python.
OpenClaw como sustrato agente
OpenClaw proporciona el ciclo de agentes, el uso de herramientas y un sistema de habilidades. Ejecuta un contenedor (server.py) que lo adapta al contrato de protocolo HTTP de AgentCore
:
Al iniciar el contenedor, server.py lanza la ejecución de openclaw gateway como un subproceso y comprueba su estado.
GET /ping vuelve a funcionar rápidamente, por lo que la sonda de preparación de AgentCore es correcta.
POST /invocations se encarga de todo: analizar la carga útil, recuperar la memoria, ensamblar el contexto, reenviar el turno a la puerta de enlace y conservar el resultado. Un aviso: AgentCore puede descongelar un contenedor congelado cuyo subproceso haya finalizado. Por lo tanto, la ruta de invocación no asume que la puerta de enlace está activa, sino que llama a un ayudante ensure_openclaw_ready () que vuelve a comprobar su estado (y reinicia la puerta de enlace si es necesario) antes de reenviar el turno
.
Este patrón de envoltura se generaliza a otros casos de uso. Cualquier marco de agente que se ejecute como un proceso local se puede adaptar al tiempo de ejecución de AgentCore de la misma manera, sin modificar el
Claude Haiku 4.5 para texto: rápido y económico para los turnos de conversación de gran volumen que dominan el uso diario.
Claude Sonnet 4.5 para la visión: Razonamiento multimodal más sólido para la tarea menos frecuente pero más difícil de diagnosticar una planta a partir de una fotografía.
El
texto cambia el flujo a través de la puerta de enlace OpenClaw, que aporta habilidades y estado de sesión. Los turnos de imagen llaman al modelo de lenguaje grande (LLM) de Bedrock directamente desde server.py y transfieren los bytes de la imagen como bloques de contenido multimodales. Distribuimos las imágenes por la puerta de enlace de forma deliberada: la compilación de OpenClaw integrada en el contenedor eliminaba las partes del contenido de image_url antes de que llegaran a Bedrock, por lo que al llamar a la API de Converse directamente desde server.py, se asegura de que el modelo vea los píxeles reales. Ambas rutas comparten el mismo indicador del sistema (persona más memoria)
, por lo que la experiencia es uniforme.
Los ID de los modelos son variables de entorno (MODEL_ID, VISION_MODEL_ID), por lo que puede intercambiar modelos por implementación sin tener que reconstruir la imagen.
Habilidades como unidad de capacidad
reutilizable
Las capacidades se declaran como habilidades en un manifiesto de community-skills.json.
Un script en el momento de la implementación las materializa en el contenedor y las registra en la configuración de OpenClaw antes de crear la imagen. Al momento de publicar este artículo, Sprout viene con habilidades meteorológicas, recordatorios y notas sobre plantas. Cambia el manifiesto y la misma canalización servirá a un dominio diferente. Esto es lo que hace que todo sea un patrón reutilizable y no solo un bot.
Telegram como puerta de entrada sin servidores
Telegram es un canal práctico para un asistente personal, ya que está basado en webhooks y mantiene todo sin servidor. No requiere desarrollo por parte del cliente, funciona en todos los dispositivos que el usuario ya posee y admite texto, imágenes y formatos enriquecidos a través de una sencilla API de bots. BotFather emite un token de bot, que se almacena en Secrets Manager. La implementación registra un webhook que dirige a Telegram al punto final de la puerta de enlace de la API. Cuando el usuario envía un mensaje, Telegram lo envía a la función Lambda del webhook para validar la carga útil y llamar a InvokeAgentRuntime. La respuesta regresa a través de la API del bot de Telegram
.
Una lección de formato a tener en cuenta: el antiguo modelo de markdown de Telegram es implacable con los caracteres que no se escapan y un solo subrayado suelto en una respuesta modelo puede hacer que no se envíe todo el mensaje. La representación de las respuestas en formato HTML es fiable, por lo que el asistente convierte la salida del modelo
en HTML seguro para Telegram antes de enviarla.
Memoria: convertir las conversaciones desechables en conocimiento duradero
La arquitectura descrita hasta ahora consiste en un agente capaz, barato y sin servidor, pero por sí solo se olvida de ti entre una conversación y otra. La memoria es lo que cambia eso. Imagina que hace semanas mencionaste que hacías un huerto orgánico, y hoy el ayudante te recomienda un tratamiento y añade, por sí solo, que eligió la opción orgánica porque no utilizas fertilizantes sintéticos. Un modelo apátrida no puede hacer eso
.
El modelo mental: eventos a corto plazo, extracción a largo plazo
La
memoria de AgentCore tiene dos capas. La memoria a corto plazoalmacena cada turno de conversación como un evento a través de CreateEvent, tecleado mediante actOrID (el identificador de chat de Telegram) y sessionID. Esta es la transcripción sin procesar. La memoria a largo plazo se produce de forma asincrónica mediante estrategias de extracción gestionadas para convertirla en registros estructurados y duraderos. Configuramos tres estrategias
:
USER_PREFERENCE: elecciones explícitas que indicó el jardinero («Solo uso fertilizante orgánico»).
SEMÁNTICA: hechos inferidos («cultiva petunias mexicanas en una cama elevada de acero corten»).
RESUMEN: resúmenes de sesiones episódicas («se discutió el amarilleo de las hojas inferiores durante una ola de calor»).
Espacios de nombres: un jardín por jardinero
Sprout archiva los registros en espacios de nombres por usuario, para que no se mezclen dos chats:
sprout/ {chat_id} /long_term: preferencias y hechos semánticos.
sprout/ {chat_id} /episodic/ {session_id}: resúmenes de las sesiones.
El ID de chat es el único segmento variable, lo que hace que el aislamiento sea sencillo de razonar y probar: cada jardinero único se asigna exactamente a un espacio de nombres y no hay dos jardineros que choquen.
La tubería de recuperación, ensamblaje e inyección
En cada turno, el agente recupera los registros relevantes a largo plazo, los clasifica y los inyecta en el indicador del sistema.
Esto es lo que ocurre en cada mensaje, dentro del archivo server.py:
Recuperar. Llama a RetrieveMemoryRecords con sprout/ {chat_id} /long_term y utiliza el mensaje del usuario como consulta de búsqueda, con un límite de 50 resultados, por debajo de un presupuesto de 3 segundos. Si se agota el tiempo de recuperación o se produce un error, se degrada correctamente y respondemos sin memoria en lugar de fallar.
prueba:
 records = memory_client.retrieve_memory_records (
 memoryID=memory_id,
 namespace=f'sprout/ {chat_id} /long_term',
 Criterios de búsqueda = {
 'searchQuery': user_message,
 «a PK»: 50,
 'Filtros de metadatos': []
 },
 ) Tiempo de espera de 3 segundos
excepto la excepción:
 records = [] # recurre a responder sin memoria
Fragmento 1: Recuperar los registros a largo plazo del turno actual (representativo). Consulte el repositorio para
ver la fuente completa).
La función de ensamblaje agrega lógica personalizada adicional. Queremos que las preferencias explícitas se clasifiquen por encima de los hechos inferidos, que el orden sea estable dentro de cada clase y que el resultado esté limitado antes de la inyección
:
def assemble (registros, cap=50):
 explicit = [r para r en los registros si r.type == 'USER_PREFERENCE']
 inferred = [r para r en los registros de r.type! = 'USER_PREFERENCE']
 # tiempos explícitos inferidos; orden estable dentro de cada clase
 ordenado = explícito + inferido
 devolución ordenada [:cap]
Fragmento 2: La fase de ensamblaje clasifica las preferencias explícitas antes que los hechos inferidos.
Metadatos: subagrupar memorias dentro de un espacio de nombres
Los espacios de nombres indican de quién es la memoria de un registro, pero los metadatos indican de qué se trata. Dentro de sprout/ {chat_id} /long_term, una búsqueda semántica de «mis petunias se están marchitando» arrojaría todo lo que tenga un significado parecido. Para un jardinero, eso significa que su preferencia de fertilizante a partir de marzo y una nota de poda de higuera se clasifican junto con los registros que realmente importan. Además, los metadatos estructurados nos ayudan a reducir el alcance de los recuerdos antes de que lleguen al mensaje.
En
este caso, cada decisión se basa en una regla. Una clave de metadatos solo se puede filtrar en el servidor si la declaras como clave indexada. Puede obtener más información en Filtrado de memoria estructurada con metadatos en Amazon Bedrock AgentCore Memory. En este caso, sprout usa
tres claves indexadas:
IndexedKeys: # en el recurso AWS: :BedrockAgentCore: :Memory
 - Clave: escriba # para separar los tipos de registros
 Tipo: CADENA
 - Clave: número de sección de qué cama o área describe
 Tipo: CADENA
 - Clave: plantas # lo que crece allí
 Tipo: STRINGLIST
Cada entrada nombra una clave, que debe coincidir con una clave indexada para poder filtrarse, y establece ExtractionType en STRICTLY_CONSISTENT, transmitida desde el evento, o en LLM_INFERRED, extraída de la conversación. En el caso de las claves inferidas, una configuración de extracción puede restringir los valores a una lista fija. Sprout hace eso exactamente, por lo que ambas rutas de escritura crearían el mismo vocabulario y un filtro tendría el mismo significado independientemente de la parte que haya creado el registro
.
Manteniendo el turno y cerrando el bucle
Cuando el modelo responde, server.py llama a CreateEvent con el turno del usuario y el turno del asistente. Ese nuevo evento alimenta las estrategias de extracción, que enriquecen la tienda a largo plazo para la próxima vez
.
memory.create_event (
 memoryID=memory_id,
 ID de actor = chat_id,
 ID de sesión = ID de sesión,
 carga útil = [
 {'rol': 'usuario', 'contenido': user_message},
 {'rol': 'asistente', 'contenido': responder},
 ],
) # alimenta la extracción de USER_PREFERENCE/SEMANTIC/SUMMARIZATION; los errores se registran, nunca son fatales
Fragmento 3: Mantener el turno para que las estrategias de extracción puedan enriquecer la memoria a largo plazo de forma asincrónica.
La extracción es asincrónica, por lo que un hecho mencionado en esta sesión normalmente se puede recuperar en una sesión posterior. Diseñe para ese retraso: los eventos de sesión a corto plazo cubren la conversación actual y los registros a largo plazo
cubren todo lo anterior.
Preparándolo: un plan de riego personalizado
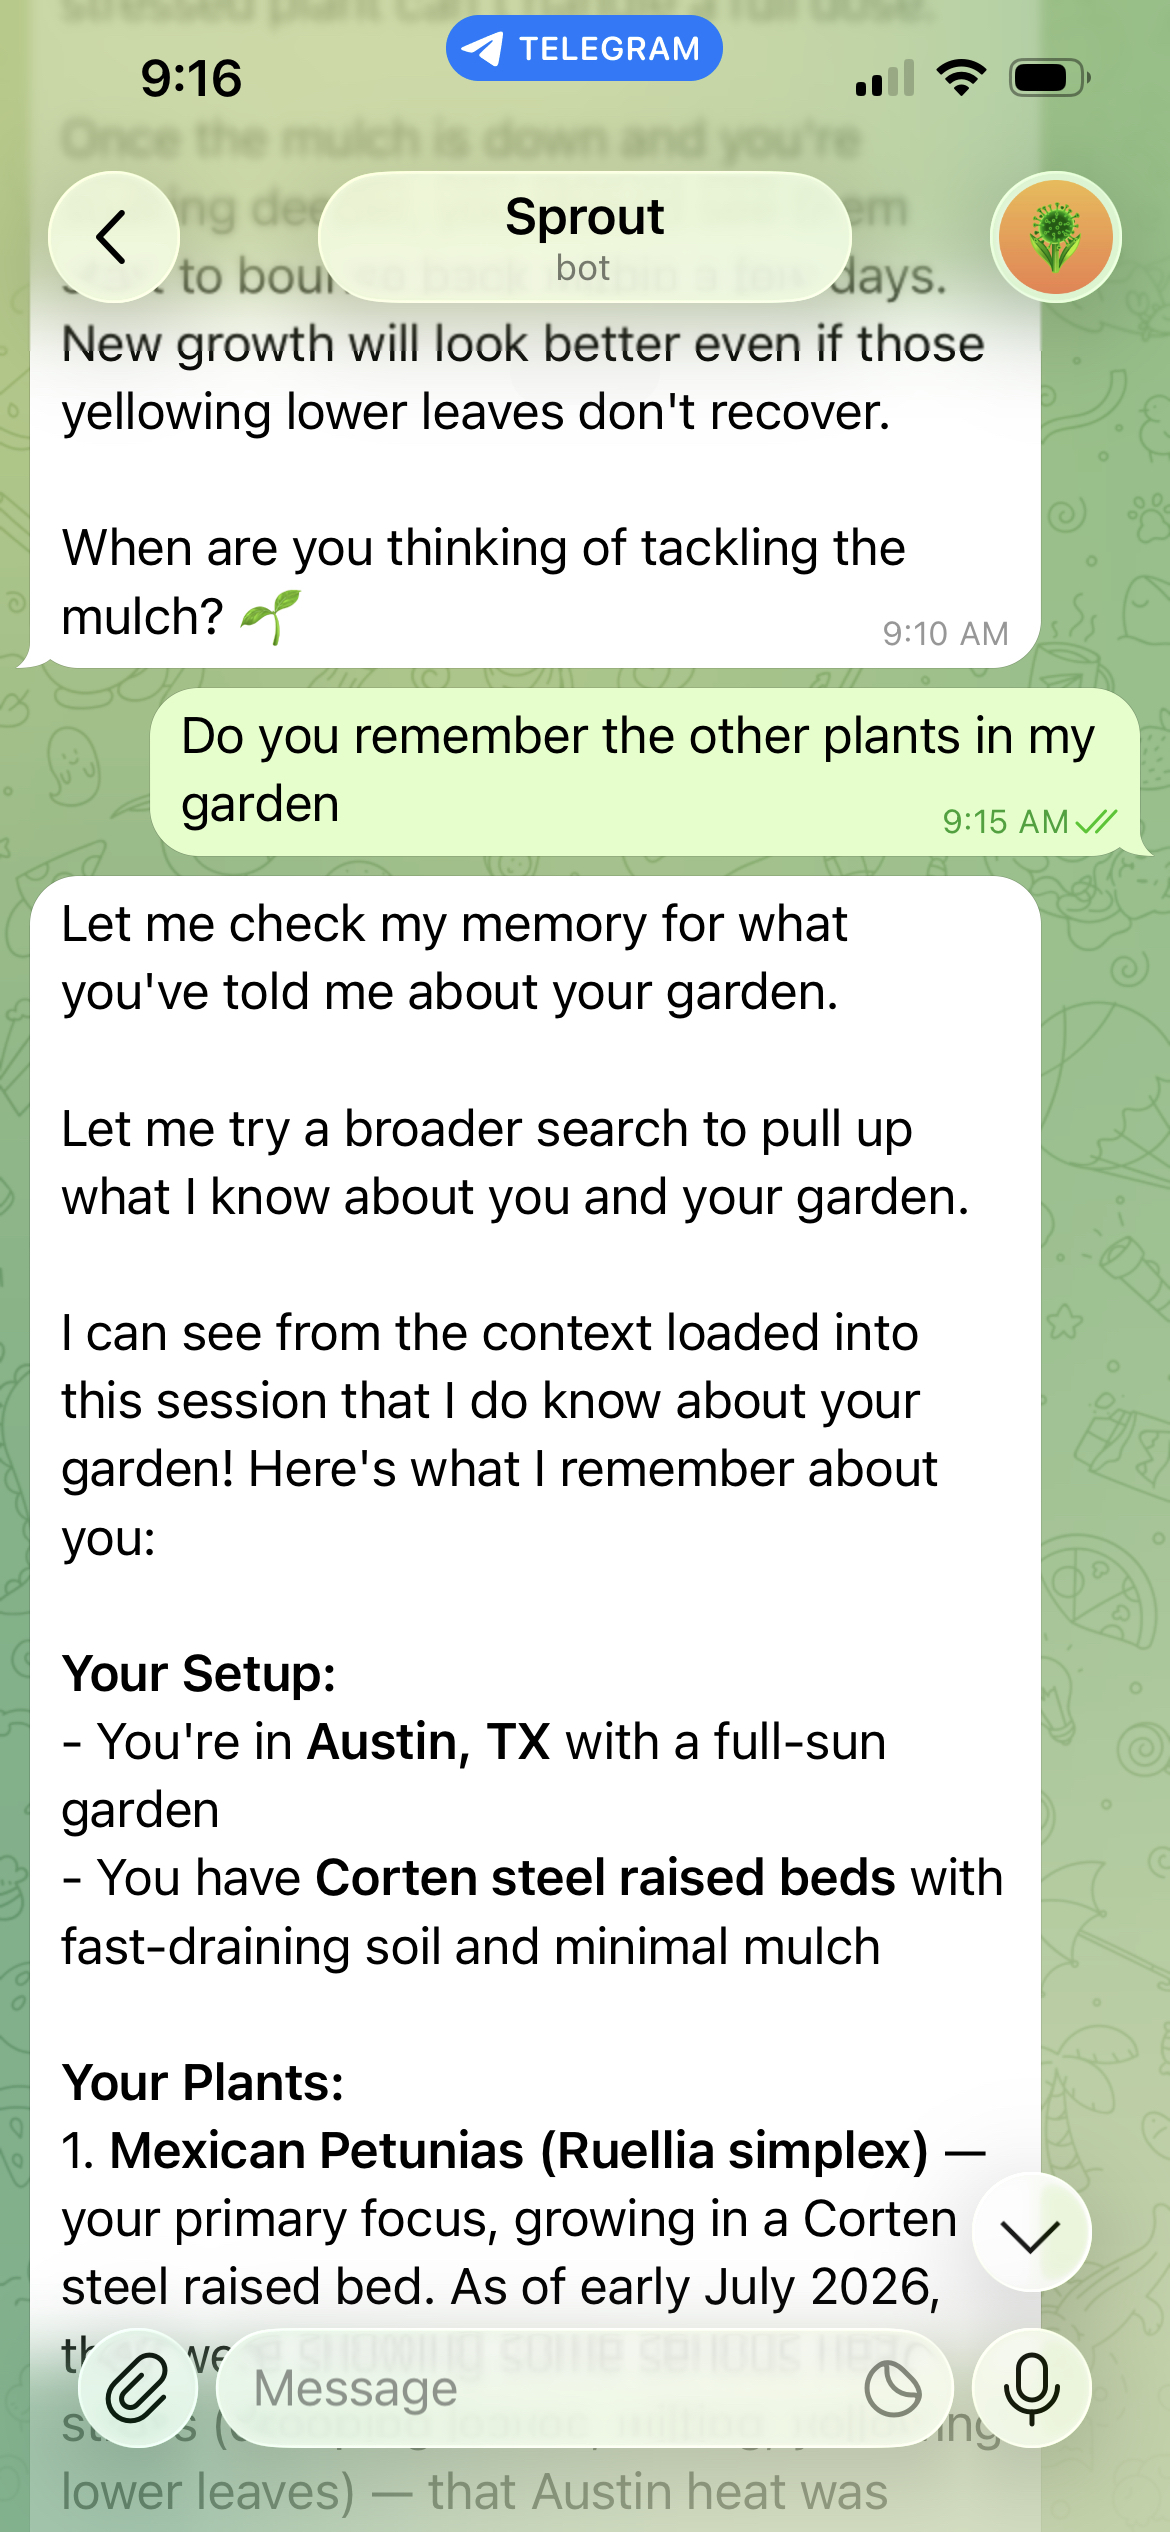
Aquí es donde todo el oleoducto funciona de principio a fin. En unas cuantas conversaciones, catalogas todo tu jardín, una planta a la vez, en un lenguaje sencillo. Cada mención se convierte en un evento. Las estrategias de extracción extraen información sobre la planta, su ubicación y su exposición al sol para convertirla en sprout/ {chat_id} /long_term. Esta mañana, el usuario hace una pregunta: «¿Recuerdas las otras plantas de mi jardín?» Retrieval recupera los registros, Assembly los clasifica y los coloca en el indicador del sistema. El asistente responde con la ubicación del usuario, la exposición al sol, la construcción de los lechos, el comportamiento del suelo y el inventario de las plantas, nada de lo cual aparece en el propio mensaje
.
Figura 2: Sprout responde a una pregunta sobre el huerto recordando el inventario de plantas almacenadas y las condiciones de cultivo
Con la habilidad programador de Amazon EventBridge → Cron path, Sprout también puede convertir ese plan en recordatorios proactivos («omita las hierbas, la tierra aún está húmeda como la de ayer») y ajustarla según las condiciones meteorológicas cuando se avecina una lluvia o una ola de calor.
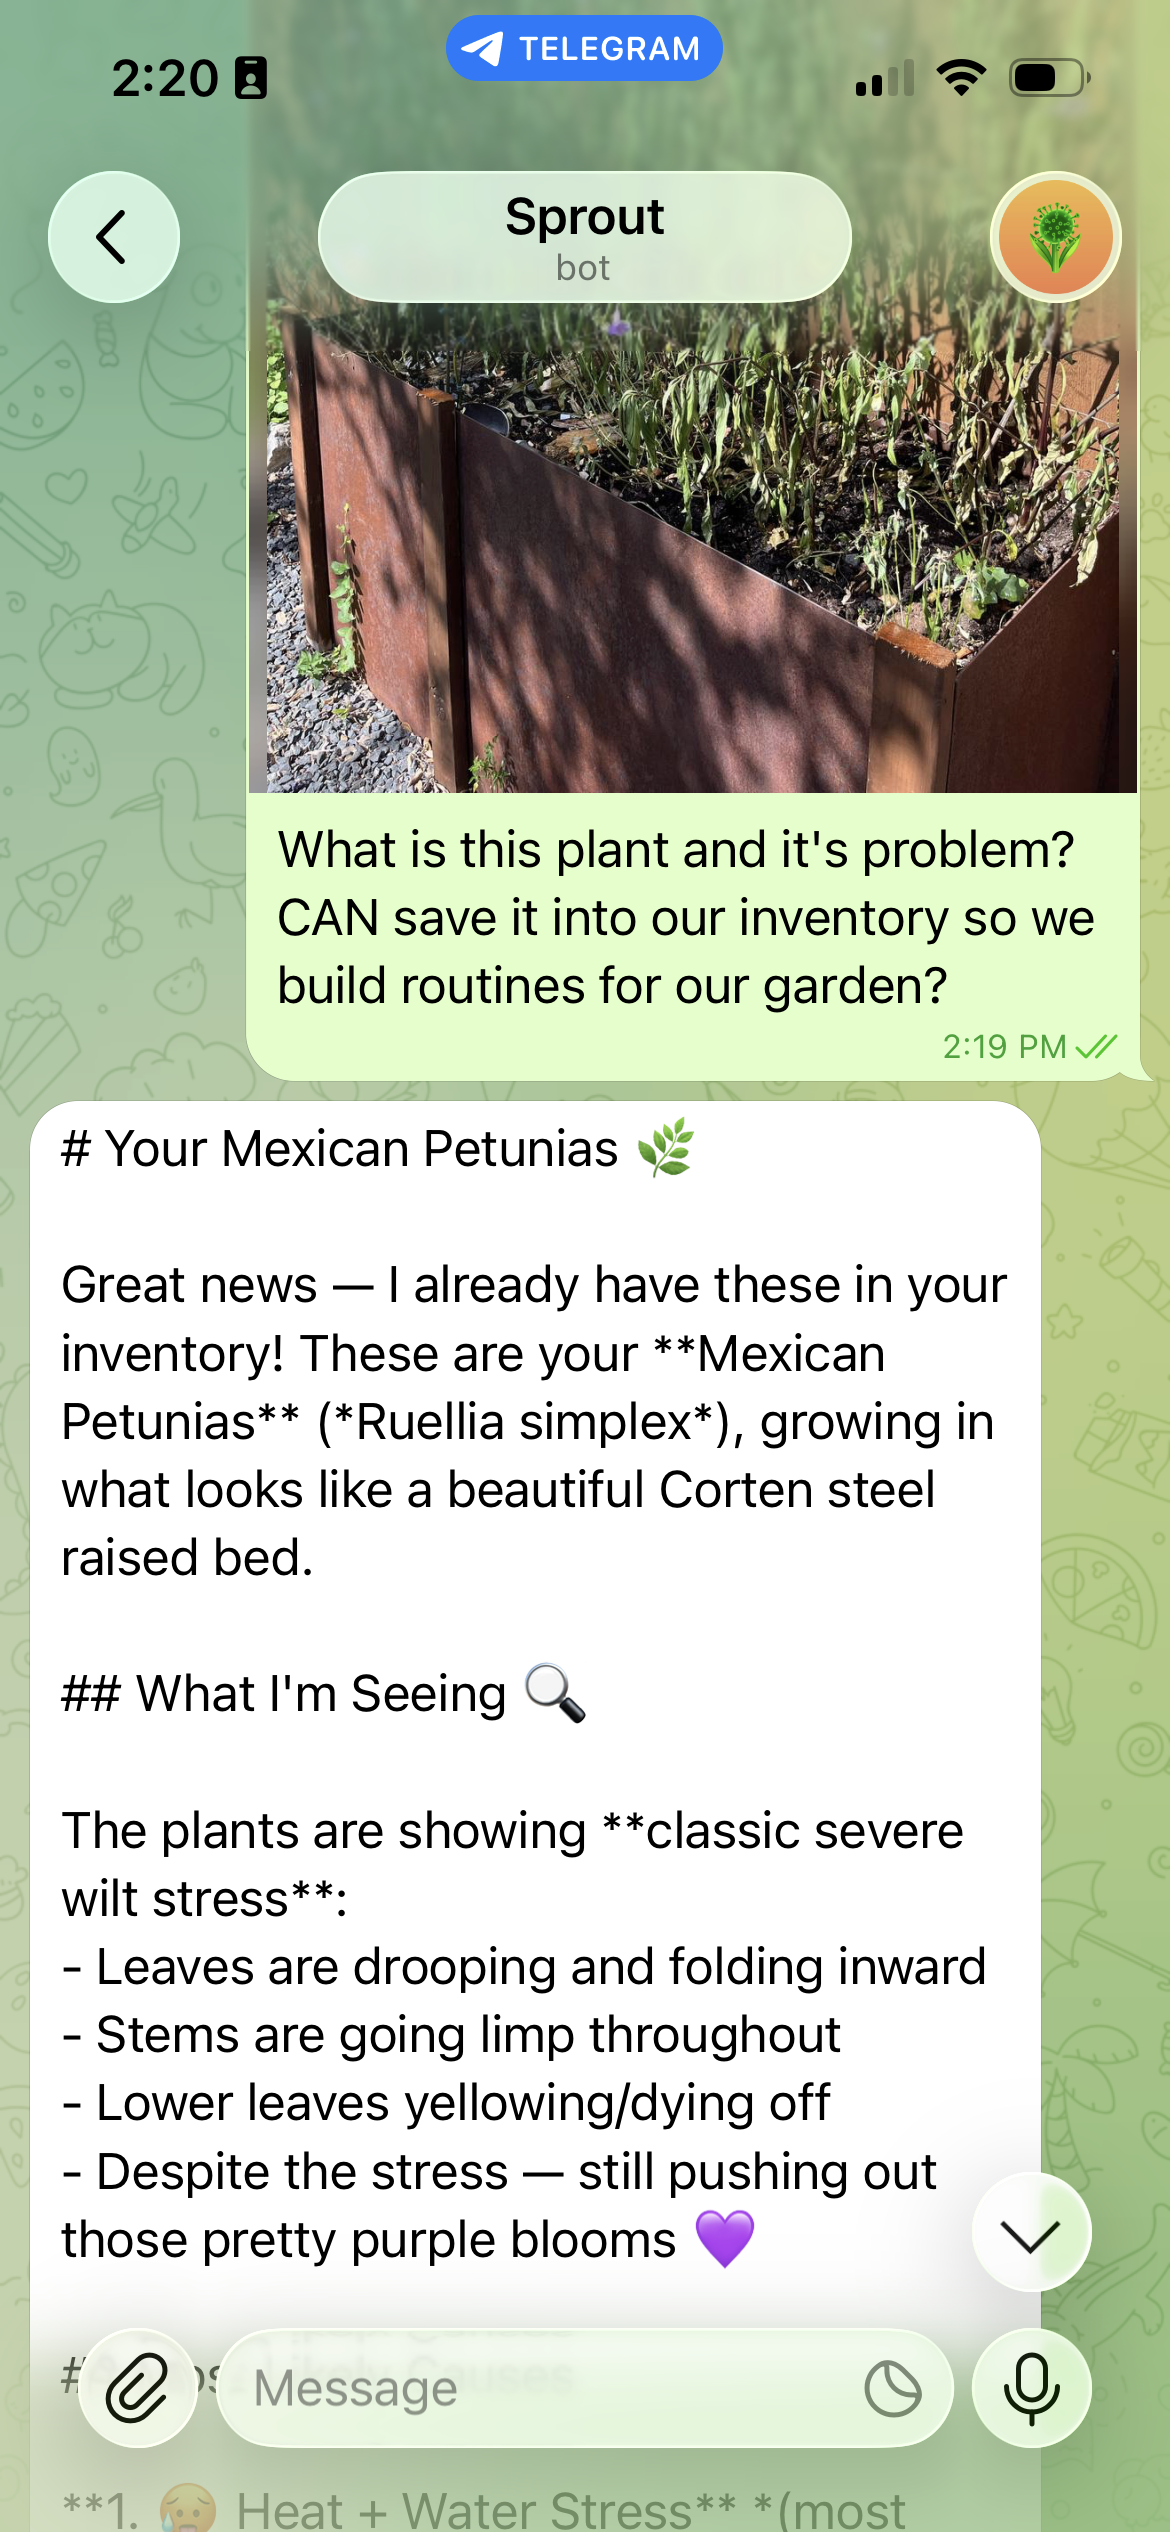
La memoria y la visión también se complementan. Cuando el usuario envía una foto de una planta marchita, la imagen pasa a Claude Sonnet 4.5, mientras que el indicador del sistema aún contiene todo lo que sabe la capa de memoria. El asistente compara la foto con las petunias mexicanas que ya están en el inventario guardado por el usuario y diagnostica el estrés causado por la marchitez en su contexto, en lugar de analizar una foto anónima de una planta en
frío.
Figura 3: Visión y memoria trabajando juntas. La foto pasa al modelo de visión, mientras que el indicador del sistema muestra el contexto del jardín almacenado por el usuario
Los modelos de visión no son infalibles. En un intercambio anterior sin el contexto del inventario, la misma planta fue identificada con seguridad como una planta luisa, una especie con flores púrpuras similares en forma de trompeta. Basar el modelo de visión en el inventario almacenado del propio usuario es lo que convirtió una suposición plausible en un diagnóstico correcto y personalizado, y es un buen ejemplo de por qué la memoria mejora la precisión y no solo el tono
.
Mantener bajos los costos de inferencia con un almacenamiento rápido en caché
Si se
inyecta memoria en cada turno, las solicitudes del sistema se agotan, y una implementación ingenua pagaría por esos tokens en cada solicitud. El almacenamiento rápido en caché en Amazon Bedrock soluciona este problema. El asistente estructura su mensaje de modo que el prefijo estable, la persona y el bloque de memoria ensamblado, ocupen el primer lugar y el mensaje volátil del usuario quede en último lugar. Bedrock almacena en caché el prefijo procesado de todas las solicitudes, de modo que los turnos repetidos dentro de una conversación omiten volver a calcular la parte que no ha cambiado. El almacenamiento rápido en caché puede reducir los costos hasta en un 90 por ciento y la latencia hasta en un 85 por ciento en los modelos
compatibles.
La regla de ordenamiento es más importante que cualquier otra configuración: poner el contenido estable en primer lugar, el contenido volátil en último lugar y mantener el orden interno del bloque de memoria determinista (lo que facilita la función de ensamblaje anterior) para que el prefijo coincida realmente entre las solicitudes.
Pautas de diseño para basarse en AgentCore y OpenClaw
Sprout es un asistente, pero las decisiones que lo sustentan son generalizadas. Si estás creando tu propio asistente a partir de esta pila, las siguientes directrices son las que aplicaríamos a cualquier dominio
.
Envuélvalo, no lo use con un tenedor. Adapte el marco de su agente al contrato de contenedor de AgentCore con un contenedor HTTP delgado en lugar de modificar el marco. El contrato es pequeño, el puerto 8080 contiene /ping y /invocations, y un contenedor
lo mantiene en la ruta de actualización del marco.
Diseñe los espacios de nombres antes de almacenar cualquier cosa. Los espacios de nombres de memoria son su límite de aislamiento. Convierte el ID de usuario en el único segmento variable y elígelo entre un ID nativo del canal en el que ya confíes, como el ID de chat. Los diseños con varios usuarios reciben con el tiempo auditorías y solicitudes de eliminación. Un esquema de espacio de nombres limpio hace que ambas cosas sean triviales
.
Trate la memoria como una mejora, nunca como una dependencia. Se debe permitir que todas las operaciones de memoria fallen correctamente. Los errores de recuperación deberían producir una respuesta sin memoria sin bloquear la respuesta. Los usuarios perdonan un giro olvidadizo con mucha más facilidad que
uno fallido.
Modelos de rutas por tarea. Utilice un modelo rápido y rentable para textos de gran volumen y reserve un modelo multimodal más sólido para los turnos que lo necesiten. Mantenga los ID del modelo en las variables de entorno para que los cambios de enrutamiento sean de configuración, no
de código.
Solicita solicitudes para la caché. La personalidad y la memoria estables primero, las entradas volátiles del usuario al final y un orden determinista en todo momento. Este hábito estructural es de donde provienen la mayoría de los ahorros de inferencia
.
Planifique la latencia de extracción. La memoria a largo plazo se extrae de forma asincrónica, así que no prometas recordar datos nuevos en la misma sesión. Deje que los eventos de la sesión a corto plazo cubran la conversación actual y los registros a largo plazo
cubran las anteriores.
Haga un presupuesto desde el primer día. Un agente basado en el consumo no es costoso hasta que un bucle de reintentos o un usuario que habla por teléfono hace lo contrario. Una alerta de AWS Budgets con el 80 por ciento y el 100 por ciento de un límite mensual no cuesta nada
y atrapa las sorpresas con antelación.
Mantenga las habilidades reducidas y con un único propósito. Una habilidad debe hacer algo que un usuario nombraría en una oración, como comprobar el tiempo o establecer un recordatorio. Las habilidades pequeñas se pueden comprobar de forma independiente, se pueden intercambiar de forma independiente y el modelo puede seleccionarlas fácilmente. Una habilidad que lo permite todo obliga al modelo a adivinar a cuál de sus
comportamientos te refieres.
Cultiva el tuyo
Dos formas de plantarlo, en el mismo jardín:
Launch Stack en un solo paso: la plantilla de CloudFormation apunta a una imagen pública de Amazon Elastic Container Registry (Amazon ECR), por lo que solo implementa un token de bot de Telegram.
Crea la tuya propia: el script scripts/ deploy.sh valida la plantilla, crea y envía tu propia imagen ARM64 a tu repositorio privado de Amazon ECR, implementa la pila y registra el webhook de Telegram para crear una compilación totalmente personalizable.
El uso personal ligero cuesta entre 5 y 9 dólares al mes en julio de 2026 (aproximadamente 2 dólares en infraestructura, entre 1 y 3 dólares en texto en Haiku y 2 dólares en Sonnet Vision), con un presupuesto de AWS integrado que alerta del 80 y el 100 por ciento del límite que establezca.
Cuando termines de experimentar, derriba todo para evitar cargas continuas. Como todo el sistema es una pila de CloudFormation, la limpieza consiste principalmente en eliminar una
sola vez:
Elimine la pila de CloudFormation. Esto elimina el agente de ejecución de AgentCore, API Gateway, las funciones de Lambda, la programación de Amazon EventBridge y las funciones asociadas de AWS Identity and Access Management
(IAM).
Elimine el almacén de memoria de AgentCore (y sus espacios de nombres) para que no se conserve ningún registro de usuario.
Elimine todas las imágenes que haya subido a su repositorio ECR privado y, si ya no es necesario, el repositorio en sí.
Elimine la alerta de presupuesto de AWS si ha creado una fuera de la pila.
Revoca el webhook de Telegram (o elimina el bot a través de BotFather) y revoca el acceso al modelo Bedrock si ya no lo necesitas.
Conclusión
El núcleo reutilizable de esta solución es un agente sin servidor en Amazon Bedrock AgentCore con un sistema de habilidades y memoria gestionada. La memoria de AgentCore elimina la necesidad de crear almacenes vectoriales y procesos de extracción personalizados y, al mismo tiempo, deja el control total sobre lo que el agente recuerda y olvida. La computación basada en el consumo y el almacenamiento rápido en caché permiten mantener un asistente realmente personalizado por unos pocos dólares al mes, y el conjunto de habilidades de OpenClaw hace que todo el patrón sea portátil en todos los dominios. La personalización también se agrava: cuanto más interactúa un usuario, más útil resulta el asistente
.
Para ir más allá, empieza con un único dominio, como los recordatorios, y amplía el alcance de la memoria de forma gradual. Explora la memoria episódica para que el agente pueda hacer referencia a conversaciones pasadas específicas («la última vez que hablamos de la higuera, decidiste dejar de usar fertilizante»), o bifurcar el repositorio, cambiar tu personalidad y habilidades y hacer crecer el asistente que necesites.
Off-the-shelf AI assistants answer individual questions well, but they fall short on a different axis: continuity. Ask a stateless assistant about your garden today and it has no idea that you mentioned your fast-draining raised beds three weeks ago, that you only use organic fertilizer, or that your petunias were struggling through a heat wave. Every conversation starts from zero, and the burden of re-explaining context falls on the user.
The problem isn’t the quality of the answers, but that the assistant has no memory of you. This post shows how to build a personal assistant that accumulates context using OpenClaw, an open source agentic system, running on AgentCore runtime, a capability of Amazon Bedrock AgentCore. AgentCore memory, a capability of Amazon Bedrock AgentCore, turns disposable chats into durable knowledge. You will also see how to tag those memories with structured metadata to retrieve records that matter for the question at hand.
Our running example is Sprout, a gardening assistant, but the architecture is domain-agnostic. Swap the persona and the skills manifest, and the same pipeline serves a support bot, a fitness coach, or an internal help desk. The entire system lives in a single AWS CloudFormation template, deploys with one command, and runs on a consumption-based model that costs a few dollars a month for light personal use. Along the way, we share design guidelines you can apply to assistants you build on this stack.
Solution overview
AgentCore is a platform to build, connect, and optimize agents at scale, with any framework or model. The following diagram shows the end-to-end request flow, from an inbound Telegram webhook through the AgentCore runtime, and its supporting AWS services.
Figure 1: Telegram webhooks and Amazon EventBridge schedules both invoke the same AgentCore runtime agent, which coordinates the OpenClaw gateway, AgentCore memory, and Amazon Bedrock
Two entry points converge on one agent. Telegram messages arrive through Amazon API Gateway and a webhook AWS Lambda function, while scheduled jobs such as morning watering reminders arrive through Amazon EventBridge Scheduler and a cronjob Lambda function. Both call the InvokeAgentRuntime API on the AgentCore runtime, where a thin server.py process coordinates the OpenClaw gateway, AgentCore memory, and the Amazon Bedrock Converse API. Amazon Simple Storage Service (Amazon S3) provides workspace storage, AWS Key Management Service (AWS KMS) handles encryption, AWS Secrets Manager holds the bot token, and Amazon CloudWatch captures logs and metrics.
Prerequisites
To deploy your own version using the Launch Stack button or scripts/deploy.sh (described in the Grow your own section), you will need:
Amazon Bedrock AgentCore access, including AgentCore runtime and AgentCore memory.
Model access granted for the models you plan to route to: Claude Haiku 4.5 for text and Claude Sonnet 4.5 for vision (or the equivalents available in your account).
Docker with linux/arm64 build support, plus the AWS Command Line Interface (AWS CLI) configured. This is needed only if you plan to build and push your own image.
A Telegram bot token (from BotFather) to serve as the assistant’s front door.
Basic familiarity with agent orchestration concepts and CloudFormation.
The architecture: A serverless agent on AgentCore runtime
Every component lives in a single CloudFormation template, and no build tooling is required to launch. The following sections walk through the load-bearing decisions.
AgentCore runtime: Pay only for active compute
The agent lives in a container on AgentCore runtime, which uses consumption-based pricing. You’re billed for the compute your agent actively consumes, not for wall-clock uptime, and you don’t pay for the time when waiting for I/O such as model response. For a personal assistant used in short bursts, that is the difference between an approximately $1–2/month baseline and an approximately $35/month always-on Amazon Elastic Compute Cloud (Amazon EC2) instance. These figures are estimates for light personal use as of July 2026. Refer to AgentCore pricing for current rates.
The runtime enforces a minimal container contract: listen on port 8080, and expose GET /ping for health and POST /invocations as the agent entry point. Our container is linux/arm64, built multi-stage from the official OpenClaw image plus a Python layer.
OpenClaw as the agent substrate
OpenClaw provides the agent loop, tool use, and a skills system. It runs a wrapper (server.py) that adapts it to AgentCore HTTP protocol contract:
On container start, server.py launches openclaw gateway run as a subprocess and health-checks it.
GET /ping returns healthy quickly, so the AgentCore readiness probe passes.
POST /invocations does the real work: parse the payload, retrieve memory, assemble context, forward the turn to the gateway, and persist the result. One callout: AgentCore can thaw a frozen container whose subprocess has exited. So invocation path doesn’t assume the gateway is alive, it calls an ensure_openclaw_ready() helper that re-checks health (and restarts the gateway if needed) before forwarding the turn.
This wrapper pattern generalizes to other use cases. Any agent framework that runs as a local process can be adapted to the AgentCore runtime the same way, without modifying the framework itself.
Two models, routed by task
Text chat and image understanding have different cost and quality tradeoffs, so the assistant routes them to different Claude models on Bedrock:
Claude Haiku 4.5 for text: Fast and cheap for the high-volume conversational turns that dominate daily use.
Claude Sonnet 4.5 for vision: Stronger multimodal reasoning for the less frequent but harder task of diagnosing a plant from a photo.
Text turns flow through the OpenClaw gateway, which brings skills and session state. Image turns call the large language model (LLM) from Bedrock directly from server.py, passing the image bytes as multimodal content blocks. We route images around the gateway deliberately: the in-container OpenClaw build dropped the image_url content parts before they reached Bedrock, so calling the Converse API directly from server.py makes sure the model sees the actual pixels. Both paths share the same system prompt (persona plus memory), so the experience stays consistent.
The model IDs are environment variables (MODEL_ID, VISION_MODEL_ID), so you can swap models per deployment without rebuilding the image.
Skills as the reusable capability unit
Capabilities are declared as skills in a community-skills.json manifest. A deploy-time script materializes them into the container and registers them in the OpenClaw config before the image is built. Sprout ships with weather, reminders, and plant notes skills at the time of publishing this post. Swap the manifest and the same pipeline serves a different domain. This is what makes the whole thing a reusable pattern and not only one bot.
Telegram as the serverless front door
Telegram is a practical channel for a personal assistant since it’s webhook-based, and it keeps everything serverless. It requires no client development, works on every device the user already owns, and supports text, images, and rich formatting through a straightforward bot API. BotFather issues a bot token, which is stored in Secrets Manager. The deployment registers a webhook that points Telegram at the API gateway endpoint. When the user sends a message, Telegram delivers it to the webhook Lambda function to validate the payload and call InvokeAgentRuntime. The reply travels back through the telegram bot API.
One formatting lesson to note: Telegram’s legacy markdown model is unforgiving about unescaped characters and a single stray underscore in a model response can make the whole message fail to send. Rendering replies as HTML is reliable so the assistant converts model output to Telegram-safe HTML before sending.
Memory: Turning disposable chats into durable knowledge
The architecture described so far is a capable, cheap, serverless agent, but on its own it still forgets you between conversations. Memory is what changes that. Imagine mentioning weeks ago that you garden organically, and today the assistant recommends a treatment and adds, on its own, that it picked the organic option because you don’t use synthetic fertilizer. A stateless model can’t do that.
The mental model: Short-term events, long-term extraction
AgentCore memory has two layers. Short-term memory stores every conversation turn as an event through CreateEvent, keyed by actorId (the Telegram chat ID) and sessionId. This is the raw transcript. Long-term memory is produced asynchronously by managed extraction strategies into durable, structured records. We configured three strategies:
USER_PREFERENCE: explicit choices the gardener stated (“I only use organic fertilizer”).
SEMANTIC: inferred facts (“grows Mexican petunias in a Corten steel raised bed”).
SUMMARIZATION: episodic session summaries (“discussed yellowing lower leaves during a heat wave”).
Namespaces: One garden per gardener
Sprout files records into per-user namespaces, so no two chats ever mix:
sprout/{chat_id}/long_term: preferences and semantic facts.
The chat ID is the only variable segment, which makes isolation straightforward to reason about and to test: each unique gardener maps to exactly one namespace, and no two gardeners collide.
The retrieval, assembly, and injection pipeline
On every turn, the agent retrieves the relevant long-term records, ranks them, and injects them into the system prompt. Here is what happens on every single message, inside server.py:
Retrieve. Call RetrieveMemoryRecords against sprout/{chat_id}/long_term, using the user’s message as the search query, capped at 50 results, under a 3-second budget. If retrieval times out or errors, we degrade gracefully and answer without memory rather than failing.
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
Snippet 1: Retrieving long-term records for the current turn (representative. See the repo for full source).
Assemble function adds additional custom logic. We want the explicit preferences to rank ahead of inferred facts, order is stable within each class, and the result is capped before injection:
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
Snippet 2: The assembly step ranks explicit preferences before inferred facts.
Metadata: Subgrouping memories inside a namespace
Namespaces answer whose memory a record is, but metadata answers what it’s about. Inside sprout/{chat_id}/long_term, a semantic search for “my petunias are wilting”, would return everything that is close in meaning. For a gardener, that means a fertilizer preference from March, and a fig tree pruning note are ranked alongside records that actually matter. And structured metadata helps us narrow down the scope of memories before it reaches the prompt.
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
    Type: STRINGLIST
Each entry names a key, which must match an indexed key to be filterable, and sets extractionType to either STRICTLY_CONSISTENT, passed through from the event, or LLM_INFERRED, extracted from the conversation. For inferred keys, an extraction configuration can restrict values to a fixed list. Sprout does that exactly, so both write paths would create the same vocabulary and a filter means the same thing regardless of which part created the record.
Persisting the turn and closing the loop
After the model responds, server.py calls CreateEvent with both the user turn and the assistant turn. That new event feeds the extraction strategies, which enrich the long-term store for next time.
Snippet 3: Persisting the turn so the extraction strategies can enrich long-term memory asynchronously.
Extraction is asynchronous, so a fact mentioned in this session typically becomes retrievable in a later one. Design for that delay: short-term session events cover the current conversation, and long-term records cover everything before it.
Putting it together: A personalized watering plan
Here is where the full pipeline works end-to-end. Over a few conversations you catalog your whole garden, one plant at a time, in plain language. Each mention becomes an event. The extraction strategies extract information about the plant, its location, and its sun exposure into sprout/{chat_id}/long_term. This morning the user asks a question, “Do you remember the other plants in my garden?” Retrieval pulls the records back, assembly ranks them, and they ride into the system prompt. The assistant answers with the user’s location, sun exposure, bed construction, soil behavior, and plant inventory, none of which appeared in the message itself.
Figure 2: Sprout answers a question about the garden by recalling the stored plant inventory and growing conditions
Using the scheduler skill on the Amazon EventBridge → Cron path, Sprout can also turn that plan into proactive reminders (“skip the herbs, the soil is still damp from yesterday”) and adjusts them against the weather skill when rain or a heat wave is coming.
Memory and vision also compound each other. When the user sends a photo of a wilting plant, the image goes to Claude Sonnet 4.5 while the system prompt still carries everything the memory layer knows. The assistant matches the photo to the Mexican petunias already in the user’s saved inventory and diagnoses wilt stress in context rather than analyzing an anonymous plant photo cold.
Figure 3: Vision and memory working together. The photo goes to the vision model while the system prompt carries the user’s stored garden context
Vision models aren’t infallible. In an earlier exchange without the inventory context, the same plant was confidently identified as a morning glory, a species with similar trumpet-shaped purple flowers. Grounding the vision model with the user’s own stored inventory is what turned a plausible-sounding guess into a correct, personalized diagnosis, and it is a good illustration of why memory improves accuracy and not only tone.
Keeping inference costs low with prompt caching
Injecting memory into every turn makes the system prompt large, and a naive implementation would pay for those tokens on every request. Prompt caching on Amazon Bedrock addresses this. The assistant structures its prompt so that the stable prefix, the persona and the assembled memory block, comes first and the volatile user message comes last. Bedrock caches the processed prefix across requests, so repeated turns within a conversation skip recompute of the unchanged portion. Prompt caching can reduce costs by up to 90 percent and latency by up to 85 percent for supported models.
The ordering rule matters more than any single setting: put stable content first, volatile content last, and keep the memory block’s internal ordering deterministic (which the preceding assembly function facilitates) so the prefix actually matches between requests.
Design guidelines to build on AgentCore and OpenClaw
Sprout is one assistant, but the decisions behind it generalize. If you’re building your own assistant on this stack, the following guidelines are the ones we would carry to any domain.
Wrap, don’t fork. Adapt your agent framework to the AgentCore container contract with a thin HTTP wrapper rather than modifying the framework. The contract is small, port 8080 with /ping and /invocations, and a wrapper keeps you on the framework’s upgrade path.
Design namespaces before you store anything. Memory namespaces are your isolation boundary. Make the user ID the only variable segment, and choose it from a channel-native ID you already trust, such as the chat ID. Multi-tenant designs get audits and deletion requests eventually. A clean namespace scheme makes both trivial.
Treat memory as an enhancement, never a dependency. Every memory operation should be allowed to fail gracefully. Retrieval failures should produce a memoryless answer without blocking the reply. Users forgive a forgetful turn far more readily than a failed one.
Route models by task. Use a fast, cost-effective model for high-volume text and reserve a stronger multimodal model for the turns that need it. Keep model IDs in environment variables so routing changes are configuration, not code.
Order prompts for the cache. Stable persona and memory first, volatile user input last, deterministic ordering throughout. This one structural habit is where most of the inference savings come from.
Plan for extraction latency. Long-term memory is extracted asynchronously, so don’t promise same-session recall of new facts. Let short-term session events cover the current conversation and long-term records cover prior ones.
Put a budget on it from day one. A consumption-based agent is inexpensive until a retry loop or a chatty user makes it otherwise. An AWS Budgets alert at 80 percent and 100 percent of a monthly cap costs nothing and catches surprises early.
Keep skills small and single-purpose. A skill should do one thing a user would name in a sentence, such as check the weather or set a reminder. Small skills are independently testable, independently swappable, and easy for the model to select correctly. A do-everything skill forces the model to guess which of its behaviors you meant.
Grow your own
Two ways to plant it, same garden:
Single-step Launch Stack: the CloudFormation template points at a public Amazon Elastic Container Registry (Amazon ECR) image, so it deploys nothing but a Telegram bot token.
Build your own: The scripts/deploy.sh script validates the template, builds and pushes your own ARM64 image to your private Amazon ECR repository, deploys the stack, and registers the Telegram webhook, for a fully customizable build.
Light personal use runs about $5–9/month as of July 2026 (roughly $2 infrastructure, $1–3 Haiku text, $2 Sonnet vision), with a built-in AWS Budget that alerts at 80 percent and 100 percent of a cap you set.
When you are done experimenting, tear everything down to avoid ongoing charges. Because the whole system is one CloudFormation stack, cleanup is mostly a single delete:
Delete the CloudFormation stack. This removes the AgentCore runtime agent, API Gateway, the Lambda functions, the Amazon EventBridge schedule, and the associated AWS Identity and Access Management (IAM) roles.
Delete the AgentCore memory store (and its namespaces) so no user records are retained.
Delete any images you pushed to your private ECR repository, and the repository itself if it’s no longer needed.
Remove the AWS Budget alert if you created one outside the stack.
Revoke Telegram’s webhook (or delete the bot through BotFather), and revoke Bedrock model access if you no longer need it.
Conclusion
The reusable core of this solution is a serverless agent on Amazon Bedrock AgentCore with a skills system and managed memory. AgentCore memory removes the need to build custom vector stores and extraction pipelines while leaving you full control over what the agent remembers and forgets, consumption-based compute plus prompt caching keeps a genuinely personalized assistant at a few dollars a month, and the OpenClaw skills manifest makes the whole pattern portable across domains. Personalization also compounds: the more a user interacts, the more useful the assistant becomes.
To go further, start with a single domain such as watering reminders and expand memory scope incrementally, explore episodic memory so the agent can reference specific past conversations (“last time we discussed the fig tree, you decided to hold off on fertilizer”), or fork the repository, swap in your own persona and skills, and grow whatever assistant you need.
To learn more, refer to the AgentCore documentation. The following related posts cover the building blocks in more depth: