
La estrella polar
Todas las organizaciones que se apresuran a utilizar agentes de inteligencia artificial se enfrentan al mismo problema: un agente que haga demostraciones de forma atractiva puede perder terreno en la producción y, cuando un humano se dé cuenta, la confianza ya está rota. Cuando el software tradicional falla con fuerza, los agentes fallan suavemente. Devolven una respuesta que parece segura, que se lee con fluidez y que es incorrecta. Cuando esa respuesta impulsa una decisión empresarial real, el costo no es una característica fallida. Es una relación rota con el usuario.
Ese es el problema de calidad en su esencia. Por lo tanto, el desafío no consiste en crear agentes que funcionen una vez, sino en demostrar que siguen funcionando, a escala, en todos los subagentes, todos los flujos de trabajo y todas las versiones. Los equipos que ganen la era de los agentes serán los que traten la calidad no como un paso final de control de calidad, sino como el sistema operativo del propio agente: se mide de forma continua, se defiende automáticamente y se mejora con cada interacción. En este artículo, mostramos cómo creamos un ciclo de calidad continuo para soluciones de agencia listas para la producción a gran escala con Amazon Bedrock
AgentCore.Problema empresarial
La solución utiliza Amazon Bedrock AgentCore y otros servicios de AWS para uso interno, por lo que los vendedores y los líderes de ventas pueden hacer preguntas empresariales en inglés sencillo desde Amazon Quick. Esta experiencia única se basa en la colaboración de varios subagentes especializados: el agente Performance Insights para obtener ingresos y rendimiento por territorio, el agente Customer Insights para obtener información sobre los clientes, el agente Data Insights para convertir texto a SQL en conjuntos de datos básicos y el acceso directo a los paneles de control. Las respuestas se basan en el territorio de cada usuario y en la seguridad a nivel de función. Los equipos de campo utilizan estas respuestas para planificar la estrategia de cuentas y prepararse para las reuniones con los clientes, por lo que las cifras deben ser correctas. La falla más dañina no es un accidente. Es una respuesta fluida y segura que es rotundamente errónea. Antes del lanzamiento, cuando evaluamos al agente de Customer Insights, descubrimos exactamente lo siguiente:
- Reportó 410,08 dólares de los ingresos de un cliente en tres meses por un servicio como «410,08 millones de dólares».
- Declaró los ingresos por ventas etiquetados como ingresos por ventas, excluyendo los ajustes.
- Ofrecía una estimación de ingresos recurrentes anuales que no aparecía en ninguna parte de los datos.
- Presentó sus propios cálculos como datos fuente.
A lo largo de las diferentes tandas, el monitoreo se mantuvo en verde. Nos dijo que el sistema había respondido, no si la respuesta era correcta.
Si estos errores se hubieran enviado sin ser detectados, el campo los habría pagado. Un vendedor que repite una cifra exagerada puede perder credibilidad ante el cliente. Esta es exactamente la razón por la que lo capturamos antes del lanzamiento. El riesgo no termina con el lanzamiento: aumenta con cada nuevo agente y con cada cambio en los datos, las instrucciones, el código o los modelos. También crece sin ningún lanzamiento, ya que las canalizaciones iniciales actualizan los datos cada semana. Las publicaciones coordinadas presentan un riesgo relacionado: cuando un cambio de datos, un cambio de herramienta y una actualización rápida combinada tienen que funcionar juntos pero se separan, el sistema funciona de forma no coincidente hasta que todos los cambios se pongan al día. En una prueba de preproducción, ese margen de desajuste por sí solo hizo que la tasa de aprobación pasara del 78 por ciento al 38 por ciento. Para detectar errores como estos, antes de cada lanzamiento y de forma continua en producción, necesitamos un marco que pueda demostrar si las respuestas están fundamentadas y son correctas, y rastrear cada error hasta su causa raíz en los datos, el mensaje o el código del agente
.En AWS, el equipo de operaciones de ventas, marketing y servicios globales (SMGS) desarrolló un sistema multiagente de producción para las ventas de campo de AWS en todo el mundo. Está dirigido a dos públicos distintos. En el caso de los equipos de ventas sobre el terreno, sustituye horas de análisis manual de datos por inteligencia conversacional bajo demanda, lo que ayuda a los vendedores a comprender el estado de su negocio, detectar los riesgos y las oportunidades y tomar medidas con mayor rapidez. En el caso de los directivos, impulsa los ritmos de gestión empresarial, incluidas las revisiones empresariales semanales (WBR), lo que permite detectar las señales importantes en toda la cartera sin necesidad de preparar informes manualmente. El mismo sistema de agencia sirve tanto para el vendedor que está en primera línea como para el líder que revisa el desempeño a gran
escala.El sistema de agencias organiza una cartera cada vez mayor de subagentes especializados, cada uno de los cuales posee un dominio de capacidades distinto. Entre ellas, el Performance Insights Agent genera narrativas de inteligencia empresarial en lenguaje natural a partir de datos de ventas complejos, lo que convierte las métricas sin procesar en información útil sobre los vendedores. El agente de Customer Insights recopila una visión de 360 grados de cada cliente al sintetizar las señales relacionadas con el uso del producto, el historial de soporte, el estado del contrato y los datos de interacción, lo que ayuda a los vendedores a comprender en qué punto se encuentra un cliente y qué es lo que necesita a continuación. El Data Insights Agent es un agente de conversión de texto a SQL que los equipos de cuentas utilizan para consultar datos de análisis estructurados en un lenguaje sencillo sin escribir ni una sola línea de código SQL. Estos tres agentes son a los que se hace referencia en el resto de
esta publicación. Lacoordinación de estos agentes de manera confiable y a escala dejó una cosa clara: la calidad de los agentes no era un problema operativo que tuviera que gestionar más adelante. Era el requisito previo para operar. Un solo subagente degradado puede dañar silenciosamente todas las respuestas posteriores, y la supervisión tradicional no lo detectará. Esa realidad hizo que un marco de evaluación del ciclo de vida completo no fuera opcional sino necesario. AgentCore Evaluations, una capacidad de Amazon Bedrock AgentCore, es el tejido conectivo que lo impulsa, junto con Amazon Bedrock Guardrails (seguridad), Amazon CloudWatch (métricas, alarmas, rastreo), Amazon Simple Storage Service (Amazon S3) y Amazon Redshift (persistencia de la evaluación), Amazon Quick (paneles) y AWS Lambda (evaluadores personalizados)
.En esta publicación, explicamos cómo abordamos los desafíos operativos más difíciles a la hora de gestionar agentes de IA a escala empresarial y cómo las evaluaciones de Amazon Bedrock AgentCore se convirtieron en la piedra angular de la calidad de los agentes. En concreto, cubrimos
:- Los agentes siguen reglas diferentes: por qué los agentes exigen una disciplina operativa diferente y por qué la supervisión tradicional (latencia, tasas de error, tiempo de actividad) hace que no sepa cuáles son las fallas más importantes.
- Un mapa para todo el proceso: el marco de evaluación de nueve etapas que creamos a partir de las evaluaciones de AgentCore, que abarca todas las fases del ciclo de vida del desarrollo de los agentes, desde la primera contratación hasta la producción.
- De la teoría a la práctica: patrones concretos (integración continua y entrega continua (CI/CD), compuertas de regresión, puntuación canaria, detección de desviaciones y ciclos de retroalimentación automatizados) y cómo las evaluaciones de AgentCore impulsan cada uno de ellos.
- Métricas que realmente importan: el impacto cuantificable en la confianza en la implementación, la prevención de la regresión y la velocidad de iteración en toda nuestra cartera de agentes.
Por qué los agentes necesitan un marco de evaluación estructurado
El software tradicional es determinista: la misma entrada produce la misma salida. Los modelos de aprendizaje automático (ML) introdujeron resultados probabilísticos y surgieron los MLOP para gestionar su entrenamiento, control de versiones, supervisión y reentrenamiento. Los agentes de IA añaden un tercer nivel de complejidad operativa: el razonamiento autónomo de varios pasos, en el que la pregunta pasa de «¿se ha estropeado algo?» a «¿el agente está tomando decisiones acertadas a lo largo de toda su cadena de razonamiento?»
Los agentes heredan los difíciles problemas de ambos predecesores e introducen algunos nuevos. No son deterministas y siguen diferentes caminos de razonamiento para entradas idénticas. Toman decisiones en cascada sobre el enrutamiento, la selección de herramientas y la síntesis, por lo que un solo paso puede fallar silenciosamente y corromper todo en el proceso posterior. Lo que es más importante, se degradan de forma silenciosa: la latencia se mantiene baja, las tasas de error se mantienen estables y, sin embargo, la calidad de la respuesta de los agentes se erosiona porque el agente sigue respondiendo.
Simplemente responde mal. Laevaluación de los agentes es la práctica de detectar exactamente eso. Abarca cinco dimensiones: la seguridad (¿se comporta dentro de unos límites definidos?) , calidad (¿el agente produce respuestas correctas, coherentes y fundamentadas?) , el rendimiento (¿es lo suficientemente rápido y fiable?) , el costo (¿funciona de manera eficiente a escala?) y el control operativo (¿podemos detectar, diagnosticar y solucionar los problemas con rapidez?). Una práctica de evaluación madura aborda cinco de forma continua, a lo largo de todo el ciclo de vida del agente
.En esta publicación, explicamos cómo operacionalizamos cinco dimensiones de evaluación en un sistema multiagente de producción. La seguridad y la protección son nuestra primera prioridad. No se envía ningún agente y ningún agente sigue corriendo si no cumple con los requisitos de seguridad. La calidad es la que más espacio ocupa en esta publicación porque es la más difícil de las cinco y es la que más se beneficia de un marco dedicado, pero no supera a la seguridad. El rendimiento, los costos y el control operativo están integrados en cada etapa del ciclo de vida, al igual que en ambas. Fundamentalmente, este marco se aplica a todos los niveles de la jerarquía de agentes. A nivel de herramienta, cada capacidad (una herramienta de desambiguación de clientes o una herramienta de recuperación de gráficos) tiene su propio contrato de evaluación. A nivel de agente, cada subagente se evalúa de principio a fin. En el nivel de múltiples agentes, las rutas de orquestación se evalúan para garantizar la coherencia, el enrutamiento correcto y la precisión de la síntesis más allá
de los límites de los agentes.Las nueve etapas se aplican en tres niveles simultáneamente y esta jerarquía no es específica de este producto. Es el modelo mental adecuado cuando creamos o integramos nuevos agentes de producción. La mayoría de los equipos comienzan evaluando a nivel de agente y terminan ahí. Sin embargo, la calidad a nivel de los agentes depende de las herramientas en las que se basan, y los sistemas con varios agentes presentan una tercera superficie de fallo que ninguno de los niveles puede detectar por sí solo. Una práctica de evaluación sólida abarca tres niveles: cada nivel tiene su propio conjunto de oro, sus propios evaluadores y sus propios criterios de promoción a
lo largo de las nueve etapas.El marco de evaluación de los agentes: nueve etapas, un ciclo cerrado
Estas nueve etapas trazan el ciclo de vida de los agentes desde la primera confirmación hasta la producción activa, y cada una responde a una pregunta a la que se enfrentan los equipos a medida que sus agentes maduran.
El ciclo de vida de los agentes y las nueve preguntas habituales
Todos los agentes de producción que forman equipos se enfrentan a las siguientes preguntas a medida que su agente madura:
Etapa 1: La Fundación: «¿Qué aspecto tiene lo bueno?»
Etapa 2: El experimento: «¿Qué versión es mejor?»
Etapa 3: La fusión (CI): «¿He roto algo?»
Etapa 4: The Gate (CD): «¿Es seguro para la producción?»
Etapa 5: The Canary: «¿Algo se rompió silenciosamente?»
Etapa 6: El adversario: «¿Y si alguien intenta romperlo?»
Etapa 7: The Drift: «¿La calidad está a la deriva en directo?»
Etapa 8: The Pulse: «¿Cómo sabemos que está funcionando ahora mismo?»
Etapa 9: El ciclo de retroalimentación: «¿Cómo mejora automáticamente?»
Creamos un marco para cada etapa del ciclo de vida de los agentes mediante las evaluaciones de AgentCore. Las nueve etapas no son herramientas independientes que se unen a posteriori.
Son nueve puntos en una única superficie de evaluación continua, impulsada por las evaluaciones de AgentCore desde la primera confirmación hasta la respuesta de producción, como se muestra en la figura 1.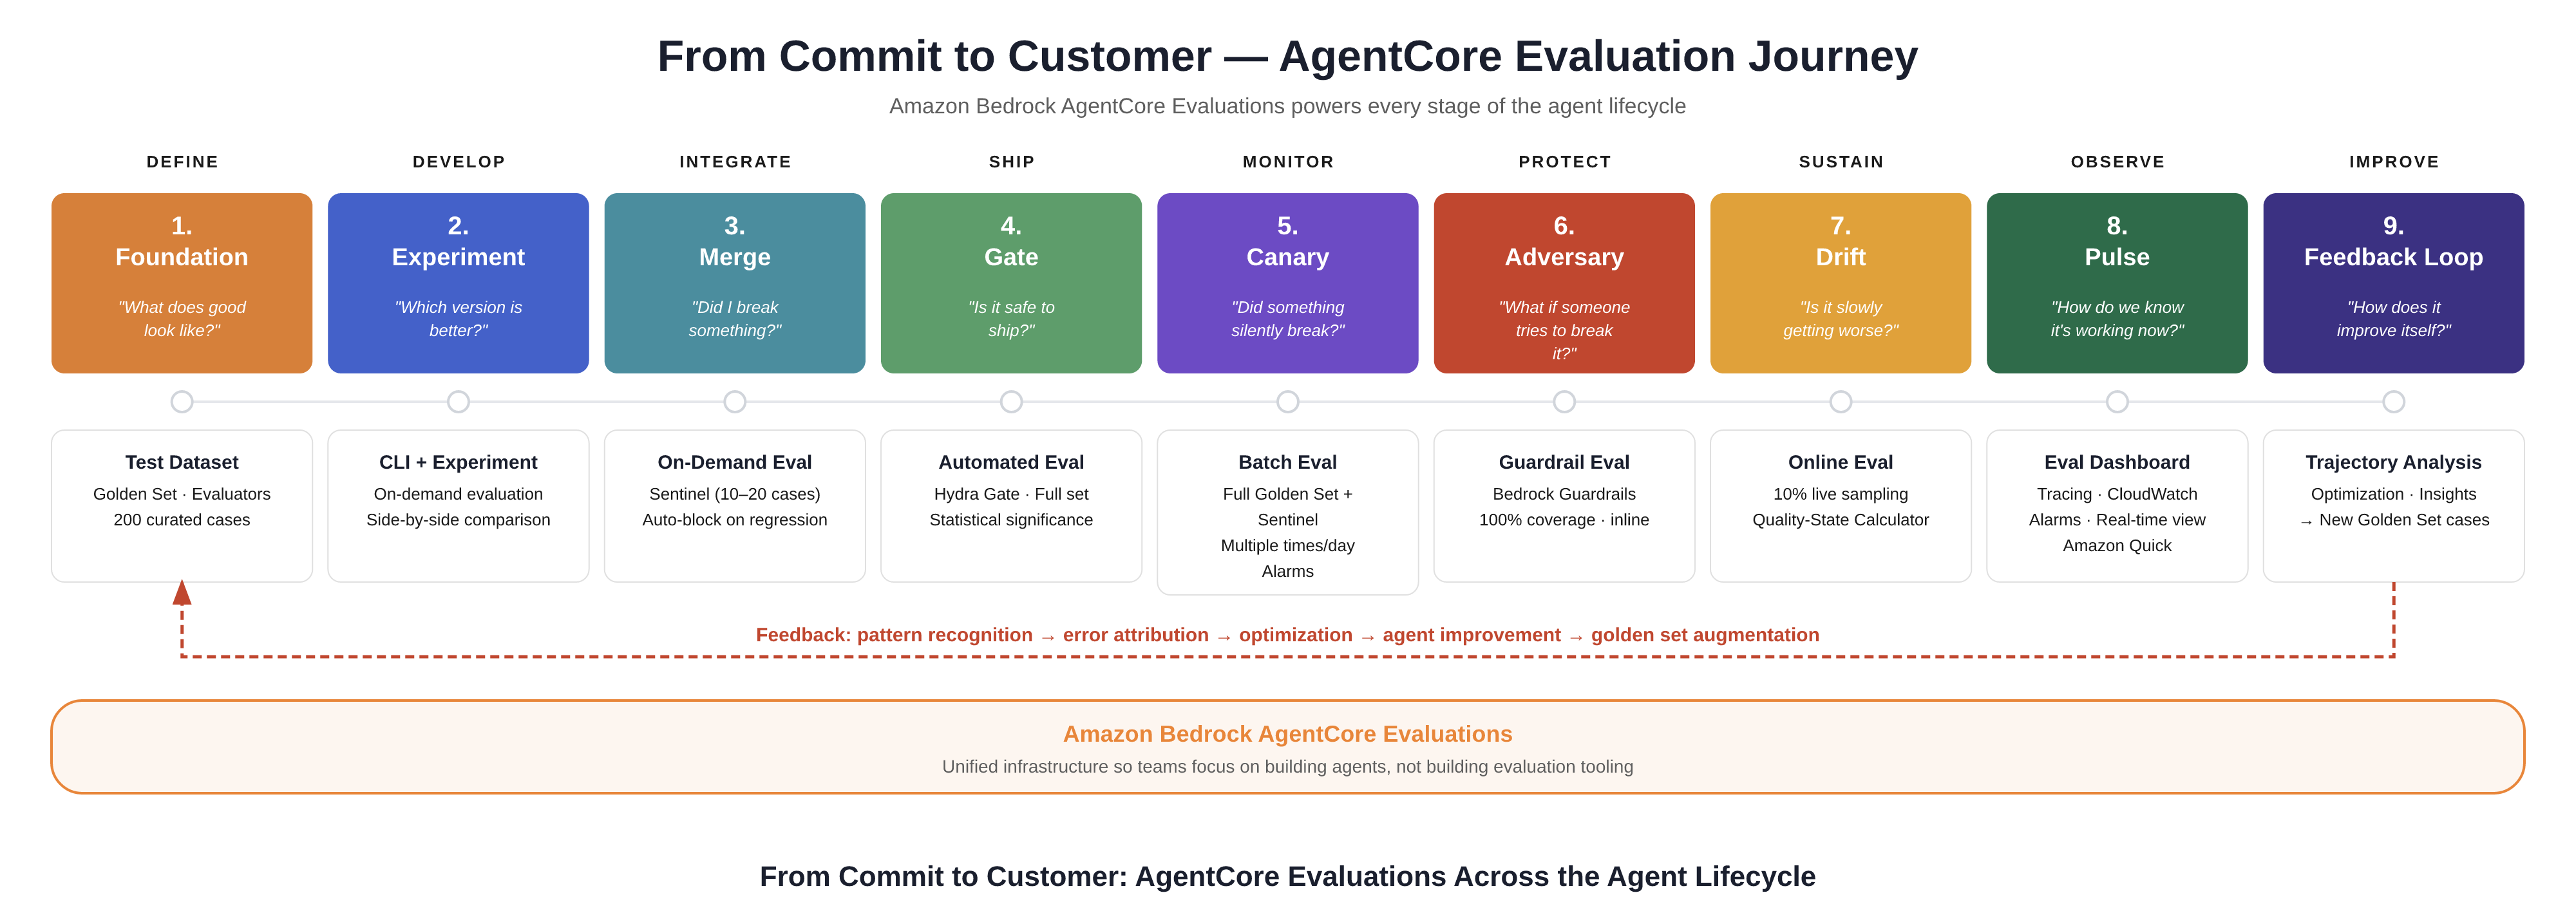
Figura 1: El proceso de evaluación de AgentCore en nueve etapas, desde Definir hasta Improve
Así es como abordamos cada una de ellas: el patrón que funciona, los servicios de AgentCore que las respaldan y cómo funciona en producción, como se muestra en el diseño del sistema en la figura 2.

Figura 2: Diseño del sistema del marco de evaluación de AgentCore
Etapa 1: La base. Defina la calidad
La base de la evaluación de un agente no consiste en elegir las herramientas adecuadas. Se trata de hacerse la pregunta correcta: ¿qué significa el éxito para este agente y cómo sabemos si está fallando? La respuesta debe provenir del cliente, no del modelo. Se trata de un proceso iterativo. Nuestra definición de éxito se ha ido perfeccionando a medida que observamos lo que el agente hace realmente en la producción. Todo lo que se define aquí (los umbrales de fallo, la lista de evaluadores, el conjunto dorado, las normas de seguridad, los presupuestos de latencia y los objetivos de costes) es el contrato que se aplica en cada etapa posterior. Si la fase 1 es vaga, todos los que se encuentran aguas abajo están haciendo conjeturas
.Etapa 1.1: Defina primero las métricas de su negocio. Comience por preguntar qué es lo que el agente puede ofrecer. Los dos usuarios finales definen el éxito de manera diferente:
- Para los vendedores, el éxito significa iniciar una conversación con el cliente con información precisa y actualizada, con el nivel de detalle adecuado y en el momento adecuado.
- Para los directivos, el éxito se basa en la elaboración de informes fiables para realizar revisiones semanales y transversales sin necesidad de una larga preparación manual. Se trata de resultados empresariales, no de propiedades del modelo .
Etapa 1.2: Traducir esas métricas empresariales en métricas de evaluación. Para cada resultado, identifique la señal que confirma que el agente la entregó. Cada señal se convierte en una métrica rastreada con un umbral explícito y una condición de alarma. La inteligencia contable precisa se basa en la precisión de la resolución de las entidades y la tasa de conexión a tierra. La confianza de los vendedores se reduce a la fidelidad y a la tasa de alucinaciones. La acción del vendedor se basa en la ayuda y el cumplimiento del alcance. Los líderes revisan los mapas de confiabilidad para determinar su precisión, la tasa de aprobación y la cobertura de respuestas. Esta traducción debe abarcar cinco dimensiones: además de los umbrales de calidad, definir políticas de protección, establecer objetivos de latencia de p50, p90 y p99 por herramienta y por agente, establecer presupuestos de coste por consulta y definir los acuerdos de nivel de servicio (SLA) que determinan cuándo se produce una alarma y
qué registro se activa.Concretamente, dado que la solución informa directamente sobre las decisiones sobre ingresos, las estrategias de renovación y las revisiones ejecutivas, el listón es muy alto. Una respuesta errónea y segura no solo hace perder el tiempo al vendedor. Conduce a tomar una decisión equivocada en un momento empresarial real. Definimos seis tipos de fallos derivados de errores de producción reales, cada uno de los cuales marca una respuesta como imprecisa:
- Intercambio de métricas: cliente y período correctos, se devolvió una métrica incorrecta. Se registra como ocurrencias por cada 100 respuestas.
- Período incorrecto: los datos de un período de tiempo se etiquetan como otro, por ejemplo, una cifra interanual (interanual) que se presenta al vendedor como mes a mes (MoM) o al revés. Se registra como% citando la ventana correcta.
- Entidad incorrecta: nombres de cuentas o subsidiarias combinados. Registrado como% de precisión de resolución de la entidad .
- Alucinación pura: cifras sin fundamento y sin fuente rastreable. Registrado como porcentaje de tasa de referencia .
- Símbolos incorrectos: métrica correcta, moneda o símbolo de unidad incorrectos. Se registra como% de tasa de cumplimiento del alcance.
- Cálculo no autorizado: las cifras derivadas no autorizadas no están presentes en los datos de origen. Se registran como ocurrencias por cada 100 respuestas .
La tasa general de aprobación de la precisión es la métrica principal. El seguimiento por dimensión es lo que hace que sea procesable. Más allá de la precisión, también hacemos un seguimiento de la relevancia de la respuesta, la fidelidad, la utilidad Seguimiento de las instrucciones, precisión en la selección de herramientas. Una respuesta correcta escondida en tres párrafos, o que llegue demasiado tarde, también ha fallado al vendedor.
Etapa 1.3: Crea una pila de evaluadores que refleje esas métricas. Ningún tipo de evaluador cubre por sí solo los distintos modos de falla posibles. Combinamos cuatro tipos:
- Evaluadores integrados de AgentCore para una amplia cobertura de referencia. La relevancia, la fidelidad y la utilidad se relacionan directamente con las plantillas de evaluación disponibles de forma nativa en AgentCore Evaluations.
- Evaluadores personalizados, uno por tipo de error en nuestra taxonomía: un evaluador de intercambio de métricas, un evaluador de períodos incorrecto, un evaluador de clientes incorrecto, un evaluador por pura alucinación, un evaluador de símbolos incorrecto y un evaluador de cálculos no autorizado. Ninguna de las seis está cubierta por plantillas nativas. Son señales específicas de un dominio que creamos sobre la base del marco de AgentCore. Saber de antemano qué métricas ya cubre una plantilla nativa y cuáles requieren un evaluador personalizado es en sí mismo parte de la decisión de diseño.
- Como evaluadores externos, implementamos los evaluadores gestionados de las bibliotecas de código abierto de terceros DeepEval y AutoEval.
- Los evaluadores deterministas se encargan de comprobar la verdad sobre la base de datos cuando se conoce con exactitud la respuesta correcta, por ejemplo, los ingresos, la fecha de renovación y el estado del contrato.
Cuando la calidad del razonamiento y la utilidad no tienen una única respuesta correcta, utilizamos rúbricas de LLM como juez, con rúbricas integradas para garantizar la relevancia, la fidelidad y la utilidad, además de admitir rúbricas totalmente personalizadas. AgentCore Evaluations proporciona tanto una evaluación básica como una evaluación basada en el LLM como juez de forma nativa, lo que nos permite adoptar ambas vías de evaluación sin crear nosotros mismos ninguno de los dos motores de puntuación. El determinismo proporciona precisión sobre los hechos. El LLM-as Judge da amplitud al razonamiento
.Etapa 1.4: Crea un conjunto perfecto para ejercitar tus métricas de evaluación. A nivel de herramienta, cada herramienta fundamental tiene sus propios pares deterministas: la identificación del cliente debe responder a la entidad canónica exacta o fallar. A nivel de agente, el análisis temático de las consultas de usuarios reales produce un conjunto de datos con cuatro tipos de preguntas (exhaustivas, informativas, razonadas y ambiguas), cada una de las cuales requiere una estrategia de evaluación diferente, que se revisa mensualmente. En el nivel de varios agentes, los escenarios de orquestación de principio a fin detectan errores que solo aparecen cuando los agentes interactúan. El conjunto dorado no es solo un conjunto de datos de calidad. También incluye casos de pruebas de seguridad, casos de referencia de latencia y casos de referencia de costes, de modo que las etapas 3 y 4 puedan comparar cinco dimensiones con el mismo conjunto de datos seleccionado.
La colección dorada es un documento vivo, creado a partir de tres fuentes. Los casos derivados de la producción se basan en consultas reales sobre vendedores y líderes, incluidas las sesiones en vivo con baja puntuación promovidas en la fase 7. Los casos derivados de fallos provienen de todas las regresiones detectadas durante la puesta en escena o la producción, incluidos los casos centinela promovidos en la fase 3 y los casos de regresión permanente promovidos en la fase 9. Los casos extremos sintéticos se diseñan deliberadamente para garantizar la cobertura de situaciones que sabemos que son importantes pero que estamos ansiosos por encontrarnos con soltura, como los cuatro tipos de preguntas anteriores y los casos de desambiguación entre la matriz y la filial y el símbolo de ticker de la fase 4. La colección está controlada por versiones, se revisa y se amplía continuamente a través de tres
fuentes.Etapa 2: El experimento. Sepa qué versión gana
Cada cambio (una actualización inmediata, una nueva herramienta, una actualización del modelo, una actualización del conjunto de datos) plantea la misma pregunta: ¿es realmente mejor esta versión? En un sistema que opera en el campo de AWS a escala mundial, la intuición no es una respuesta aceptable.
Antes de que se fusione un cambio, realizamos una evaluación bajo demanda de AgentCore, que se puntúa según el mismo conjunto dorado con el mismo conjunto de evaluadores. El equipo de desarrollo utiliza los indicadores de calidad, latencia, costes y contexto para seleccionar las comparaciones posteriores, que se evalúan simultáneamente en cinco dimensiones, como se muestra en la figura 3. Un modelo que mejora la precisión en un 5 por ciento, pero duplica la latencia y triplica el costo, no gana automáticamente
.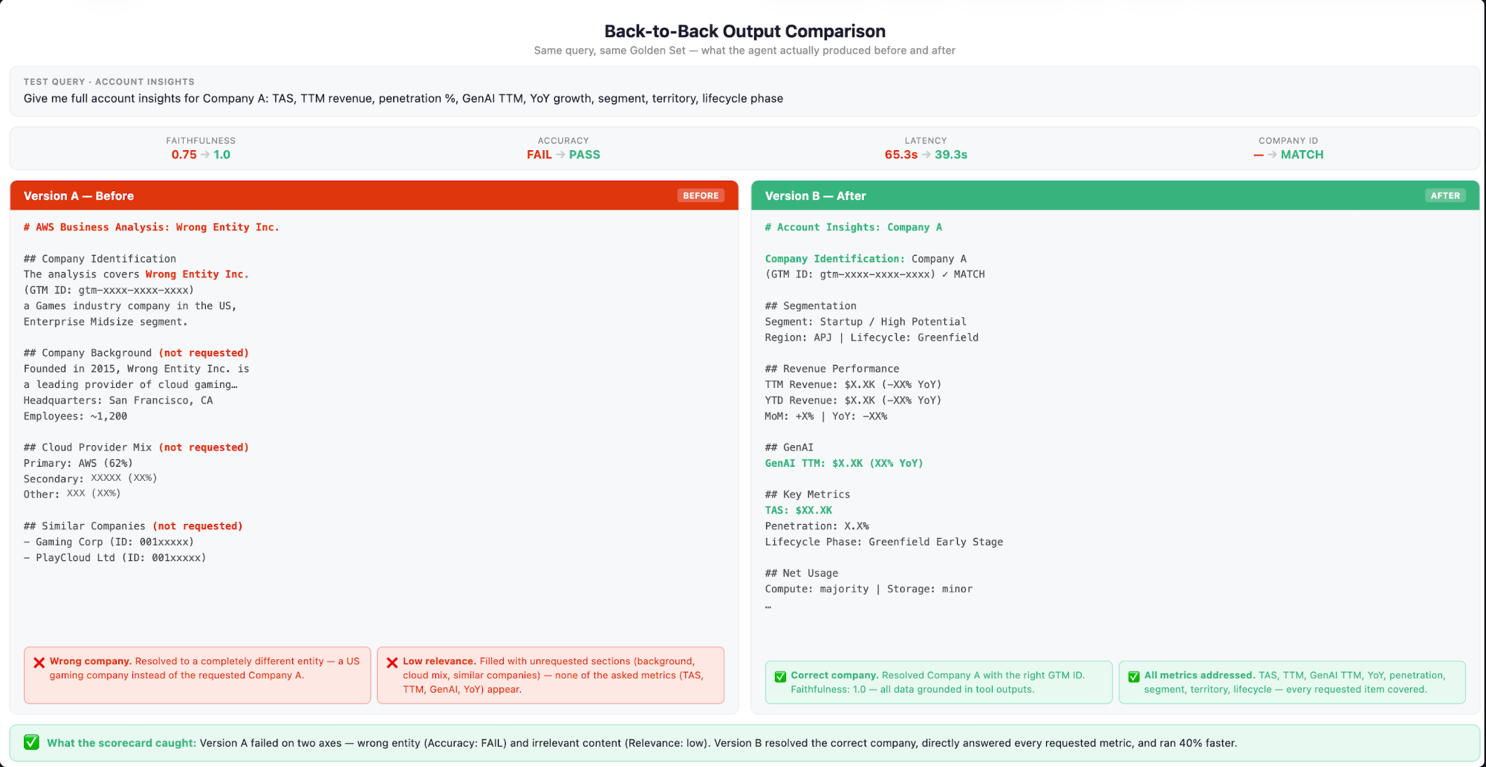
Figura 3: Comparación en paralelo de las respuestas de dos agentes candidatos en una evaluación bajo demanda de AgentCore en relación con la calidad, la latencia y el costo. Los números y valores de la figura son ilustrativos
.Hacemos un seguimiento de la calidad como un cuadro de mando integral, no como un solo número. La tasa de aprobación por sí sola no te dice lo suficiente. Cada evaluación produce un desglose completo de todas las categorías de fallos de nuestra taxonomía: no solo si la calidad mejoró, sino también dónde y por qué, tal y como se muestra en la tabla de puntuación de la figura 4. Todas las evaluaciones también se registran en su totalidad: las entradas, las salidas, el contexto recuperado, las puntuaciones y los motivos de la evaluación se almacenan en S3 y en nuestro lago de datos, lo que nos brinda una capa de observabilidad persistente para rastrear el error hasta su causa principal: lo que el agente vio, lo que generó y por qué salió mal. Tras tres meses de iteración específica, esta tarjeta de puntuación hizo que la tasa de aprobación pasara del 93 por ciento a un 96 por ciento estable: las alucinaciones puras cayeron de 138 a menos de 52 por cada 10 000 respuestas, los cálculos no autorizados cayeron de 59 a menos de 44, lo que confirmó que la recuperación era sólida y que los beneficios provenían de las correcciones generacionales. Sin el desglose por categoría y los datos de seguimiento detallados que lo respaldan, habríamos
hecho iteraciones a ciegas.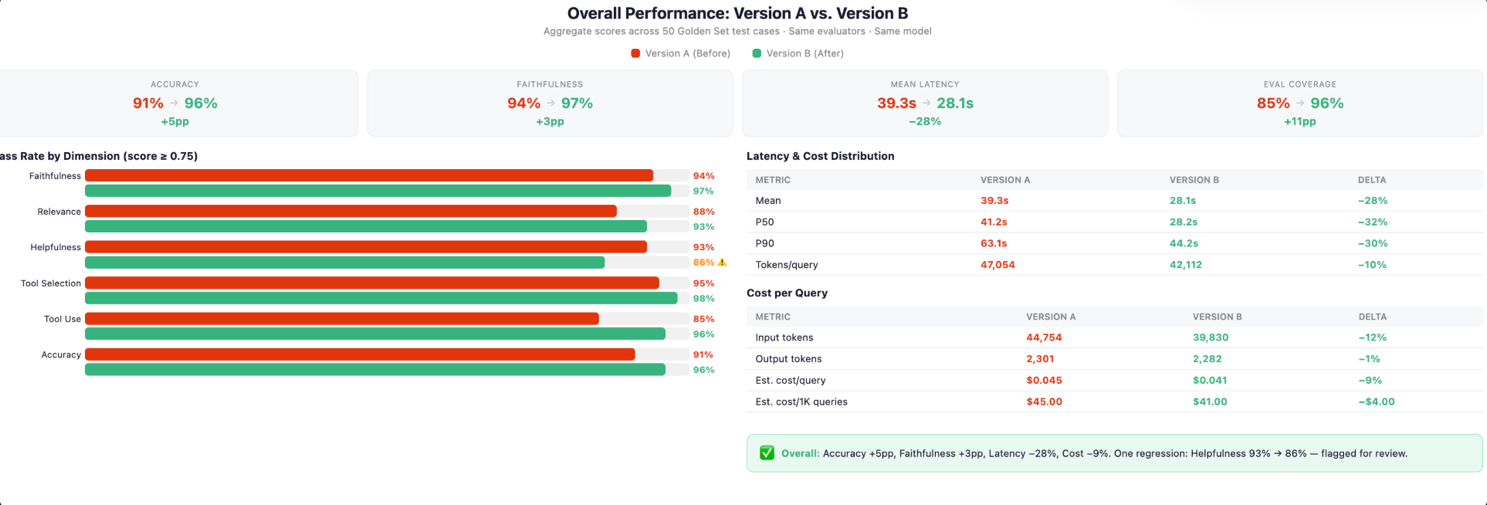
Figura 4: Tarjeta de puntuación de la evaluación con desglose de errores por categoría y tendencia de la tasa de aprobación. Los números y valores de la figura son ilustrativos
.Etapa 3: La fusión (CI). Evite la regresión en el momento de la fusión
La fase 3 es una etapa de preproducción. Se ejecuta en el entorno de ensayo, se activa a partir de cambios en el código y la configuración, y su función consiste en bloquear un cambio incorrecto antes de que llegue a la fase de producción. Si la fase 3 detecta una regresión, no se envía nada
. Losingenieros o los científicos cambian el sistema de muchas maneras: el aviso, los datos subyacentes, las herramientas o el modelo. El cambio parece limpio a nivel local, las pruebas son superadas, pero un aviso que mejore las respuestas de las cuentas de tecnología podría degradar silenciosamente las respuestas de las cuentas de servicios financieros. Sin una puerta automática, este barco se envía
.Nuestra evaluación de CI se activa automáticamente en cada implementación provisional mediante la evaluación bajo demanda de AgentCore. Los ingenieros no tienen que acordarse de realizar una evaluación. Ningún despliegue puede saltarse la puerta silenciosamente. La carrera se completa en minutos porque solo evalúa el conjunto centinela, no el conjunto dorado completo. La velocidad es intencionada: el centinela es lo suficientemente estrecho como para ejecutarlo en todos los despliegues, pero lo suficientemente representativo como para detectar los fallos
más importantes.El conjunto centinela es una selección curada de los escenarios de mayor riesgo en cinco dimensiones. Las regresiones de calidad que superan la tolerancia bloquean el despliegue. Una infracción de los límites de seguridad bloquea con la misma intensidad. Un cambio que duplique la latencia de p90 no se lleva a cabo sin una decisión deliberada. Los picos de coste de los tokens se marcan antes de que se acumulen a gran escala. Cada centinela publica sus puntuaciones en CloudWatch como métricas personalizadas. Después de cada ejecución, se emiten las puntuaciones de calidad, la latencia, el coste por consulta y la tasa de aprobación por motivos de seguridad, y las alarmas de CloudWatch se configuran para que se activen si alguna métrica supera el umbral de la fase 1. Cada ejecución también se registra y almacena, lo que permite obtener el registro de auditoría en el que se basan las etapas 8 y 9. Mantenemos un centinela independiente en cada nivel: herramienta, agente y agente múltiple. Un cambio que mejora la calidad a nivel de agente pero degrada una herramienta fundamental sigue bloqueando. El centinela se revisa una vez al mes, y una regresión que pasa a la fase de producción se convierte inmediatamente en un caso permanente para que no llegue dos
veces a los usuarios.Un ejemplo de lo que capta esto. Tras una actualización de normalización de datos, una herramienta de desambiguación empezó a devolver entidades sin resolver para un subconjunto de formatos de nombres de cuentas. El agente, al recibir una entidad no resuelta, respondió con una estimación aproximada y devolvió datos reales sobre el cliente equivocado. Nuestro centinela a nivel de herramienta incluye exactamente este tipo de casos extremos: la verificación de la verdad sobre la resolución de la entidad falló en los formatos de nombre de cuenta afectados y la implementación se bloqueó automáticamente. El cambio nunca llegó a la fase de producción.
Etapa 4: The Gate (CD). Realice envíos con confianza cuantitativa
El centinela cubre 15 casos. La producción abarca decenas de miles de patrones de consulta en cientos de tipos de cuentas, regiones geográficas y segmentos de vendedores. Es necesario eliminar al centinela. No es suficiente
.Antes de enviar un candidato, realizamos una evaluación bajo demanda de AgentCore comparándola con todas las dimensiones del evaluador. A esto lo llamamos Quality Gate. Sustituye «parece estar bien» por una decisión de envío cuantitativa.
Ejecución en espacio aislado y simulación de herramientas. Piense en ello como una repetición, no como una llamada en vivo. Antes de tiempo, congelamos un conjunto de datos conocido y versionado que muestra el comportamiento correcto de la herramienta. Todas las llamadas a herramientas que hace el candidato durante el proceso de acceso son interceptadas y respondidas desde ese conjunto de datos inmovilizado, en lugar de hacerlo desde un sistema real. Creamos ese conjunto de datos congelado en dos pasos. En primer lugar, probamos cada herramienta por sí sola: le enviamos un conjunto de entradas de nuestro conjunto dorado donde ya se conoce la respuesta correcta, y puntuamos lo que realmente arroja con respecto a esa respuesta conocida. Esto nos indica si la herramienta en sí misma funciona (resolución de entidades, recuperación, generación de SQL) incluso antes de que el agente intervenga. En segundo lugar, una vez que se confirma que las respuestas de una herramienta son correctas, congelamos esas mismas respuestas validadas en el conjunto de datos de reproducción que el agente ve durante la evaluación. Esto significa que el agente se somete a pruebas basándose únicamente en su propio razonamiento, no en función de la velocidad o disponibilidad de las herramientas en tiempo real, y dado que todos los candidatos reproducen el mismo conjunto de datos inmovilizados, cualquier diferencia de puntuación entre ambas tiene que ver con el agente, no con la varianza de la
herramienta.Puntuación agregada de principio a fin. La clasificación también es holística: el agente candidato completo responde a 200 preguntas pendientes de principio a fin y obtiene una puntuación según una rúbrica de LLM como juez en todas las dimensiones del evaluador. Cualquiera de estas tres condiciones cierra la puerta automáticamente: la puntuación global es inferior a la obtenida anteriormente por el candidato, no supera la línea base de producción actual o más de un porcentaje definido de las 200 preguntas queda por debajo del umbral por pregunta. El candidato debe responder las tres preguntas, lo que capta lo que un promedio simple puede ocultar: un modelo que mejora la media mientras reprueba discretamente una mayor parte de las preguntas individuales no
es aprobado.Un ejemplo de lo que esto capta. Aquí es donde la burla pone a prueba el propio razonamiento del agente, no solo las herramientas que lo sustentan. Nuestro ejemplo es un caso de discrepancia jerárquica: el agente de Customer Insights y el agente de Data Insights devuelven cifras de ingresos diferentes y correctas de forma individual para el mismo cliente, una para la cuenta principal y la otra para una filial. Ninguno de los dos números es incorrecto. En este caso, se comprueba si el agente deduce el alcance correcto a partir de la semántica de la consulta y de la personalidad del solicitante (es probable que un vendedor quiera la filial, mientras que una consulta de liderazgo probablemente quiera que la matriz se acumule), en lugar de establecer un valor predeterminado, hacer un promedio o pedirle al vendedor que desactive la ambigüedad. El candidato falló y devolvió la cifra correspondiente a los padres en el caso de una pregunta de ámbito subsidiario. La verdad fundamental para este caso especifica el alcance esperado de la pregunta, por lo que Quality Gate detectó inmediatamente el desajuste: no se trataba de un número incorrecto, sino del número correcto para un ámbito incorrecto
.Etapa 5: El canario. Detecte las fallas silenciosas posteriores a la implementación
Stage 5 es un monitor de posproducción. Se ejecuta de forma continua en el entorno de producción comparándolo con el tráfico en directo y con casos de evaluación sintéticos, y su función consiste en detectar los problemas que no se han producido cambios en el código y que, por lo tanto, la fase 3 no ha detectado. La fase 3 protege contra los cambios de los ingenieros. La fase 5 protege contra todo lo demás, como los cambios en los datos, la evolución del comportamiento de los modelos, los cambios en las dependencias de terceros u otras condiciones, como el aumento de la latencia o los cambios en los patrones de tráfico, que solo se manifiestan cuando hay una carga real
.El producto funciona contra un patrimonio de datos alimentado por miles de esquemas ascendentes y canalizaciones de datos. En un día determinado, docenas de esas canalizaciones se actualizan sin que se active una implementación o una puerta de CI. El código del agente no ha cambiado, el modelo no ha cambiado, pero los datos sobre los que razona han cambiado y, como resultado, la calidad puede degradarse silenciosamente. Lo aprendimos por las malas: una canalización inicial se actualizó con un cambio de esquema, el agente empezó a citar datos de un período de tiempo incorrecto y la primera señal llegó a través de una consulta del vendedor, en lugar de una alerta automática. En la fase 5, lo detectamos en el primer periodo de evaluación de 30 minutos
.Llevamos a cabo la evaluación por lotes de AgentCore siguiendo dos programas complementarios, y la cadencia se eligió de forma deliberada.
Nos decidimos por ciclos de 30 minutos después de aprender de ambas partes: 15 minutos generaban demasiadas falsas alarmas; 60 minutos dejaban pasar dos horas antes de que se registrara una verdadera degradación. Llamamos a cada ciclo de 30 minutos una ventana de evaluación. Treinta minutos captan una tendencia real en 90 minutos (tres ventanas consecutivas) y filtran el ruido generado por una sola consulta. Cada ventana marca una selección de todos contra todos en el conjunto dorado, lo que proporciona una cobertura completa en 24 horas
.Los umbrales son deliberadamente más bajos que los de las puertas de CI/CD. Un fallo en una sola ventana es una señal operativa, no un incidente. Solo pagamos de guardia después de tres violaciones consecutivas del umbral de Windows. Esta regla la aprendimos por las malas: el primer mes que utilizamos un umbral de ventanilla única, oncall dejó de confiar totalmente en el sistema. Una vez al día, el conjunto dorado completo aparece en los umbrales de entrada como la tarjeta de puntuación diaria más importante. Los intervalos de 30 minutos muestran la tendencia. La tirada diaria lo confirma y te quita un billete.
Todas las tiradas se publican en CloudWatch (precisión, tasas de alucinaciones, velocidad de conexión a tierra, latencia y coste), con una lógica de alarma que distingue entre las dos cadencias. El canario se divide en tres niveles: las puntuaciones a nivel de herramienta revelan que la herramienta de recuperación está degradada antes de que corrompa
las respuestas a nivel de agente.Otro ejemplo de lo que capta. Tras una actualización inicial del índice, una herramienta de recuperación empezó a mostrar fragmentos poco relevantes en lugar del contexto preciso necesario para responder a la consulta. La latencia era nominal. La tasa de errores era cero. El agente siguió dando respuestas fluidas y seguras al razonar sobre un contexto poco fundamentado, produciendo respuestas que parecían correctas pero que citaban cifras incorrectas. No se activó ninguna alarma de infrarrojos. Lo detectó en los primeros 30 minutos: la velocidad de toma de tierra y la precisión de la recuperación se redujeron en comparación con el centinela a nivel de herramienta, lo que activó la alarma de CloudWatch antes de que los vendedores actuaran ante las respuestas degradadas. La baja puntuación de los evaluadores indicaba la traza exacta responsable. A partir de ahí, el ingeniero de guardia abrió ese rastreo en AgentCore y rastreó el contexto degradado hasta la herramienta de recuperación en cuestión de minutos
.Etapa 6: El adversario. Protéjase del uso indebido
No todos los malos resultados provienen de un modelo degradado. Las consultas diseñadas para extraer datos de cuentas no autorizados y las inyecciones rápidas incrustadas en los documentos recuperados son patrones predecibles en un sistema que atiende a miles de usuarios con datos empresariales confidenciales
.La seguridad no es un escenario. Atraviesa las nueve etapas. Aplicamos Amazon Bedrock Guardrails en dos puntos de cada interacción. En el momento de la entrada, validamos el alcance de la consulta y la comprobamos para que se inserte rápidamente. En el momento de la salida, verificamos que no se revele ningún dato confidencial a usuarios no autorizados y que el agente no haya sido manipulado para infringir una política. Estas comprobaciones se ejecutan en el 100 por ciento del tráfico, de forma sincrónica, antes de que el usuario reciba una respuesta.
Configuramos dos capas de protección, cada una de las cuales cubre una clase de amenaza distinta:
Los filtros de contenido detectan y bloquean el contenido dañino o inapropiado tanto en las entradas como en las salidas. Aplicamos filtros en todas las categorías, incluidas la VIOLENCIA, EL ODIO, EL SEXO, LA MALA CONDUCTA Y LOS INSULTOS. Las solicitudes o respuestas que activen estos filtros se bloquean antes de que lleguen al vendedor o se muestren al usuario
Los filtros de seguridad rápidos protegen al agente de la manipulación por parte de los adversarios en una sola categoría de protección PROMPT_ATTACK, que abarca tres subtipos: JAILBREAK (intentos de anular las instrucciones del sistema del agente o eludir sus límites operativos), PROMPT_INJECTION (instrucciones no deseadas incrustadas en los documentos recuperados, los resultados de las herramientas o las consultas de los usuarios) y PROMPT_LEAKA (intenta extraer la solicitud del sistema o la configuración interna). En un sistema multiagente que utiliza Retrieval Augmented Generation (RAG), la inyección rápida a través del contenido recuperado es un riesgo real. Un documento no intencionado en los datos de la cuenta de un vendedor podría intentar redirigir el comportamiento del agente a
Las normas de seguridad se definen en la fase 1, se comprueban las regresiones en las fases 3 y 4 y se aplican de forma continua durante la producción.
Etapa 7: La deriva. Mantenga la calidad y valide con tráfico en vivo
La calidad se degrada desde múltiples direcciones: los datos ascendentes cambian sin provocar una implementación, los modelos se vuelven obsoletos y los usuarios superan los límites con consultas que ningún conjunto de oro anticipa del todo. La fase 7 lo detecta antes que los vendedores y valida a los candidatos comparándolos con el tráfico real
de usuarios antes de la implementación completa. Detección de desviaciones.Con la evaluación en línea de AgentCore, muestreamos el 10 por ciento del tráfico en vivo de forma continua a través de los diferentes evaluadores definidos en la etapa 1, de modo que la desviación se ve inmediatamente como una desviación con respecto a las líneas de base establecidas fuera de línea. Las puntuaciones se utilizan en una calculadora de estado de calidad que monitoriza la calidad, la latencia y el coste en un mismo intervalo
.Un ejemplo de producción. Nuestro set perfecto para la identificación de clientes se creó a partir de estuches con bordes sintéticos: variaciones de nombres, búsquedas de filiales, abreviaturas. Funcionó bien fuera de línea. Sin embargo, en el tráfico en tiempo real, los vendedores consultaban con símbolos bursátiles («¿qué pasa con AMZN?») , nombres abreviados y errores tipográficos que no utilizaban mayúsculas y minúsculas. La calculadora Quality-State calculó la diferencia en tres intervalos consecutivos de 30 minutos: el 98 por ciento a la 1:30 a.m., el 81 por ciento a las 2:00 a.m., y el 80 por ciento a las 2:30 a.m. CloudWatch llamó por teléfono cuando se superó el umbral acumulable. El ingeniero de guardia preguntó al agente: «¿Qué pasó con la precisión de la identificación del cliente entre la 1 de la madrugada y las 3 de la madrugada?» y recibió un resumen de las tendencias en el que se señalaban las búsquedas en los símbolos bursátiles y los nombres abreviados que indicaban la causa del fallo. El rastreo del agente hizo que la causa principal fuera visible de inmediato. La solución: ampliar el conjunto dorado con las sesiones en directo con puntuaciones más bajas y actualizar la herramienta de desambiguación para normalizar los formatos de entrada antes de la resolución. La precisión se recuperó hasta los valores iniciales en el siguiente ciclo de evaluación
.El tráfico en tiempo real alimenta dos ciclos de mejora continua: las sesiones con puntuaciones bajas se convierten en casos extremos, y los grupos de trazas con puntuaciones bajas permiten revisar rápidamente, actualizar las herramientas y ajustar las rutas.
Pruebas A/B: cuando un candidato supera la barrera de calidad, AgentCore Gateway, una función de Amazon Bedrock AgentCore, dirige una parte del tráfico real entre los agentes actuales y los candidatos. Bajo demanda se confirma que no hay regresión en los casos conocidos. Internet confirma que resiste las entradas largas y las frases novedosas que solo producen los usuarios reales. Un candidato debe ganar o empatar en todas las dimensiones del evaluador
antes de la implementación completa.Etapa 8: El pulso. Visibilidad de calidad en tiempo real
Una sola llamada al agente puede afectar a tres subagentes, cinco herramientas y dos rutas de recuperación. Cuando se activa una alarma de calidad, «algo en proceso de creación de agentes» no es un manual de operaciones. En la fase 8, las señales de las fases 5, 6 y 7 convergen en una capa de observabilidad con la resolución suficiente para actuar
. Laobservabilidad de AgentCore, una capacidad de Amazon Bedrock AgentCore, es la base. Para los agentes alojados en el entorno de ejecución de AgentCore, una funcionalidad de Amazon Bedrock AgentCore, cada ejecución se instrumenta automáticamente mediante OpenTelemetry, lo que emite telemetría estructurada para cada paso del razonamiento: herramientas denominadas, orden, entradas y salidas, latencia y consumo de tokens, que se publican directamente en CloudWatch como métricas y registros personalizados, una vez habilitada la búsqueda de transacciones de CloudWatch (un paso de configuración único). Las puntuaciones de los evaluadores son un proceso independiente: provienen de las configuraciones de evaluación, no de la instrumentación de ejecución, y se depositan en su propio grupo de registros de CloudWatch. Cada ejecución de evaluación también conserva todos sus resultados en S3 y en nuestro lago de datos,
alimentando dos paneles:- Un panel conversacional para consultar los resultados de evaluación y observabilidad.
- Un panel de Amazon Quick para el análisis de tendencias, el seguimiento de los cuadros de mando y las comparaciones entre agentes a lo largo de todo el historial.
Las vistas apropiadas para cada rol se encuentran en la parte superior. Los ingenieros de guardia obtienen una visión que prioriza el rastreo: desde una alarma de CloudWatch hasta el registro de AgentCore Observability que la activó con un solo clic. El rastreo muestra cada herramienta llamada, en qué orden, con la latencia por paso, el consumo de tokens, el costo y todo el contexto del razonamiento: todo lo que se necesita para pasar de «alarma» a «causa raíz identificada» sin necesidad de abrir una segunda herramienta
, como se muestra en la figura 5.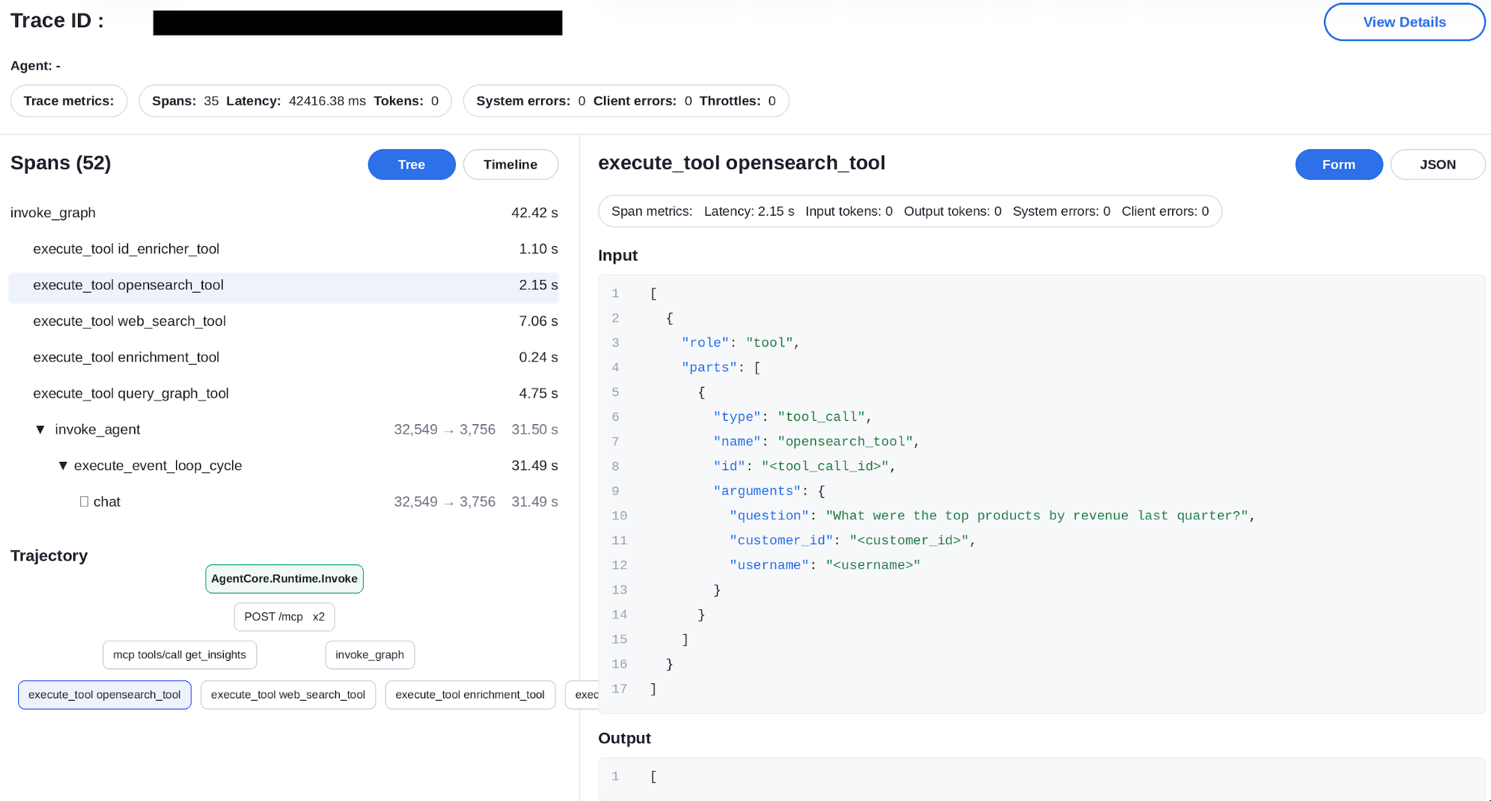
Figura 5: Seguimiento de la ejecución de AgentCore para el agente de Customer Insights, que muestra el árbol de expansión, la trayectoria y las métricas a nivel de intervalo. Los números y valores de la figura son ilustrativos
.Los gerentes de producto obtienen los paneles de tendencias rápidas de Amazon: puntuaciones de calidad por subagente y función, versión tras versión. Los directivos reciben un resumen de salud de una sola página que se ajusta a las revisiones semanales y transversales de las cinco dimensiones, y una verificación puntual de un minuto que responde a la pregunta «¿cuál es el desempeño
de nuestros agentes?»La figura 6 muestra la vista desde arriba de nuestro panel de evaluación semanal: una tasa de aprobación combinada entre los evaluadores personalizados y los evaluadores integrados de AgentCore, junto con la latencia, durante toda la semana. Los números y valores de la figura son ilustrativos
.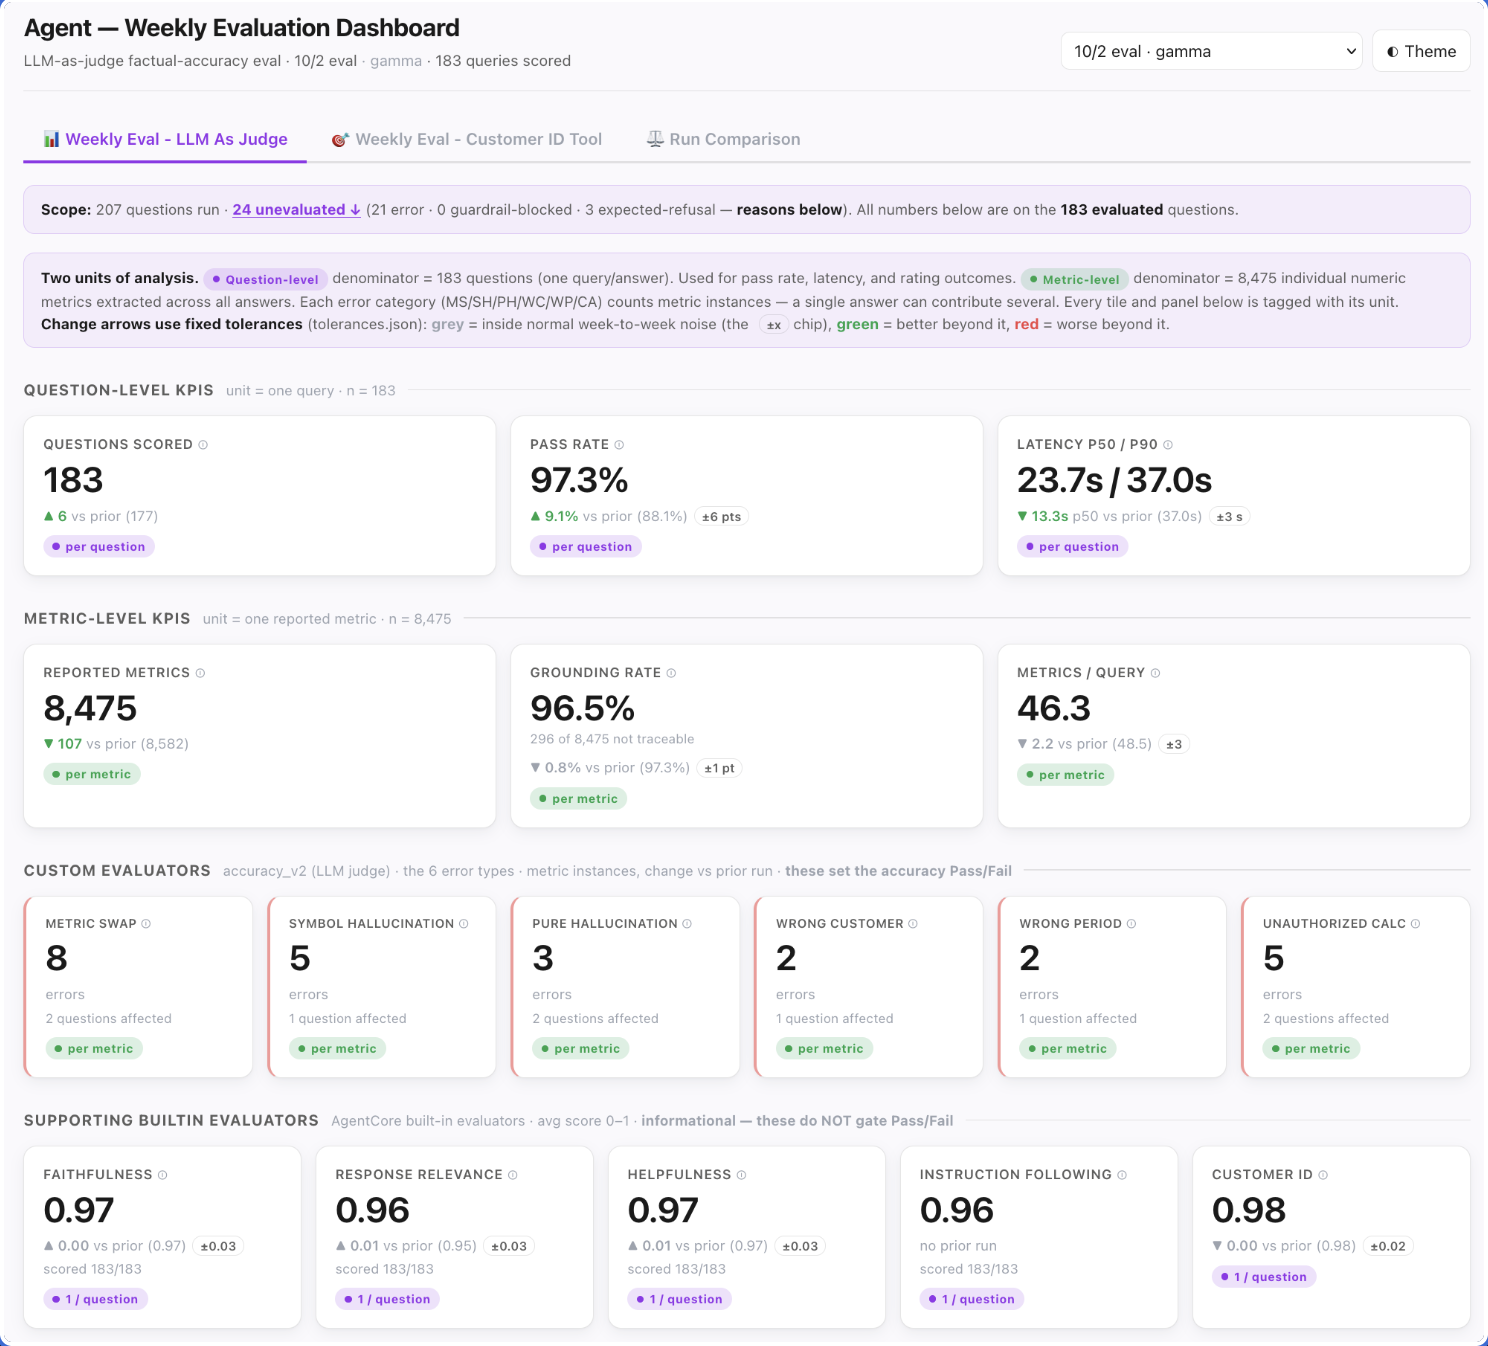 Figura 6: Panel de evaluación semanal de primera línea con tasa de aprobación y latencia combinadas. Los números y valores de la figura son ilustrativos.
La figura 7 profundiza en esa misma operación a nivel de evaluador personalizado y categoría de fallo, desglosando exactamente qué tipos de error (permutas métricas, alucinaciones, errores de identificación de clientes y otros) están aumentando la brecha y a cuántas preguntas afecta cada uno de ellos. Los números y valores de la figura son ilustrativos.
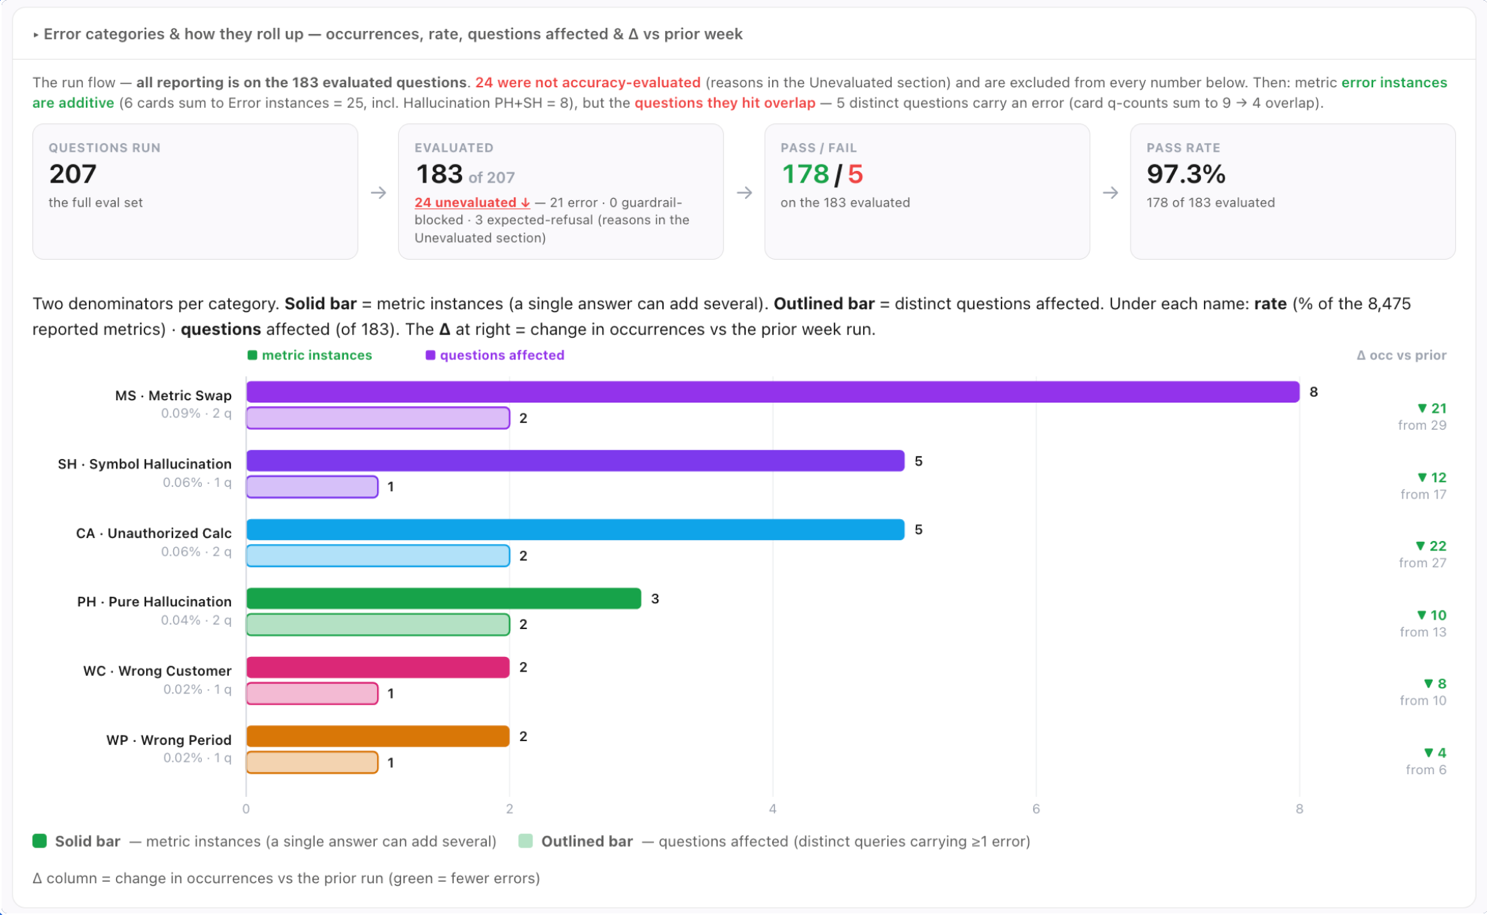 Figura 7: Panel de informes de errores semanales en el que se desglosan las fallas por categoría. Los números y valores de la figura son ilustrativos.
Antes de la etapa 8, el tiempo medio de detección (MTTD) era de días a semanas. Tras la fase 8, son menos de cuatro horas y la primera señal es una alarma de CloudWatch con un registro de AgentCore adjunto
.Etapa 9: El ciclo de retroalimentación. Mejora continua
Esta etapa convierte las observaciones en acciones. El sistema aumenta la calidad con el tiempo. Usamos la optimización de AgentCore, una función de Amazon Bedrock AgentCore,
para cerrar el ciclo.- Recomendación de solicitud del sistema: analiza los rastros de los agentes y genera una solicitud de sistema optimizada basada en datos que mejora el rendimiento del evaluador objetivo. La solución utiliza patrones de error y agrega instrucciones de comportamiento específicas .
- Recomendación sobre la descripción de la herramienta: analiza los rastros de los agentes y genera descripciones más precisas de las herramientas para reducir la confusión al seleccionar las herramientas. Especialmente cuando un agente selecciona la herramienta equivocada para solicitudes ambiguas .
Veamos un ejemplo:
La optimización de AgentCore en acción
En qué mejorar:
Evaluador objetivo: alucinación: modelo que reproduce textualmente valores codificados a partir de ejemplos de pocas fotos en contextos no relacionados.Por qué ocurrió esto: Algunos ejemplos muestran cantidades reales en dólares y nombres de clientes (por ejemplo, «4,2 millones de dólares», «Acme Corp») que el modelo memoriza y filtra en consultas no relacionadas.
Cómo solucionarlo: Sustituya los valores codificados en algunos ejemplos breves por marcadores de posición genéricos (por ejemplo,
$ [AMOUNT],) para que el modelo aprenda la estructura de respuestas sin memorizar puntos de datos específicos.[CUSTOMER_NAME]Impacto y resultado: se aplicó una corrección. Los casos de alucinaciones puras se redujeron de 138 a menos de 52 por cada 10 000 respuestas, y la tasa general de alucinaciones se redujo del 93 al 96 por ciento
.
La optimización de AgentCore utiliza recomendaciones para producir cambios rápidos en las descripciones de herramientas y sistemas basados en datos, basados en el seguimiento de agentes reales y en un evaluador de objetivos. La optimización de AgentCore se basa en las evaluaciones de AgentCore. Los rastreos con puntuaciones bajas pasan a formar parte del conjunto dorado como protección permanente contra la regresión, de modo que cada error no
llegue dos veces a los usuarios.Las métricas clave de la evaluación de los agentes de un vistazo
Las métricas de evaluación se definen en la etapa 1, se aplican en las nueve etapas y se supervisan de forma continua durante la producción. Este conjunto no es estático. A medida que aprendemos del agente de producción, surgen nuevos patrones de error, se pueden medir nuevas dimensiones y las métricas evolucionan en consecuencia. Lo que sigue es el punto de partida y lo que rastreamos en la actualidad.
| Nivel | Métrico | Qué mide | Rastreado como |
| Calidad: Agente | Precisión general (tasa de aprobación) | % de respuestas sin errores de taxonomía | Métrica del cuadro de mando principal |
| Calidad: Agente | Tasa de permuta métrica | Cliente y período correctos, se devolvió una métrica incorrecta | Ocurrencias por cada 100 respuestas |
| Calidad: Agente | Tasa de período incorrecta | Datos de una ventana temporal incorrecta | % que cita la ventana de tiempo correcta |
| Calidad: Agente | Tarifa de cliente incorrecta | Nombres de cuentas o subsidiarias combinados | % de precisión en la resolución de la entidad |
| Calidad: Agente | Tasa de puesta a tierra | Cifras rastreables hasta una fuente recuperada | % de cifras reportadas fundamentadas |
| Calidad: Agente | Alcance: tasa de cumplimiento | Respuestas que abordan la pregunta formulada | % de respuestas sobre el tema |
| Calidad: Agente | Tasa de cálculo no autorizada | Cifras derivadas no autorizadas | Ocurrencias por cada 100 respuestas |
| Calidad: Agente | Relevancia, fidelidad, utilidad | Calidad de respuesta en todas las dimensiones integradas de AgentCore | Puntuación del evaluador integrado de AgentCore (0—1) |
| Calidad: Herramienta | Precisión en la identificación del cliente | La herramienta se resuelve con la entidad canónica exacta | % de resoluciones correctas (determinista) |
| Calidad: Herramienta | Precisión en la selección de herramientas | El agente selecciona la herramienta correcta para la consulta | Puntuación del evaluador integrado de AgentCore (0—1) |
| Calidad: Herramienta | Precisión de recuperación | El contexto recuperado contiene la información necesaria | % de recuperaciones con el contexto relevante |
| Calidad: Herramienta | Precisión en la generación de SQL | Data Insights Agent genera el SQL correcto | % de conjuntos de resultados correctos (determinista) |
| Calidad: Herramienta | Tasa de aprobación de la herramienta | % de llamadas a herramientas que arrojan una respuesta válida | % de éxito por herramienta |
| Calidad: multiagente | Precisión, tasa de aprobación de principio a | La ruta de orquestación completa produce una respuesta correcta | % de escenarios que superaron a todos los evaluadores |
| Calidad: multiagente | Precisión de enrutamiento | Orchestrator se dirige a los subagentes correctos | % de enrutamiento correcto (determinista) |
| Calidad: multiagente | Síntesis: fidelidad | Las salidas de subagentes se combinan sin distorsión | La calificación de LLM como juez supera los límites de los agentes |
| Calidad: multiagente | Precisión de propagación del contexto | El contexto que se pasa entre los agentes es correcto y completo | % de rastros sin pérdida de contexto |
| Seguridad | Tasa de bloqueo de barandillas | % de solicitudes bloqueadas en la entrada o la salida | Por cada 1000 solicitudes |
| Seguridad | Tasa de infracción de entrada/salida | % de consultas o respuestas marcadas como infractoras de la política | % del total de solicitudes/respuestas |
| Seguridad | Latencia de barandilla | La sobrecarga de latencia añadida por las comprobaciones de guardarraíl | p99 (objetivo: menos de 50 ms) |
| Rendimiento | Latencia de un extremo | Desde la consulta recibida hasta la respuesta entregada | p50, p90, p99 |
| Rendimiento | Latencia por subagente/herramienta | Ejecución por subagente y por herramienta | p50, p90, p99 de forma independiente |
| Rendimiento | Tasa de regresión de latencia | Ejecuciones de CI que superan el umbral de latencia de la fase 1 | % de ejecuciones de CI |
| Coste | Coste por consulta | Coste total del token por solicitud de usuario de principio a fin | Tokens de entrada + salida × precio |
| Coste | Costo por respuesta exitosa | Coste por consulta dividido por la tasa de aprobación | Penaliza las fallas costosas |
| Coste | Promedio de llamadas a herramientas por consulta | Eficiencia del razonamiento. El aumento de las llamadas indica una degradación | Promedio por consulta |
| Control de operaciones | MTTD/MTTR | Tiempo de detección y corrección, por clase de fallo | Horas (objetivo de tiempo medio: menos de 4 horas) |
| Control de operaciones | Tasa de detección de automatización | Los incidentes detectados mediante la evaluación comparados con las quejas de los usuarios | % (objetivo: por encima del 95%) |
| Control de operaciones | Tasa de falsos positivos de alarma | Las alarmas no corresponden a una degradación real | % del total de alarmas |
Conclusión
El impacto del marco de evaluación de los agentes en nueve etapas fue concreto y medible. Las regresiones de calidad que antes tardaban días o semanas en aparecer y que, por lo general, llegaban a raíz de una reclamación del vendedor, ahora se detectan en menos de cuatro horas mediante una evaluación automatizada. Las decisiones de implementación que antes se basaban en un juicio subjetivo ahora requieren que cada evaluador supere un umbral cuantitativo. Los ciclos de iteración rápida se redujeron de días a minutos. La seguridad pasó de las auditorías periódicas a una cobertura del 100 por ciento en cada solicitud. Las regresiones de latencia se detectan en el punto de entrada de la CI antes de que lleguen a la fase de producción. Las sorpresas de costes que antes aparecían semanas después en la facturación ahora se evalúan en la segunda fase y son aplicadas por el departamento de calidad antes de que se produzca un cambio. Y «algo en proceso» pasó de ser una alarma de CloudWatch a hacer un seguimiento completo de la ejecución de los agentes con un solo clic y ver cada paso del razonamiento.
La lección más amplia es una lección que la industria ya ha aprendido antes. DevOps nos enseñó que enviar código sin pruebas automatizadas es imprudente. Los MLOps nos enseñaron que implementar modelos sin supervisión es peligroso. AgentOps nos enseña lo mismo sobre los agentes de IA: operarlos sin una evaluación continua y multinivel
es volar a ciegas.El marco de nueve etapas que se describe aquí no es específico para los agentes de inteligencia de ventas. Los equipos que implementen sistemas con múltiples agentes que razonan, llaman a subagentes, utilizan herramientas y sintetizan las respuestas se enfrentarán a estas mismas preguntas durante el mismo ciclo de vida. Su taxonomía de errores tendrá un aspecto diferente. Tu conjunto dorado reflejará tu dominio. Tu lista de evaluadores se adaptará a tus usuarios. Lo que se mantiene constante es el principio: la evaluación no es un paso final de control de calidad. Es el sistema operativo del propio agente, que se mide continuamente, se defiende automáticamente y se mejora con cada interacción.
Si está creando agentes de producción y quiere incorporar este tipo de disciplina de evaluación a su sistema, Amazon Bedrock AgentCore Evaluations le ofrece la plataforma para hacerlo: evaluación bajo demanda para experimentos, evaluación por lotes para un monitoreo continuo, evaluación en línea del tráfico en vivo, evaluadores integrados y personalizados, evaluación de conjuntos de datos (en versión preliminar pública), integración con CloudWatch y la optimización de AgentCore incluye recomendaciones y pruebas A/B para cerrar el ciclo de retroalimentación. Comience con la primera etapa, defina qué es lo bueno para su agente y deje que el marco se encargue del resto.
¿Está listo para empezar? Consulte Evaluar el desempeño de los agentes en la documentación de Amazon Bedrock AgentCore. Y si está creando agentes de producción y desea obtener información sobre cómo aplicar este marco a su sistema, estaremos encantados de ayudarle. Póngase en contacto con nosotros directamente o a través de su equipo de cuentas de AWS.
Para obtener más información sobre las evaluaciones de Amazon Bedrock AgentCore, consulte Evaluar el desempeño de los agentes en la documentación de AWS. Para obtener una introducción técnica, lea Cree agentes de IA confiables con las evaluaciones de AgentCore. Para ver cómo creamos el agente Performance Insights, lea Cómo AWS SMGS utiliza un asistente conversacional con tecnología de inteligencia artificial para transformar la gestión empresarial con Amazon Bedrock AgentCore. Para obtener más información sobre las recomendaciones y la optimización de AgentCore, lea Optimización de AgentCore: mejore el ciclo de calidad de los agentes con recomendaciones y pruebas A/B
Reconocimiento
Extendemos nuestro más sincero agradecimiento a nuestros patrocinadores ejecutivos y mentores cuya visión y orientación hicieron posible esta iniciativa: Damien Forthomme, director III de Ciencias Aplicadas; Akhand Singh, director de ingeniería de datos; Sujit Narapareddy, director de AWS Insights;
Monica Jain, directora sénior de productos tecnológicos, y Norman Braddock, director sénior de gestión de productos de IA en AWS; Muhammad Umar Javed, científico aplicado III, nivel 6.