Construcción de aplicaciones de voz de inteligencia artificial de latencia ultra baja en AWS
Building ultra-low-latency voice AI applications on AWS
Nolan Chen
La inteligencia artificial conversacional está transformando la forma en que los humanos interactúan con la tecnología. Desde asistentes virtuales y centros de contacto impulsados por IA hasta herramientas de traducción y accesibilidad en tiempo real, las interfaces de voz primero están convirtiéndose rápidamente en el modo de interacción predeterminado para millones de usuarios en todo el mundo.
Sin embargo, entregar una experiencia de voz verdaderamente natural sigue siendo uno de los desafíos más difíciles en la infraestructura de IA. Los usuarios esperan una respuesta similar a la humana. La latencia excesiva puede interrumpir el flujo conversacional y erosionar la confianza. Para sentirse natural, el habla generada por IA debe llegar dentro de la misma ventana temporal que la toma de turnos humana.
Esta publicación introduce cómo Cartesia, un socio de AWS especializado en IA de voz en tiempo real, utiliza modelos de espacio de estado (SSMs) diseñados a propósito y la infraestructura de AWS para entregar texto a habla y habla a texto sub-100ms a escala global. Los desarrolladores pueden crear experiencias de voz que se sienten indistinguibles de la conversación humana.
El auge de la IA conversacional y las expectativas de latencia
La demanda de IA de voz en tiempo real está creciendo rápidamente en various industrias:
Centros de contacto: Los agentes de IA que manejan millones de interacciones con clientes requieren generación de habla instantánea para mantener un diálogo natural.
Telehealth: Las consultas de pacientes remotos requieren voz de baja latencia para una comunicación precisa y empática.
Juegos y mundos virtuales: Las experiencias inmersivas requieren síntesis de voz en tiempo real para personajes no jugables (NPC) y interacciones de jugadores.
Accesibilidad: Los lectores de pantalla y las interfaces de voz deben responder instantáneamente para servir a los usuarios con discapacidades visuales.
Ventas entrantes y salientes: Los agentes de ventas de IA deben responder sin pausas incómodas para calificar prospectos, manejar objeciones y mantener a los prospectos en la línea.
Los modelos de texto a habla (TTS) basados en transformadores tradicionales luchan con la latencia de transmisión porque procesan secuencias completas antes de producir la salida. Esta limitación arquitectónica crea una tensión fundamental: una mayor calidad a menudo significa una mayor latencia. Una nueva clase de modelos, los Modelos de Espacio de Estado, resuelve este intercambio.
IA para voz: Modelos de Espacio de Estado (SSM)
Los Modelos de Espacio de Estado (SSMs) adoptan un enfoque fundamentalmente diferente para procesar secuencias en comparación con los transformadores, la arquitectura detrás de la mayoría de la inteligencia artificial de hoy en día. Los transformadores utilizan un mecanismo llamado atención, que compara cada elemento de una secuencia con todos los demás elementos. Como resultado, la cantidad de cálculo crece cuadráticamente a medida que la secuencia se vuelve más larga. Los SSMs, en cambio, tratan una secuencia como un sistema que evoluciona continuamente con el tiempo, procesándola paso a paso y llevando un estado interno compacto hacia adelante. Esto se puede convertir en una forma que los computadores manejan de manera eficiente, manteniendo el costo bajo para ciertas secuencias largas. Esta eficiencia hace que los SSMs sean adecuados para datos de transmisión en tiempo real, como el habla en vivo.
Las ventajas clave de los SSMs para el procesamiento de audio incluyen:
Dependencias de largo alcance de alta calidad: Los SSMs estructurados son una forma de recurrencia lineal, pero su parametrización de estado preserva la información a lo largo de secuencias de audio largas, evitando la decadencia de la señal de largo alcance que limita las redes neuronales recurrentes clásicas (RNNs), como las redes LSTM (long short-term memory).
Huella de memoria constante: A diferencia de los transformadores que almacenan todos los tokens anteriores, los SSMs mantienen un estado oculto de tamaño fijo.
Soporte de transmisión nativo: La estructura recurrente procesa la entrada token por token, por lo que admite la transmisión real sin modificaciones arquitectónicas.
Estas propiedades hacen que los SSMs sean únicos para aplicaciones de voz en tiempo real donde tanto la calidad como la latencia son innegociables.
Cómo funciona: SSMs para voz en tiempo real
Cartesia pone estas ventajas de los SSMs en funcionamiento en dos modelos de voz de producción: Sonic para generación de habla e Ink para transcripción.
Presentando Cartesia
Cartesia es una empresa de inteligencia multimodal en tiempo real que ha construido una aplicación de inteligencia artificial de voz, diseñada específicamente sobre la arquitectura de Modelo de Espacio de Estado. Fundada por investigadores que fueron pioneros en los avances de los SSM, la aplicación de Cartesia está diseñada para inferencia de transmisión en el borde de la percepción humana.
La aplicación cuenta con dos modelos básicos, Sonic para texto a habla e Ink para habla a texto, ambos optimizados para una latencia de primer byte inferior a 100 ms mientras se mantiene una salida de calidad de estudio.
Sonic (texto a habla)
Sonic es el modelo de texto a habla de transmisión insignia de Cartesia, que entrega una síntesis de habla ultrarrealista con una latencia inferior a 100 ms:
Primer byte de audio en aproximadamente 90ms: Los usuarios escuchan la voz responder casi de inmediato.
Cualidad de voz ultra-realista: Prosodia, emoción y expresividad naturales en más de 44 idiomas.
Clonación de voz con datos mínimos: Crea voces personalizadas con sonido natural a partir de muestras de audio de 10 segundos.
Arquitectura nativa de transmisión: El audio comienza a generarse antes de que se reciba la entrada de texto completa.
Síntesis consciente del contexto: Mantiene un tono y estilo consistentes a lo largo de pasajes largos.
Sonic es recomendado para equipos que desean el tiempo de producción más rápido con un mínimo de sobrecarga operativa. Llame a la API y reciba audio de transmisión en tiempo real.
Ink (reconocimiento de voz a texto)
Ink es el modelo de reconocimiento de voz a texto de transmisión de Cartesia, diseñado específicamente para aplicaciones de inteligencia artificial conversacional:
Detección de turnos nativa: Identifica automáticamente cuándo un hablante ha terminado su turno, lo que elimina pausas incómodas sin un modelo de detección de actividad de voz (VAD) o de punto final separado.
Punto final consciente del contexto: Utiliza la comprensión semántica para distinguir entre pausas en medio de una oración y límites de conversación reales.
Transcripción de transmisión: Emite transcritos parciales en tiempo real mientras el usuario habla, para que un modelo de lenguaje grande (LLM) downstream pueda comenzar a formar su respuesta antes de que termine el turno.
Robustez contra el ruido: Mantiene la precisión en entornos ruidosos comunes en implementaciones del mundo real.
Soporte para varios hablantes: Maneja el habla superpuesta y las transiciones de hablante de manera elegante.
Juntos, Sonic e Ink proporcionan la pila de voz de inteligencia artificial completa necesaria para construir agentes conversacionales que se sienten humanos.
Implementación de Cartesia en AWS
Si necesita soberanía de datos, control de latencia o cumplimiento, puede implementar los modelos de Cartesia directamente en su propia cuenta de AWS. Sonic se entrega como un paquete de modelo de inteligencia artificial de Amazon SageMaker a través de AWS Marketplace, que implementa en un punto final de inteligencia artificial de SageMaker que se ejecuta completamente dentro de su nube privada virtual (VPC). Los datos de inferencia no salen de su cuenta.
Los patrones de implementación en esta sección cubren Sonic. Ink está disponible actualmente a través de la API de Cartesia, que puede comprar a través de la plataforma de inteligencia artificial de voz de Cartesia en AWS Marketplace. Hay dos patrones principales disponibles para Sonic.
Opción 1: Amazon SageMaker AI (paquete de modelo de AWS Marketplace)
Implementar en Amazon SageMaker AI es el camino más rápido hacia un punto de conexión Sonic administrado en una VPC. Sonic se envía como un paquete de modelo de AWS Marketplace, por lo que hay un paso de suscripción único que otorga a su cuenta un ARN de paquete de modelo específico de la región de AWS. Luego, crea el punto de conexión de SageMaker AI desde ese ARN, ya sea desde la consola o con el SDK de SageMaker o Boto3. Los siguientes pasos siguen el cuaderno de implementación oficial de Cartesia.
Requisitos previos
Ejecuta desde una instancia de Amazon SageMaker Notebook o SageMaker Studio.
El rol de ejecución de AWS Identity and Access Management (IAM) necesita AmazonSageMakerFullAccess.
Para suscribirse, su rol (y usted) necesitan aws-marketplace:Subscribe, aws-marketplace:Unsubscribe, y aws-marketplace:ViewSubscriptions. De lo contrario, la cuenta ya debe estar suscrita a la lista.
Antes de la implementación, elija un tipo de instancia compatible desde el SupportedRealtimeInferenceInstanceTypes field: del paquete de modelo
ml.g6e.xlarge o superior
ml.g7e.2xlarge o superior
ml.g7.2xlarge o superior
ml.p5.48xlarge
ml.p5en.48xlarge
Si el valor aplicado del tipo de instancia elegido es inferior a su uso actual más la cantidad de instancias de punto de conexión planificada, es posible que deba solicitar un aumento de cuota de servicio. Consulte cuotas de SageMaker AI para obtener más detalles.
Implementar Sonic 3.6 en un punto de conexión de SageMaker
En Amazon SageMaker JumpStart, puede suscribirse a su paquete de modelo de AWS Marketplace, crear un modelo de SageMaker y alojarlo en un punto de conexión en tiempo real. Los siguientes cuatro pasos muestran el camino de implementación.
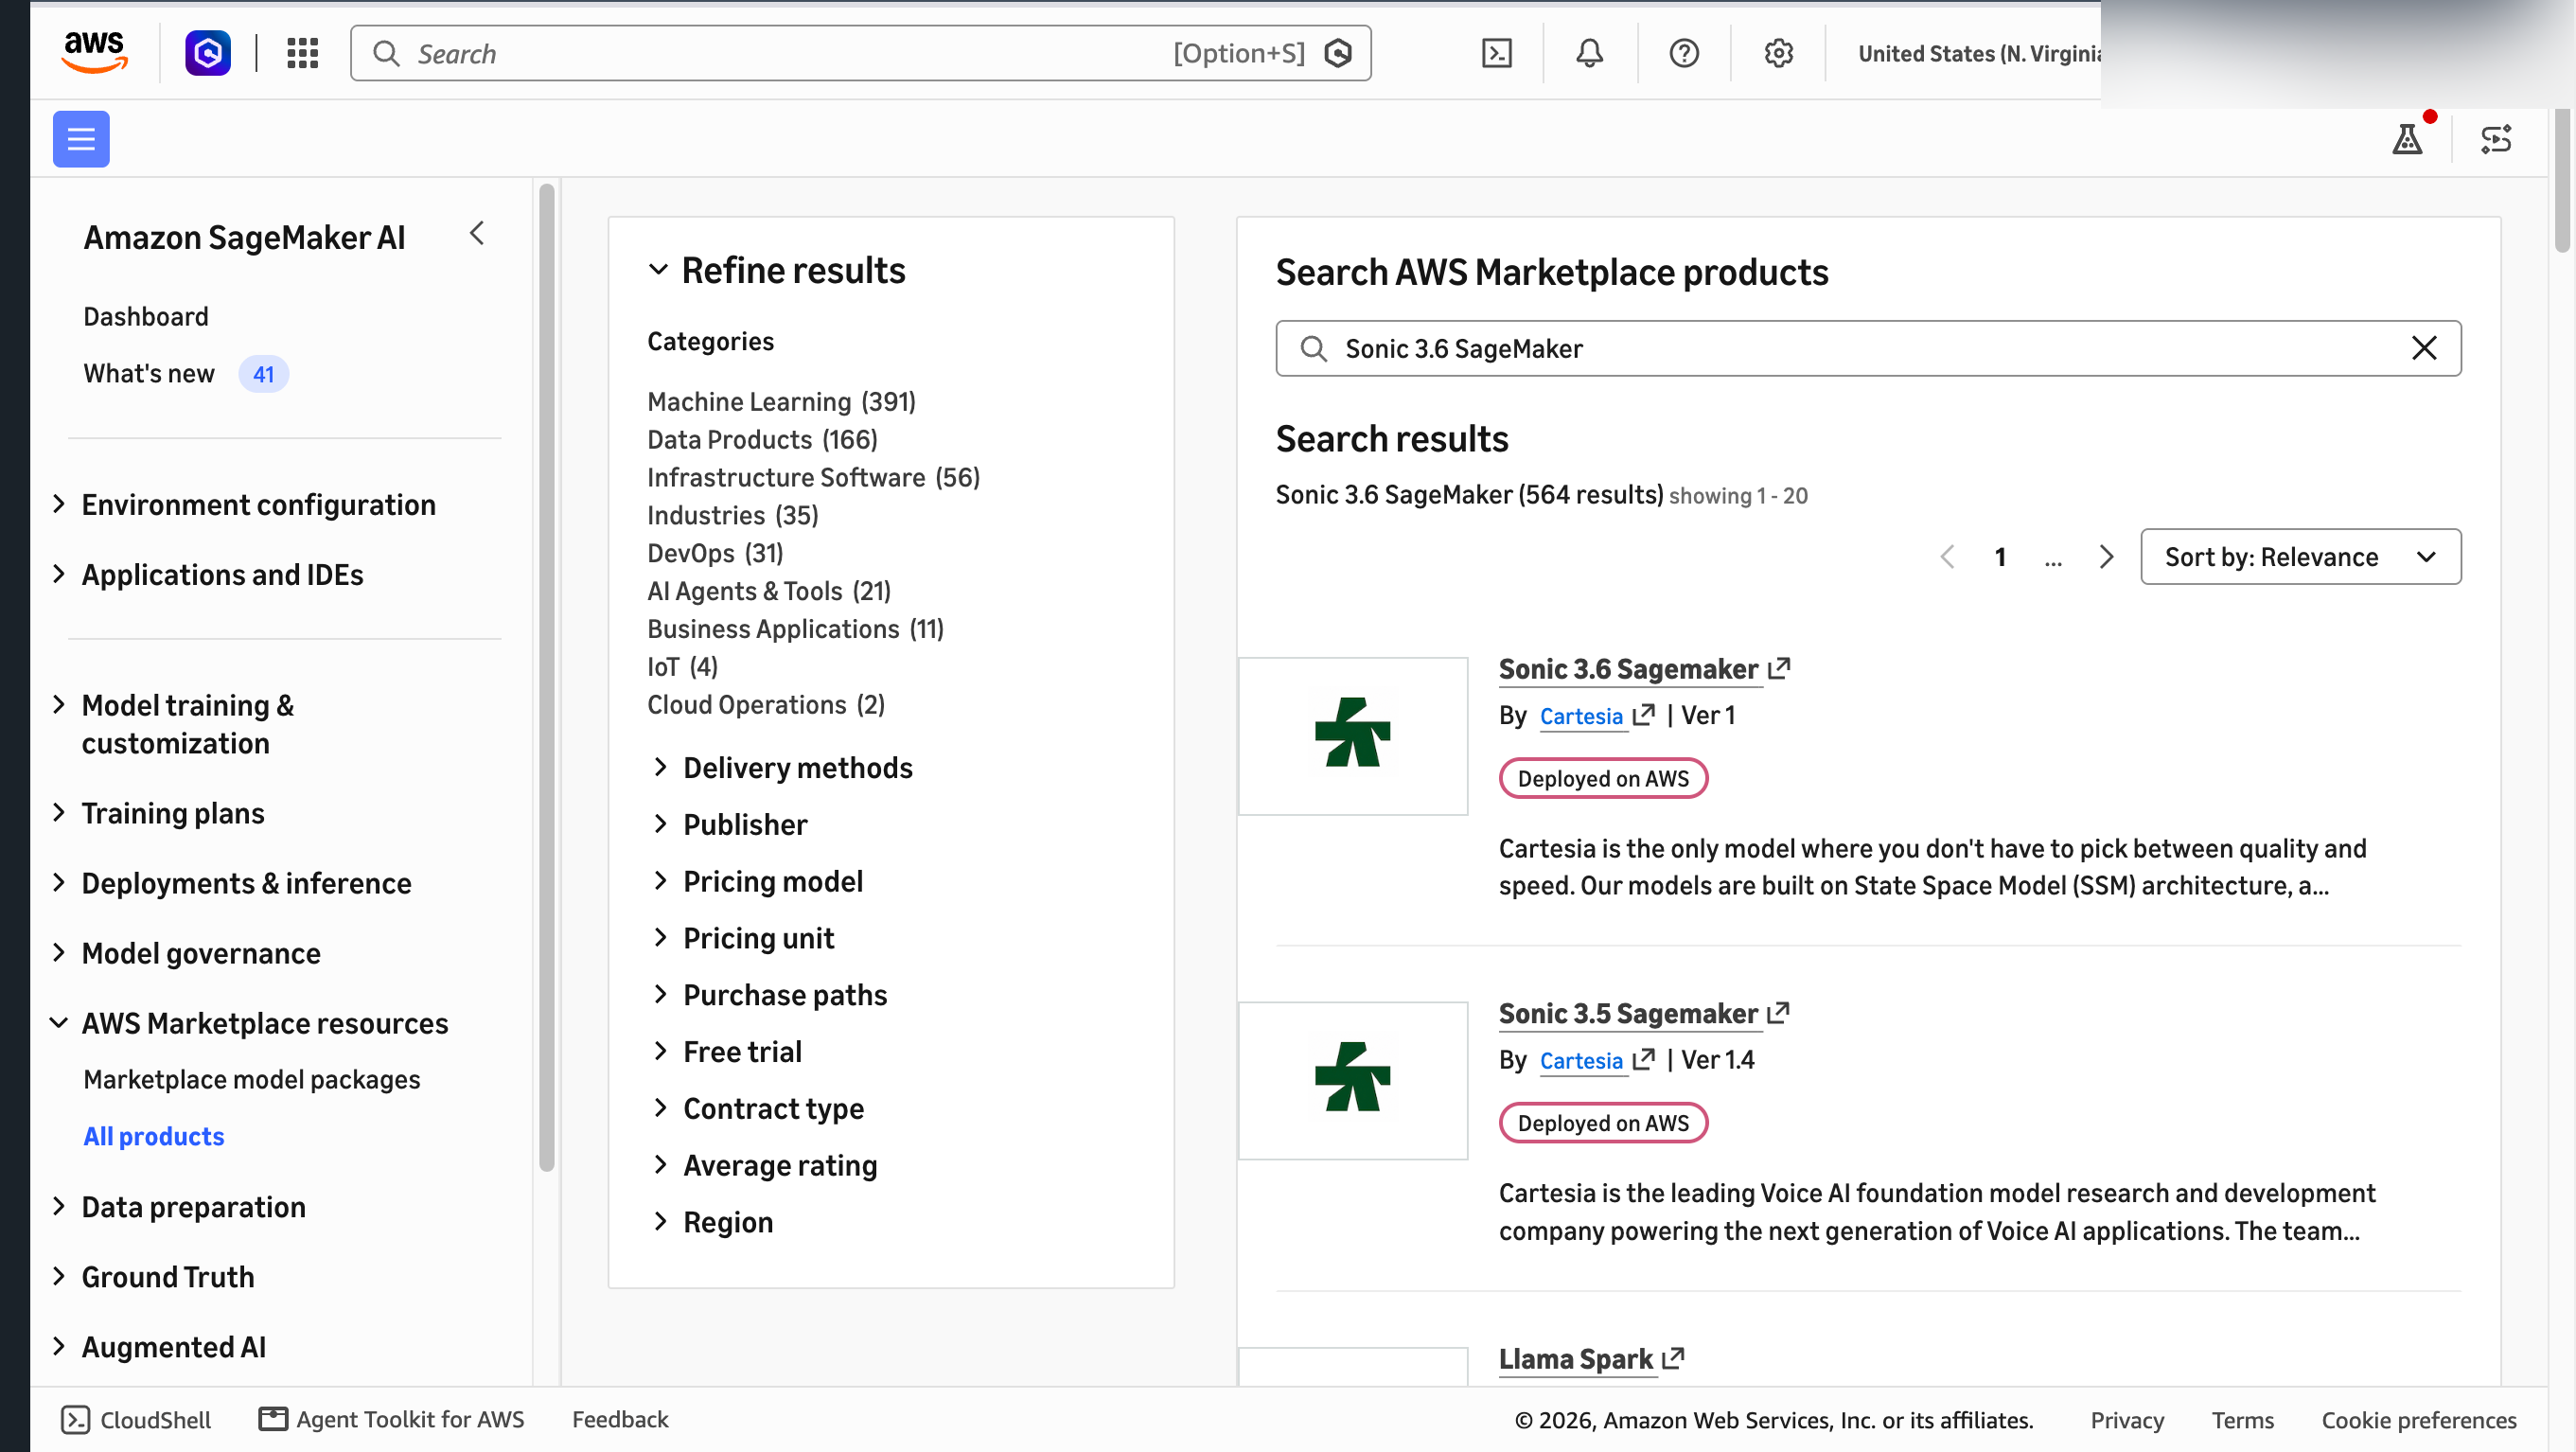
En SageMaker AI, abra Recursos de AWS Marketplace, luego Todos los productos. Busque Sonic 3.6 SageMaker y elija la lista de Cartesia.
Figura 1: Búsqueda de AWS Marketplace para el paquete de modelo de SageMaker Sonic 3.6 de Cartesia
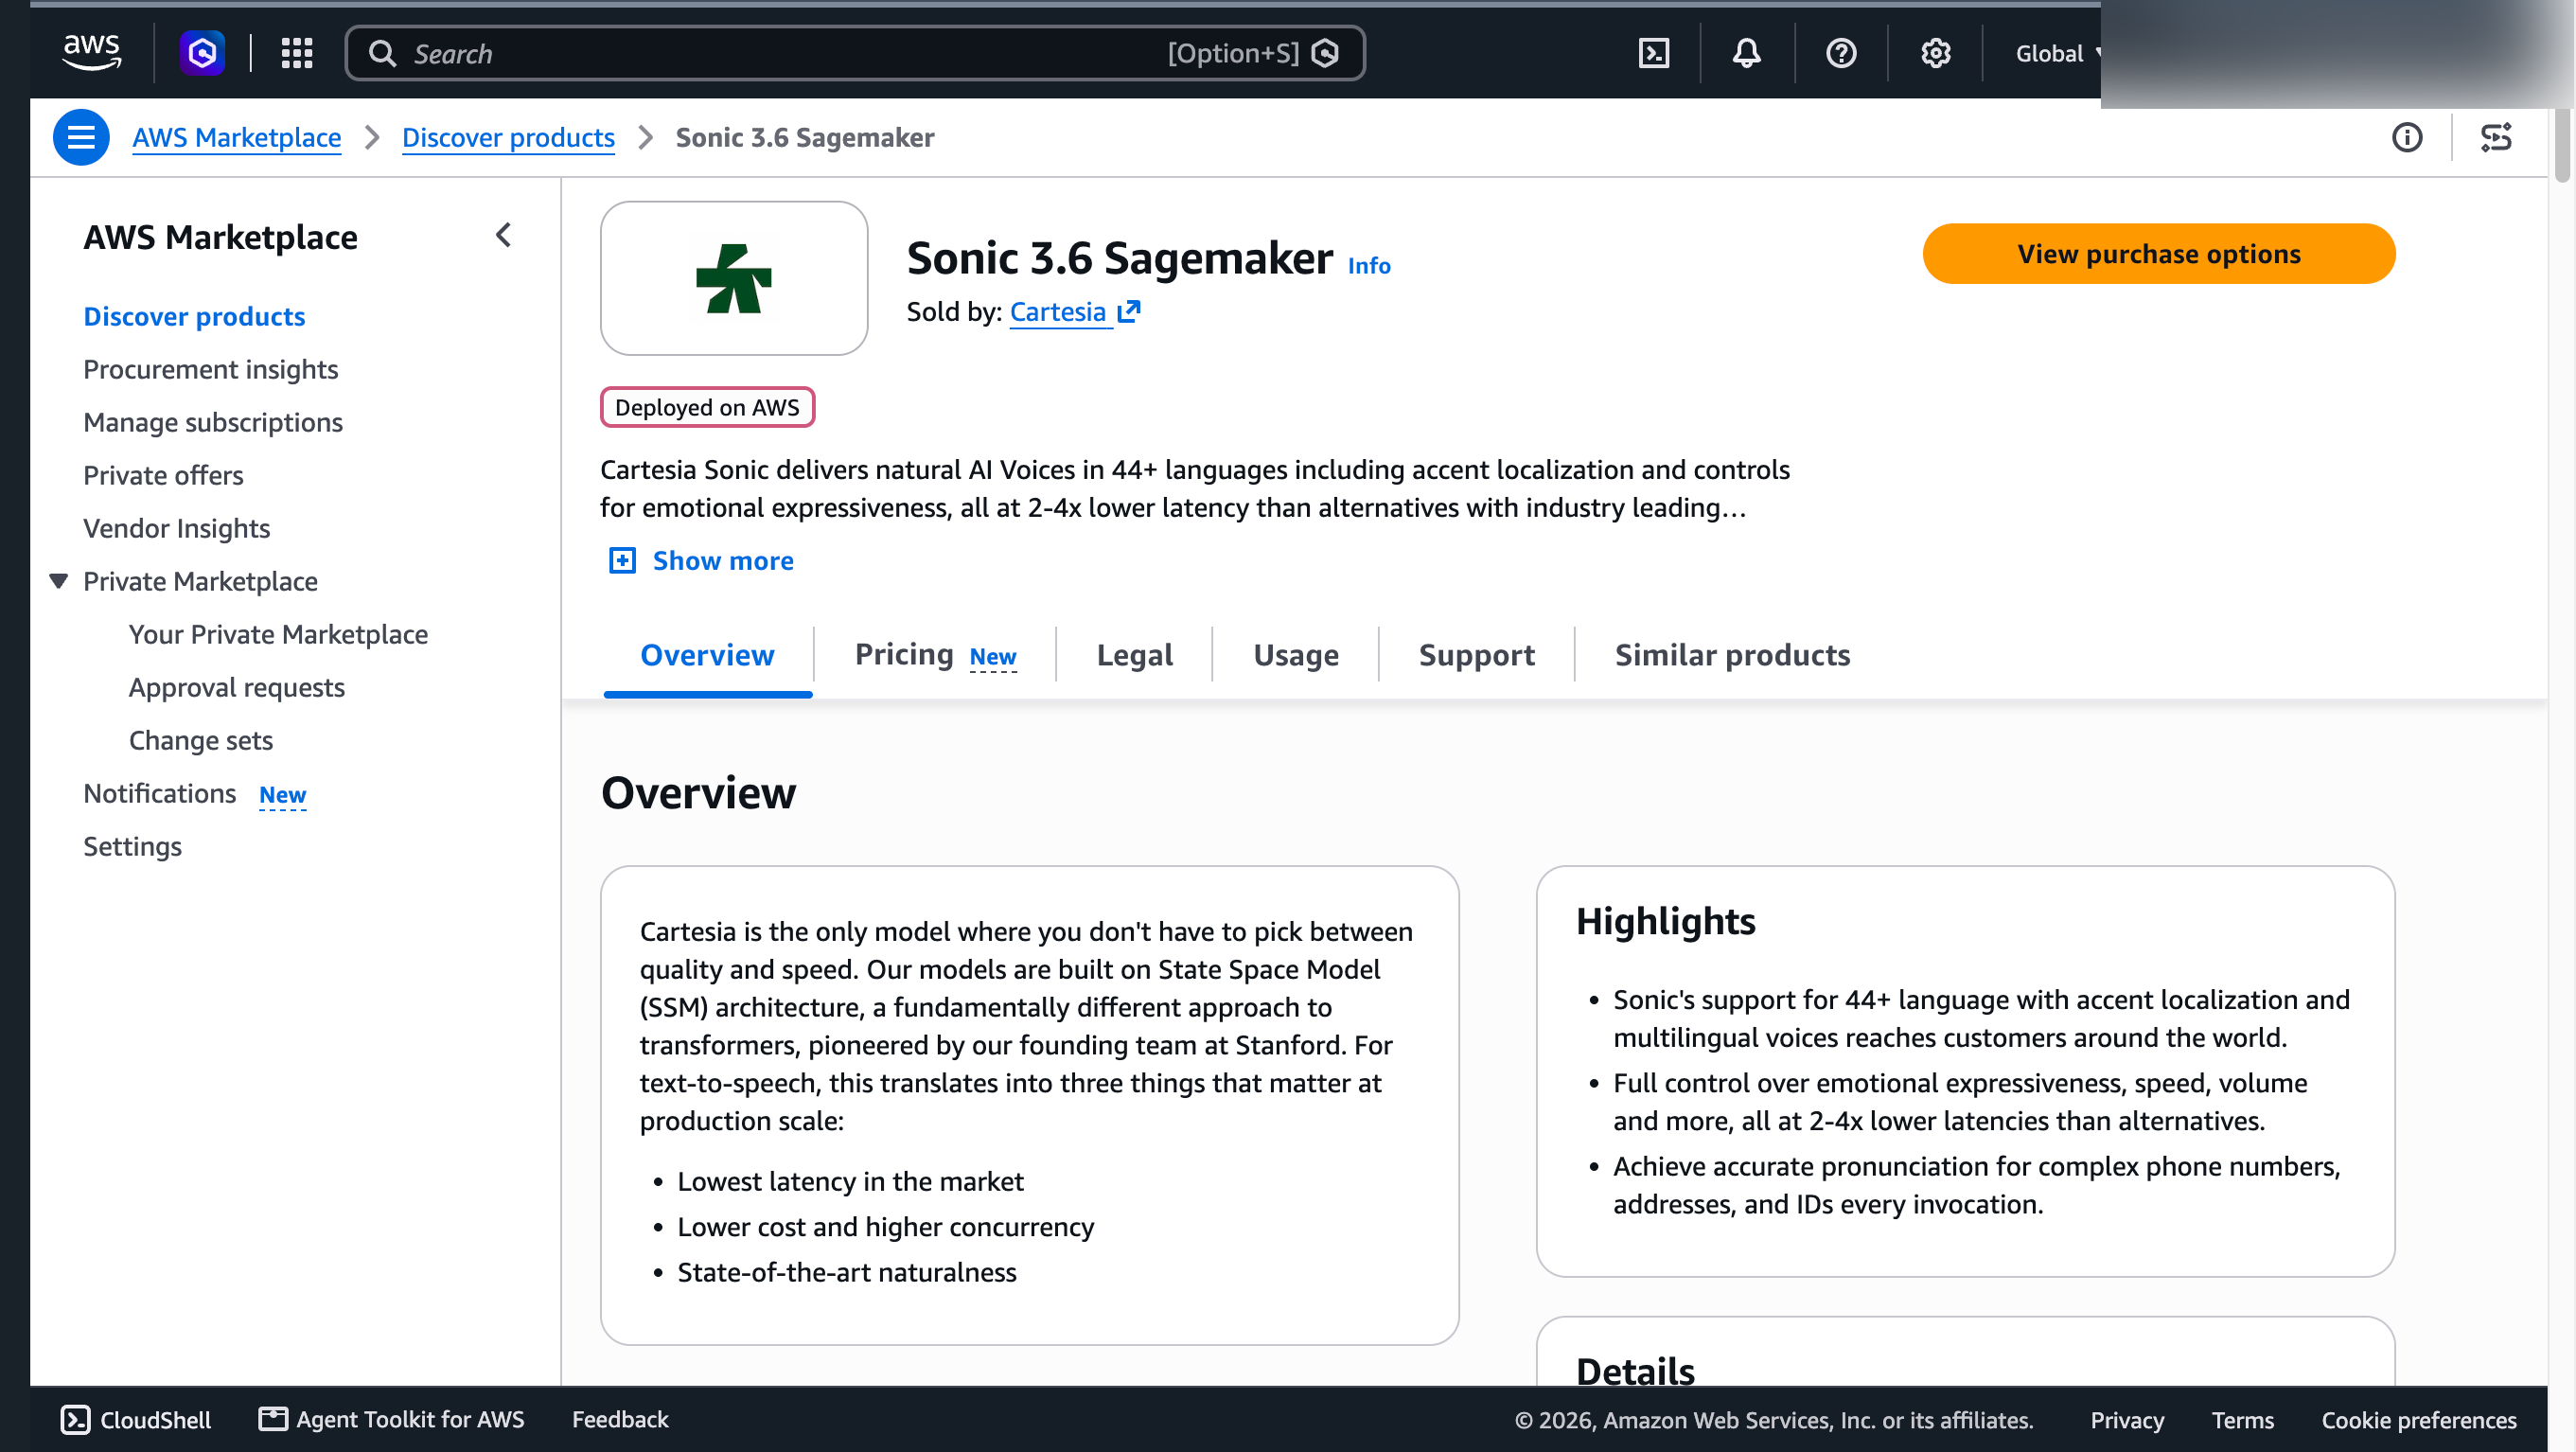
Elija Ver opciones de compra, revise los precios y términos, y suscríbase. La suscripción otorga a su cuenta de AWS acceso al paquete de modelo. No implementa recursos.
Figura 2: La lista de Cartesia Sonic 3.6 en AWS Marketplace
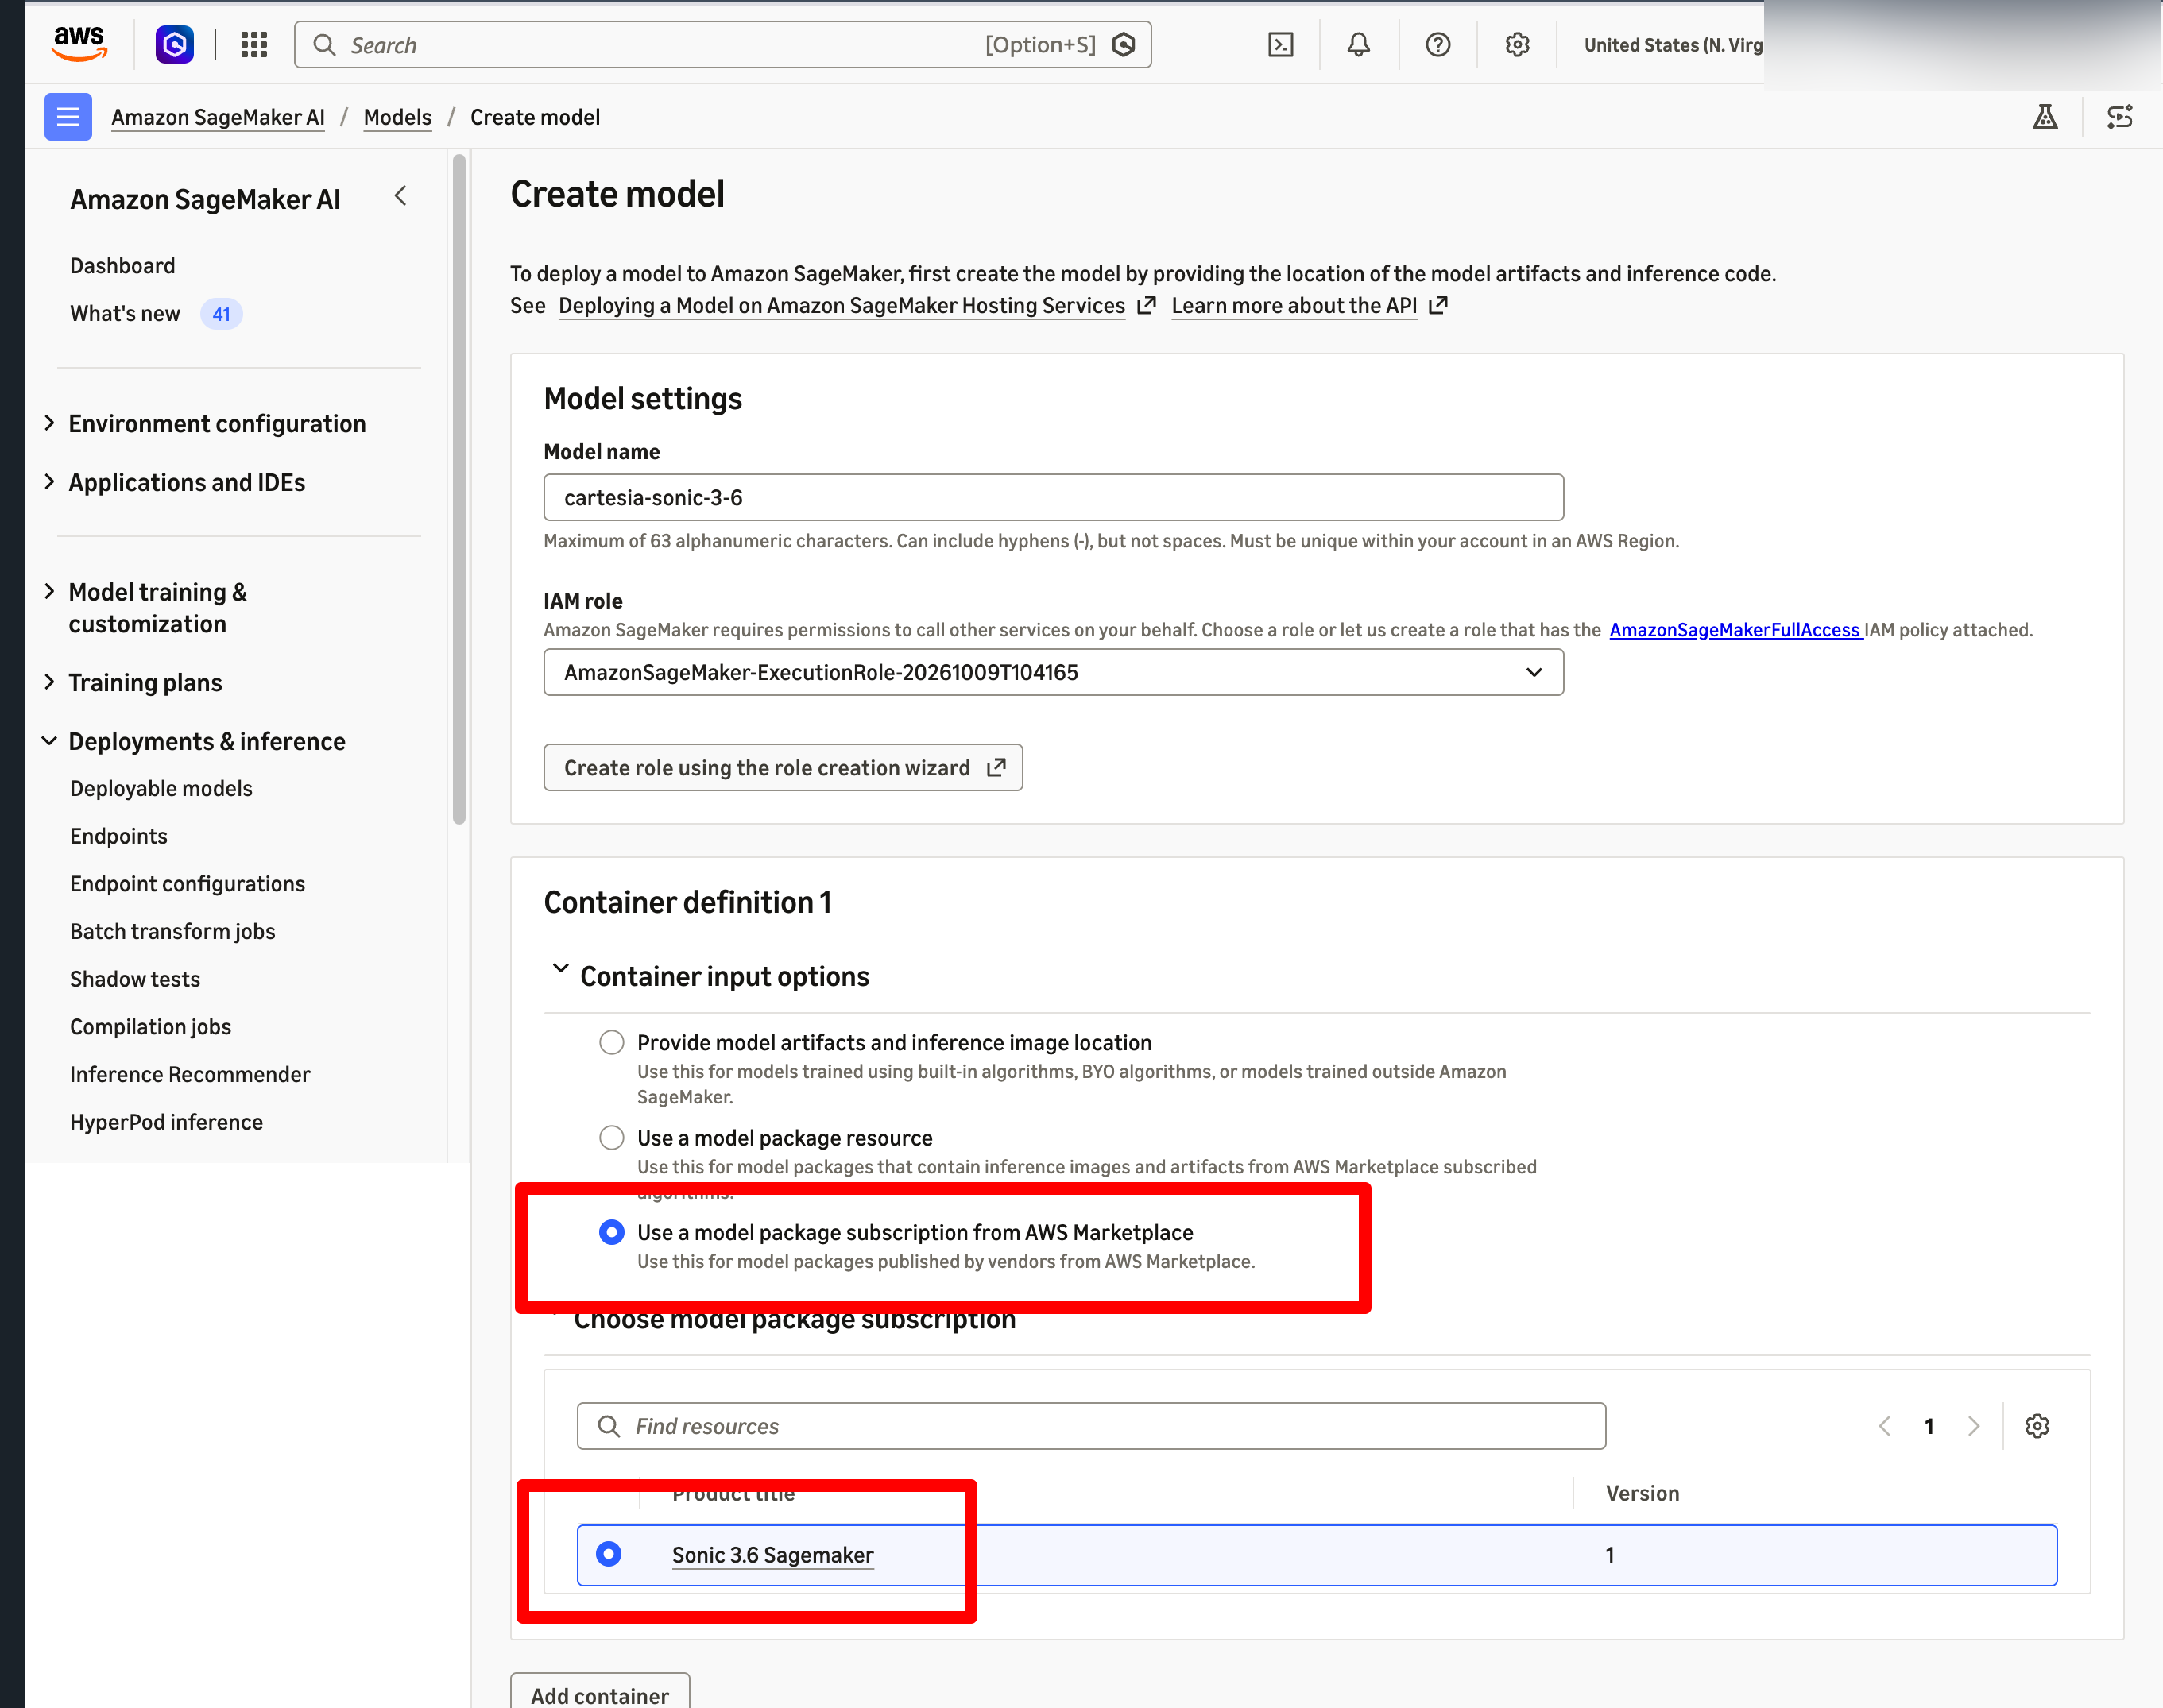
Abrir Implementaciones e inferencia > Modelos implementables, elegir Crear modelo, seleccionar Usar una suscripción de paquete de modelo desde AWS Marketplace y seleccionar Sonic 3.6 SageMaker. Elegir un rol de ejecución, luego crear el modelo.
Figura 3: Creación de un modelo de SageMaker desde la suscripción de Sonic 3.6
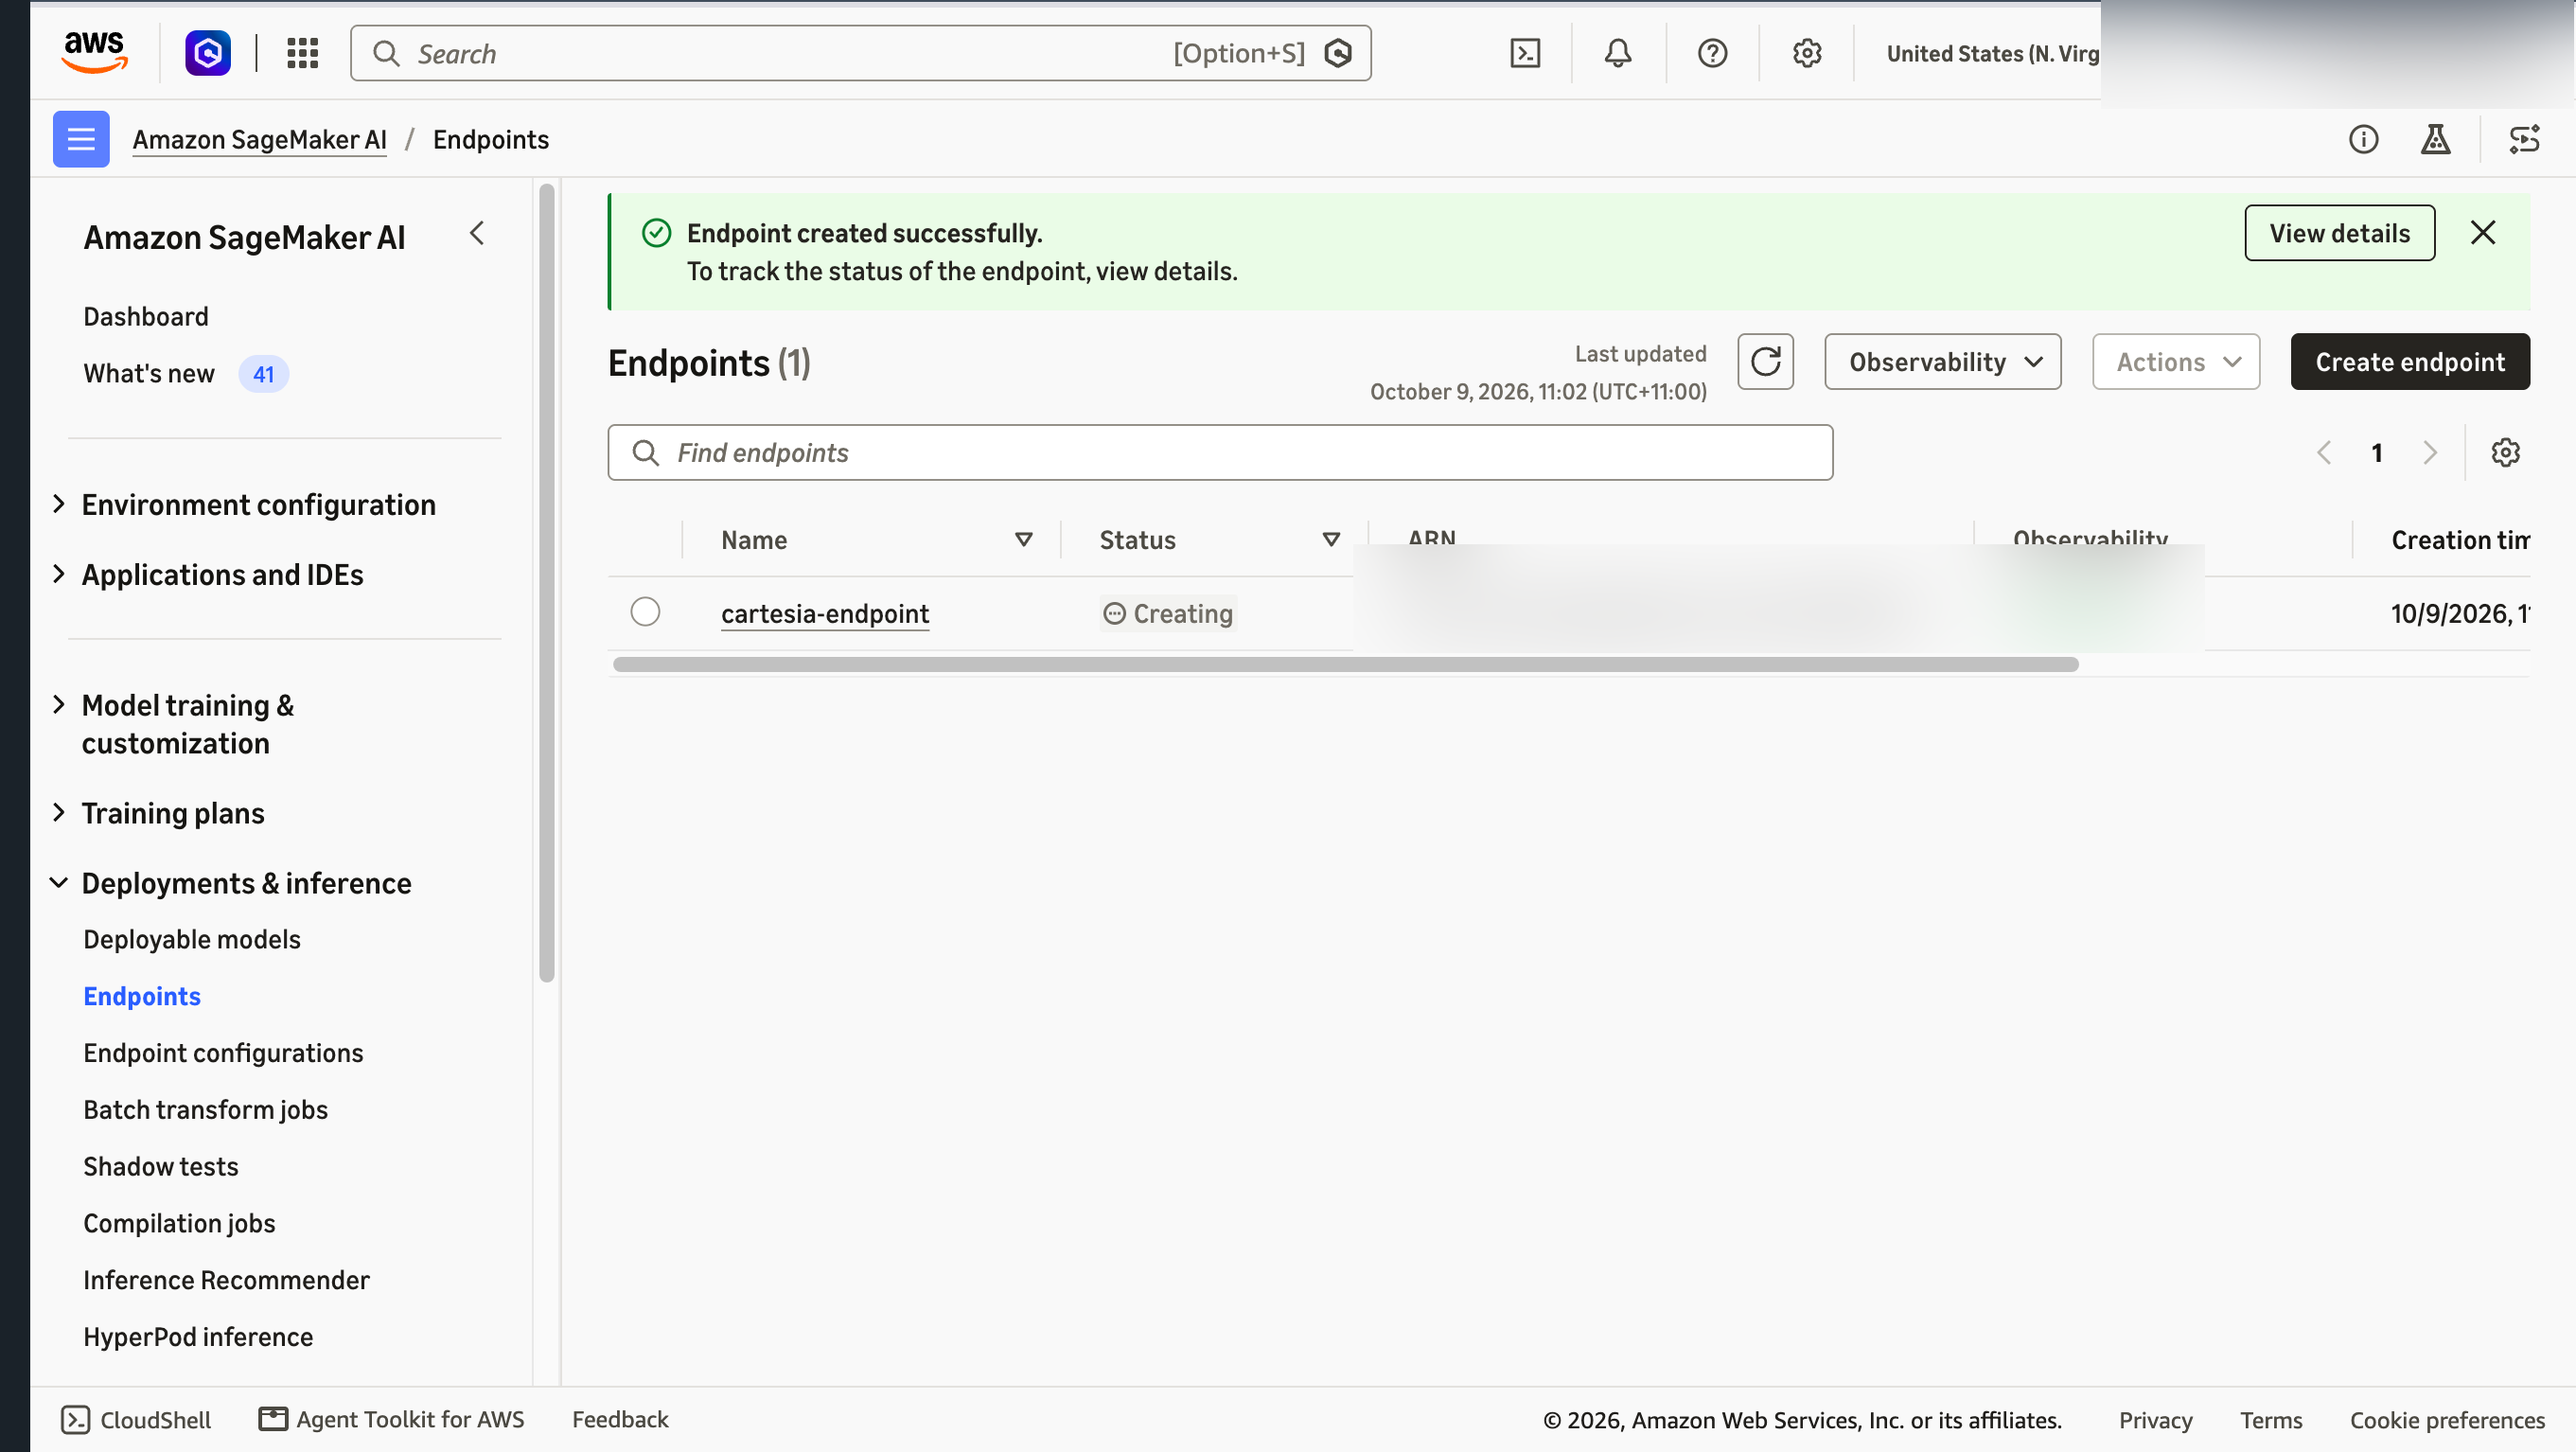
Crear un punto de conexión en tiempo real desde el modelo con una instancia de GPU compatible, como ml.g6e.2xlarge. El punto de conexión aparece primero con estado Creando. Esperar a EnServicio antes de invocarlo.
Figura 4: El punto de conexión de SageMaker para Sonic 3.6
El ARN del paquete de modelo es específico de la región. Para verificar el paquete Sonic 3.6 en US East (N. Virginia) con la API de SageMaker, ejecutar:
Después de que el punto de conexión alcance EnServicio, invocarlo con la API de SageMaker Runtime InvokeEndpointWithResponseStream y procesar el flujo de audio devuelto en la aplicación.
Opción 2: Administrado de forma autónoma en instancias de GPU de EC2
Algunos equipos tienen infraestructura de GPU existente, requisitos de red estrictos o necesidad de coubicar Cartesia con otros servicios. Para estos casos, puede ejecutar el contenedor del modelo usted mismo en instancias de GPU de Amazon Elastic Compute Cloud (Amazon EC2). Esto le da control total sobre el runtime, escalado y ruta de red. Utiliza la imagen del contenedor de Cartesia, obtenida de Cartesia, en lugar del paquete de modelo de AWS Marketplace.
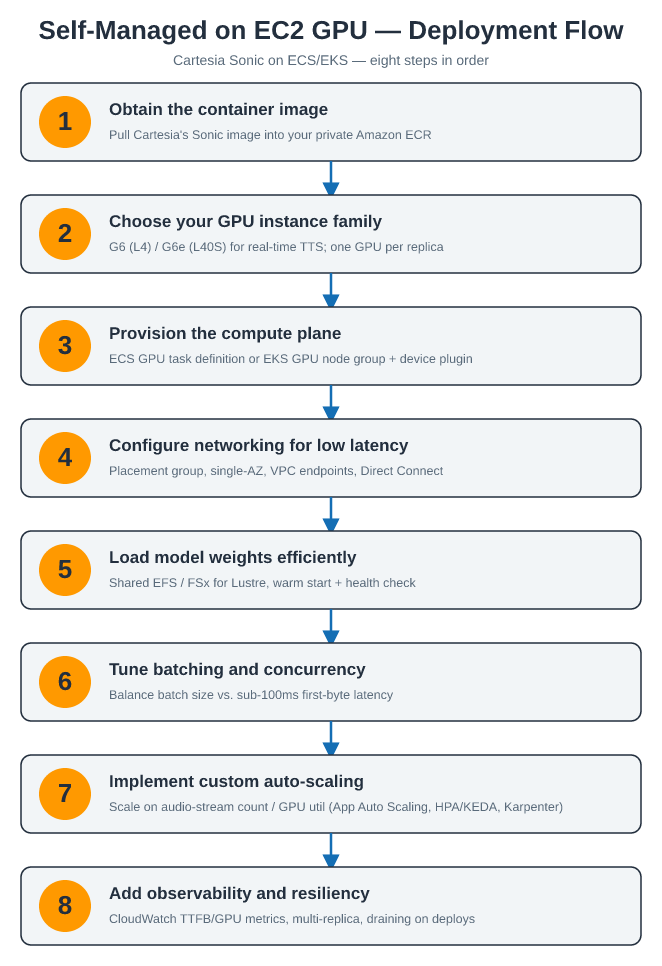
Figura 5: Flujo de implementación autoadministrada para Cartesia Sonic en instancias de GPU de Amazon EC2
Obtenga la imagen del contenedor. Solicite la imagen del contenedor Sonic y los términos de licencia de Cartesia. Replique la imagen en su propio repositorio privado de Amazon Elastic Container Registry (Amazon ECR) para que su plano de cómputo pueda extraerla con credenciales con ámbito de IAM en lugar de acceder a un registro externo a escala.
Seleccione su familia de instancias de GPU. Sonic se ejecuta en instancias de GPU de NVIDIA. Las familias G6 (L4) y G6e (L40S) son el equilibrio óptimo para TTS en tiempo real. La familia G5 (A10G) anterior también funciona. Coincida la memoria de GPU y vCPU con su concurrencia objetivo y prefiera una instancia de GPU única por réplica del modelo para escalado más sencillo.
Proporcione el plano de cómputo (Amazon Elastic Container Service (Amazon ECS) o Amazon Elastic Kubernetes Service (Amazon EKS)). Para ECS: registre una definición de tarea de GPU (establezca el requisito de recursos de GPU del contenedor, por ejemplo, resourceRequirements con tipo GPU) y ejecútela como un servicio detrás de un Application Load Balancer. Para EKS: cree un grupo de nodos de GPU (o un provisionador de Karpenter) utilizando la AMI optimizada para GPU de EKS, instale el plugin de dispositivo de NVIDIA y despliegue el contenedor como una implementación front-end con un Servicio/Ingress.
Configure la red para baja latencia. Coloque los nodos de inferencia en un grupo de colocación de clúster para minimizar la latencia entre nodos, mantenga las réplicas en una sola Zona de disponibilidad para la ruta más ajustada y utilice puntos de conexión de VPC para extracciones de ECR/S3. Para llamadores híbridos o locales, termine el tráfico a través de AWS Direct Connect o un Balanceador de carga de red privado para evitar saltos de internet público.
Carga los pesos del modelo de manera eficiente. Almacena los pesos del modelo en un volumen compartido de baja latencia (Amazon Elastic File System (Amazon EFS) o Amazon FSx para Lustre) montado en réplicas para que las nuevas pods/tareas comiencen sin volver a descargar artefactos de varios GB. Calienta el modelo al iniciar el contenedor y expone una comprobación de estado para que el equilibrador de carga solo enrute a réplicas listas.
Ajusta el procesamiento por lotes y la concurrencia. Establece el tamaño de lote máximo del contenedor y los límites de flujo concurrente para que coincidan con tu perfil de tráfico. Un tamaño de lote más grande mejora la utilización de la GPU, pero agrega latencia de primer byte, así que ajusta contra tu objetivo de sub-100ms. Realiza pruebas de rendimiento de streams-per-GPU para encontrar la capacidad de réplica que escalarás.
Implementa escalado automático personalizado. Escala en una señal que refleje la carga real, como el recuento de streams de audio activos o la utilización de la GPU, en lugar de la CPU. En Amazon ECS, usa AWS Application Auto Scaling con una métrica personalizada de Amazon CloudWatch. En Amazon EKS, usa HPA/KEDA impulsado por una métrica de GPU o recuento de streams, con Karpenter (o Cluster Autoscaler) agregando nodos de GPU a medida que crecen las réplicas.
Agrega observabilidad y resiliencia. Emite latencia (tiempo hasta el primer byte), recuentos de streams y métricas de GPU a CloudWatch. Ejecuta al menos dos réplicas en nodos para disponibilidad. Establece políticas de actualización o drenaje para que las implementaciones no caigan en streams de audio en vuelo.
Se recomienda este enfoque cuando se integra Cartesia en un sistema de aprendizaje automático (ML) existente, se cumplen requisitos de red o cumplimiento no disponibles a través de servicios administrados, o se optimiza el costo con capacidad de GPU Reservada o Spot. El compromiso es que tú eres el responsable de la provisión, escalado, parcheo y monitoreo que SageMaker manejaría por ti.
AWS ofrece dos formas de ejecutar Sonic, cada una adecuada para un punto de partida diferente.
El camino administrado, utilizando el paquete de modelo de inteligencia artificial de Amazon SageMaker desde AWS Marketplace, es el predeterminado para la mayoría de los equipos: te suscribes, implementas en un punto final de VPC en minutos y dejas que SageMaker maneje el escalado y las operaciones.
El camino de administración propia, ejecutando el contenedor del modelo en instancias de GPU de EC2, está diseñado para equipos con restricciones específicas: infraestructura de GPU existente, requisitos de red estrictos o la necesidad de coubicar Cartesia con otros servicios. Para estos equipos, el control total sobre el runtime, la escalabilidad y la ruta de red es más importante que el tiempo de implementación.
La siguiente tabla resume cómo se comparan los dos.
Criterios
SageMaker (Marketplace)
EC2 GPU (Autoadministrado)
Tiempo de implementación
Minutos después de suscribirse
Horas a días
Computación
Punto de conexión en tiempo real. Vea SupportedRealtimeInferenceInstanceTypes para instancias compatibles.
Instancias de GPU de EC2
Control operativo
Administrado por AWS
Control total
Escalabilidad
Escalabilidad automática de SageMaker
Políticas de escalabilidad personalizadas
Modelo de costo
Tarifa de software + por hora de instancia + infra
EC2 (ahorros de Reserved/Spot)
Red
Punto de conexión en VPC (aislamiento de red)
Grupos de colocación, Direct Connect
Mejor para
Rápido, administrado, en VPC
Infraestructura personalizada, control máximo
Más allá de implementar Cartesia en su propia cuenta, estos modelos ya han sido probados en producción dentro de los servicios de Amazon, y pocos entornos son más exigentes para la voz en tiempo real que un centro de contacto en vivo. Amazon Connect es precisamente ese campo de pruebas.
En producción: Amazon Connect
¿Qué es Amazon Connect?
Amazon Connect es un servicio de centro de contacto basado en la nube que las empresas utilizan para configurar y ejecutar operaciones de soporte al cliente que manejan llamadas de voz entrantes y salientes, chat y mensajería. Con precios de pago por uso y una integración profunda con los servicios de AWS, Amazon Connect impulsa millones de interacciones de clientes diarias en diversas industrias, desde servicios financieros hasta atención médica.
Cómo Cartesia potencia la experiencia de Amazon Connect
Los modelos de inteligencia artificial de voz de Cartesia se integran de forma nativa con Amazon Connect para ofrecer experiencias de centro de contacto de próxima generación:
Respuesta instantánea: Alivie las pausas poco naturales que erosionan la confianza del cliente en las interacciones impulsadas por inteligencia artificial.
Transcripción en tiempo real: Ink proporciona transcripción en vivo con detección de turnos inteligentes para flujos de trabajo de asistencia de agentes.
Soporte multilingüe: Sirva a los clientes en más de 44 idiomas con calidad de voz consistente y prosodia natural.
Infraestructura escalable: Maneje los picos de tráfico durante las horas pico sin degradación en la calidad de voz o la latencia.
Al combinar la orquestación omnicanal de Amazon Connect con la inteligencia de voz en tiempo real de Cartesia, puede automatizar interacciones de clientes complejas mientras mantiene la experiencia natural y receptiva que genera confianza y lealtad.
Empezar
¿Listo para crear aplicaciones de inteligencia artificial de voz con latencia ultra baja? Estos son los siguientes pasos:
Implementar Sonic a través de SageMaker JumpStart: Busque “Cartesia” en el centro de modelos de SageMaker JumpStart e implemente un punto de conexión en tiempo real en minutos.
Probar la API de Cartesia: Comience con la guía de inicio de Cartesia. No se requiere configuración de infraestructura.
Explorar arquitecturas de referencia: Visite el repositorio de GitHub de Cartesia para obtener cuadernos de ejemplo, plantillas de implementación y ejemplos de integración.
Conversational AI is transforming how humans interact with technology. From virtual assistants and AI-powered contact centers to real-time translation and accessibility tools, voice-first interfaces are rapidly becoming the default mode of interaction for millions of users worldwide.
Yet delivering a truly natural voice experience remains one of the hardest challenges in AI infrastructure. Users expect human-like responsiveness. Excess latency can break conversational flow and erode trust. To feel natural, AI-generated speech must arrive within the same temporal window as human turn-taking.
This post introduces how Cartesia, an AWS Partner specializing in real-time voice AI, uses purpose-built State Space Models (SSMs) and AWS infrastructure to deliver sub-100ms text-to-speech and speech-to-text at global scale. Developers can build voice experiences that feel indistinguishable from human conversation.
The rise of conversational AI and latency expectations
The demand for real-time voice AI is growing rapidly across industries:
Contact centers: AI agents handling millions of customer interactions require instantaneous speech generation to maintain natural dialogue.
Gaming and virtual worlds: Immersive experiences require real-time voice synthesis for non-player characters (NPCs) and player interactions.
Accessibility: Screen readers and voice interfaces must respond instantly to serve users with visual impairments.
Inbound and outbound sales: AI sales agents must respond without awkward pauses to qualify leads, handle objections, and keep prospects on the line.
Traditional transformer-based text-to-speech (TTS) models struggle with streaming latency because they process entire sequences before producing output. This architectural limitation creates a fundamental tension: higher quality often means higher latency. A new class of models, State Space Models, resolves this trade-off.
AI for voice: State Space Models (SSM)
State Space Models (SSMs) take a fundamentally different approach to processing sequences than transformers, the architecture behind most of today’s AI. Transformers use a mechanism called attention, which compares every element in a sequence to every other element. As a result, the amount of computation grows quadratically as the sequence gets longer. SSMs instead treat a sequence as a system that evolves continuously over time, processing it step by step and carrying a compact internal state forward. This can be converted into a form computers handle efficiently, keeping the cost low for certain long sequences. This efficiency makes SSMs well suited to real-time, streaming data like live speech.
Key advantages of SSMs for audio processing include:
High-quality long-range dependencies: Structured SSMs are a form of linear recurrence, but their state parameterization preserves information over long audio sequences, avoiding the long-range signal decay that limits classic recurrent neural networks (RNNs) such as long short-term memory (LSTM) networks.
Constant memory footprint: Unlike transformers that cache all previous tokens, SSMs maintain a fixed-size hidden state.
Native streaming support: The recurrent structure processes input token-by-token, so it supports true streaming without architectural modifications.
These properties make SSMs uniquely suited for real-time voice applications where both quality and latency are non-negotiable.
How it works: SSMs for real-time voice
Cartesia puts these SSM advantages to work in two production voice models: Sonic for speech generation and Ink for transcription.
Introducing Cartesia
Cartesia is a real-time multimodal intelligence company that has built a voice AI application, purpose-built on State Space Model architecture. Founded by researchers who pioneered SSM advances, Cartesia’s application is designed for streaming inference at the edge of human perception.
The application features two core models, Sonic for text-to-speech and Ink for speech-to-text, both optimized for sub-100ms first-byte latency while maintaining studio-quality output.
Sonic (text-to-speech)
Sonic is Cartesia’s flagship streaming text-to-speech model, delivering ultra-realistic speech synthesis with sub-100ms latency:
First audio byte in approximately 90ms: Users hear the voice respond almost instantaneously.
Ultra-realistic voice quality: Natural prosody, emotion, and expressiveness across over 44 languages.
Voice cloning with minimal data: Create natural-sounding custom voices from 10-second audio samples.
Streaming-native architecture: Audio begins generating before the full text input is received.
Context-aware synthesis: Maintains consistent tone and style across long passages.
Sonic is recommended for teams that want the fastest time-to-production with minimal operational overhead. Call the API and receive streaming audio in real time.
Ink (speech-to-text)
Ink is Cartesia’s streaming speech-to-text model, purpose-built for conversational AI applications:
Native turn detection: Automatically identifies when a speaker has finished their turn, alleviating awkward pauses without a separate voice activity detection (VAD) or end pointing model.
Context-aware end pointing: Uses semantic understanding to distinguish between mid-sentence pauses and true conversation boundaries.
Streaming transcription: Emits partial transcripts in real time as the user speaks, so a downstream large language model (LLM) can begin forming its response before the turn ends.
Noise robustness: Maintains accuracy in noisy environments common in real-world deployments.
Multi-speaker support: Handles overlapping speech and speaker transitions gracefully.
Together, Sonic and Ink provide the complete voice AI stack needed to build conversational agents that feel human.
Deploying Cartesia on AWS
If you need data sovereignty, latency control, or compliance, you can deploy Cartesia models directly into your own AWS account. Sonic is delivered as an Amazon SageMaker AI model package through AWS Marketplace, which you deploy to a SageMaker AI endpoint running entirely within your virtual private cloud (VPC). Inference data doesn’t leave your account.
The deployment patterns in this section cover Sonic. Ink is currently available through the Cartesia API, which you can purchase through the Cartesia Voice AI Platform listing in AWS Marketplace. Two primary patterns are available for Sonic.
Option 1: Amazon SageMaker AI (AWS Marketplace model package)
Deploying on Amazon SageMaker AI is the fastest path to a managed, in-VPC Sonic endpoint. Sonic ships as an AWS Marketplace model package, so there’s a one-time subscribe step that grants your account an AWS Region-specific model-package ARN. You then create the SageMaker AI endpoint from that ARN, either from the console or with the SageMaker or Boto3 SDK. The following steps follow Cartesia’s official deployment notebook.
Prerequisites
Run from an Amazon SageMaker Notebook Instance or SageMaker Studio.
The AWS Identity and Access Management (IAM) execution role needs AmazonSageMakerFullAccess.
To subscribe, your role (and you) need aws-marketplace:Subscribe, aws-marketplace:Unsubscribe, and aws-marketplace:ViewSubscriptions. Otherwise, the account must already be subscribed to the listing.
Before deployment, choose a supported instance type from the model package’s SupportedRealtimeInferenceInstanceTypes field:
ml.g6e.xlarge or larger
ml.g7e.2xlarge or larger
ml.g7.2xlarge or larger
ml.p5.48xlarge
ml.p5en.48xlarge
If your chosen instance type’s applied value is below your current usage plus your planned endpoint instance count, you may need to request a service quota increase. See SageMaker AI quotas for details.
Deploy Sonic 3.6 to a SageMaker endpoint
In Amazon SageMaker JumpStart, you can subscribe to its AWS Marketplace model package, create a SageMaker model, and host it on a real-time endpoint. The following four steps show the deployment path.
In SageMaker AI, open AWS Marketplace resources, then All products. Search for Sonic 3.6 SageMaker and choose the Cartesia listing.
Figure 1: Searching AWS Marketplace for the Cartesia Sonic 3.6 SageMaker model package
Choose View purchase options, review the pricing and terms, and subscribe. The subscription grants your AWS account access to the model package. It doesn’t deploy resources.
Figure 2: The Cartesia Sonic 3.6 listing in AWS Marketplace
Open Deployments & inference > Deployable models, choose Create model, select Use a model package subscription from AWS Marketplace, and select Sonic 3.6 SageMaker. Choose an execution role, then create the model.
Figure 3: Creating a SageMaker model from the Sonic 3.6 subscription
Create a real-time endpoint from the model with a supported GPU instance, such as ml.g6e.2xlarge. The endpoint first appears with Creating status. Wait for InService before invoking it.
Figure 4: The SageMaker endpoint for Sonic 3.6
The model-package ARN is Region-specific. To verify the Sonic 3.6 package in US East (N. Virginia) with the SageMaker API, run:
After the endpoint reaches InService, invoke it with the SageMaker Runtime InvokeEndpointWithResponseStream API and process the returned audio stream in your application.
Option 2: Self-managed on EC2 GPU instances
Some teams have existing GPU infrastructure, strict networking requirements, or a need to co-locate Cartesia with other services. For these cases, you can run the model container yourself on Amazon Elastic Compute Cloud (Amazon EC2) GPU instances. This gives you full control over the runtime, scaling, and network path. It uses Cartesia’s container image, obtained from Cartesia, rather than the AWS Marketplace model package.
Figure 5: Self-managed deployment flow for Cartesia Sonic on Amazon EC2 GPU instances
Obtain the container image. Request the Sonic container image and licensing terms from Cartesia. Replicate it into your own private Amazon Elastic Container Registry (Amazon ECR) repository so your compute plane can pull it with IAM-scoped credentials rather than reaching out to an external registry at scale.
Choose your GPU instance family. Sonic runs on NVIDIA GPU instances. The G6 (L4) and G6e (L40S) families are the optimal balance for real-time TTS. The earlier G5 (A10G) also works. Match GPU memory and vCPU to your target concurrency and prefer a single-GPU instance per model replica for simplest scaling.
Provision the compute plane (Amazon Elastic Container Service (Amazon ECS) or Amazon Elastic Kubernetes Service (Amazon EKS)). For ECS: register a GPU task definition (set the container’s GPU resource requirement, for example, resourceRequirements with type GPU) and run it as a service behind an Application Load Balancer. For EKS: create a GPU node group (or Karpenter provisioner) using the EKS GPU-optimized AMI, install the NVIDIA device plugin, and deploy the container as a Deployment fronted by a Service/Ingress.
Configure networking for low latency. Place inference nodes in a cluster placement group to minimize inter-node latency, keep replicas in a single Availability Zone for the tightest path, and use VPC endpoints for ECR/S3 pulls. For hybrid or on-premises callers, terminate traffic over AWS Direct Connect or a private Network Load Balancer to avoid public-internet hops.
Load model weights efficiently. Store model weights on a shared, low-latency volume (Amazon Elastic File System (Amazon EFS) or Amazon FSx for Lustre) mounted across replicas so new pods/tasks start without each re-downloading multi-GB artifacts. Warm the model at container start and expose a health check so the load balancer only routes to ready replicas.
Tune batching and concurrency. Set the container’s max batch size and concurrent-stream limits to match your traffic profile. Higher batch size improves GPU utilization but adds first-byte latency, so tune against your sub-100ms target. Benchmark streams-per-GPU to find the replica capacity you will scale on.
Implement custom auto scaling. Scale on a signal that reflects real load, active audio-stream count or GPU utilization, rather than CPU. On Amazon ECS, use AWS Application Auto Scaling with a custom Amazon CloudWatch metric. On Amazon EKS, use HPA/KEDA driven by a GPU or stream-count metric, with Karpenter (or Cluster Autoscaler) adding GPU nodes as replicas grow.
Add observability and resiliency. Emit latency (time-to-first-byte), stream counts, and GPU metrics to CloudWatch. Run at least two replicas across nodes for availability. Set rolling-update or draining policies so deployments don’t drop in-flight audio streams.
This approach is recommended when integrating Cartesia into an existing machine learning (ML) system, meeting networking or compliance requirements not available through managed services, or optimizing cost with Reserved or Spot GPU capacity. The trade-off is that you own provisioning, scaling, patching, and monitoring that SageMaker would otherwise handle for you.
AWS offers two ways to run Sonic, each suited to a different starting point.
The managed path, using the Amazon SageMaker AI model package from AWS Marketplace, is the default for most teams: you subscribe, deploy to an in-VPC endpoint in minutes, and let SageMaker handle scaling and operations.
The self-managed path, running the model container yourself on EC2 GPU instances, is designed for teams with specific constraints: existing GPU infrastructure, strict networking requirements, or a need to co-locate Cartesia with other services. For these teams, full control over the runtime, scaling, and network path matters more than time to deployment.
The following table summarizes how the two compare.
Criteria
SageMaker (Marketplace)
EC2 GPU (Self-Managed)
Time to Deployment
Minutes after subscribing
Hours to days
Compute
Real-time endpoint. See SupportedRealtimeInferenceInstanceTypes for supported instances.
EC2 GPU instances
Operational Control
Managed by AWS
Full control
Scaling
SageMaker automatic scaling
Custom scaling policies
Cost Model
Software fee + per instance hour + infra
EC2 (Reserved/Spot savings)
Networking
In-VPC endpoint (network isolation)
Placement groups, Direct Connect
Best For
Fast, managed, in-VPC
Custom infra, max control
Beyond deploying Cartesia in your own account, these models are already proven in production inside Amazon services, and few environments are more demanding for real-time voice than a live contact center. Amazon Connect is exactly that proving ground.
In production: Amazon Connect
This section shows how Cartesia’s voice models operate inside Amazon Connect at production scale.
What is Amazon Connect?
Amazon Connect is a cloud-based contact center service that businesses use to set up and run customer support operations that handle inbound and outbound voice calls, chat, and messaging. With pay-as-you-go pricing and deep integration with AWS services, Amazon Connect powers millions of customer interactions daily across industries from financial services to healthcare.
How Cartesia powers the Amazon Connect experience
Cartesia’s voice AI models integrate natively with Amazon Connect to deliver next-generation contact center experiences:
Instant responsiveness: Alleviate unnatural pauses that erode customer confidence in AI-powered interactions.
Real-time transcription: Ink provides live transcription with intelligent turn detection for agent-assist workflows.
Multilingual support: Serve customers in over 44 languages with consistent voice quality and natural prosody.
Scalable infrastructure: Handle traffic spikes during peak hours without degradation in voice quality or latency.
By combining the omnichannel orchestration of Amazon Connect with Cartesia’s real-time voice AI, you can automate complex customer interactions while maintaining the natural, responsive experience that builds trust and loyalty.
Getting started
Ready to build ultra-low-latency voice AI applications? Here are next steps:
Deploy Sonic through SageMaker JumpStart: Search for “Cartesia” in the SageMaker JumpStart model hub and deploy a real-time endpoint in minutes.
Try the Cartesia API: Get started with the Cartesia get-started guide. No infrastructure setup required.
Explore reference architectures: Visit the Cartesia GitHub repository for sample notebooks, deployment templates, and integration examples.