Ajuste preciso del GPT-OSS-20B para el razonamiento multilingüe en Amazon SageMaker HyperPod
Fine-tuning GPT-OSS-20B for multilingual reasoning on Amazon SageMaker HyperPod
Mijanur Palash
El GPT-OSS-20B es un modelo de razonamiento de peso abierto que piensa en inglés. Pídele que razone en francés, alemán, español o italiano y, de todos modos, reconocerá la instrucción y, de todos modos, expresará su cadena de pensamiento en inglés. En una prueba de razonamiento multilingüe de 50 ejemplos, el modelo base razonó en el idioma de destino correcto solo el 22 por ciento de las veces. Ese 22 por ciento correspondió casi en su totalidad a ejemplos en inglés (100 por ciento en inglés, 0 por ciento en francés, 10 por ciento en alemán, 0 por ciento en español, 0 por ciento en italiano
).
Para los equipos que implementan modelos de razonamiento para usuarios que no hablan inglés, esa brecha es importante. Un usuario que hace una pregunta en francés espera que el modelo razone y responda en francés, no que cambie al inglés a mitad de camino. Cerrar esa brecha es un problema de ajuste. Esto plantea una pregunta a la que se enfrentan todos los equipos una vez que comienzan a personalizar los modelos de peso libre: ¿ajustes supervisados (SFT), aprendizaje reforzado con la optimización de políticas relativas grupales (GRPO
) o ambos?
En este artículo, explicamos cómo ajustamos el GPT-OSS-20B para que permitiera el razonamiento multilingüe en Amazon SageMaker HyperPod. Mostramos cuándo el SFT por sí solo fue suficiente y cuándo el GRPO añadió un valor cuantificable. Para comprender de manera más amplia cuándo ayuda el GRPO, también realizamos un experimento controlado con el Qwen2.5-7B en dos tareas con diferentes brechas de capacidad. La respuesta resumida: el SFT hace la mayor parte del trabajo, el GRPO lo perfecciona cuando hay margen para perfeccionarlo, y lo que decide el resultado es adaptar la técnica a la brecha
de capacidad.
Descripción general de la solución
En esta sección se describen la tarea y el conjunto de datos de razonamiento multilingües, cómo se complementan SFT y GRPO y el conjunto de programas de formación que utilizamos en Amazon SageMaker HyperPod.
La tarea y el conjunto de datos
El conjunto de datos es HuggingFaceH4/Multilingual-Thinking, un conjunto de datos sobre el razonamiento en cadena traducido al francés, español, alemán e italiano junto con el inglés, con aproximadamente 949 ejemplos de capacitación y 50 de validación. El modelo se basa en un lenguaje de razonamiento, es decir, la instrucción basada en el sistema, y debe razonar y responder en ese idioma de destino, por encima de su fuerte dominio del inglés. La evaluación consiste en 50 casos de prueba: 10 problemas matemáticos/lógicos en 5 idiomas (EN/FR/DE/ES/IT)
.
Hay dos métricas que importan:
El lenguaje de razonamiento es correcto: ¿la cadena de pensamiento está en el idioma solicitado?
El lenguaje de respuesta es correcto: ¿la respuesta final está en el idioma solicitado?
Cómo encajan SFT y GRPO
La forma más clara de pensar en las dos técnicas: la SFT enseña un comportamiento que el modelo no tiene. El GRPO optimiza un comportamiento que el modelo ya puede producir a veces. El GRPO toma muestras de un grupo de respuestas por mensaje e impulsa la política hacia las respuestas superiores a la media. Si el comportamiento deseado tiene una probabilidad cero en la distribución base, el GRPO tiene muy poco que reforzar. Esa sola idea explica casi todos los resultados de esta publicación
.
La pila de entrenamiento
Utilizamos Amazon SageMaker HyperPod con la orquestación de Amazon Elastic Kubernetes Service (Amazon EKS). Para las ejecuciones iniciales de SFT y GRPO en GPT-OSS-20B, utilizamos la biblioteca TRL de PyTorch. Para el experimento de control de Qwen, cambiamos a VerL como entrenador, a Ray y KubeRay para la orquestación distribuida y a vLLM para una rápida generación de despliegues. Los puntos de control y los conjuntos de datos se basaban en Amazon FSx for Lustre, y la estructura entre nodos utilizaba Elastic Fabric Adapter (EFA). Todos los ajustes utilizaron la adaptación de rango bajo (LoRa), que es eficiente en cuanto a los parámetros y se adapta bien tanto a SFT como a GRPO
.
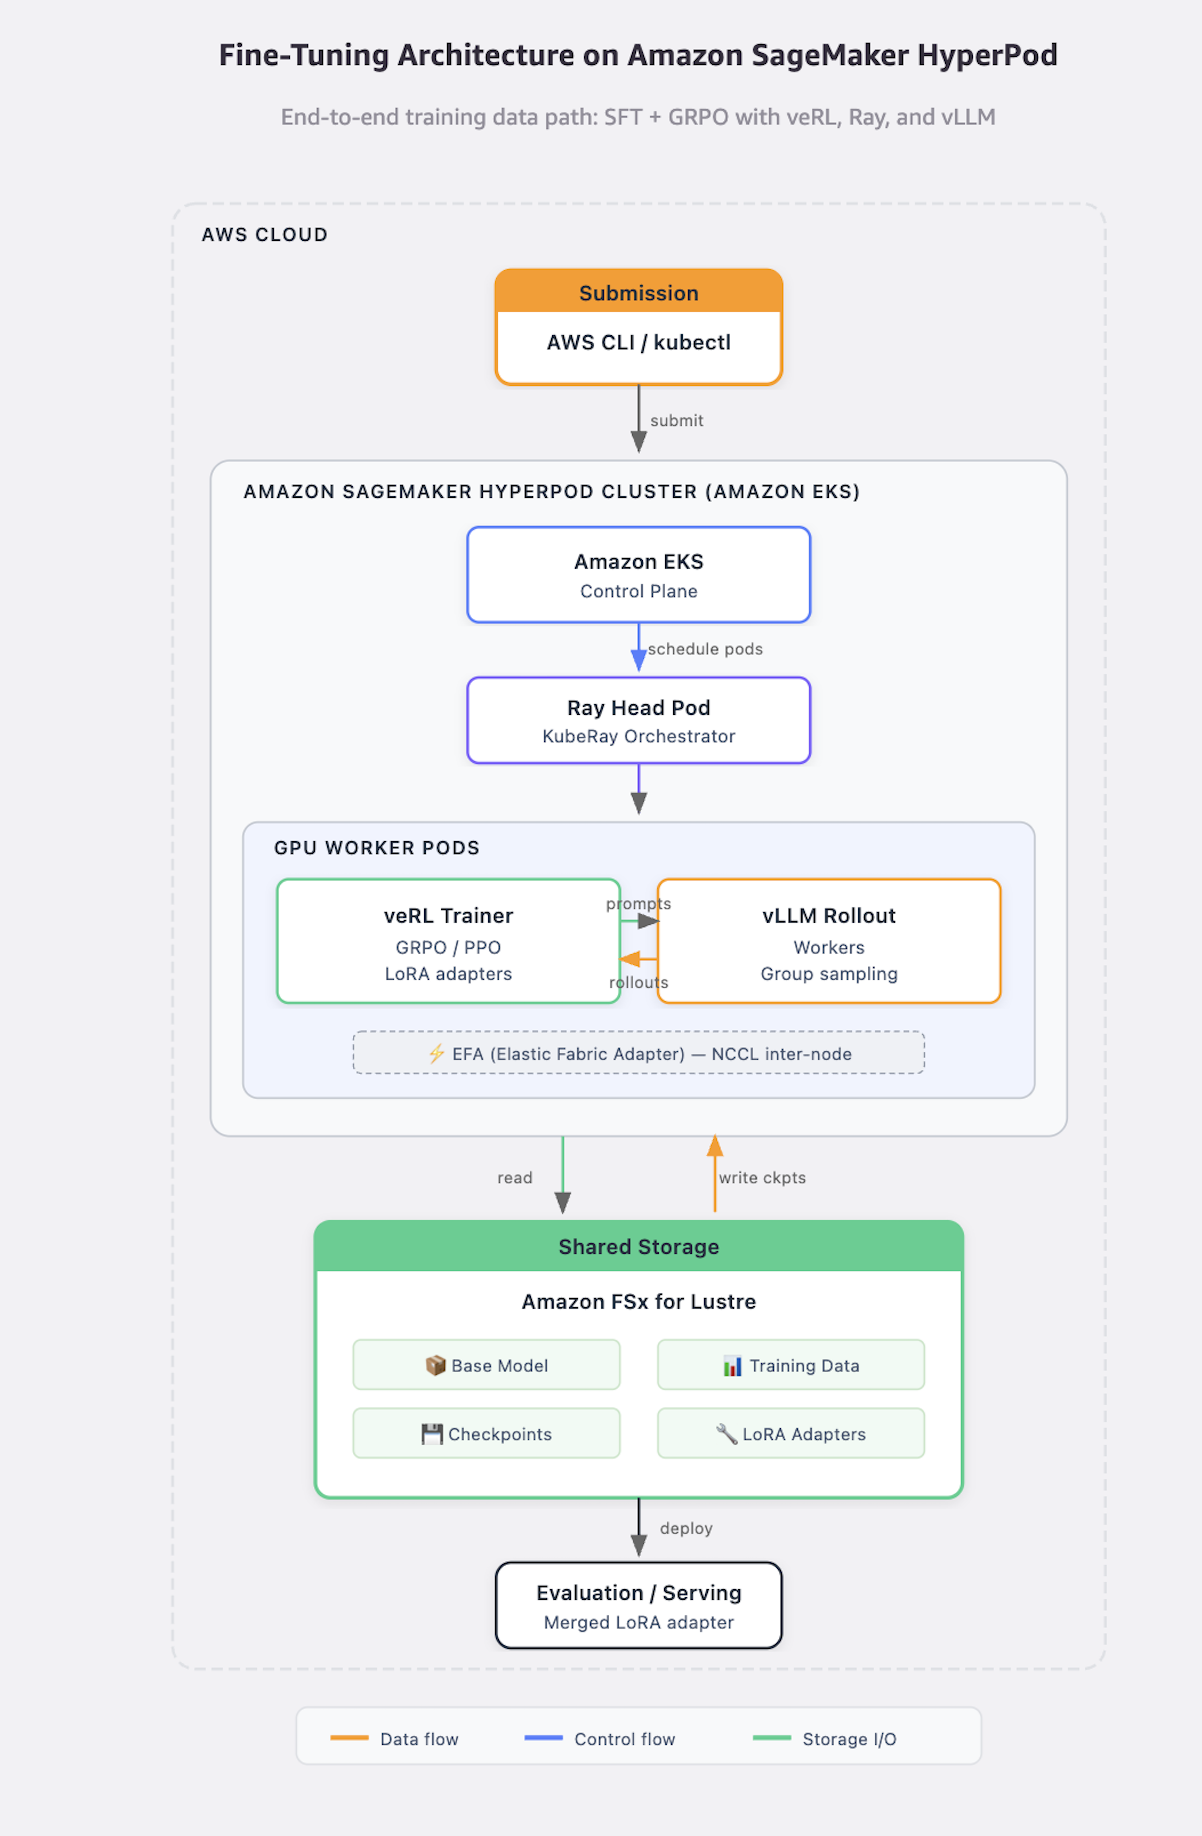
El siguiente diagrama muestra la ruta de los datos de entrenamiento de principio a fin. Un envío del usuario llega al plano de control de Amazon EKS del clúster HyperPod de Amazon SageMaker. Amazon EKS programa un módulo de Ray Head y módulos de trabajo que ejecutan los equipos de entrenamiento de vURL y de implementación de vLLM. Ambos conjuntos de módulos incorporan Amazon FSx for Lustre para el modelo base, los datos de entrenamiento y los puntos de control. Los colectivos entre nodos utilizan EFA. Los despliegues se transmiten desde vLLM al entrenador de VerL, y este último devuelve los puntos de control a Amazon FSx for Lustre
.
Figura 1: Ruta de datos de entrenamiento de extremo a extremo para el ajuste fino de SFT y GRPO en Amazon SageMaker HyperPod con vErL, Ray, KuberRay, vLLM y Amazon FSx for Lustre para experimentos de control de Qwen
A continuación se describe cada salto con más detalle. El remitente inicia la ejecución desde Amazon SageMaker Studio o la interfaz de línea de comandos de AWS (AWS CLI). El plano de control de Amazon EKS de Amazon SageMaker HyperPod coloca los pods en los nodos de la GPU y pone en marcha un Ray Head con módulos de trabajo para los trabajadores de entrenamiento de vURL y de implementación de vLLM. Amazon FSx for Lustre proporciona almacenamiento compartido de alto rendimiento para el modelo base, los datos de entrenamiento y los puntos de control. Cuando finaliza el entrenamiento, el instructor envía el adaptador LoRa a Amazon FSx for Lustre para su posterior
evaluación o distribución.
Prerrequisitos
Para seguir adelante, necesitas:
Un clúster HyperPod de Amazon SageMaker con orquestación de Amazon EKS. El GPT-OSS SFT utilizó 4 × ml.g6 y 12 veces más grande (16 × L40S de 48 GB). El control Qwen utilizaba 2 x G6 de 0,48 x de tamaño (16 x L40S).
Un sistema de archivos Amazon FSx for Lustre montado en el clúster con un PersistentVolumeClaim denominado fsx-claim at /fsx.
Instancias compatibles con EFA y una biblioteca de comunicaciones colectivas (NCCL) de NVIDIA en funcionamiento y una pila aws-ofi-nccl para SFT multinodo.
Un registro de contenedores, como Amazon Elastic Container Registry (Amazon ECR), para almacenar la imagen de formación creada a partir del repositorio de referencia.
Un token de acceso de HuggingFace para openai/gpt-oss-20b y el conjunto de datos HuggingFaceH4/Multilingual-Thinking.
La interfaz de línea de comandos de AWS (CLI de AWS), kubectl, docker y envsubst están disponibles en su estación de trabajo.
clon de git https://github.com/awslabs/awsome-distributed-ai
cd awsome-distributed-ai/3.test_cases/pytorch/trl/gpt-oss-lora-grpo
Copia la plantilla de entorno y, a continuación, edita env_vars para configurar tu registro ECR, el nombre de la imagen, la etiqueta y el token de HuggingFace:
cp env_vars.ejemplo env_vars
fuente env_vars
Crea la imagen de entrenamiento y envíala a tu registro. La imagen incluye PyTorch, TRL, HuggingFace Transformers, PEFT y los scripts de entrenamiento e inferencia
:
artefactos d &. /build_push.sh y cd.
Dirija kubectl a su clúster y aplique el pod del administrador de almacenamiento FSx. El administrador de almacenamiento le proporciona un shell en el sistema de archivos compartido para la conversión en puntos de control
Empezamos midiendo el modelo base, luego configuramos la ejecución del SFT y examinamos los resultados.
La brecha entre el modelo base
El GPT-OSS-20B basado en la evaluación de 50 casos obtuvo un 22 por ciento de aciertos en el lenguaje de razonamiento (11/50).
Por idioma: inglés 100 por ciento, francés 0 por ciento, alemán 10 por ciento, español 0 por ciento, italiano 0 por ciento. El modelo utiliza de forma predeterminada el razonamiento en inglés independientemente de la instrucción
.
Configuración SFT
La configuración SFT utilizó LoRa r=8, α=16, entrenado para dar 1000 pasos en 4 × ml.g6e.12 x large (16 × L40S 48 GB) con datos completamente fragmentados en paralelo (FSDP), precisión bf16 y puntos de control de gradiente.
El trabajo se ejecuta como un HyperpodPyTorchJob elástico administrado por Kueue y lanzado con hyperpodrun.
Cuando termine el entrenamiento, convierta el punto de control del FSDP al formato PEFT (ajuste preciso según los parámetros) que esperan el entrenador de GRPO de TRL y los guiones de inferencia:
Los resultados de SFT y la curva de aprendizaje por etapas
Después de la SFT, el modelo razona en el idioma correcto el 100 por ciento de las veces (50/50) en los cinco idiomas. SFT aprendió esto en
dos etapas:
Alrededor de la etapa 200, el modelo aprendió a razonar en el idioma de destino (la métrica del lenguaje de razonamiento alcanza el 100 por ciento).
Alrededor del paso 1000, el modelo también aprendió a dar la respuesta en el idioma de destino.
Evaluación final de SFT (paso 1000):
Lenguaje de razonamiento correcto: 100 por ciento (50/50).
Lenguaje de respuesta correcto: 62 por ciento (31/50).
Ambos aciertos: 62 por ciento (31/50).
Precisión de respuesta por idioma: FR 60 por ciento, DE 60 por ciento, ES 30 por ciento, IT 60 por ciento, EN 100 por ciento.
Conclusión: el SFT no es opcional en este caso. El modelo base no puede seguir en absoluto la enseñanza del lenguaje del razonamiento, y SFT lleva el lenguaje del razonamiento del 22 por ciento al 100 por ciento. La brecha restante es el lenguaje de las respuestas, con un 62 por ciento. Esa es la parte más difícil, porque la respuesta final es corta y el inglés previo es más fuerte allí
.
Refina el lenguaje de las respuestas con GRPO
El
lenguaje de las respuestas era el objetivo obvio del GRPO. El SFT ya producía un razonamiento correcto el 100 por ciento de las veces, y el modelo a veces producía la respuesta en el idioma correcto, por lo que había una
señal para reforzarlo.
Ejecute GRPO en la parte superior del punto de control de SFT
Ejecutamos GRPO con el GRPOTrainer de TRL, empezando por el puesto de control de SFT. La configuración: cargar el SFT LoRa, ejecutar merge_and_unload y añadir un nuevo LoRa (r=8, α=16, aproximadamente un 0,068 por ciento de parámetros entrenables, 13,6 M de 20 B). En el entrenamiento se utilizaron K = 8 generaciones por mensaje, device_map=auto, una tasa de aprendizaje de 1 a 6 y 10 épocas. La función de recompensa puntuó el lenguaje de respuesta (±5,0), el lenguaje de razonamiento (±1,5) y la brevedad (+0,5 o −1,0), lo que arroja un rango combinado de −7,5 a +7,0
.
Lanza GRPO desde el punto de control SFT convertido:
GRPO escribe los puntos de control en /fsx/checkpoints/grpo-singlenode/. Elija el mejor punto de control para compararlo con la evaluación que no ha realizado (la métrica basada en el lenguaje de respuestas alcanzó su punto máximo al principio de esta ejecución) y conviértala al formato PEFT para fines de inferencia
y evaluación.
Resultado (del punto de control de la SFT):
El lenguaje de razonamiento es correcto: 100 por ciento (mantenido: el GRPO no rompió lo que enseñaba SFT).
Lenguaje de respuesta correcto: del 62 al 70 por ciento (+8 puntos, 35/50).
Ambas aciertan: 70 por ciento.
Respuesta por idioma: FR 70 por ciento, DE 80 por ciento, ES 60 por ciento, IT 40 por ciento, EN 100 por ciento.
El GRPO obtuvo una ganancia real de +8 puntos en la métrica del lenguaje de respuesta, mientras que mantuvo el razonamiento en un 100 por ciento. La ganancia se produjo cuando había margen para ganar. El lenguaje de las respuestas era el comportamiento, a veces correcto, en el que SFT no había convergido del todo, y el GRPO lo reforzó
.
Compare las inferencias de base, SFT y GRPO una al lado de la otra
Para ver la diferencia cualitativa, implemente tres módulos de inferencia que compartan el mismo modelo base pero carguen adaptadores diferentes:
El módulo base razona en inglés a pesar de las instrucciones. El módulo SFT razona en francés, pero a menudo responde en inglés. El módulo GRPO razona y responde en francés. Para reproducir la evaluación completa de 50 casos que generó los números anteriormente, ejecute el manifiesto de evaluación y lea el archivo de resultados desde el administrador de almacenamiento de FSx:
Para comprender de manera más amplia cuándo el GRPO agrega valor, realizamos un experimento controlado en Qwen2.5-7B en dos tareas con diferentes brechas de capacidad.
Pruebe el patrón con un control Qwen2.5-7B
Para probar la tesis de «combinar la técnica con la brecha de capacidad» en un modelo diferente y diferentes tareas, realizamos experimentos controlados con el Qwen2.5-7B-Instruct. La primera tarea es la misma tarea de razonamiento multilingüe (cuando hay margen de maniobra). La segunda tarea es el GSM8K, donde el modelo ya tiene la máxima precisión. Este es un experimento interno y el repositorio público aún no se ha publicado
.
Infraestructura: 2 g6e.48 x large (16 × L40S), EFA 100 Gbps, FSx Lustre, Ray 2.44 + KubeRay 1.4.2, VerL v0.6.1, vLLM 0.8.4.
Brazos: A = base, B = solo SFT, C = SFT+GRPO.
Razonamiento multilingüe (50 casos)
Métrico
Una base
SÉ SUAVE
C SFT+GRUPO
GRUPO Δ
Formato estructurado
0%
92%
98%
+6
Lenguaje de razonamiento
0%
96%
98%
+2
Idioma de respuesta
0%
38%
44%
+6
Ambos correctos
0%
38%
44%
+6
GSM8K, una tarea sin margen
En el GSM8K, el Qwen2.5-7B básico ya obtiene una puntuación del 90,5 por ciento (181/200). El GRPO en el paso 30 también obtiene una puntuación del 90,5 por ciento. Cuando la mayoría de los grupos muestreados son totalmente correctos, la ventaja relativa del grupo se reduce a cero, por lo que no hay ninguna señal de aprendizaje. Esta es la otra mitad de la tesis: el GRPO necesita margen (pass @k >> pass @1) para tener algo que optimizar. Sin margen de maniobra no hay ganancia
.
Mejores prácticas
Comience con SFT. El GRPO no puede enseñar un comportamiento con una probabilidad de base cero. Solo puede reforzar las respuestas que el modelo ya produce a veces. La SFT hizo que el lenguaje de razonamiento pasara del 22 por ciento al 100 por ciento, y cada GRPO que ganó en este trabajo se basó en ese punto
de control de la SFT.
Usa LoRa tanto para SFT como para GRPO. LoRa r=8/α=16 era eficiente en cuanto a parámetros (se podía entrenar un 0,068 por ciento) y, en el control Qwen, se mantuvo numéricamente estable gracias al GRPO (la norma de clasificación es de 0,23, unos 11,7 GB por GPU). Es un valor predeterminado seguro cuando quieres que SFT y GRPO compartan la misma forma de adaptador.
Haga coincidir la técnica con la brecha. Use SFT para detectar el comportamiento faltante. Use GRPO para refinar un comportamiento existente, que a veces es correcto. El límite realista de GRPO en este caso era de +6
a +8 puntos.
Comprueba el margen de recompensa antes de dedicarle horas a la GPU. Si la mayoría de los grupos tienen toda la razón (GSM8K con una base del 90,5 por ciento), la ventaja relativa del grupo se reduce a cero y el GRPO no obtiene ningún gradiente. Verifique que haya margen de maniobra (pase @k >> pase
@1) antes de iniciar una ejecución de GRPO.
Limpiar los recursos
Para evitar cargos continuos, elimine los recursos de la carga de trabajo y, a continuación, la infraestructura subyacente:
Elimine los módulos y trabajos de entrenamiento e inferencia:
kubectl eliminar hyperpodpytorchjob lora-hyperpod-elastic --ignore-not-found
kubectl borra pod grupo-inferencia-base única inferencia-grupo entrenado\
 eval-grpo fsx-storage-manager
--ignore-non-found
Reduzca o elimine el clúster HyperPod de Amazon SageMaker o sus grupos de nodos.
Elimine el sistema de archivos Amazon FSx for Lustre una vez que haya exportado los puntos de control que quiera conservar.
Elimine cualquier depósito u objeto de Amazon Simple Storage Service (Amazon S3) que se utilice para archivar datos de entrenamiento o puntos de control.
Conclusión
Mostramos cómo ajustar el GPT-OSS-20B para el razonamiento multilingüe en Amazon SageMaker HyperPod y cómo decidir entre SFT y GRPO. La SFT hizo la mayor parte del trabajo: el lenguaje de razonamiento pasó del 22 por ciento al 100 por ciento. El GRPO añadió un refinamiento real y modesto a los lugares donde había margen de maniobra (respuesta del 62 al 70 por ciento). Un control paralelo de Qwen2.5-7B confirmó el patrón. El GRPO añadió un 6 por ciento más en el razonamiento multilingüe, aspecto en el que había margen de mejora. No supuso ninguna ventaja respecto al GSM8K, donde el modelo ya tenía una precisión máxima (90,5 por
ciento).
Marco de decisión:
Comportamiento que el modelo no puede realizar en absoluto: utilice SFT.
Comportamiento que tiene a veces, con margen de maniobra: usa SFT y luego GRPO por unos cuantos puntos más.
El modelo ya tiene la máxima precisión o el objetivo tiene una probabilidad base cero: el GRPO no ayudará.
Para probarlo tú mismo, recorre los casos de prueba del repositorio awsome-distributed-ai. Para obtener más información sobre Amazon SageMaker HyperPod, consulte la página de detalles del servicio y la documentación de Amazon SageMaker HyperPod. Para ver un tutorial sobre Ray en Amazon SageMaker HyperPod, consulte la publicación relacionada Cómo ejecutar cursos distribuidos en Amazon SageMaker HyperPod con Ray y Amazon SageMaker Studio. El enlace se añadirá una vez que se publique la entrada. Comparte tus resultados en los comentarios.
Acerca de los autores
GPT-OSS-20B is an open-weight reasoning model that thinks in English. Ask it to reason in French, German, Spanish, or Italian and it acknowledges the instruction, then produces its chain-of-thought in English anyway. On a 50-example multilingual reasoning test, the base model reasoned in the correct target language only 22 percent of the time. That 22 percent was almost entirely the English examples (English 100 percent, French 0 percent, German 10 percent, Spanish 0 percent, Italian 0 percent).
For teams deploying reasoning models for non-English users, that gap matters. A user who asks a question in French expects the model to reason and answer in French, not to switch to English mid-thought. Closing that gap is a fine-tuning problem. It raises a question every team faces once they start customizing open-weight models: supervised fine-tuning (SFT), reinforcement learning with Group Relative Policy Optimization (GRPO), or both?
In this post, we walk through how we fine-tuned GPT-OSS-20B for multilingual reasoning on Amazon SageMaker HyperPod. We show when SFT alone was sufficient and when GRPO added measurable value on top. To understand more broadly when GRPO helps, we also ran a controlled Qwen2.5-7B experiment across two tasks with different capability gaps. The short answer: SFT does most of the work, GRPO refines when there is headroom to refine, and matching the technique to the capability gap is what decides the outcome.
Solution overview
This section covers the multilingual reasoning task and dataset, how SFT and GRPO complement each other, and the training stack we ran on Amazon SageMaker HyperPod.
The task and dataset
The dataset is HuggingFaceH4/Multilingual-Thinking — a chain-of-thought reasoning dataset translated into French, Spanish, German, and Italian alongside English, roughly 949 training and 50 validation examples. The model receives a reasoning language: system-prompt instruction and must both reason and answer in that target language, overriding its strong English prior. The evaluation is 50 test cases: 10 math/logic problems across 5 languages (EN/FR/DE/ES/IT).
Two metrics matter:
Reasoning-language correct – is the chain-of-thought in the requested language?
Answer-language correct – is the final answer in the requested language?
How SFT and GRPO fit together
The clearest way to think about the two techniques: SFT teaches a behavior the model doesn’t have. GRPO optimizes a behavior the model can already sometimes produce. GRPO works by sampling a group of responses per prompt and pushing the policy toward the above-average ones. If the desired behavior has zero probability in the base distribution, there is very little for GRPO to reinforce. That single idea explains almost every result in this post.
The training stack
We ran on Amazon SageMaker HyperPod with Amazon Elastic Kubernetes Service (Amazon EKS) orchestration. For the initial SFT and GRPO runs on GPT-OSS-20B, we used the PyTorch TRL library. For the Qwen control experiment, we switched to veRL as the trainer, with Ray and KubeRay for distributed orchestration and vLLM for fast rollout generation. Checkpoints and datasets lived on Amazon FSx for Lustre, and the inter-node fabric used Elastic Fabric Adapter (EFA). All fine-tuning used Low-Rank Adaptation (LoRA), which is parameter-efficient and well-suited to both SFT and GRPO.
The following diagram shows the training data path end-to-end. A submission from the user lands on the Amazon EKS control plane of the Amazon SageMaker HyperPod cluster. Amazon EKS schedules a Ray head pod plus worker pods that run the veRL trainer and vLLM rollout workers. Both sets of pods mount Amazon FSx for Lustre for the base model, training data, and checkpoints. Inter-node collectives use EFA. Rollouts stream from vLLM back to the veRL trainer, and the trainer writes checkpoints back to Amazon FSx for Lustre.
Figure 1: End-to-end training data path for SFT and GRPO fine-tuning on Amazon SageMaker HyperPod with veRL, Ray, KubeRay, vLLM, and Amazon FSx for Lustre for Qwen control experiments
The following describes each hop in more detail. The submitter starts the run from Amazon SageMaker Studio or the AWS Command Line Interface (AWS CLI). The Amazon EKS control plane on Amazon SageMaker HyperPod places pods on GPU nodes and starts a Ray head with worker pods for the veRL trainer and the vLLM rollout workers. Amazon FSx for Lustre provides shared, high-throughput storage for the base model, the training data, and the checkpoints. When training completes, the trainer writes the LoRA adapter back to Amazon FSx for Lustre for downstream evaluation or serving.
Prerequisites
To follow along, you need:
An Amazon SageMaker HyperPod cluster with Amazon EKS orchestration. GPT-OSS SFT used 4× ml.g6e.12xlarge (16× L40S 48GB). The Qwen control used 2× g6e.48xlarge (16× L40S).
An Amazon FSx for Lustre file system mounted on the cluster with a PersistentVolumeClaim named fsx-claim at /fsx.
EFA-enabled instances and a working NVIDIA Collective Communications Library (NCCL) and aws-ofi-nccl stack for multi-node SFT.
A container registry such as Amazon Elastic Container Registry (Amazon ECR) to hold the training image built from the reference repository.
A HuggingFace access token for openai/gpt-oss-20b and the HuggingFaceH4/Multilingual-Thinking dataset.
The AWS Command Line Interface (AWS CLI), kubectl, docker, and envsubst available on your workstation.
Set up the training environment
All of the commands, manifests, and scripts referenced below live in the awsome-distributed-ai GitHub repository under 3.test_cases/pytorch/trl/gpt-oss-lora-grpo/. Clone the repository and change into the test case directory:
git clone https://github.com/awslabs/awsome-distributed-ai
cd awsome-distributed-ai/3.test_cases/pytorch/trl/gpt-oss-lora-grpo
Copy the environment template, then edit env_vars to set your ECR registry, image name, tag, and HuggingFace token:
cp env_vars.example env_vars
source env_vars
Build the training image and push it to your registry. The image bundles PyTorch, TRL, HuggingFace Transformers, PEFT, and the training and inference scripts:
cd artifacts && ./build_push.sh && cd ..
Point kubectl at your cluster and apply the FSx storage manager pod. The storage manager gives you a shell into the shared file system for checkpoint conversion and eval-log inspection:
We begin by measuring the base model, then configure the SFT run and examine the results.
The base-model gap
Base GPT-OSS-20B on the 50-case eval scored 22 percent reasoning-language correct (11/50). Per-language: English 100 percent, French 0 percent, German 10 percent, Spanish 0 percent, Italian 0 percent. The model defaults to English reasoning regardless of the instruction.
SFT configuration
The SFT setup used LoRA r=8, α=16, trained for 1,000 steps on 4× ml.g6e.12xlarge (16× L40S 48GB) with Fully Sharded Data Parallel (FSDP) full-shard, bf16 precision, and gradient checkpointing. The job runs as an elastic HyperPodPyTorchJob managed by Kueue, launched with hyperpodrun.
When training completes, convert the FSDP checkpoint to the Parameter-Efficient Fine-Tuning (PEFT) format that TRL’s GRPO trainer and the inference scripts expect:
After SFT, the model reasons in the correct language 100 percent of the time (50/50) across all five languages. SFT learned this in two stages:
Around step 200, the model learned to reason in the target language (reasoning-language metric hits 100 percent).
Around step 1000, the model additionally learned to give the answer in the target language.
Final SFT eval (step 1000):
Reasoning-language correct: 100 percent (50/50).
Answer-language correct: 62 percent (31/50).
Both correct: 62 percent (31/50).
Per-language answer accuracy: FR 60 percent, DE 60 percent, ES 30 percent, IT 60 percent, EN 100 percent.
Takeaway: SFT is not optional here. The base model can’t follow the reasoning-language instruction at all, and SFT takes reasoning-language from 22 percent to 100 percent. The remaining gap is answer-language at 62 percent. That’s the harder half, because the final answer is short and the English prior is strongest there.
Refine answer-language with GRPO
Answer-language was the obvious target for GRPO. SFT already produced correct reasoning 100 percent of the time, and the model sometimes produced the answer in the right language, so there was a signal to reinforce.
Run GRPO on top of the SFT checkpoint
We ran GRPO with TRL’s GRPOTrainer, starting from the SFT checkpoint. The setup: load the SFT LoRA, call merge_and_unload, and add a new LoRA (r=8, α=16, about 0.068 percent trainable parameters, 13.6M of 20B). Training used K=8 generations per prompt, device_map=auto, learning rate 1e-6, and 10 epochs. The reward function scored answer-language (±5.0), reasoning-language (±1.5), and brevity (+0.5 or −1.0), for a combined range of −7.5 to +7.0.
GRPO writes checkpoints to /fsx/checkpoints/grpo-singlenode/. Pick the best checkpoint against your held-out eval (the answer-language metric peaked early in this run) and convert it to PEFT format for inference and evaluation.
Answer-language correct: 62 to 70 percent (+8 points, 35/50).
Both correct: 70 percent.
Per-language answer: FR 70 percent, DE 80 percent, ES 60 percent, IT 40 percent, EN 100 percent.
GRPO delivered a real +8 point gain on the answer-language metric while holding reasoning at 100 percent. The gain came where there was headroom to gain. Answer-language was the sometimes-correct behavior that SFT had not fully converged on, and GRPO reinforced it.
Compare base, SFT, and GRPO inference side by side
To see the qualitative difference, deploy three inference pods that share the same base model but load different adapters:
The base pod reasons in English despite the instruction. The SFT pod reasons in French but often answers in English. The GRPO pod reasons and answers in French. To reproduce the full 50-case eval that generated the numbers earlier, run the evaluation manifest and read the result file from the FSx storage manager:
To understand more broadly when GRPO adds value, we ran a controlled experiment on Qwen2.5-7B across two tasks with different capability gaps.
Test the pattern with a Qwen2.5-7B control
To test the “match technique to capability gap” thesis on a different model and different tasks, we ran controlled experiments on Qwen2.5-7B-Instruct. The first task is the same multilingual reasoning task (where headroom exists). The second task is GSM8K, where the model is already at peak accuracy. This is an internal experiment, and the public repo has not yet been released.
On GSM8K, base Qwen2.5-7B already scores 90.5 percent (181/200). GRPO at step 30 also scores 90.5 percent. When most sampled groups are all-correct, the group-relative advantage collapses to zero, so there is no learning signal. This is the other half of the thesis: GRPO needs headroom (pass@k >> pass@1) to have anything to optimize. No headroom means no gain.
Best practices
Start with SFT. GRPO cannot teach a behavior with zero base probability. It can only reinforce responses the model already sometimes produces. SFT took reasoning-language from 22 percent to 100 percent, and every GRPO win in this work was built on that SFT checkpoint.
Use LoRA for both SFT and GRPO. LoRA r=8/α=16 was parameter-efficient (0.068 percent trainable), and on the Qwen control it stayed numerically stable through GRPO (grad norm 0.23, about 11.7 GB per GPU). It’s a strong default when you want SFT and GRPO to share the same adapter shape.
Match the technique to the gap. Use SFT for missing behavior. Use GRPO for refining an existing, sometimes-correct behavior. GRPO’s realistic ceiling here was +6 to +8 points.
Check for reward headroom before spending GPU-hours. If most groups are all-correct (GSM8K 90.5 percent base), the group-relative advantage collapses to zero and GRPO gets no gradient. Verify there is headroom (pass@k >> pass@1) before starting a GRPO run.
Clean up resources
To avoid ongoing charges, delete the workload resources and then the underlying infrastructure:
Scale down or delete the Amazon SageMaker HyperPod cluster or its node groups.
Delete the Amazon FSx for Lustre file system once you have exported any checkpoints you want to keep.
Delete any Amazon Simple Storage Service (Amazon S3) buckets or objects used for training data or checkpoint archives.
Conclusion
We showed how to fine-tune GPT-OSS-20B for multilingual reasoning on Amazon SageMaker HyperPod, and how to decide between SFT and GRPO. SFT did most of the work: reasoning-language went from 22 percent to 100 percent. GRPO added a real, modest refinement on top (answer 62 percent to 70 percent) where headroom existed. A parallel Qwen2.5-7B control confirmed the pattern. GRPO added +6 percent on multilingual reasoning, where there was room to improve. It added no gain on GSM8K, where the model was already at peak accuracy (90.5 percent).
Decision framework:
Behavior the model can’t do at all: use SFT.
Behavior it does sometimes, with headroom: use SFT then GRPO for a few points more.
Model already at peak accuracy, or target has zero base probability: GRPO won’t help.
To try this yourself, walk through the test cases in the awsome-distributed-ai repository. For more on Amazon SageMaker HyperPod, see the service detail page and the Amazon SageMaker HyperPod documentation. For a walkthrough of Ray on Amazon SageMaker HyperPod, see the related post Running distributed training on Amazon SageMaker HyperPod with Ray and Amazon SageMaker Studio. The link will be added after that post is published. Share your results in the comments.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.