Corregir el sesgo de evaluación para desbloquear mejores modelos en Amazon Bedrock
Fix evaluation bias to unlock better models on Amazon Bedrock
Khaled Thabit
Esta publicación fue coautoria con Khaled Thabit, Meriem Boughrara y Mohamed Desouky de Property Finder.
El equipo de ingeniería de Property Finder, una aplicación de bienes raíces digitales, descubrió que el 96,8 por ciento de sus etiquetas de evaluación habían sido heredadas directamente de las predicciones de un solo modelo en lugar de ser verificadas por expertos humanos. Su verdad fundamental estaba sesgada sistemáticamente hacia el modelo vigente, lo que hizo que todas las alternativas parecieran tener un rendimiento inferior. Las etiquetas también tenían errores, pero el sesgo era lo que bloqueaba la comparación objetiva de los modelos. Descubrieron esto al migrar su carga de trabajo de visión de IA a una opción más rentable en Amazon Bedrock.
Property Finder procesa decenas de miles de imágenes de propiedades todos los días en Oriente Medio y África del Norte (MENA). Su sistema evalúa 11 atributos de calidad por imagen. Estos cubren la detección de marcas de agua, la clasificación de habitaciones, el estado de amueblamiento, la calidad de la foto y los indicadores de construcción. Eso es miles de nuevas listas de propiedades con un promedio de 15 imágenes cada una. Todas necesitan una evaluación de calidad antes de estar en vivo.
Property Finder necesitaba una opción más rentable. Pero medido contra esas etiquetas, cualquier alternativa estaba en desventaja.
La parte más difícil no fue encontrar un modelo mejor. Fue descubrir que su propia metodología de evaluación era el obstáculo.
En esta publicación, compartimos cómo Property Finder identificó el sesgo de evaluación, creó una verdad fundamental imparcial y aplicó la optimización evolutiva de instrucciones para seleccionar el modelo correcto en Amazon Bedrock, logrando una mayor precisión a un costo 86 por ciento menor. Pasamos por la metodología y los ejemplos de iteración, con lecciones que puedes aplicar a tus propias cargas de trabajo.
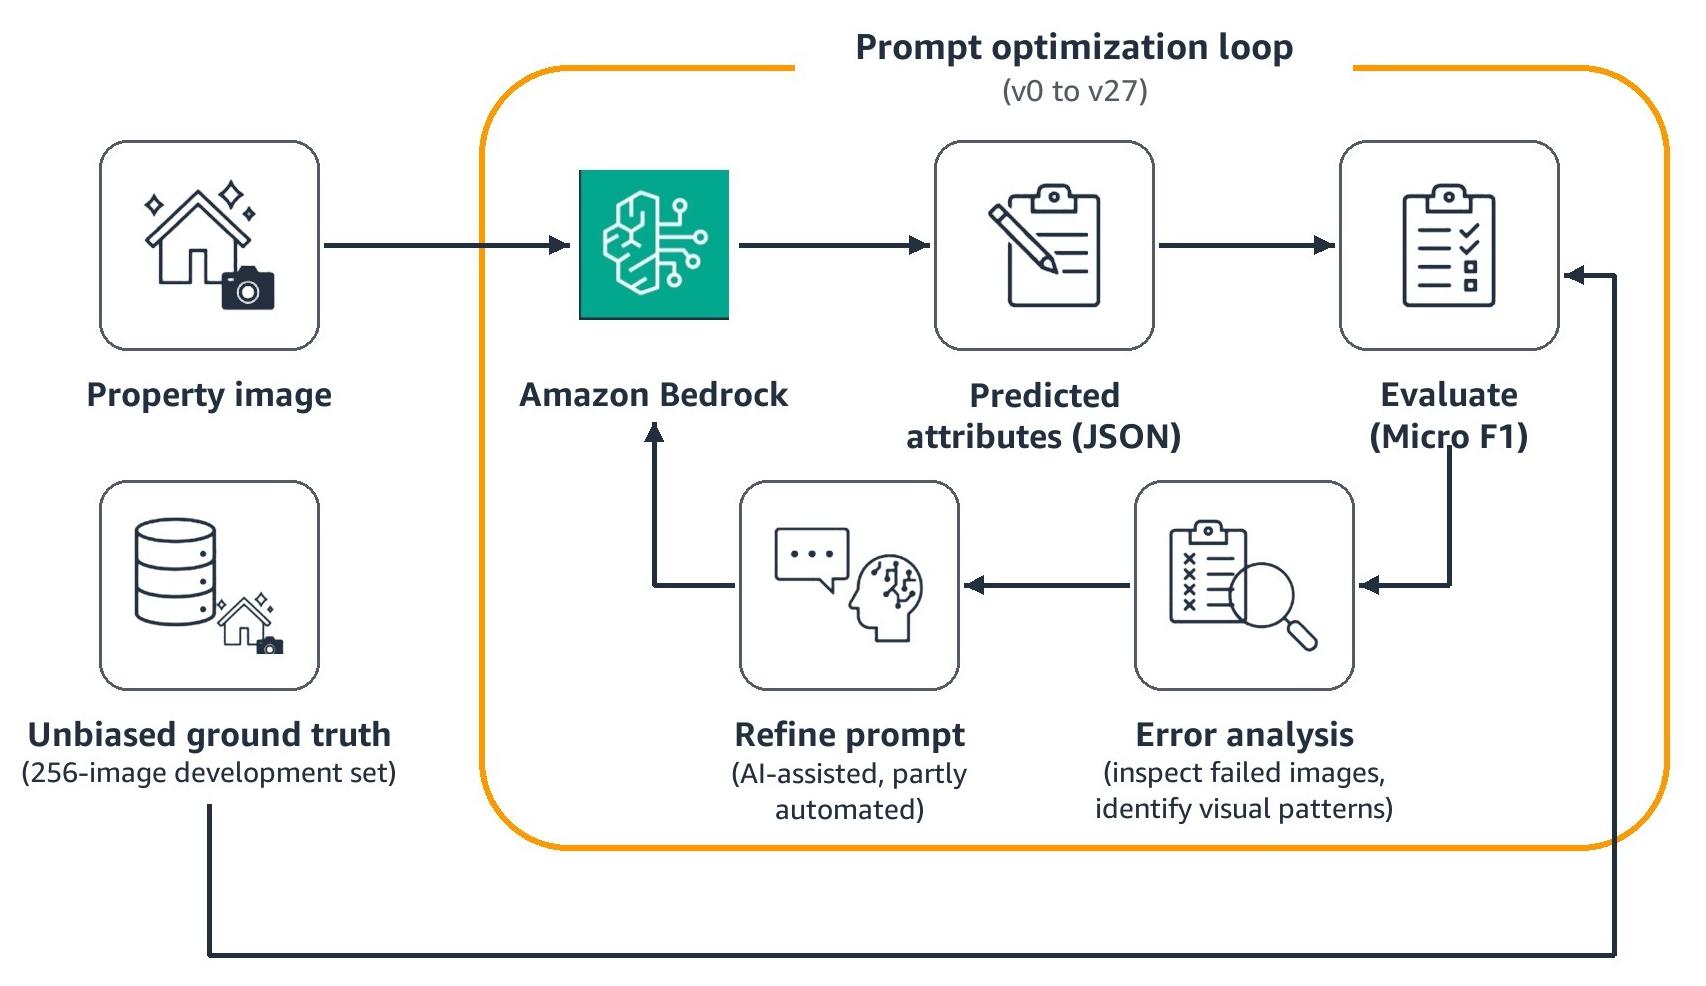
La siguiente figura ilustra el bucle de optimización de instrucciones que Property Finder y el equipo de Innovación de IA Generativa de AWS utilizaron para mejorar iterativamente la precisión de clasificación en Amazon Bedrock.
Figura 1: Arquitectura del bucle de optimización de instrucciones
El diagrama muestra el ciclo de optimización de la solicitud iterativa. Una imagen de propiedad es procesada por Amazon Bedrock, que produce los atributos predichos en formato JSON. Durante la optimización, estas predicciones se califican con Micro F1 contra el conjunto de desarrollo de 256 imágenes anotadas por expertos. El análisis de errores inspecciona entonces las imágenes fallidas e identifica patrones visuales, que informan la próxima versión de la solicitud. El bucle se ejecutó desde la v0 hasta la v27. Los asistentes de IA ayudaron a refinar las solicitudes, y las versiones posteriores utilizaron la optimización automatizada.
Tu evaluación podría estar mintiendo
Muchos equipos se encuentran con este escenario. Quieres comparar modelos de visión, así que creas un conjunto de datos de evaluación. La forma más común de obtener etiquetas es ejecutar tu modelo actual y tratar sus salidas como verdad fundamental. El modelo ha estado ejecutándose en producción y nadie se quejó, así que las etiquetas deben ser lo suficientemente buenas.
Pero esto crea una evaluación circular donde cualquier alternativa se juzga por lo cerca que se ajusta al comportamiento del titular, no por la corrección real.
El conjunto de datos de evaluación de Property Finder tenía exactamente este problema. De sus muestras etiquetadas, el 96,8 por ciento provenía directamente de las predicciones del modelo de lenguaje de visión existente (VLM) en lugar de la verificación humana independiente. Cualquier modelo alternativo estaba estructuralmente desfavorecido antes de que se procesara una sola imagen.
Los errores ocultos confirmaron la gravedad. La extracción de texto de agua tenía errores a nivel de carácter marcados como correctos, incluyendo nombres de marcas alucinados y caracteres faltantes. La clasificación de fotos forzó etiquetas únicas en imágenes que contenían varios tipos de habitaciones.
En el 3,2 por ciento restante de las muestras etiquetadas por humanos, los anotadores habían introducido categorías fuera de la especificación original, como Oficina que aparecía donde no existía tal etiqueta en la solicitud. Una comparación de modelos pierde validez cuando la clave de respuesta fue escrita por el modelo que estás tratando de reemplazar.
Construyendo una verdad fundamental en la que puedes confiar
Para romper el ciclo, necesitas expertos humanos con conocimientos reales del dominio que realicen anotaciones frescas de forma independiente. Sin referencia a las salidas de modelos anteriores. Sin acceso a lo que el titular predijo.
Alcance del conjunto de datos
El equipo de Property Finder anotó manualmente 356 imágenes de los Emiratos Árabes Unidos y un conjunto separado de imágenes de Egipto. El equipo seleccionó estas imágenes de listados de producción no etiquetados en segmentos de la industria representativos. Este artículo informa los resultados sobre las imágenes de los Emiratos Árabes Unidos. Las imágenes de Egipto sirvieron como una verificación transregional de 230 imágenes y no se informan aquí. Las primeras 256 imágenes de los Emiratos Árabes Unidos que se anotaron formaron el conjunto de desarrollo para la afinación. El conjunto de evaluación para la comparación final del modelo utiliza las 356 imágenes, agregando 100 imágenes anotadas después de las corridas de desarrollo. Un conjunto de 356 imágenes es aproximadamente suficiente para detectar diferencias moderadas entre modelos. Las clases raras dentro de los atributos individuales tienen menos ejemplos, por lo que las diferencias más pequeñas en esos atributos pueden no ser detectables.
Anotación de expertos
Un experto en estrategia y análisis anotó todas las imágenes. Trajo conocimientos especializados sobre los estándares de calidad de los listados de bienes raíces. El equipo del AWS Generative AI Innovation Center realizó revisiones de calidad sistemáticas a través de sesiones de aclaración dedicadas. Esas revisiones resolvieron casos ambiguos y mantuvieron la etiquetación coherente en todo el conjunto de datos.
Transición a multi-etiqueta
Las imágenes de bienes raíces frecuentemente muestran varias habitaciones a través de puertas o muestran características de calidad superpuestas. El cambio de clasificación de una sola etiqueta a multi-etiqueta mitigó una gran fuente de ambigüedad artificial.
Una foto de un pasillo que muestra un dormitorio a través de una puerta es genuinamente ambos. Después de permitir varias etiquetas, se mide lo que el modelo acierta en lugar de penalizarlo por predicciones secundarias razonables.
Un enfoque híbrido podría complementar esta metodología: modelos de diferentes familias generan etiquetas candidatas y desacuerdos, y expertos humanos resuelven cada caso, por lo que no se utiliza directamente la salida del modelo como etiqueta. Esto reduciría la carga de anotación para la expansión futura del conjunto de datos.
Selección de métricas
Micro F1 sirvió como la métrica principal porque pondera cada predicción de manera igualitaria, lo que coincide con el objetivo empresarial de corrección general de etiquetas. Macro F1 se informó junto con ella porque Micro F1 está dominada por clases frecuentes y puede ocultar un rendimiento débil en atributos raros. La precisión y el recuerdo por etiqueta ayudaron a identificar modos de fallo específicos. La intersección sobre la unión (IoU) por muestra midió cuán estrechamente las etiquetas predichas de cada imagen se superponían con las etiquetas del experto. Los nueve atributos de una sola etiqueta, como la detección de rotación o de marcas de agua, tienen una respuesta correcta por imagen. El equipo de AWS también los puntuó con precisión de coincidencia exacta, la participación de imágenes donde la respuesta coincide con la etiqueta del experto.
Optimización de la invitación como aprendizaje de refuerzo
Con una evaluación imparcial en su lugar, puede comenzar a mejorar. No puede mejorar lo que no puede medir correctamente.
La optimización sigue un bucle análogo al aprendizaje por refuerzo. Piensa en cada versión de la solicitud como un agente, la puntuación Micro F1 como la señal de recompensa y el análisis de errores como el gradiente para la mejora. La idea se asemeja a GEPA (evolución reflexiva de solicitudes genéticas-pareto), donde mutas componentes de la solicitud, evalúas la idoneidad, seleccionas supervivientes e iteras. En este compromiso, el equipo de AWS refinó la mayoría de las versiones a partir del análisis de errores, con asistentes de IA que revisaban imágenes fallidas y proponían cambios.
MIPROv2, un marco de optimización de solicitudes automatizado de la biblioteca DSPy, complementó este proceso manual para la tarea de clasificación de fotos en v27.
Donde empezó
La primera solicitud (v0) utilizó instrucciones de clasificación genéricas, simplificadas aquí para ilustrar:
“Clasifica esta imagen en una de las siguientes categorías: Sala de estar, Cocina, Dormitorio, Baño…”
El modelo propietario A, la línea de base de producción de Property Finder, obtuvo una puntuación Micro F1 de 0,55 en el conjunto de desarrollo de 256 imágenes. Utilizó v22, una solicitud ajustada para su familia de modelos. Las puntuaciones antes de v21 utilizaron la configuración de etiqueta única anterior y no son directamente comparables.
Iteración por iteración
El equipo de AWS probó versiones tempranas en varios modelos candidatos y agregó formato de salida estructurado y definiciones específicas de atributos.
El arreglo más instructivo provino del análisis de errores a nivel de imagen. En las versiones tempranas de etiqueta única, el modelo clasificó consistentemente las habitaciones visibles a través de puertas como el tipo de habitación secundaria. El equipo de Innovación de IA Generativa de AWS agregó instrucciones explícitas para clasificar según la habitación que ocupa la mayoría del marco. El posterior cambio a salida de etiqueta múltiple mantuvo la habitación principal como etiqueta y permitió habitaciones visibles a través de puertas como etiquetas adicionales.
La personalización regional produjo la siguiente ganancia. En algunas regiones, las fotos de listados llevan sobrepuestas decorativas textos árabes que no son filigranas. Las reglas para ese texto eliminaron toda una categoría de falsos positivos.
La invitación v21 cambió la clasificación de fotos y la categoría de habitaciones a salida de varias etiquetas y se convirtió en la invitación de inicio compartida para cada modelo. Con ella, Llama 4 Maverick 17B Instruct de Meta obtuvo un Micro F1 de 0,75 en el conjunto de desarrollo. A partir de ahí, el equipo de AWS ajustó la invitación de cada modelo por separado. Para este modelo, v24 se centró en la sobreestimación del tamaño de la habitación, el manejo de varias etiquetas y el formato de salida. Luego, v25, una versión optimizada automáticamente, movió las tareas críticas al principio. En v27, MIPROv2 reestructuró la tarea de clasificación de fotos, y el Micro F1 del modelo en esa tarea alcanzó 0,76.
Donde terminó
La invitación final, v27_PF, es v27 más las reglas que Property Finder agregó para renders, imágenes con bordes o marcos y corredores. Al igual que v27, mantiene las reglas de texto en árabe y las instrucciones de formato de salida. Un paso de normalización después de cada llamada al modelo maneja las diferencias de formato restantes.
Con v27_PF, Llama 4 Maverick 17B Instruct obtuvo un Micro F1 de 0,80 en el conjunto de evaluación de 356 imágenes, donde el modelo propietario A obtuvo 0,56 con v22. El conjunto de evaluación incluye las 256 imágenes de desarrollo, y las invitaciones de ambos modelos se ajustaron en esas imágenes. Por lo tanto, estas puntuaciones son optimistas.
El cambio del modelo propietario A a Llama 4 Maverick 17B Instruct, cada uno con su propia invitación ajustada, elevó el Micro F1 de 0,55 a 0,81 en el conjunto de desarrollo. Eso es una ganancia relativa del 47 por ciento. El ajuste de la invitación solo, en Llama 4 Maverick 17B Instruct, lo elevó de 0,75 con la invitación compartida v21 a 0,81 con v27.
Lecciones de enfoques fallidos
No todo funcionó. El enfoque de 2-bucket puso los atributos de marca de agua y los demás atributos en dos llamadas a la API separadas. No trajo ninguna ganancia de precisión significativa. La detección de imágenes enmarcadas también disminuyó bruscamente. Sin los atributos de marca de agua en la misma invitación, los modelos confundieron las superposiciones de marca de agua con bordes de imagen.
Las invitaciones genéricas también fallaron independientemente del modelo que se ejecutara en ellas. La imaginería inmobiliaria tiene demasiada especificidad de dominio para una instrucción de un tamaño que se adapte a todos.
Resultados: Costo, precisión y velocidad
El equipo del Centro de Innovación de Inteligencia Artificial Generativa de AWS evaluó múltiples modelos en Amazon Bedrock con el marco de evaluación imparcial. Todos los modelos comenzaron con la llamada compartida v21 y luego se ajustaron para su familia de modelos en el conjunto de desarrollo. El modelo propietario A obtuvo una ronda de ajuste, v22. Llama 4 Maverick 17B Instruct obtuvo varias, v24 a v27, además de las reglas de casos de borde de Property Finder, por lo que tenía más esfuerzo de ajuste detrás de él. La comparación final con el modelo propietario A utilizó el conjunto de evaluación de 356 imágenes. Property Finder seleccionó Llama 4 Maverick 17B Instruct para su carga de trabajo de producción en función de la precisión en todos los 11 atributos y la eficiencia de costo. Para obtener la disponibilidad de modelos por región, consulte Modelos compatibles por región de AWS en Amazon Bedrock.
La siguiente tabla muestra la precisión de coincidencia exacta que Llama 4 Maverick 17B Instruct (v27_PF) alcanzó en cada atributo de etiqueta única, puntuado en el conjunto de evaluación de 356 imágenes. Obtuvo un 90 por ciento o más en seis de los nueve, y coincidió o superó al modelo propietario A en todos los 11 atributos. En la clasificación de fotos, que puede tener varias etiquetas por imagen, los dos obtuvieron la misma puntuación.
Atributo
Precisión de coincidencia exacta
Detección de rotación
100%
Detección de personas
97%
Detección de imagen encajonada
97%
Detección de filigrana
94%
Detección de renderizado
93%
Estado amueblado
91%
Habitación en construcción
81%
Tamaño de la habitación
65%
Extracción de texto de filigrana
55%
Costo por 1,000 imágenes
Property Finder puntuación de decenas de miles de imágenes al día, por lo que el costo por imagen es importante. Llama 4 Maverick 17B Instruct es un modelo de peso abierto rentable, y el pipeline obtiene todos los atributos para una imagen en una sola llamada.
Resultado
Valor
Costo estimado por 1,000 imágenes
$2.35
Reducción de costo en comparación con la configuración anterior de Property Finder
86%
Estas cifras son estimaciones a partir de diciembre de 2025 en la región US East (Ohio). La figura de Llama 4 Maverick 17B Instruct supone 9,000 tokens de entrada y 200 tokens de salida por imagen, según el análisis de costo original de dos llamadas. Una sola llamada con el prompt de producción lleva alrededor de 7,500–8,000 tokens de entrada, por lo que esta es una estimación superior. El 86 por ciento la compara con la estimación del análisis de costo para la configuración anterior de Property Finder, que utilizó el prompt v21. La comparación de precisión utilizó v22, que se ajustó desde v21, por lo que su costo puede ser diferente. Para obtener los precios actuales, consulte los precios de Amazon Bedrock.
Velocidad de inferencia
Property Finder ejecuta esta pipeline optimizada en producción, procesando decenas de miles de imágenes diarias con Llama 4 Maverick 17B Instruct en Amazon Bedrock. En su propia supervisión, Property Finder observó una reducción del 40–60 por ciento en la latencia de inferencia en comparación con su configuración anterior.
Aplicar esto a sus cargas de trabajo
Comience auditando sus etiquetas de evaluación. Si provienen de predicciones de modelos en lugar de expertos humanos, tiene el mismo problema de sesgo que encontró Property Finder.
Construya una verdad fundamental de expertos en el dominio para unos pocos cientos de muestras representativas y mantenga una división de prueba separada que nunca utilice para ajuste. Adopte métricas de multi-etiqueta donde su tarea de clasificación involucra atributos superpuestos. Luego, itere sobre los prompts utilizando el análisis de errores de imagen, tratando cada iteración como una generación en un bucle de optimización evolutiva.
Cuando despliegue una pipeline como esta, agregue controles de AI responsables. Por ejemplo, puede utilizar Amazon Bedrock Guardrails para hacer cumplir las políticas de contenido y filtrar salidas de modelo inapropiadas. Las predicciones de atributos en esta pipeline no vienen con una puntuación de confianza calibrada, por lo que utilice una señal de alerta práctica para elegir imágenes para revisión humana. La discrepancia del modelo es una señal de alerta de este tipo. Cuando dos modelos dan respuestas diferentes para un atributo, la imagen es a menudo ambigua. Un segundo modelo en cada imagen agrega costo, por lo que puede comenzar con una muestra. Verifique con qué frecuencia la señal de alerta detecta errores reales en su conjunto de desarrollo antes de confiar en ella.
Conclusión
En esta publicación, pasamos por cómo Property Finder identificó el sesgo de evaluación, construyó una verdad fundamental sin sesgo y aplicó la optimización evolutiva de prompts para lograr una mejor precisión a un costo más bajo a través de la selección de modelo en Amazon Bedrock.
Tres elementos necesitaban unirse para lograr este resultado: una evaluación imparcial para medir honestamente, la flexibilidad para evaluar y cambiar entre familias de modelos sin volver a plataforma, y instrucciones cuidadosamente evolucionadas adaptadas al dominio. Amazon Bedrock proporcionó la base. Proporcionó a Property Finder acceso a varias familias de modelos a través de una sola API, heredó los controles de gobernanza y seguridad de AWS y la capacidad de adoptar nuevos modelos a medida que estén disponibles sin cambiar su infraestructura.
Comparta sus experiencias con la evaluación de modelos y la optimización de instrucciones en los comentarios.
Reconocimientos
Contribuyentes adicionales de AWS incluyen a Yousuf Albannai, Amine Sehili, Thomas Ounnas, Aris Tsakpinis, Rafik Soliman, Nikhil Ulhas Pandit y Sneh Sharma.
Acerca de los autores
This post was co-authored with Khaled Thabit, Meriem Boughrara, and Mohamed Desouky from Property Finder.
The engineering team at Property Finder, a digital real estate application, discovered that 96.8 percent of their evaluation labels had been inherited directly from a single model’s predictions rather than verified by human experts. Their ground truth was systematically skewed toward the incumbent model, making every alternative appear to underperform. The labels also had errors, but the bias was what blocked objective model comparison. They uncovered this when migrating their vision AI workload to a more cost-effective option on Amazon Bedrock.
Property Finder processes tens of thousands of property images every day across the Middle East and North Africa (MENA). Their system evaluates 11 quality attributes per image. These cover watermark detection, room classification, furnishing status, photo quality, and construction indicators. That’s thousands of new property listings with an average of 15 images each. All need quality assessment before going live.
Property Finder needed a more cost-effective option. But measured against those labels, any alternative was at a disadvantage.
The hardest part was not finding a better model. It was discovering that their evaluation methodology itself was the blocker.
In this post, we share how Property Finder identified evaluation bias, built unbiased ground truth, and applied evolutionary prompt optimization to select the right model on Amazon Bedrock, achieving higher accuracy at 86 percent lower cost. We walk through the methodology and iteration examples, with lessons you can apply to your own workloads.
The following figure illustrates the prompt optimization loop that Property Finder and the AWS Generative AI Innovation Center team used to iteratively improve classification accuracy on Amazon Bedrock.
Figure 1: Prompt optimization loop architecture
The diagram shows the iterative prompt optimization cycle. A property image is processed by Amazon Bedrock, which outputs the predicted attributes in JSON format. During optimization, these predictions are scored with Micro F1 against the 256-image expert-annotated development set. Error analysis then inspects failed images and identifies visual patterns, which inform the next prompt version. The loop ran from v0 to v27. AI assistants helped refine the prompts, and later versions used automated optimization.
Your evaluation might be lying
Many teams encounter this scenario. You want to compare vision models, so you build an evaluation dataset. The most common way to get labels is to run your current model and treat its outputs as ground truth. The model has been running in production and nobody complained, so the labels must be good enough.
But this creates a circular evaluation where any alternative gets judged by how closely it matches the incumbent’s behavior, not by actual correctness.
Property Finder’s evaluation dataset had exactly this problem. Of their labeled samples, 96.8 percent came directly from the predictions of the existing vision language model (VLM) rather than independent human verification. Any alternative model was structurally disadvantaged before a single image was even processed.
Hidden errors confirmed the severity. Watermark text extraction had character-level mistakes marked as correct, including hallucinated brand names and missing characters. Photo classification forced single labels onto images containing multiple room types.
In the remaining 3.2 percent of human-labeled samples, annotators had introduced categories outside the original specification, like Office appearing where no such label existed in the prompt. A model comparison loses validity when the answer key was written by the model you are trying to replace.
Building ground truth you can trust
To break the cycle, you need human experts with real domain knowledge doing fresh annotations independently. No reference to previous model outputs. No access to what the incumbent predicted.
Dataset scope
Property Finder’s team hand-annotated 356 UAE images and a separate set of Egypt images. The team selected these from unlabeled production listings across representative industry segments. This post reports results on the UAE images. The Egypt images served as a cross-regional check on 230 images and are not reported here. The first 256 UAE images to be annotated formed the development set for tuning. The evaluation set for the final model comparison uses all 356, adding 100 images annotated after the development runs. A set of 356 images is roughly sufficient to detect moderate differences between models. Rare classes within individual attributes have fewer examples, so smaller differences on those attributes might not be detectable.
Expert annotation
A strategy and analytics expert annotated all images. They brought specialized knowledge of real estate listing quality standards. The AWS Generative AI Innovation Center team conducted systematic quality reviews through dedicated clarification sessions. Those reviews settled ambiguous cases and kept the labeling consistent across the dataset.
Multi-label transition
Real estate images frequently show multiple rooms through doorways or display overlapping quality characteristics. The switch from single-label to multi-label classification alleviated a major source of artificial ambiguity.
A hallway photo showing a bedroom through a doorway is genuinely both. After you allow multiple labels, you measure what the model gets right rather than penalizing it for reasonable secondary predictions.
A hybrid approach could complement this methodology: models from different families surface candidate labels and disagreements, and human experts adjudicate every case, so no model output is used directly as a label. This would reduce the annotation burden for future dataset expansion.
Metrics selection
Micro F1 served as the primary metric because it weights each prediction equally, which matches the business goal of overall label correctness. Macro F1 was reported alongside it because Micro F1 is dominated by frequent classes and can hide weak performance on rare attributes. Per-label precision and recall helped identify specific failure modes. Per-sample intersection over union (IoU) measured how closely each image’s predicted labels overlapped the expert’s labels. The nine single-label attributes, such as rotation or watermark detection, have one right answer per image. The AWS team also scored them with exact-match accuracy, the share of images where the answer matches the expert label.
Prompt optimization as reinforcement learning
With unbiased evaluation in place, you can start improving. You cannot improve what you cannot measure correctly.
The optimization follows a loop analogous to reinforcement learning. Think of each prompt version as an agent, the Micro F1 score as the reward signal, and error analysis as the gradient for improvement. The idea resembles GEPA (Genetic-Pareto reflective prompt evolution), where you mutate prompt components, evaluate fitness, select survivors, and iterate. In this engagement, the AWS team refined most versions from error analysis, with AI assistants reviewing failed images and proposing changes.
MIPROv2, an automated prompt optimization framework from the DSPy library, complemented this manual process for the photo classification task in v27.
Where it started
The first prompt (v0) used generic classification instructions, simplified here for illustration:
“Classify this image into one of the following categories: Living Room, Kitchen, Bedroom, Bathroom…”
Proprietary model A, Property Finder’s production baseline, scored a Micro F1 of 0.55 on the 256-image development set. It used v22, a prompt tuned for its model family. Scores before v21 used the earlier single-label setup and aren’t directly comparable.
Iteration by iteration
The AWS team tested early versions on several candidate models and added structured output formatting and attribute-specific definitions.
The most instructive fix came from image-level error analysis. In the early single-label versions, the model consistently classified rooms visible through doorways as the secondary room type. The AWS Generative AI Innovation Center team added explicit instructions to classify based on the room occupying the majority of the frame. The later switch to multi-label output kept the main room as a label and allowed rooms visible through doorways as additional labels.
Regional customization produced the next gain. In some regions, listing photos carry decorative Arabic text overlays that are not watermarks. Rules for that text removed a whole category of false positives.
The v21 prompt switched photo classification and room category to multi-label output and became the shared starting prompt for every model. With it, Llama 4 Maverick 17B Instruct from Meta scored a Micro F1 of 0.75 on the development set. From there, the AWS team tuned each model’s prompt separately. For this model, v24 targeted room size overestimation, multi-label handling, and output format. Then v25, an automatically optimized version, moved the critical tasks first. In v27, MIPROv2 restructured the photo classification task, and the model’s Micro F1 on that task reached 0.76.
Where it ended
The final prompt, v27_PF, is v27 plus rules that Property Finder added for renders, images with borders or frames, and corridors. Like v27, it keeps the Arabic text rules and output format instructions. A normalization step after each model call handles remaining format differences.
With v27_PF, Llama 4 Maverick 17B Instruct scored a Micro F1 of 0.80 on the 356-image evaluation set, where proprietary model A scored 0.56 with v22. The evaluation set includes the 256 development images, and both models’ prompts were tuned on those images. These scores are therefore optimistic.
The switch from proprietary model A to Llama 4 Maverick 17B Instruct, each on its own tuned prompt, lifted Micro F1 from 0.55 to 0.81 on the development set. That is a 47 percent relative gain. Prompt tuning alone, on Llama 4 Maverick 17B Instruct, raised it from 0.75 with the shared v21 prompt to 0.81 with v27.
Lessons from failed approaches
Not everything succeeded. The 2-bucket approach put the watermark attributes and the other attributes in two separate API calls. It brought no meaningful accuracy gain. Boxed-image detection also dropped sharply. Without the watermark attributes in the same prompt, the models mistook watermark overlays for image borders.
Generic prompts also failed regardless of which model you ran them on. Real estate imagery has too much domain specificity for a one-size-fits-all instruction.
Results: Cost, accuracy, and speed
The AWS Generative AI Innovation Center team evaluated multiple models on Amazon Bedrock with the unbiased evaluation framework. All models started from the shared v21 prompt and were then tuned for their model family on the development set. Proprietary model A got one tuning round, v22. Llama 4 Maverick 17B Instruct got several, v24 to v27, plus Property Finder’s edge-case rules, so it had more tuning effort behind it. The final comparison against proprietary model A used the 356-image evaluation set. Property Finder selected Llama 4 Maverick 17B Instruct for their production workload based on accuracy across all 11 attributes and cost efficiency. For model availability by Region, refer to Supported models by AWS Region in Amazon Bedrock.
The following table shows the exact-match accuracy that Llama 4 Maverick 17B Instruct (v27_PF) reached on each single-label attribute, scored on the 356-image evaluation set. It scored 90 percent or higher on six of the nine, and matched or exceeded proprietary model A on all 11 attributes. On photo classification, which can have several labels per image, the two scored the same.
Attribute
Exact-match accuracy
Rotation detection
100%
People detection
97%
Boxed-image detection
97%
Watermark detection
94%
Render detection
93%
Furnished status
91%
Room under construction
81%
Room size
65%
Watermark text extraction
55%
Cost per 1,000 images
Property Finder scores tens of thousands of images a day, so per-image cost matters. Llama 4 Maverick 17B Instruct is a cost-effective open-weight model, and the pipeline gets all attributes for an image in a single call.
Result
Value
Estimated cost per 1,000 images
$2.35
Cost reduction compared with Property Finder’s previous setup
86%
These figures are estimates as of December 2025 in the US East (Ohio) Region. The Llama 4 Maverick 17B Instruct figure assumes 9,000 input tokens and 200 output tokens per image, from the original two-call cost analysis. A single call with the production prompt carries about 7,500–8,000 input tokens, so this is an upper estimate. The 86 percent compares it with the cost analysis estimate for Property Finder’s previous setup, which used the v21 prompt. The accuracy comparison used v22, which was tuned from v21, so its cost might differ. For current pricing, refer to Amazon Bedrock pricing.
Inference speed
Property Finder runs this optimized pipeline in production, processing tens of thousands of images daily with Llama 4 Maverick 17B Instruct on Amazon Bedrock. In their own monitoring, Property Finder observed a 40–60 percent reduction in inference latency compared with their previous setup.
Apply this to your workloads
Start by auditing your evaluation labels. If they came from model predictions rather than human experts, you have the same bias problem Property Finder found.
Build domain-expert ground truth for a few hundred representative samples, and keep a separate test split that you never use for tuning. Adopt multi-label metrics where your classification task involves overlapping attributes. Then iterate on prompts using image error analysis, treating each iteration as a generation in an evolutionary optimization loop.
When you deploy a pipeline like this, add responsible AI controls. For example, you can use Amazon Bedrock Guardrails to enforce content policies and filter inappropriate model outputs. The attribute predictions in this pipeline don’t come with a calibrated confidence score, so use a practical signal to choose images for human review. Model disagreement is one such signal. When two models give different answers for an attribute, the image is often ambiguous. A second model on every image adds cost, so you can start with a sample. Check how often the signal catches real errors on your development set before you rely on it.
Conclusion
In this post, we walked through how Property Finder identified evaluation bias, built unbiased ground truth, and applied evolutionary prompt optimization to achieve better accuracy at lower cost through model selection on Amazon Bedrock.
Three elements needed to come together for this result: unbiased evaluation to measure honestly, the flexibility to evaluate and switch between model families without re-platforming, and carefully evolved prompts tailored to the domain. Amazon Bedrock provided the foundation. It gave Property Finder access to multiple model families through a single API, inherited AWS governance and security controls, and the ability to adopt new models as they become available without changing their infrastructure.
To get started with model evaluation and selection on Amazon Bedrock, visit the Amazon Bedrock documentation. If you process vision workloads at scale and want help building an unbiased evaluation framework, reach out to the AWS Generative AI Innovation Center.
Share your experiences with model evaluation and prompt optimization in the comments.
Acknowledgments
Additional contributors from AWS include Yousuf Albannai, Amine Sehili, Thomas Ounnas, Aris Tsakpinis, Rafik Soliman, Nikhil Ulhas Pandit, and Sneh Sharma.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.