La administración del ciclo de vida de modelos de visión por computadora a nivel de flota es un problema que surge en el momento en que una prueba de concepto de inspección de calidad tiene éxito. Una cámara y un modelo funcionan bien. Luego, la planta solicita el mismo resultado en 40 líneas, cada una con varias cámaras, y cada cámara ve el mundo de manera diferente. Cada una tiene un ángulo diferente, un deslumbramiento diferente en la misma superficie de acero inoxidable y una luz ambiental diferente dependiendo de qué puerta de bahía esté abierta. En los despliegues de producción en los que hemos trabajado, un solo modelo entrenado con footage combinado tiene un rendimiento inferior al de cámaras individuales, por lo que cada cámara termina con su propio modelo ajustado. Ahora, el problema real ya no es entrenar un modelo bien, sino entrenar, evaluar, versionar y enviar miles de ellos sin un humano en el bucle para cada uno.
Esta publicación actualiza el patrón introducido en la serie de 2023 Build an end-to-end MLOps pipeline for visual quality inspection at the edge para el SDK de Python de Amazon SageMaker v3 actual. Reemplaza el Amazon SageMaker Edge Manager obsoleto con Amazon SageMaker Neo para la optimización de borde. Paso a paso, explico una tubería de Amazon SageMaker de doble rama que entrena un detector de anomalías y un clasificador de defectos por cámara, con puertas de calidad que bloquean los modelos que no funcionan bien. Un paso de compilación de SageMaker Neo dentro de la tubería garantiza que cada modelo registrado se envíe con un artifact optimizado para dispositivo, y una capa de orquestación de AWS Step Functions controla el entrenamiento de la flota. Despliegas todo con el Kit de Desarrollo de AWS (AWS CDK), y una ejecución completa de la tubería con datos sintéticos cuesta alrededor de $0.07 en cómputo.
La muestra completa está disponible en el repositorio de GitHub de aws-samples.
Visión general de la solución
El siguiente diagrama muestra el ciclo de vida de modelo de la muestra a nivel de flota. Una capa de orquestación cola solicitudes de re-entrenamiento y limita el trabajo concurrente. Una tubería de entrenamiento por cámara prepara los datos, entrena y evalúa un detector de anomalías y un clasificador, y produce artifactos de modelo versionados para dispositivos de borde.
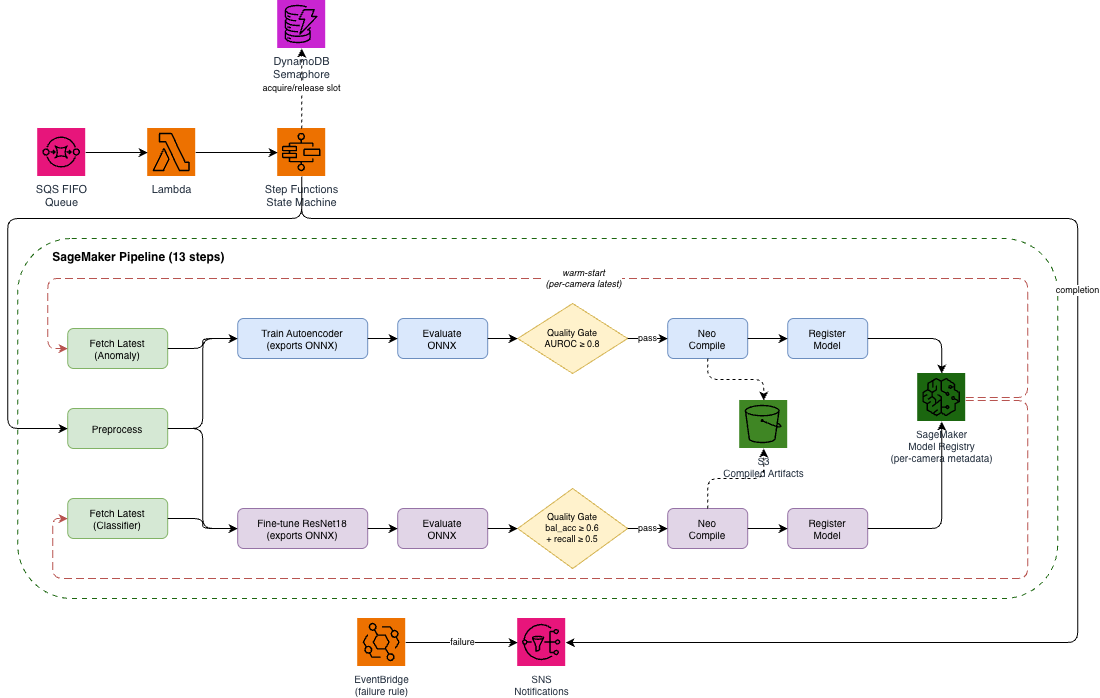
Figura 1: Arquitectura de la solución
La mitad de entrenamiento es una sola tubería de SageMaker, parametrizada por cámara, que ejecuta 13 pasos por ejecución. Tres pasos de entrada se ejecutan en paralelo: Preprocesamiento, Recuperación de la última anomalía y Recuperación de la última clasificadora. La tubería preprocesa las imágenes de esa cámara y recupera el modelo aprobado más reciente de la cámara para cada rama, luego entrena dos modelos. El primero es un autoencoder convolucional pequeño que aprende a qué se parece un producto normal y marca anomalías por error de reconstrucción. El segundo es un clasificador ResNet18 afinado para confirmar el defecto. Cada rama exporta su modelo a ONNX, evalúa el artefacto exportado contra datos retenidos y pasa por una puerta de calidad. Pasada la puerta, el modelo se compila con SageMaker Neo para el objetivo de borde configurado, y solo entonces se registra en el Registro de modelos de SageMaker. Como resultado, cada paquete aprobado tiene un artefacto compilado listo para el dispositivo. Los paquetes llevan la ID de la cámara como metadatos, y el filtro de inicio cálido de cada rama se filtra en ella, por lo que la re-entrenamiento siempre se reanuda desde la historia de esa cámara.
La mitad de orquestación controla el ritmo de la flota. Las solicitudes de re-entrenamiento aterrizan en una cola FIFO de Amazon Simple Queue Service (Amazon SQS) y una función de AWS Lambda inicia una ejecución de Step Functions por solicitud. Cada ejecución adquiere un slot a través de un semáforo de DynamoDB antes de iniciar su tubería, por lo que una ráfaga de solicitudes se drena a un ritmo constante en lugar de lanzarse todas al mismo tiempo. Las finalizaciones se publican en Amazon Simple Notification Service (Amazon SNS), y las fallas operativas alcanzan el mismo tema a través de una regla de Amazon EventBridge con el error original preservado.
La salida del sistema es artefactos de modelo por cámara, versionados y con puerta de calidad. El Registro de modelos mantiene el ONNX portátil, y S3 mantiene la compilación de Neo del modelo, que es una biblioteca compartida optimizada para el dispositivo cargada por el tiempo de ejecución de DLR en lugar de ONNX. Ambos están listos para cualquier mecanismo de entrega que utilice su planta.
Requisitos previos
Para implementar la muestra, necesita lo siguiente:
- Una cuenta de AWS con permisos para crear roles de AWS Identity and Access Management (IAM).
- Un bucket de Amazon Simple Storage Service (Amazon S3).
- Un repositorio de Amazon Elastic Container Registry (Amazon ECR).
- Los recursos de SageMaker AI, AWS Step Functions, AWS Lambda, Amazon Simple Queue Service (Amazon SQS), Amazon Simple Notification Service (Amazon SNS), Amazon EventBridge y Amazon DynamoDB en los stacks.
- Python 3.10, 3.11 o 3.12, Docker.
- La versión 2.1131.0 o posterior de la CLI de AWS CDK.
Las versiones anteriores de la CLI fallan con una incompatibilidad de esquema de ensamblado de cloud contra versiones recientes de aws-cdk-lib. No se necesita un aumento de cuota de servicio. La capa de orquestación admite como máximo cinco ejecuciones de pipeline al mismo tiempo de forma predeterminada, lo que mantiene los trabajos de entrenamiento de SageMaker concurrentes dentro de la cuota de cuenta estándar.
Si se implementa en una región de AWS diferente a la predeterminada de la CLI, establezca los tres AWS_REGION, AWS_DEFAULT_REGION y CDK_DEFAULT_REGION en el comando de implementación en sí, en lugar de en el perfil de shell, por ejemplo, AWS_REGION=us-east-2 AWS_DEFAULT_REGION=us-east-2 CDK_DEFAULT_REGION=us-east-2 cdk deploy --all. La CLI de CDK, Boto3 y la CLI de AWS resuelven la región desde conjuntos de variables superpuestos pero no idénticos, y una incompatibilidad produce implementaciones parciales confusas. Prefijar el comando establece los tres solo para esa invocación, por lo que la región predeterminada se mantiene sin cambios.
Definir el pipeline de entrenamiento con SDK v3
El código de esta sección se extrae de la aplicación de CDK en el repositorio en lugar de un script independiente, y se ejecuta durante cdk deploy, cuando el stack sintetiza la definición del pipeline. La configuración del entorno y los comandos de implementación vienen más adelante, en Implementar y ejecutar la muestra. El SDK v3 reorganizó el SDK de Python de SageMaker en paquetes modulares, y las importaciones muestran la nueva forma de la biblioteca:
from sagemaker.train import ModelTrainer
from sagemaker.train.configs import InputData, Compute, OutputDataConfig
from sagemaker.core.training.configs import MetricDefinition
from sagemaker.serve.model_builder import ModelBuilder
from sagemaker.mlops.workflow.pipeline import Pipeline
from sagemaker.mlops.workflow.steps import ProcessingStep, TrainingStep
from sagemaker.mlops.workflow.model_step import ModelStep
from sagemaker.mlops.workflow.condition_step import ConditionStep
from sagemaker.core.workflow.conditions import ConditionGreaterThanOrEqualTo
from sagemaker.core.workflow.functions import JsonGet
Instalar sagemaker>=3.0.0,<4 extrae sagemaker-core, sagemaker-train, sagemaker-serve y sagemaker-mlops como paquetes separados. La configuración de entrenamiento que v2 distribuyó en los argumentos del constructor Estimator ahora vive en objetos de configuración tipados que se pasan a ModelTrainer. Este es el entrenador de la rama de anomalías, tal como está en la muestra:
anomalib_trainer = ModelTrainer(
    training_image=custom_training_image_uri,
    compute=Compute(
        instance_type=training_instance_type.to_string(),
        instance_count=1,
    ),
    base_job_name="cv-pipeline-anomalib-train",
    sagemaker_session=pipeline_session,
    role=role_arn,
    hyperparameters={
        "program": "train_anomalib.py",
        "model_name": "autoencoder",
        "image_size": "256",
        "num_epochs": "3",
        "batch_size": "16",
        "learning_rate": "0.001",
    },
    input_data_config=anomalib_input_data,
    output_data_config=OutputDataConfig(
        s3_output_path=run_prefix("anomalib-training")
    ),
).with_metric_definitions(
    [
        MetricDefinition(
            name="image_auroc",
            regex=r"validation:image_auroc=([0-9]*\.?[0-9]+)",
        ),
    ]
)
anomalib_input_data conecta cuatro canales (train, validation, test, pretrained_model) desde las propiedades de los pasos upstream, y run_prefix limita todos los caminos de S3 al ID de ejecución del pipeline para que las ejecuciones de flota concurrentes nunca colisionen. Ambos están en el repositorio.
Dos comportamientos de v3 son importantes cuando la pipeline vive dentro de una aplicación CDK, y ninguno de ellos aparece en el registro de cambios como un cambio que rompe la compatibilidad. Primero, el SDK v3 valida el rol de ejecución de la pipeline contra IAM en vivo mientras se construye la definición de la pipeline. Esta validación ocurre en el momento de síntesis en lugar de en el momento de ejecución. Una aplicación CDK no puede crear el rol y la pipeline en una sola implementación, porque el rol no existe aún cuando el SDK lo valida. Esto es separado de cdk bootstrap, que provisiona los recursos de la herramienta CDK una vez por cuenta y región, y que puede haberse realizado ya en su cuenta. El propio despliegue de dos fases de la muestra está impulsado por una bandera de contexto que resulta compartir ese nombre. Un paso inicial con -c bootstrap=true crea el rol, el bucket y el repositorio ECR, y el segundo paso sintetiza la pipeline contra el rol que ahora existe. El nombre de recurso de Amazon (ARN) del rol incrustado en la definición de la pipeline también debe ser una cadena concreta, no un token CDK no resuelto.
En segundo lugar, el validador de roles v3 simula permisos de extracción de ECR sin un ARN de recurso, por lo que un rol de ejecución limitado a un solo repositorio ECR falla la validación, aunque funcionaría en tiempo de ejecución. El rol de la muestra lleva una concesión de ECR más amplia por esta razón.
Por último, un hábito v3 que utiliza la muestra: construir la pipeline con PipelineSession(default_bucket=your_bucket) enruta las cargas administradas por el SDK, como el código de paso, al bucket propio de la pipeline, de modo que todos los artefactos viven en un solo lugar y los permisos del rol de ejecución cubren un solo bucket. (Otorgar al rol acceso al bucket predeterminado del SDK también funciona. Este enfoque es más ordenado.)
Calidad de las puertas que coinciden con el comportamiento de los datos de defectos
Cada modelo entrenado se evalúa antes del registro, y la evaluación se ejecuta contra el artefacto ONNX exportado en lugar del modelo PyTorch en memoria. Esa distinción es importante: el artefacto que se limita es el artefacto que se envía, por lo que un problema de exportación nunca puede pasar un modelo roto por una ejecución de entrenamiento con buena apariencia.
La rama de anomalías limita el AUROC de al menos 0,8. La rama del clasificador limita dos métricas al mismo tiempo, y la elección de las métricas está determinada por la propiedad definitoria de los datos de defectos: desequilibrio de clases pesado. En esta muestra, aproximadamente el 90 por ciento de las imágenes son buenas, lo que es realista para una línea de producción. Contra esa distribución, la precisión simple no tiene sentido, porque un modelo que predice "bueno" para cada imagen obtiene una puntuación de aproximadamente 0,9 mientras captura cero defectos. La precisión equilibrada, la media de la recuperación por clase, corrige eso, pero tiene su propio punto ciego. Un modelo con una recuperación perfecta de partes buenas y solo el 20 por ciento de recuperación de defectos aún obtiene una puntuación de (1,0 + 0,2) / 2 = 0,6. Por lo tanto, la puerta requiere una precisión equilibrada de al menos 0,6 y una recuperación de defectos de al menos 0,5, juntas:
step_check_classifier = ConditionStep(
    name="CheckClassifierQuality",
    conditions=[
        ConditionGreaterThanOrEqualTo(
            left=JsonGet(
                step_name=step_eval_classifier.name,
                property_file="evaluation",
                json_path="balanced_accuracy",
            ),
            right=min_accuracy,
        ),
        ConditionGreaterThanOrEqualTo(
            left=JsonGet(
                step_name=step_eval_classifier.name,
                property_file="evaluation",
                json_path="defect_recall",
            ),
            right=min_defect_recall,
        ),
    ],
    if_steps=[step_compile_classifier, step_register_classifier],
    else_steps=[step_fail_classifier],
    depends_on=[step_eval_classifier],
)
Un ConditionStep AND sus condiciones, por lo que ambas deben pasar. Los umbrales son parámetros de la pipeline, ajustables por ejecución sin volver a implementar. Si una puerta falla, un FailStep marca la ejecución como fallida y el modelo de esa rama nunca llega al registro (las dos ramas pasan por la puerta de forma independiente, por lo que el modelo de la otra rama aún puede registrarse). La flota sigue sirviendo el modelo aprobado anterior para esa cámara.
El código de entrenamiento aborda el mismo desequilibrio desde el otro lado. El clasificador es un resnet18 afinado con pesos de ImageNet y una cabeza de dos clases. En tamaños de conjuntos de datos por cámara, afinar los pesos preentrenados es lo que evita que el modelo colapse en la clase mayoritaria. El código de entrenamiento equilibra los lotes de entrenamiento con un WeightedRandomSampler que utiliza frecuencias de clase inversas, mientras que la pérdida permanece sin ponderar. Combinar una pérdida ponderada con muestreo ponderado corrige excesivamente hacia la clase minoritaria.
Compilando para el edge con SageMaker Neo, dentro de la pipeline
Observe la if_steps de la puerta en el código anterior: después de la puerta, la compilación se ejecuta primero y el registro depende de ella. Ambos scripts de entrenamiento exportan ONNX con ejes de lote dinámicos. Las puertas de calidad califican esos artefactos exportados bajo ONNX Runtime, y luego un paso CompileAnomalibNeo o CompileClassifierNeo pasa el artefacto aprobado a SageMaker Neo. La invariante es puerta, luego compilar, luego registrar. Un modelo solo se convierte en un paquete aprobado si también se compila para el objetivo de edge de la flota, por lo que el registro nunca anuncia un modelo que los dispositivos no pueden ejecutar.
El paso de compilación encapsula tres detalles propensos a errores. Neo requiere que la tarjeta de entrada contenga solo el archivo del modelo, pero los trabajos de entrenamiento emiten model.tar.gz con el punto de control y las métricas junto con el modelo ONNX. El paso vuelve a empaquetar una tarjeta ONNX solo primero. Neo también requiere formas de entrada concretas mientras que las exportaciones declaran un eje de lote dinámico, por lo que el tamaño de lote 1 se fija en la solicitud de compilación. Y porque los pasos de la pipeline pueden volver a intentarse, el nombre del trabajo de compilación se deriva de forma determinista del ID de ejecución, por lo que una repetición reanuda la votación del trabajo que ya se inició en lugar de huérfano.
El objetivo es un parámetro de la canalización: NeoTargetDevice selecciona un dispositivo con nombre como jetson_xavier o rasp4b, y su valor predeterminado se compila para la plataforma NeoTargetOs/NeoTargetArch, LINUX/X86_64 de forma predeterminada. El paquete compilado contiene el compiled.so optimizado junto con el runtime de DLR para cargarlo. La salida predeterminada se ejecuta en cualquier host Linux x86_64, por lo que puede validarla antes de comprometerse con objetivos específicos del dispositivo. La compilación en sí no incurre en cargo. Paga por la instancia de procesamiento que la impulsa y el almacenamiento de S3 de las salidas. Para compilar un modelo ya registrado para tipos de dispositivos adicionales más adelante, sin volver a entrenar, el repositorio incluye un script ad hoc que ejecuta el mismo flujo contra el Registro de modelos.
Modelos por cámara en el Registro de modelos
Cada rama se registra en su propio grupo de paquetes de modelo, y cada paquete lleva el ID de la cámara y sus métricas de evaluación. Del ejemplo, con la cableado de las métricas eliminado:
classifier_model_builder = ModelBuilder(
    s3_model_data_url=classifier_model_data,
    image_uri=custom_training_image_uri,
    sagemaker_session=pipeline_session,
    role_arn=role_arn,
)
step_register_classifier = ModelStep(
    name="RegisterClassifierModel",
    depends_on=[step_compile_classifier],
    step_args=classifier_model_builder.register(
        model_package_group_name="sm1k-classifier-model-group",
        approval_status="Approved",
        model_metrics=classifier_metrics,
        customer_metadata_properties={"CameraId": camera_id},
    ),
)
customer_metadata_properties es lo que convierte dos grupos de paquetes compartidos en un catálogo de flota. Los paquetes de todas las cámaras viven en los mismos grupos, y la historia por cámara se recupera filtrando los metadatos. Cada rama tiene un paso de recuperación que pasa por los paquetes aprobados más nuevos primero hasta que encuentra el modelo más reciente de la cámara que realiza la solicitud, porque ListModelPackages no puede filtrar los metadatos del cliente en el servidor. En la primera ejecución de una cámara, la recuperación no encuentra nada y el entrenamiento vuelve a su inicialización de inicio en frío (pesos de ImageNet para el clasificador, inicialización aleatoria para el autoencoder). Cada ejecución posterior se reanuda desde el modelo anterior de esa cámara, lo que hace que el reentrenamiento incremental frecuente y económico sea viable en toda la flota.
Tenga en cuenta qué son y qué no son estas entradas del registro: catalogan artefactos con versiones y calidad, pero su referencia de contenedor es la imagen de entrenamiento, que no sirve para puntos de conexión de inferencia. Existen para un flujo de trabajo de flota donde un sistema descendente extrae artefactos y los envía a dispositivos, no para CreateEndpoint.
Orquestación de solicitudes de entrenamiento de flota
Cada cuenta de AWS tiene cuotas de servicio para trabajos de entrenamiento de SageMaker concurrentes, y cada ejecución de la canalización aquí lanza varios trabajos, por lo que el reentrenamiento de la flota necesita un ritmo. Algo tiene que evitar que un estallido de 500 solicitudes se convierta en 500 lanzamientos de canalización simultáneos. El ejemplo utiliza un semáforo, un contador de ranuras disponibles que funciona como un estacionamiento con cinco espacios. Antes de que la máquina de estado de Step Functions inicie una canalización, toma una ranura incrementando atómicamente un contador en DynamoDB, con una condición que rechaza el incremento una vez que se alcanza el límite:
acquire_semaphore = tasks.DynamoUpdateItem(
    self, "AcquireSemaphore",
    table=semaphore_table,
    key={"LockName": tasks.DynamoAttributeValue.from_string("pipeline-concurrency")},
    update_expression="SET ActiveCount = if_not_exists(ActiveCount, :zero) + :one",
    condition_expression="attribute_not_exists(ActiveCount) OR ActiveCount < :limit",
)
Si todos los espacios están ocupados, la ejecución espera y vuelve a intentarlo. Cuando su pipeline finaliza, decrementa el contador para liberar el espacio. Un detalle que vale la pena considerar en sus propios diseños es que la expresión de condición de DynamoDB hace cumplir el límite en una sola operación atómica, en lugar de que la máquina de estado lea el contador y tome una decisión, lo que dejaría una ventana de carrera entre la lectura y la escritura. El repositorio implementa el resto del endurecimiento operativo, incluyendo la liberación de espacios en todos los caminos de falla y el envío de ejecuciones fallidas a Amazon SNS a través de Amazon EventBridge. Su README cubre el tamaño de los límites de espera.
El límite de cinco es un parámetro de pila, establecido en un valor bajo para que la muestra se implemente y se ejecute en cualquier cuenta estándar sin solicitar aumentos de cuota. Ajuste según lo que las cuotas de trabajo de capacitación de su cuenta admitan. Más allá de las cuotas de una sola cuenta, escalar la capacitación de la flota es un tema propio. Las palancas estándar son aumentar las cuotas de servicio, distribuir la capacitación en diferentes tipos de instancias o regiones y distribuir la flota en varias cuentas. También puede mantener el backlog en SQS y admitir trabajo solo cuando se libere la capacidad. Esas opciones dependen del tamaño y la forma de su flota. La muestra le da el esqueleto funcional para extender.
Implementar y ejecutar la muestra
El recorrido en el README del repositorio es la versión autorizada. La siguiente forma abreviada comienza desde una extracción limpia y configura el entorno antes de la primera implementación:
git clone https://github.com/aws-samples/sample-sagemaker-fleet-cv-pipeline
cd sample-sagemaker-fleet-cv-pipeline && python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cdk bootstrap                                           # once per account/region
cdk deploy SageMakerCVPipelineStack -c bootstrap=true   # roles, bucket, ECR
cdk deploy --all                                        # pipeline + orchestration
./scripts/push_ecr_image.sh                             # build and push training image
De forma predeterminada, el pipeline genera imágenes de línea de producción sintéticas, por lo que puede validar todo el sistema de extremo a extremo sin conjunto de datos y sin aprobaciones de datos. Una ejecución completa ejecuta los 13 pasos, incluyendo ambas compilaciones de Neo, en aproximadamente 15 minutos y cuesta aproximadamente $0,07 en tiempo de ml.m5.xlarge facturado (Región de US East (Ohio) (us-east-2), julio de 2026, bajo demanda). Los recursos de orquestación juntos cuestan menos de $0,10 por mes a escala de muestra.
Para ejercitar la pipeline con imágenes reales, el repositorio incluye un descargador para el conjunto de datos BCCD. El conjunto de datos es una colección de 364 imágenes de microscopía de frotis de sangre anotadas originalmente open source en GitHub y reorganizadas en formato Pascal VOC bajo una licencia MIT. El mismo conjunto de datos también es distribuido por Roboflow como dominio público. El script asigna la presencia de plaquetas a la clase de defecto, divide opcionalmente las imágenes por cámara para simular una flota y sube los archivos tar de entrenamiento al bucket de la pipeline. La notebook acompañante ejecuta la pipeline completa con los datos reales y realiza inferencia ONNX lado a lado con una muestra normal y una anómala. Tratar las plaquetas como defectos es un sustituto ilustrativo para una distribución de defectos de fabricación, no una reclamación clínica.
Limpieza
Los paquetes de modelo se crean en el runtime de la pipeline, por lo que AWS CloudFormation no puede eliminarlos. Elimínelos con la CLI de AWS primero, luego destruya las pilas con cdk destroy --all -c bootstrap=true --force. El README enumera los comandos exactos.
Conclusión
En esta publicación, mostré una arquitectura de referencia de SageMaker SDK v3 funcionando para el ciclo de vida de visión por computadora a escala de flota. La arquitectura incluye una pipeline de entrenamiento de doble rama donde cada modelo es evaluado en su artifacto ONNX exportado, compilado con SageMaker Neo y solo entonces registrado. Un diseño de registro de modelos utiliza metadatos de cámara para convertir grupos de paquetes compartidos en historial inicializable por cámara, y una capa de orquestación de Step Functions controla el entrenamiento de la flota dentro de los límites de cuenta. Para los equipos cuyas necesidades son cubiertas por opciones administradas como Amazon Lookout for Vision, ese es el camino más simple. Este patrón se dirige a la restricción de escala de flota por cámara que las opciones administradas no cubren. Las reglas de diseño se transfieren más allá de la visión por computadora: evaluar en precisión equilibrada más recall de clase minoritaria en lugar de precisión, evaluar y compilar el artifacto que se envía, y hacer que los fallos operativos notifiquen en lugar de terminar silenciosamente.
La muestra se despliega en minutos y una ejecución de validación completa cuesta alrededor de siete centavos de cómputo, por lo que un próximo paso de bajo costo es clonar el repositorio y ejecutarlo. A partir de ahí, apunte el descargador de BCCD a un bucket real, establezca NeoTargetDevice para su hardware o ajuste los límites de orquestación a su flota. Para la migración del SDK v3 en sí, la documentación del SDK de Python de SageMaker y la serie de dos partes que anuncia el nuevo SDK son las referencias que mantuve abiertas durante todo el proceso.
Si desea ayuda para adaptar este patrón a su entorno de producción, comuníquese con el equipo de su cuenta de AWS.
Acerca del autor
Fleet-wide computer vision model lifecycle management is a problem that shows up the moment a quality inspection proof of concept succeeds. One camera and one model work fine. Then the plant asks for the same result on 40 lines, each with several cameras, and every camera sees the world differently. Each has a different angle, different glare off the same stainless surface, and different ambient light depending on which bay door is open. In production deployments we have worked on, a single model trained on pooled footage underperforms enough individual cameras that each camera ends up with its own fine-tuned model. Now the real problem is no longer training one model well. It’s training, evaluating, versioning, and shipping thousands of them without a human in the loop for each one.
This post updates the pattern introduced in the 2023 series Build an end-to-end MLOps pipeline for visual quality inspection at the edge for the current Amazon SageMaker Python SDK v3. It replaces the since-deprecated Amazon SageMaker Edge Manager with Amazon SageMaker Neo for edge optimization. I walk through a dual-branch Amazon SageMaker Pipeline that trains an anomaly detector and a defect classifier per camera, with quality gates that block underperforming models. An in-pipeline SageMaker Neo compilation step ensures every registered model ships with a device-optimized artifact, and an AWS Step Functions orchestration layer paces fleet training. You deploy everything with the AWS Cloud Development Kit (AWS CDK), and a full pipeline run on synthetic data costs about $0.07 in compute.
The complete sample is available in the aws-samples GitHub repository.
Solution overview
The following diagram shows the sample’s fleet-wide model lifecycle. An orchestration layer queues re-training requests and limits concurrent work. A per-camera training pipeline prepares data, trains and evaluates an anomaly detector and a classifier, and produces versioned model artifacts for edge devices.
Figure 1: Solution architecture
The training half is a single SageMaker Pipeline, parameterized by camera, that runs 13 steps per execution. Three entry steps run in parallel: Preprocess, Fetch Latest Anomaly, and Fetch Latest Classifier. The pipeline preprocesses that camera’s images and fetches the camera’s most recent approved model for each branch, then trains two models. The first is a small convolutional autoencoder that learns what normal product looks like and flags anomalies by reconstruction error. The second is a ResNet18 classifier fine-tuned to confirm the defect. Each branch exports its model to ONNX, evaluates the exported artifact against held-out data, and passes through a quality gate. Past the gate, the model is compiled with SageMaker Neo for the configured edge target, and only then registered in the SageMaker Model Registry. As a result, every approved package has a device-ready compiled artifact. Packages carry the camera ID as metadata, and each branch’s warm-start fetch filters on it, so re-training always resumes from that camera’s own history.
The orchestration half paces the fleet. Re-training requests land on an Amazon Simple Queue Service (Amazon SQS) FIFO queue, and an AWS Lambda function starts a Step Functions execution per request. Each execution acquires a slot through a DynamoDB semaphore before starting its pipeline, so a burst of requests drains at a steady rate instead of all launching at once. Completions publish to Amazon Simple Notification Service (Amazon SNS), and operational failures reach the same topic through an Amazon EventBridge rule with the original error preserved.
The output of the system is versioned, quality-gated, per-camera model artifacts. The Model Registry holds the portable ONNX, and S3 holds the Neo-compiled build of that model, which is a device-optimized shared library loaded by the DLR runtime rather than ONNX. Both are ready for whatever delivery mechanism your plant uses.
Prerequisites
To deploy the sample you need the following:
- An AWS account with permissions to create AWS Identity and Access Management (IAM) roles.
- An Amazon Simple Storage Service (Amazon S3) bucket.
- An Amazon Elastic Container Registry (Amazon ECR) repository.
- The SageMaker AI, AWS Step Functions, AWS Lambda, Amazon Simple Queue Service (Amazon SQS), Amazon Simple Notification Service (Amazon SNS), Amazon EventBridge, and Amazon DynamoDB resources in the stacks.
- Python 3.10, 3.11, or 3.12, Docker.
- The AWS CDK CLI version 2.1131.0 or later.
Previous CLI versions fail with a cloud assembly schema mismatch against recent versions of aws-cdk-lib. No service quota increase is needed. The orchestration layer admits at most five pipeline executions at a time by default, which keeps concurrent SageMaker training jobs inside the standard account quota.
If you deploy to an AWS Region other than your CLI default, set all three of AWS_REGION, AWS_DEFAULT_REGION, and CDK_DEFAULT_REGION on the deploy command itself rather than in your shell profile, for example, AWS_REGION=us-east-2 AWS_DEFAULT_REGION=us-east-2 CDK_DEFAULT_REGION=us-east-2 cdk deploy --all. The CDK CLI, Boto3, and the AWS Command Line Interface (AWS CLI) resolve the Region from overlapping but not identical variable sets, and a mismatch produces confusing partial deployments. Prefixing the command sets all three for that invocation only, so your own default Region is left unchanged.
Defining the training pipeline with SDK v3
The code in this section is excerpted from the CDK application in the repository rather than a standalone script, and it runs during cdk deploy, when the stack synthesizes the pipeline definition. Environment setup and the deploy commands come later, under Deploying and running the sample. SDK v3 reorganized the SageMaker Python SDK into modular packages, and the imports show the new shape of the library:
from sagemaker.train import ModelTrainer
from sagemaker.train.configs import InputData, Compute, OutputDataConfig
from sagemaker.core.training.configs import MetricDefinition
from sagemaker.serve.model_builder import ModelBuilder
from sagemaker.mlops.workflow.pipeline import Pipeline
from sagemaker.mlops.workflow.steps import ProcessingStep, TrainingStep
from sagemaker.mlops.workflow.model_step import ModelStep
from sagemaker.mlops.workflow.condition_step import ConditionStep
from sagemaker.core.workflow.conditions import ConditionGreaterThanOrEqualTo
from sagemaker.core.workflow.functions import JsonGet
Installing sagemaker>=3.0.0,<4 pulls in sagemaker-core, sagemaker-train, sagemaker-serve, and sagemaker-mlops as separate packages. Training configuration that v2 spread across Estimator constructor arguments now lives in typed config objects passed to ModelTrainer. This is the anomaly branch’s trainer, verbatim from the sample:
anomalib_trainer = ModelTrainer(
    training_image=custom_training_image_uri,
    compute=Compute(
        instance_type=training_instance_type.to_string(),
        instance_count=1,
    ),
    base_job_name="cv-pipeline-anomalib-train",
    sagemaker_session=pipeline_session,
    role=role_arn,
    hyperparameters={
        "program": "train_anomalib.py",
        "model_name": "autoencoder",
        "image_size": "256",
        "num_epochs": "3",
        "batch_size": "16",
        "learning_rate": "0.001",
    },
    input_data_config=anomalib_input_data,
    output_data_config=OutputDataConfig(
        s3_output_path=run_prefix("anomalib-training")
    ),
).with_metric_definitions(
    [
        MetricDefinition(
            name="image_auroc",
            regex=r"validation:image_auroc=([0-9]*\.?[0-9]+)",
        ),
    ]
)
anomalib_input_data wires four channels (train, validation, test, pretrained_model) from upstream step properties, and run_prefix scopes every S3 path to the pipeline execution ID so concurrent fleet runs never collide. Both are in the repository.
Two v3 behaviors matter when the pipeline lives inside a CDK application, and neither appears in the changelog as a breaking change. First, SDK v3 validates the pipeline’s execution role against live IAM while building the pipeline definition. This validation happens at synthesis time rather than execution time. A CDK app can’t create the role and the pipeline in one deployment, because the role doesn’t exist yet when the SDK validates it. This is separate from cdk bootstrap, which provisions the CDK toolkit resources once per account and Region and might already be done in your account. The sample’s own two-phase deploy is driven by a context flag that happens to share that name. An initial pass with -c bootstrap=true creates the role, bucket, and ECR repository, and the second pass synthesizes the pipeline against the now-existing role. The role Amazon Resource Name (ARN) embedded in the pipeline definition must also be a concrete string, not an unresolved CDK token.
Second, the v3 role validator simulates ECR pull permissions without a resource ARN, so an execution role scoped to a single ECR repository fails validation even though it would work at runtime. The sample’s role carries a broader ECR grant for this reason.
Lastly, one v3 habit the sample uses: constructing the pipeline with PipelineSession(default_bucket=your_bucket) routes SDK-managed uploads, such as step code, into the pipeline’s own bucket, so every artifact lives in one place and the execution role’s permissions cover a single bucket. (Granting the role access to the SDK’s default bucket works too. This approach is tidier.)
Quality gates that match how defect data behaves
Every trained model is evaluated before registration, and the evaluation runs against the exported ONNX artifact rather than the in-memory PyTorch model. That distinction matters: the artifact you gate is the artifact you ship, so an export problem can never slip a broken model past a healthy-looking training run.
The anomaly branch gates on AUROC of at least 0.8. The classifier branch gates on two metrics at once, and the choice of metrics is shaped by the defining property of defect data: heavy class imbalance. In this sample roughly 90 percent of images are good, which is realistic for a production line. Against that distribution, plain accuracy is meaningless, because a model that predicts “good” for every image scores about 0.9 while catching zero defects. Balanced accuracy, the mean of per-class recall, corrects for that, but it has its own blind spot. A model with perfect recall on good parts and only 20 percent recall on defects still scores (1.0 + 0.2) / 2 = 0.6. So the gate requires balanced accuracy of at least 0.6 and defect recall of at least 0.5, together:
step_check_classifier = ConditionStep(
    name="CheckClassifierQuality",
    conditions=[
        ConditionGreaterThanOrEqualTo(
            left=JsonGet(
                step_name=step_eval_classifier.name,
                property_file="evaluation",
                json_path="balanced_accuracy",
            ),
            right=min_accuracy,
        ),
        ConditionGreaterThanOrEqualTo(
            left=JsonGet(
                step_name=step_eval_classifier.name,
                property_file="evaluation",
                json_path="defect_recall",
            ),
            right=min_defect_recall,
        ),
    ],
    if_steps=[step_compile_classifier, step_register_classifier],
    else_steps=[step_fail_classifier],
    depends_on=[step_eval_classifier],
)
A ConditionStep ANDs its conditions, so both must pass. The thresholds are pipeline parameters, adjustable per execution without redeploying. If a gate fails, a FailStep marks the execution failed and that branch’s model never reaches the registry (the two branches gate independently, so the other branch’s model may still register). The fleet keeps serving the previous approved model for that camera.
The training code addresses the same imbalance from the other side. The classifier is a fine-tuned resnet18 with ImageNet weights and a two-class head. At per-camera dataset sizes, fine-tuning pretrained weights is what keeps the model from collapsing onto the majority class. The training code balances training batches with a WeightedRandomSampler using inverse class frequencies, while the loss stays unweighted. Combining a weighted loss with weighted sampling over-corrects toward the minority class.
Compiling for the edge with SageMaker Neo, inside the pipeline
Notice the gate’s if_steps in the preceding code: past the gate, compilation runs first and registration depends on it. Both training scripts export ONNX with dynamic batch axes. The quality gates score those exported artifacts under ONNX Runtime, and then a CompileAnomalibNeo or CompileClassifierNeo step hands the gated artifact to SageMaker Neo. The invariant is gate, then compile, then register. A model only becomes an Approved package if it also compiled for the fleet’s edge target, so the registry never advertises a model the devices cannot run.
The compile step encapsulates three error-prone details. Neo requires the input tarball to contain only the model file, but training jobs emit model.tar.gz with the checkpoint and metrics alongside the ONNX model. The step repackages an ONNX-only tarball first. Neo also requires concrete input shapes while the exports declare a dynamic batch axis, so batch size 1 is pinned in the compilation request. And because pipeline steps can retry, the compilation job name derives deterministically from the execution ID, so a retry resumes polling the job it already started instead of orphaning it.
The target is a pipeline parameter: NeoTargetDevice selects a named device such as jetson_xavier or rasp4b, and its default compiles for the NeoTargetOs/NeoTargetArch platform, LINUX/X86_64 by default. The compiled package contains the optimized compiled.so plus the DLR runtime for loading it. The default output runs on any x86_64 Linux host, so you can validate it before committing to device-specific targets. Compilation itself incurs no charge. You pay for the processing instance that drives it and the S3 storage of the outputs. For compiling an already-registered model for additional device types later, without re-training, the repository includes an ad-hoc script that runs the same flow against the Model Registry.
Per-camera models in the Model Registry
Each branch registers into its own model package group, and every package carries the camera ID and its evaluation metrics. From the sample, with the metrics wiring elided:
classifier_model_builder = ModelBuilder(
    s3_model_data_url=classifier_model_data,
    image_uri=custom_training_image_uri,
    sagemaker_session=pipeline_session,
    role_arn=role_arn,
)
step_register_classifier = ModelStep(
    name="RegisterClassifierModel",
    depends_on=[step_compile_classifier],
    step_args=classifier_model_builder.register(
        model_package_group_name="sm1k-classifier-model-group",
        approval_status="Approved",
        model_metrics=classifier_metrics,
        customer_metadata_properties={"CameraId": camera_id},
    ),
)
Camera identity in customer_metadata_properties is what turns two shared package groups into a fleet catalog. Packages from all cameras live in the same groups, and per-camera history is recovered by filtering on the metadata. Each branch has a fetch step that pages through approved packages newest-first until it finds the requesting camera’s latest model, because ListModelPackages cannot filter on customer metadata server-side. On a camera’s first run the fetch finds nothing and training falls back to its cold-start initialization (ImageNet weights for the classifier, random initialization for the autoencoder). Every later run resumes from that camera’s own prior model, which is what makes frequent, cheap, incremental re-training viable across a fleet.
Note what these registry entries are and are not: they catalog versioned, quality-gated artifacts, but their container reference is the training image, which serves no inference endpoints. They exist for a fleet workflow where a downstream system pulls artifacts and ships them to devices, not for CreateEndpoint.
Orchestrating fleet training requests
Every AWS account has service quotas on concurrent SageMaker training jobs, and each pipeline execution here launches several jobs, so fleet re-training needs pacing. Something has to keep a burst of 500 requests from becoming 500 simultaneous pipeline launches. The sample uses a semaphore, a counter of available slots that works like a parking lot with five spaces. Before the Step Functions state machine starts a pipeline, it takes a slot by atomically incrementing a counter in DynamoDB, with a condition that refuses the increment once the cap is reached:
acquire_semaphore = tasks.DynamoUpdateItem(
    self, "AcquireSemaphore",
    table=semaphore_table,
    key={"LockName": tasks.DynamoAttributeValue.from_string("pipeline-concurrency")},
    update_expression="SET ActiveCount = if_not_exists(ActiveCount, :zero) + :one",
    condition_expression="attribute_not_exists(ActiveCount) OR ActiveCount < :limit",
)
If all slots are taken, the execution waits and retries. When its pipeline finishes, it decrements the counter to release the slot. One detail is worth carrying into your own designs. The DynamoDB condition expression enforces the cap in a single atomic operation, rather than the state machine reading the counter and deciding, which would leave a race window between the read and the write. The repository implements the rest of the operational hardening, including releasing slots on every failure path and forwarding failed executions to Amazon SNS through Amazon EventBridge. Its README covers sizing the wait bounds.
The cap of five is a stack parameter, set low so the sample deploys and runs in any standard account without requesting quota increases. Adjust it to whatever your account’s training-job quotas support. Past a single account’s quotas, scaling fleet training is its own topic. The standard levers are raising the service quotas, spreading training across instance types or Regions, and distributing the fleet across multiple accounts. You can also hold the backlog in SQS and admit work only as capacity frees up. Those choices depend on your fleet’s size and shape. The sample gives you the working skeleton to extend.
Deploying and running the sample
The walkthrough in the repository README is the authoritative version. The following short form starts from a clean checkout and sets up the environment before the first deploy:
git clone https://github.com/aws-samples/sample-sagemaker-fleet-cv-pipeline
cd sample-sagemaker-fleet-cv-pipeline && python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cdk bootstrap                                           # once per account/region
cdk deploy SageMakerCVPipelineStack -c bootstrap=true   # roles, bucket, ECR
cdk deploy --all                                        # pipeline + orchestration
./scripts/push_ecr_image.sh                             # build and push training image
By default the pipeline generates synthetic production line images, so you can validate the whole system end to end with no dataset and no data approvals. A full run executes all 13 steps, including both Neo compilations, in about 15 minutes and costs roughly $0.07 in billed ml.m5.xlarge time (US East (Ohio) Region (us-east-2), July 2026, on-demand). The orchestration resources together cost well under $0.10 per month at sample scale.
To exercise the pipeline on real images, the repository includes a downloader for the BCCD dataset. The dataset is a collection of 364 annotated blood smear microscopy images originally open sourced on GitHub and reorganized into Pascal VOC format under an MIT license. The same dataset is also distributed by Roboflow as public domain. The script maps platelet presence to the defect class, optionally splits the images per camera to simulate a fleet, and uploads training tarballs to the pipeline bucket. The accompanying notebook runs the full pipeline on the real data and does side-by-side ONNX inference on a normal and an anomalous sample. Treating platelets as defects is an illustrative stand-in for a manufacturing defect distribution, not a clinical claim.
Cleaning up
Model packages are created at pipeline runtime, so AWS CloudFormation cannot delete them. Remove them with the AWS CLI first, then destroy the stacks with cdk destroy --all -c bootstrap=true --force. The README lists the exact commands.
Conclusion
In this post, I showed a working SageMaker SDK v3 reference architecture for the fleet-scale computer vision lifecycle. The architecture includes a dual-branch training pipeline where every model is quality-gated on its exported ONNX artifact, compiled with SageMaker Neo, and only then registered. A Model Registry layout uses camera metadata to turn shared package groups into per-camera warm-startable history, and a Step Functions orchestration layer paces fleet training within account quotas. For teams whose needs are met by managed options such as Amazon Lookout for Vision, that is the simpler path. This pattern targets the per-camera, fleet-scale constraint that managed options do not cover. The design rules transfer beyond computer vision: gate on balanced accuracy plus minority-class recall rather than accuracy, evaluate and compile the artifact you ship, and make operational failures notify rather than terminate silently.
The sample deploys in minutes and a full validation run costs about seven cents of compute, so a low-cost next step is to clone the repository and run it. From there, point the BCCD downloader at a real bucket, set NeoTargetDevice for your hardware, or size the orchestration bounds to your fleet. For the SDK v3 migration itself, the SageMaker Python SDK documentation and the two-part series announcing the new SDK are the references I kept open throughout.
If you want help adapting this pattern to your production environment, reach out to your AWS account team.
About the author
