
La afinación es el proceso de continuar entrenando un modelo de lenguaje grande preentrenado (LLM) con los datos propios de una empresa para que se adapte a un dominio, tarea o estilo específico, en lugar de confiar solo en el conocimiento de propósito general. Para las empresas, el valor es doble. Un modelo afinado entrega una precisión medible y mejor en el trabajo específico del dominio, reduciendo costos: un modelo especializado más pequeño puede igualar o superar a un modelo de frontera en su tarea a una fracción del precio de inferencia por token. Estos ahorros se acumulan a lo largo de millones de solicitudes. La afinación se ha convertido, por lo tanto, en un proceso esencial para las empresas que buscan obtener más valor de los LLM a menor costo.
Los métodos de afinación eficiente en parámetros (PEFT) como la adaptación de baja rango (LoRA) han surgido como una solución práctica para la afinación de LLM para tareas downstream, reduciendo los requisitos de capacidad de GPU al actualizar solo un pequeño subconjunto de parámetros de LLM. LoRA busca equilibrar la eficiencia y la expresividad, sin embargo, la naturaleza de baja rango de la actualización de peso inherente limita el poder de representación de los modelos afinados con LoRA, comprometiendo potencialmente el rendimiento en tareas complejas. Este intercambio obstaculiza la capacidad de los métodos LoRA para capturar patrones complejos necesarios para tareas diversas. Para abordar estos desafíos, la afinación completa (FFT) actualiza los parámetros del modelo simultáneamente, superando las limitaciones de baja rango para que los LLM puedan absorber completamente el conocimiento específico del dominio complejo.
Personalización de modelo sin servidor de Amazon SageMaker AI ahora es compatible con Afinación Completa (FFT), para que pueda lograr una calidad de modelo superior sin administrar infraestructura. No se requiere provisionamiento de GPU, configuración de cluster ni configuración de entrenamiento distribuido. En esta publicación, exploramos cuándo y dónde FFT supera consistentemente a LoRA en benchmarks clave, examinamos las propiedades espectrales de las matrices de peso del modelo que explican esta brecha de calidad, proporcionamos pautas prácticas de ajuste de hiperparámetros respaldadas por experimentos controlados que utilizan la personalización de modelo sin servidor de SageMaker AI, y le mostramos cómo empezar a trabajar con FFT en SageMaker AI.
Afinación Completa: Por qué es importante
Los tipos de personalización de modelos como LoRA reducen los parámetros entrenables congelando los pesos del modelo preentrenado e inyectando pequeños pares separados de matrices de reemplazo (llamadas matrices de bajo rango) en las capas del modelo. Esto funciona bien para adaptaciones simples, pero la estructura de bajo rango limita inherentemente el poder de representación del modelo afinado. A medida que las tareas se vuelven más complejas y los conjuntos de datos escalan más allá de decenas de miles de ejemplos, LoRA alcanza un límite de precisión donde aumentar el rango (y por lo tanto los parámetros entrenables) no logra cerrar la brecha de precisión con el afinamiento estándar. Este límite revela que la brecha de rendimiento no se debe simplemente a la menor cantidad de parámetros. Se debe a la deficiencia de rango en sí. La actualización de bajo rango no puede capturar la complejidad completa de los cambios de peso necesarios para la adaptación de tareas profundas.
Sin embargo, para tareas y dominios complejos donde existen grandes conjuntos de datos de buena calidad, el afinamiento de rango completo sobresale al actualizar los parámetros del modelo simultáneamente. FFT modifica la matriz de pesos del modelo de manera uniforme, utilizando la capacidad de representación completa de las matrices de pesos del modelo en lugar de restringir las actualizaciones a un subespacio pequeño, y sin introducir las distorsiones abruptas y localizadas características de los métodos de bajo rango. El resultado es una convergencia de modelo más fuerte, una mejor alineación de activación en las capas del modelo y un modelo que captura fielmente tanto la distribución de la tarea objetivo como la riqueza de su conocimiento preentrenado. La ventaja de calidad de FFT crece con la escala del conjunto de datos: con 100K+ ejemplos de entrenamiento, FFT alcanzó el 90,0 por ciento en la corrección semántica LLM-as-Judge en tareas de generación de código, como se muestra en el siguiente gráfico.
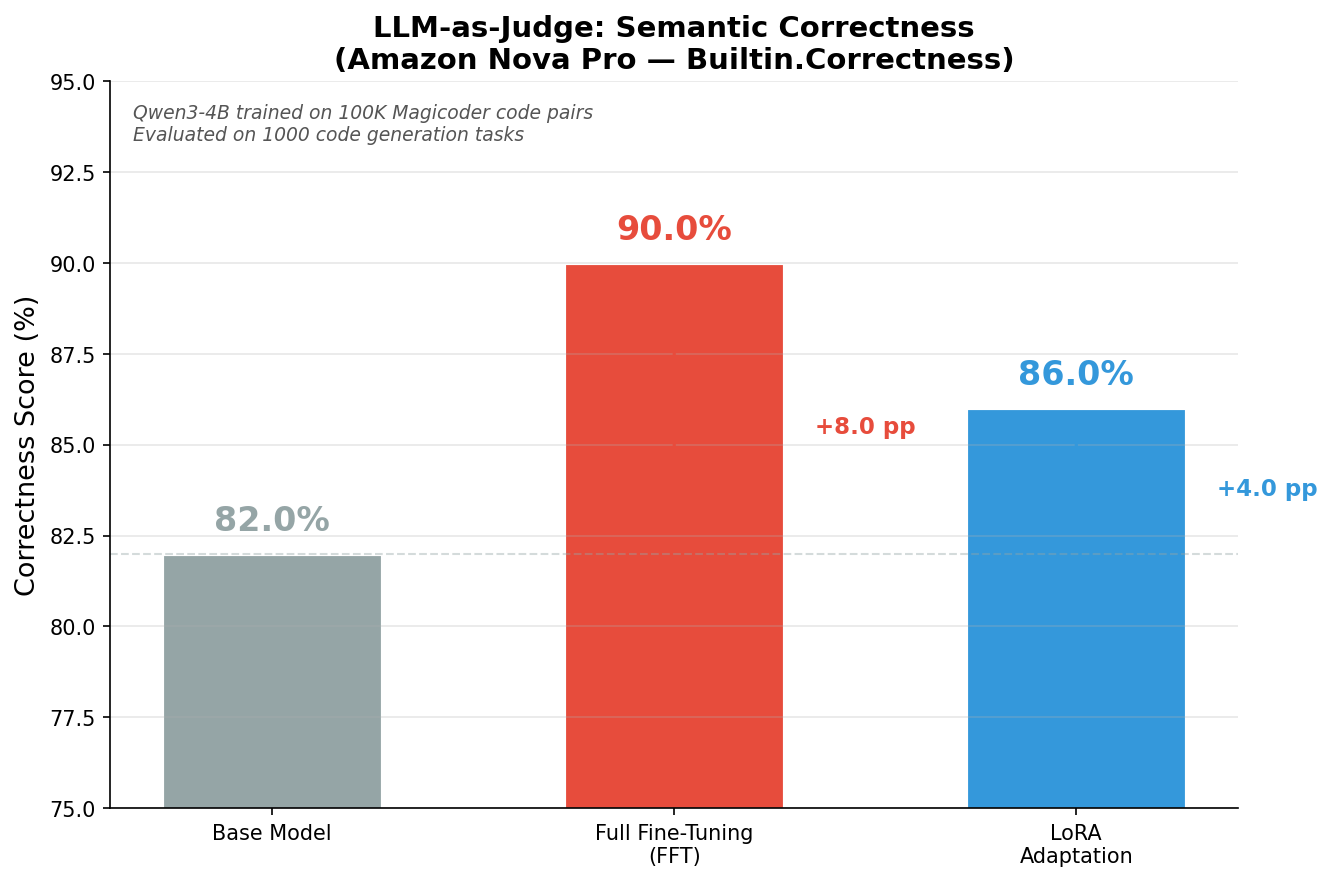
Figura 1: Corrección semántica LLM-as-Judge por método de entrenamiento a medida que los datos de entrenamiento escalan a 100K+ ejemplos
Además, el siguiente gráfico de radar proporciona una visión holística: el modelo base (polígono interior) muestra puntuaciones consistentemente bajas en todos los ejes. LoRA (polígono medio) muestra una mejora fuerte y equilibrada. FFT (polígono exterior) se extiende aún más en cada dimensión, con ventajas particularmente pronunciadas en las puntuaciones BLEU y ROUGE-2. Esta ventaja de calidad multidimensional confirma que no se trata de un artefacto específico de la métrica, sino de una ventaja fundamental de la optimización de rango completo.
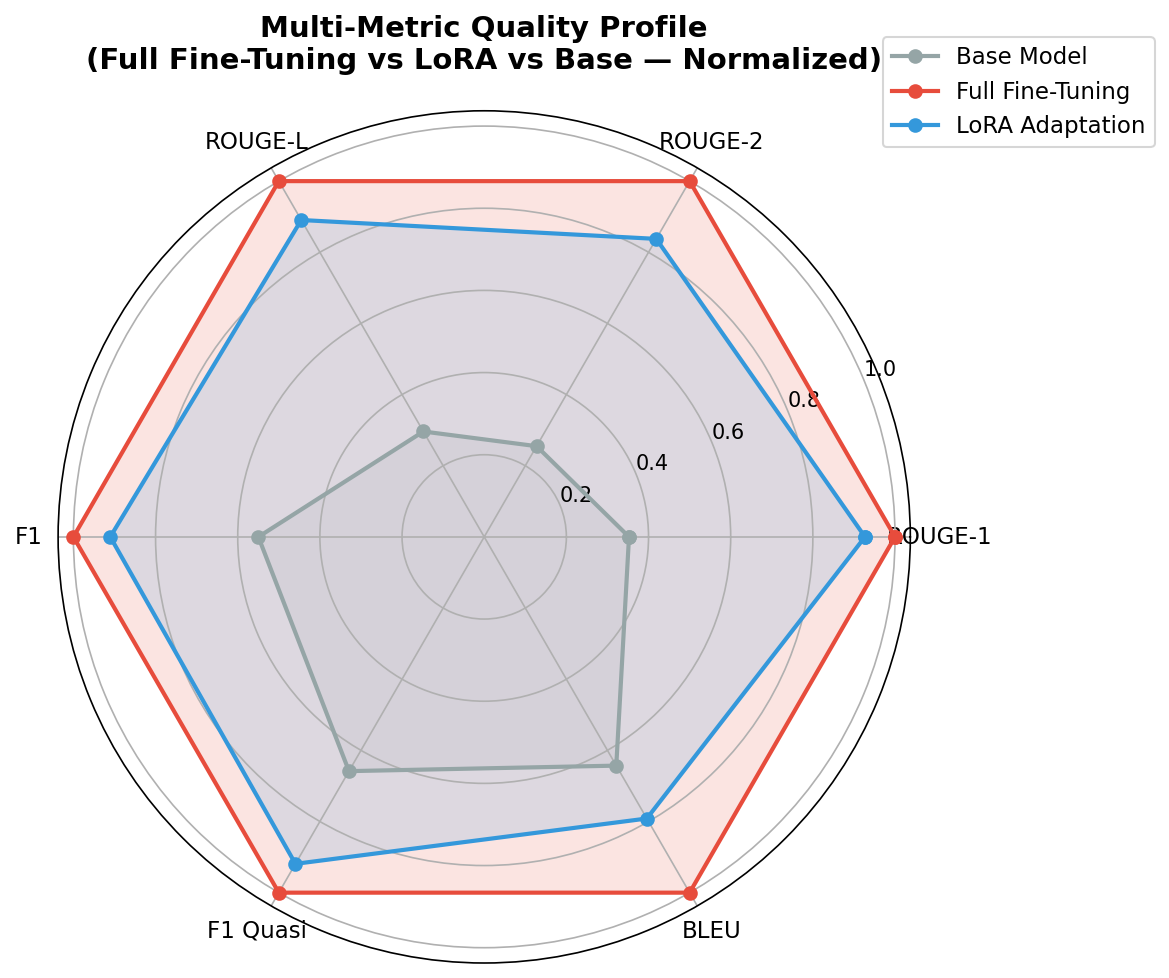
Figura 2: Gráfico de radar que compara el modelo base, LoRA y FFT en dimensiones de calidad
Los detalles de cómo llegamos a estos resultados, los conjuntos de datos de codificación utilizados para la personalización del modelo y el proceso de experimentación se explican en detalle en las secciones siguientes.
Experimentación y resultados de benchmark
En esta publicación, utilizamos la técnica de Ajuste fino supervisado (SFT) en un modelo base Qwen3-4B ofrecido dentro de Amazon SageMaker AI Studio y realizamos todas las experimentaciones de ajuste fino utilizando Personalización de modelo servidorless de SageMaker AI en los métodos de entrenamiento LoRA y FFT. En cada experimento, ambos métodos recibieron los mismos prompts, objetivos y código de evaluación.
Conjunto de datos: Generación de código 110K pares de instrucciones
Para toda la experimentación, ajustamos el modelo base Qwen3-4B en el conjunto de datos Magicoder-Evol-Instruct-110K, un corpus curado de 110,000 pares de instrucciones y respuestas de codificación que abarcan el diseño de algoritmos, depuración, estructuras de datos y programación de sistemas. Aplicamos una división 90/5/5 al conjunto de datos: 99,000 registros para entrenamiento, 5,500 para validación para monitorear la convergencia y la pérdida de entrenamiento durante el trabajo de personalización, y 5,500 reservados como conjunto de prueba para una evaluación imparcial del modelo final, como se registra en los activos de conjunto de datos de SageMaker AI y se muestra en la siguiente figura.
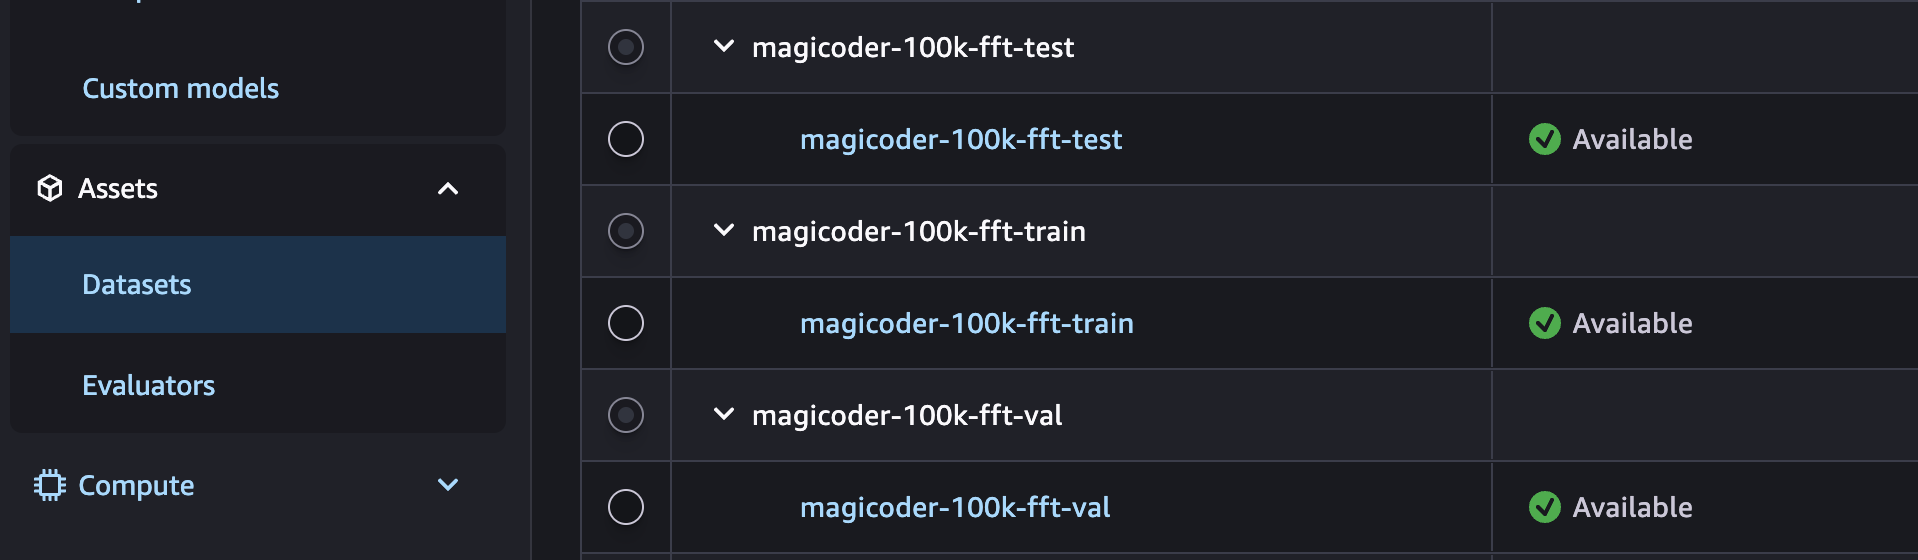
Figura 3: El conjunto de datos de 110K pares de instrucciones registrado en los activos de conjunto de datos de SageMaker AI
Trabajo de personalización de modelo sin servidor
Todos los experimentos de personalización de modelo en esta publicación se realizaron en Amazon SageMaker AI Serverless Model Customization. La personalización de modelo sin servidor en SageMaker AI permite a los científicos de datos y los ingenieros de aprendizaje automático (ML) centrarse en la afinación del modelo sin administrar la infraestructura o la planificación de la capacidad de GPU. Especifica el modelo base, el conjunto de datos y los hiperparámetros, y el servicio maneja la asignación de cómputo y la administración de puntos de control de manera automática en un modo sin servidor. El siguiente fragmento de código muestra uno de esos experimentos para lanzar un trabajo de afinación completa (FFT) en la personalización de modelo sin servidor utilizando el SDK de Python de SageMaker.
El código desencadena un trabajo de personalización de modelo sin servidor, mostrado en la siguiente captura de pantalla, con métricas de rendimiento de entrenamiento rastreadas en el trabajo y visibles en la aplicación de MLflow vinculada.
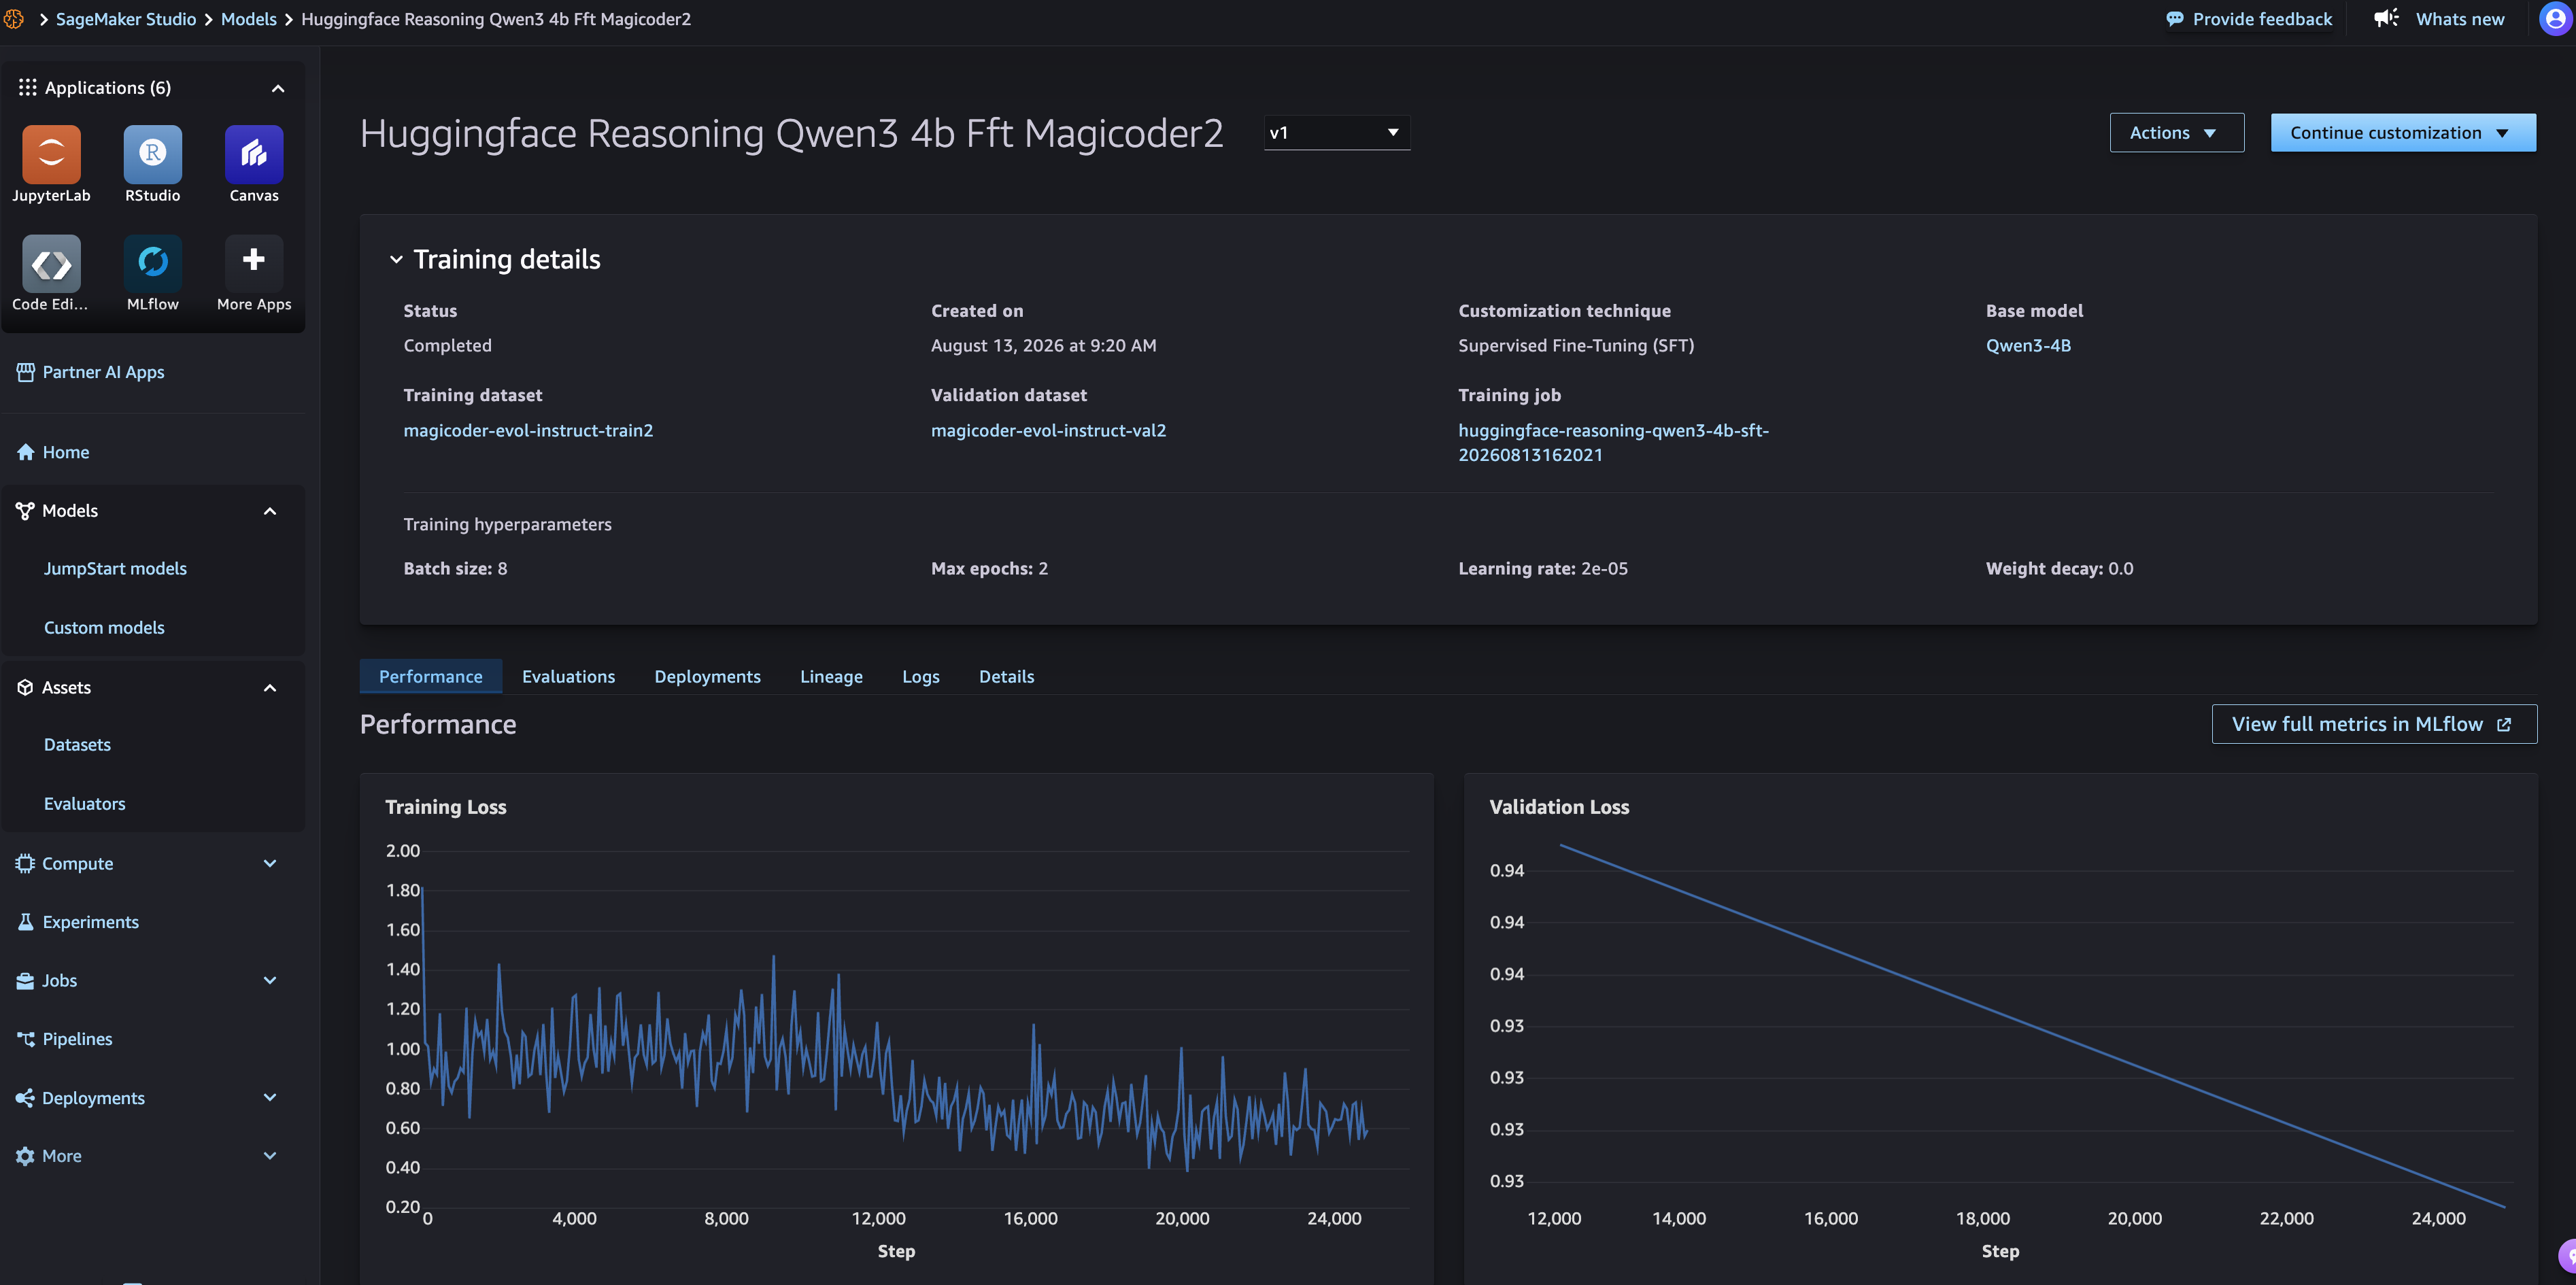
Figura 4: Trabajo de personalización de modelo sin servidor con métricas de entrenamiento rastreadas en MLflow
Cambiar de afinación completa a LoRA requiere solo un cambio: establecer TrainingType.FULL en TrainingType.LORA. El resto del código permanece idéntico:
Evaluación y benchmarking del modelo
Probamos los modelos personalizados resultantes en tres métodos de evaluación diversos integrados en la personalización de modelo sin servidor de SageMaker AI: LLM-as-Judge, PRIMECODE y MMLU, mostrados en la siguiente imagen. Cada uno se dirige a una dimensión diferente de la calidad del modelo: corrección semántica, fidelidad de generación de código y retención de conocimiento general. Juntos proporcionan una imagen completa de la calidad de la personalización del modelo.
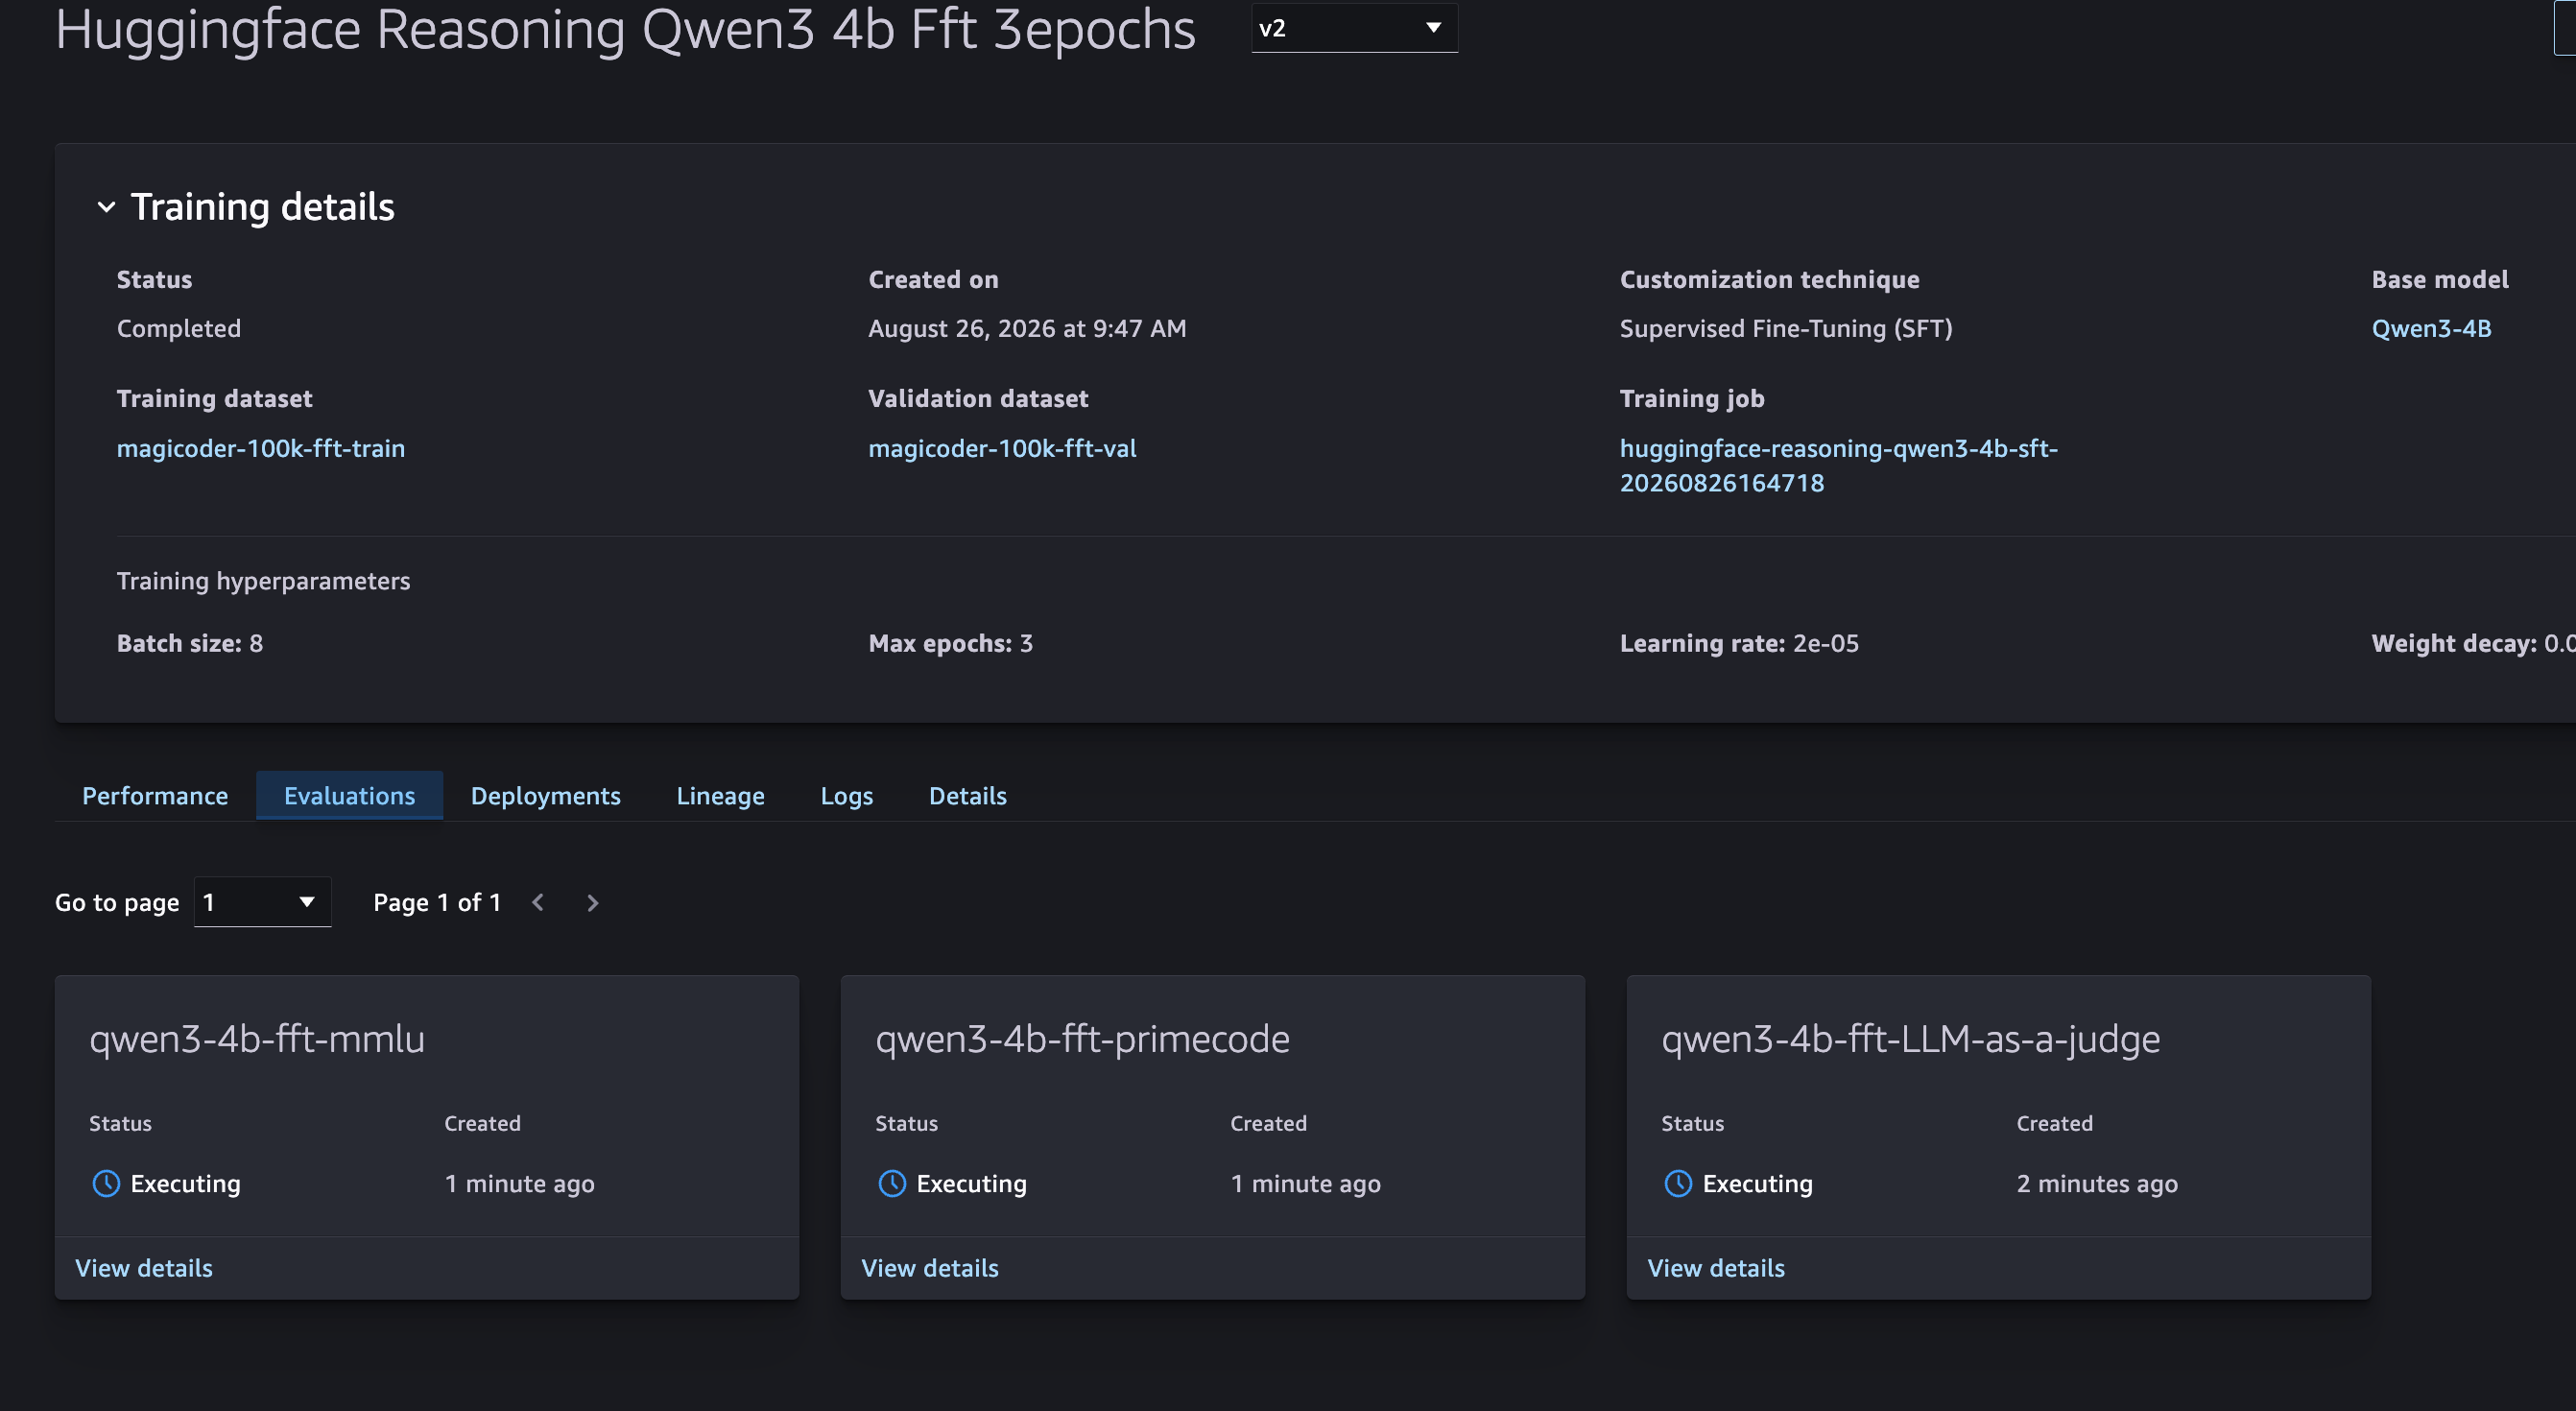
Figura 5: Los tres métodos de evaluación integrados en la personalización de modelos sin servidor de SageMaker AI
La métrica LLM-as-Judge utiliza un modelo de frontera (en este caso, Amazon Nova Pro) como evaluador automatizado que lee el código generado por el modelo junto con la solicitud original y juzga si la solución es lógicamente correcta. En la personalización de modelos sin servidor, puede evaluar tanto el modelo personalizado como el modelo base, como se muestra en la siguiente figura.
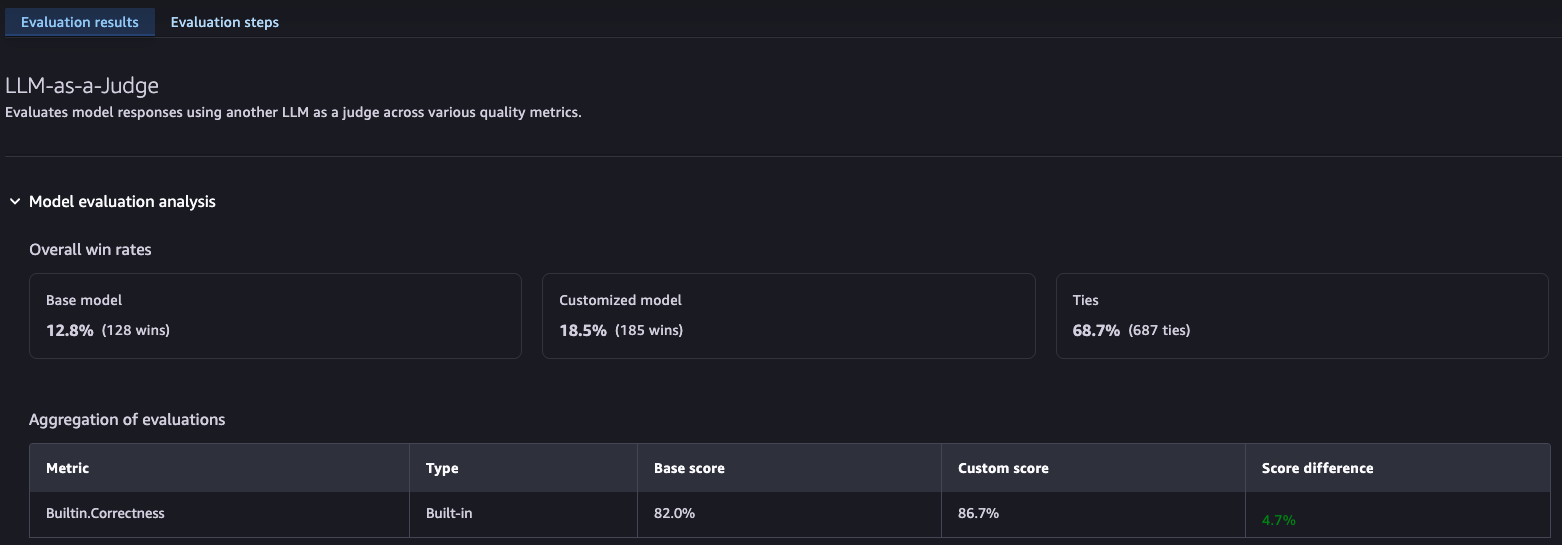
Figura 6: Evaluación LLM-as-Judge que compara el modelo personalizado y el modelo base
PRIMECODE es una evaluación de puntuación personalizada que mide lo cerca que está el código generado por el modelo con respecto a las soluciones de referencia utilizando métricas de similitud de texto determinísticas: BLEU (precisión de n-gramas), ROUGE-1/2/L (superposición orientada a la recuperación) y F1 (equilibrio entre precisión y recuperación). Estas métricas son completamente reproducibles, lo que las hace ideales para estudios de ablación controlados. Utilizamos PRIMECODE como nuestra métrica principal para la calidad del código a nivel de superficie porque cuantifica lo bien que el modelo ha aprendido los patrones de codificación, las convenciones de formato y el estilo de implementación presentes en los datos de entrenamiento. Una puntuación BLEU alta significa que el modelo genera código que se parece estructuralmente a las soluciones escritas por expertos, como se muestra en los siguientes resultados.
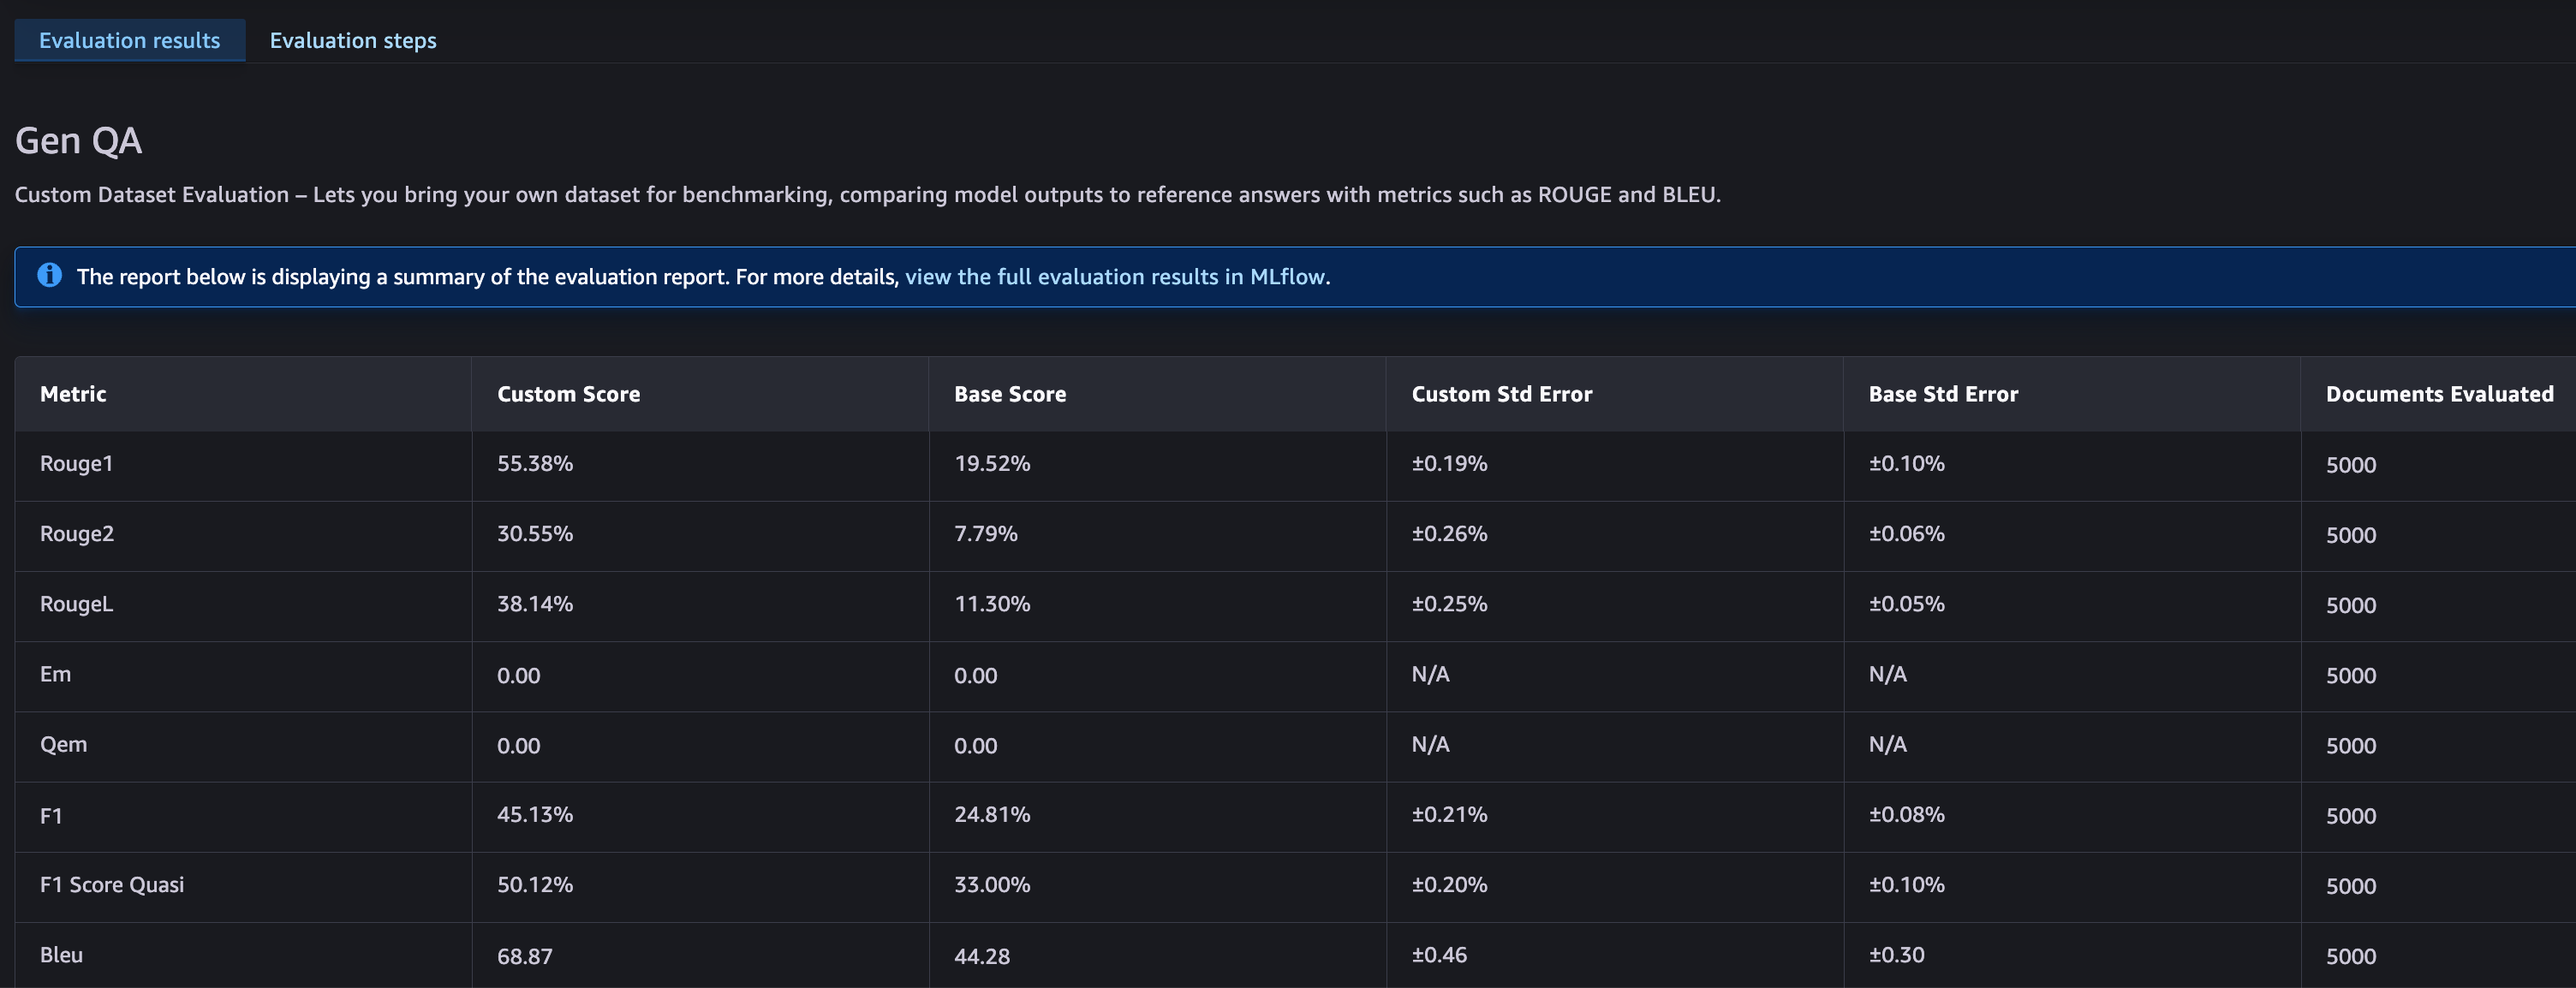
Figura 7: Puntuaciones de similitud de texto de PRIMECODE para el modelo personalizado
MMLU (Comprensión de Lenguaje Multitarea Masiva) es una referencia integrada que prueba el modelo en 57 materias académicas, desde álgebra abstracta y anatomía hasta Nutrición y Filosofía. Mide si el modelo retiene su amplio conocimiento general después de un ajuste fino específico del dominio, como se muestra en la figura siguiente. Utilizamos MMLU como nuestra barrera de detección de olvido. El ajuste fino en código puede sobreescribir las capacidades generales almacenadas en los pesos del modelo. Al rastrear la precisión de MMLU antes y después del ajuste fino, podemos cuantificar exactamente cuánto conocimiento general sacrifica el modelo para mejorar la generación de código, y si nuestras opciones de hiperparámetros aceleran o mitigan este intercambio.
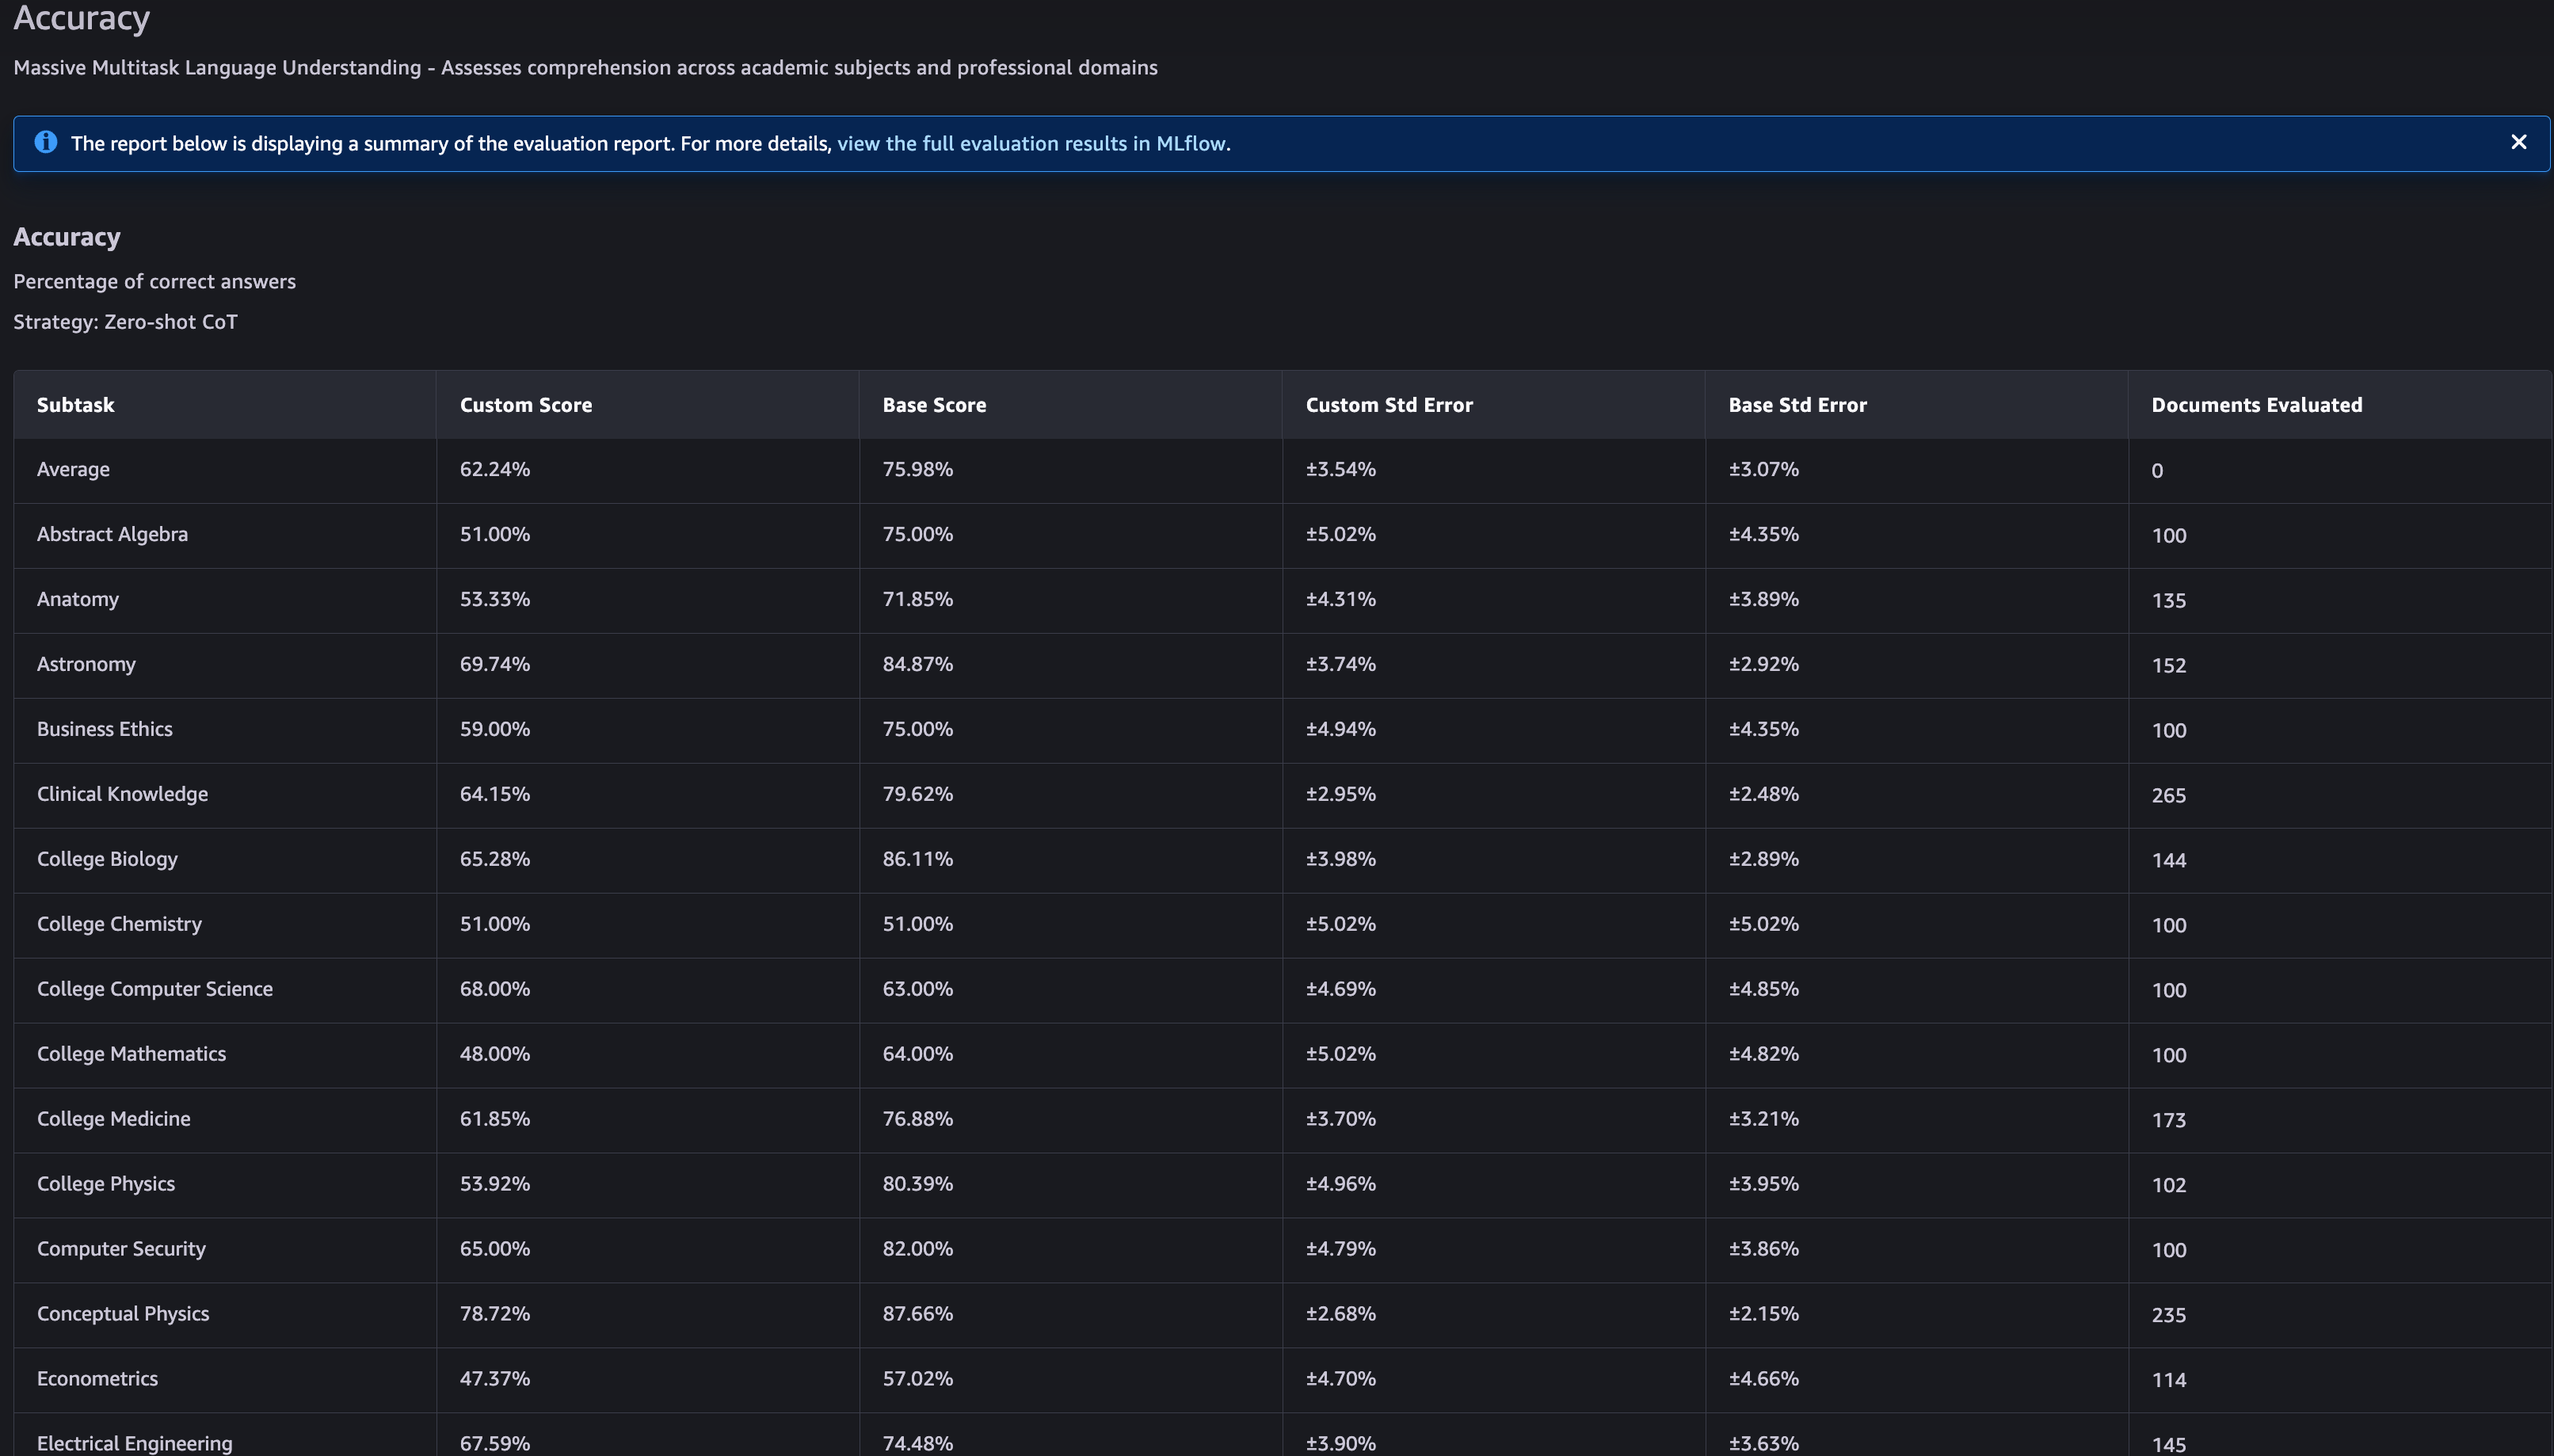
Figura 8: Precisión de MMLU antes y después del ajuste fino
Experimentación rápida a gran escala
La facilidad de configuración y uso de la personalización de modelos sin servidor de SageMaker AI nos permitió realizar experimentación rápida sin volver a provisionar la infraestructura. Cambiamos los tipos de entrenamiento entre LoRA y FFT, barrimos hiperparámetros y probamos en varios modelos base. En una ventana de tiempo corta, ejecutamos decenas de experimentos de personalización de modelos en varios modelos base compatibles (Qwen3-4B, DeepSeek-R1-1.5B, Nemotron-30B, Gemma-4-26B), ablatando sistemáticamente la tasa de aprendizaje, el tamaño del lote, la relación de calentamiento, el recuento de épocas y la escala del conjunto de datos. Cada experimento, desde la presentación del trabajo hasta los resultados de evaluación, se completó en unas pocas horas y los modelos ajustados resultantes se registraron automáticamente en el Registro de modelos de SageMaker como Paquetes de modelos con versiones, listos para revisión o implementación.
Opciones de hiperparámetros
La personalización de modelos sin servidor de SageMaker AI admite muchos hiperparámetros. En esta sección, explicamos algunos de los más importantes, informados por la serie de experimentos que realizamos en múltiples configuraciones de hiperparámetros dentro de la tarea de generación de código mencionada anteriormente. Si bien los valores efectivos variarán según la tarea, los patrones observados en estos experimentos proporcionan puntos de partida útiles al configurar trabajos de personalización de modelos FFT. Para obtener más información sobre los hiperparámetros que puede configurar antes de lanzar un trabajo de personalización de modelo FFT, consulte la página de documentación de hiperparámetros.
1. learning_rate
En el ajuste fino completo, la tasa de aprendizaje controla con qué agresividad se actualiza cada peso. A diferencia de LoRA, donde solo cambian pequeñas matrices de adaptador, una tasa de aprendizaje FFT que es demasiado alta sobrescribe permanentemente el conocimiento preentrenado. En nuestros experimentos, el siguiente mapa de riesgo LR × tamaño de conjunto de datos muestra que una LR de 2e-5 en un conjunto de datos grande (más de 100 mil) fue la zona segura.
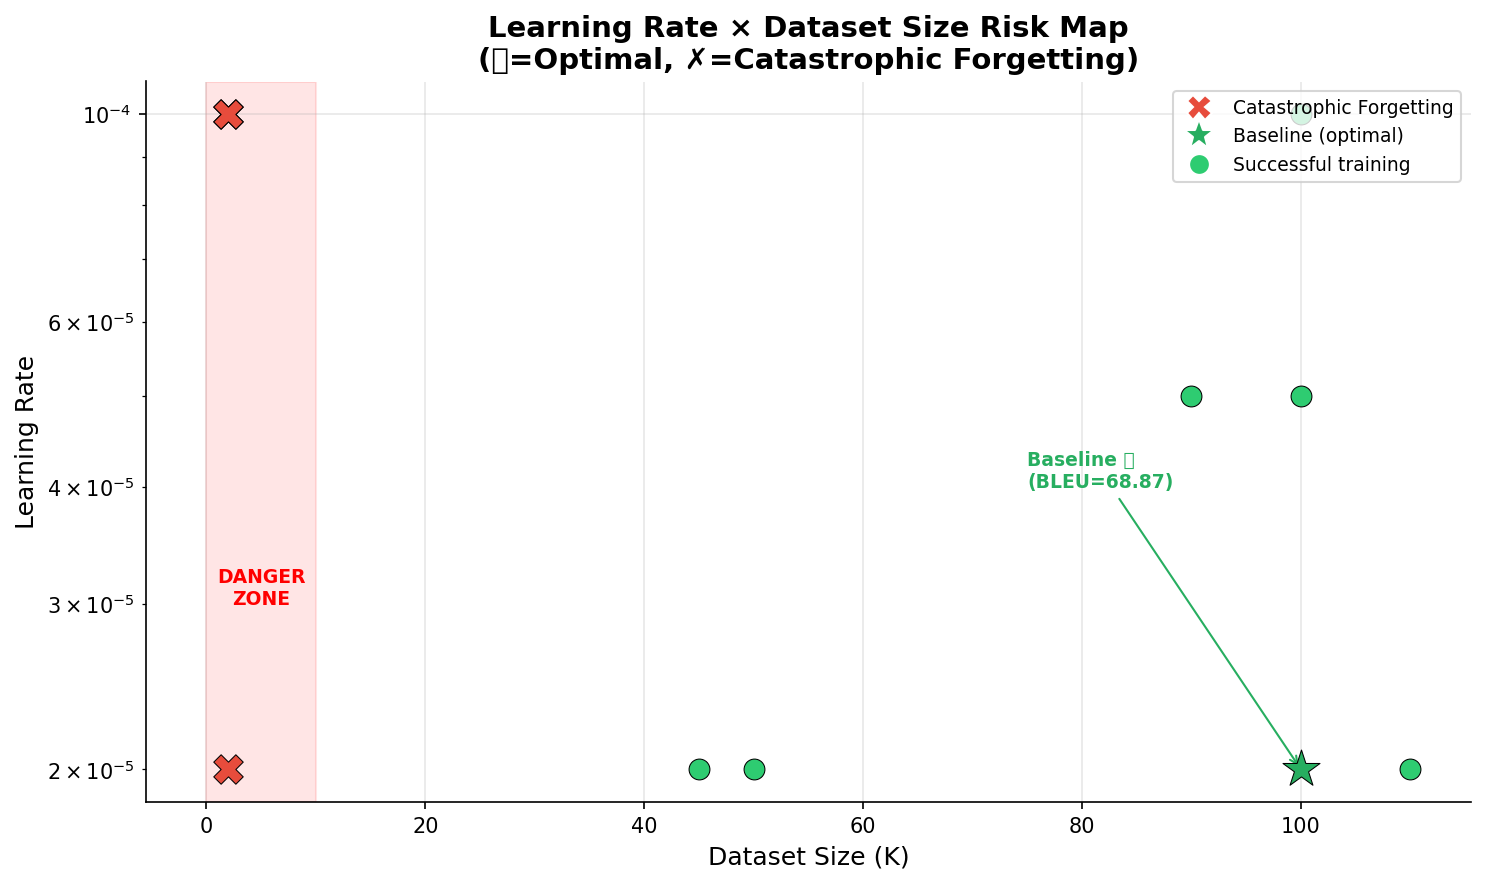
Figura 9: Mapa de riesgo de tasa de aprendizaje y tamaño de conjunto de datos para ajuste fino completo
2. max_epochs
La cuenta de épocas en FFT es fundamentalmente una pregunta de olvido, no una pregunta de curva de pérdida. La pérdida de entrenamiento seguirá disminuyendo y su validación mantenida parecerá saludable porque comparte una distribución con los datos de entrenamiento, pero las capacidades en todo lo que no se entrenó se degradan silenciosamente. La puntuación de corrección LLM-as-Judge aumentó a 90,0 por ciento en 3 épocas, y extender más allá de 3 épocas degradó cada variante con la que experimentamos.
3. global_batch_size
El tamaño del lote determina cuántos ejemplos contribuyen a cada paso de gradiente. A una tasa de aprendizaje fija, los lotes más pequeños producen actualizaciones más ruidosas que se comportan mucho como una tasa de aprendizaje más alta, aumentando el riesgo de olvido. Los lotes más grandes reducen el ruido, pero también reducen la cantidad de pasos de optimización, lo que potencialmente puede provocar un ajuste insuficiente.
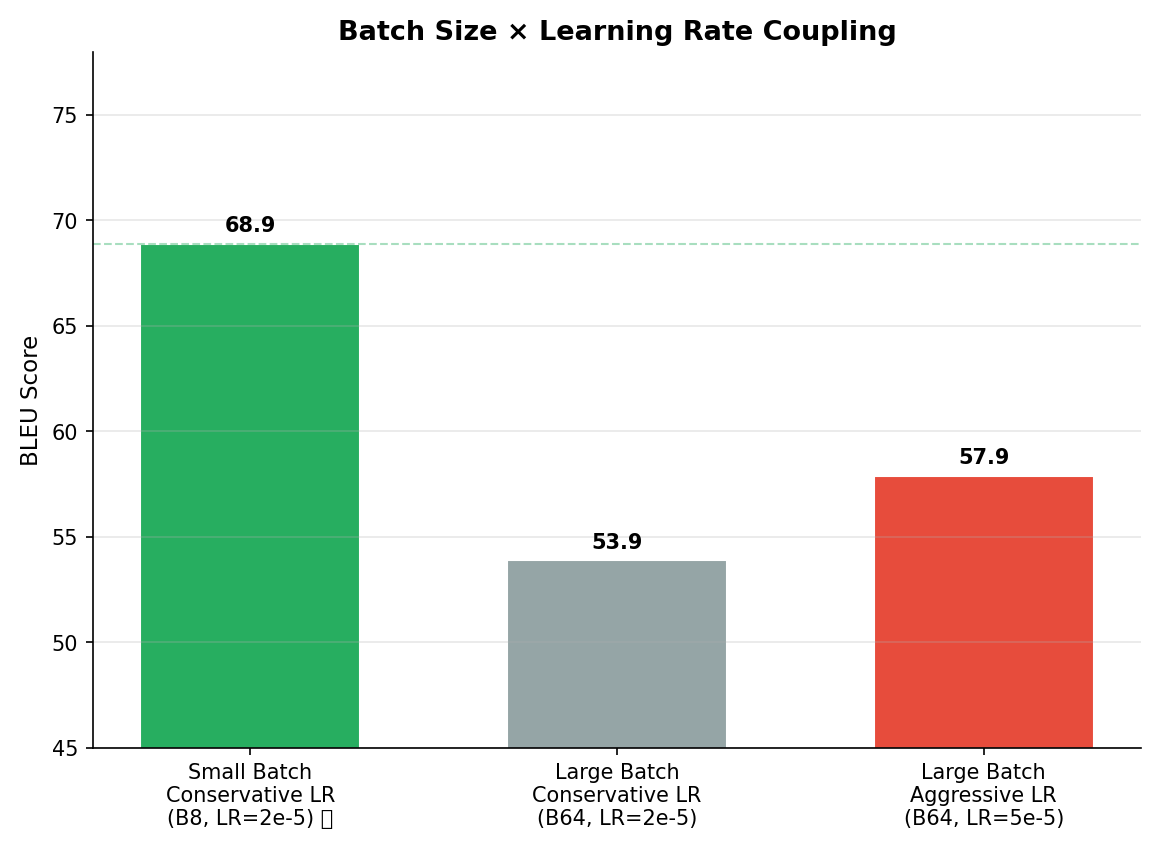
Figura 10: Efecto del tamaño de lote global en la calidad del modelo
Riesgo de olvido catastrófico
FFT modifica cada parámetro en el modelo, incluidos los parámetros que codifican el conocimiento general adquirido durante el preentrenamiento. Cuando el ajuste fino empuja estos parámetros demasiado agresivamente hacia un dominio estrecho, el modelo puede "olvidar" sus capacidades más amplias, un fenómeno conocido como olvido catastrófico. Lo probamos sistemáticamente utilizando MMLU, midiendo la retención del conocimiento general en todas nuestras configuraciones de ajuste fino. Una configuración de referencia con warmup=5 por ciento, tamaño de lote 8 y LR=2e-5 preservó mejor el conocimiento general (MMLU), como se muestra en la siguiente figura.
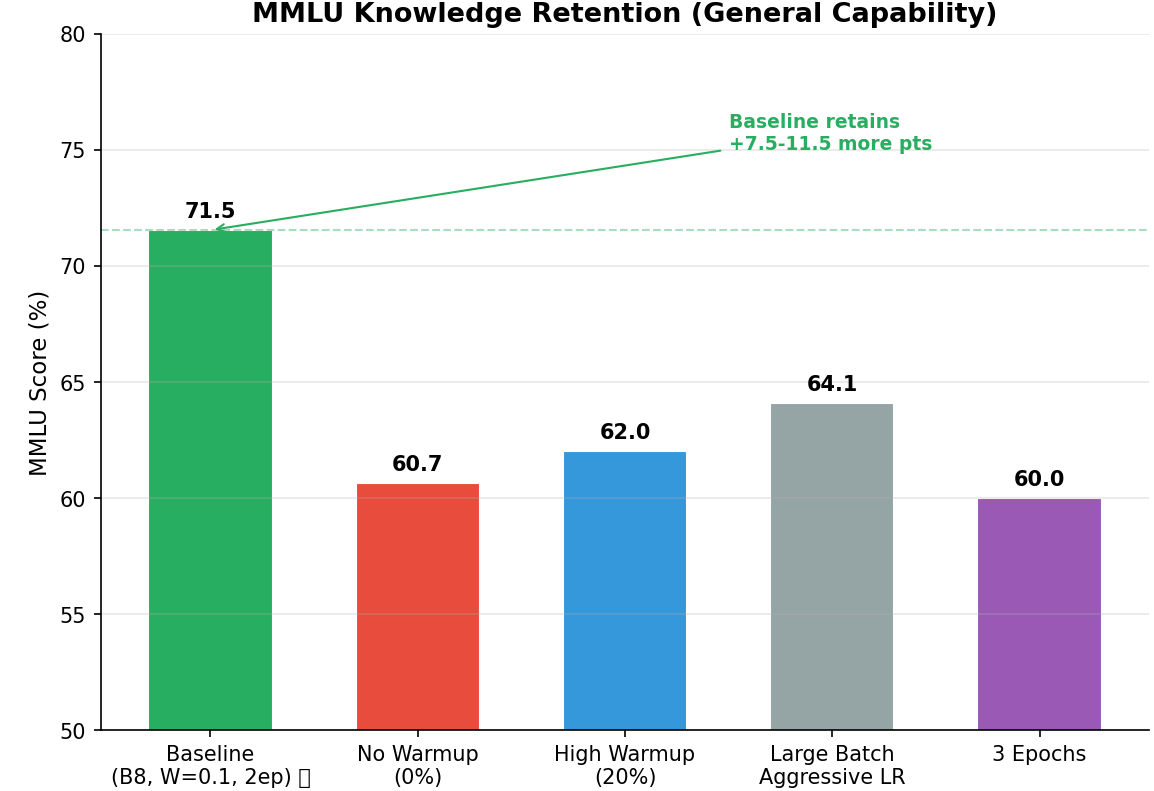
Figura 11: Retención de conocimiento general de MMLU en configuraciones de hiperparámetros
Por lo tanto, es importante destacar que FFT no es universalmente superior a LoRA, y su eficacia es extremadamente sensible a las elecciones de hiperparámetros. Por ejemplo, en nuestros experimentos, tanto FFT como LoRA tuvieron un rendimiento inferior al modelo base en MATH exact match, lo que subraya el desafío de preservar las capacidades de razonamiento durante el ajuste fino específico del dominio. Las tasas de aprendizaje agresivas (LR ≥ 5e-5) en FFT resultaron particularmente destructivas, lo que hizo que las puntuaciones de MATH cayeran a 2-3 por ciento y la precisión de MMLU disminuyera a 3,6 por ciento, lo que es una clara evidencia de olvido catastrófico. Además, LoRA ligeramente superó a FFT en la métrica LLM-as-Judge (81,5 por ciento en comparación con 79,5 por ciento), lo que demuestra que los métodos eficientes en parámetros aún pueden tener una ventaja en evaluaciones de calidad subjetiva. Estos hallazgos refuerzan que la elección entre FFT y LoRA debe guiarse por una experimentación cuidadosa, las características del conjunto de datos y una clara comprensión de los compromisos involucrados.
Conclusión
Con Ajuste fino completo en la personalización de modelos sin servidor de Amazon SageMaker AI, su modelo puede absorber completamente el conocimiento específico del dominio cuando la complejidad de la tarea y la escala de los datos lo requieran. Si su caso de uso requiere una adaptación profunda, como razonamiento especializado, generación de código o comprensión del lenguaje específico del dominio, y tiene suficientes datos de entrenamiento de alta calidad, el ajuste fino completo (FFT) entrega resultados medibles más fuertes.
Puede comenzar con FFT en Personalización de modelos sin servidor de SageMaker AI con entrenamiento sin servidor, evaluación integrada y sin planificación de infraestructura o capacidad de cómputo, para que pueda centrarse en sus datos y opciones de hiperparámetros. Puede utilizar el SDK de Python de SageMaker para configurar y lanzar sus trabajos de entrenamiento y evaluación de forma programática. Puede ver la documentación de los modelos base compatibles disponibles para el ajuste fino completo en la personalización de modelos sin servidor.