Cómo Amazon Marketplace evalúa la calidad del contenido con Amazon SageMaker AI
How Amazon Marketplace evaluates content quality with Amazon SageMaker AI
James Kim
El contenido A+ es el widget de medios ricos en la página de detalles del producto de Amazon. A través de activos visuales, las marcas comunican el valor único del producto y la marca para ayudar a los clientes a tomar decisiones de compra informadas. Los socios de ventas que utilizan contenido A+ de alta calidad aumentan sus ventas en un 8-20 por ciento en comparación con aquellos que no lo tienen. Una amplia variedad de marcas, desde marcas establecidas con grandes equipos de diseño internos hasta marcas con recursos limitados, utilizan contenido A+, lo que crea inconsistencia en la calidad del contenido. Un proyecto de contenido A+ típico combina texto, imágenes y video en una historia de producto coherente. Evaluar cada activo de forma aislada pasa por alto la calidad que surge de cómo esos activos trabajan juntos. Cuando su contenido abarca múltiples módulos heterogéneos y necesita una señal de calidad holística en lugar de controles por activo, el enfoque de fusión multi-modelo descrito en esta publicación puede ayudar. En esta publicación, examinamos este problema en el contexto del contenido A+.
El contenido A+ proporciona libertad creativa a los socios de ventas para expresar su auténtico ser en sus páginas de detalles de productos, sin especificaciones de contenido estrictas como la relación de imagen y el recuento de palabras de texto.
Aunque esta flexibilidad permite una narrativa de marca atractiva, también crea una variación sustancial en la composición y calidad del contenido.
Con la evaluación de la calidad y las recomendaciones de mejora, las marcas pueden transformar el contenido promedio en contenido de alta calidad que sea más coherente, relevante y útil. Este contenido mejorado ayuda a los clientes a tomar decisiones de compra más informadas y a establecer relaciones duraderas con las marcas, lo que conduce a una mejora de los ingresos para los socios de ventas.
Para lograr este objetivo, un sistema de evaluación debe evaluar la experiencia de contenido completa, proporcionar recomendaciones accionables más allá de las puntuaciones numéricas y reflejar las nuances a través de las categorías de productos. Los enfoques existentes luchan por cumplir con todos estos requisitos simultáneamente, por lo que en esta publicación, verá un nuevo enfoque que utiliza Modelos de Visión-Lenguaje (VLM) para comprender y evaluar el contenido de forma holística, y un componente de generación basado en difusión que produce activos visuales mejorados a partir de las señales de calidad resultantes.
En esta publicación, aprenderá a:
Representar el contenido de comercio electrónico completo como una sola instantánea y evaluarlo de forma holística con un VLM.
Combinar puntuaciones semánticas de VLM con señales de legibilidad de OCR en un clasificador CatBoost ligero entrenado en anotaciones de expertos.
Utilizar SHAP para explicar las decisiones de calidad y generar recomendaciones de mejora accionables para los socios de ventas.
Implementar la canalización de extremo a extremo en Amazon SageMaker AI, desde la ingesta de datos y anotación hasta la alojamiento de modelos, explicabilidad y monitoreo de producción.
Oportunidades y desafíos en la evaluación basada en VLM
Un modelo de lenguaje de visión (VLM) empareja un codificador de imagen con un gran modelo de lenguaje (LLM). El codificador, a menudo un transformador de visión (ViT), divide una imagen en parches y los convierte en incrustaciones, y un pequeño conector mapea esas incrustaciones en el espacio de entrada del modelo de lenguaje (Flamingo, LLaVA). Muchos VLMs reutilizan el codificador de imagen de CLIP, que aprendió a emparejar imágenes con sus subtítulos. Debido a que los VLMs están entrenados para seguir instrucciones, puedes darle una imagen junto con un rubric de criterios de evaluación y obtener una evaluación escrita sin entrenamiento específico de tarea. Cuando necesitas un acuerdo más cercano con los revisores humanos, puedes ajustar el modelo en ejemplos etiquetados. Esto hace que los VLMs sean un punto de partida práctico para verificar imágenes de productos contra tus pautas de contenido a escala.
Los modelos de visión convencionales ya pueden puntuar activos individuales, por ejemplo, marcar una imagen borrosa o un error de gramática en una lista de viñetas. Usar un VLM para calificar cada activo por separado agrega poco más allá de eso. Una página de detalles de producto, sin embargo, combina imágenes, texto y módulos de diseño en una sola historia, y su calidad depende de cómo funcionan esas piezas juntas. Nuestro enfoque renderiza la página completa como una sola instantánea y le pide al VLM que la evalúe como la ven los clientes.
Considera una página de licuadora con una imagen de héroe, una lista de características con viñetas que resalta la velocidad y la capacidad de la cuchilla, y una foto de estilo de vida de la licuadora en una cocina moderna. Revisados uno por uno, cada activo pasa: la imagen es nítida, las viñetas son gramaticales y la foto está bien iluminada. Vistos juntos, aparecen problemas. Las viñetas podrían anunciar un pitcher de 64 oz mientras que la foto de estilo de vida muestra un modelo de un solo servicio, o la foto de estilo de vida podría estar sobre la imagen de héroe para que los clientes vean la cocina antes del producto. Debido a que el significado de un activo depende de dónde aparezca y qué lo rodee, estos problemas solo se muestran cuando la página se evalúa en su totalidad. La instantánea le da al VLM esa vista completa. Usarlo en producción agrega tres requisitos: las puntuaciones deben coincidir con los estándares de calidad de expertos, la evaluación debe ser precisa y eficiente a escala, y cada resultado debe explicar qué corregir.
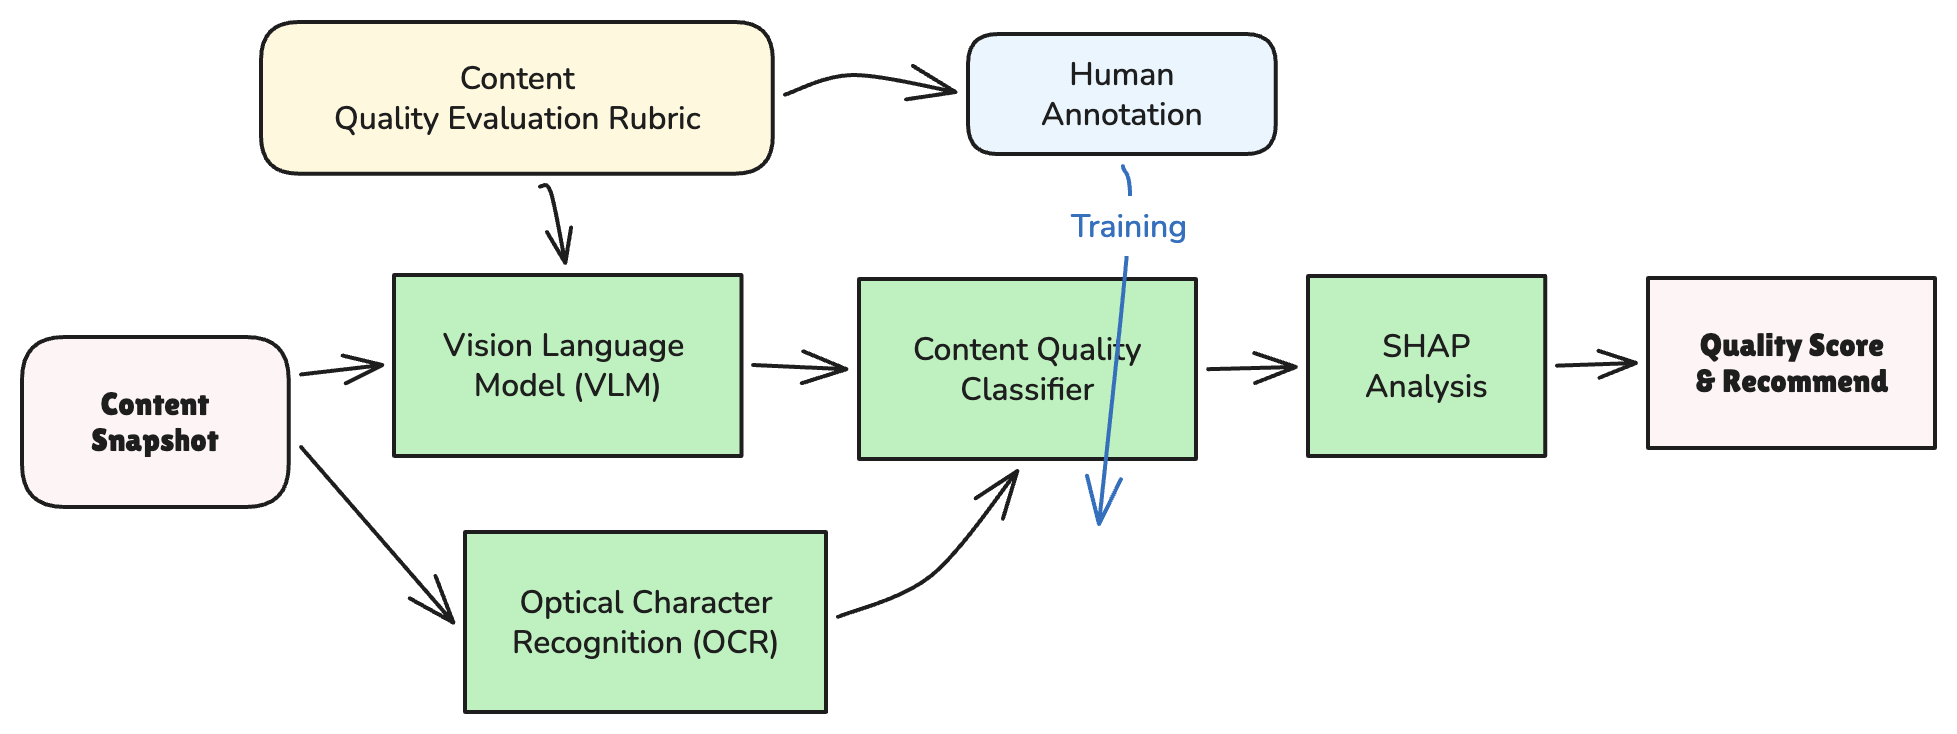
Como se muestra en la Figura 1, abordamos estas consideraciones a través de una arquitectura de fusión de modelos múltiples basada en VLM diseñada alrededor de la adaptabilidad, el rendimiento y la explicabilidad. Las siguientes secciones describen cada componente.
Figura 1: Diagrama de bloques del enfoque de fusión de modelos múltiples basado en VLM, que incluye modelos VLM, OCR y clasificador
Evaluación de contenido de VLM adaptativa con anotaciones de expertos
Un VLM preentrenado con una rúbrica puntuación de contenido de su conocimiento general, y esas puntuaciones no siempre coinciden con los estándares de calidad de ecommerce. La fine-tuning del VLM para cerrar esa brecha requeriría infraestructura de entrenamiento de GPU y, con solo unos pocos miles de ejemplos etiquetados, conlleva un riesgo real de sobreajuste. En su lugar, mantenemos el VLM y la rúbrica de prompt fijos, usamos las salidas estructuradas del VLM como características y entrenamos un clasificador CatBoost en ellas para predecir etiquetas de calidad de expertos. CatBoost, una biblioteca de árboles de decisión de impulso de gradiente, funciona bien en conjuntos de datos tabulares pequeños como este. Como solo el clasificador se vuelve a entrenar, actualizar el sistema a medida que se acumulan anotaciones o cambian los criterios lleva un trabajo de CPU corto en lugar de una carrera de fine-tuning de modelo de base.
El VLM recibe la instantánea de la página y una rúbrica de prompt que cubre cuatro dimensiones de calidad: Narrativa visual, Presentación de características, Diseño A+ y Optimización de conversión. Cada dimensión tiene criterios explícitos y reglas de deducción de puntos. Para cada dimensión, el VLM devuelve una puntuación de 0 a 10, un valor de confianza y una justificación en lenguaje natural. Por ejemplo, reduce la puntuación y explica por qué cuando una página carece de módulos diversos o imágenes de estilo de vida, o repite información. Las puntuaciones y los valores de confianza se convierten en características del clasificador, y las justificaciones ayudan a los socios de ventas a entender el resultado.
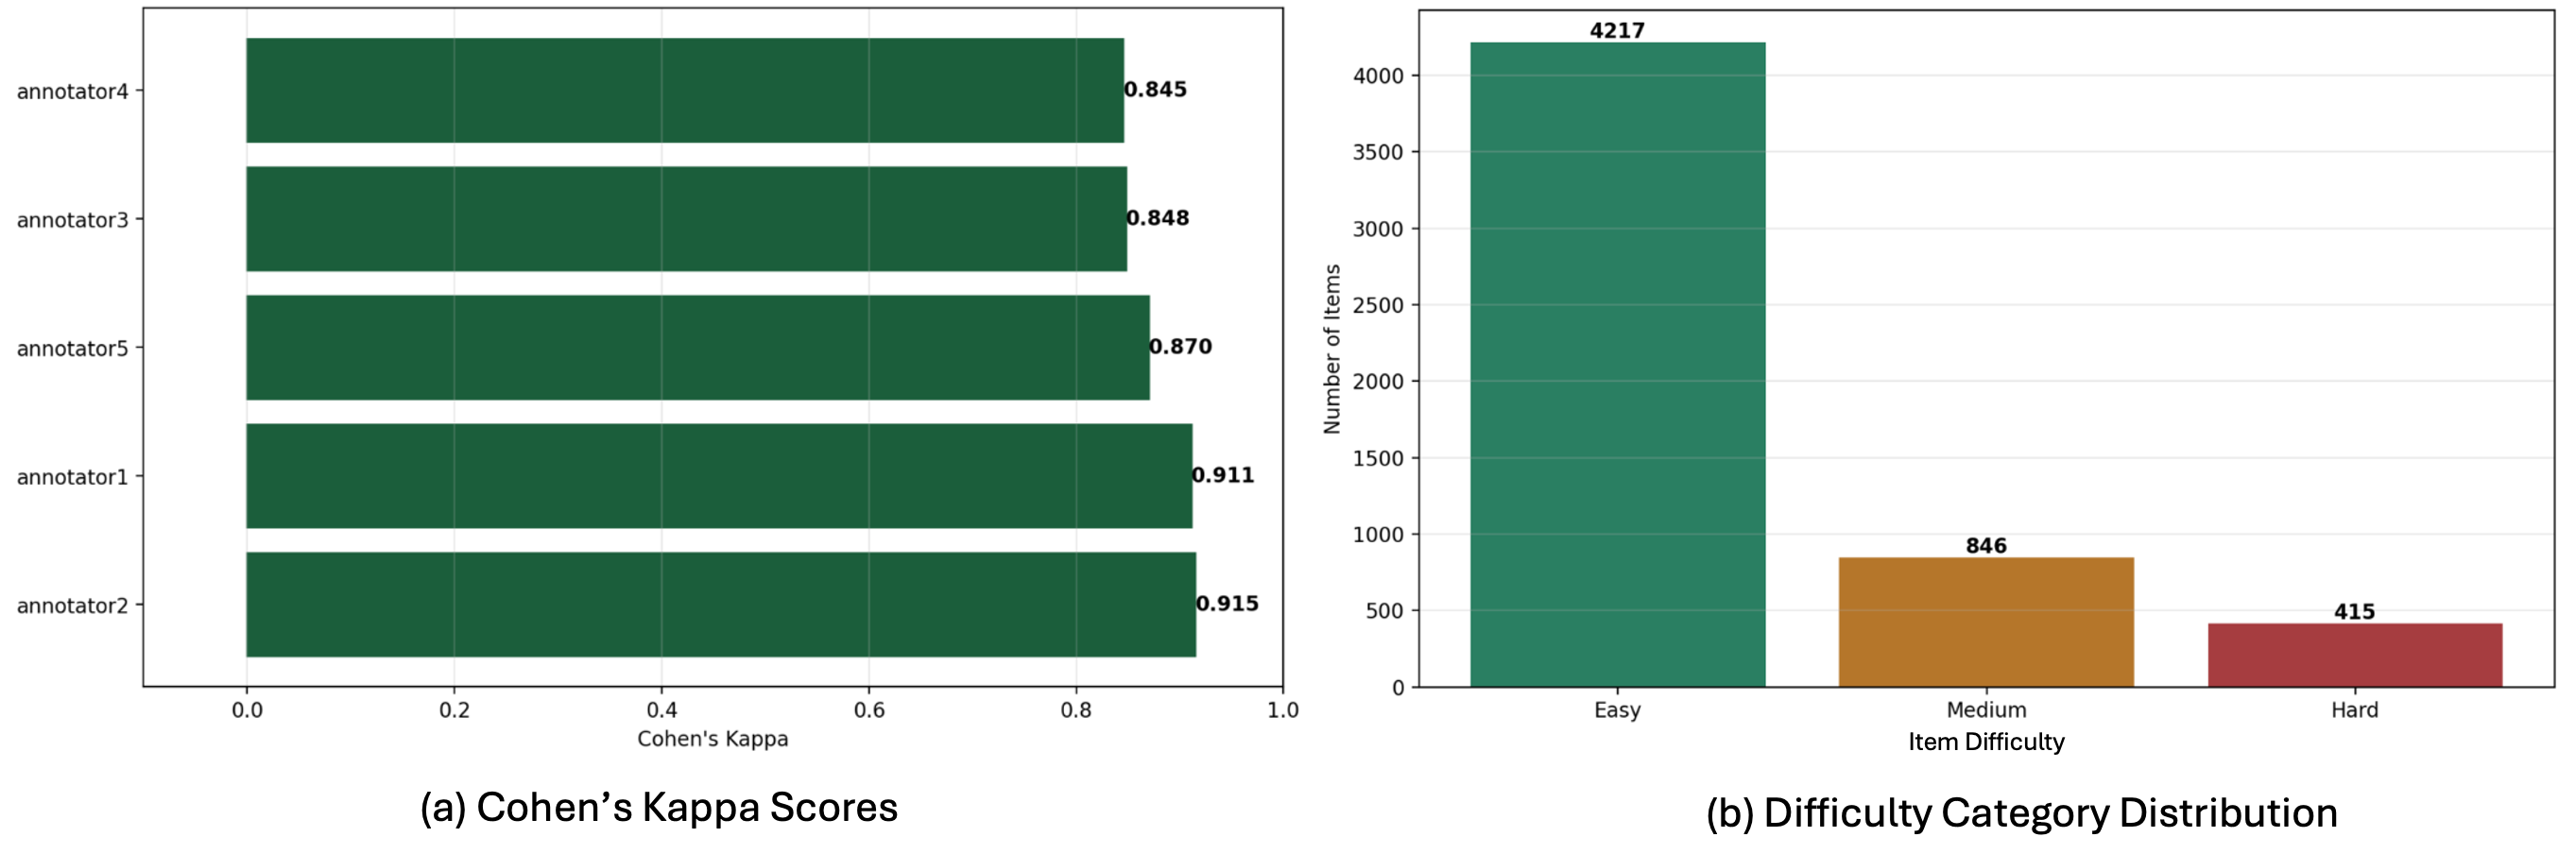
Para construir las etiquetas de entrenamiento, un experto en marketing de ecommerce y cuatro anotadores profesionales calificaron de forma independiente 5,478 páginas de detalles de productos de 10 categorías de productos como de alta o baja calidad, utilizando los mismos criterios. Evaluamos sus calificaciones y tomamos el voto de la mayoría para crear una etiqueta de consenso. Las clases están casi equilibradas (49.6 por ciento de alta calidad), por lo que un clasificador no puede obtener una buena puntuación prediciendo la clase de la mayoría. Para medir la confiabilidad de la etiqueta, usamos el kappa de Cohen, que mide con qué frecuencia dos calificadores están de acuerdo después de tener en cuenta el acuerdo que alcanzarían por casualidad. Una puntuación de 0 significa que el acuerdo no es mejor que el azar, 1 significa un acuerdo perfecto, y los valores superiores a 0.8 suelen considerarse fuertes. Cada anotador obtuvo una puntuación entre 0.845 y 0.915 cuando se comparó con la etiqueta de consenso.
Figura 2: Rendimiento del annotator y distribución de la dificultad del contenido. La división casi equitativa de las clases descarta el sesgo de la clase mayoritaria (izquierda), y la distribución de la dificultad explica el desacuerdo residual (derecha)
Comparamos el clasificador con una línea de base en un conjunto de retención del 20 por ciento (alrededor de 1,100 páginas). La línea de base promedia las cuatro puntuaciones de VLM y aplica un umbral fijo, por lo que cada dimensión cuenta igual. La línea de base alcanzó una precisión de 0,80 y una puntuación F1 de 0,84 en la clase de alta calidad. El clasificador CatBoost, entrenado en las mismas puntuaciones, alcanzó una precisión de 0,89 y una puntuación F1 de 0,90. Debido a que el clasificador aprende cuánto importa cada dimensión y cómo interactúan las dimensiones, sus predicciones coinciden más estrechamente con las decisiones de los expertos.
Evaluación de contenido de VLM de alto rendimiento con OCR
Los VLM capturan bien el significado general y la composición visual de una página, pero son menos confiables en cuestiones de legibilidad de granularidad fina, como cuán congestionado está el texto o cuánto espacio separa las líneas. Debido a su fundamento en el modelo de lenguaje, también pueden favorecer descripciones largas y detalladas incluso cuando los clientes prefieren texto conciso que puedan escanear rápidamente. En una página con mucho texto, un VLM podría calificar la información del producto densa como útil mientras los clientes luchan por leer oraciones largas empaquetadas en un área pequeña. Para capturar estos problemas, usamos un modelo de reconocimiento óptico de caracteres (OCR) alojado en SageMaker AI Inference para extraer cada bloque de texto y su posición, y luego calcular cuatro señales cuantitativas: Densidad de texto, Densidad de caracteres, Espaciado y Legibilidad general. Combinar estas puntuaciones de OCR con la evaluación semántica y visual de VLM agrega información complementaria que mejora la clasificación de calidad.
A partir de esa salida, calculamos cuatro puntuaciones de legibilidad:
Densidad de texto: La proporción del área de la página cubierta por texto.
Densidad de caracteres: La cantidad de caracteres por unidad de área de la página.
Espaciado: Cuán consistente y suficiente es el espacio en blanco entre palabras, líneas y párrafos.
Legibilidad general: Una señal combinada de las tres puntuaciones anteriores.
Como estas puntuaciones dependen del diseño en lugar de la redacción, dos páginas con texto idéntico pueden obtener puntuaciones diferentes.
El modelo de fusión combina las cuatro puntuaciones de la rúbrica VLM y las cuatro puntuaciones OCR en ocho características y entrena un clasificador CatBoost en las mismas etiquetas de expertos. La Tabla 1 lo compara con modelos entrenados en cada conjunto de características por separado, utilizando el mismo conjunto de retención del 20 por ciento.
En el mismo conjunto de retención del 20 por ciento, el modelo CatBoost que solo utiliza características OCR alcanzó una precisión de 0,82 y una puntuación F1 de 0,83, mientras que el modelo que solo utiliza características VLM alcanzó 0,89 y 0,90. El modelo fusionado OCR-VLM-CatBoost superó a ambos modelos independientes, alcanzando una precisión de 0,94 y una puntuación F1 de 0,95. La mejora de 0,05 en ambas métricas sobre el modelo solo VLM demuestra que OCR no es una señal de reemplazo. Complementa el juicio holístico de VLM con información de legibilidad de texto de grano fino.
Configuración
Precisión
Puntuación F1
Línea de base (puntuaciones VLM promediadas + umbral)
0,80
0,84
CatBoost solo OCR
0,82
0,83
CatBoost solo VLM
0,89
0,90
CatBoost fusionado OCR-VLM
0,94
0,95
Evaluación explicable de contenido VLM con SHAP
Una etiqueta de calidad sola no le dice a los socios de venta qué arreglar primero. Para encontrar qué dimensiones impulsaron cada decisión, utilizamos SHapley Additive exPlanations (SHAP), que asigna a cada característica un valor que muestra cuánto empujó una predicción hacia alta o baja calidad. Dado que las puntuaciones VLM y OCR alimentan el mismo clasificador, SHAP mide ambas en una escala común. Las puntuaciones crudas no pueden hacer esto: una puntuación de Narración Visual de 6 y una alta Densidad de Caracteres no le dicen cuál fue más importante para la decisión.
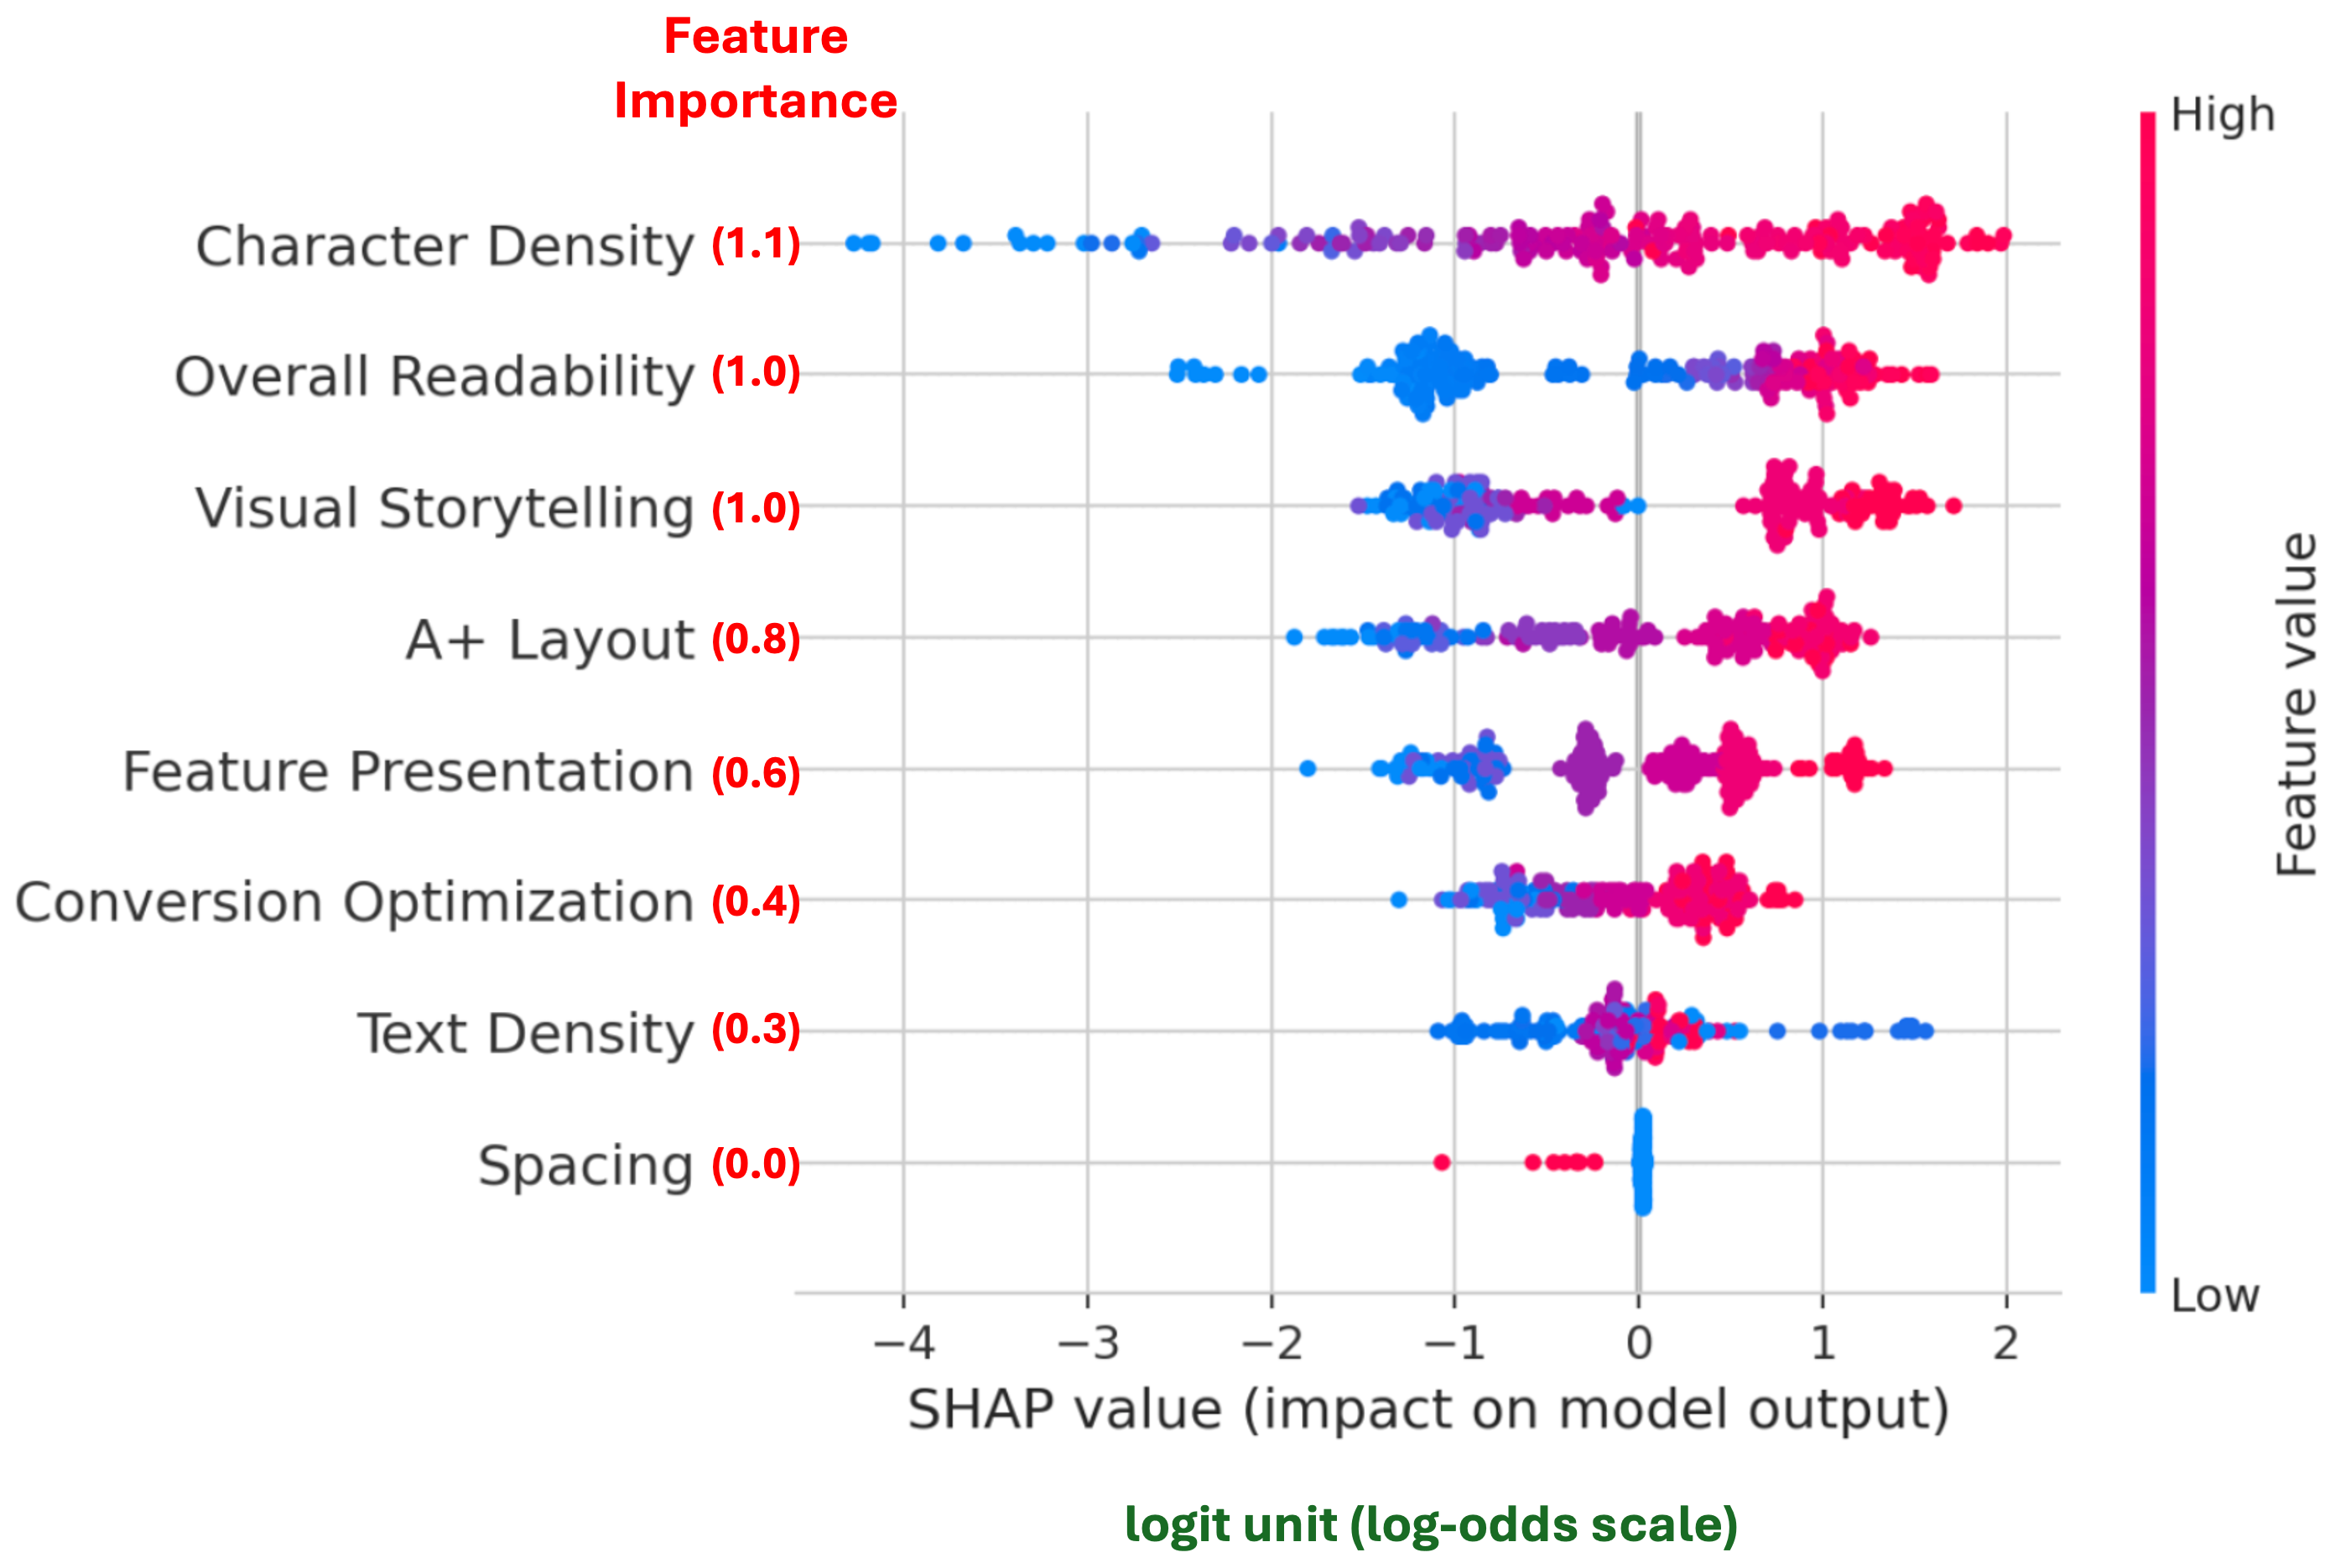
En todo el conjunto de retención, las características más influyentes fueron la Densidad de Caracteres OCR (valor absoluto de SHAP medio 1,1), la Legibilidad General OCR (1,0) y la Narración Visual VLM (1,0). Les siguieron el Diseño A+ (0,8), la Presentación de Características (0,6) y la Optimización de Conversión (0,4). Tanto las características OCR como VLM se encuentran cerca de la parte superior, por lo que el clasificador depende de ambas fuentes.
Figura 3: Distribuciones de valores SHAP globales para todas las características VLM y OCR
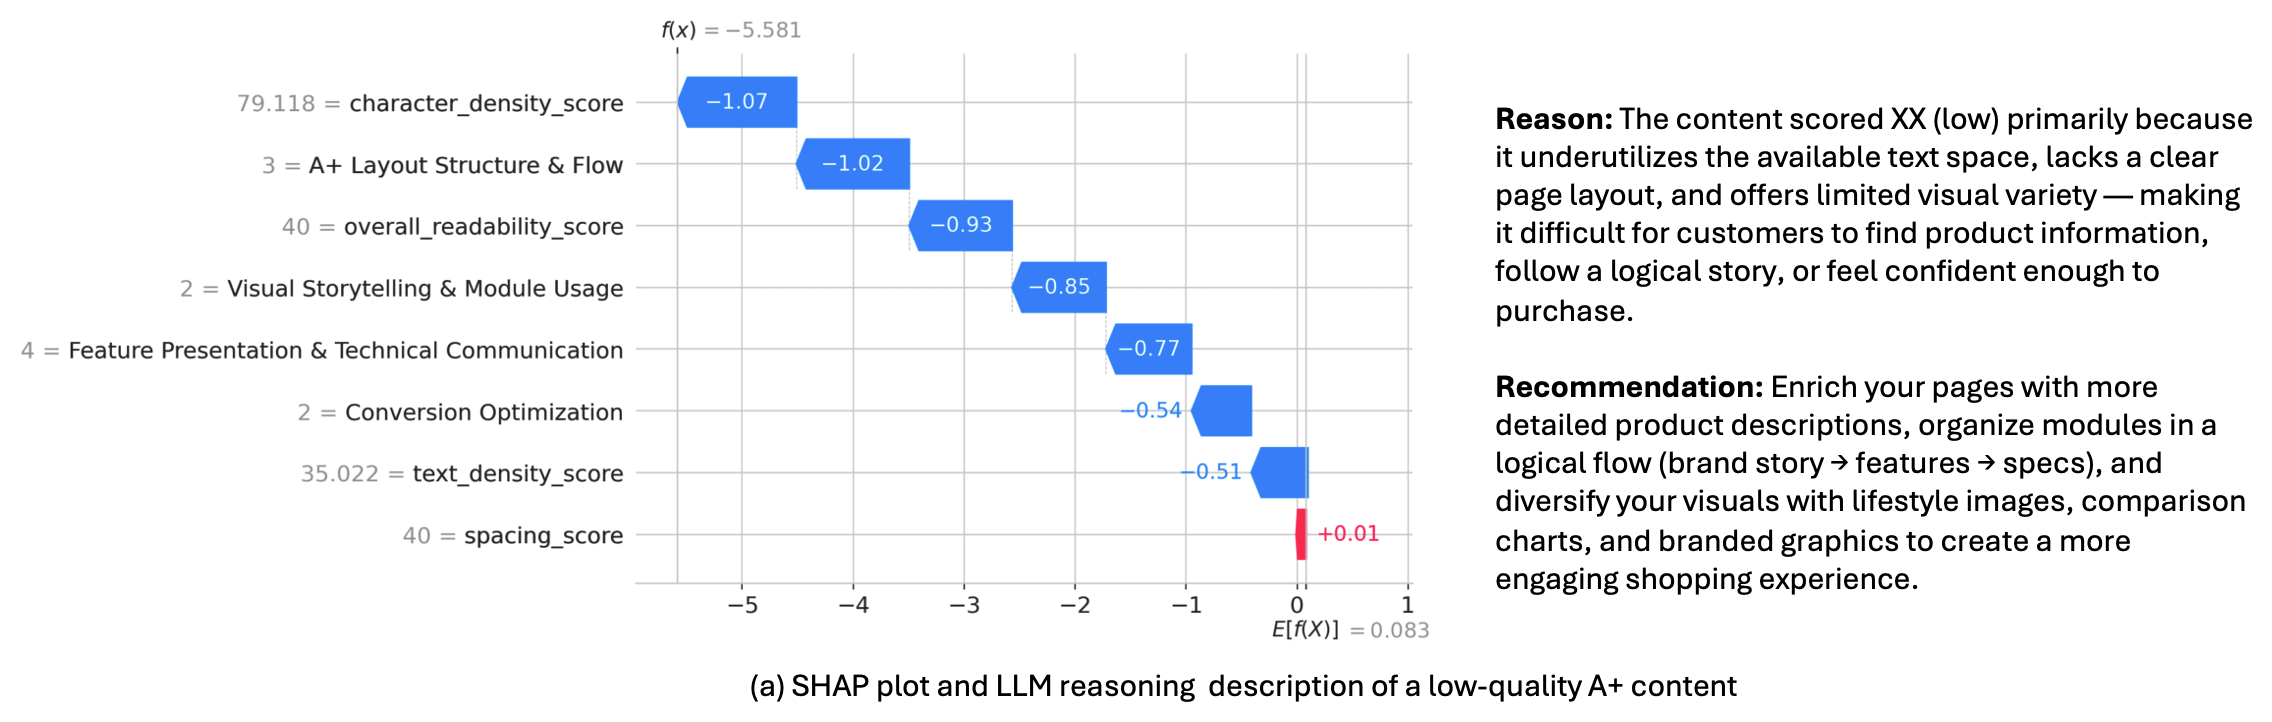
Para una página individual, SHAP muestra qué características redujeron la decisión. Para cada página clasificada como de baja calidad, clasificamos las ocho características por valor SHAP, luego pasamos las características más negativas, la categoría de producto y las mejores prácticas de ecommerce, junto con las razones de la VLM, a un LLM, que las convierte en acciones específicas y priorizadas.
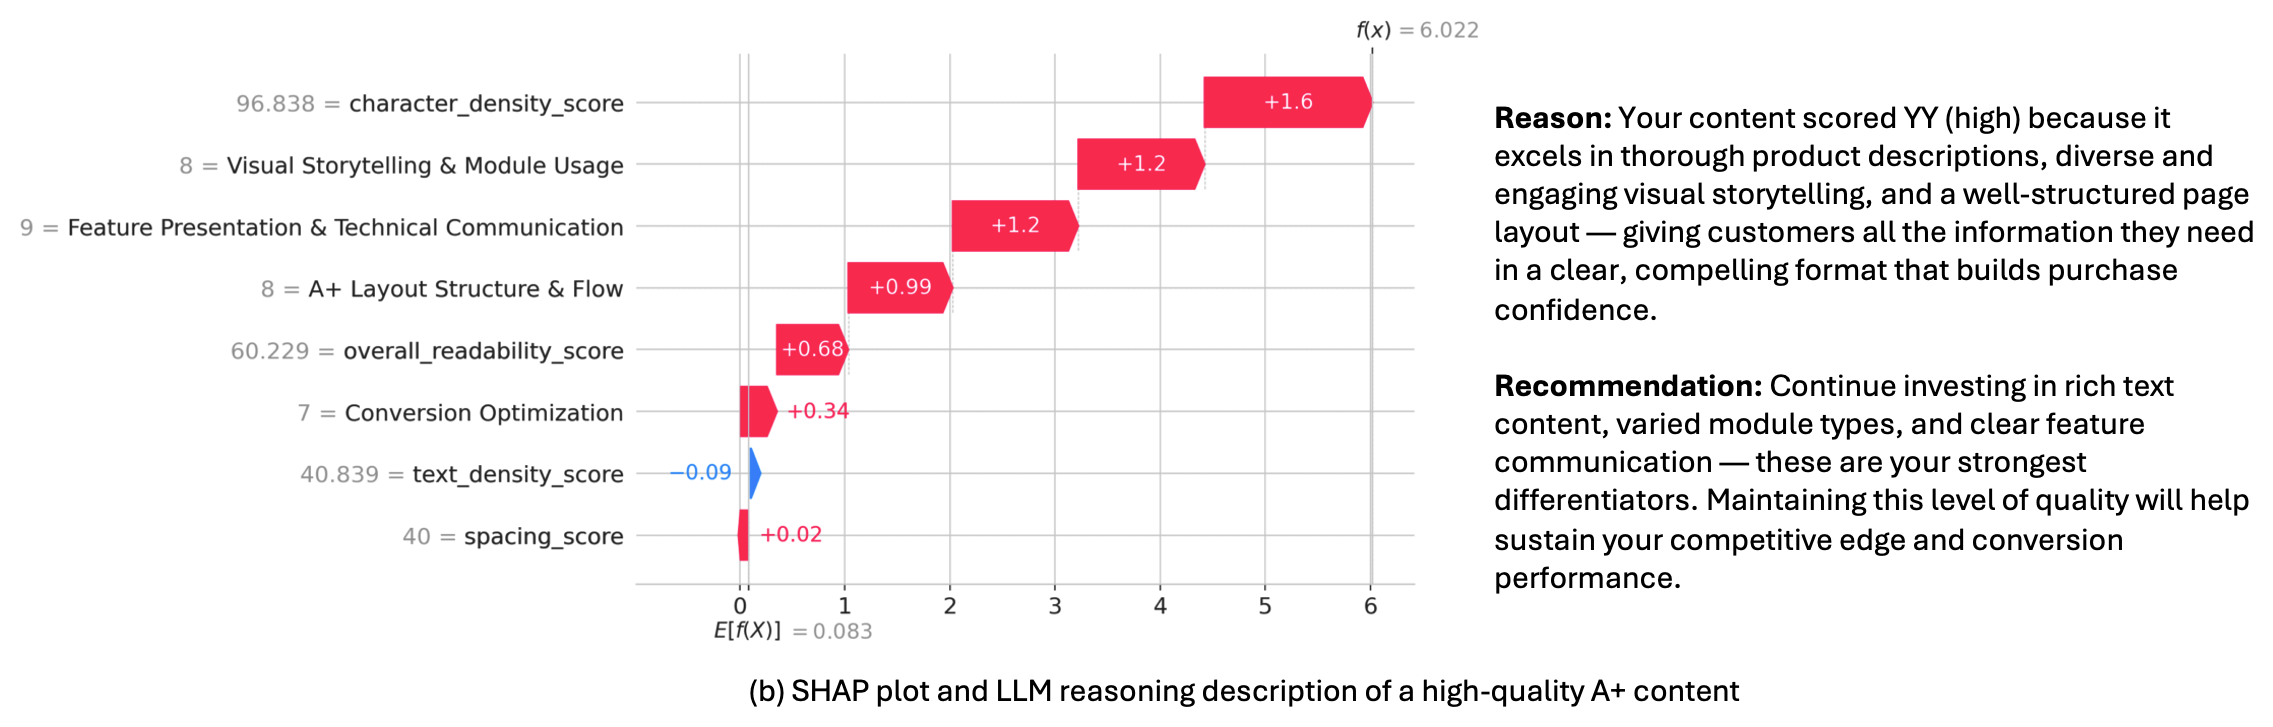
La Figura 4 muestra dos tramas de SHAP locales con la razón del LLM basada en los resultados de SHAP, para una muestra de contenido A+ de baja calidad y una de alta calidad. Por ejemplo, si el diseño A+ tiene un valor SHAP de -1,2 y la narración visual tiene -0,3, el sistema prioriza la reestructuración del diseño y el rebalanceo de texto e imágenes, seguido de mejoras en la imagen.
Figura 4: Dos distribuciones de valores de SHAP locales para todas las características de VLM y OCR: (a) un caso de baja calidad, donde la mayoría de las características contribuyen negativamente y impulsan una recomendación de mejora solicitada; (b) un caso de alta calidad, donde la mayoría de las características contribuyen positivamente
Validamos la efectividad de estas recomendaciones basadas en explicaciones midiendo las puntuaciones de calidad después de que los socios de ventas revisaron su contenido. La puntuación de calidad promedio después de la revisión aumentó en 1,4 puntos en una escala de 10 puntos en una muestra estadísticamente significativa. Las contribuciones de SHAP pueden traducirse, por lo tanto, de explicaciones de decisiones a prioridades y métodos de mejora accionables. La explicabilidad no es, por lo tanto, solo una capacidad auxiliar para comprender el modelo, sino que funciona como un mecanismo de retroalimentación que mejora materialmente la calidad del contenido.
Resultados
El sistema completo califica cada instantánea de página con VLM y OCR, combina las cuatro puntuaciones de VLM y las cuatro puntuaciones de OCR en un solo vector de características y lo pasa a un clasificador CatBoost entrenado con etiquetas de expertos. Luego, SHAP identifica qué características impulsaron cada decisión. Para medir qué agrega cada componente, comparamos cuatro configuraciones en el mismo conjunto de retención del 20%. El conjunto de retención proviene de 5,478 páginas de detalles de productos en 10 categorías de productos, incluyendo Muebles, Zapatos, Alimentos, Belleza y Ropa.
La línea de base promedia las cuatro puntuaciones de VLM y aplica un umbral fijo, por lo que cada dimensión cuenta igual. Alcanzó una precisión de 0.80 y una puntuación F1 de 0.84. Entrenar un clasificador CatBoost en las mismas puntuaciones permite que el modelo aprenda qué dimensiones son más importantes y cómo interactúan, lo que aumentó la precisión a 0.89 y la puntuación F1 a 0.90. Un clasificador entrenado solo en las puntuaciones de OCR alcanzó una precisión de 0.82 y una puntuación F1 de 0.83. Combinar las puntuaciones de VLM y OCR dio los mejores resultados, con una precisión de 0.94 y una puntuación F1 de 0.95. Eso es 14 puntos porcentuales de precisión más alta y 11 puntos más altos de F1 que la línea de base.
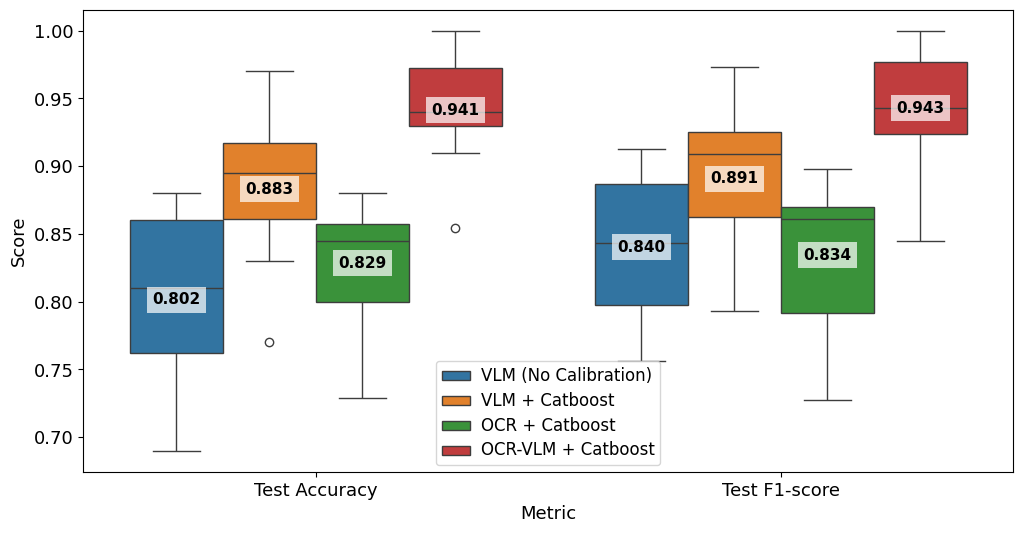
Figura 5: Comparación de precisión y F1 en las configuraciones de evaluación de VLM y OCR
Examinar cada ganancia de rendimiento por separado aclara el valor del enfoque integrado. La calibración de CatBoost reduce primero las limitaciones de un umbral fijo al aprender pesos y límites de decisión no lineales específicos de la dimensión. Luego, agregar características de OCR suministra señales de legibilidad de texto que VLM puede pasar por alto. En general, el modelo de fusión final mejora la precisión en 0.14 y la puntuación F1 en 0.11 con respecto a la línea de base.
También cambiamos el backbone de VLM en un experimento adicional en un conjunto de datos de una sola categoría que contiene 499 proyectos de contenido. Con una variante de VLM más ligera, la línea de base alcanzó una precisión de 0.74 y una puntuación F1 de 0.72, mientras que el modelo OCR-VLM-CatBoost alcanzó 0.90 para ambas métricas. Con una variante de VLM más capaz, la línea de base alcanzó una precisión de 0.79 y una puntuación F1 de 0.84, mientras que el modelo de fusión alcanzó 0.94 y 0.95. El enfoque de fusión mejoró la precisión en 0.16 y 0.15 para los dos VLM, respectivamente, demostrando que las características de OCR complementarias entregan ganancias consistentes sin depender de un modelo de base en particular.
Para reducir los costos de desarrollo y mantener el acceso a modelos base de alto rendimiento, el sistema congela el VLM y entrena solo el clasificador de bajo overhead. En producción, un experimento A/B a nivel mundial que ajustó la visibilidad del contenido A+ de baja calidad según las decisiones de calidad del modelo produjo una mejora estadísticamente significativa en las Ventas de Productos Ordenados (OPS). Más allá de alinearse estrechamente con el juicio de expertos, el sistema integrado proporciona una señal de calidad que puede respaldar las decisiones de experiencia del cliente y empresariales a gran escala.
Implementación en Amazon SageMaker AI
Figura 6: Arquitectura del sistema de calidad de contenido en Amazon SageMaker AI
1. Renderización de instantánea de contenido e ingesta de datos: Se renderiza la experiencia completa de contenido A+, capturando cómo los clientes ven realmente la página.
Trabajos de procesamiento de SageMaker ejecutan trabajos de renderización contenerizados a gran escala, desacoplando la preparación de datos del entrenamiento y la inferencia de cómputo.
2. Puntuación del VLM y alojamiento del modelo: Los anotadores etiquetan de forma independiente el contenido utilizando la rúbrica de calidad. Sus etiquetas de consenso agregadas se convierten en los objetivos de entrenamiento. El VLM congelado recibe cada instantánea más un prompt de rúbrica y produce cuatro puntuaciones del 0 al 10 (Narración visual, Presentación de características, Diseño A+, Optimización de conversión), cada una con un valor de confianza y justificación. SageMaker AI Inference aloja el VLM con la opción de implementación que se adapta a la carga de trabajo:
Puntos de conexión en tiempo real para puntuación sincrónica y baja latencia de listados individuales.
Puntos de conexión asíncronos para cargas grandes, como instantáneas de alta resolución, donde se acepta un ligero retraso.
Transformación por lotes para puntuación por lotes sin conexión a escala de catálogo.
Estas opciones admiten escalado automático, infraestructura administrada y selección de instancias de GPU.
Trabajos de entrenamiento de SageMaker se pueden utilizar opcionalmente para ajustar o destilar aún más el VLM (por ejemplo, adaptadores de adaptación de baja rango (LoRA), destilación de conocimientos en un modelo más pequeño) si los equipos desean una variante especializada con menor latencia. Evite esto para mantener el costo de recalibración rentable y agnóstico de VLM.
3. Extracción de legibilidad de OCR: En paralelo, OCR extrae texto y posiciones de cuadros delimitadores de cada instantánea y calcula cuatro señales de legibilidad: densidad de texto, densidad de caracteres, espaciado y legibilidad general.
SageMaker JumpStart proporciona modelos preentrenados y desplegables de una sola acción desde su centro de modelos, evitando la necesidad de buscar, empaquetar y evaluar modelos desde cero. Los equipos seleccionan un modelo, lo ajustan opcionalmente sin administrar la infraestructura utilizando Personalización de modelo sin servidor de SageMaker en contenido de comercio electrónico, y lo despliegan directamente. Inferencia de IA de SageMaker luego hospeda el modelo de OCR seleccionado como un punto de conexión.
4. Agregación y almacenamiento de características:
Almacén de características de SageMaker proporciona acceso en línea (inferencia de baja latencia) y fuera de línea (entrenamiento por lotes) a las mismas características, evitando la inclinación de entrenamiento-servicio. Los equipos pueden compartir características en toda la organización, para que los consumidores downstream puedan reutilizar las mismas características curadas.
5. Entrenamiento de clasificador: Un clasificador CatBoost se entrena en el vector de características de ocho dimensiones contra anotaciones de expertos para aprender pesos de dimensiones no uniformes y límites de decisión no lineales. Trabajos de entrenamiento de SageMaker se pueden utilizar aquí nuevamente. Puede registrar modelos entrenados directamente en el Registro de modelos de SageMaker para control de versiones, flujos de trabajo de aprobación y despliegue de producción.
7. Monitoreo de producción y re-entrenamiento: En producción, los modelos de ML se degradan naturalmente con el tiempo. Las estéticas de los clientes cambian, se lanzan nuevos tipos de módulos A+, las categorías de productos evolucionan y el comportamiento de los vendedores cambia. Los patrones de puntuación que el clasificador aprendió de las anotaciones históricas se desalinean gradualmente con lo que significa la calidad hoy en día, lo que lleva a una erosión silenciosa de la precisión si no se controla. La monitorización continua cierra esta brecha detectando cuándo la distribución de datos en vivo o las predicciones del modelo se han desviado lo suficiente de la línea de base de entrenamiento como para justificar una recalibración.
SageMaker AI ModelOps proporciona una colección de ejemplos y recursos para ayudarlo a operacionalizar las cargas de trabajo de inteligencia artificial generativa y aprendizaje automático en SageMaker AI.
SageMaker AIOps proporciona la herramienta para rastrear la calidad de los datos, la calidad del modelo y el desplazamiento de la atribución de características. SageMaker Pipelines también automatiza el flujo de trabajo de re-entrenamiento de extremo a extremo cuando se superan los umbrales de desplazamiento.
8. Generación de contenido basada en difusión: Cerrando el ciclo, las puntuaciones de calidad y las recomendaciones derivadas de SHAP condicionan un modelo de difusión que genera activos de imagen A+ mejorados. En lugar de dejar que los vendedores interpreten las recomendaciones y creen nuevo contenido desde cero, el sistema produce activos visuales listos para usar (imágenes de estilo de vida mejoradas, diseños reequilibrados o tomas de producto mejoradas) que abordan directamente las dimensiones que SHAP señaló como las que contribuyen más negativamente. Estos activos generados y las sugerencias de mejora de lenguaje natural se presentan a los vendedores, para que puedan mejorar sus listados en amazon.com.
Conclusión
En esta publicación, mostramos cómo evaluar las páginas de detalles de productos como los ven los clientes al renderizar cada página como una sola instantánea y puntuarla con un VLM. También pasamos por la implementación del sistema en Amazon SageMaker AI. Construimos el sistema alrededor de tres objetivos. Para la adaptabilidad, mantenemos el VLM fijo y entrenamos un clasificador CatBoost en sus puntuaciones de rubric, para que el sistema coincida con el juicio experto y pueda actualizarse con un trabajo de solo CPU. Para el rendimiento, agregamos puntuaciones de legibilidad OCR que capturan el texto denso o mal espaciado que el VLM pasa por alto. Para la explicabilidad, SHAP identifica qué características impulsaron cada decisión, y un LLM convierte esos resultados en recomendaciones prioritarias para los socios de ventas.
En 5,478 páginas de detalles de productos de 10 categorías de productos, el modelo fusionado alcanzó una precisión de 0.94 y una puntuación F1 de 0.95, 14 y 11 puntos porcentuales por encima de la línea de base de puntuación promedio. Las páginas revisadas utilizando las recomendaciones mejoraron su puntuación de calidad en un promedio de 1.4 puntos en una escala de 10.
Los estándares de calidad de contenido difieren en las categorías de productos, idiomas y mercados, y nuestras anotaciones de expertos no pueden representar completamente cada contexto. A continuación, planeamos evaluar esqueletos de VLM más eficientes y métodos de inferencia para ejecutar el sistema en un catálogo global.
Sobre los autores
A+ Content is the rich media widget on the Amazon product detail page. Through visual assets, brands communicate unique product and brand value to help customers make informed purchase decisions. Selling partners using high-quality A+ Content boost their sales by 8–20 percent compared to those without it. A wide variety of brands, from established brands with large in-house design teams to bootstrapped brands with limited resources, use A+ Content, creating inconsistency in content quality. A typical A+ Content project combines text, images, and video into a cohesive product story. Evaluating each asset in isolation misses the quality that emerges from how those assets work together. When your content spans multiple heterogeneous modules and you need a holistic quality signal rather than per-asset checks, the multi-model fusion approach described in this post can help. In this post, we examine this problem in the context of A+ Content.
A+ Content provides creative freedom for selling partners to express their authentic selves on their product detail pages, without strict content specifications such as image ratio and text word count.
Although this flexibility allows compelling brand storytelling, it also creates substantial variation in content composition and quality.
With quality evaluation and improvement recommendations, brands can transform average content into high-quality content that is more coherent, relevant, and useful. This improved content helps customers make more informed purchasing decisions and build lasting relationships with brands, leading to improved revenue for selling partners.
To achieve this goal, an evaluation system must assess the complete content experience, provide actionable recommendations beyond numeric scores, and reflect the nuances across product categories. Existing approaches struggle to meet all these requirements simultaneously, so in this post, you will see a new approach using Vision-Language Models (VLMs) to understand and evaluate content holistically, and a diffusion-based generation component that produces improved visual assets from the resulting quality signals.
In this post, you will learn how to:
Render complete ecommerce content as a single snapshot and evaluate it holistically with a VLM.
Combine VLM semantic scores with OCR readability signals in a lightweight CatBoost classifier trained on expert annotations.
Use SHAP to explain quality decisions and generate actionable improvement recommendations for selling partners.
Implement the end-to-end pipeline on Amazon SageMaker AI, from data ingestion and annotation through model hosting, explainability, and production monitoring.
Opportunities and challenges in VLM-based evaluation
A vision language model (VLM) pairs an image encoder with a large language model (LLM). The encoder, often a vision transformer (ViT), splits an image into patches and turns them into embeddings, and a small connector maps those embeddings into the language model’s input space (Flamingo, LLaVA). Many VLMs reuse the image encoder from CLIP, which learned to match images with their captions. Because VLMs are trained to follow instructions, you can give one an image along with a rubric of evaluation criteria and get back a written assessment without task-specific training. When you need closer agreement with human reviewers, you can fine-tune the model on labeled examples. This makes VLMs a practical starting point for checking product images against your content guidelines at scale.
Conventional computer vision models can already score individual assets, for example flagging a blurry image or a grammar error in a bullet list. Using a VLM to grade each asset separately adds little beyond that. A product detail page, however, combines images, text, and layout modules into a single story, and its quality depends on how those pieces work together. Our approach renders the full page as a single snapshot and asks the VLM to evaluate it as customers see it.
Consider a blender page with a hero image, a bulleted feature list highlighting blade speed and capacity, and a lifestyle photo of the blender in a modern kitchen. Checked one by one, each asset passes: the image is sharp, the bullets are grammatical, and the photo is well lit. Viewed together, problems appear. The bullets might advertise a 64-oz pitcher while the lifestyle photo shows a single-serve model, or the lifestyle photo might sit above the hero image so customers see the kitchen before the product. Because an asset’s meaning depends on where it appears and what surrounds it, these issues only show up when the page is evaluated as a whole. The snapshot gives the VLM that complete view. Using it in production adds three requirements: scores must match expert quality standards, evaluation must be accurate and efficient at scale, and each result must explain what to fix.
As shown in Figure 1, we address these considerations through a VLM-based multi-model fusion architecture designed around adaptability, performance, and explainability. The following sections describe each component.
Figure 1: Block diagram of the VLM-based multi-model fusion approach, including VLM, OCR, and classifier models
Adaptive VLM content evaluation with expert annotations
A pretrained VLM prompted with a rubric scores content from its general knowledge, and those scores don’t always match ecommerce quality standards. Fine-tuning the VLM to close that gap would require GPU training infrastructure and, with only a few thousand labeled examples, carries a real risk of overfitting. Instead, we keep the VLM and rubric prompt fixed, use the VLM’s structured outputs as features, and train a CatBoost classifier on them to predict expert quality labels. CatBoost, a gradient-boosted decision tree library, performs well on small tabular datasets like this one. Because only the classifier is retrained, updating the system as annotations accumulate or criteria change takes a short CPU-only job rather than a foundation model fine-tuning run.
The VLM receives the page snapshot and a rubric prompt covering four quality dimensions: Visual Storytelling, Feature Presentation, A+ Layout, and Conversion Optimization. Each dimension has explicit criteria and point-deduction rules. For each dimension, the VLM returns a score from 0 to 10, a confidence value, and a natural-language rationale. For example, it lowers the score and explains why when a page lacks diverse modules or lifestyle imagery, or repeats information. The scores and confidence values become the classifier’s features, and the rationales help selling partners understand the result.
To build the training labels, one ecommerce marketing expert and four professional annotators independently rated 5,478 product detail pages from 10 product categories as high or low quality, using the same criteria. We assessed their ratings and took the majority vote to create a consensus label. The classes are nearly balanced (49.6 percent high quality), so a classifier can’t score well by predicting the majority class. To measure label reliability, we used Cohen’s kappa, which measures how often two raters agree after accounting for the agreement they would reach by chance. A score of 0 means agreement is no better than chance, 1 means perfect agreement, and values above 0.8 are generally considered strong. Each annotator scored between 0.845 and 0.915 when compared against the consensus label.
Figure 2: Annotator performance and content difficulty distribution. The near-even class split rules out majority-class bias (left), and the difficulty distribution explains the residual disagreement (right)
We compared the classifier with a baseline on a 20 percent holdout set (about 1,100 pages). The baseline averages the four VLM scores and applies a fixed threshold, so every dimension counts equally. The baseline reached 0.80 accuracy and an F1 score of 0.84 on the high-quality class. The CatBoost classifier, trained on the same scores, reached 0.89 accuracy and an F1 score of 0.90. Because the classifier learns how much each dimension matters and how the dimensions interact, its predictions match expert decisions more closely.
High-performance VLM content evaluation with OCR
VLMs capture the overall meaning and visual composition of a page well, but they are less reliable at fine-grained readability issues, such as how crowded the text is or how much space separates lines. Because of their language-model foundation, they can also favor long, detailed descriptions even when customers prefer concise text they can scan quickly. On a text-heavy page, a VLM might rate dense product information as helpful while customers struggle to read long sentences packed into a small area. To capture these issues, we use an optical character recognition (OCR) model hosted on SageMaker AI Inference to extract each block of text and its position, then calculate four quantitative signals: Text Density, Character Density, Spacing, and Overall Readability. Combining these OCR scores with the VLM’s semantic and visual assessment adds complementary information that improves quality classification.
From that output, we calculate four readability scores:
Text Density: The share of the page area covered by text.
Character Density: The number of characters per unit of page area.
Spacing: How consistent and sufficient the whitespace is between words, lines, and paragraphs.
Overall Readability: A combined signal from the three preceding scores.
Because these scores depend on layout rather than wording, two pages with identical text can score differently.
The fusion model combines the four VLM rubric scores and the four OCR scores into eight features and trains a CatBoost classifier on the same expert labels. Table 1 compares it with models trained on each feature set alone, using the same 20 percent holdout set.
On the same 20 percent holdout set, the CatBoost model using only OCR features achieved 0.82 accuracy and a 0.83 F1 score, while the model using only VLM features achieved 0.89 and 0.90. The fused OCR-VLM-CatBoost model outperformed both standalone models, reaching 0.94 accuracy and a 0.95 F1 score. The 0.05 improvement in both metrics over the VLM-only model demonstrates that OCR isn’t a replacement signal. It complements the VLM’s holistic judgment with fine-grained text-readability information.
Configuration
Accuracy
F1 Score
Baseline (averaged VLM scores + threshold)
0.80
0.84
OCR-only CatBoost
0.82
0.83
VLM-only CatBoost
0.89
0.90
Fused OCR-VLM CatBoost
0.94
0.95
Explainable VLM content evaluation with SHAP
A quality label alone doesn’t tell selling partners what to fix first. To find which dimensions drove each decision, we use SHapley Additive exPlanations (SHAP), which assigns each feature a value showing how far it pushed a prediction toward high or low quality. Because the VLM and OCR scores feed the same classifier, SHAP measures both on a common scale. Raw scores can’t do this: a Visual Storytelling score of 6 and a high Character Density don’t tell you which one mattered more to the decision.
Across the holdout set, the most influential features were OCR Character Density (mean absolute SHAP value 1.1), OCR Overall Readability (1.0), and VLM Visual Storytelling (1.0). They were followed by A+ Layout (0.8), Feature Presentation (0.6), and Conversion Optimization (0.4). Both OCR and VLM features rank near the top, so the classifier depends on both sources.
Figure 3: Global SHAP value distributions for all VLM and OCR features
For an individual page, SHAP shows which features lowered the decision. For each page classified as low quality, we rank the eight features by SHAP value, then pass the most negative features, the product category, and ecommerce best practices, along with the VLM’s rationales, to an LLM, which turns them into prioritized, specific actions.
Figure 4 shows two local SHAP plots with the LLM reasoning grounded in the SHAP results, for a low-quality and a high-quality A+ Content sample. For example, if A+ Layout has a SHAP value of -1.2 and Visual Storytelling has -0.3, the system prioritizes restructuring the layout and rebalancing text and images, followed by improvements to the imagery.
Figure 4: Two local SHAP value distributions for all VLM and OCR features: (a) a low-quality case, where most features contribute negatively and drive an improvement-requested recommendation; (b) a high-quality case, where most features contribute positively
We validated the effectiveness of these explanation-based recommendations by measuring quality scores after selling partners revised their content. The average post-revision quality score increased by 1.4 points on a 10-point scale on a statistically significant sample. SHAP contributions can therefore be translated from decision explanations into actionable improvement priorities and methods. Explainability is therefore not merely an auxiliary capability for understanding the model. It functions as a feedback mechanism that materially improves content quality.
Results
The complete system scores each page snapshot with the VLM and OCR, combines the four VLM scores and four OCR scores into a single feature vector, and passes it to a CatBoost classifier trained on expert labels. SHAP then identifies which features drove each decision. To measure what each component adds, we compared four configurations on the same 20 percent holdout set. The holdout set comes from 5,478 product detail pages across 10 product categories, including Furniture, Shoes, Grocery, Beauty, and Apparel.
The baseline averages the four VLM scores and applies a fixed threshold, so every dimension counts equally. It reached 0.80 accuracy and an F1 score of 0.84. Training a CatBoost classifier on the same scores lets the model learn which dimensions matter most and how they interact, which raised accuracy to 0.89 and F1 to 0.90. A classifier trained on the OCR scores alone reached 0.82 accuracy and an F1 score of 0.83. Combining the VLM and OCR scores gave the best results, with 0.94 accuracy and an F1 score of 0.95. That’s 14 percentage points higher accuracy and 11 points higher F1 than the baseline.
Figure 5: Accuracy and F1 comparison across VLM and OCR evaluation configurations
Examining each performance gain separately makes the value of the integrated approach clearer. CatBoost calibration first reduces the limitations of a fixed threshold by learning dimension-specific weights and nonlinear decision boundaries. Adding OCR features then supplies text-readability signals that the VLM can miss. Overall, the final fusion model improves accuracy by 0.14 and F1 by 0.11 over the baseline.
We also changed the VLM backbone in an additional experiment on a single-category dataset containing 499 content projects. With a lighter VLM variant, the baseline achieved 0.74 accuracy and a 0.72 F1 score, while the OCR-VLM-CatBoost model achieved 0.90 for both metrics. With a more capable VLM variant, the baseline achieved 0.79 accuracy and a 0.84 F1 score, while the fusion model achieved 0.94 and 0.95. The fusion approach improved accuracy by 0.16 and 0.15 for the two VLMs, respectively, demonstrating that complementary OCR features deliver consistent gains without depending on a particular foundation model.
To reduce development costs while retaining access to high-performance foundation models, the system freezes the VLM and trains only the low-overhead classifier. In production, a worldwide A/B experiment that adjusted the visibility of low-quality A+ Content based on the model’s quality decisions produced a statistically meaningful improvement in Ordered Product Sales (OPS). Beyond aligning closely with expert judgment, the integrated system provides a quality signal that can support customer-experience and business decisions at scale.
Implementation on Amazon SageMaker AI
This section describes how the architecture is implemented end-to-end on Amazon SageMaker AI. Each stage of the pipeline from content rendering and expert annotation through VLM scoring, OCR extraction, feature aggregation, classifier training, SHAP-based explainability, and production monitoring maps to a managed SageMaker AI capability. This design keeps the operational overhead low. The following steps walk through how each component is deployed, connected, and maintained in production.
Figure 6: Architecture of the content-quality system on Amazon SageMaker AI
1. Content snapshot rendering and data ingestion: The complete A+ Content experience is rendered, capturing how customers actually see the page.
SageMaker Processing Jobs run containerized rendering jobs at scale, decoupling data preparation from training and inference compute.
2. VLM scoring and model hosting: Annotators independently label content using the quality rubric. Their aggregated consensus labels become the training targets. The frozen VLM receives each snapshot plus a rubric prompt and outputs four scores from 0 to 10 (Visual Storytelling, Feature Presentation, A+ Layout, Conversion Optimization), each with a confidence value and rationale. SageMaker AI Inference hosts the VLM with the deployment option that fits the workload:
Real-Time Endpoints for synchronous, low-latency scoring of individual listings.
Asynchronous Endpoints for large payloads such as high-resolution snapshots, where a slight delay is acceptable.
Batch Transform for offline bulk scoring at catalog scale.
These options support automatic scaling, managed infrastructure, and GPU instance selection.
SageMaker Training Jobs can optionally be used to further tune or distill the VLM (for example, Low-Rank Adaptation (LoRA) adapters, knowledge distillation into a smaller model) if teams want a specialized, lower-latency variant. Avoid this to keep recalibration cost-effective and VLM-agnostic.
3. OCR readability extraction: In parallel, OCR extracts text and bounding-box positions from each snapshot and computes four readability signals: Text Density, Character Density, Spacing, and Overall Readability.
SageMaker JumpStart provides pre-trained, single-action deployable models from its model hub, avoiding the need to source, package, and benchmark models from scratch. Teams select a model, optionally fine-tune it without managing infrastructure using SageMaker Serverless Model Customization on ecommerce content, and deploy directly. SageMaker AI Inference then hosts the chosen OCR model as an endpoint.
4. Feature aggregation and storage:
SageMaker Feature Store provides both online (low-latency inference) and offline (batch training) access to the same features, avoiding training-serving skew. Teams can share features across the organization, so downstream consumers can reuse the same curated features.
5. Classifier training: A CatBoost classifier is trained on the eight-dimensional feature vector against expert annotations to learn non-uniform dimension weights and nonlinear decision boundaries. SageMaker Training Jobs can be used here again. You can register trained models directly to SageMaker Model Registry for versioning, approval workflows, and production deployment.
7. Production monitoring and re-training: In production, ML models naturally degrade over time. Customer aesthetics shift, new A+ module types launch, product categories evolve, and seller behavior changes. The scoring patterns the classifier learned from historical annotations gradually fall out of alignment with what quality means today, leading to silent accuracy erosion if left unchecked. Continuous monitoring closes this gap by detecting when the live data distribution or model predictions have drifted far enough from the training baseline to warrant recalibration.
SageMaker AI ModelOps provides a collection of examples and resources to help you operationalize generative AI and machine learning workloads on SageMaker AI.
SageMaker AIOps provides the tool to track data quality, model quality, and feature-attribution drift. SageMaker Pipelines also automates the re-training workflow end-to-end when drift thresholds are breached.
8. Diffusion-based content generation: Closing the loop, the quality scores and SHAP-derived recommendations condition a diffusion model that generates improved A+ image assets. Rather than leaving sellers to interpret recommendations and create new content from scratch, the system produces ready-to-use visual assets (upgraded lifestyle imagery, rebalanced layouts, or enhanced product shots) that directly address the dimensions SHAP flagged as most negatively contributing. These generated assets and natural-language improvement suggestions are surfaced to sellers, so they can upgrade their listings on amazon.com.
Conclusion
In this post, we showed how to evaluate product detail pages as customers see them by rendering each page as a single snapshot and scoring it with a VLM. We also walked through implementing the system on Amazon SageMaker AI. We built the system around three goals. For adaptability, we keep the VLM fixed and train a CatBoost classifier on its rubric scores, so the system matches expert judgment and can be updated with a short CPU-only job. For performance, we add OCR readability scores that catch dense or poorly spaced text the VLM misses. For explainability, SHAP identifies which features drove each decision, and an LLM turns those results into prioritized recommendations for selling partners.
On 5,478 product detail pages from 10 product categories, the fused model reached 0.94 accuracy and a 0.95 F1 score, 14 and 11 percentage points above the averaged-score baseline. Pages revised using the recommendations improved their quality score by an average of 1.4 points on a scale of 10.
Content quality standards differ across product categories, languages, and marketplaces, and our expert annotations can’t fully represent every context. Next, we plan to evaluate more efficient VLM backbones and inference methods to run the system on a global catalog.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.