Cómo Deepgram optimizó la IA de voz a escala con AWS Trainium
How Deepgram optimized voice AI at scale with AWS Trainium
Pierre Lienhart
A medida que la voz se convierte en una modalidad de primera clase para la IA, los modelos de Deepgram abarcan agentes de voz a texto, de texto a voz y de voz. Ahora procesan cuatrillones de tokens de audio al año para más de 200 000 desarrolladores y 1400 organizaciones. Los clientes los utilizan a través de la API de Deepgram o los ejecutan en sus propios entornos, incluida
la IA de Amazon SageMaker.
En
el caso de Deepgram, la eficiencia del servicio determina la cantidad de audio que el sistema puede procesar para un presupuesto de infraestructura determinado. Las cargas de trabajo por lotes de gran volumen ejercen una gran presión sobre ese presupuesto, por lo que cuanto más eficientemente se utilice cada hora de aceleración, más audio podrá ofrecer Deepgram en la misma flota. Esto convirtió la eficiencia de la inferencia en un objetivo natural, por lo que Deepgram recurrió a los chips de IA de AWS para mejorarla. Trabajaron con AWS para llevar su modelo de conversión de voz a texto Nova-3 a AWS Trainium2 para cargas de trabajo por lotes sin conexión
, como el análisis de centros de atención al cliente y la transcripción médica.
El compromiso comenzó con la entrega de Nova-3 por parte de Deepgram como código PyTorch estándar. Durante varios meses, Deepgram y el equipo de AWS Forward Deployed Engineering (FDE) adaptaron el Nova-3 a AWS Trainium2 para reconstruir PyTorch y lo ajustaron para el nuevo hardware. La configuración final ejecuta ocho réplicas de modelos en una única instancia trn2.3xlarge de Amazon Elastic Compute Cloud (Amazon EC2). En las cargas de trabajo por lotes de Deepgram sin conexión y orientadas al rendimiento, esa configuración procesaba entre un 11 y un 70 por ciento más de audio por dólar que las opciones de procesamiento que Deepgram había estado utilizando. En el momento de la evaluación, lo medimos utilizando los precios de las instancias. Estas ganancias ayudan a Deepgram a escalar de manera eficiente, a seguir enviando mejores modelos y a ofrecerlos a los clientes a precios más bajos. Estas ventajas pueden extenderse a los clientes que alojan automáticamente modelos de Deepgram en su propia nube privada virtual (VPC) en Amazon SageMaker AI. Allí, Deepgram y AWS siguen mejorando la facilidad de configuración, la fiabilidad y la observabilidad
.
En este artículo, analizamos todos los esfuerzos realizados en Trainium para optimizar las inferencias: la adaptación de Nova-3 a la pila de software de AWS Neuron, los posteriores ajustes a nivel del núcleo, el tiempo de ejecución de Rust en paralelo a los datos que permitió que el propio servidor modelo de Deepgram llamara a Trainium y los resultados de rendimiento y costes que medimos mediante la transcripción por lotes.
Optimización de Nova-3 a Trainium2 con PyTorch nativo
Comenzando con el código estándar de PyTorch, utilizamos TorchNeuron, la integración nativa de PyTorch con el compilador Neuron, que admite tanto la ejecución rápida como el comando torch.compile.Primero ejecutamos Nova-3 en modo ansioso en Trainium2 y comprobamos qué operaciones recaían en la CPU y, a continuación, las compilamos con torch.compile. La ruta compilada ejecutaba todas las operaciones del modelo
en Trainium2 sin que se detectaran fallos de CPU.
Hemos compilado el codificador y el decodificador como gráficos independientes de forma estática mediante torch.compile. En todo momento, comprobamos la precisión numérica en dos niveles: la coherencia de los resultados a nivel de capa en comparación con la CPU y la tasa de errores de palabras (WER) de extremo a extremo, que tenía que mantenerse en línea con los valores de referencia y el objetivo de Deepgram
.
Partiendo de esa base de trabajo, iniciamos el trabajo de optimización sustituyendo varias capas por núcleos fusionados de la biblioteca pública de NKI (NKILib), una colección de núcleos de referencia prediseñados escritos con la interfaz de núcleo de neuronas (NKI). Los núcleos abarcaban operaciones como la fusión de proyecciones de QKV, la fusión de capas de red de alimentación directa (FFN) y la convolución 1D en profundidad
.
Optimizamos el rendimiento y, por extensión, la rentabilidad, centrándonos en las cargas de trabajo de inferencia offline de Deepgram. El rendimiento se presenta como una ganancia relativa con respecto a una configuración básica y no como audio absoluto procesado por segundo, y analizamos los tamaños de lote del 1 al 128 para encontrar el tamaño de lote que maximiza el
rendimiento.
Ajuste a nivel de núcleo con Neuron Explorer y NAD
Habilitar los núcleos es solo el primer paso de un ciclo de optimización: habilitar un kernel NKI (personalizado o de NKILib), perfilar la carga de trabajo y, a continuación, ajustar el kernel existente o reemplazarlo por uno nuevo en función de los conocimientos de creación de perfiles. Este ciclo se repite hasta que se alcance el objetivo de rendimiento. En cada paso, una parte diferente de la pila de Neuron acelera el trabajo: NkiLib proporciona núcleos de reemplazo de forma inmediata, Neuron Explorer es la herramienta ideal para crear perfiles de las cargas de trabajo de las neuronas, y el kit de herramientas Neuron Agentic Development (NAD) acelera el análisis de perfiles y el ajuste del núcleo gracias a sus habilidades de creación de perfiles y
creación de núcleos.
En nuestro caso, los núcleos NKILib nos dieron la mayor parte del camino, y la creación de perfiles mostró dónde funcionaría mejor un kernel escrito a mano. En cada ocasión, las habilidades de creación de perfiles de NAD nos llevaron del perfil de Neuron Explorer a la causa raíz, y las habilidades de creación de núcleos de NAD nos ayudaron a crear los núcleos sustitutivos
.
Capa
Lo que encontramos y cambiamos
Ganancia
FFN
El programa de ordenamiento en teselas del kernel de referencia recargaba el conjunto completo de pesos de proyección desde la memoria externa del chip para cada tesela de fichas, por lo que el ancho de banda de la memoria limitaba el rendimiento a medida que aumentaba el número de fichas. Nuestro núcleo, ajustado a mano, carga cada bloque de ponderación una vez, lo reutiliza en varios bloques de fichas y canaliza las lecturas de ponderación con el cálculo integrado en el chip.
Una latencia 2.0 veces menor en comparación con el kernel de referencia, con un tamaño de lote de 96
Conv1d en profundidad
El kernel experimental de NkiLib enmarcó la operación como una multiplicación matricial general implícita (GEMM), lo que redujo el uso de Tensor Engine. La reescribimos para convertirla en un bucle de transmisión, multiplicación y acumulación en el motor vectorial, lo que nos permitió aprovechar al máximo el motor, lo suficiente como para compensar con creces el menor
rendimiento máximo del motor vectorial.
Se aceleró 1,5 veces más que en el kernel de referencia, con un tamaño de lote de 96
Conv2D
Las capas conv2d del modelo tropezaron con un obstáculo en la compilación: más allá del tamaño de lote 32, estas capas impidieron que el modelo se compilara como un solo gráfico. Como NKILib no tenía un núcleo conv2d, escribimos uno desde cero en NKI. El núcleo pasó por varias iteraciones basadas en la creación de perfiles siguiendo el procedimiento descrito anteriormente, desbloqueando lotes de tamaños superiores a 32
.
Hasta 50 veces en el módulo de convolución para lotes de tamaños inferiores a 32
Tiempo de ejecución paralelo de datos en Rust
Cada dispositivo Trainium2 cuenta con ocho núcleos neuronales físicos, expuestos de forma predeterminada como cuatro núcleos neuronales lógicos (LNC2). Como cada instancia del modelo Nova-3 cabe cómodamente en un único núcleo físico, hemos reducido el número de núcleos físicos por núcleo lógico a uno (LNC1). Esta configuración nos permite alojar ocho réplicas de modelos (DP8) por dispositivo Trainium2. Las entradas se procesan de forma simultánea y, al mismo tiempo, se maximiza el rendimiento por dispositivo. El tiempo de ejecución paralelo de datos se basa en una cola que roba trabajo con un subproceso por
réplica.
La
pila de servidores de producción de Deepgram está escrita en Rust, por lo que portar Nova-3 a Trainium2 requería más que compilar el modelo: también tenía que ejecutarse sin Python o PyTorch en la ruta de publicación. Por lo tanto, creamos un entorno de ejecución ligero en el que Rust coordina las réplicas de modelos a través de una cola compartida que roba trabajo. Una capa C carga y ejecuta el formato de archivo ejecutable de Neuron (NEFFs) compilado con antelación directamente a través de la API Neuron Runtime (libnrt). El motor de ejecución se integra directamente con la arquitectura de servicio de Deepgram y reproduce las secuencias de los tokens de referencia exactamente
en cada tamaño de lote probado.
Lo comparamos con los tiempos de ejecución paralelos de datos de Python con subprocesos múltiples (MT) y multiprocesamiento (MP). En comparación con la línea base de MP, el tiempo de ejecución de Rust elimina por completo la sobrecarga del intérprete de Python. En comparación con la versión de base de MT, alivia aún más la serialización mediante el bloqueo global del intérprete (GIL), por lo que las llamadas de despacho desde subprocesos de trabajo simultáneos ya no se incluyen en un solo proceso. Estas ventajas son importantes porque Nova-3 realiza una secuencia de pequeñas llamadas al decodificador para cada fragmento de audio, lo que hace que el despacho del servidor sea el cuello de botella cuando los lotes son de menor tamaño. Por lo tanto, la mejora del rendimiento es mayor allí, y sigue siendo significativa incluso con el tamaño de los lotes que maximiza el rendimiento. En este caso, el tiempo de ejecución de Rust supuso un aumento del rendimiento del 7,5% con respecto a la línea base de multiprocesamiento de
Python.
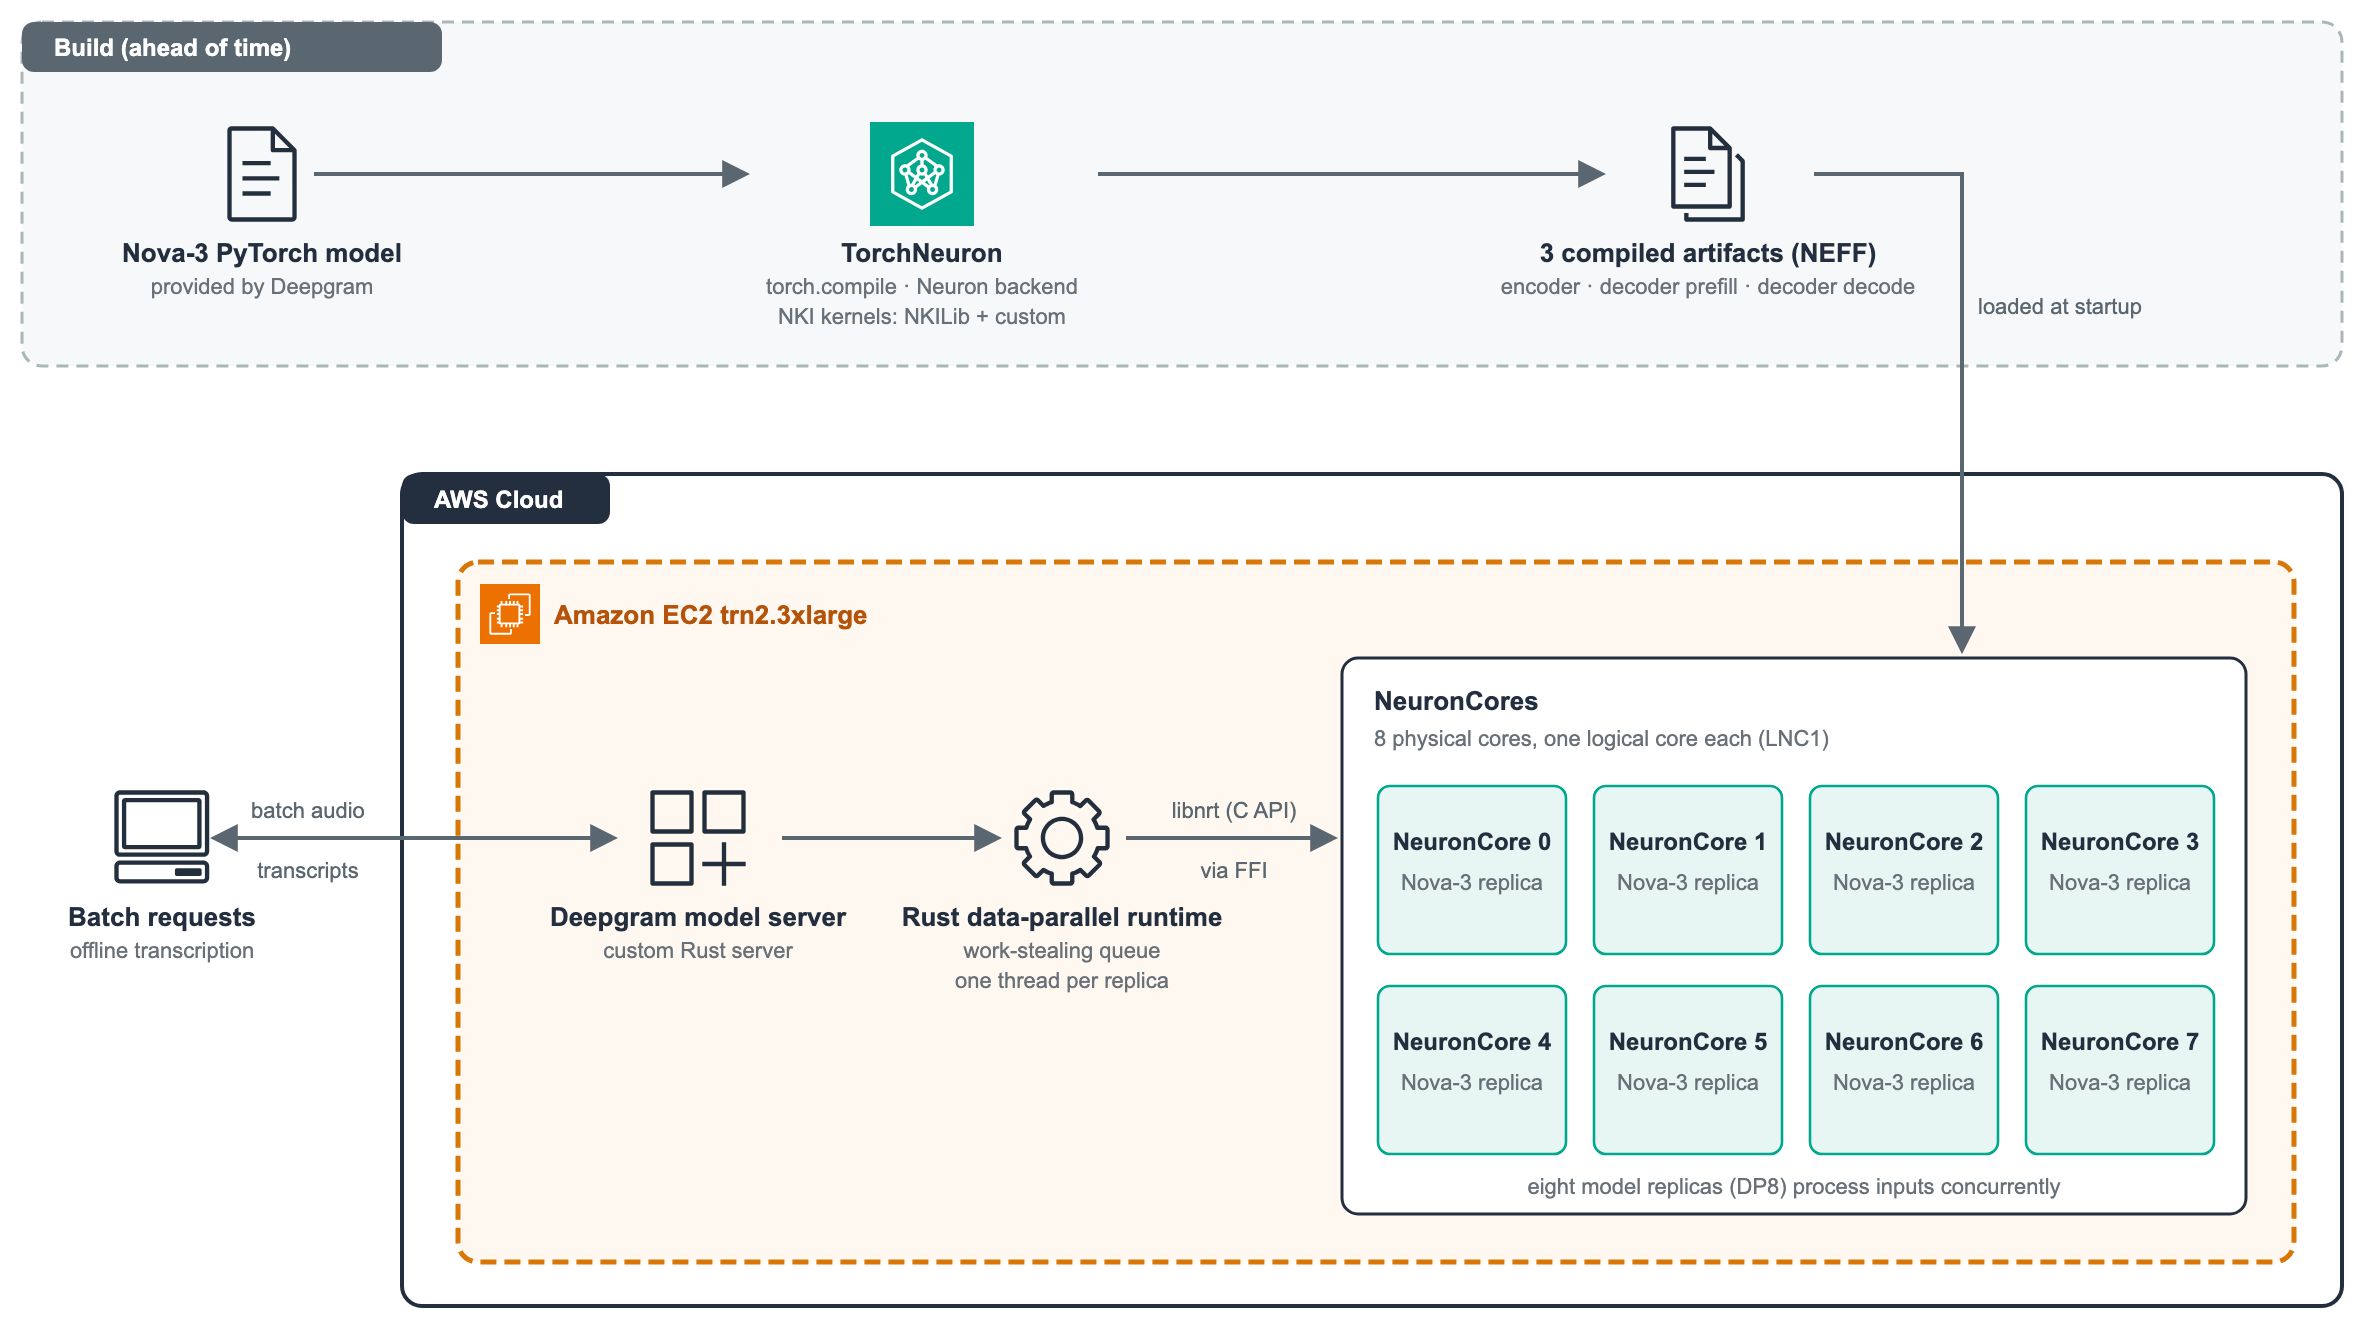
Figura 1: Deepgram Nova-3 en AWS Trainium2, compilado con antelación y servido desde Rust
Impacto en el ahorro de costos
Medimos la relación precio-rendimiento según el audio procesado por dólar. En las cargas de trabajo por lotes de Deepgram sin conexión y orientadas al rendimiento, la configuración Trainium2 para un solo dispositivo (trn2.3 x large)
procesaba entre un 11 y un 70 por ciento más de audio por dólar que las opciones de procesamiento que Deepgram utilizaba.
Conclusión
En este artículo, demostramos cómo Deepgram y el FDE de AWS adaptaron el modelo PyTorch de voz a texto Nova-3 al hardware de Trainium mediante TorchNeuron, que proporciona una integración del marco nativo de PyTorch con AWS Trainium. Hemos mejorado el rendimiento al reemplazar las capas directamente por núcleos prediseñados de NkiLib. Luego evaluamos el rendimiento con Neuron Explorer y utilizamos las habilidades de creación de perfiles de Neuron Agentic Development (NAD) para consultar los datos de creación de perfiles y acelerar la resolución de problemas de rendimiento. Basándonos en estos conocimientos, adaptamos el código fuente del núcleo utilizando las habilidades de escritura del núcleo de NAD. Por último, creamos un entorno de ejecución paralelo de datos ligero de Rust para AWS Trainium, que denominaba a la API Neuron Runtime desde Rust. Nuestra configuración demostró un ahorro de costos en escenarios sin conexión y orientados al rendimiento, lo que validó a AWS Trainium como una opción
viable y eficiente para las cargas de trabajo de inferencia de Deepgram.
As voice becomes a first-class modality for AI, Deepgram’s models span speech-to-text, text-to-speech, and voice agents. They now process quadrillions of audio tokens a year for more than 200,000 developers and 1,400 organizations. Customers use them through the Deepgram API or run them in their own environments, including on Amazon SageMaker AI.
For Deepgram, serving efficiency determines how much audio the system can process for a given infrastructure budget. High-volume batch workloads put heavy pressure on that budget, so the more efficiently each accelerator hour is used, the more audio Deepgram can serve on the same fleet. That made inference efficiency a natural target and Deepgram turned to AWS AI chips to improve it. They worked with AWS to bring its Nova-3 speech-to-text model to AWS Trainium2 for offline batch workloads such as contact-center analytics and medical transcription.
The engagement began with Deepgram delivering Nova-3 as standard PyTorch code. Over several months, Deepgram and the AWS Forward Deployed Engineering (FDE) team ported Nova-3 to AWS Trainium2 in PyTorch reconstruction and tuned it for the new hardware. The final configuration runs eight model replicas on a single Amazon Elastic Compute Cloud (Amazon EC2) trn2.3xlarge instance. On Deepgram’s offline, throughput-oriented batch workloads, that setup processed 11–70 percent more audio per dollar than the compute options Deepgram had been running. We measured this using instance pricing at the time of the evaluation. These gains help Deepgram scale efficiently, keep shipping better models, and bring them to customers at lower prices. These benefits can extend to customers who self-host Deepgram models in their own virtual private cloud (VPC) on Amazon SageMaker AI. There, Deepgram and AWS continue to improve ease of setup, reliability, and observability.
In this post, we walk through the full inference optimization effort on Trainium: porting Nova-3 to the AWS Neuron software stack, the kernel-level tuning that followed, the data-parallel Rust runtime that lets Deepgram’s own model server call Trainium, and the throughput and cost results we measured on batch transcription.
Optimizing Nova-3 to Trainium2 with native PyTorch
Starting with standard PyTorch code, we used TorchNeuron, the native PyTorch integration of the Neuron Compiler, which supports both eager execution and torch.compile. We ran Nova-3 in eager mode on Trainium2 first and checked which operations fell back to the CPU, then compiled with torch.compile. The compiled path ran every model operation on Trainium2 with no CPU fallbacks detected.
We compiled the encoder and decoder as separate static-shape graphs using torch.compile. Throughout, we checked numerical accuracy at two levels: layer-level output consistency against CPU, and the end-to-end Word Error Rate (WER), which had to stay in line with Deepgram’s reference values and target.
From that working baseline, we kicked off the optimization work by replacing several layers with fused kernels from the public NKI Library (NKILib), a collection of pre-built reference kernels written with the Neuron Kernel Interface (NKI). The kernels covered operations such as fused QKV projections, fused feed-forward network (FFN) layers, and depthwise 1D convolution.
We optimized for throughput and, by extension, cost efficiency, targeting Deepgram’s offline inference workloads. Throughput is reported as a relative gain over a baseline configuration rather than as absolute audio processed per second, and we swept batch sizes 1–128 to find the throughput-maximizing batch size.
Kernel-level tuning with Neuron Explorer and NAD
Enabling kernels is only the first step of an optimization flywheel: enable an NKI kernel (custom or from NKILib), profile the workload, then either tune the existing kernel or replace it with a new one based on the profiling insights. This cycle repeats until the performance target is met. At each step, a different part of the Neuron stack accelerates the work: NKILib provides drop-in replacement kernels, Neuron Explorer is the go-to tool for profiling Neuron workloads, and the Neuron Agentic Development (NAD) toolkit speeds up profiling analysis and kernel tuning through its profiling and kernel-writing skills.
In our case, the NKILib kernels got us most of the way, and profiling showed where a hand-written kernel would do better. Each time, the NAD profiling skills took us from a Neuron Explorer profile to a root cause, and the NAD kernel-writing skills helped produce the replacement kernels.
Layer
What we found and changed
Gain
FFN
The reference kernel’s tiling schedule reloaded the full set of projection weights from off-chip memory for every token tile, so memory bandwidth limited throughput as the token count grew. Our hand-tuned kernel loads each weight tile once, reuses it across multiple token tiles, and pipelines weight reads with on-chip compute.
2.0x lower latency compared to the reference kernel at batch size 96
Depthwise conv1d
The experimental NKILib kernel framed the operation as an implicit general matrix multiply (GEMM), which left Tensor Engine utilization low. We rewrote it as a broadcast multiply-accumulate loop on the Vector Engine, reaching full engine utilization, enough to more than offset the Vector Engine’s lower peak throughput.
1.5x speedup compared to the reference kernel at batch size 96
Conv2d
The model’s conv2d layers hit a compilation bottleneck: beyond batch size 32, these layers prevented the model from compiling as a single graph. Since NKILib had no conv2d kernel, we wrote one from scratch in NKI. The kernel went through several profiler-informed iterations following the flywheel described earlier, unlocking batch sizes above 32.
Up to 50x on the convolution module at batch sizes ≤32
Data-parallel runtime in Rust
Each Trainium2 device features eight physical NeuronCores, exposed by default as four logical NeuronCores (LNC2). Because each Nova-3 model instance fits comfortably on a single physical core, we reduced the number of physical cores per logical core to one (LNC1). This configuration lets us host eight model replicas (DP8) per Trainium2 device. Inputs are processed concurrently while maximizing per-device throughput. The data-parallel runtime is driven by a work-stealing queue with one thread per replica.
Deepgram’s production serving stack is written in Rust, so porting Nova-3 to Trainium2 required more than compiling the model: it also had to run without Python or PyTorch in the serving path. We therefore built a lightweight runtime in which Rust coordinates model replicas through a shared work-stealing queue. A C layer loads and executes ahead-of-time-compiled Neuron Executable File Format (NEFFs) directly through the Neuron Runtime API (libnrt). The runtime integrates directly with Deepgram’s serving architecture and reproduced the reference token sequences exactly at every tested batch size.
We benchmarked it against multithreaded (MT) and multiprocessing (MP) Python data-parallel runtimes. Compared with the MP baseline, the Rust runtime removes the overhead of the Python interpreter entirely. Compared with the MT baseline, it further alleviates global interpreter lock (GIL) serialization, so dispatch calls from concurrent worker threads are no longer contended within a single process. These gains matter because Nova-3 performs a sequence of small decoder calls for each audio chunk, making host-side dispatch the bottleneck at low batch sizes. The throughput improvement is therefore largest there, and remains meaningful even at the throughput-maximizing batch size. There, the Rust runtime delivered a 7.5% throughput gain over the multiprocessing Python baseline.
Figure 1: Deepgram Nova-3 on AWS Trainium2, compiled ahead of time and served from Rust
Cost saving impact
We measured price-performance as audio processed per dollar. On Deepgram’s offline, throughput-oriented batch workloads, the single-device Trainium2 setup (trn2.3xlarge) processed 11–70 percent more audio per dollar than the compute options Deepgram had been running.
Conclusion
In this post, we demonstrated how Deepgram and the AWS FDE ported the Nova-3 speech-to-text PyTorch model to Trainium hardware using TorchNeuron, which provides native PyTorch framework integration for AWS Trainium. We improved performance by replacing layers directly with pre-built kernels from NKILib. We then assessed performance using Neuron Explorer and used the Neuron Agentic Development (NAD) profiling skills to query profiling data and accelerate performance troubleshooting. Building on these insights, we adapted kernel source code using the NAD kernel-writing skills. Finally, we built a lightweight Rust data-parallel runtime for AWS Trainium, calling the Neuron Runtime API from Rust. Our setup demonstrated cost savings in offline, throughput-oriented scenarios, validating AWS Trainium as a viable and efficient option for Deepgram’s inference workloads.
To try this approach on your own models, start with the AWS Neuron documentation, which covers the compiler, the runtime, and the supported frameworks. The Neuron Kernel Interface (NKI) guide explains how to write the kernels described in this post, and the NKI samples repository holds the reference kernels we started from. The Neuron developer tools documentation covers the profiling and agentic tooling we used here, including Neuron Explorer and Neuron Agentic Development. For instance sizes and pricing, see Amazon EC2 Trn2 Instances. For help scoping a similar port, contact the AWS Forward Deployed Engineering.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.