Presentamos Reflection Beam: un modelo de peso abierto para la codificación de agencias en AWS
Introducing Reflection Beam: an open-weight model for agentic coding on AWS
Clement Perrot
Reflection AI presentó Beam, un modelo de peso abierto para la codificación de agencias y tareas a largo plazo, como el mantenimiento del código, el uso de herramientas, la interpretación de los resultados y la finalización de flujos de trabajo de varios pasos. Esta versión de formato abierto permite a los desarrolladores e investigadores controlar el tiempo de ejecución, el entorno de implementación y el proceso de personalización
.
En esta publicación, explicamos la visión de Reflection y mostramos cómo puede implementar Beam en AWS. Comience con un punto de enlace JumpStart en tiempo real de Amazon SageMaker para disponer de una ruta totalmente gestionada. Cuando necesite un control nativo de Kubernetes sobre la infraestructura de GPU distribuidas, utilice Amazon SageMaker HyperPod Inference con JumpStart, SGLang o vLLM. También explicamos cómo el total de 501 000 millones de parámetros de Beam configuran el almacenamiento en puntos de control, el peso de la memoria, la fragmentación y el paralelismo, mientras que sus 23 000 millones de parámetros activos influyen en el cálculo por token
.
En el momento del lanzamiento, Beam estará disponible en Amazon SageMaker JumpStart en EE.UU. Este (Norte de Virginia) y EE.UU. Este (Ohio).
La visión de Reflection para la inteligencia abierta
La misión de Reflection es hacer que la inteligencia sea abierta y accesible para todos a través de modelos abiertos, investigaciones publicadas y software de código abierto. Su paquete completo de inteligencia artificial abarca modelos, software básico, infraestructura de producción y aplicaciones. Beam ofrece este enfoque a los desarrolladores que crean sistemas agenciales y de ingeniería de software
.
Acerca de Reflection Beam
Beam es un modelo poco especializado para resolver problemas de software, modificar código, invocar herramientas y actuar sobre la base de resultados intermedios. Cuenta con un total de 501 mil millones de parámetros y 23 mil millones de parámetros activos, y Reflection informa de una longitud efectiva del contexto
de 1 millón de tokens.
Reflection publica los pesos de Beam a través de Hugging Face bajo la licencia Apache 2.0. Beam 1.0 está disponible en las variantes de puntos de control BF16, FP8 y NVFP4. Estos formatos proporcionan diferentes tamaños de memoria y compatibilidad de hardware. Puede implementar el modelo con la configuración de contenedores JumpStart administrada por AWS o inspeccionar y personalizar el modelo con SGLang o vLLM
en su entorno de AWS.
Comprenda la arquitectura de implementación
Elija la ruta de servicio que cumpla con sus requisitos de control y escalado.
Comience con un punto de enlace en tiempo real de SageMaker JumpStart cuando desee un paquete de modelos, un punto de enlace y una API de invocación administrados por AWS sin utilizar Kubernetes.
Utilice JumpStart on HyperPod Inference cuando desee configurar el contenedor y el modelo gestionado por AWS en un clúster de HyperPod gestionado por Amazon Elastic Kubernetes Service (Amazon EKS).
Utilice SGLang o vLLM en HyperPod Inference cuando necesite controlar la imagen que se publica, los argumentos en tiempo de ejecución, la cuantificación o la ejecución distribuida.
Ajuste el tamaño de la implementación en función del almacenamiento en puntos de control, el peso de la memoria, la caché de KV, la longitud del contexto, el procesamiento por lotes, la sobrecarga del tiempo de ejecución y el paralelismo admitido.
Defina los objetivos de simultaneidad y latencia esperados y, a continuación, configure las réplicas, el almacenamiento en caché, el enrutamiento y el escalado automático a partir del comportamiento medido de la carga de trabajo.
La ruta en tiempo real de JumpStart empaqueta el modelo, el contenedor y el punto final detrás de un flujo de trabajo de implementación administrado. La ruta HyperPod expone el tiempo de ejecución del clúster y del servidor para que pueda controlar la ejecución distribuida, el almacenamiento en caché, el enrutamiento
y el escalado.
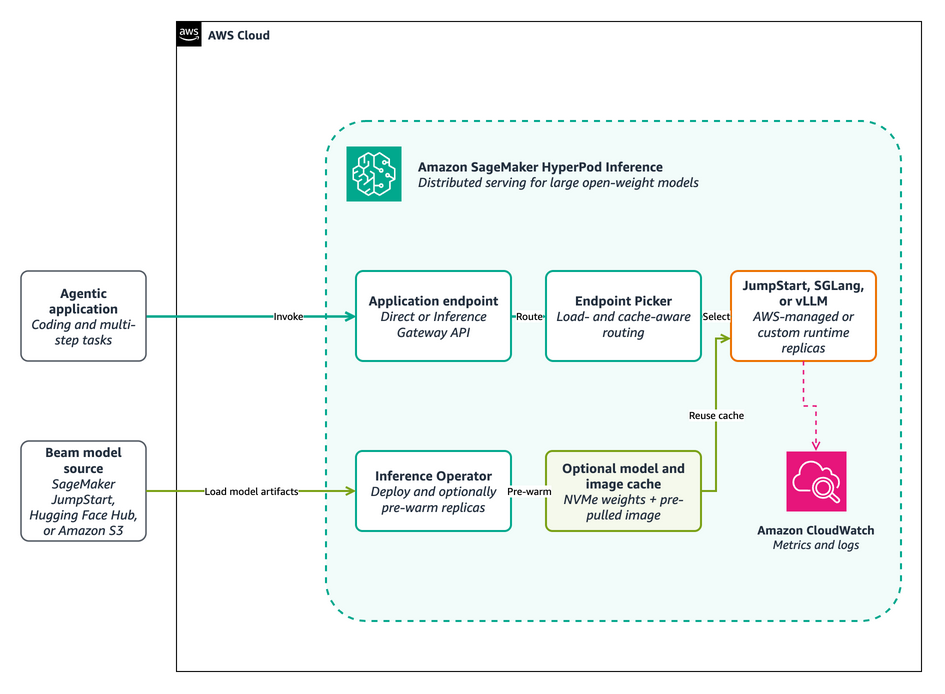
El siguiente diagrama muestra los componentes que utiliza la ruta del HyperPod. Beam se puede obtener a través de SageMaker JumpStart, Hugging Face Hub o una réplica opcional de Amazon Simple Storage Service (Amazon S3). Los trabajadores distribuidos utilizan el contenedor JumpStart administrado por AWS o un entorno de ejecución SGLang o vLLM personalizado.
Figura 1: Implementación de Distributed Beam con Amazon SageMaker HyperPod Inference
Requisitos previos
Necesitas:
Una cuenta de AWS con permisos para la ruta de implementación de SageMaker seleccionada y sus recursos compatibles con AWS Identity and Access Management (IAM), redes y almacenamiento.
Acceda a Beam a través de SageMaker JumpStart o de uno de los repositorios de puntos de control de Beam 1.0 en Hugging Face.
Aceptación de los términos del modelo, de la interfaz de línea de comandos de AWS (CLI de AWS) y de Python 3.11 o posterior.
Cuota y capacidad de GPU para una configuración de Beam compatible.
Planifique y obtenga la capacidad de la GPU
El
total de 501 mil millones de parámetros de Beam requiere una implementación de varias GPU. El BF16 es el que más memoria necesita, así que planifique una configuración multinodo con suficiente memoria de GPU agregada para cubrir el peso y la sobrecarga de tiempo de ejecución. Para el FP8, usa ml.p5.48xlarge con las GPU NVIDIA H100 o ml.p5e.48xlarge y ml.p5en.48xlarge con las GPU H200. Para la NVFP4, usa ml.p6-b200.48xlarge con las GPU NVIDIA B200. Confirma que el punto de control, el tiempo de ejecución y el diseño paralelo publicados sean compatibles
con el tipo de instancia seleccionado.
Calcule la memoria para los pesos, la caché de KV y la sobrecarga de tiempo de ejecución para una réplica y, a continuación, confirme la estimación con una prueba de carga.
Elija una región de AWS que sea compatible con la instancia acelerada requerida.
Compruebe la cuota de servicio y la capacidad disponible para el tipo de instancia seleccionado. Utilice la capacidad bajo demanda cuando esté disponible, o utilice un plan de formación de SageMaker como reserva a corto plazo para el trabajo programado
.
Deje tiempo para la transferencia de imágenes, la descarga del peso, la carga de fragmentos y la inicialización del tiempo de ejecución.
Ruta 1: Cómo empezar a usar un punto final en tiempo real de SageMaker JumpStart
Utilice primero un punto de enlace en tiempo real de JumpStart cuando desee disponer de la ruta más corta desde el catálogo de modelos hasta un punto de enlace HTTPS administrado. El ejemplo admite los ID de los modelos BF16, FP8 y NVFP4 mediante un comando que reconoce las variantes. Sus archivos README y Python son la fuente fiable de los tipos de instancias, esquemas de solicitudes, comandos de despliegue y comandos de limpieza compatibles
.
Clona el repositorio de muestras.
clon de git https://github.com/aws-samples/sagemaker-genai-hosting-examples.git
Acceda al directorio de ejemplos de implementación de SageMaker JumpStart.
cd SageMaker-Genai-Hosting-Examples/01-modelos/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/
Cree y active un entorno virtual de Python.
python3 -m venv .venv
fuente .venv/bin/activate
Instale la dependencia de ejemplo.
python -m pip install -r requirements.txt
Ejecute el ciclo de vida limitado de implementación, invocación y limpieza para FP8.
pitón jumpstart_real_time.py\
--variante fp8\
--nombre-punto final reflection-beam-fp8-smoke
El comando implementa el punto final del FP8, envía una solicitud breve, imprime la respuesta y limpia el punto final. Usa bf16 o nvfp4 para seleccionar otra variante de punto de control; NVFP4 es la predeterminada si omites --variant. Usa las funciones de Python en el archivo README cuando necesites mantener un punto final en
ejecución.
Ruta 2: Implemente con SageMaker HyperPod Inference
Utilice HyperPod Inference cuando necesite un control nativo de Kubernetes sobre la infraestructura de GPU distribuidas. Puede usar la configuración de contenedores JumpStart administrada por AWS o implementar Beam con SGLang o vLLM. El README de muestra de implementación de HyperPod Inference y sus archivos de configuración son la fuente fiable de los manifiestos, los identificadores de modelos e imágenes, las versiones de tiempo de ejecución compatibles y los comandos publicados
.
Antes de empezar, configura el acceso de kubectl a un clúster de HyperPod orquestado por EKS con el HyperPod Inference Operator y los complementos necesarios. Si habilita el almacenamiento en caché de modelos, también necesitará la nube privada virtual (VPC) del clúster, las subredes, los grupos de seguridad, el acceso a los artefactos de Beam y de tiempo de ejecución seleccionados y la capacidad de NVMe local. Usa un token de acceso aislado de Hugging Face si el
repositorio seleccionado requiere autenticación.
Implementa una revisión fija de Beam desde Hugging Face Hub para su desarrollo y experimentación. Para las implementaciones de producción y el almacenamiento en caché de modelos, copie el punto de control en Amazon S3 o Amazon FSx. El almacenamiento en caché de modelos e imágenes de HyperPod puede precargar los pesos en el almacenamiento NVMe local del nodo y extraer previamente la imagen de servicio
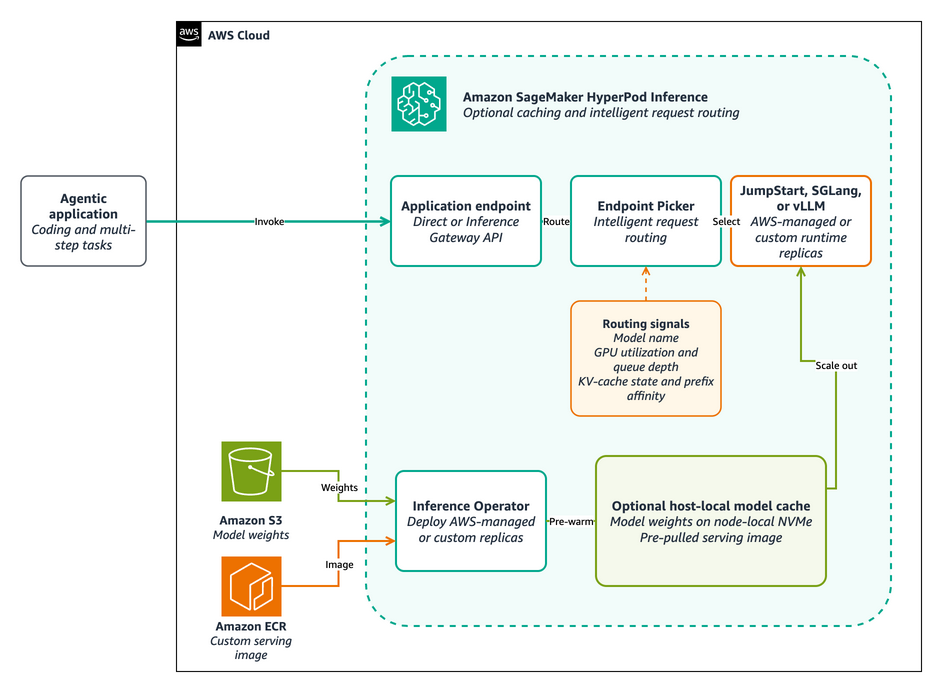
El siguiente diagrama amplía el flujo de solicitudes de preparación y ejecución del modelo. Cuando se habilita el almacenamiento en caché del modelo, el operador de inferencia calienta los nodos aptos con los pesos y la imagen de servicio seleccionados. Durante el tiempo de ejecución, la puerta de enlace de inferencia y el selector de puntos finales pueden dirigir cada solicitud a una réplica adecuada gestionada por JumpStart
, SGLang o VLLM.
Figura 2: Almacenamiento en caché del modelo HyperPod y enrutamiento de solicitudes
Prepare los artefactos de implementación
Utilice entradas inmutables para poder reproducir los resultados de implementación y rendimiento.
Utilice la versión del modelo JumpStart registrada en la muestra de implementación.
Elija el punto de control BF16, FP8 o NVFP4 para un tiempo de ejecución personalizado.
Para un tiempo de ejecución personalizado, mantén el resumen público de la imagen y el SHA de confirmación de Beam en la configuración de la versión de muestra.
Duplique la imagen publicada en un repositorio privado de Amazon Elastic Container Registry (Amazon ECR) solo cuando su clúster no pueda extraer la imagen original o su organización necesite un registro aprobado.
Mantén los tokens, los secretos generados, los identificadores de modelos privados, las credenciales de registro y los resultados no publicados fuera del repositorio.
Elija una ruta de servicio
Comience con SageMaker JumpStart, a menos que su carga de trabajo requiera una configuración o un tiempo de ejecución de inferencia específicos.
Ruta de servicio
Úselo cuando
Lo que administras
SageMaker JumpStart
Quiere una configuración de contenedores y modelos administrada por AWS con menos mantenimiento en tiempo de ejecución.
Seleccione la versión del modelo de Beam, el tipo de instancia admitido, la configuración del punto final y la política de escalado.
SGLang o VLLm
Necesita un tiempo de ejecución o una configuración de inferencia específicos, como argumentos de tiempo de ejecución personalizados, analizadores, cuantificación o paralelismo.
Fija la imagen en tiempo de ejecución, la revisión del modelo, la configuración del analizador y la configuración de ejecución distribuida compatibles.
Implemente con SageMaker JumpStart
SageMaker JumpStart reduce el trabajo de integración de contenedores, mientras que HyperPod conserva el control sobre la capacidad, el escalado y la observabilidad de los clústeres.
En SageMaker Studio, abra el catálogo de modelos de JumpStart.
En Todos los modelos públicos, elija Beam.
Elija SageMaker HyperPod como objetivo de implementación.
Seleccione el clúster y el espacio de nombres de Kubernetes.
Introduzca un nombre de punto final y elija Deploy.
Confirme el estado de la implementación antes de invocar el punto final con el esquema de solicitud JumpStart publicado.
Sustituya sglang por vllm para usar vLLm. El ayudante valida la configuración seleccionada, aplica el manifiesto renderizado sin escribir los valores de versión en el disco, espera con un tiempo de espera fijo e imprime los diagnósticos si se produce un error
en la implementación.
Invoca Beam
Invoca los puntos finales de JumpStart con el esquema de solicitud del modelo publicado. Para SGLang o vLLM, utilice la prueba de humo acotado incluida en la muestra de HyperPod
Realice un chequeo médico privado y una solicitud breve con la configuración de muestreo inicial recomendada.
pitón hyperpod_tool.py\
--config config/deployment.env\
jerga fumadora\
--prompt «Enumere tres comprobaciones para comprobar si la implementación del modelo es correcta. »\
--temperatura 1.0\
--top 0.7
Sustituya sglang por vllm para una implementación de vLLM. El ayudante selecciona un trabajador preparado, abre un puerto de reenvío temporal, comprueba el estado del punto final, envía
la solicitud y cierra el reenvío de puertos.
La respuesta es similar a la siguiente:
1. Confirme que los informes de punto final están listos.
2. Envíe una solicitud de inferencia breve.
3. Revise los registros de servicio para ver si hay errores de inicio.
Para una puerta de enlace de inferencia autenticada, utilice el procedimiento bearer-token del README de muestra de HyperPod. Mantén las credenciales alejadas del código fuente, los manifiestos
y el historial de comandos.
Mida y ajuste el rendimiento
Pruebe cada ruta de entrega con solicitudes de codificación y uso de herramientas repetidas y representativas en la concurrencia esperada.
Registre la versión del modelo de Beam, el resumen de la imagen, el tipo de instancia, la precisión, la longitud del contexto, el paralelismo, los argumentos de entrega, el estado de la caché y las repeticiones de las pruebas.
Mida la tasa de éxito de las solicitudes, el tiempo de p50 y p95 hasta el primer token, el tiempo por token de salida, la latencia de extremo a extremo y el total de los tokens de salida por segundo.
A partir de esos resultados, ajuste el tamaño de los lotes, la asignación de la caché KV, el recuento de réplicas, el escalado automático y el almacenamiento en caché de modelos e imágenes.
Vuelva a comprobar la calidad de salida después de cambiar la precisión o la cuantificación.
Limpiar
Elimine los recursos cuando termine las pruebas para evitar cargos continuos.
Para un endpoint en tiempo real de SageMaker JumpStart, siga las instrucciones de limpieza del README de muestra de implementación de SageMaker JumpStart.
Para JumpStart, SGLang o vLLM en Amazon SageMaker HyperPod Inference, siga las instrucciones de limpieza que aparecen en el archivo README de muestra de la implementación de HyperPod Inference.
Elimine un clúster dedicado de HyperPod o Amazon EKS creado para el tutorial.
Elimine los pesos en caché no utilizados, los artefactos reflejados, los balanceadores de carga, los grupos de registros, las funciones de IAM temporales y los datos de inferencia capturados.
Conclusión
Reflection Beam ofrece a los desarrolladores un modelo abierto diseñado para la codificación de agencias y las tareas de varios pasos. Comience con un punto final de SageMaker JumpStart en tiempo real para lograr una implementación totalmente gestionada. Utilice SageMaker HyperPod Inference con JumpStart cuando necesite controlar la infraestructura nativa de Kubernetes sin administrar el contenedor de servicio, o elija SGLang o vLLM
cuando necesite un tiempo de ejecución personalizado.
Reflection AI introduced Beam, an open-weight model for agentic coding and long-horizon tasks such as maintaining code, using tools, interpreting results, and completing multi-step workflows. The open-weight release gives developers and researchers control over the runtime, deployment environment, and customization process.
In this post, we explain Reflection’s vision and show how you can deploy Beam on AWS. Start with an Amazon SageMaker JumpStart real-time endpoint for a fully managed path. When you need Kubernetes-native control over distributed GPU infrastructure, use Amazon SageMaker HyperPod Inference with JumpStart, SGLang, or vLLM. We also explain how Beam’s 501 billion total parameters shape checkpoint storage, weight memory, sharding, and parallelism, while its 23 billion active parameters influence per-token compute.
At launch, Beam is available in Amazon SageMaker JumpStart in US East (N. Virginia) and US East (Ohio).
Reflection’s vision for open intelligence
Reflection’s mission is to make intelligence open and accessible to all through open model weights, published research, and open source software. Its full AI stack spans models, core software, production infrastructure, and applications. Beam brings this approach to developers building software engineering and agentic systems.
About Reflection Beam
Beam is a sparse mixture-of-experts model for resolving software issues, modifying code, calling tools, and acting on intermediate results. It has 501 billion total parameters and 23 billion active parameters, and Reflection reports an effective context length of 1 million tokens.
Reflection releases Beam’s weights through Hugging Face under the Apache 2.0 license. Beam 1.0 is available in BF16, FP8, and NVFP4 checkpoint variants. These formats provide different memory footprints and hardware compatibility. You can deploy the model with the AWS managed JumpStart container configuration or inspect and customize the model with SGLang or vLLM in your AWS environment.
Understand the deployment architecture
Choose the serving path that meets your control and scaling requirements.
Start with a SageMaker JumpStart real-time endpoint when you want an AWS managed model package, endpoint, and invocation API without operating Kubernetes.
Use JumpStart on HyperPod Inference when you want the AWS managed container and model configuration on a HyperPod cluster orchestrated by Amazon Elastic Kubernetes Service (Amazon EKS).
Use SGLang or vLLM on HyperPod Inference when you need to control the serving image, runtime arguments, quantization, or distributed execution.
Size the deployment for checkpoint storage, weight memory, KV cache, context length, batching, runtime overhead, and the supported parallelism.
Define the expected concurrency and latency targets, then configure replicas, caching, routing, and autoscaling from measured workload behavior.
The JumpStart real-time path packages the model, container, and endpoint behind a managed deployment workflow. The HyperPod path exposes the cluster and serving runtime so that you can control distributed execution, caching, routing, and scaling.
The following diagram shows the components used by the HyperPod path. Beam can be sourced through SageMaker JumpStart, Hugging Face Hub, or an optional Amazon Simple Storage Service (Amazon S3) mirror. The distributed workers use the AWS managed JumpStart container or a custom SGLang or vLLM runtime.
Figure 1: Distributed Beam deployment with Amazon SageMaker HyperPod Inference
Prerequisites
You need:
An AWS account with permissions for your selected SageMaker deployment path and its supporting AWS Identity and Access Management (IAM), networking, and storage resources.
Access to Beam through SageMaker JumpStart or one of the Beam 1.0 checkpoint repositories on Hugging Face.
Acceptance of the model terms, the AWS Command Line Interface (AWS CLI), and Python 3.11 or later.
GPU quota and capacity for a supported Beam configuration.
Plan and obtain GPU capacity
Beam’s 501 billion total parameters require a multi-GPU deployment. BF16 has the largest weight-memory requirement, so plan a multi-node configuration with enough aggregate GPU memory for the weights and runtime overhead. For FP8, use ml.p5.48xlarge with NVIDIA H100 GPUs or ml.p5e.48xlarge and ml.p5en.48xlarge with H200 GPUs. For NVFP4, use ml.p6-b200.48xlarge with NVIDIA B200 GPUs. Confirm that the released checkpoint, runtime, and parallel layout support the selected instance type.
Calculate memory for weights, KV cache, and runtime overhead for one replica, then confirm the estimate with a load test.
Choose an AWS Region that supports the required accelerated instance.
Check the service quota and available capacity for the selected instance type. Use on-demand capacity when available, or use a SageMaker training plan as a short-term reservation for scheduled work.
Allow time for image transfer, weight download, shard loading, and runtime initialization.
Path 1: Get started with a SageMaker JumpStart real-time endpoint
Use a JumpStart real-time endpoint first when you want the shortest path from the model catalog to a managed HTTPS endpoint. The sample supports the BF16, FP8, and NVFP4 model IDs through one variant-aware command. Its README and Python file are the source of truth for supported instance types, request schema, deployment command, and cleanup command.
The command deploys the FP8 endpoint, sends a short request, prints the response, and cleans up the endpoint. Use bf16 or nvfp4 to select another checkpoint variant; NVFP4 is the default when you omit --variant. Use the Python functions in the README when you need to keep an endpoint running.
Path 2: Deploy with SageMaker HyperPod Inference
Use HyperPod Inference when you need Kubernetes-native control over distributed GPU infrastructure. You can use the AWS managed JumpStart container configuration or deploy Beam with SGLang or vLLM. The HyperPod Inference deployment sample README and its configuration files are the source of truth for released manifests, model and image identifiers, supported runtime versions, and commands.
Before you begin, configure kubectl access to an EKS-orchestrated HyperPod cluster with the HyperPod Inference Operator and required add-ons. You also need the cluster virtual private cloud (VPC), subnets, security groups, access to the selected Beam and runtime artifacts, and local NVMe capacity if you enable model caching. Use an isolated Hugging Face access token if the selected repository requires authentication.
Deploy a pinned Beam revision from Hugging Face Hub for development and experimentation. For production deployments and model caching, copy the checkpoint to Amazon S3 or Amazon FSx. HyperPod model and image caching can preload weights onto node-local NVMe storage and pre-pull the serving image.
The next diagram expands the model preparation and runtime request flow. When model caching is enabled, the Inference Operator warms eligible nodes with the selected weights and serving image. At runtime, the Inference Gateway and Endpoint Picker can direct each request to a suitable JumpStart-managed, SGLang, or vLLM replica.
Figure 2: HyperPod model caching and request routing
Prepare deployment artifacts
Use immutable inputs so that you can reproduce deployment and performance results.
Use the JumpStart model release recorded in the deployment sample.
Choose the BF16, FP8, or NVFP4 checkpoint for a custom runtime.
For a custom runtime, keep the public Beam commit SHA and image digest in the sample release configuration.
Mirror the released image into a private Amazon Elastic Container Registry (Amazon ECR) repository only when your cluster cannot pull the upstream image or your organization requires an approved registry.
Keep tokens, generated secrets, private model IDs, registry credentials, and unpublished results out of the repository.
Choose a serving path
Start with SageMaker JumpStart unless your workload requires a specific inference runtime or configuration.
Serving path
Use it when
What you manage
SageMaker JumpStart
You want an AWS-managed container and model configuration with less runtime maintenance.
Select the Beam model version, supported instance type, endpoint configuration, and scaling policy.
SGLang or vLLM
You need a specific inference runtime or configuration, such as custom runtime arguments, parsers, quantization, or parallelism.
Pin the supported runtime image, model revision, parser configuration, and distributed execution settings.
Deploy with SageMaker JumpStart
SageMaker JumpStart reduces container integration work while HyperPod retains control over cluster capacity, scaling, and observability.
In SageMaker Studio, open the JumpStart model catalog.
Under All public models, choose Beam.
Choose SageMaker HyperPod as the deployment target.
Select the cluster and Kubernetes namespace.
Enter an endpoint name, and choose Deploy.
Confirm the deployment status before invoking the endpoint with the released JumpStart request schema.
For an infrastructure-as-code workflow, use the released JumpStart configuration in the HyperPod sample. You can inspect the reflection-beam-jumpstart.yaml manifest template before configuring the deployment.
Clone the sample repository, and enter the HyperPod Beam directory.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/
Create the local configuration files described in the README.
Replace sglang with vllm to use vLLM. The helper validates the selected settings, applies the rendered manifest without writing release values to disk, waits with a fixed timeout, and prints diagnostics if deployment fails.
Invoke Beam
Invoke JumpStart endpoints with the released model request schema. For SGLang or vLLM, use the bounded smoke test included in the HyperPod sample.
Run a private health check and short request with the recommended starting sampling settings.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
Replace sglang with vllm for a vLLM deployment. The helper selects a ready worker, opens a temporary port-forward, checks endpoint health, sends the request, and closes the port-forward.
The response resembles the following:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
For an authenticated Inference Gateway, use the bearer-token procedure in the HyperPod sample README. Keep credentials out of source code, manifests, and command history.
Measure and tune performance
Test each serving path with repeated, representative coding and tool-use requests at the expected concurrency.
Record the Beam model version, image digest, instance type, precision, context length, parallelism, serving arguments, cache state, and test repetitions.
Measure request success rate, p50 and p95 time to first token, time per output token, end-to-end latency, and aggregate output tokens per second.
Tune batch size, KV cache allocation, replica count, autoscaling, and model and image caching from those results.
Recheck output quality after changing precision or quantization.
Clean up
Delete resources when you finish testing to avoid ongoing charges.
For a SageMaker JumpStart real-time endpoint, follow the cleanup instructions in the SageMaker JumpStart deployment sample README.
For JumpStart, SGLang, or vLLM on Amazon SageMaker HyperPod Inference, follow the cleanup instructions in the HyperPod Inference deployment sample README.
Delete a dedicated HyperPod or Amazon EKS cluster created for the walkthrough.
Delete unused cached weights, mirrored artifacts, load balancers, log groups, temporary IAM roles, and captured inference data.
Conclusion
Reflection Beam gives developers an open-weight model designed for agentic coding and multi-step tasks. Start with a SageMaker JumpStart real-time endpoint for a fully managed deployment. Use SageMaker HyperPod Inference with JumpStart when you need Kubernetes-native infrastructure control without managing the serving container, or choose SGLang or vLLM when you need a custom runtime.