Mantenga la inferencia en ejecución a través de las insuficiencias de capacidad regionales con enrutamiento de inferencia entre regiones en Amazon SageMaker AI
Keep inference running through regional capacity shortfalls with cross-Region inference routing in Amazon SageMaker AI
Dmitry Soldatkin
Servir un modelo desde más de una región de AWS es un patrón bien establecido para inferencia de alta disponibilidad: cuando una región se queda sin capacidad de GPU, las solicitudes se mueven a otra. El patrón es simple de describir y difícil de operar. Hasta ahora, si servías modelos en puntos finales administrados de AI de Amazon SageMaker, la enrutamiento entre regiones era una pieza que todavía tenías que construir tú mismo.
Hoy, estamos introduciendo el enrutamiento de inferencia entre regiones en Amazon SageMaker AI. Utiliza un nuevo recurso, el enrutador de inferencia, que da a tu aplicación una sola ruta de invocación a través de los puntos finales y componentes de inferencia que ya ejecutas, en una o más regiones de AWS y cuentas de AWS. Registra los destinos que sirven un modelo, y tu aplicación invoca al enrutador en lugar de un punto final específico. El enrutador mantiene las solicitudes en su propia región mientras el destino local esté saludable, desvía nuevas solicitudes a otro destino registrado cuando no esté, y devuelve el tráfico gradualmente después de la recuperación.
Un punto final de SageMaker AI se ejecuta en una región de AWS y una cuenta. Cuando el autoscaling no puede agregar instancias del tipo que necesita tu punto final, las solicitudes se limitan y se agotan, incluso cuando el mismo modelo tiene capacidad de sobra en otra región. Para utilizar esa capacidad, tu aplicación debe detectar un punto final que está luchando y cambiar de región, decidir qué errores son seguros para volver a intentar sin ejecutar el modelo dos veces, mover el tráfico hacia atrás después de la recuperación sin fluctuar, y administrar el acceso a puntos finales en otras cuentas. Ese código se encuentra en la ruta crítica de cada solicitud, y cada equipo que sirve modelos en varias regiones mantiene su propia versión de él.
Cómo funciona el enrutamiento de inferencia entre regiones
El enrutamiento de inferencia entre regiones se basa en algunas ideas clave:
Tú decides dónde se ejecuta tu modelo – Para cada modelo, elegís qué endpoints y componentes de inferencia puede utilizar el enrutador.
SageMaker AI decide qué destino sirve cada solicitud – El enrutador prefiere su propia Región y cambia las nuevas solicitudes a otro destino solo cuando el local no puede servir de manera confiable.
Tus endpoints siguen siendo los mismos – Desplegás endpoints como lo haces hoy, con los mismos modelos, configuraciones, grupos de instancias y autoscaling. Las llamadas directas a InvokeEndpoint siguen funcionando, y el enrutador pasa InferenceId y CustomAttributes a través, como lo hace InvokeEndpoint.
Puedes ver cada decisión – Cada respuesta en tiempo real te dice qué destino sirvió la solicitud y por qué.
Algunos términos describen las piezas:
Enrutador de inferencia – Un recurso de SageMaker AI regional en tu cuenta que tu aplicación invoca.
Objetivo de enrutamiento – Un nombre para un modelo lógico en un enrutador, como fraud-model. Un enrutador puede contener muchos objetivos de enrutamiento, y cada uno falla de manera independiente de los demás.
Destino – Un endpoint en tiempo real, componente de inferencia o endpoint asíncrono registrado bajo un objetivo de enrutamiento, identificado por su nombre de recurso de Amazon (ARN) completo, que le indica al enrutador su Región y cuenta. Un objetivo de enrutamiento contiene destinos en tiempo real, que pueden combinar endpoints y componentes de inferencia en diferentes Regiones y cuentas, o solo endpoints asíncronos.
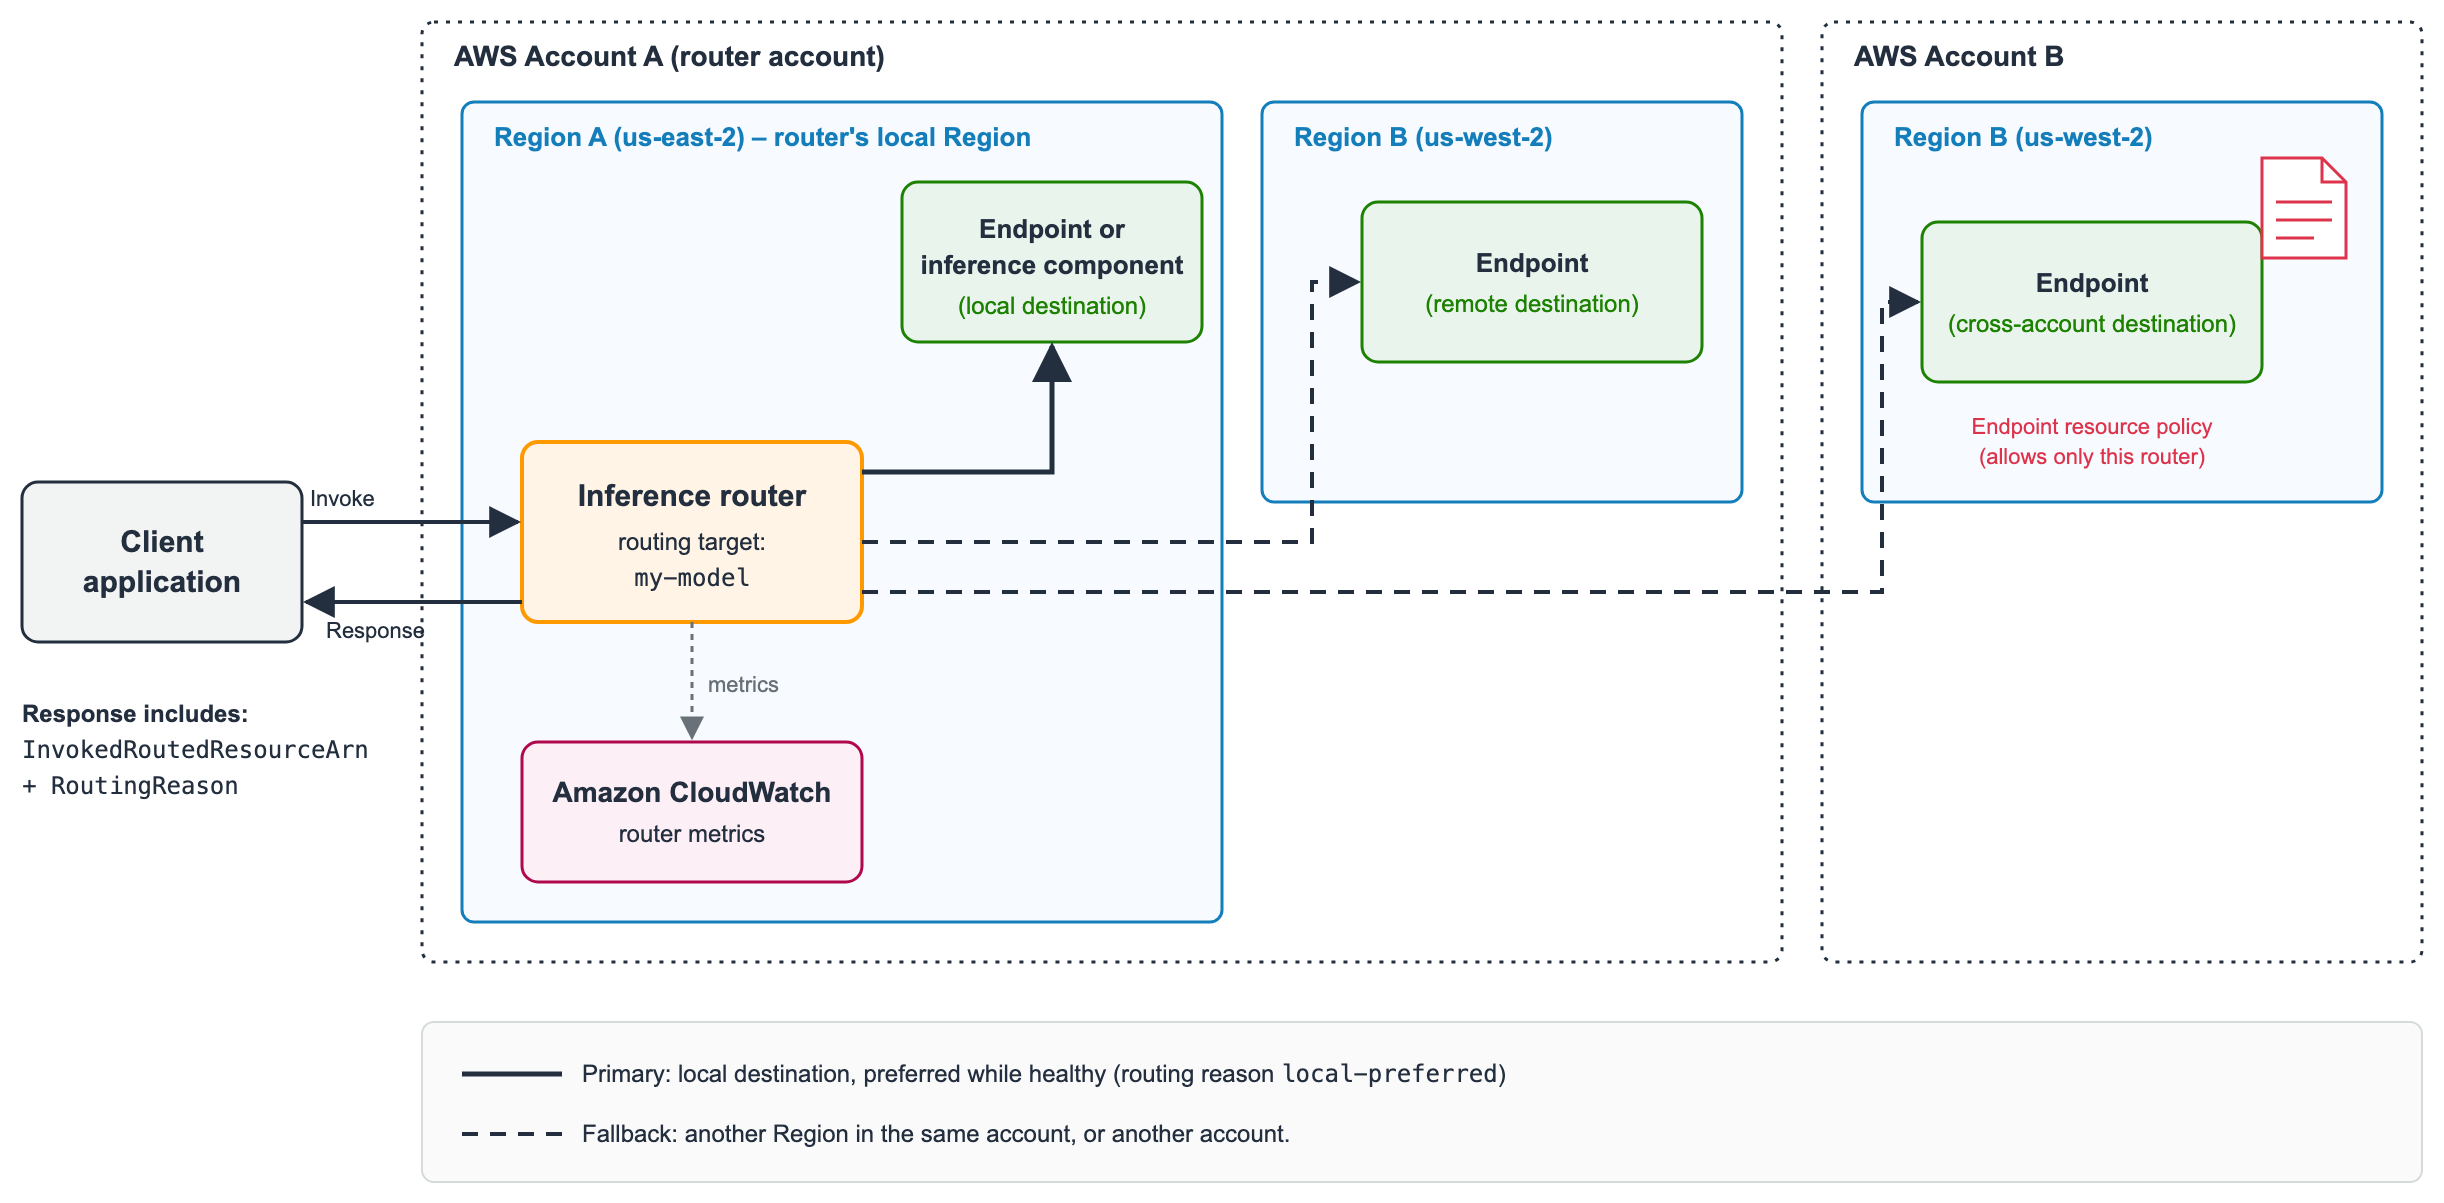
Destino local – Un destino en la Región del enrutador, preferido mientras esté saludable.
Razón de enrutamiento – Un valor devuelto con cada respuesta en tiempo real que explica a dónde fue la solicitud y por qué.
Figura 1: Cada solicitud va a un destino saludable, con el enrutador prefiriendo destinos en su propia Región
Cómo se toman las decisiones de enrutamiento
El enrutador considera solo los destinos que están registrados en el objetivo de enrutamiento y que está autorizado a invocar. Entre ellos, prefiere los destinos en su propia Región, y cuando más de un destino local es saludable, distribuye las solicitudes entre ellos de manera uniforme. Las solicitudes solo salen de la Región cuando los destinos locales no pueden servir de manera confiable. Para detectar esto, SageMaker AI calcula una puntuación de salud para cada destino a partir de sus solicitudes recientes, medidas en la Región del propio destino. Los errores del servidor (5xx), los limites de velocidad y los tiempos de espera reducen la puntuación. Los errores de la plataforma SageMaker AI (por ejemplo, una comprobación de salud fallida) la reducen aún más. Los errores causados por la propia solicitud, como una entrada inválida, no reducen la puntuación, porque la misma solicitud fallaría en cualquier Región. La latencia del modelo no es una entrada, por lo que un endpoint que sigue devolviendo respuestas exitosas mantiene su tráfico. Señales como lanzamientos de instancias fallidos o un endpoint que ejecuta menos instancias que su objetivo de escalado automático hacen que el enrutador reaccione más rápido, pero solo después de que el destino comience a fallar las solicitudes.
El enrutador evalúa la salud de cada destino y la publica en Amazon CloudWatch como uno de tres estados. Un destino healthy sirve normalmente. Un destino overloaded sigue sirviendo, y el enrutador mueve parte de su tráfico. Un destino degraded está fallando o no puede servir, por lo que el enrutador mueve la mayor parte de su tráfico y mantiene una pequeña parte para detectar la recuperación.
Figura 2: Cómo cada estado de salud de destino cambia el tráfico que el enrutador envía a él
SageMaker AI administra los umbrales y la temporización de conmutación por error, por lo que no necesitas ajustar ningún umbral. Si la información de salud de los destinos remotos se vuelve obsoleta, el enrutador mantiene el tráfico en su propia Región, por lo que una brecha en la supervisión nunca mueve el tráfico por sí sola.
Cuándo se mueve el tráfico y cuándo regresa
Cuanto más solicitudes fallan, más tráfico se mueve, por lo que un destino no necesita fallar directamente primero. El tráfico comienza a moverse dentro de aproximadamente un minuto de errores sostenidos, o más tiempo para un destino con poco tráfico. El tráfico que sale de la Región local se distribuye entre los destinos remotos saludables en proporción a su salud. No puedes establecer pesos ni un orden de respaldo. Después de la recuperación, el tráfico regresa en varios minutos, más lentamente de lo que salió. Las solicitudes en curso no se interrumpen.
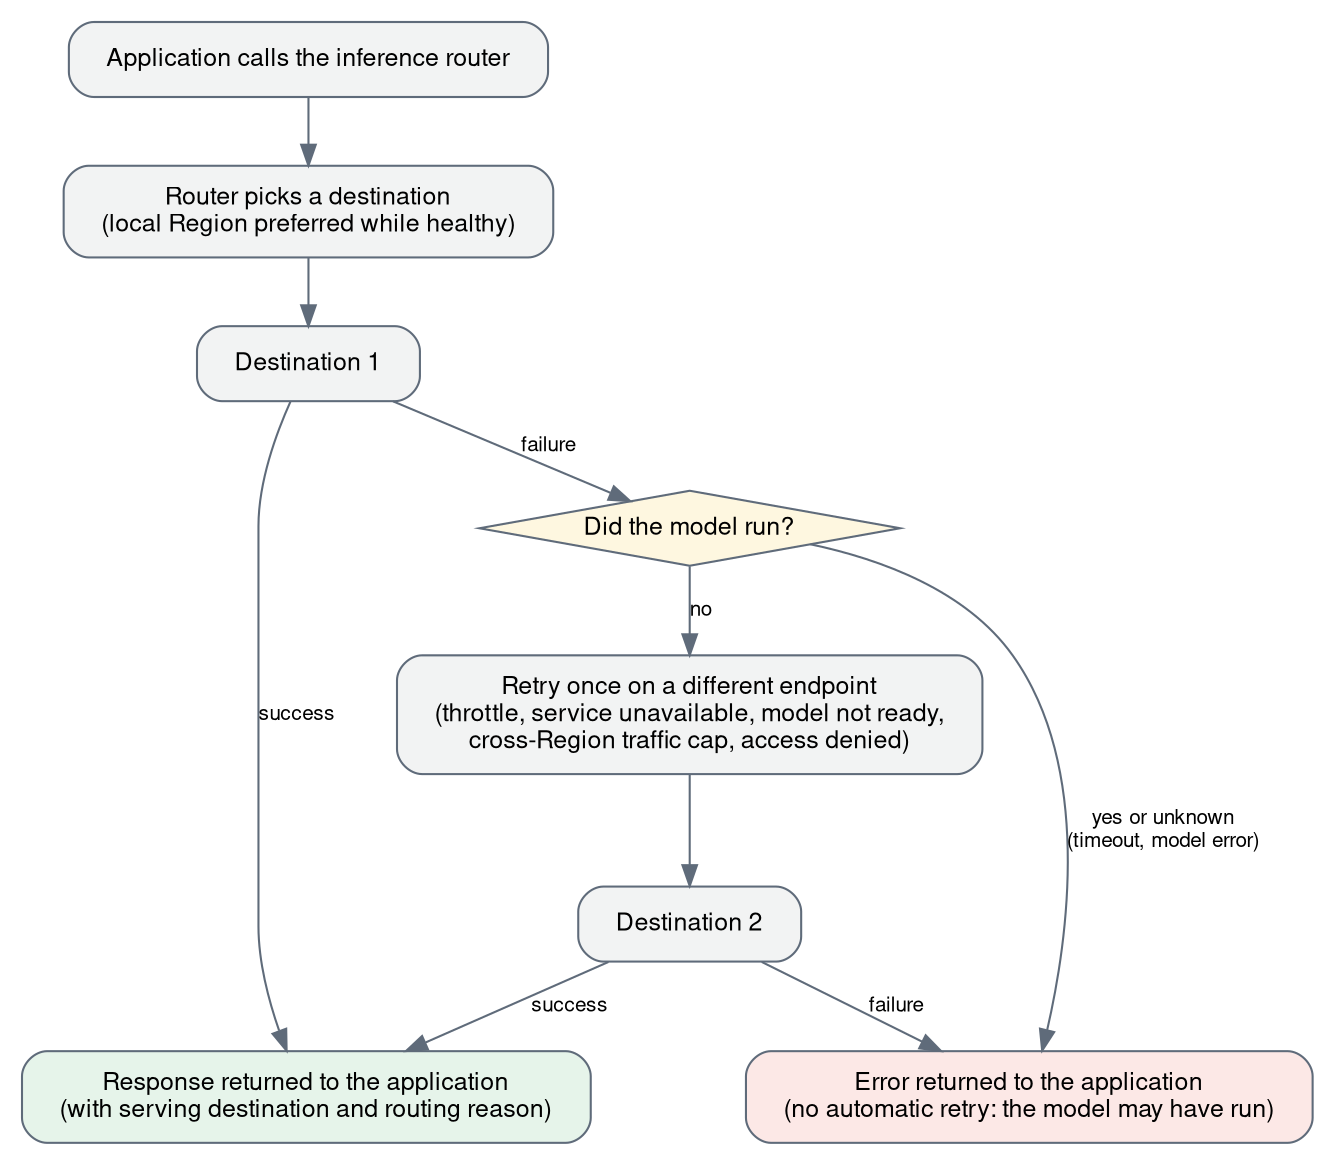
Cuando un destino falla una solicitud en tiempo real sin ejecutar el modelo, el enrutador reintenta esa solicitud una vez en un destino diferente. Esto cubre, por ejemplo, un estrangulamiento, un error 503, un modelo que no está listo, un rechazo por una limitación de tráfico entre regiones o acceso denegado por el destino. El enrutador nunca reintenta timeouts, errores 500 o errores de modelo.
Para solicitudes asíncronas, el enrutador intenta cada destino elegible una vez, primero los destinos locales, hasta que uno acepte la solicitud.
Figura 3: El enrutador reintenta una solicitud en tiempo real una vez en otro destino, y solo cuando el modelo no se ejecutó
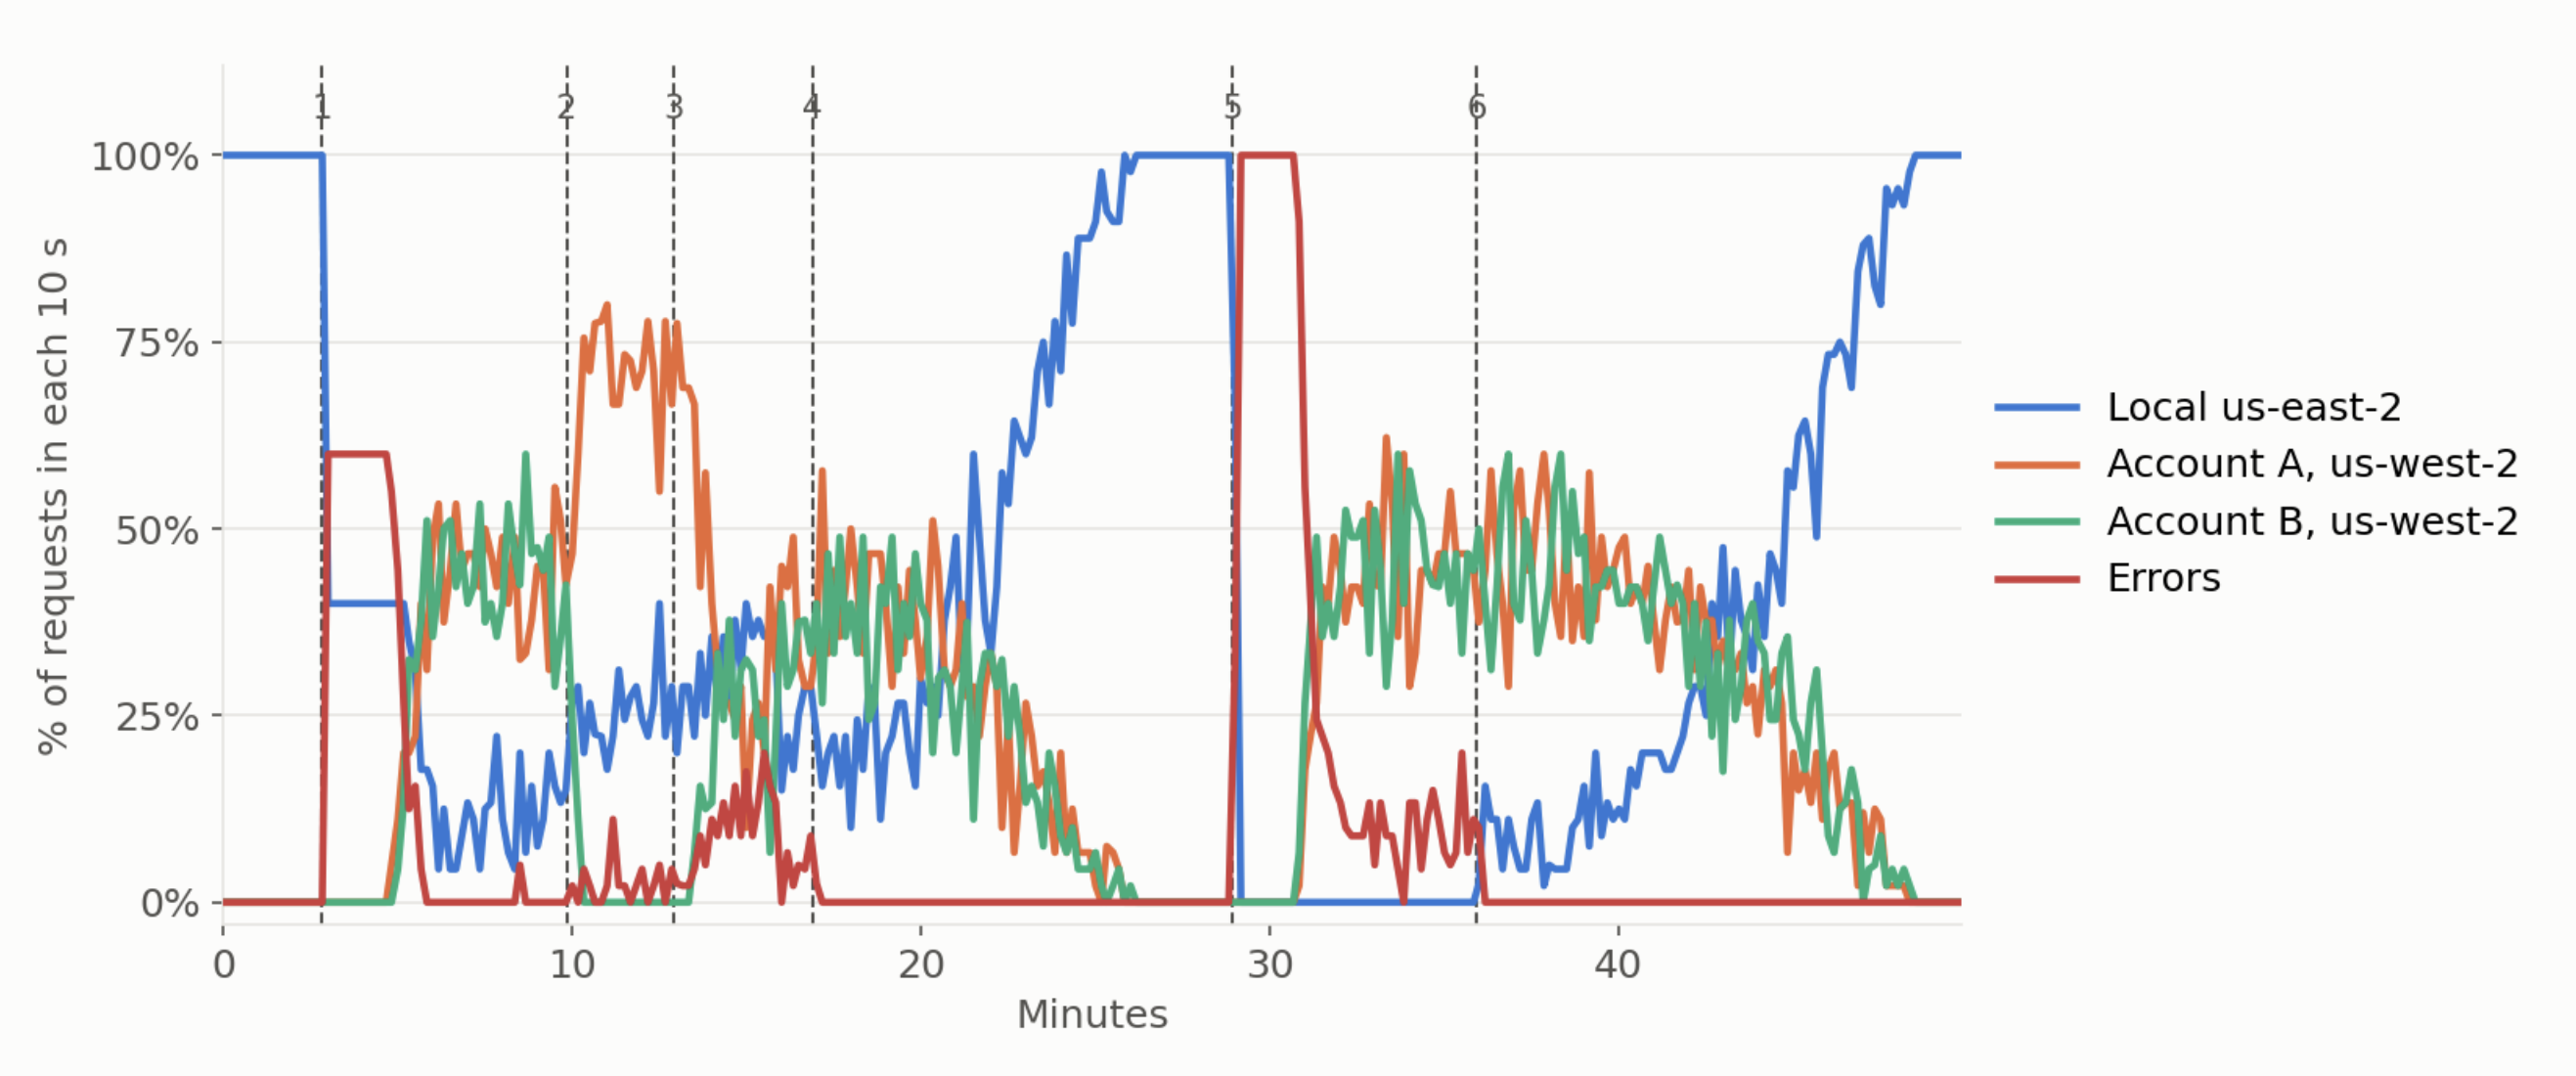
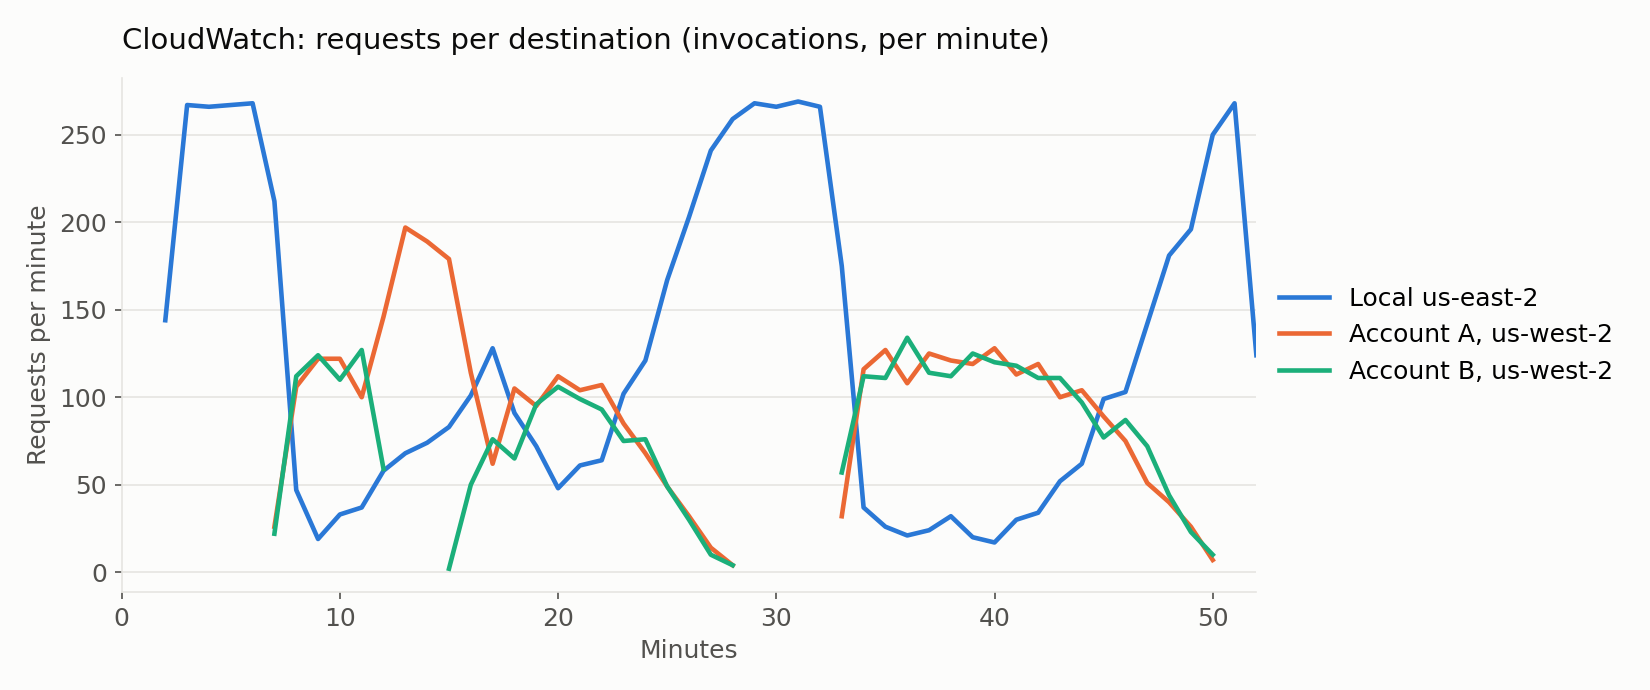
La Figura 4 muestra dónde se atendieron las solicitudes en una de nuestras pruebas con un modelo de prueba.
Figura 4: Dónde se atendieron las solicitudes mientras el punto de conexión local estaba sobrecargado, un destino en otra cuenta perdió y recuperó acceso, y el punto de conexión local se recuperó
Qué puedes enrutar
Los siguientes casos de uso muestran formas comunes de utilizar el enrutamiento de inferencia entre regiones en Amazon SageMaker AI.
Mantener el servicio cuando una región se queda sin capacidad de GPU. Cuando su tipo de instancia de la serie G se queda sin capacidad en EE. UU. Este (Ohio) durante el tráfico pico y las solicitudes comienzan a limitarse, el enrutador desvía las nuevas solicitudes al mismo modelo en EE. UU. Oeste (Oregón), donde el escalado automático absorbe el exceso, y mueve el tráfico hacia atrás gradualmente después de que EE. UU. Este (Ohio) se recupere.
Enrutar a través de puntos de conexión propiedad de cuentas de AWS separadas. Cuando una cuenta de plataforma central es propietaria del enrutador y otras cuentas son propietarias de los puntos de conexión, cada propietario de punto de conexión otorga acceso a un enrutador con nombre, y las solicitudes llegan a esos puntos de conexión solo a través de ese enrutador. Cubriremos la configuración después de esta lista.
Servir muchos modelos desde un enrutador. Cree un enrutador con un objetivo de enrutamiento por modelo, cada uno enumerando los destinos de ese modelo, y pase el nombre del objetivo de enrutamiento en cada solicitud. Cada modelo falla de forma independiente.
Poner el enrutador detrás de su propia puerta de enlace. Si opera una puerta de enlace de API o modelo, puede apuntar la integración de SageMaker AI de su puerta de enlace al enrutador, para que SageMaker AI maneje la selección de región para los modelos alojados en SageMaker mientras su puerta de enlace decide cuándo usar un proveedor diferente. Por ejemplo, consulte el post de Salesforce.
Enrutar solicitudes asíncronas. Los puntos de conexión asíncronos, en la cuenta del enrutador o en otras cuentas, pueden ser destinos. Su aplicación llama a InvokeInferenceRouterAsync con el nombre del objetivo de enrutamiento y la ubicación de entrada de Amazon Simple Storage Service (Amazon S3), y obtiene un InferenceId y las ubicaciones de salida y falla, como con InvokeEndpointAsync.
Proteger un punto de conexión de recepción del exceso de otras regiones. En un punto de conexión en tiempo real, puede establecer un límite de tráfico entre regiones opcional para que las solicitudes de otras regiones solo puedan utilizar una parte de su capacidad. Los llamadores locales de su punto de conexión conservan el resto. Cubriremos los detalles más adelante en esta sección.
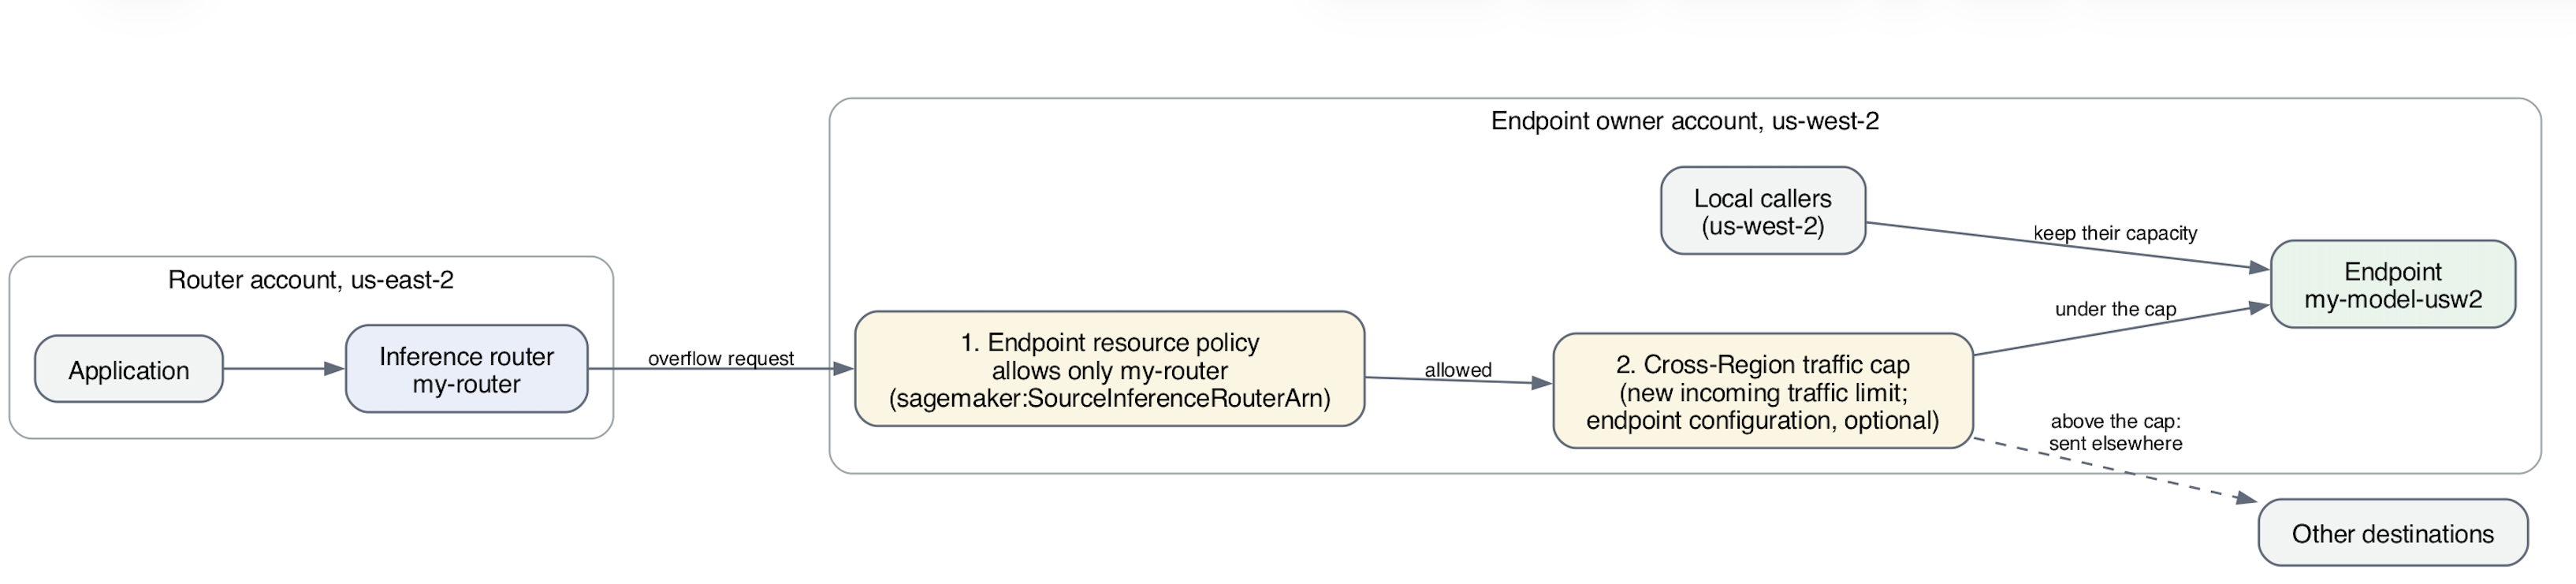
Cuando un destino pertenece a una cuenta diferente a la del enrutador, ambas cuentas deben permitir cada solicitud. En el lado del punto de conexión, el propietario adjunta una política basada en recursos que permite que la cuenta del enrutador invoque el punto de conexión, y la clave de condición sagemaker:SourceInferenceRouterArn limita ese acceso a un enrutador con nombre. La siguiente política permite que solo my-router en la cuenta 444455556666 invoque el punto de conexión. Su segunda declaración no tiene condición de enrutador y permite que la cuenta del enrutador lea el estado del punto de conexión. Sin esa declaración, el destino muestra su estado como desconocido.
En la cuenta del enrutador, los llamadores necesitan sagemaker:InvokeInferenceRouter (o sagemaker:InvokeInferenceRouterAsync) en el enrutador y sagemaker:InvokeEndpoint (o sagemaker:InvokeEndpointAsync) en cada destino, porque el enrutador invoca cada destino en nombre del llamador. Un enrutador nunca da a un llamador acceso a un endpoint que no pudiera llamar directamente. Para que DescribeInferenceRouter informe el estado de cada destino, los llamadores también necesitan sagemaker:DescribeEndpoint en los endpoints y sagemaker:DescribeInferenceComponent en los componentes de inferencia. Las aplicaciones en otras cuentas llaman al enrutador asumiendo un rol en la cuenta del enrutador. Para una guía paso a paso, consulte Cómo Salesforce está avanzando en la entrega de modelos a escala global con enrutamiento de inferencia entre regiones en Amazon SageMaker AI y Guía del usuario sobre destinos entre cuentas.
Figura 5: Controles que mantiene el propietario del endpoint: una política de endpoint que permite un enrutador con nombre y una capacidad de tráfico entre regiones opcional
Proteger un endpoint receptor con una capacidad de tráfico entre regiones
Cuando el enrutador mueve las solicitudes lejos de una región con poca capacidad, esas solicitudes aterrizan en endpoints que ya sirven a los llamadores de su propia región. Por defecto, un endpoint receptor acepta cualquier cantidad de tráfico entre regiones, por lo que un aumento de desbordamiento puede hacer que entre en estrangulamiento. Con una capacidad de tráfico entre regiones, el propietario del endpoint decide cuánta capacidad del endpoint pueden utilizar otras regiones.
Establece el límite en CreateEndpointConfig con CrossRegionTrafficConfig, que toma dos valores requeridos. MaxInvocationsPerSecondPerInstance es el número de invocaciones por segundo que una instancia puede tomar, que se mide con una prueba de carga de su modelo, tipo de instancia y carga típica de trabajo. MaxCrossRegionPercentPerEndpoint es la parte de esa capacidad que otras regiones pueden utilizar. SageMaker AI multiplica la tasa por instancia por las instancias en servicio y aplica el porcentaje, por lo que el límite sigue el escalado automático. Por ejemplo, con 50 invocaciones por segundo por instancia, un límite del 20 por ciento y 4 instancias en servicio, el punto de conexión acepta hasta 40 solicitudes por segundo de otras regiones. Cuando el escalado automático agrega 2 instancias, el límite aumenta a 60 solicitudes por segundo.
sm = boto3.client("sagemaker", region_name="us-west-2")
sm.create_endpoint_config(
    EndpointConfigName="my-model-config-us-west-2",
    ProductionVariants=[...],  # your existing variants, unchanged
    CrossRegionTrafficConfig={
        "MaxInvocationsPerSecondPerInstance": 50,
        "MaxCrossRegionPercentPerEndpoint": 20,
    },
)
Solo las solicitudes de otras regiones cuentan contra el límite. Las solicitudes de la región propia del punto de conexión, incluidas las llamadas directas InvokeEndpoint y las llamadas desde un enrutador en la misma región, nunca son limitadas por él. Cuando las solicitudes entre regiones exceden el límite, el punto de conexión rechaza las solicitudes adicionales antes de que se ejecute el modelo y el enrutador vuelve a intentar cada una en un destino diferente. Si ningún otro destino puede tomar la solicitud, la aplicación obtiene un error de limitación.
El límite se aplica a los puntos de conexión en tiempo real, y todos los componentes de inferencia en un punto de conexión comparten el mismo. Para un punto de conexión que hospeda componentes de inferencia, pruebe una instancia con su mezcla habitual de componentes de inferencia y cargas de trabajo para medir MaxInvocationsPerSecondPerInstance, y vuelva a ejecutar la prueba cuando cambie esa mezcla o sus cargas de trabajo. Si omite CrossRegionTrafficConfig, el punto de conexión acepta cualquier cantidad de tráfico entre regiones.
Comience: Un modelo en dos regiones
En este ejemplo, implementamos Qwen3-4B con el contenedor vLLM como un componente de inferencia en US East (Ohio) y US West (Oregon), en una cuenta. Dado que el enrutador de inferencia no admite la transmisión de respuestas, la aplicación envía solicitudes no de transmisión, y cada solicitud debe completarse en aproximadamente un minuto, el mismo límite que InvokeEndpoint. Luego creamos un enrutador en US East (Ohio) con un objetivo de enrutamiento que enumera ambos:
Ejecute DescribeInferenceRouter y confirme que el RoutingStatus de cada destino sea Routable antes de enviar tráfico.
La aplicación invoca el enrutador con el nombre del objetivo de enrutamiento y la misma carga de trabajo que enviaría a InvokeEndpoint, y lee el destino de servicio y la razón de enrutamiento de la respuesta:
RoutingStatus en DescribeInferenceRouter (us-east-2 / us-west-2)
Servido por
Razón de enrutamiento
Ambos componentes de inferencia en ejecución
Routable / Routable
us-east-2
local-preferred
Componente de inferencia de us-east-2 eliminado
Unroutable / Routable
us-west-2
only-healthy
Componente de inferencia de us-east-2 restaurado
Routable / Routable
us-west-2
only-healthy
Traffic de regreso en us-east-2
Routable / Routable
us-east-2
local-preferred
El tráfico se mantuvo en US East (Ohio) mientras su componente de inferencia estuvo en ejecución, se movió a US West (Oregon) sin cambios en la aplicación cuando lo eliminamos, y regresó después de restaurarlo.
La notebook completa para este ejemplo está disponible en GitHub.
Consejo: Utilice grupos de instancias y enrutamiento de inferencia entre regiones juntos. Con un grupo de instancias con capacidad, SageMaker AI puede utilizar otro tipo de instancia en la misma región durante la creación y el escalado. El enrutador mueve las nuevas solicitudes a otra región cuando el endpoint local en su conjunto no puede servir. Para obtener más detalles, consulte Inferencia con capacidad: conmutación automática de instancias para endpoints de SageMaker AI.
Vea a dónde fue cada solicitud
El enrutador de inferencia le ofrece dos vistas del enrutamiento: un registro de cada respuesta en tiempo real y métricas en CloudWatch.
Registro de enrutamiento por solicitud
Cada respuesta en tiempo real incluye el ARN del destino que sirvió la solicitud en InvokedRoutedResourceArn, y la razón de enrutamiento en RoutingReason. La razón de enrutamiento es una de las siguientes:
local-preferred – Servido por un destino saludable en la región del enrutador.
capacity-available – Servido por un destino con capacidad disponible.
failover – Alejado de un destino que no podía servir de manera confiable.
only-healthy – Servido por el único destino elegible que estaba saludable.
Recomendamos registrar ambos valores con los registros de solicitudes de su propia aplicación.
Las respuestas asíncronas no incluyen el destino de servicio. Las métricas del enrutador en CloudWatch muestran dónde se colocaron las solicitudes asíncronas.
Métricas del enrutador en CloudWatch
El enrutador publica métricas de OpenTelemetry en CloudWatch en su propia cuenta y región, etiquetadas con el enrutador, el objetivo de enrutamiento y el destino:
aws.sagemaker.inference_router.invocations – Solicitudes por destino, con una etiqueta error.type en caso de errores (invocation_4xx, invocation_5xx o invocation_model_error).
aws.sagemaker.inference_router.destination.duration – Tiempo en el destino, incluyendo su modelo.
aws.sagemaker.inference_router.overhead.duration – El trabajo propio del enrutador más el tiempo de red hacia y desde otra región.
aws.sagemaker.inference_router.destination.status – Cada destino como healthy, overloaded o degraded.
Figura 6: Solicitudes por destino desde la métrica de invocaciones de CloudWatch del enrutador durante la prueba mostrada en la Figura 4
Cada punto de conexión de destino sigue publicando sus métricas de SageMaker AI existentes en su propia cuenta y región. Para verlas en un solo lugar, use la observabilidad entre cuentas de CloudWatch y los paneles entre cuentas y entre regiones.
AWS CloudTrail registra las llamadas de API del enrutador (crear, actualizar, eliminar, describir y listar) como eventos de administración y las invocaciones del enrutador como eventos de datos. Habilita eventos de datos en su seguimiento como lo hace para otros eventos de datos de SageMaker AI.
Planifique su implementación
Tenga en cuenta lo siguiente al diseñar con el enrutador de inferencia:
Coloque el enrutador en la Región donde se origina la mayor parte de su tráfico. El enrutador siempre prefiere los destinos en su propia Región.
Dimensione cada Región para su propio tráfico más el desbordamiento que desea que absorba. De forma predeterminada, un punto de conexión receptor acepta cualquier cantidad de tráfico entre Regiones, así que configure el autoscaling con margen para el desbordamiento que espera. Para proteger a los llamadores locales de un punto de conexión, establezca un límite de tráfico entre Regiones, como se describe en Proteja un punto de conexión receptor con un límite de tráfico entre Regiones. Si todos los destinos remotos alcanzan su límite, las solicitudes que superan los límites combinados devuelven errores de limitación.
Mantenga una Región de respaldo de bajo costo. Puede registrar un componente de inferencia en otra Región y mantener su costo bajo, pero planifique cómo obtiene capacidad. Un componente de inferencia remoto con cero copias solo recibe una pequeña parte del tráfico durante el failover, y esas solicitudes fallan hasta que tenga copias. Mantenga al menos una copia en ejecución o configure el autoscaling en copias y confirme que se escala antes de que dependa de la Región de respaldo.
Planifique la resiliencia en el punto de entrada. Un enrutador es regional, por lo que si su Región se ve afectada, las llamadas a él fallan. Cree enrutadores en dos Regiones y cambie entre ellos en el lado del cliente.
Registre solo destinos donde se pueda procesar sus datos. Una solicitud se puede procesar en la Región del enrutador o en cualquier Región donde haya registrado un destino. Para los datos que deben permanecer en una geografía, use un enrutador separado, por ejemplo, uno para los datos de EE. UU. y otro para los datos de la UE. Es responsable de configurar sus enrutadores para que se ajusten a sus obligaciones de residencia y cumplimiento de datos.
Mantenga sus propias reintentos modestos. Un error de limitación significa que todos los destinos estaban ocupados, y un error de servicio no disponible significa que ningún destino podía aceptar la solicitud. Un error de servicio no disponible después de aproximadamente un minuto significa que la solicitud se agotó el tiempo de espera y es posible que el modelo se haya ejecutado, así que no la reintente automáticamente.
Elimine los destinos eliminados del enrutador. El tráfico ya evita un punto de conexión eliminado, pero el enrutador nunca elimina un destino por sí solo.
Llame al enrutador de forma privada. Las aplicaciones en una nube privada virtual (VPC) pueden llamar al enrutador a través de un punto de conexión de interfaz VPC (AWS PrivateLink), que admite IPv4 (no se admite IPv6/dual-stack).
También tenga en cuenta las siguientes limitaciones:
La transmisión de respuestas no es compatible.
Una solicitud en tiempo real que el destino no responde dentro de aproximadamente un minuto falla con un error de servicio no disponible.
Cada enrutador puede contener hasta 20 objetivos de enrutamiento, cada objetivo de enrutamiento puede contener hasta 10 destinos y las cargas de trabajo en tiempo real pueden ser de hasta 6 MB. Para conocer las cuotas predeterminadas, como los enrutadores por cuenta y las tasas de solicitud, y cómo solicitar un aumento, consulte Cuotas de servicio en la documentación de Amazon SageMaker AI.
Conclusión
El enrutamiento de inferencia entre regiones en Amazon SageMaker AI proporciona a su aplicación una ruta de invocación única a través de los puntos de conexión y los componentes de inferencia que ya ejecuta, en varias regiones de AWS y cuentas de AWS. El enrutador prefiere su propia región, cambia las nuevas solicitudes cuando un destino no puede servir de manera confiable, devuelve el tráfico gradualmente después de la recuperación y le muestra dónde se ejecutó cada solicitud y por qué. Sus puntos de conexión, modelos, contenedores y políticas de escalado automático no cambian.
El enrutamiento de inferencia entre regiones está disponible en general a partir de hoy en la mayoría de las regiones comerciales de AWS (excepto me-south-1 y me-central-1), para inferencia en tiempo real y asíncrona.
No hay cargos adicionales por el enrutamiento de inferencia entre regiones en Amazon SageMaker AI. Paga por los puntos de conexión y componentes de inferencia de SageMaker AI que atienden sus solicitudes a precios estándar de SageMaker AI, ya sea que una solicitud los alcance directamente o a través de un enrutador de inferencia. El enrutador de inferencia publica métricas en Amazon CloudWatch en la cuenta del enrutador, y paga las tarifas estándar de CloudWatch por esas métricas y cualquier consulta que ejecute sobre ellas. Para obtener más detalles, consulte Precios de Amazon SageMaker AI.
Serving a model from more than one AWS Region is a well-established pattern for highly available inference: when one Region runs short of GPU capacity, requests move to another. The pattern is simple to describe and hard to operate. Until now, if you served models on Amazon SageMaker AI managed endpoints, cross-Region routing was a piece you still had to build yourself.
Today, we’re introducing cross-Region inference routing in Amazon SageMaker AI. It uses a new resource, the inference router, that gives your application one invocation path across the endpoints and inference components you already run, in one or more AWS Regions and AWS accounts. You register the destinations that serve a model, and your application invokes the router instead of a specific endpoint. The router keeps requests in its own Region while the local destination is healthy, shifts new requests to another registered destination when it isn’t, and returns traffic gradually after recovery.
A SageMaker AI endpoint runs in one AWS Region and one account. When autoscaling can’t add instances of the type your endpoint needs, requests throttle and time out, even when the same model has spare capacity in another Region. To use that capacity, your application must detect a struggling endpoint and switch Regions, decide which errors are safe to retry without running the model twice, move traffic back after recovery without flapping, and manage access to endpoints in other accounts. That code sits on the critical path of every request, and every team serving models across Regions maintains its own version of it.
How cross-Region inference routing works
Cross-Region inference routing is based on a few core ideas:
You decide where your model might run – For each model, you choose which endpoints and inference components the router might use.
SageMaker AI decides which destination serves each request – The router prefers its own Region and shifts new requests to another destination only when the local one can’t serve reliably.
Your endpoints stay the same – You deploy endpoints as you do today, with the same models, configurations, instance pools, and autoscaling. Direct InvokeEndpoint calls keep working, and the router passes InferenceId and CustomAttributes through, as InvokeEndpoint does.
You can see every decision – Each real-time response tells you which destination served the request and why.
A few terms describe the pieces:
Inference router – A Regional SageMaker AI resource in your account that your application invokes.
Routing target – A name for one logical model on a router, such as fraud-model. A router can hold many routing targets, and each fails over independently of the others.
Destination – A real-time endpoint, inference component, or asynchronous endpoint registered under a routing target, identified by its full Amazon Resource Name (ARN), which tells the router its Region and account. A routing target holds either real-time destinations, which can mix endpoints and inference components across Regions and accounts, or asynchronous endpoints only.
Local destination – A destination in the router’s Region, preferred while it’s healthy.
Routing reason – A value returned with each real-time response that explains where the request went and why.
The Region you create the router in is its local Region. To prefer a different Region, create a router there. The router doesn’t create capacity, scale your endpoints, deploy models, or copy model artifacts and container images. Each destination must already be running in its Region.
Figure 1: Each request goes to a healthy destination, with the router preferring destinations in its own Region
How routing decisions are made
The router considers only destinations that are registered on the routing target and that it’s authorized to invoke. Among those, it prefers destinations in its own Region, and when more than one local destination is healthy, it spreads requests across them evenly. Requests leave the Region only when local destinations can’t serve reliably. To detect that, SageMaker AI calculates a health score for each destination from its recent requests, measured in the destination’s own Region. Server errors (5xx), throttles, and timeouts lower the score. Errors from the SageMaker AI platform (for example, failed health check) lower it the most. Errors caused by the request itself, such as invalid input, don’t lower it, because the same request would fail in any Region. Model latency isn’t an input, so an endpoint that keeps returning successful responses keeps its traffic. Signals such as failed instance launches or an endpoint running fewer instances than its autoscaling target make the router react faster, but only after the destination starts failing requests.
The router evaluates each destination’s health and publishes it to Amazon CloudWatch as one of three states. A healthy destination serves normally. An overloaded destination still serves, and the router moves part of its traffic away. A degraded destination is failing or can’t serve, so the router moves most of its traffic away and keeps a small share to detect recovery.
Figure 2: How each destination health state changes the traffic the router sends to it
SageMaker AI manages failover thresholds and timing, so you don’t need to tune any thresholds. If health information for remote destinations goes stale, the router keeps traffic in its own Region, so a gap in monitoring never moves traffic on its own.
When traffic moves, and when it comes back
The more requests fail, the more traffic moves, so a destination need not fail outright first. Traffic starts to move within about a minute of sustained errors, or longer for a destination with little traffic. Traffic that leaves the local Region is spread across the healthy remote destinations in proportion to their health. You can’t set weights or a fallback order. After recovery, traffic returns over several minutes, more slowly than it left. Requests in progress aren’t interrupted.
When a destination fails a real-time request without running the model, the router retries that request once on a different destination. This covers, for example, a throttle, a 503 error, a model that isn’t ready, a rejection by a cross-Region traffic cap, or access denied by the destination. The router never retries timeouts, 500 errors, or model errors.
For asynchronous requests, the router tries each eligible destination once, local destinations first, until one accepts the request.
Figure 3: The router retries a real-time request once on another destination, and only when the model didn’t run
Figure 4 shows where requests were served in one of our tests with a test model.
Figure 4: Where requests were served as the local endpoint was overloaded, a destination in another account lost and regained access, and the local endpoint recovered
What you can route
The following use cases show common ways to use cross-Region inference routing in Amazon SageMaker AI.
Keep serving when one Region runs short of GPU capacity. When your G-series instance type runs short in US East (Ohio) during peak traffic and requests start to throttle, the router shifts new requests to the same model in US West (Oregon), where autoscaling absorbs the overflow, and moves traffic back gradually after US East (Ohio) recovers.
Route across endpoints owned by separate AWS accounts. When a central platform account owns the router and other accounts own the endpoints, each endpoint owner grants access to one named router, and requests reach those endpoints only through that router. We cover the setup after this list.
Serve many models from one router. Create one router with one routing target per model, each listing that model’s destinations, and pass the routing target name on each request. Each model fails over independently.
Put the router behind your own gateway. If you operate an API or model gateway, you can point its SageMaker AI integration at the router, so SageMaker AI handles Region selection for SageMaker-hosted models while your gateway decides when to use a different provider. For example, see the Salesforce post.
Route asynchronous requests. Asynchronous endpoints, in the router’s account or in other accounts, can be destinations. Your application calls InvokeInferenceRouterAsync with the routing target name and the Amazon Simple Storage Service (Amazon S3) input location, and gets back an InferenceId and the output and failure locations, as with InvokeEndpointAsync.
Protect a receiving endpoint from other Regions’ overflow. On a real-time endpoint, you can set an optional cross-Region traffic cap so that requests from other Regions can use only part of its capacity. Your endpoint’s local callers keep the rest. We cover the details later in this section.
When a destination belongs to a different account than the router, both accounts must allow each request. On the endpoint side, the owner attaches a resource-based policy that allows the router account to invoke the endpoint, and the sagemaker:SourceInferenceRouterArn condition key limits that access to one named router. The following policy allows only my-router in account 444455556666 to invoke the endpoint. Its second statement has no router condition and lets the router account read the endpoint’s status. Without that statement, the destination shows its status as unknown.
In the router account, callers need sagemaker:InvokeInferenceRouter (or sagemaker:InvokeInferenceRouterAsync) on the router and sagemaker:InvokeEndpoint (or sagemaker:InvokeEndpointAsync) on every destination, because the router invokes each destination on the caller’s behalf. A router never gives a caller access to an endpoint they couldn’t call directly. For DescribeInferenceRouter to report each destination’s status, callers also need sagemaker:DescribeEndpoint on endpoints and sagemaker:DescribeInferenceComponent on inference components. Applications in other accounts call the router by assuming a role in the router account. For a walkthrough, see How Salesforce is advancing global-scale model serving with cross-Region inference routing in Amazon SageMaker AI and User Guide on cross-account destinations.
Figure 5: Controls the endpoint owner keeps: an endpoint policy that allows one named router, and an optional cross-Region traffic cap
Protect a receiving endpoint with a cross-Region traffic cap
When the router moves requests away from a Region that’s short on capacity, those requests land on endpoints that already serve their own Region’s callers. By default, a receiving endpoint accepts any amount of cross-Region traffic, so a surge of overflow can push it into throttling. With a cross-Region traffic cap, the endpoint owner decides how much of the endpoint’s capacity other Regions might use.
You set the cap in CreateEndpointConfig with CrossRegionTrafficConfig, which takes two required values. MaxInvocationsPerSecondPerInstance is the number of invocations per second that one instance can take, which you measure with a load test of your model, instance type, and typical payload. MaxCrossRegionPercentPerEndpoint is the share of that capacity that other Regions might use. SageMaker AI multiplies the per-instance rate by the instances in service and applies the percentage, so the cap follows autoscaling. For example, with 50 invocations per second per instance, a 20 percent cap, and 4 instances in service, the endpoint accepts up to 40 requests per second from other Regions. When autoscaling adds 2 instances, the cap rises to 60 requests per second.
sm = boto3.client("sagemaker", region_name="us-west-2")
sm.create_endpoint_config(
    EndpointConfigName="my-model-config-us-west-2",
    ProductionVariants=[...],  # your existing variants, unchanged
    CrossRegionTrafficConfig={
        "MaxInvocationsPerSecondPerInstance": 50,
        "MaxCrossRegionPercentPerEndpoint": 20,
    },
)
Only requests from other Regions count against the cap. Requests from the endpoint’s own Region, including direct InvokeEndpoint calls and calls from a router in the same Region, are never throttled by it. When cross-Region requests exceed the cap, the endpoint rejects the extra requests before your model runs, and the router retries each one once on a different destination. If no other destination can take the request, your application gets a throttling error.
The cap applies to real-time endpoints, and all inference components on an endpoint share it. For an endpoint that hosts inference components, load test one instance with its usual mix of inference components and payloads to measure MaxInvocationsPerSecondPerInstance, and run the test again when that mix or your payloads change. If you leave out CrossRegionTrafficConfig, the endpoint accepts any amount of cross-Region traffic.
Get started: One model in two Regions
In this example, we deploy Qwen3-4B with the vLLM container as an inference component in US East (Ohio) and US West (Oregon), in one account. Because the inference router doesn’t support response streaming, the application sends non-streaming requests, and each request must complete within about a minute, the same limit as InvokeEndpoint. We then create a router in US East (Ohio) with one routing target that lists both:
Run DescribeInferenceRouter and confirm that each destination’s RoutingStatus is Routable before you send traffic.
The application invokes the router with the routing target name and the same payload it would send to InvokeEndpoint, and reads the serving destination and routing reason from the response:
RoutingStatus in DescribeInferenceRouter (us-east-2 / us-west-2)
Served by
Routing reason
Both inference components running
Routable / Routable
us-east-2
local-preferred
us-east-2 inference component removed
Unroutable / Routable
us-west-2
only-healthy
us-east-2 inference component restored
Routable / Routable
us-west-2
only-healthy
Traffic back in us-east-2
Routable / Routable
us-east-2
local-preferred
Traffic stayed in US East (Ohio) while its inference component ran, moved to US West (Oregon) with no change to the application when we removed it, and came back after we restored it.
The complete notebook for this example is available on GitHub.
Tip: Use instance pools and cross-Region inference routing together. With a capacity-aware instance pool, SageMaker AI can use another instance type in the same Region at creation and during scale-out. The router moves new requests to another Region when the local endpoint as a whole can’t serve. For details, see Capacity-aware inference: Automatic instance fallback for SageMaker AI endpoints.
See where each request went
The inference router gives you two views of routing: a record on every real-time response and metrics in CloudWatch.
Per-request routing record
Every real-time response includes the ARN of the destination that served the request in InvokedRoutedResourceArn, and the routing reason in RoutingReason. The routing reason is one of the following:
local-preferred – Served by a healthy destination in the router’s Region.
capacity-available – Served by a destination with available capacity.
failover – Moved away from a destination that couldn’t serve reliably.
only-healthy – Served by the only eligible destination that was healthy.
We recommend logging both values with your application’s own request logs.
Asynchronous responses don’t include the serving destination. Router metrics in CloudWatch show where asynchronous requests were placed.
Router metrics in CloudWatch
The router publishes OpenTelemetry metrics to CloudWatch in its own account and Region, labeled with the router, routing target, and destination:
aws.sagemaker.inference_router.invocations – Requests per destination, with an error.type label on failures (invocation_4xx, invocation_5xx, or invocation_model_error).
aws.sagemaker.inference_router.destination.duration – Time at the destination, including your model.
aws.sagemaker.inference_router.overhead.duration – The router’s own work plus network time to and from another Region.
aws.sagemaker.inference_router.destination.status – Each destination as healthy, overloaded, or degraded.
Figure 6: Requests per destination from the router’s CloudWatch invocations metric during the test shown in Figure 4
Each destination endpoint keeps publishing its existing SageMaker AI metrics in its own account and Region. To view them in one place, use CloudWatch cross-account observability and cross-account cross-Region dashboards.
AWS CloudTrail records the router’s API calls (create, update, delete, describe, and list) as management events and router invocations as data events. You enable data events on your trail as you do for other SageMaker AI data events.
Plan your deployment
Keep the following in mind when you design with the inference router:
Put the router in the Region where most of your traffic originates. The router always prefers destinations in its own Region.
Size each Region for its own traffic plus the overflow you want it to absorb. By default, a receiving endpoint accepts any amount of cross-Region traffic, so configure autoscaling with headroom for the overflow you expect. To protect an endpoint’s local callers, set a cross-Region traffic cap, as described in Protect a receiving endpoint with a cross-Region traffic cap. If every remote destination reaches its cap, requests beyond the combined caps return throttling errors.
Keep a low-cost standby Region. You can register an inference component in another Region and keep its cost low, but plan for how it gets capacity. A remote inference component with zero copies receives only a small share of traffic during failover, and those requests fail until it has copies. Keep at least one copy running, or configure autoscaling on copies and confirm that it scales out before you rely on the standby Region.
Plan for resilience at the entry point. A router is regional, so if its Region is impaired, calls to it fail. Create routers in two Regions and switch between them on the client side.
Register only destinations where your data might be processed. A request can be processed in the router’s Region or in any Region where you’ve registered a destination. For data that must stay in one geography, use a separate router, for example one for US data and one for EU data. You are responsible for configuring your routers to align with your data residency and compliance obligations.
Keep your own retries modest. A throttling error means every destination was busy, and a service-unavailable error means no destination could take the request. A service-unavailable error after about a minute means the request timed out and the model might have run, so don’t retry it automatically.
Remove deleted destinations from the router. Traffic already avoids a deleted endpoint, but the router never removes a destination on its own.
Call the router privately. Applications in a virtual private cloud (VPC) can call the router through an interface VPC endpoint (AWS PrivateLink), which supports IPv4 (IPv6/dual-stack not supported).
Also note the following limitations:
Response streaming isn’t supported.
A real-time request that the destination doesn’t respond to within about a minute fails with a service-unavailable error.
Each router holds up to 20 routing targets, each routing target holds up to 10 destinations, and real-time payloads can be up to 6 MB. For default quotas, such as routers per account and request rates, and how to request an increase, see Service Quotas in the Amazon SageMaker AI documentation.
Conclusion
Cross-Region inference routing in Amazon SageMaker AI gives your application one invocation path across the endpoints and inference components you already run, in multiple AWS Regions and AWS accounts. The router prefers its own Region, shifts new requests when a destination can’t serve reliably, returns traffic gradually after recovery, and shows you where each request ran and why. Your endpoints, models, containers, and autoscaling policies don’t change.
Cross-Region inference routing is generally available starting today in most commercial AWS Regions (except me-south-1 and me-central-1), for real-time and asynchronous inference.
There is no additional charge for cross-Region inference routing in Amazon SageMaker AI. You pay for the SageMaker AI endpoints and inference components that serve your requests at standard SageMaker AI pricing, whether a request reaches them directly or through an inference router. The inference router publishes metrics to Amazon CloudWatch in the router’s account, and you pay standard CloudWatch rates for those metrics and any queries you run on them. For details, see Amazon SageMaker AI pricing.