Administrado NVIDIA Dynamo en Amazon SageMaker HyperPod de inferencia
Managed NVIDIA Dynamo on Amazon SageMaker HyperPod Inference
Vinay Arora
Servir modelos de lenguaje grandes (LLM) de manera eficiente requiere memoria de GPU suficiente y una coordinación cuidadosa del procesamiento de prompts y la generación de tokens. Los pesos FP8 de GLM-5.3, por ejemplo, superan los 640 GB de memoria de GPU en una sola instancia de ml.p5.48xlarge, antes de considerar la caché KV y la sobrecarga de runtime. Los prompts largos también pueden ralentizar la generación de tokens cuando ambos comparten las mismas GPUs.
Amazon SageMaker HyperPod Inference ahora admite NVIDIA Dynamo, combinando las capacidades de inferencia distribuida de Dynamo con la administración de infraestructura de HyperPod para abordar estos desafíos. Dynamo es un framework de inferencia distribuida de código abierto que admite implementación multi-nodo, prefill y decodificación disagregados, y enrutamiento consciente de KV con motores como vLLM, SGLang y TensorRT-LLM. HyperPod admite estas implementaciones con redes de alta velocidad Elastic Fabric Adapter (EFA), programación de GPU coordinada y monitoreo y recuperación de salud de nodos. En esta publicación, ilustramos la implementación multi-nodo y disagregada a través de un ejemplo de implementación, compartimos resultados de benchmark y esbozamos las mejores prácticas para optimizar la inferencia en HyperPod.
Cómo funciona la integración
El complemento HyperPod Inference instala las definiciones de recursos personalizados de Dynamo y estos componentes de servicio y programación:
HyperPod Inference Operator administra la implementación de endpoint a través de un recurso personalizado InferenceEndpointConfig (IEC). Su sección dynamoSpec suministra la configuración de Dynamo.
Operador de Dynamo administra los recursos definidos en un DynamoGraphDeployment (DGD), incluyendo el frontend, los workers de modelo, los recuentos de réplicas y los requisitos de recursos.
Grovecoordina grupos relacionados de pods, incluyendo workers multi-nodo, y sus relaciones de escalado.
Los contenedores de aprendizaje profundo de AWS (DLC) proporcionan el runtime de Dynamo, mientras que el complemento administra las versiones de componentes integrados. Para adoptar una versión de Dynamo compatible, actualice el complemento.
Arquitectura de implementación
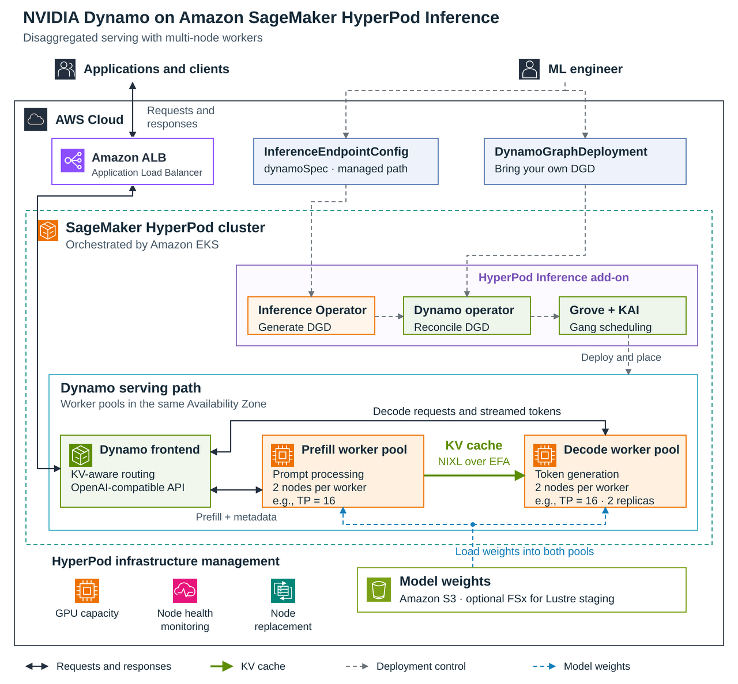
El siguiente diagrama muestra las rutas de implementación, los componentes de servicio y la administración de infraestructura para la inferencia disagregada en SageMaker HyperPod. El frontend de Dynamo enruta las solicitudes a los trabajadores de prellenado, que procesan las solicitudes, y a los trabajadores de decodificación, que generan tokens. Estos grupos separados permiten un escalado y ajuste independientes. Ambos grupos cargan los pesos completos del modelo, y la caché KV se transfiere entre ellos a través de EFA.
Dynamo también admite el servicio agregado, donde el prellenado y la decodificación se ejecutan en el mismo trabajador. En cualquiera de las topologías, los trabajadores pueden ejecutarse en una instancia o abarcar varias instancias utilizando paralelismo de tensor y pipeline. El enrutador consciente de KV de Dynamo considera el prefijo reusable de la caché KV y la carga activa del trabajador en ambas topologías. La reutilización de prefijos puede reducir la recomputación de solicitudes y mejorar el tiempo hasta el primer token, mientras que la conciencia de carga ayuda a evitar la sobrecarga de los trabajadores. Para obtener más detalles sobre la arquitectura de Dynamo, consulte la visión general de la base de conocimientos de Dynamo.
HyperPod proporciona monitoreo de salud de nodos, GPU y EFA, y administra el reemplazo de nodos, mientras que los componentes de orquestación recrean los trabajadores afectados. Las implementaciones configuradas a través de InferenceEndpointConfig con dynamoSpec admiten la invocación a través de puntos finales de SageMaker.
Figura 1: Rutas de implementación, componentes de servicio y administración de infraestructura para NVIDIA Dynamo en Amazon SageMaker HyperPod Inference
Dos formas de configurar su implementación
Ya sea que sea nuevo en HyperPod, nuevo en Dynamo o ambos, la extensión ofrece dos rutas de implementación para adaptarse a su flujo de trabajo:
Bring-your-own DynamoGraphDeployment (DGD) permite a los usuarios existentes de Dynamo continuar utilizando la documentación, las recetas y los manifiestos de upstream, con el operador de Dynamo que administra la implementación. Para llevar una DGD existente a HyperPod, use una imagen de contenedor compatible y configure el almacenamiento, la red y la colocación de pods para su cluster.
InferenceEndpointConfig con dynamoSpec permite a los usuarios existentes de HyperPod Inference implementar un nuevo punto final de Dynamo utilizando el mismo formato de configuración y la interfaz compatible con OpenAI que ya conocen. Para el motor de inferencia, puede elegir vLLM, SGLang o TensorRT-LLM, con vLLM utilizado de forma predeterminada. El operador también proporciona valores predeterminados para enrutamiento consciente de KV y recuentos de réplicas.
Ambos caminos admiten implementaciones de instancia única y multi-nodo. En cualquier caso, HyperPod administra la salud del nodo y su reemplazo. La tabla resume las responsabilidades de cada camino.
Bring-your-own DGD
InferenceEndpointConfig con dynamoSpec
Escribe
Manifest completo de DGD
IEC que contiene dynamoSpec
Mejor para
Equipos que desean control directo del grafo de servicio o reutilización de DGD existentes
Equipos que desean configuración de punto final administrada a través de IEC
Pesos del modelo
Configura la descarga o montaje de los pesos
El operador prepara los pesos desde Amazon Simple Storage Service (Amazon S3) o Amazon FSx
Punto final, TLS, registro
Configura y administra estos recursos
Administrado a través del operador de inferencia de HyperPod
Autoscaling
Configura y administra la escalabilidad
Autoscaling de eventos de Kubernetes (KEDA) a través de autoScalingSpec para implementaciones agregadas y desagregadas
Ejemplo de implementación: GLM-5.3
Los siguientes extractos utilizan el camino de implementación de InferenceEndpointConfig (IEC) con vLLM en instancias ml.p5.48xlarge. Los ajustes específicos de Dynamo pertenecen a spec.dynamoSpec. La fuente del modelo y los ajustes del punto final se incluyen en el manifiesto completo.
Servicio agregado de varios nodos
Esta configuración ejecuta una réplica de modelo-trabajador en dos instancias (16 GPUs), con dos réplicas frontend para el manejo de solicitudes. Establecer dynamoSpec.frontend.routingMode en kv-aware activa el enrutamiento consciente de KV.
Aquí, spec.replicas controla la cantidad de réplicas de modelo-trabajador, mientras que frontend.replicas controla la cantidad de réplicas frontend.
Servicio desagregado de varios nodos
Reemplace aggregation bajo spec.dynamoSpec con el siguiente bloque disaggregation, manteniendo la configuración frontend precedente. Los recuentos de réplicas se establecen por separado para prellenado y decodificación. Este ejemplo ejecuta una réplica de prellenado y dos réplicas de decodificación, cada una abarcando dos instancias, para un total de seis instancias.
Aplicar el manifiesto completo con kubectl apply. El operador de inferencia de HyperPod hace que los pesos del modelo configurado estén disponibles para los workers y genera el DGD. Grove y KAI Scheduler coordinan la colocación para que los pods necesarios para cada worker multi-nodo se programen juntos.
Después de que el punto de conexión de SageMaker esté listo y configurado para completar conversaciones, los clientes pueden enviar una carga útil de solicitud compatible con OpenAI a través de la API de tiempo de ejecución de SageMaker:
Realizamos benchmarks de Dynamo en SageMaker HyperPod en dos modelos para comparar configuraciones de servicio.
Prefill y decodificación desagregada para Qwen3-235B
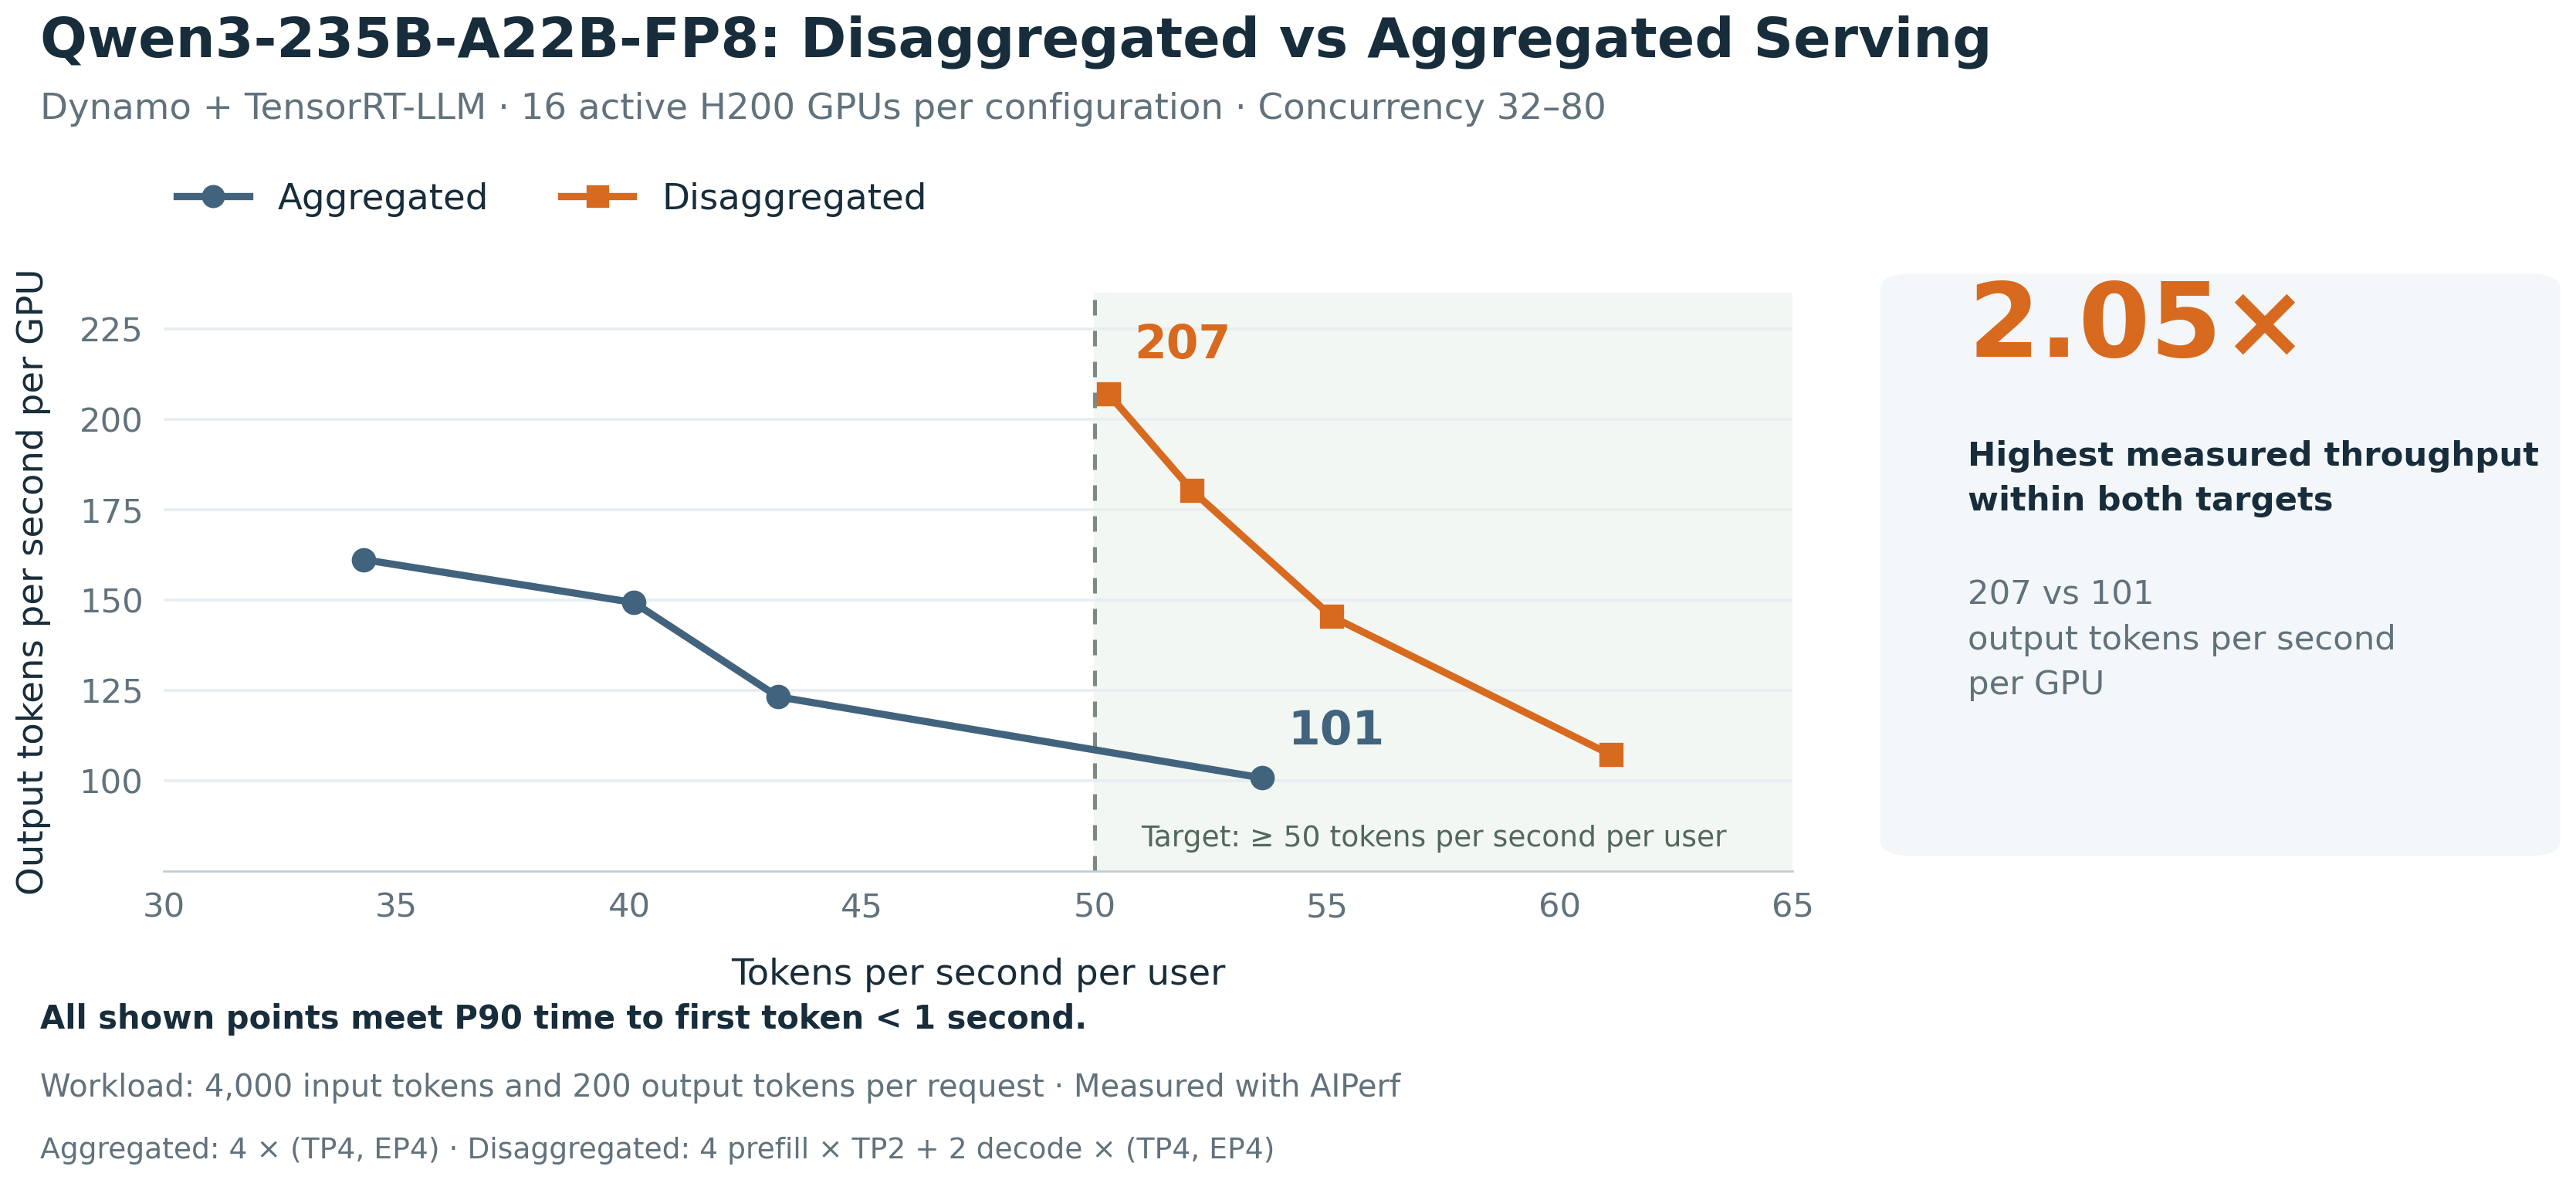
Utilizamos AIPerf para comparar el servicio agregado y desagregado para Qwen3-235B-A22B-FP8 utilizando Dynamo con TensorRT-LLM en dos instancias p5en.48xlarge (16 GPUs H200). Las solicitudes contenían 4,000 tokens de entrada y 200 tokens de salida. Mantuvimos los puntos medidos que cumplieron con dos objetivos: tiempo de primer token P90 por debajo de un segundo y velocidad de generación mediana de al menos 50 tokens por segundo por usuario. Entre estos puntos, el servicio desagregado logró 2,05 veces el rendimiento máximo agregado: 207 versus 101 tokens de salida por segundo por GPU, en concurrencia 80 y 32, respectivamente.
Figura 2: Rendimiento de servicio agregado en comparación con el servicio desagregado para Qwen3-235B-A22B-FP8
Servicio agregado multi-nodo para Qwen3.5-397B
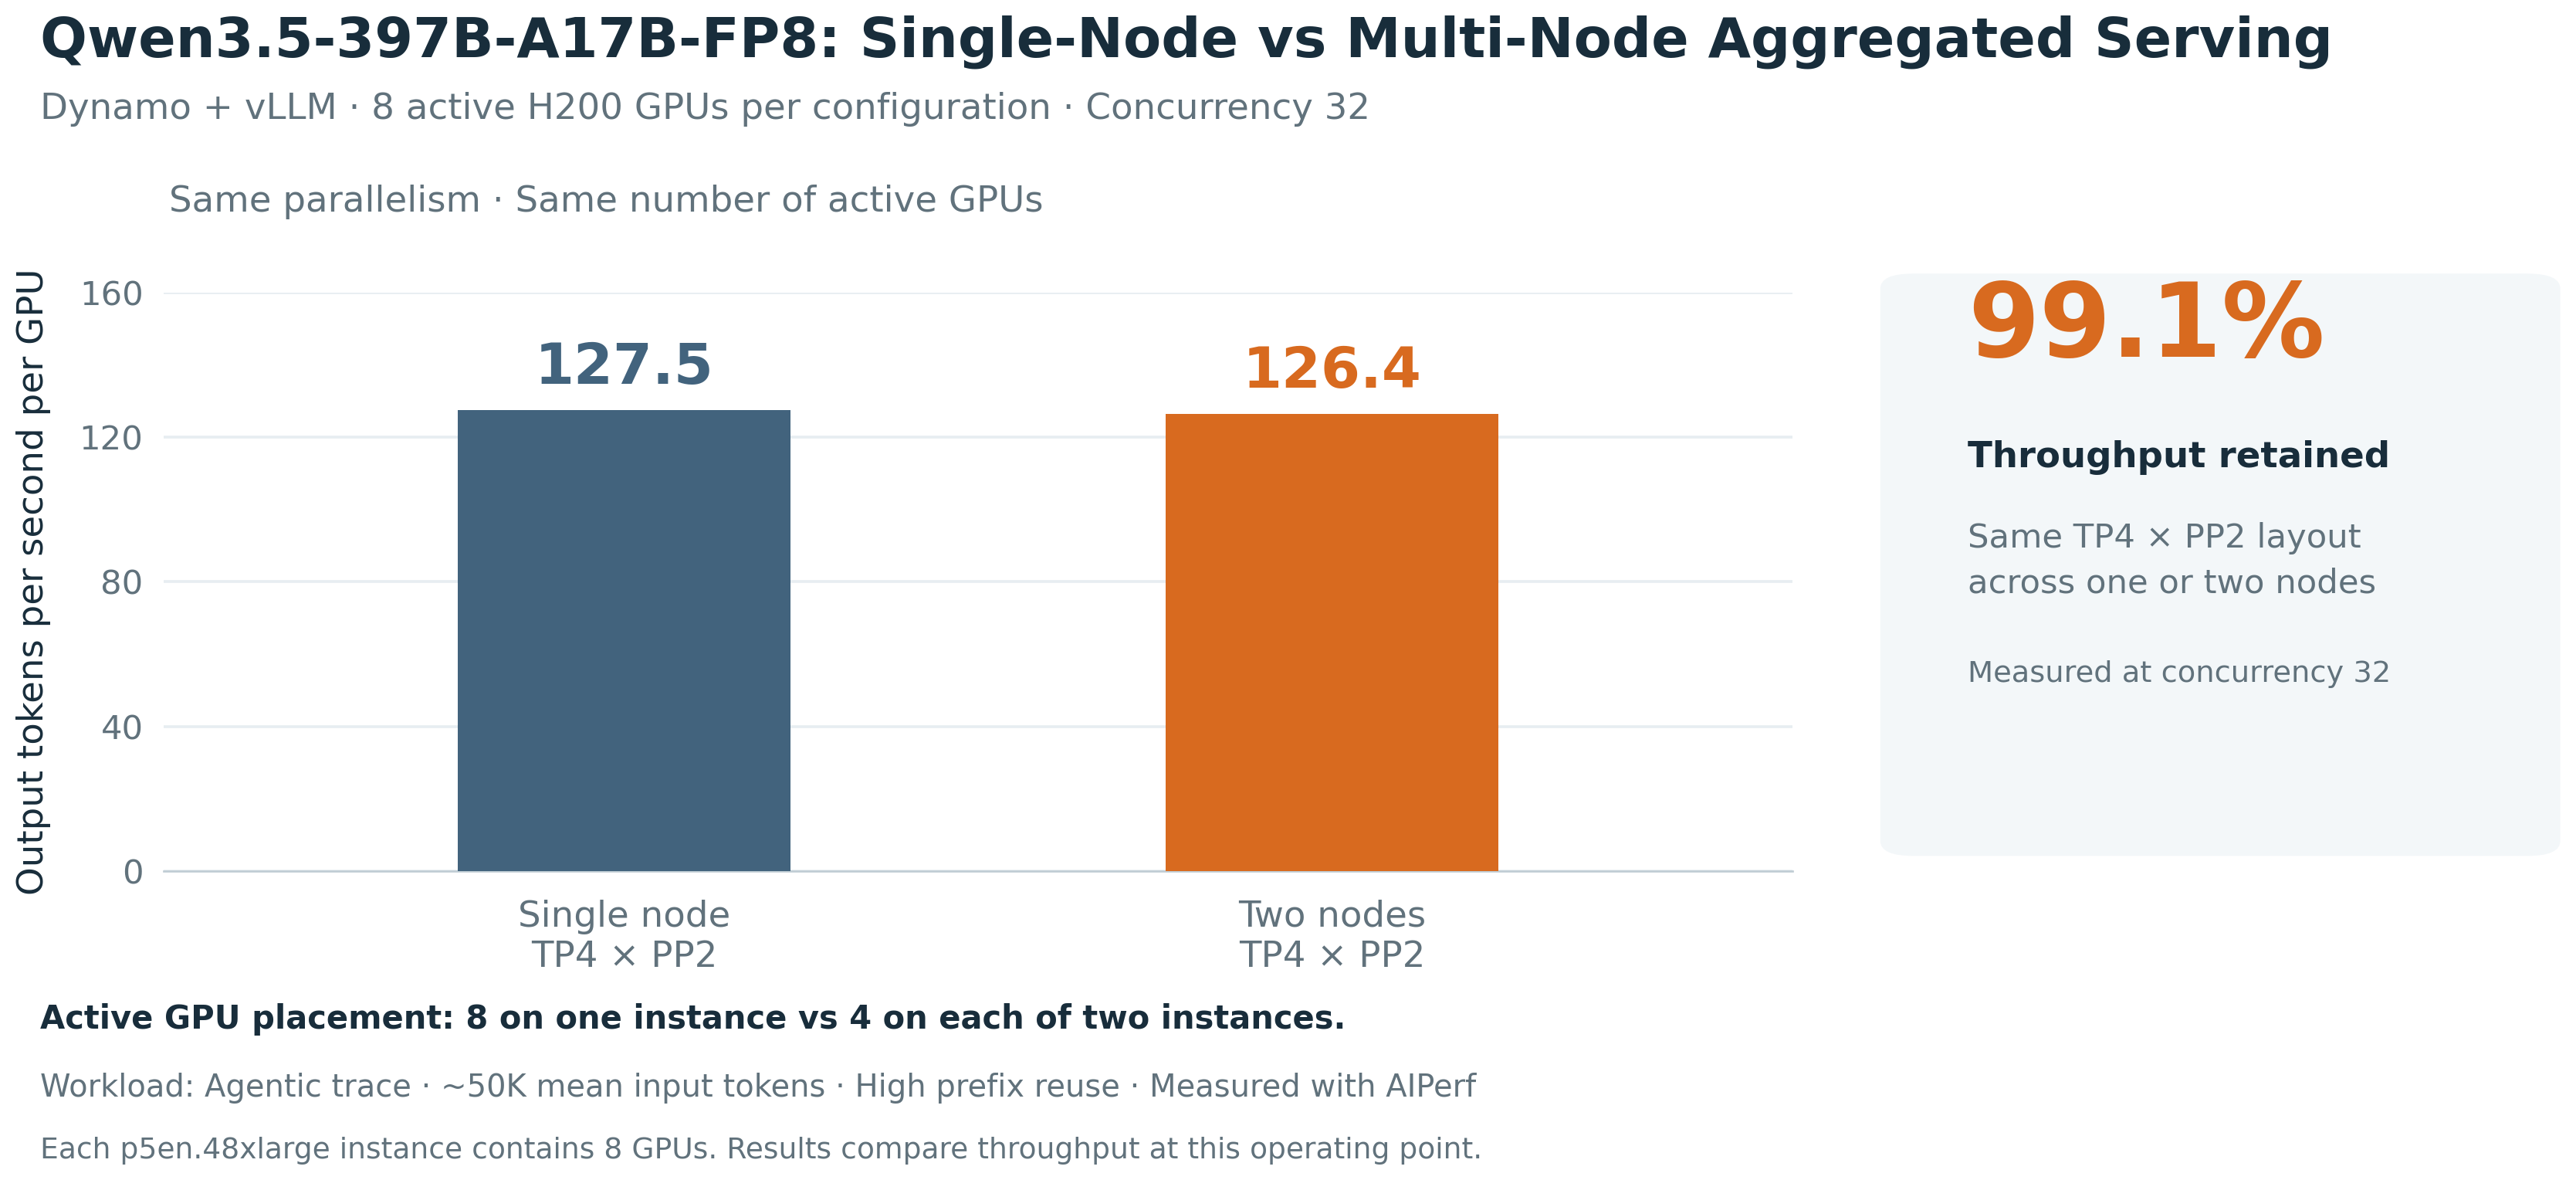
Dynamo admite el servicio multi-nodo en ambos modos agregados y desagregados para modelos que exceden la memoria de GPU de una sola instancia. Para evaluar un worker que abarca nodos, utilizamos AIPerf para realizar pruebas de rendimiento de servicio agregado multi-nodo para Qwen3.5-397B-A17B-FP8 con Dynamo y vLLM, utilizando TP4 × PP2 y ocho GPUs H200 activas. Este modelo cabe en una sola instancia, por lo que en la práctica no lo dividirías. Sirve aquí como una línea de base controlada. Comparamos ocho GPUs en un p5en.48xlarge con cuatro GPUs en cada una de dos instancias, utilizando el mismo modelo, paralelismo y configuración de carga de trabajo. Con una carga de trabajo agente que presenta un alto reuso de prefijo a una concurrencia de 32, la configuración de dos nodos entregó 126,4 tokens de salida por segundo por GPU, manteniendo el 99,1 por ciento del rendimiento de un solo nodo. Esto muestra que Dynamo en SageMaker HyperPod puede servir un modelo que necesita más de una instancia a través de los nodos. El límite del nodo en sí no se convierte en una penalización de rendimiento significativa.
Figura 3: Rendimiento de un solo nodo en comparación con el rendimiento de dos nodos para el servicio agregado multi-nodo de Qwen3.5-397B-A17B-FP8
Mejores prácticas para inferencia optimizada
NVIDIA Dynamo proporciona recetas y herramientas para ayudarlo a seleccionar una configuración de servicio, realizar pruebas de rendimiento y ajustar su implementación en SageMaker HyperPod.
Comience con una receta coincidente – Elija una receta de Dynamo para su modelo, motor de inferencia y tipo de GPU. Tenga en cuenta los pesos del modelo, la caché KV y la memoria de tiempo de ejecución al dimensionar los workers. Para configuraciones admitidas, AISimulate puede ayudar a comparar el servicio agregado y desagregado, elegir el paralelismo y dimensionar las piscinas de workers de prellenado y decodificación antes de probar en GPUs.
Verifique la comunicación antes de realizar pruebas de rendimiento – Para implementaciones que abarcan instancias, confirme que la comunicación utiliza el transporte EFA pretendido, incluidas las transferencias de caché KV entre workers de prellenado y decodificación. Consulte la guía de EFA de Dynamo.
Realice pruebas de rendimiento con tráfico representativo – Reproduzca su tráfico con AIPerf, o utilice una traza agente generada con longitudes de prompt representativas, longitudes de salida y reutilización de prefijo. Barra de concurrencia para cada configuración, retenga los puntos que cumplan con sus SLAs y elija en función de las prioridades de costo y latencia.
Ajuste a partir de cuellos de botella medidos – Ajuste la topología y la asignación de workers antes de los ajustes del motor, cambiando una variable a la vez. Siga la guía de ajuste de rendimiento, o utilice habilidades de agente de optimización de Dynamo para ayudar con las pruebas de rendimiento y el ajuste. Valide cada candidato en su implementación de HyperPod de destino.
Conclusión
NVIDIA Dynamo en SageMaker HyperPod Inference simplifica la implementación y operación de modelos grandes con servicio multi-nodo, prellenado y decodificación desagregados, y enrutamiento consciente de KV. El complemento administrado instala los componentes de servicio, y los valores predeterminados de configuración simplifican la configuración del punto de conexión. HyperPod administra los pesos del modelo, escalas automáticamente los clusters en función de las métricas de GPU y inferencia, supervisa la salud de los nodos y reemplaza los nodos fallidos. Conjuntamente, estas capacidades reducen el trabajo de infraestructura no diferenciado para que los equipos puedan centrarse en sus modelos y aplicaciones. Comience con las instrucciones de configuración y los ejemplos de implementación completos en el repositorio vinculado.
Reconocimientos
Los autores desean agradecer a Eliuth Triana, Felipe Garcia, Sanjana Checker, Junyuan Yang, Jiahong Liu, Anish Maddipoti, Jacob Kern y Abdullahi Olaoye de NVIDIA por sus contribuciones a esta publicación. También nos gustaría agradecer a Can Sun, Ophelia Yang, Aryaman Kothari, David Oh y Ayush Kumar de AWS por sus contribuciones.
Sobre los autores
Serving large language models (LLMs) efficiently requires sufficient GPU memory and careful coordination of prompt processing and token generation. GLM-5.3’s FP8 weights, for example, exceed the 640 GB of GPU memory on a single ml.p5.48xlarge instance, before accounting for KV cache and runtime overhead. Long prompts can also slow token generation when both share the same GPUs.
Amazon SageMaker HyperPod Inference now supports NVIDIA Dynamo, combining Dynamo’s distributed inference capabilities with the infrastructure management of HyperPod to address these challenges. Dynamo is an open source distributed inference framework that supports multi-node deployment, disaggregated prefill and decode, and KV-aware routing with engines such as vLLM, SGLang, and TensorRT-LLM. HyperPod supports these deployments with high-performance Elastic Fabric Adapter (EFA) networking, coordinated GPU scheduling, and node health monitoring and recovery. In this post, we illustrate multi-node and disaggregated serving through a deployment example, share benchmark results, and outline best practices for optimizing inference on HyperPod.
How the integration works
The HyperPod Inference add-on installs the Dynamo custom resource definitions and these serving and scheduling components:
HyperPod Inference Operator manages endpoint deployment through an InferenceEndpointConfig (IEC) custom resource. Its dynamoSpec section supplies the Dynamo configuration.
Dynamo operator manages resources defined in a DynamoGraphDeployment (DGD), including the frontend, model workers, replica counts, and resource requirements.
Grovecoordinates related groups of pods, including multi-node workers, and their scaling relationships.
Kubernetes AI (KAI) Schedulerplaces pods on GPU resources, using gang scheduling to schedule the pods required for a multi-node worker together.
AWS Deep Learning Containers (DLCs) provide the Dynamo runtime, while the add-on manages integrated component versions. To adopt a supported Dynamo release, update the add-on.
Deployment architecture
The following diagram shows the deployment paths, serving components, and infrastructure management for disaggregated inference on SageMaker HyperPod. The Dynamo frontend routes requests to prefill workers, which process prompts, and decode workers, which generate tokens. These separate pools allow independent scaling and tuning. Both pools load the full model weights, and KV cache transfers between them over EFA.
Dynamo also supports aggregated serving, where prefill and decode run in the same worker. In either topology, workers can run on one instance or span multiple instances using tensor and pipeline parallelism. Dynamo’s KV-aware router considers reusable prefix KV cache and active worker load in both topologies. Prefix reuse can reduce prompt recomputation and improve time to first token, while load awareness helps avoid overloading workers. For more details on the Dynamo architecture, see the Dynamo Knowledge Base overview.
HyperPod provides node, GPU, and EFA health monitoring and manages node replacement, while the orchestration components recreate affected workers. Deployments configured through InferenceEndpointConfig with dynamoSpec support invocation through SageMaker endpoints.
Figure 1: Deployment paths, serving components, and infrastructure management for NVIDIA Dynamo on Amazon SageMaker HyperPod Inference
Two ways to configure your deployment
Whether you are new to HyperPod, new to Dynamo, or both, the add-on offers two deployment paths to fit your workflow:
Bring-your-own DynamoGraphDeployment (DGD) lets existing Dynamo users continue using upstream documentation, recipes, and manifests, with the Dynamo operator managing the deployment. To bring an existing DGD to HyperPod, use a supported container image and configure storage, networking, and pod placement for your cluster.
InferenceEndpointConfig with dynamoSpec lets existing HyperPod Inference users deploy a new Dynamo endpoint using the same configuration format and OpenAI-compatible interface they already know. For the inference engine, you can choose vLLM, SGLang, or TensorRT-LLM, with vLLM used by default. The operator also supplies defaults for KV-aware routing and replica counts.
Both paths support single-instance and multi-node deployments. In either case, HyperPod manages node health and replacement. The table summarizes the responsibilities for each path.
Bring-your-own DGD
InferenceEndpointConfig with dynamoSpec
You write
Complete DGD manifest
IEC containing dynamoSpec
Best for
Teams wanting direct control of the serving graph or reuse of existing DGDs
Teams wanting managed endpoint setup through IEC
Model weights
You configure downloading or mounting the weights
The operator stages weights from Amazon Simple Storage Service (Amazon S3) or Amazon FSx
Endpoint, TLS, registration
You configure and manage these resources
Managed through the HyperPod Inference Operator
Autoscaling
You configure and manage scaling
Kubernetes Event-driven Autoscaling (KEDA) through autoScalingSpec for aggregated and disaggregated deployments
Deployment example: GLM-5.3
The following excerpts use the InferenceEndpointConfig (IEC) deployment path with vLLM on ml.p5.48xlarge instances. Dynamo-specific settings belong under spec.dynamoSpec. Model source and endpoint settings are included in the complete manifest.
Multi-node aggregated serving
This configuration runs one model-worker replica across two instances (16 GPUs), with two frontend replicas for request handling. Setting dynamoSpec.frontend.routingMode to kv-aware turns on KV-aware routing.
Here, spec.replicas controls the number of model-worker replicas, while frontend.replicas controls the number of frontend replicas.
Multi-node disaggregated serving
Replace aggregation under spec.dynamoSpec with the following disaggregation block, keeping the preceding frontend configuration. Replica counts are set separately for prefill and decode. This example runs one prefill replica and two decode replicas, each spanning two instances, for a total of six instances.
Apply the complete manifest with kubectl apply. The HyperPod Inference Operator makes the configured model weights available to the workers and generates the DGD. Grove and KAI Scheduler coordinate placement so that the pods required for each multi-node worker are scheduled together.
After the SageMaker endpoint is ready and configured for chat completions, clients can send an OpenAI-compatible request payload through the SageMaker Runtime API:
We benchmarked Dynamo on SageMaker HyperPod across two models to compare serving configurations.
Disaggregated prefill and decode for Qwen3-235B
We used AIPerf to compare aggregated and disaggregated serving for Qwen3-235B-A22B-FP8 using Dynamo with TensorRT-LLM on two p5en.48xlarge instances (16 H200 GPUs). Requests contained 4,000 input tokens and 200 output tokens. We retained measured points that met two targets: P90 time to first token below one second, and median generation speed of at least 50 tokens per second per user. Among these points, disaggregated serving achieved 2.05× the highest aggregated throughput: 207 versus 101 output tokens per second per GPU, at concurrency 80 and 32, respectively.
Figure 2: Aggregated compared to disaggregated serving throughput for Qwen3-235B-A22B-FP8
Multi-node aggregated serving for Qwen3.5-397B
Dynamo supports multi-node serving in both aggregated and disaggregated modes for models that exceed a single instance’s GPU memory. To evaluate a worker spanning nodes, we used AIPerf to benchmark multi-node aggregated serving for Qwen3.5-397B-A17B-FP8 with Dynamo and vLLM, using TP4 × PP2 and eight active H200 GPUs. This model fits on one instance, so in practice you would not split it. It serves here as a controlled baseline. We compared eight GPUs on one p5en.48xlarge against four GPUs on each of two instances, using the same model, parallelism, and workload configuration. With an agentic workload featuring high prefix reuse at concurrency 32, the two-node configuration delivered 126.4 output tokens per second per GPU, retaining 99.1 percent of single-node throughput. This shows that Dynamo on SageMaker HyperPod can serve a model that needs more than one instance across nodes. The node boundary itself does not become a significant throughput penalty.
Figure 3: Single-node compared to two-node throughput for multi-node aggregated serving of Qwen3.5-397B-A17B-FP8
Best practices for optimized inference
NVIDIA Dynamo provides recipes and tools to help you select a serving configuration, benchmark performance, and tune your deployment on SageMaker HyperPod.
Start with a matching recipe – Choose a Dynamo recipe for your model, inference engine, and GPU type. Account for model weights, KV cache, and runtime memory when sizing workers. For supported configurations, AISimulate can help compare aggregated and disaggregated serving, choose parallelism, and size prefill and decode worker pools before testing on GPUs.
Verify communication before benchmarking – For deployments spanning instances, confirm that communication uses the intended EFA transport, including KV-cache transfers between prefill and decode workers. See the Dynamo EFA guide.
Benchmark representative traffic – Replay your traffic with AIPerf, or use a generated agentic trace with representative prompt lengths, output lengths, and prefix reuse. Sweep concurrency for each configuration, retain points meeting your SLAs, and choose based on cost and latency priorities.
Tune from measured bottlenecks – Adjust topology and worker allocation before engine settings, changing one variable at a time. Follow the performance tuning guide, or use Dynamo optimization agent skills to assist with benchmarking and tuning. Validate each candidate on your target HyperPod deployment.
Conclusion
NVIDIA Dynamo on SageMaker HyperPod Inference simplifies deploying and operating large models with multi-node serving, disaggregated prefill and decode, and KV-aware routing. The managed add-on installs the serving components, and configuration defaults simplify endpoint setup. HyperPod manages model weights, auto-scales clusters based on GPU and inference metrics, monitors node health, and replaces failed nodes. Together, these capabilities reduce undifferentiated infrastructure work so teams can focus on their models and applications. Get started with the setup instructions and complete deployment examples in the linked repository.
Acknowledgements
The authors would like to thank Eliuth Triana, Felipe Garcia, Sanjana Checker, Junyuan Yang, Jiahong Liu, Anish Maddipoti, Jacob Kern and Abdullahi Olaoye from NVIDIA for their contributions to this post. We also would like to thank Can Sun, Ophelia Yang, Aryaman Kothari, David Oh, and Ayush Kumar from AWS for their contributions.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.