Administración de costos de Amazon Bedrock de extremo a extremo: Un libro de jugadas para equipos de FinOps y plataforma
Managing Amazon Bedrock costs end to end: A playbook for FinOps and platform teams
Aswath Ram A Srinivasan
La gestión de costos para la inteligencia artificial generativa es una responsabilidad compartida entre los equipos que construyen aplicaciones y los equipos responsables del gasto en la nube. Muchos equipos comienzan comparando las tarifas de tokens por modelo y pidiendo a los equipos de aplicaciones que acorten las solicitudes. Esos pasos ayudan, pero no responden a las preguntas que los líderes de finanzas y ingeniería hacen a medida que se escalan el uso: ¿qué equipo gastó esto, en qué carga de trabajo y fue ese gasto dentro de un presupuesto aprobado?
Las cargas de trabajo agenticas hacen que esas preguntas sean más apremiantes. Un asistente conversacional típicamente emite una invocación de modelo por turno de usuario. Un flujo de trabajo agéntico, como un asistente de codificación de IA que planea un cambio, lee archivos, llama a herramientas y itera, emite muchas invocaciones por tarea y lleva un contexto más grande en cada una. El consumo de tokens, por lo tanto, se escala con el grado de autonomía que se otorga al flujo de trabajo y el tamaño del contexto que lleva, en lugar de con la cantidad de interacciones de usuario. Dado que el consumo es una función de cómo se diseña y opera una carga de trabajo, la gestión de costos para la inteligencia artificial generativa es una disciplina arquitectónica y operativa. Los promedios publicados son un pobre sustituto de sus propios números: use el AWS Pricing Calculator y la página de precios de Amazon Bedrock para modelar tarifas, y use el paso 2 de esta publicación para medir lo que sus cargas de trabajo realmente consumen.
La solución no es un modelo más barato o una solicitud más pequeña. Es un modelo operativo: un bucle repetible que atribuye cada dólar a un propietario, hace que cada solicitud sea observable, alerta y hace cumplir los presupuestos antes de que el gasto excedido se acumule, optimiza los valores predeterminados de la plataforma que impulsan la mayor parte del desperdicio y revisa todo el sistema con una cadencia.
En esta publicación, aprenderá a gestionar el costo de Amazon Bedrock en cinco pasos. Atribuirá cada dólar a un propietario, hará que cada solicitud sea observable, controlará el gasto con presupuestos y aplicación, optimizará los valores predeterminados de la plataforma que impulsan la mayor parte del gasto evitable y operará una cadencia de revisión que convierte los datos en decisiones. Este enfoque está construido a partir de bloques de construcción de AWS, y puede personalizarlo y aplicarlo a su propio entorno. La publicación está escrita para dos audiencias: practicantes de FinOps que poseen la atribución, la carga de trabajo, los presupuestos y la revisión de anomalías, y equipos de ingeniería de plataforma que poseen la registración, los metadatos de solicitud, la aplicación y los valores predeterminados de enrutamiento.
El modelo operativo en una sola vista
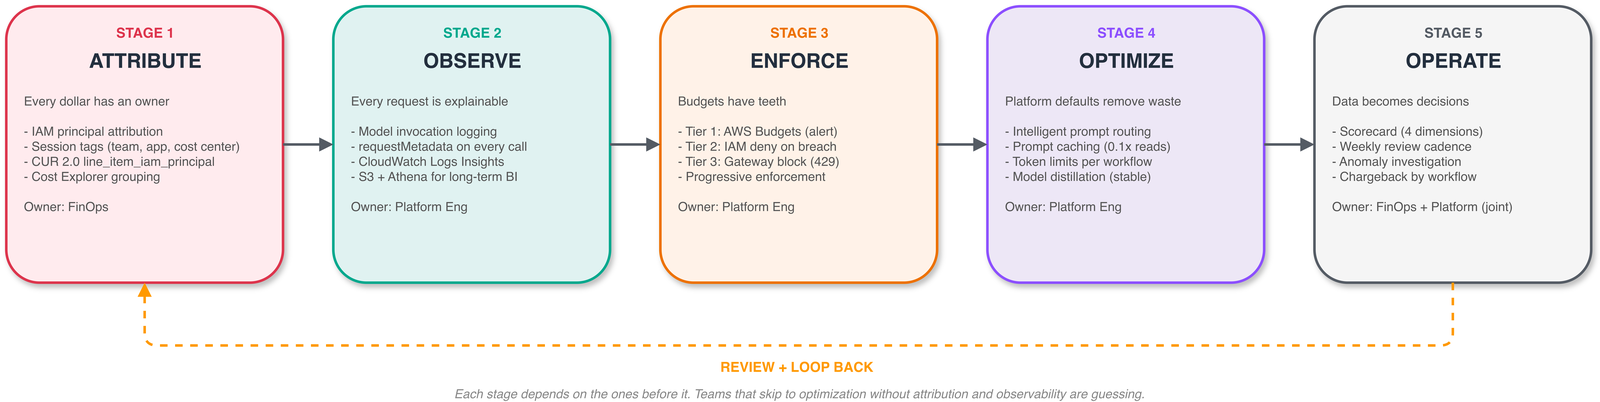
Cinco etapas, ejecutadas en forma de bucle. Atributo: cada dólar de Amazon Bedrock se asigna a una identidad, equipo y aplicación en la canalización de facturación. Observa: cada solicitud se registra con suficientes metadatos para explicar qué generó el gasto. Aplica: los presupuestos tienen consecuencias, con alertas como mínimo y bloques rigurosos donde el riesgo lo exige. Optimiza: las configuraciones predeterminadas de la plataforma (enrutamiento de modelos, almacenamiento en caché, límites de tokens) eliminan el desperdicio de manera centralizada en lugar de pedir a cada equipo que sea cuidadoso. Opera: una pequeña tarjeta de puntaje y una cadencia de revisión convierten los datos en decisiones. FinOps lidera las etapas uno y cinco. La ingeniería de plataforma lidera las etapas dos a cuatro. La revisión es conjunta. Las etapas están secuenciadas deliberadamente. Cada una depende de las anteriores, y los equipos que saltan directamente a la optimización sin atribución y observabilidad están adivinando.
Figura 1: El modelo de operación de cinco etapas, ejecutado como un bucle continuo
Etapa 1: Asignar cada dólar
No se puede gestionar lo que no se puede asignar, y todo lo que está corriente abajo (chargeback, presupuestos, aplicación, detección de anomalías) depende de esta etapa. La base es la atribución de costos granular de Amazon Bedrock (ver Introducción a la atribución de costos granular para Amazon Bedrock): Amazon Bedrock asigna automáticamente los costos de inferencia al principal de AWS Identity and Access Management (IAM) que realizó la llamada, en todos los modelos, sin recursos que gestionar. El ARN del llamador se coloca en la columna line_item_iam_principal del Informe de costos y uso de AWS (CUR) 2.0, y la cobertura abarca usuarios de IAM, roles, identidades federadas y claves de API.
La configuración consta de cuatro pasos:
Active los datos de principal de IAM en su exportación de datos de CUR 2.0.
Etiquete sus principales de IAM con dimensiones comerciales como equipo, aplicación y centro de costo. Para el acceso federado, configure su proveedor de identidad para pasar nombres de sesión y etiquetas a través de reclamos OIDC o SAML.
Active esas etiquetas como etiquetas de asignación de costos en la facturación de AWS (consola o la API UpdateCostAllocationTagsStatus).
Analice las etiquetas: aparecen en CUR 2.0 con un prefijo iamPrincipal/ (por ejemplo, iamPrincipal/team) y aparecen en AWS Cost Explorer bajo la categoría IAM dentro de las 24-48 horas después de la activación, listas para filtrar y agrupar por equipo, aplicación o centro de costo.
Esta es una atribución por identidad con facturación de grado de factura sin infraestructura personalizada.
El problema del rol compartido
El patrón que merece más atención es el problema del rol compartido, porque es donde la mayoría de las plataformas pierden silenciosamente la atribución. Un gateway de modelo de lenguaje grande (LLM) que llama a Amazon Bedrock a través de un solo rol de IAM atribuye cada dólar a ese rol, eliminando por completo la visibilidad por usuario. La solución es la administración de sesión por usuario. El gateway asume el rol de invocación de Amazon Bedrock una vez por usuario, pasando la identidad del usuario como nombre de sesión del rol y sus atributos como etiquetas de sesión, y luego almacena en caché esas credenciales durante hasta una hora (una llamada al servicio de token de seguridad de AWS (AWS STS) por usuario por hora, no por solicitud).
Esto requiere dos roles: un rol de ejecución de gateway que contenga los permisos sts:AssumeRole y sts:TagSession, y el rol de invocación de Amazon Bedrock que asume. El resultado es entradas line_item_iam_principal como assumed-role/BedrockRuntimeRole/gw-alex, cada una con las etiquetas del usuario: la atribución por usuario y por inquilino restaurada detrás de un gateway compartido.
import boto3

sts = boto3.client("sts")

# One call per user; cache the returned credentials up to 1 hour
response = sts.assume_role(
    RoleArn="arn:aws:iam::123456789012:role/BedrockRuntimeRole",
    RoleSessionName="gw-alex", # the user, not the gateway
    Tags=[
        {"Key": "team", "Value": "sales-ai"},
        {"Key": "application", "Value": "renewal-agent"},
        {"Key": "costCenter", "Value": "CC-2041"}
    ]
)
Una nota sobre perfiles de inferencia de aplicación y proyectos
Amazon Bedrock ofrece dos mecanismos de atribución adicionales, cada uno adecuado para un patrón diferente. Los perfiles de inferencia de aplicaciones son recursos precreados, por aplicación, en el endpoint bedrock-runtime que llevan etiquetas de asignación de costos. Crea un perfil por aplicación, por modelo y por región de AWS, y los llamadores hacen referencia al ARN del perfil, lo que se adapta a los equipos con un conjunto pequeño y estable de aplicaciones y modelos. Los proyectos y espacios de trabajo sirven al endpoint bedrock-mantle (API de respuestas, API de completaciones de chat). Un proyecto no está vinculado a un modelo específico, por lo que un solo ID de proyecto abarca muchos modelos, lo que se adapta a los equipos cuyo uso de modelos cambia con frecuencia. Pasa el ID del proyecto durante la inicialización del cliente y sus etiquetas fluyen hacia CUR 2.0 y Cost Explorer (ver Administrar costos de IA con proyectos de Amazon Bedrock). Los proyectos son la ruta de atribución para cargas de trabajo compatibles con OpenAI en Amazon Bedrock.
Para las cargas de trabajo bedrock-runtime, recomendamos la atribución de principal de IAM a través de etiquetas de sesión como mecanismo principal. Escala con su sistema de identidad, no requiere recursos precreados y cubre todos los modelos y operaciones de API. Los perfiles de inferencia de aplicaciones funcionan bien cuando un conjunto pequeño y estable de unidades comerciales necesita una separación de facturación de grado de factura sin cambios en el diseño de identidad. Utilice proyectos para las cargas de trabajo bedrock-mantle que utilicen la API de respuestas o la API de completaciones de chat.
Etapa 2: Hacer que cada solicitud sea observable
CUR te dice quién gastó. Los registros de invocación te dicen qué sucedió. Amazon Bedrock admite la registración de invocación de modelos de datos de solicitud, datos de respuesta y metadatos en Amazon CloudWatch Logs, Amazon Simple Storage Service (Amazon S3) o ambos. Utilice Amazon CloudWatch para consultas operativas rápidas y S3 más Amazon Athena para acceso a inteligencia empresarial (BI) a largo plazo. Trate la registración como infraestructura, no como un interruptor manual: aprovisione el grupo de registros o el bucket a través de código, defina las políticas de retención y cifrado, y valide la entrega durante la configuración del entorno. Si la registración solo existe en desarrollo o solo en una región, su programa de costos se vuelve fragmentario en el momento en que el uso crece.
La registración también cierra la brecha de latencia: la atribución de CUR tiene un retraso de aproximadamente 24 horas, pero CloudWatch junto con OpenTelemetry pueden proporcionar paneles en tiempo casi real que muestran el gasto por desarrollador en cuestión de minutos (Análisis del uso de Claude Code con CloudWatch y OpenTelemetry demuestra esto de principio a fin).
Metadatos de solicitud para atribución a nivel de carga de trabajo
Los registros sin procesar responden preguntas a nivel de identidad. Para responder preguntas a nivel de carga de trabajo (qué característica, flujo de trabajo o inquilino generó los tokens), estampe metadatos de solicitud en cada llamada. Amazon Bedrock captura estos metadatos en los registros de invocación para su análisis posterior:
Amazon Bedrock no aplica metadatos de solicitud, y los equipos caen rápidamente en esquemas inconsistentes cuando cada aplicación hace su propia cosa. El equipo de la plataforma debe inyectar metadatos obligatorios de manera centralizada en un SDK compartido o una puerta de enlace, normalizar el conjunto de claves y tratar la cobertura de metadatos como una métrica de salud de la plataforma.
Consultas de diagnóstico
Con los registros y metadatos en su lugar, CloudWatch Logs Insights responde las preguntas pendientes. ¿Quién consume la mayoría de los tokens:
fields @timestamp, identity.arn as caller, modelId,
input.inputTokenCount as inTokens,
output.outputTokenCount as outTokens
| stats sum(inTokens + outTokens) as totalTokens,
count(*) as calls
by caller, modelId
| sort totalTokens desc
| limit 25
requestMetadata.application y requestMetadata.workflow en lugar de caller produce la clasificación a nivel de carga de trabajo: la vista del producto y los equipos de ingeniería pedirán a FinOps que inicie las conversaciones de cargo cuando comiencen.
Nota: Las rutas de campo mostradas en la consulta anterior son ilustrativas. Verifique contra su esquema de registro de invocación, que puede variar según el modelo, la operación de API y la configuración de registro.
Etapa 3: Aplicar presupuestos
Con la atribución y la observabilidad en su lugar, la aplicación se convierte en una elección de arquitectura en lugar de un deseo. Hay tres niveles viables. El correcto depende de su velocidad de gasto, su tolerancia al riesgo de gasto excesivo y de cómo sus herramientas se conectan a Amazon Bedrock.
Nivel 1: Monitoreo y alerta (sin bloqueo)
Amazon Bedrock escribe la identidad principal en la canalización de facturación de forma automática. Puedes agregar AWS Budgets para alertas de umbral, con los paneles de OpenTelemetry de la Etapa 2 que cierran la brecha de 24 horas de CUR para la visibilidad diaria. No hay nada que desplegar, facturación nativa de AWS y no se agrega latencia en las llamadas de inferencia. Funciona con herramientas que llaman a Amazon Bedrock directamente. Nada puede detener el gasto de forma permanente, por lo que ves el problema después de que ocurre. Adecuado para la adopción temprana, donde la alerta y la intervención humana son suficientes. Dos guías para constructores te llevan a través de esto: Limitar el uso de Bedrock y controlar los costos, y Análisis detallado de la administración de Bedrock en Claude Code con AWS Budgets y etiquetas.
Nivel 2: Aplicación de etiquetas de IAM (denegar en caso de incumplimiento)
Una función de AWS Lambda agregadora cuenta los contadores de token y dólar por usuario en Amazon DynamoDB a partir de los datos de registro de invocación. Cuando un usuario incumple su umbral, la función agrega su identidad a una política de denegación de IAM compartida (denegando bedrock:*) hasta un restablecimiento mensual o anulación administrativa. Esta aplicación se ejecuta completamente en IAM y registro de Amazon Bedrock, sin componentes de terceros en la ruta de inferencia, y funciona con herramientas que llaman a Amazon Bedrock directamente. La Guía para Claude Code con Amazon Bedrock en la Biblioteca de soluciones de AWS proporciona una variante desplegable. Verifica el uso de cada usuario contra los límites por usuario y por equipo cuando emite credenciales, y retiene las credenciales una vez que un usuario excede su límite. Dado que esta verificación utiliza telemetría de uso emitida por el cliente, sus cifras pueden diferir de CUR. En cualquiera de las formas, la aplicación es asíncrona. Un bloque tiene efecto segundos a minutos después de la llamada que incumple para una actualización de la política de IAM, o en la próxima actualización de credenciales para la verificación de credenciales. Tu equipo de plataforma es el propietario de la canalización. Este nivel es adecuado para equipos que necesitan una aplicación real, pueden tolerar ese retraso y desean mantener el software de terceros fuera de la ruta de datos.
Nivel 3: Aplicación de puerta de enlace (bloqueo síncrono)
Un gateway se encuentra en el camino de los datos de inferencia y aplica los presupuestos de manera sincrónica, devolviendo HTTP 429 en el momento en que un usuario o equipo excede su límite. Obtiene bloqueo por debajo de un segundo, listas de permitidos de modelo por usuario, límites de velocidad de token y reglas de enrutamiento centralizadas. El compromiso: un componente en el camino de los datos que debe ser implementado, escalado y revisado en términos de seguridad. Los clientes deben estar configurados para enviar sus solicitudes a través del gateway.
Conectividad: Si los desarrolladores llaman a Amazon Bedrock directamente sin proxy, solo los Niveles 1 y 2 son viables.
Velocidad de gasto: Si el gasto ya está en millones por mes, cree la aplicación de cumplimiento ahora. Si las alertas pueden contener la línea durante otro trimestre, invierta en las Etapas 1 y 2 primero y agregue la aplicación de cumplimiento cuando los datos lo exijan.
La mayoría de las organizaciones deben hacerlo por etapas: observar en el Nivel 1, luego avanzar. Trate a los tres como puentes, no como destinos: la Lente de AI Agentic bien estructurada ya codifica la gobernanza de costos de agente como una preocupación arquitectónica de primera clase, y la base de atribución de la Etapa 1 es lo que cualquier aplicación de cumplimiento administrada se basará.
Etapa 4: Optimizar los valores predeterminados
La mayoría del desperdicio de Amazon Bedrock no es descuido individual. Son valores predeterminados de plataforma que nadie configuró. Las dos palancas de mayor impacto están controladas por la plataforma.
Enrutamiento de modelo
No todas las tareas necesitan un modelo de frontera. Las finalizaciones de rutina (código de plantilla, sugerencias de linting, refactorizaciones pequeñas) pueden ejecutarse en modelos más pequeños y económicos, reservando la calidad para el razonamiento complejo, a través de enrutamiento de solicitudes inteligentes dentro de una familia de modelos o reglas de enrutamiento en la puerta de enlace (consulte Reduce costos y latencia con Amazon Bedrock Intelligent Prompt Routing y almacenamiento en caché de solicitudes para la guía completa). ¿Qué flujos de trabajo pueden reducir la velocidad es una pregunta empírica: extraiga la tabla de clasificación de cargas de trabajo de la Etapa 2, ejecute una evaluación de calidad en el modelo más económico para las entradas principales y enruté lo que pase. Para las flotas de codificación agente, donde el código de plantilla domina el volumen de llamadas, más de la mitad de las llamadas que aterrizan en modelos más económicos es un objetivo alcanzable.
Almacenamiento en caché de solicitudes
El almacenamiento en caché de solicitudes recompensa los prefijos repetidos estables. A partir de octubre de 2026, el precio publicado de Amazon Bedrock para los modelos Anthropic Claude en EE. UU. Este (Virginia del Norte) factura una escritura en caché a 1,25 veces la tasa de entrada base con el tiempo de vida (TTL) de 5 minutos (2 veces con el TTL de 1 hora). Una lectura en caché se factura a 0,1 veces la tasa de entrada base en Claude Sonnet 4.6 y Claude Haiku 4.5, y a 0,05 veces en Claude Sonnet 5.5 y Claude Opus 5.5. Verifique la página de precios para su modelo y región, porque estos multiplicadores varían según el modelo y pueden cambiar. Las matemáticas de punto de equilibrio son más amigables de lo que asumen los equipos. Con el TTL de 5 minutos, una sola reutilización ya paga por la escritura, y diez llamadas contra un prefijo estable cuestan aproximadamente una quinta parte del precio sin caché (alrededor del 22 por ciento a una tasa de lectura de 0,1x, 17 por ciento a 0,05x). El único caso perdedor son las escrituras que nunca se vuelven a leer, que cuestan un 25 por ciento extra con el TTL de 5 minutos y el doble con el TTL de 1 hora. Por lo tanto, el panel de la plataforma debe rastrear el volumen de lecturas en caché frente al volumen de escrituras en caché por flujo de trabajo. Una baja relación de lectura significa que el prefijo no es en realidad estable (generalmente un timestamp o un ID de sesión incrustado antes del punto de caché).
Los candidatos aparecen directamente en los registros de invocación:
fields requestMetadata.workflow as workflow, modelId,
input.inputTokenCount as inTokens
| stats count(*) as calls,
avg(inTokens) as avgInputTokens,
sum(inTokens) as totalInputTokens
by workflow, modelId
| filter calls > 50 and avgInputTokens > 2000
| sort totalInputTokens desc
| limit 25
Nota: Las rutas de campo mostradas en la consulta anterior son ilustrativas. Verifique contra su esquema de registro de invocación, que puede variar según el modelo, la operación de API y la configuración de registro.
Optimización a nivel de aplicación
Una tercera clase de ahorros (recuperación justo a tiempo en lugar de contexto relleno, compactación de conversaciones largas, destilación de flujos de trabajo de alto volumen estables en modelos más pequeños) pertenece a los equipos de aplicación en lugar de a la plataforma. El trabajo de la plataforma es hacer que esos ahorros sean visibles: publicar la clasificación de tokens por flujo de trabajo, establecer límites de tokens por modelo y flujo de trabajo, y permitir que los equipos que poseen flujos de trabajo costosos vean exactamente dónde se encuentran.
Etapa 5: Operar el ciclo
Las primeras cuatro etapas producen datos. Esta los convierte en decisiones. El equipo de la plataforma ejecuta un panel de salud en ejecución con cuatro señalesles:
Mezcla de modelos: Qué modelos se llaman y con qué frecuencia, la medida directa de la disciplina de enrutamiento.
Tasas de solicitudes fallidas: Errores, limitaciones y tiempos de espera. Cada reintento agrega latencia, y un tiempo de espera del lado del cliente en una solicitud que aún se completa en el lado del servicio puede ser facturado dos veces, una por la llamada abandonada y otra por el reintento.
Eficacia de la caché: La relación de lectura y escritura de la Etapa 4.
Cobertura de metadatos: El porcentaje de llamadas de producción con metadatos completos. Cada llamada no cubierta es un punto ciego de atribución que degrada silenciosamente todos los demás números.
Cuando una señalale se desvía, el remedio es un cambio de política (reglas de enrutamiento, límites de tokens, aplicación de metadatos), no un correo electrónico que pide a los equipos que tengan cuidado.
El ciclo del dinero
FinOps ejecuta el ciclo del dinero con los mismos datos. Cuando la atribución es limpia, la detección de anomalías se convierte en una corriente de investigación en lugar de una alarma general: un pico en un equipo o aplicación etiquetada desencadena una búsqueda en la clasificación de la Etapa 2, no en una sala de guerra. La asignación de cargos se ejecuta desde los agrupamientos de CUR por equipo y aplicación.
Tarjeta de puntuación
Los siguientes umbrales son puntos de partida, no prescripciones. Calíbrenlos contra sus propios datos de flota y nivel de precios antes de adoptarlos como política.
Dimensión
Métrica
Verde
Amarillo
Rojo
Economía de unidades
Costo por resultado exitoso
≤ presupuesto
1–1.5x presupuesto
>1.5x presupuesto
Costo por desarrollador
Gasto diario por desarrollador
<$100
$100–$300
>$300
Enrutamiento de modelos
% de llamadas a modelos costo-eficientes
>50%
30–50%
<30%
Eficiencia de caché
Proporción de lecturas de caché
>60%
30–60%
<30%
El color verde significa que la carga de trabajo opera dentro de su sobre envolvente económico. El color amarillo significa que la disciplina de enrutamiento o caché se está relajando. El color rojo significa que el gasto se está concentrando en modelos premium o contexto sin caché, y los controles de la Etapa 3 y 4 son la ruta de remediación. Revise esta tabla de puntajes con una cadencia regular (semanal para flotas de alta velocidad, quincenal para el resto) y trátela como la superficie de decisión conjunta de FinOps más plataforma.
Conclusión
En esta publicación, aprendió a crear un modelo de operación de cinco etapas que lleva el gasto de Amazon Bedrock desde sin control hasta completamente gobernado:
Atribuir cada dólar a un propietario utilizando etiquetas de principal de IAM, etiquetas de sesión y CUR 2.0.
Observar cada solicitud a través de la registración de invocación de modelo y metadatos de solicitud marcados.
Asegurar los presupuestos en el nivel que coincide con su riesgo: monitoreo solo, denegación de IAM en caso de incumplimiento o bloqueo de puerta de enlace sincrónica.
Optimizar los valores predeterminados de la plataforma con enrutamiento de prompt inteligente y caché de prompt para eliminar el desperdicio de manera centralizada.
Operar una tabla de puntajes y una cadencia de revisión que convierte la telemetría en decisiones de política.
Tenga en cuenta la primera fila de esa tabla de puntajes: costo por resultado exitoso, no costo por llamada. Esa distinción es donde esta guía se entrega. Todo aquí hace que el gasto de Amazon Bedrock sea visible, atribuible, limitado y eficiente, pero un flujo de trabajo puede ser perfectamente eficiente y aún no ser digno de ejecutarse. Decidir eso requiere medir el agente contra el proceso humano que reemplazó, lo cual es una disciplina de producto y análisis en lugar de FinOps. Lo que la plataforma de costo contribuye es la base: la atribución limpia y los datos de costo por flujo de trabajo son exactamente las entradas que la medición de resultados une.
Construya las cinco etapas y podrá responder de principio a fin: quién lo gastó, por qué y si estuvo controlado. Eso es lo que significa administrar el costo de Amazon Bedrock, y es la diferencia entre una revisión de factura mensual y un modelo de operación.
Cost management for generative AI is a shared responsibility between the teams that build applications and the teams accountable for cloud spend. Many teams start by comparing per-model token rates and asking application teams to shorten prompts. Those steps help, but they don’t answer the questions that finance and engineering leaders ask as usage scales: which team spent this, on which workload, and was that spend inside an approved budget?
Agentic workloads make those questions more pressing. A conversational assistant typically issues one model invocation per user turn. An agentic workflow, such as an AI coding assistant that plans a change, reads files, calls tools, and iterates, issues many invocations per task and carries a larger context on each one. Token consumption therefore scales with the degree of autonomy you grant the workflow and the size of the context it carries, rather than with the number of user interactions. Because consumption is a function of how a workload is designed and operated, cost management for generative AI is an architectural and operational discipline. Published averages are a poor substitute for your own numbers: use the AWS Pricing Calculator and the Amazon Bedrock pricing page to model rates, and use Step 2 of this post to measure what your workloads actually consume.
The fix isn’t a cheaper model or a smaller prompt. It’s an operating model: a repeatable loop that attributes every dollar to an owner, makes every request observable, alerts on and enforces budgets before overspend compounds, optimizes the platform defaults that drive most waste, and reviews the whole system on a cadence.
In this post, you learn how to manage Amazon Bedrock cost in five steps. You attribute every dollar to an owner, make every request observable, control spend with budgets and enforcement, optimize the platform defaults that drive most avoidable spend, and operate a review cadence that turns data into decisions. This approach is built from AWS building blocks, and you can customize it and apply it to your own environment. The post is written for two audiences: FinOps practitioners who own attribution, chargeback, budgets, and anomaly review, and platform engineering teams who own logging, request metadata, enforcement, and routing defaults.
The operating model in one view
Five stages, run as a loop. Attribute: every Amazon Bedrock dollar lands on an identity, team, and application in the billing pipeline. Observe: every request is logged with enough metadata to explain what generated the spend. Enforce: budgets have teeth, with alerts at minimum and hard blocks where the risk demands them. Optimize: the platform defaults (model routing, caching, token limits) remove waste centrally instead of asking every team to be careful. Operate: a small scorecard and a review cadence turn the data into decisions. FinOps leads stages one and five. Platform engineering leads two through four. The review is joint. The stages are sequenced deliberately. Each one depends on the ones before it, and teams that jump straight to optimization without attribution and observability are guessing.
Figure 1: The five-stage operating model, run as a continuous loop
Stage 1: Attribute every dollar
You can’t manage what you can’t attribute, and everything downstream (chargeback, budgets, enforcement, anomaly detection) depends on this stage. The foundation is the granular cost attribution of Amazon Bedrock (see Introducing granular cost attribution for Amazon Bedrock): Amazon Bedrock automatically attributes inference costs to the AWS Identity and Access Management (IAM) principal that made the call, across all models, with no resources to manage. The caller’s ARN lands in the line_item_iam_principal column of the AWS Cost and Usage Report (CUR) 2.0, and coverage spans IAM users, roles, federated identities, and API keys.
Setup is four steps:
Turn on IAM principal data in your CUR 2.0 data export.
Tag your IAM principals with business dimensions such as team, application, and cost center. For federated access, configure your identity provider to pass session names and tags through OIDC or SAML claims.
Activate those tags as cost allocation tags in AWS Billing (console or the UpdateCostAllocationTagsStatus API).
Analyze the tags: they surface in CUR 2.0 with an iamPrincipal/ prefix (for example, iamPrincipal/team) and appear in AWS Cost Explorer under the IAM category within 24–48 hours of activation, ready for filtering and grouping by team, application, or cost center.
This is invoice-grade, per-identity attribution with no custom infrastructure.
The shared-role problem
The pattern that deserves the most attention is the shared-role problem, because it is where most platforms silently lose attribution. A large language model (LLM) gateway that calls Amazon Bedrock through a single IAM role attributes every dollar to that one role, eliminating per-user visibility entirely. The fix is per-user session management. The gateway assumes the Amazon Bedrock invocation role once per user, passing the user’s identity as the role session name and their attributes as session tags, then caches those credentials for up to an hour (one AWS Security Token Service (AWS STS) call per user per hour, not per request).
This needs two roles: a gateway execution role holding sts:AssumeRole and sts:TagSession permissions, and the Amazon Bedrock invocation role it assumes. The result is line_item_iam_principal entries like assumed-role/BedrockRuntimeRole/gw-alex, each carrying its user’s tags: per-user and per-tenant attribution restored behind a shared gateway.
import boto3

sts = boto3.client("sts")

# One call per user; cache the returned credentials up to 1 hour
response = sts.assume_role(
    RoleArn="arn:aws:iam::123456789012:role/BedrockRuntimeRole",
    RoleSessionName="gw-alex", # the user, not the gateway
    Tags=[
        {"Key": "team", "Value": "sales-ai"},
        {"Key": "application", "Value": "renewal-agent"},
        {"Key": "costCenter", "Value": "CC-2041"}
    ]
)
A note on application inference profiles and Projects
Amazon Bedrock offers two more attribution mechanisms, each suited to a different pattern. Application inference profiles are pre-created, per-application resources on the bedrock-runtime endpoint that carry cost allocation tags. You create one profile per application per model per AWS Region, and callers reference the profile ARN, which fits teams with a small and stable set of applications and models. Projects and workspaces serve the bedrock-mantle endpoint (Responses API, Chat Completions API). A project isn’t tied to a specific model, so a single project ID spans many models, which fits teams whose model usage changes frequently. You pass the project ID at client initialization, and its tags flow to CUR 2.0 and Cost Explorer (see Manage AI costs with Amazon Bedrock Projects). Projects are the attribution path for OpenAI-compatible workloads on Amazon Bedrock.
For bedrock-runtime workloads, we recommend IAM principal attribution through session tags as the primary mechanism. It scales with your identity system, requires no pre-created resources, and covers every model and API operation. Application inference profiles work well when a small, stable set of business units needs invoice-grade billing separation without changes to identity design. Use projects for bedrock-mantle workloads that use the Responses API or Chat Completions API.
Stage 2: Make every request observable
CUR tells you who spent. Invocation logs tell you what happened. Amazon Bedrock supports model invocation logging of request data, response data, and metadata to Amazon CloudWatch Logs, Amazon Simple Storage Service (Amazon S3), or both. Use Amazon CloudWatch for fast operational queries and S3 plus Amazon Athena for long-term business intelligence (BI) access. Treat logging as infrastructure, not a manual toggle: provision the log group or bucket through code, define retention and encryption policies, and validate delivery during environment setup. If logging exists only in development or only in one Region, your cost program becomes fragmentary the moment usage grows.
Logging also closes the latency gap: CUR attribution lags roughly 24 hours, but CloudWatch plus OpenTelemetry can power near-real-time dashboards showing per-developer spend within minutes (Analyzing Claude Code usage with CloudWatch and OpenTelemetry demonstrates this end to end).
Request metadata for workload-level attribution
Raw logs answer identity-level questions. To answer workload-level questions (which feature, workflow, or tenant generated the tokens), stamp request metadata on every call. Amazon Bedrock captures this metadata in the invocation logs for later analysis:
Amazon Bedrock doesn’t enforce request metadata, and teams drift into inconsistent schemas quickly when every application does its own thing. The platform team should inject mandatory metadata centrally in a shared SDK wrapper or gateway, normalize the key set, and treat metadata coverage as a platform health metric.
Diagnostic queries
With logs and metadata in place, CloudWatch Logs Insights answers the standing questions. Who consumes the most tokens:
fields @timestamp, identity.arn as caller, modelId,
input.inputTokenCount as inTokens,
output.outputTokenCount as outTokens
| stats sum(inTokens + outTokens) as totalTokens,
count(*) as calls
by caller, modelId
| sort totalTokens desc
| limit 25
The same query grouped by requestMetadata.application and requestMetadata.workflow instead of caller produces the workload-level leaderboard: the view product and engineering teams will ask FinOps for the moment chargeback conversations start.
Note: Field paths shown in the preceding query are illustrative. Verify against your invocation log schema, which may vary by model, API operation, and logging configuration.
Stage 3: Enforce budgets
With attribution and observability in place, enforcement becomes an architecture choice rather than a wish. There are three viable tiers. The right one depends on your spend velocity, your risk tolerance for overspend, and how your tools connect to Amazon Bedrock.
Tier 1: Monitor and alert (no blocking)
Amazon Bedrock writes principal identity into the billing pipeline automatically. You put AWS Budgets on top for threshold alerts, with the OpenTelemetry dashboards from Stage 2 closing the 24-hour CUR gap for day-to-day visibility. Nothing to deploy, native AWS billing, and no added latency on inference calls. It works with tools that call Amazon Bedrock directly. Nothing can hard-stop spend, so you see the problem after it happens. Right for early adoption, where alerting plus human intervention is sufficient. Two builder guides walk through it: Limiting Bedrock usage and controlling costs, and Deep dive on managing Bedrock in Claude Code with AWS Budgets and Tags.
Tier 2: IAM tag enforcement (deny on breach)
An aggregator AWS Lambda function tallies per-user token and dollar counters in Amazon DynamoDB from invocation log data. When a user breaches their threshold, the function adds their identity to a shared IAM deny policy (denying bedrock:*) until a monthly reset or admin override. This enforcement runs entirely on IAM and Amazon Bedrock logging, with no third-party component in the inference path, and it works with tools that call Amazon Bedrock directly. The Guidance for Claude Code with Amazon Bedrock in the AWS Solutions Library provides a deployable variant. It checks each user’s usage against per-user and per-team limits when it issues credentials, and withholds credentials once a user exceeds their limit. Because that check uses usage telemetry emitted by the client, its figures can differ from CUR. In either form, enforcement is asynchronous. A block takes effect seconds to minutes after the breaching call for an IAM policy update, or at the next credential refresh for the credential check. Your platform team owns the pipeline. This tier is right for teams that need real enforcement, can tolerate that lag, and want to keep third-party software out of the data path.
Tier 3: Gateway enforcement (synchronous block)
A gateway sits in the inference data path and enforces budgets synchronously, returning HTTP 429 the moment a user or team exceeds their limit. You get sub-second blocking, per-user model allowlists, token rate limits, and centrally enforced routing rules. The trade-off: a component in the data path that must be deployed, scaled, and security-reviewed. Clients must be configured to send their requests through the gateway.
Connectivity: If developers call Amazon Bedrock directly with no proxy, only Tiers 1 and 2 are viable.
Spend velocity: If spend is already in the millions per month, build enforcement now. If alerts can hold the line for another quarter, invest in Stages 1 and 2 first and add enforcement when the data demands it.
Most organizations should phase it: observe at Tier 1, then step up. Treat all three as bridges, not destinations: the Well-Architected Agentic AI Lens already codifies agent cost governance as a first-class architectural concern, and the attribution foundation from Stage 1 is what any managed enforcement will sit on.
Stage 4: Optimize the defaults
Most Amazon Bedrock waste is not individual carelessness. It is platform defaults nobody set. The two highest-impact levers are both platform-controlled.
Model routing
Not every task needs a frontier model. Routine completions (boilerplate, linting suggestions, small refactors) can run on smaller, cheaper models with quality reserved for complex reasoning, through intelligent prompt routing within a model family or routing rules at the gateway (see Reduce costs and latency with Amazon Bedrock Intelligent Prompt Routing and prompt caching for the full walkthrough). Which workflows can downshift is an empirical question: pull the workload leaderboard from Stage 2, run a quality evaluation on the cheaper model for the top entries, and route what passes. For agentic coding fleets, where boilerplate dominates call volume, more than half of calls landing on cheaper models is an achievable target.
Prompt caching
Prompt caching rewards stable repeated prefixes. As of October 2026, the published Amazon Bedrock pricing for Anthropic Claude models in US East (N. Virginia) bills a cache write at 1.25x the base input rate with the 5-minute time-to-live (TTL) (2x with the 1-hour TTL). A cache read is billed at 0.1x the base input rate on Claude Sonnet 4.6 and Claude Haiku 4.5, and at 0.05x on Claude Sonnet 5.5 and Claude Opus 5.5. Check the pricing page for your model and Region, because these multipliers vary by model and can change. The break-even math is friendlier than teams assume. With the 5-minute TTL, a single reuse already pays for the write, and ten calls against a stable prefix cost roughly a fifth of the uncached price (about 22 percent at a 0.1x read rate, 17 percent at 0.05x). The only losing case is writes that are never re-read, which cost 25 percent extra with the 5-minute TTL and double with the 1-hour TTL. So the platform dashboard should track cache-read volume against cache-write volume per workflow. A low read ratio means the prefix is not actually stable (usually a timestamp or session ID embedded before the cache point).
Candidates surface directly from the invocation logs:
fields requestMetadata.workflow as workflow, modelId,
input.inputTokenCount as inTokens
| stats count(*) as calls,
avg(inTokens) as avgInputTokens,
sum(inTokens) as totalInputTokens
by workflow, modelId
| filter calls > 50 and avgInputTokens > 2000
| sort totalInputTokens desc
| limit 25
Note: Field paths shown in the preceding query are illustrative. Verify against your invocation log schema, which may vary by model, API operation, and logging configuration.
Application-level optimization
A third class of savings (just-in-time retrieval instead of stuffed context, compaction of long conversations, distilling stable high-volume workflows onto smaller models) belongs to application teams rather than the platform. The platform’s job is to make those savings visible: publish the per-workflow token leaderboard, set token limits per model and workflow, and let the teams that own expensive workflows see exactly where they stand.
Stage 5: Operate the loop
The first four stages produce data. This one turns it into decisions. The platform team runs a standing health dashboard with four signals:
Model mix: Which models are called and how often, the direct measure of routing discipline.
Failed request rates: Errors, throttles, and timeouts. Each retry adds latency, and a client-side timeout on a request that still completes on the service side can be billed twice, once for the abandoned call and once for the retry.
Cache effectiveness: The read-versus-write ratio from Stage 4.
Metadata coverage: The percentage of production calls with complete metadata. Every uncovered call is an attribution blind spot that quietly degrades every other number.
When a signal drifts, the remediation is a policy change (routing rules, token limits, metadata enforcement), not an email asking teams to be careful.
The money loop
FinOps runs the money loop on the same data. When attribution is clean, anomaly detection becomes an investigation stream rather than a panicked all-hands: a spike in a tagged team or application triggers a lookup in the Stage 2 leaderboard, not a war room. Chargeback runs from CUR groupings by team and application.
Scorecard
The following thresholds are starting points, not prescriptions. Calibrate them against your own fleet data and pricing tier before adopting them as policy.
Dimension
Metric
Green
Yellow
Red
Unit economics
Cost per successful outcome
≤ budget
1–1.5x budget
>1.5x budget
Per-dev cost
Daily spend per developer
<$100
$100–$300
>$300
Model routing
% of calls to cost-efficient-models
>50%
30–50%
<30%
Cache efficiency
Cache-read hit ratio
>60%
30–60%
<30%
Green means the workload operates inside its economic envelope. Yellow means routing or caching discipline is slipping. Red means spend is concentrating in premium models or uncached context, and the Stage 3 and 4 controls are the remediation path. Review this scorecard on a regular cadence (weekly for high-velocity fleets, biweekly otherwise) and treat it as the joint FinOps-plus-platform decision surface.
Conclusion
In this post, you learned how to build a five-stage operating model that takes Amazon Bedrock spend from uncontrolled to fully governed:
Attribute every dollar to an owner using IAM principal tags, session tags, and CUR 2.0.
Observe every request through model invocation logging and stamped request metadata.
Enforce budgets at the tier that matches your risk: monitor-only, IAM deny on breach, or synchronous gateway blocking.
Optimize platform defaults with intelligent prompt routing and prompt caching to remove waste centrally.
Operate a scorecard and review cadence that turns telemetry into policy decisions.
Notice the first row of that scorecard: cost per successful outcome, not cost per call. That distinction is where this playbook hands off. Everything here makes Amazon Bedrock spend visible, attributable, capped, and efficient, but a workflow can be perfectly efficient and still not be worth running. Deciding that requires measuring the agent against the human process it replaced, which is a product and analytics discipline rather than a FinOps one. What the cost platform contributes is the foundation: clean attribution and per-workflow cost data are exactly the inputs that outcome measurement joins against.
Build the five stages and you can answer, end to end: who spent it, why, and whether it was controlled. That is what it means to manage Amazon Bedrock cost, and it is the difference between a monthly bill review and an operating model.