Aprendizaje de Refuerzo de Varios Giros en Amazon SageMaker AI: Una guía práctica
Multi-Turn Reinforcement Learning on Amazon SageMaker AI: A hands-on guide
Daniel Quang
La mayoría de la afinación enseña a un modelo a producir una mejor respuesta a una sola llamada. Las tareas agénticas son diferentes. Un agente que presenta un informe de gastos o triagea un ticket de soporte toma una secuencia de acciones, y cada paso depende de lo que sucedió antes. Rara vez hay una secuencia correcta para imitar, y la única retroalimentación confiable es si toda la secuencia tuvo éxito. La afinación supervisada no tiene etiquetas para eso, y el aprendizaje de refuerzo de un solo turno no puede acreditar una decisión tomada tres pasos antes del resultado.
El Aprendizaje de Refuerzo de Varios Turnos (MTRL) en Amazon SageMaker AI entrena modelos en exactamente esa señal. SageMaker AI envía llamadas a un agente que hospedas en Amazon Bedrock AgentCore, o en tu propia infraestructura, como Amazon Elastic Kubernetes Service (Amazon EKS), Amazon Elastic Compute Cloud (Amazon EC2) o AWS Fargate, a través de un reenviador de AWS Lambda. El ejemplo aquí utiliza AgentCore. El agente llama al modelo de política que se está entrenando, actúa en tu entorno durante tantos turnos como necesite la tarea y informa una recompensa cuando finaliza el episodio. No especificas la trayectoria correcta, solo cómo puntuar el resultado.
Esta publicación utiliza Wordle, un juego en el que un jugador tiene seis intentos para adivinar una palabra oculta de cinco letras, como ejemplo. Después de cada intento, cada letra se vuelve verde si está en la posición correcta, amarilla si está en la palabra pero en una posición diferente, y gris si no está en la palabra. El juego se adapta a MTRL porque las reglas son pocas, cada intento depende de la retroalimentación del último y el resultado se puntuación de manera objetiva. Wordle es un ejemplo de enseñanza, y los modelos fronterizos ya lo juegan bien. En la práctica, utilizarías MTRL para hacer que un modelo pequeño y de bajo costo sea bueno en una tarea de varios pasos específica de tu negocio, como un flujo de trabajo interno que los modelos públicos nunca se entrenaron. La misma canalización se aplica a ese entorno.
En nuestra ejecución, MTRL tomó gpt-oss-20b de una tasa de resolución del 61 por ciento a una del 84 por ciento en palabras retenidas a su esfuerzo de razonamiento predeterminado, y del 15 por ciento al 69 por ciento en el esfuerzo bajo en el que se entrenó, por aproximadamente $339 en tokens de entrenamiento. En esta publicación, recorremos la canalización de extremo a extremo: implementar el agente y la recompensa en AgentCore, preparar el conjunto de datos, entrenar, monitorear en MLflow y evaluar en la configuración de servicio. También compartimos los errores de diseño de recompensa y los fallos de entrenamiento que encontramos. Tus conjuntos de datos, agente y modelo entrenado permanecen en tu cuenta de AWS y no se utilizan para entrenar los modelos base. Todo el código está en el repositorio aws-samples acompañante.
Visión general de la solución
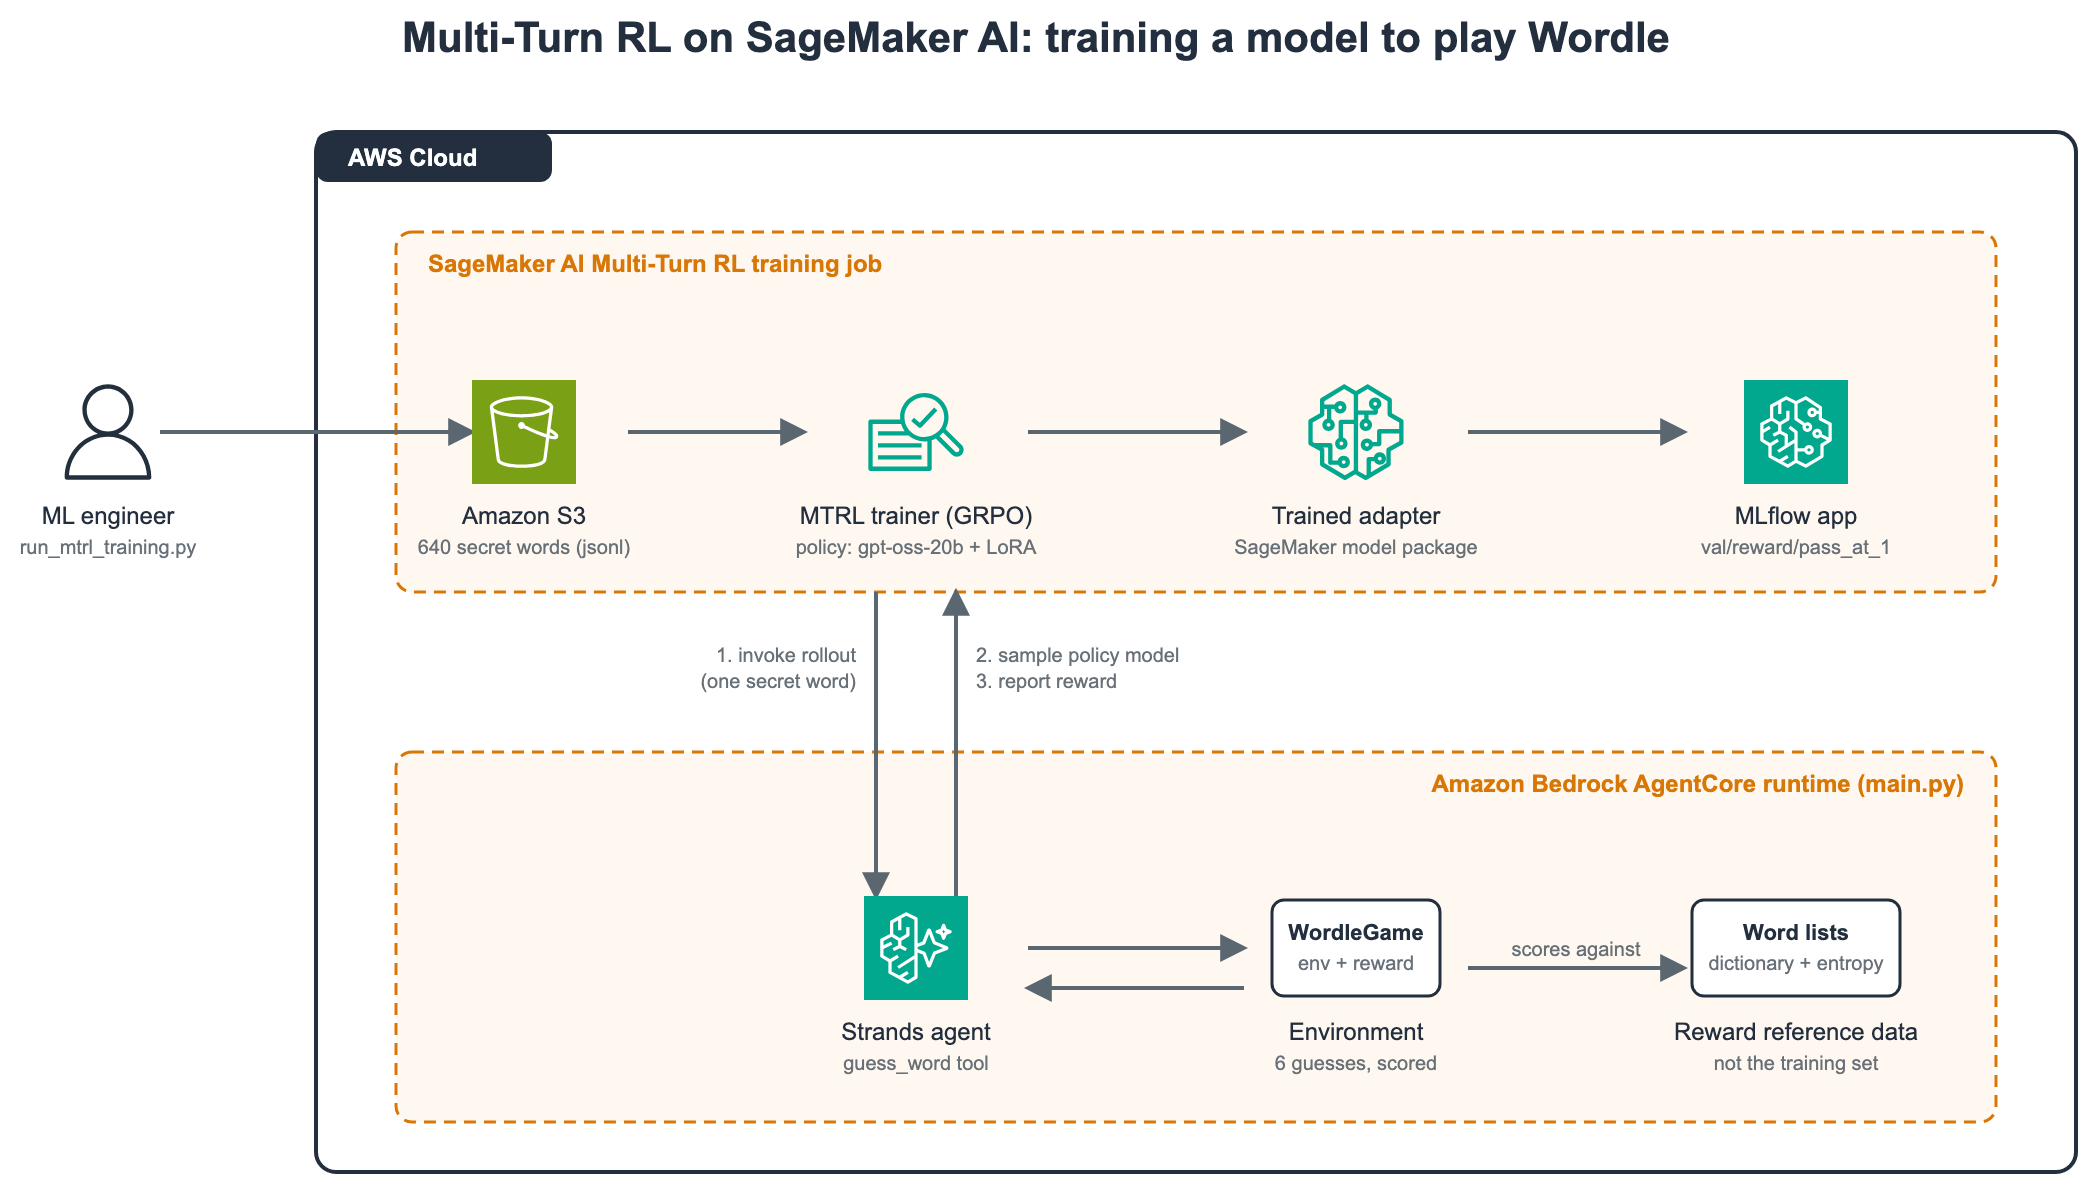
El sistema tiene dos mitades. SageMaker AI posee el trabajo de entrenamiento y el modelo de política. AgentCore hospeda el agente, el entorno de Wordle y la función de recompensa. El siguiente diagrama muestra cómo se conectan.
Figura 1: MTRL en SageMaker AI, donde el trabajo de entrenamiento invoca al agente hospedado en AgentCore una vez por rollout para muestrear el modelo de política, jugar el juego y reportar una recompensa
Para cada rollout, el servicio MTRL invoca el runtime de AgentCore, una capacidad de Amazon Bedrock AgentCore, con una fila de entrenamiento, que contiene una palabra secreta. Un agente Strands en el runtime llama al modelo de política a través del endpoint OpenAI compatible del SageMaker Job Runtime. El modelo juega hasta seis intentos a través de una herramienta, guess_word, y después de cada intento, el entorno devuelve una retroalimentación por letra y un resumen de lo que se conoce. Cuando el juego termina, el agente devuelve una recompensa. Group Relative Policy Optimization (GRPO) utiliza la dispersión de recompensas en varios rollouts de la misma palabra para actualizar un adaptador de adaptación de bajo rango (LoRA) en el modelo de política.
Tres puntos de diseño son importantes para lo que sigue:
El agente y la recompensa viven en un solo lugar. Un solo archivo Python desplegado en AgentCore contiene el entorno, la herramienta y la función de puntuación.
El conjunto de datos solo lleva la palabra secreta. Las listas de palabras empaquetadas con el agente se construyen a partir de las listas de palabras de código abierto SCOWL y se utilizan solo para puntuar.
La recompensa es dominante en el resultado. Una solución paga 1,05-1,55 dependiendo de la velocidad, una pérdida paga -0,5 y nunca hacer una suposición válida paga -1,5. Un pequeño término de modelado recompensa una buena estrategia dentro de cada nivel.
Modelos y regiones de AWS compatibles
MTRL es servidorless: selecciona un modelo base y el servicio provisiona la infraestructura de entrenamiento y muestreo. En el momento de la escritura, es compatible con los siguientes modelos base, cada uno entrenado con un adaptador LoRA:
Modelo base
Regiones de AWS
Amazon Nova 2 Lite
Este de EE. UU. (N. Virginia) (us-east-1), Oeste de EE. UU. (Oregón) (us-west-2)
GPT-OSS-20B
Este de EE. UU. (N. Virginia) (us-east-1), Oeste de EE. UU. (Oregón) (us-west-2)
Gemma 4 31B (instruction-tuned)
Oeste de EE. UU. (Oregón) (us-west-2)
Qwen 3.6 27B
Oeste de EE. UU. (Oregón) (us-west-2)
Elegimos GPT-OSS-20B porque tiene el precio por token más bajo de los cuatro y su esfuerzo de razonamiento es controlable por solicitud. Consulte la documentación de MTRL para la lista actual.
Precios
No elige instancias ni dimensiona un cluster. Paga por millón de tokens en tres dimensiones, con precios según el modelo base:
Prefill: tokens de entrada que el modelo de política procesa. Estos se acumulan en una tarea de varias vueltas, porque cada vuelta vuelve a leer el historial.
Sample: tokens que el modelo de política genera, incluidos tokens de razonamiento.
Train: tokens procesados en el paso hacia atrás que actualiza el adaptador LoRA.
La ejecución de 100 pasos consumió 491,6 millones de tokens prefill, 159,7 millones de tokens sample y 643,3 millones de tokens train en 105.486 despliegues en 12 horas y 40 minutos. A los precios de lista de GPT-OSS-20B en la región Este de EE. UU. (N. Virginia) (us-east-1) en el momento de la escritura, eso es aproximadamente $339:
Dimensión
Tokens
Precio por 1M
Costo
Prefill
491.616.806
$0,12
$58,99
Sample
159.737.098
$0,30
$47,92
Train
643.308.554
$0,36
$231,59
Total
1.294.662.458
$338,50
La dimensión de entrenamiento domina y se escala con la longitud de la trayectoria, por lo que juegos más cortos y razonamientos menos verbosos reducen la factura. El tiempo de ejecución de AgentCore factura por separado por la vCPU y la memoria que utiliza el agente. Para esta ejecución, eso fue aproximadamente $79, según las métricas de uso de Amazon CloudWatch del tiempo de ejecución en los precios de lista de us-east-1. DescribeJob informa los recuentos de tokens bajo BillableTokenUsage. Consulte precios de Amazon SageMaker AI para las tarifas actuales.
Python 3.10 o posterior, uv, Node 20 o posterior, y la CLI de AgentCore (npm install -g @aws/agentcore). Consulta Introducción a Amazon Bedrock AgentCore para la instalación y los permisos de IAM que necesita la CLI.
botocore 1.43.37 o posterior, en la máquina que lanza el trabajo. Esta es la primera versión que incluye la operación AgentRFTCreateJob.
Dos roles de AWS Identity and Access Management (IAM), descritos en el Paso 1.
Un bucket de Amazon Simple Storage Service (Amazon S3) en la misma región que el agente. El trabajo de entrenamiento también debe ejecutarse en esa región, porque CreateJob rechaza un ARN de tiempo de ejecución entre regiones.
Paso 1: Crear los roles de IAM
MTRL utiliza dos roles, y uno de ellos tiene una política de confianza que la documentación general de SageMaker AI no menciona.
Role de tiempo de ejecución del agente.agentcore deploy crea este rol para usted. Confía en bedrock-agentcore.amazonaws.com y necesita la política administrada AmazonSageMakerJobRuntimeAccess, que permite que el agente llame al modelo de política e informe recompensas. La pila de CDK en el repositorio de muestra adjunta esta política automáticamente.
Role del trabajo de entrenamiento. Usted crea este rol. Debe confiar en job.sagemaker.amazonaws.com con sts:AssumeRole y sts:TagSession, y necesita la política administrada AmazonSageMakerJobFullAccess.
Nota: El principal de confianza es job.sagemaker.amazonaws.com, no sagemaker.amazonaws.com. Con el principal genérico, CreateJob falla con “No se pudo asumir el rol”, y el mensaje nombra al principal correcto solo después de los reintentos.
Paso 2: Implementar el agente en Amazon Bedrock AgentCore
Clona el repositorio de muestra, establece su cuenta y región en Wordle/agentcore/aws-targets.json, e implementa:
git clone https://github.com/aws-samples/sample-multi-turn-rl-wordle
cd sample-multi-turn-rl-wordle/Wordle
agentcore validate
agentcore deploy
La CLI construye las dependencias del agente para la plataforma Linux ARM64 del tiempo de ejecución, crea el rol de ejecución con AmazonSageMakerJobRuntimeAccess adjunto e implementa a través de AWS CloudFormation. Lo recomendamos sobre la carga de un paquete de código en la consola, donde es común obtener incorrectas las aproximadamente 700 MB de dependencias compiladas o el adjunto de la política. Anote el ARN de tiempo de ejecución en la salida para el trabajo de entrenamiento.
Figura 2: El runtime del agente Wordle en la consola de Amazon Bedrock AgentCore con estado Listo
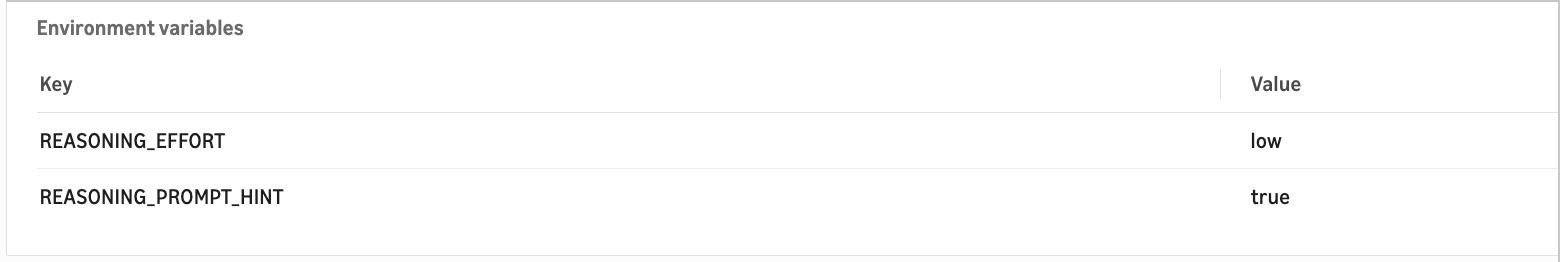
El runtime lee dos variables de entorno de agentcore.json. REASONING_EFFORT=low establece reasoning_effort en cada solicitud al modelo de política. En nuestros trabajos de evaluación, el esfuerzo bajo utilizó de 63 a 83 por ciento menos tokens de muestra por juego que el esfuerzo medio. REASONING_PROMPT_HINT=true también agrega “Razonamiento: bajo” al prompt del sistema, que es cómo gpt-oss lee la configuración en su formato de chat Harmony. Ninguna variable da al modelo ninguna pista sobre la palabra secreta.
Figura 3: Variables de entorno de runtime que muestran REASONING_EFFORT establecido en bajo
El agente es un archivo, main.py. Simplificado, su punto de entrada se parece al siguiente. Para tu propia tarea, cambias el análisis de la tarea, las herramientas y la recompensa:
app = BedrockAgentCoreApp()

@app.entrypoint  # outermost: starts the HTTP server AgentCore invokes
@sagemaker_rft_handler  # reports the returned reward to SageMaker AI
def handle_rollout(payload):
    prompt, answer = parse_task(payload["prompt"])
    game = WordleGame(answer)

    @tool
    def guess_word(guess: str) -> str:
        """Submit a 5-letter Wordle guess and get feedback."""
        return game.guess(guess)

    agent = Agent(model=build_model(), system_prompt=SYSTEM_PROMPT, tools=[guess_word])
    agent(prompt)
    return {"reward": game.final_reward()}
Importante: El decorador sagemaker_rft_handler no inicia un servidor HTTP por sí solo. Envuélvelo con BedrockAgentCoreApp y @app.entrypoint, con el decorador de punto de entrada más externo. Sin esto, cada invocación caduca después de 30 segundos.
Paso 3: Verificar el runtime
Antes de gastar tiempo de GPU, confirma que toda la cadena funciona con una carga útil con forma similar a la que envía el servicio de entrenamiento. El repositorio incluye una como Wordle/payload.json:
Se espera que el ARN de trabajo falso falle, y la forma en que falla es la prueba. Coloca tu propio ID de cuenta en él primero: para un ARN de trabajo en otra cuenta, el servicio devuelve un 403 antes de verificar si el trabajo existe, lo que parece una configuración de IAM rota. Desde el directorio de Wordle, ejecuta:
En los registros de Amazon CloudWatch del runtime, ve el agente analizar la solicitud, autenticarse en el punto de conexión de Job Runtime y recibir un error 400 que dice “No se pudo encontrar el trabajo”. Ese error confirma que el análisis, la autenticación y la informe de errores funcionan. El comando mismo imprime {“reward”: -1.5}, porque el agente nunca alcanzó el modelo de política. Un error 403 que dice “no autorizado para acceder a este recurso” significa que el ARN del trabajo aún tiene el nombre de otra cuenta. Un tiempo de espera de 30 segundos en su lugar significa que el servidor HTTP no se está iniciando (consulte la nota importante en el paso 2).
Paso 4: Preparar el conjunto de datos
El conjunto de datos MTRL no tiene respuestas de destino, transcripciones o etiquetas. Cada fila es una tarea que el agente intentará realizar. A continuación, se muestran las primeras tres filas del archivo de entrenamiento:
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"riser\", \"id\": \"wordle_train_0000\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"swoon\", \"id\": \"wordle_train_0001\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"dirty\", \"id\": \"wordle_train_0002\"}"}
El servicio lee la columna prompt (o la primera columna) y pasa la cadena al agente tal como está, sin analizarla. Hicimos que la cadena fuera un pequeño objeto JSON con tres campos:
prompt: la instrucción que el agente muestra al modelo de política, idéntica en cada fila.
answer: la palabra secreta. Solo el entorno y la función de recompensa la utilizan. El modelo de política nunca la ve.
id: un ID de fila para rastrear una ejecución en los registros hasta su fila de origen.
El repositorio de ejemplo make_dataset.py dibuja 640 palabras de entrenamiento (cinco lotes completos de 128) y 128 palabras de validación de la lista de respuestas sin superposición, por lo que la tasa de resolución de validación mide la generalización. El servicio también acepta Apache Parquet, matrices JSON y CSV. Cargue ambos archivos en Amazon S3:
Como el servicio nunca inspecciona la cadena prompt, una tarea de producción puede empaquetar una lista de mensajes completa, una configuración de herramientas o una especificación de recompensa en ella. Consulte la documentación de MTRL para obtener ejemplos, incluido cómo proteger el contenido sensible en la cadena.
Paso 5: Iniciar el trabajo de entrenamiento
El lanzador utiliza la clase MultiTurnRLTrainer del SDK sagemaker-train. Apúntelo al ARN de runtime del paso 2, el rol del paso 1, los conjuntos de datos del paso 4 y una aplicación MLflow para métricas. La aplicación MLflow es obligatoria, así que si no tiene una, créela primero con aws sagemaker create-mlflow-app:
El lanzador anula tres hiperparámetros y deja todos los demás en el valor predeterminado de gpt-oss-20b. Establece sampling_max_tokens en 8192, el máximo del servicio, porque con el valor predeterminado de 4096, gpt-oss a menudo se quedaba sin tokens mientras razonaba, antes de su primera llamada a una herramienta. Establece max_epochs en 20 y max_steps en 100: 640 filas con el valor predeterminado global_batch_size de 128 son 5 pasos por época, y con el valor predeterminado group_size de 8, cada paso juega 1,024 juegos. El trabajo pasa por los estados Iniciando, Descargando y Pendiente antes de llegar a Entrenamiento. Después de que comienza el entrenamiento, el runtime de AgentCore comienza a recibir invocaciones de rollout.
Importante: No redepliegue el agente mientras un trabajo esté en ejecución. Redeployar reinicia el runtime, las rollouts en vuelo no reciben solicitudes de muestreo y el servicio falla todo el trabajo.
Paso 6: Monitorear el entrenamiento en MLflow
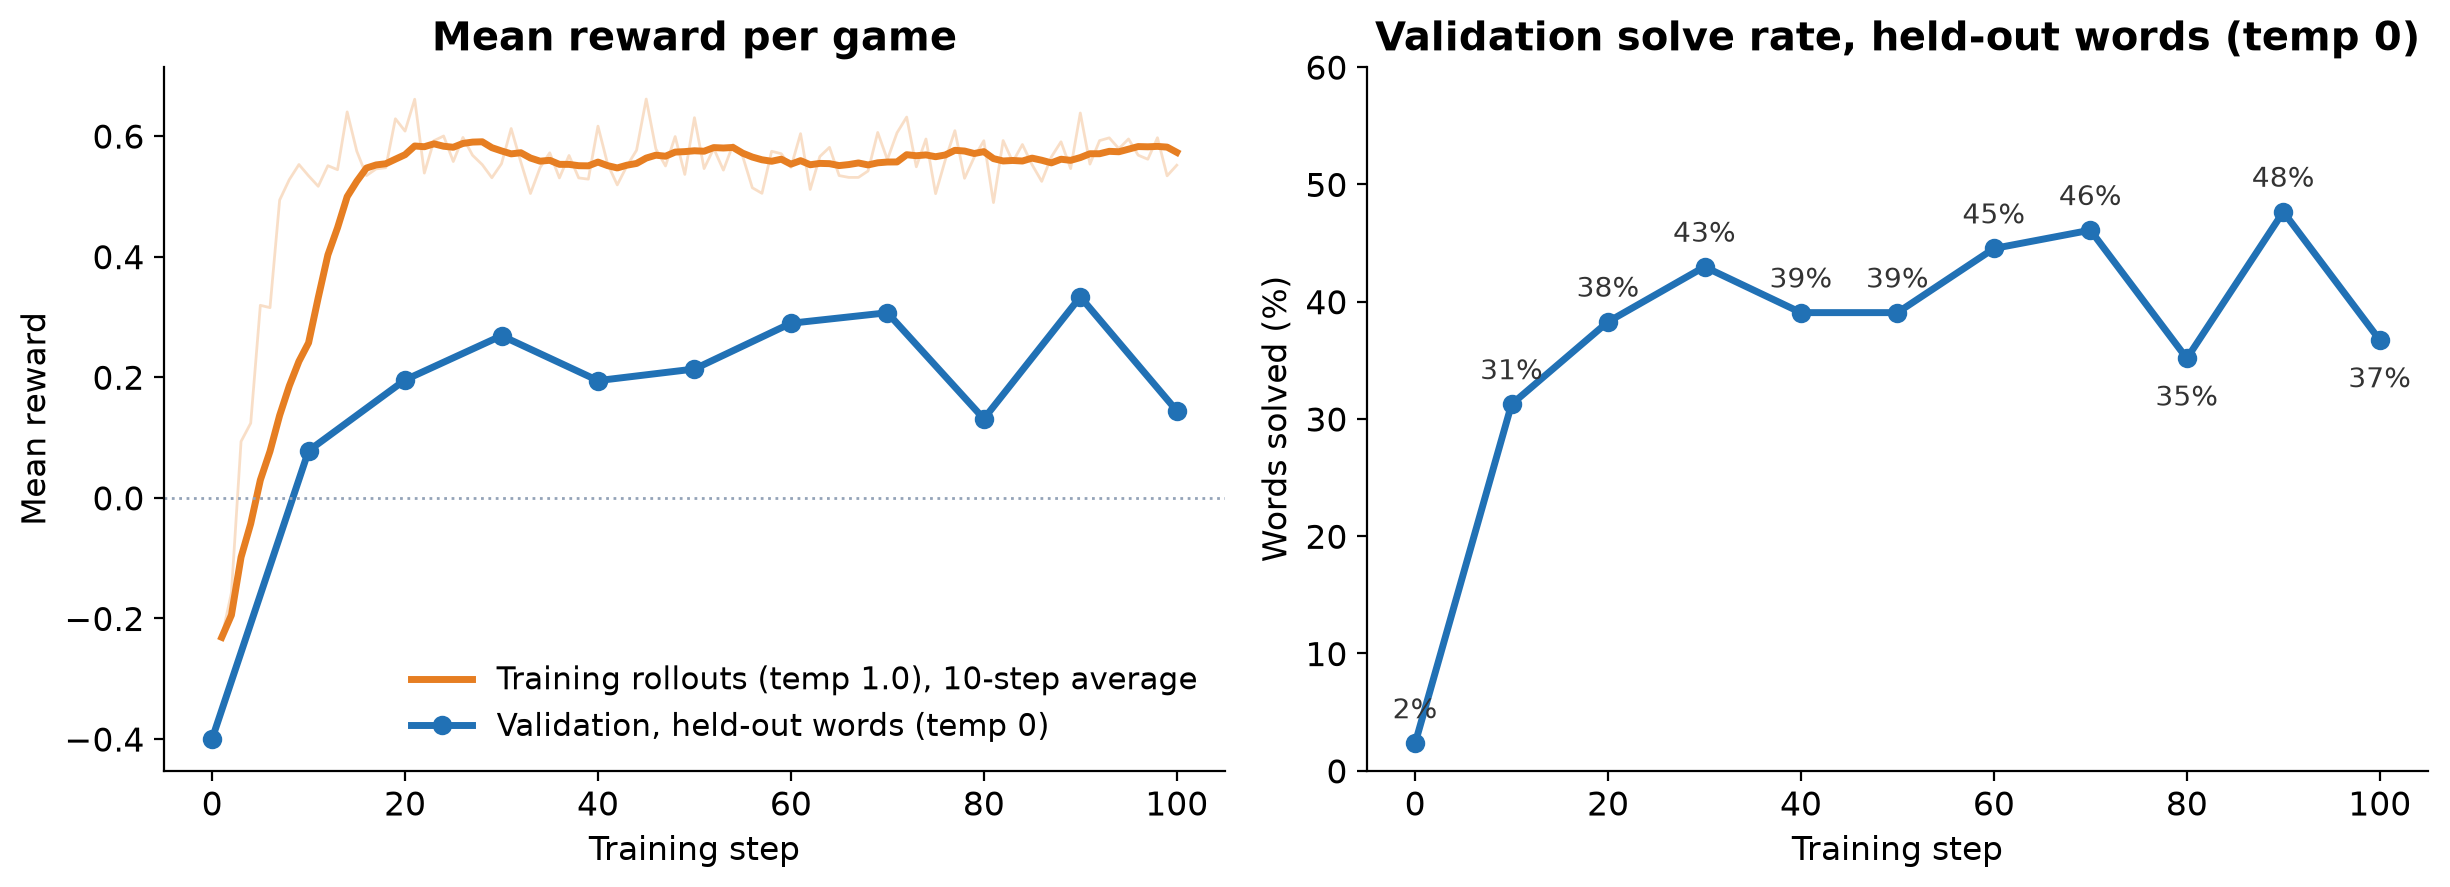
El servicio registra estadísticas de recompensa, token y turno en cada paso y ejecuta validación cada val_every pasos. La métrica a observar es val/reward/pass_at_1, la fracción de palabras retenidas resueltas. Cada resolución obtiene una puntuación de al menos 1.01, por lo que supera el umbral success_threshold del servicio de 1.0 y pass@1 lo cuenta. El siguiente gráfico se construye a partir de la historia de MLflow de esta ejecución:
Figura 4: Curvas de entrenamiento para la ejecución de 100 pasos, con la recompensa media por juego a la izquierda y la tasa de resolución de validación a la derecha
La recompensa de entrenamiento asciende a aproximadamente +0.57 dentro de 15 pasos y se mantiene allí. La recompensa de validación se mantiene más baja, en su mayoría debido a la temperatura 1.0 versus 0 en lugar de sobreajuste (ver Paso 7). La tasa de resolución de validación salta del 2 al 31 por ciento en los primeros 10 pasos, luego se mueve entre el 35 y el 48 por ciento. Con 128 palabras, esos cambios son en su mayoría ruido. No probamos si más pasos ayudan en la configuración de servicio.
Las trazas de OpenTelemetry del runtime en CloudWatch registran cada turno del modelo y llamada a una herramienta. Aquí hay un juego que el modelo entrenado jugó durante un trabajo de evaluación (esfuerzo medio, temperatura 1.0), con el razonamiento recortado. La palabra secreta era PASTE:
[model] Reasoning: [...] "CRANE" has 5 distinct letters: C,R,A,N,E. [...]
We'll guess "CRANE".
Tool call: guess_word(guess="CRANE")
[tool] Guess 1/6: CRANE -> C=gray, R=gray, A=yellow, N=gray, E=green
Current Knowledge:
- Correct Position (Green): _ _ _ _ E
- In Word, Wrong Position (Yellow): 'A' (at least 1)
- Not in Word (Gray): C, N, R
- Guesses Remaining: 5
[model] Reasoning: [...] "ALIVE": ends with E, includes A. Letters not C,N,R.
Tool call: guess_word(guess="ALIVE")
[tool] Guess 2/6: ALIVE -> A=yellow, L=gray, I=gray, V=gray, E=green
[model] Reasoning: [...] So positions not 1 or 3 for A. Positions left: 2,4
for A. [...] We might guess "HASTE"? [...]
Tool call: guess_word(guess="HASTE")
[tool] Guess 3/6: HASTE -> H=gray, A=green, S=green, T=green, E=green
[model] Reasoning: We have the word: _ASTE. [...] "PASTE" is a word. PASTE
fits. Also "WASTE" also fits [...] Choose "PASTE" maybe.
Tool call: guess_word(guess="PASTE")
[tool] Guess 4/6: PASTE --- all green. Correct, you solved it!
Un rollout del modelo entrenado desde las trazas del runtime de AgentCore. El modelo mantiene las letras verdes en su lugar, nunca reutiliza una letra gris y usa cada letra amarilla para descartar posiciones, aunque nada en los datos de entrenamiento le mostró cómo hacerlo.
Paso 7: Evaluar el modelo entrenado en la configuración de servicio
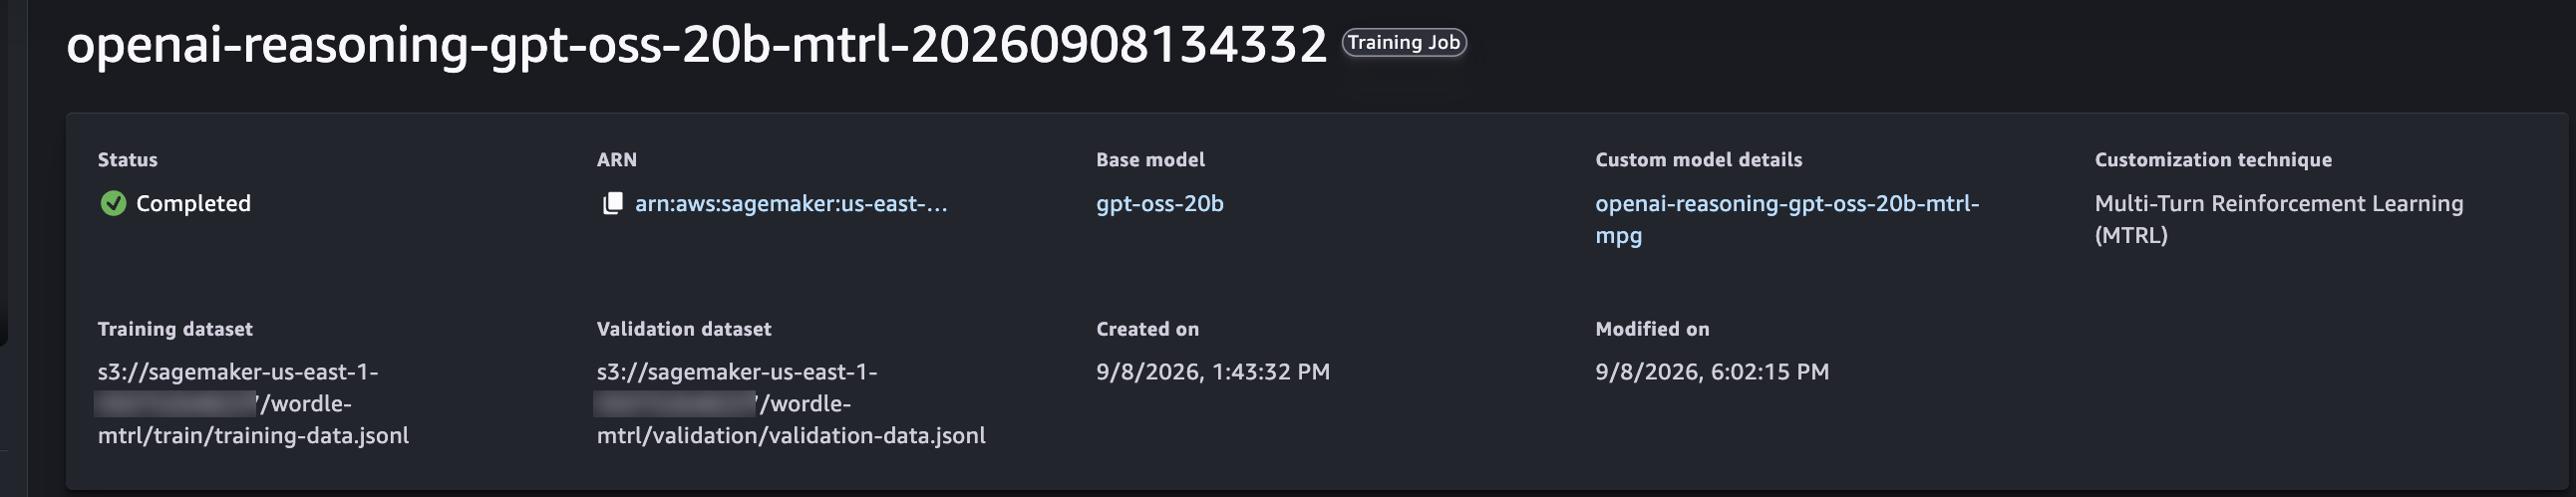
Una vez que el trabajo se completa, su página en SageMaker AI Studio muestra el estado y el grupo de paquetes de modelos que contiene el modelo entrenado. DescribeJob, con JobCategory establecido en AgentRFT, devuelve el ARN del paquete de modelos de salida y los recuentos de tokens facturables.
Figura 5: El trabajo de entrenamiento completado en SageMaker AI Studio en la pestaña Trabajos, Entrenamiento, RL de varias vueltas
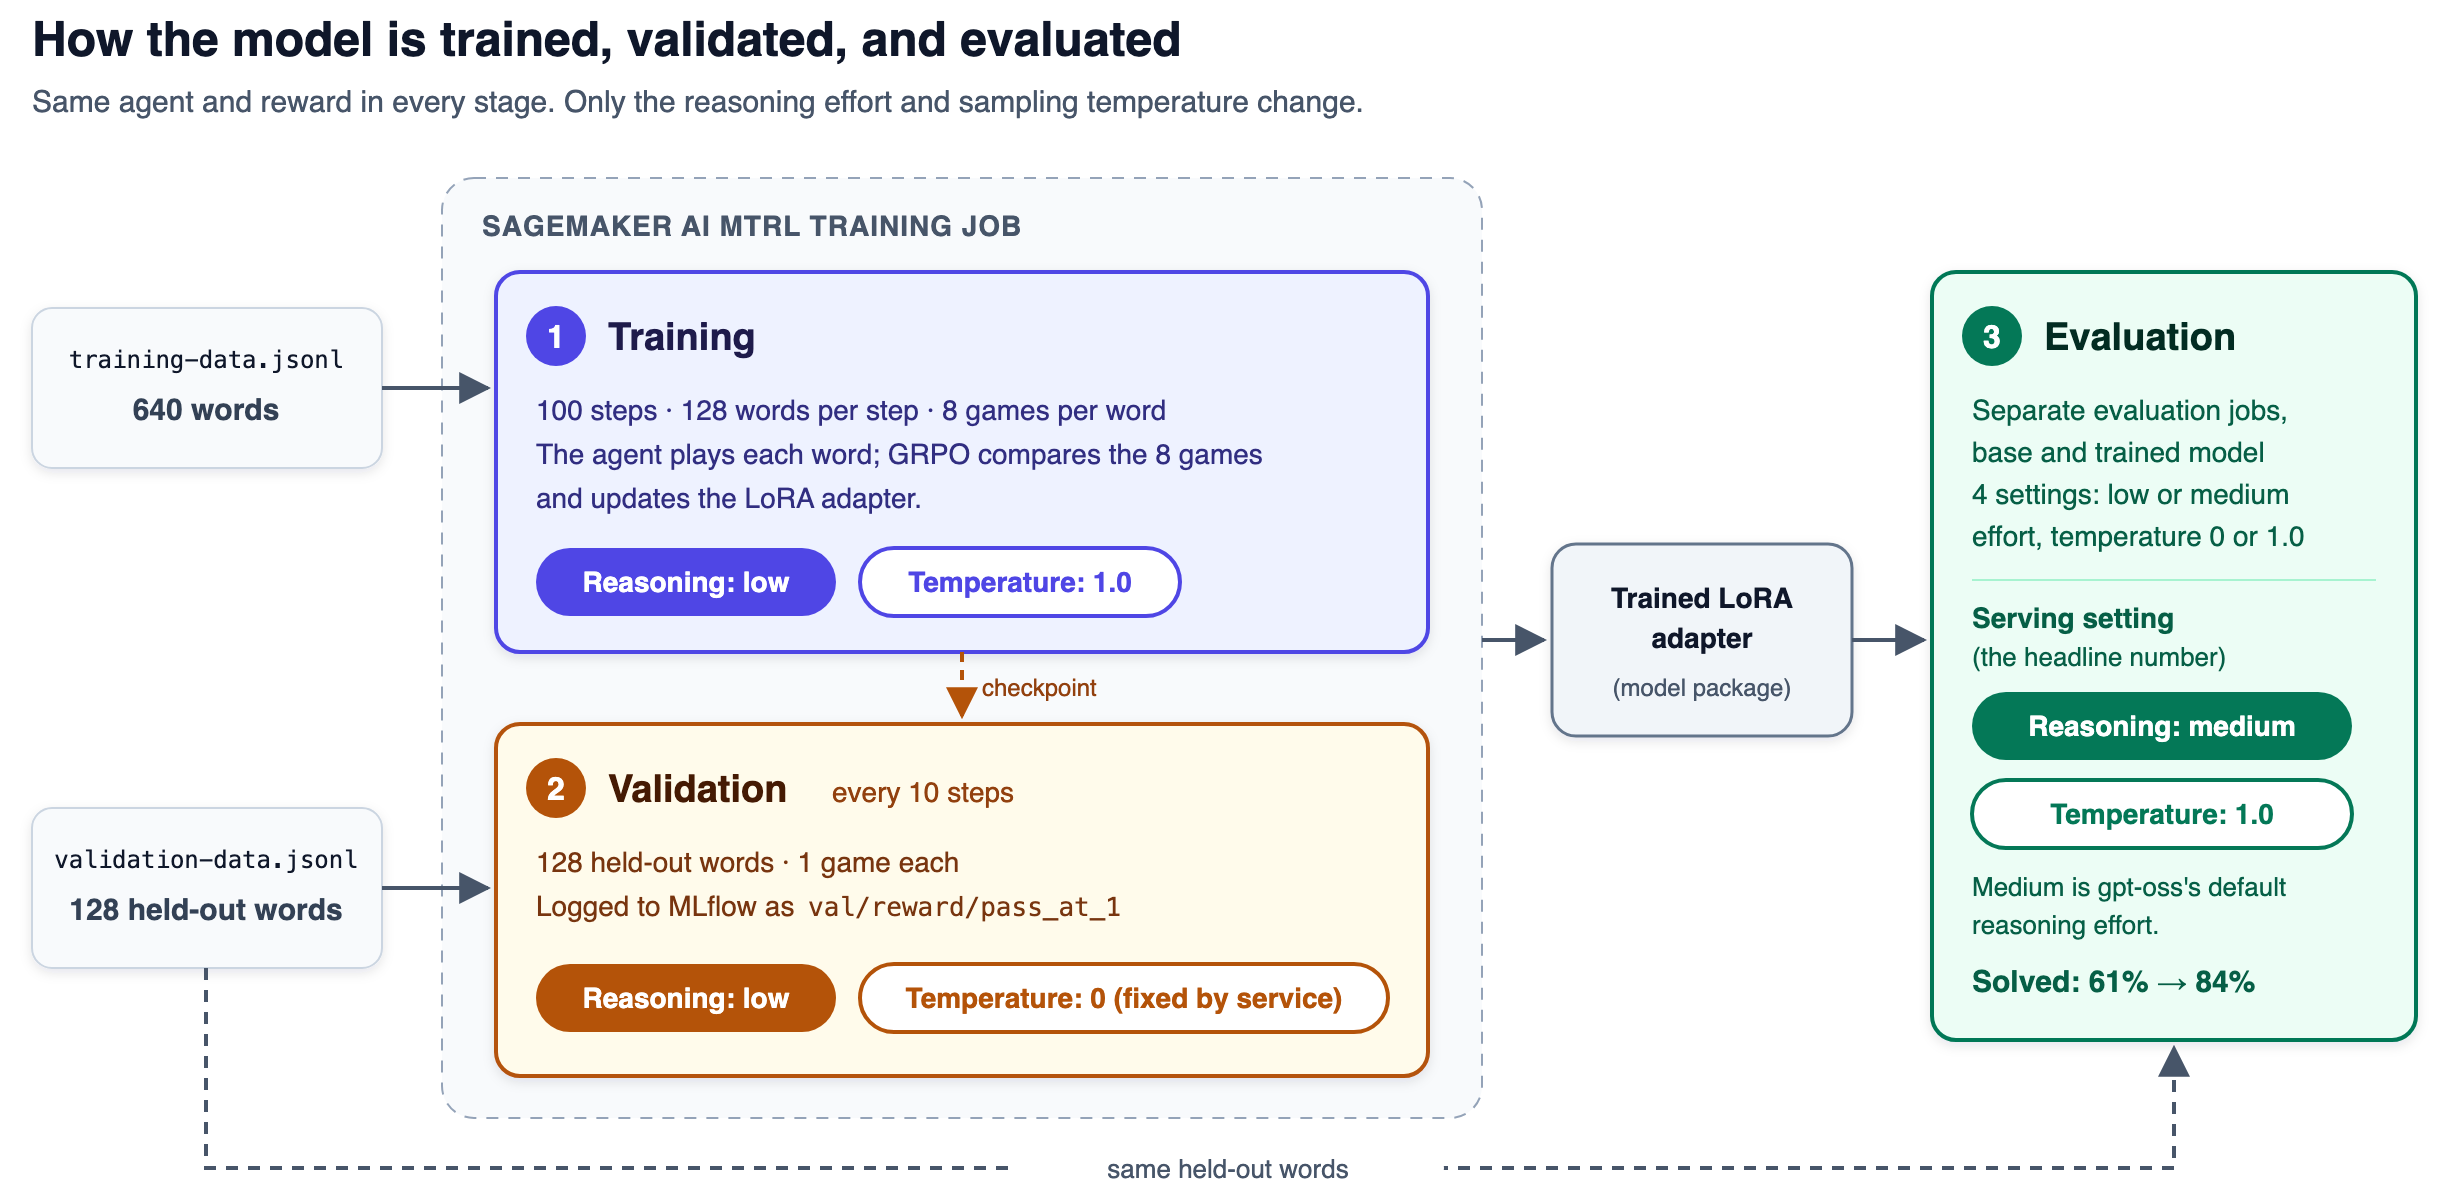
Un trabajo de evaluación (JobCategory establecido en AgentRFTEvaluation) reproduce los prompts de evaluación a través del mismo entorno de ejecución AgentCore y recompensa, en el modelo base o el paquete entrenado, y registra eval/reward/pass_at_1 en MLflow. A diferencia de la validación de entrenamiento, puede establecer la temperatura. El lanzador del repositorio ejecuta las evaluaciones una tras otra, porque la cuota predeterminada permite un trabajo de evaluación a la vez (puede solicitar un aumento):
Figura 6: Esfuerzo de razonamiento y temperatura de muestreo en cada etapa, donde el trabajo de entrenamiento fija la validación a temperatura 0 y el esfuerzo desplegado, mientras que los trabajos de evaluación le permiten elegir
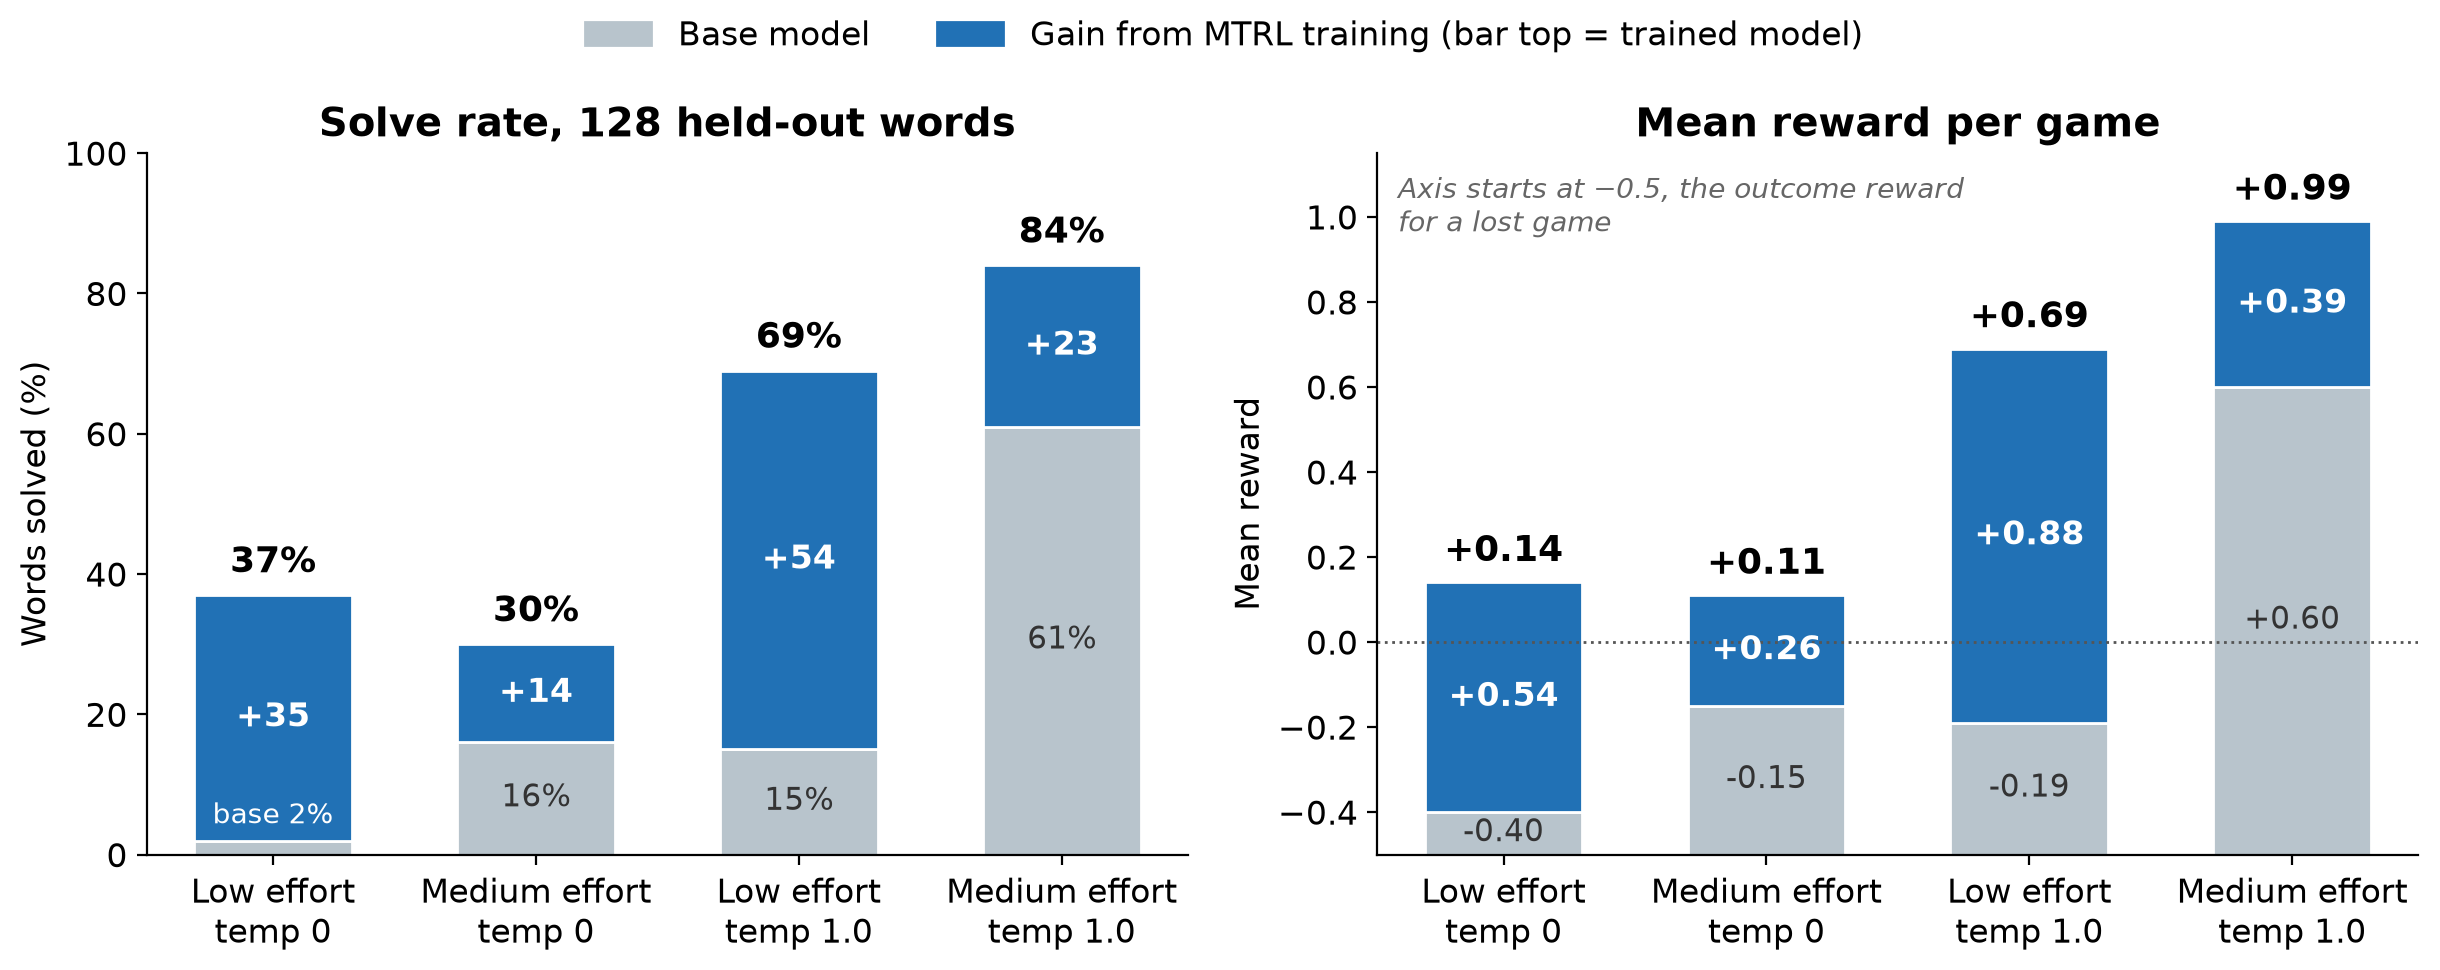
Cada evaluación de 128 palabras tomó de cuatro a siete minutos. El esfuerzo de razonamiento proviene de las variables de entorno del agente, por lo que para cambiarlo, edita REASONING_EFFORT, vuelve a implementar y evalúa. Evaluamos ambos modelos a bajo y medio esfuerzo y a temperatura 0 y 1.0:
Figura 7: Modelo base versus modelo entrenado bajo cuatro configuraciones de descodificación, con la tasa de resolución a la izquierda y la recompensa media por juego a la derecha
El segmento gris de cada barra es el modelo base y el segmento azul es la ganancia del entrenamiento. El par de esfuerzo bajo y temperatura 0 es la validación del trabajo de entrenamiento en los pasos 0 y 100. El resultado entrenado de esfuerzo medio y temperatura 1,0 es el promedio de dos ejecuciones (80 y 88 por ciento).
A temperatura 0, ambos modelos a menudo terminan el juego sin resolver, en cualquier esfuerzo. Con muestreo activado, el esfuerzo medio agrega 15 puntos para el modelo entrenado y 46 para el modelo base. El adaptador agrega 14–54 puntos en cada configuración, por lo que lo que el entrenamiento enseñó se transfiere entre configuraciones.
La curva de validación del trabajo de entrenamiento en MLflow contó una historia diferente: alcanzó un máximo del 48 por ciento en el paso 90 y terminó en 37 por ciento, evaluado a temperatura 0. La referencia de hiperparámetros recomienda temperatura 0 para la evaluación porque la descodificación codiciosa hace que las curvas sean determinísticas y comparables entre ejecuciones. Informamos temperatura 1,0 porque así es como servimos el modelo. A esfuerzo medio y temperatura 1,0, el modelo entrenado resuelve el 84 por ciento de las palabras retenidas, en comparación con el 61 por ciento del modelo base.
Consejo: Evalúe en las configuraciones que servirá. La curva de entrenamiento dice que este adaptador termina en 37 por ciento. En las configuraciones de servicio, resuelve el 84 por ciento. Los trabajos de evaluación que muestran esto cuestan alrededor de $1,20 en tokens y tardan alrededor de una hora.
Paso 8: Limpieza
Los trabajos de entrenamiento y evaluación dejan de facturarse cuando se completan, pero el runtime de AgentCore, su rol de IAM, la aplicación de MLflow y los objetos de S3 persisten. Desde el directorio del proyecto:
# 1. Agent runtime and its execution role. remove all resets the project config;
# the next deploy sees the empty state and tears down the deployed resources.
cd sample-multi-turn-rl-wordle/Wordle
agentcore remove all
agentcore deploy

# 2. MLflow app
aws sagemaker delete-mlflow-app --arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>

# 3. Datasets, job output, and evaluation output
aws s3 rm s3://<YOUR_BUCKET>/wordle-mtrl/ --recursive
Como agentcore remove all reescribe los archivos bajo agentcore/, ejecute git checkout -- agentcore/ si desea volver a implementar. Eliminar la pila de CloudFormation AgentCore-Wordle-default elimina los mismos recursos y deja los archivos intactos. El rol del trabajo de entrenamiento y los paquetes del modelo no se facturan.
Análisis detallado: Diseñar la recompensa
Nuestra recompensa necesitó una revisión y el error es común.
El primer diseño sumó la puntuación por suposición del proyecto wordle-lora-rl en todo el juego. Esa puntuación funciona allí porque cada suposición es una muestra de entrenamiento independiente. Sumada en una sola recompensa por juego, produjo dos inversiones que solo encontramos leyendo trazas:
Un juego perdido pagó una recompensa positiva. Seis turnos de bonificaciones sumaron aproximadamente +0.49.
Resolver en el turno 1 obtuvo una puntuación inferior a resolver en el turno 3. Una resolución en la primera suposición obtuvo +0.99 y una resolución en la tercera suposición obtuvo +1.61, porque los turnos adicionales recogieron más bonificaciones.
La solución separa un término de resultado dominante de un término de modelado pequeño y acotado:
reward = outcome + w * clip(shaping, -1, 1), w = 0.04 if solved, else 0.15
El término de resultado se establece enteramente por cómo terminó el juego:
Resultado
Valor
Resuelto en la suposición n
1.05 + 0.5 * (6 – n) / 5, así que 1.55 en la suposición 1 hasta 1.05 en la suposición 6
Jugadas las seis suposiciones, sin resolver
-0.5
Nunca se hizo una suposición válida
-1.5
El término de modelado es esa puntuación por suposición, sumada en todo el juego:
Penalizaciones por contradecir una letra verde, amarilla o gris conocida, por repetir una suposición y por palabras fuera del diccionario.
Una bonificación de entropía para una palabra de apertura fuerte.
Bonificaciones por intentar letras nuevas y por reducir el conjunto de posibilidades restantes.
La suma se recorta a [-1, 1] y se escala por 0.04 para una resolución y 0.15 para una pérdida, así que separa juegos con el mismo resultado pero nunca mueve un juego a otro nivel. Con valores de modelado típicos:
Escenario
Recompensa
Resuelto en la suposición 1
+1.550
Resuelto en la suposición 3
+1.375
Resuelto en la suposición 6
+1.069
Perdido después de seis suposiciones
-0.427
Nunca se hizo una suposición válida
-1.500
Una solución más rápida siempre supera a una más lenta, toda solución supera a toda pérdida y nunca jugar es el peor resultado. Nuestra primera solución utilizó un solo peso de 0.15, lo que permitió que una solución de adivinanza-3 con forma completa (+1.45) superara a una solución de adivinanza-2 con el mínimo (+1.25). Las cuentas de adivinanzas adyacentes están 0.1 aparte, por lo que un peso de solución más pequeño de 0.04 elimina la superposición, y la peor solución (+1.01) aún supera el umbral de éxito de 1.0. La forma aún importa porque GRPO aprende de la varianza de la recompensa dentro de un grupo, por lo que dos juegos perdidos que difieren en la consistencia de las pistas aún enseñan algo al modelo. Como aconseja la documentación de SageMaker AI, comience con una recompensa basada en el resultado, agregue forma de manera escasa y verifique la recompensa en trayectorias reales.
Análisis detallado: Qué salió mal, en el orden en que lo encontrarás
Cada uno de estos costó al menos una ejecución de entrenamiento.
Token de portador bajo concurrencia. Acuñar un token con una sesión de botocore fresca por llamada agotó al proveedor de credenciales en 32 implementaciones concurrentes, y almacenar en caché tokens durante una hora devolvió errores 403 cuando las credenciales se rotaban. La solución es una sesión de autoactualización, una caché corta y una firma nuevamente en 403.
Una implementación que nunca alcanza el modelo de política falla todo el trabajo. Cuando cada llamada de modelo en una implementación falló la autenticación, el servicio terminó el trabajo con “No se recibieron solicitudes de muestreo”. Devolver un estado de error también lo hace fallar, así que siempre devuelva una recompensa. Un juego donde el modelo se muestrea pero nunca hace una suposición válida está bien: obtiene -1.5, y la ejecución de 100 pasos tuvo 51 de ellos en aproximadamente 105,000 implementaciones.
Llamadas de herramientas que se desvían hacia texto plano. Con una tasa de aprendizaje demasiado alta, el modelo escribió llamadas de herramientas como texto, cada implementación obtuvo la misma recompensa de piso y el gradiente desapareció. El agente ahora recupera suposiciones de texto sin formato con una pequeña penalización de formato.
El plateau. La recompensa de entrenamiento dejó de aumentar después de aproximadamente el paso 15 y la validación dejó de mejorar después de aproximadamente el paso 30, aunque a temperatura 0 la validación subestima el modelo (Paso 7). Un plan de estudios que siembra juegos con suposiciones anteriores, o más implementaciones por palabra que el valor predeterminado group_size de 8, es lo que probaríamos a continuación.
Conclusión
MTRL en SageMaker AI entrena un modelo en el resultado de todo un episodio. Eso se ajusta a tareas agénticas, donde la trayectoria correcta es desconocida y solo el resultado puede ser evaluado. Usamos una sola recompensa a nivel de episodio. Cuando los pasos intermedios también pueden ser evaluados, MTRL también acepta una recompensa por turno a través de la API UpdateReward. En esta publicación, un modelo de 20B con peso abierto alcanzó una tasa de resolución del 84 por ciento en la configuración de servicio, en comparación con el 61 por ciento, por aproximadamente $339 en tokens de entrenamiento y aproximadamente $79 en uso de tiempo de ejecución de AgentCore. El 37 por ciento que informa la curva de entrenamiento es un artefacto de cómo el trabajo de entrenamiento evalúa la validación, así que evalúe en la configuración que utilizará para servir.
Para empezar, clone el repositorio de ejemplo, siga los pasos anteriores y ejecute la prueba de humo en el paso 3 antes de comprometer el tiempo de la GPU. Para las API subyacentes, consulte la documentación de SageMaker AI MTRL.
Sobre los autores
Most fine-tuning teaches a model to produce a better answer to a single prompt. Agentic tasks are different. An agent that files an expense report or triages a support ticket takes a sequence of actions, and each step depends on what came before. There’s rarely one correct sequence to imitate, and the only reliable feedback is whether the whole sequence succeeded. Supervised fine-tuning has no labels for that, and single-turn reinforcement learning cannot credit a decision made three steps before the outcome.
Multi-Turn Reinforcement Learning (MTRL) on Amazon SageMaker AI trains models on exactly that signal. SageMaker AI sends prompts to an agent you host on Amazon Bedrock AgentCore, or on your own infrastructure, such as Amazon Elastic Kubernetes Service (Amazon EKS), Amazon Elastic Compute Cloud (Amazon EC2), or AWS Fargate, through an AWS Lambda forwarder. The example here uses AgentCore. The agent calls the policy model being trained, acts in your environment over as many turns as the task needs, and reports one reward when the episode ends. You don’t specify the right trajectory, only how to score the result.
This post uses Wordle, a game in which a player has six tries to guess a hidden five-letter word, as the example. After each guess, every letter turns green if it is in the right position, yellow if it’s in the word but in a different position, and gray if it isn’t in the word. The game suits MTRL because the rules are few, each guess depends on the feedback from the last, and the outcome is scored objectively. Wordle is a teaching example, and frontier models already play it well. In practice, you would use MTRL to make a small, low-cost model good at a multi-step task specific to your business, such as an internal workflow that public models were never trained on. The same pipeline applies to that setting.
In our run, MTRL took gpt-oss-20b from a 61 to an 84 percent solve rate on held-out words at its default reasoning effort, and from 15 to 69 percent at the low effort it trained at, for about $339 in training tokens. In this post, we walk through the pipeline end-to-end: deploying the agent and reward to AgentCore, preparing the dataset, training, monitoring in MLflow, and evaluating at serving settings. We also share the reward-design mistakes and training failures we hit. Your datasets, agent, and trained model stay in your AWS account and are not used to train the base models. All code is in the accompanying aws-samples repository.
Solution overview
The system has two halves. SageMaker AI owns the training job and the policy model. AgentCore hosts the agent, the Wordle environment, and the reward function. The following diagram shows how they connect.
Figure 1: MTRL on SageMaker AI, where the training job invokes the AgentCore-hosted agent once per rollout to sample the policy model, play the game, and report a reward
For every rollout, the MTRL service invokes the AgentCore runtime, a capability of Amazon Bedrock AgentCore, with one training row, which holds one secret word. A Strands agent in the runtime calls the policy model through the SageMaker Job Runtime’s OpenAI-compatible endpoint. The model plays up to six guesses through one tool, guess_word, and after each guess the environment returns per-letter feedback and a summary of what is known. When the game ends, the agent returns one reward. Group Relative Policy Optimization (GRPO) uses the spread of rewards across several rollouts of the same word to update a Low-Rank Adaptation (LoRA) adapter on the policy model.
Three design points matter for what follows:
The agent and reward live in one place. A single Python file deployed to AgentCore holds the environment, the tool, and the scoring function.
The dataset carries only the secret word. The word lists bundled with the agent are built from the open-source SCOWL word lists and are used only for scoring.
The reward is outcome-dominant. A solve pays 1.05–1.55 depending on speed, a loss pays -0.5, and never making a valid guess pays -1.5. A small shaping term rewards good strategy within each tier.
Supported models and AWS Regions
MTRL is serverless: you pick a base model and the service provisions the training and sampling infrastructure. At the time of writing, it supports the following base models, each trained with a LoRA adapter:
Base model
AWS Regions
Amazon Nova 2 Lite
US East (N. Virginia) (us-east-1), US West (Oregon) (us-west-2)
GPT-OSS-20B
US East (N. Virginia) (us-east-1), US West (Oregon) (us-west-2)
Gemma 4 31B (instruction-tuned)
US West (Oregon) (us-west-2)
Qwen 3.6 27B
US West (Oregon) (us-west-2)
We chose GPT-OSS-20B because it has the lowest per-token price of the four and its reasoning effort is controllable per request. See the MTRL documentation for the current list.
Pricing
You don’t choose instances or size a cluster. You pay per million tokens in three dimensions, priced by base model:
Prefill: input tokens the policy model processes. These accumulate in a multi-turn task, because every turn re-reads the history.
Sample: tokens the policy model generates, including reasoning tokens.
Train: tokens processed in the backward pass that updates the LoRA adapter.
The 100-step run consumed 491.6 million prefill, 159.7 million sample, and 643.3 million train tokens across 105,486 rollouts in 12 hours 40 minutes. At GPT-OSS-20B list prices in the US East (N. Virginia) Region (us-east-1) at the time of writing, that is about $339:
Dimension
Tokens
Price per 1M
Cost
Prefill
491,616,806
$0.12
$58.99
Sample
159,737,098
$0.30
$47.92
Train
643,308,554
$0.36
$231.59
Total
1,294,662,458
$338.50
The train dimension dominates and scales with trajectory length, so shorter games and less verbose reasoning cut the bill. The AgentCore runtime bills separately for the vCPU and memory the agent uses. For this run, that was about $79, from the runtime’s Amazon CloudWatch usage metrics at us-east-1 list prices. DescribeJob reports the token counts under BillableTokenUsage. See Amazon SageMaker AI pricing for current rates.
Prerequisites
To follow this walkthrough, you need the following. See also the MTRL prerequisites.
Python 3.10 or later, uv, Node 20 or later, and the AgentCore CLI (npm install -g @aws/agentcore). See Get started with Amazon Bedrock AgentCore for installation and the IAM permissions the CLI needs.
botocore 1.43.37 or later, on the machine that launches the job. This is the first version that includes the AgentRFTCreateJob operation.
Two AWS Identity and Access Management (IAM) roles, described in Step 1.
An Amazon Simple Storage Service (Amazon S3) bucket in the same Region as the agent. The training job must also run in that Region, because CreateJob rejects a cross-Region runtime ARN.
Step 1: Create the IAM roles
MTRL uses two roles, and one of them has a trust policy that the general SageMaker AI documentation doesn’t mention.
Agent runtime role.agentcore deploy creates this role for you. It trusts bedrock-agentcore.amazonaws.com and needs the AmazonSageMakerJobRuntimeAccess managed policy, which lets the agent call the policy model and report rewards. The CDK stack in the sample repository attaches this policy automatically.
Training job role. You create this one. It must trust job.sagemaker.amazonaws.com with both sts:AssumeRole and sts:TagSession, and it needs the AmazonSageMakerJobFullAccess managed policy.
Note: The trust principal is job.sagemaker.amazonaws.com, not sagemaker.amazonaws.com. With the generic principal, CreateJob fails with “Could not assume role,” and the message names the correct principal only after retries.
Step 2: Deploy the agent to Amazon Bedrock AgentCore
Clone the sample repository, set your account and Region in Wordle/agentcore/aws-targets.json, and deploy:
git clone https://github.com/aws-samples/sample-multi-turn-rl-wordle
cd sample-multi-turn-rl-wordle/Wordle
agentcore validate
agentcore deploy
The CLI builds the agent’s dependencies for the runtime’s Linux ARM64 platform, creates the execution role with AmazonSageMakerJobRuntimeAccess attached, and deploys through AWS CloudFormation. We recommend it over uploading a code package on the console, where it’s common to get the roughly 700 MB of compiled dependencies or the policy attachment wrong. Note the runtime ARN in the output for the training job.
Figure 2: The Wordle agent runtime in the Amazon Bedrock AgentCore console with status Ready
The runtime reads two environment variables from agentcore.json. REASONING_EFFORT=low sets reasoning_effort on every request to the policy model. In our evaluation jobs, low effort used 63 to 83 percent fewer sample tokens per game than medium. REASONING_PROMPT_HINT=true also adds “Reasoning: low” to the system prompt, which is how gpt-oss reads the setting in its Harmony chat format. Neither variable gives the model any hint about the secret word.
Figure 3: Runtime environment variables showing REASONING_EFFORT set to low
The agent is one file, main.py. Simplified, its entrypoint looks like the following. For your own task, you change the task parsing, the tools, and the reward:
app = BedrockAgentCoreApp()

@app.entrypoint  # outermost: starts the HTTP server AgentCore invokes
@sagemaker_rft_handler  # reports the returned reward to SageMaker AI
def handle_rollout(payload):
    prompt, answer = parse_task(payload["prompt"])
    game = WordleGame(answer)

    @tool
    def guess_word(guess: str) -> str:
        """Submit a 5-letter Wordle guess and get feedback."""
        return game.guess(guess)

    agent = Agent(model=build_model(), system_prompt=SYSTEM_PROMPT, tools=[guess_word])
    agent(prompt)
    return {"reward": game.final_reward()}
Important: The sagemaker_rft_handler decorator does not start an HTTP server by itself. Wrap it with BedrockAgentCoreApp and @app.entrypoint, with the entrypoint decorator outermost. Without this, every invocation times out after 30 seconds.
Step 3: Verify the runtime
Before spending GPU time, confirm the whole chain works with a payload shaped like the one the training service sends. The repository includes one as Wordle/payload.json:
The fake job ARN is expected to fail, and the way it fails is the proof. Put your own account ID into it first: for a job ARN in another account, the service returns a 403 before it checks whether the job exists, which looks like a broken IAM setup. From the Wordle directory, run:
In the runtime’s Amazon CloudWatch logs, you see the agent parse the prompt, authenticate to the Job Runtime endpoint, and receive a 400 error reading “Could not find job.” That failure confirms that parsing, authentication, and error reporting work. The command itself prints {“reward”: -1.5}, because the agent never reached the policy model. A 403 reading “not authorized to access this resource” means the job ARN still names another account. A 30-second timeout instead means the HTTP server is not starting (see the Important note in Step 2).
Step 4: Prepare the dataset
The MTRL dataset has no target responses, transcripts, or labels. Each row is one task for the agent to attempt. Here are the first three rows of the training file:
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"riser\", \"id\": \"wordle_train_0000\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"swoon\", \"id\": \"wordle_train_0001\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"dirty\", \"id\": \"wordle_train_0002\"}"}
The service reads the prompt column (or the first column) and passes the string to your agent verbatim, without parsing it. We made the string a small JSON object with three fields:
prompt: the instruction the agent shows the policy model, identical on every row.
answer: the secret word. Only the environment and the reward function use it. The policy model never sees it.
id: a row ID for tracing a rollout in the logs back to its source row.
The sample repository’s make_dataset.py draws 640 training words (five full batches of 128) and 128 validation words from the answer list with no overlap, so the validation solve rate measures generalization. The service also accepts Apache Parquet, JSON arrays, and CSV. Upload both files to Amazon S3:
Because the service never inspects the prompt string, a production task can pack a full message list, tool configuration, or reward specification into it. See the MTRL documentation for examples, including how to protect sensitive content in the string.
Step 5: Launch the training job
The launcher uses the MultiTurnRLTrainer class from the sagemaker-train SDK. Point it at the runtime ARN from Step 2, the role from Step 1, the datasets from Step 4, and an MLflow app for metrics. The MLflow app is required, so if you don’t have one, create it first with aws sagemaker create-mlflow-app:
The launcher overrides three hyperparameters and leaves every other one at the gpt-oss-20b default. It sets sampling_max_tokens to 8192, the service maximum, because at the default of 4096 gpt-oss often ran out of tokens while reasoning, before its first tool call. It sets max_epochs to 20 and max_steps to 100: 640 rows at the default global_batch_size of 128 is 5 steps per epoch, and with the default group_size of 8, each step plays 1,024 games. The job moves through Starting, Downloading, and Pending before reaching Training. After it’s training, your AgentCore runtime begins receiving rollout invocations.
Important: Don’t redeploy the agent while a job is running. Redeploying restarts the runtime, in-flight rollouts see no sampling requests, and the service fails the entire job.
Step 6: Monitor training in MLflow
The service logs reward, token, and turn statistics at every step and runs validation every val_every steps. The metric to watch is val/reward/pass_at_1, the fraction of held-out words solved. Every solve scores at least 1.01, so it clears the service’s success_threshold of 1.0 and pass@1 counts it. The following chart is built from this run’s MLflow history:
Figure 4: Training curves for the 100-step run, with mean reward per game on the left and validation solve rate on the right
Training reward climbs to about +0.57 within 15 steps and holds there. Validation reward stays lower, mostly because of temperature 1.0 versus 0 rather than overfitting (see Step 7). The validation solve rate jumps from 2 to 31 percent in the first 10 steps, then moves between 35 and 48 percent. With 128 words, those swings are mostly noise. We did not test whether more steps help at serving settings.
The runtime’s OpenTelemetry traces in CloudWatch record every model turn and tool call. Here is one game the trained model played during an evaluation job (medium effort, temperature 1.0), with the reasoning trimmed. The secret word was PASTE:
[model] Reasoning: [...] "CRANE" has 5 distinct letters: C,R,A,N,E. [...]
We'll guess "CRANE".
Tool call: guess_word(guess="CRANE")
[tool] Guess 1/6: CRANE -> C=gray, R=gray, A=yellow, N=gray, E=green
Current Knowledge:
- Correct Position (Green): _ _ _ _ E
- In Word, Wrong Position (Yellow): 'A' (at least 1)
- Not in Word (Gray): C, N, R
- Guesses Remaining: 5
[model] Reasoning: [...] "ALIVE": ends with E, includes A. Letters not C,N,R.
Tool call: guess_word(guess="ALIVE")
[tool] Guess 2/6: ALIVE -> A=yellow, L=gray, I=gray, V=gray, E=green
[model] Reasoning: [...] So positions not 1 or 3 for A. Positions left: 2,4
for A. [...] We might guess "HASTE"? [...]
Tool call: guess_word(guess="HASTE")
[tool] Guess 3/6: HASTE -> H=gray, A=green, S=green, T=green, E=green
[model] Reasoning: We have the word: _ASTE. [...] "PASTE" is a word. PASTE
fits. Also "WASTE" also fits [...] Choose "PASTE" maybe.
Tool call: guess_word(guess="PASTE")
[tool] Guess 4/6: PASTE --- all green. Correct, you solved it!
A trained-model rollout from the AgentCore runtime traces. The model keeps green letters in place, never reuses a gray letter, and uses each yellow letter to rule out positions, though nothing in the training data showed it how.
Step 7: Evaluate the trained model at serving settings
When the job completes, its page in SageMaker AI Studio shows the status and the model package group that holds the trained model. DescribeJob, with JobCategory set to AgentRFT, returns the output model package ARN and the billable token counts.
Figure 5: The completed training job in SageMaker AI Studio on the Jobs, Training, Multi-turn RL tab
An evaluation job (JobCategory set to AgentRFTEvaluation) plays your evaluation prompts through the same AgentCore runtime and reward, on the base model or the trained package, and logs eval/reward/pass_at_1 to MLflow. Unlike training validation, you can set the temperature. The repository’s launcher runs evaluations back to back, because the default quota allows one evaluation job at a time (you can request an increase):
Figure 6: Reasoning effort and sampling temperature at each stage, where the training job fixes validation at temperature 0 and the deployed effort while evaluation jobs let you choose
Each 128-word evaluation took four to seven minutes. Reasoning effort comes from the agent’s environment variables, so to change it you edit REASONING_EFFORT, redeploy, and evaluate. We evaluated both models at low and medium effort and at temperature 0 and 1.0:
Figure 7: Base model versus trained model under four decoding settings, with solve rate on the left and mean reward per game on the right
The gray segment of each bar is the base model and the blue segment is the gain from training. The low-effort, temperature-0 pair is the training job’s validation at steps 0 and 100. The medium-effort, temperature-1.0 trained result is the mean of two runs (80 and 88 percent).
At temperature 0, both models often end the game without a solve, at either effort. With sampling on, medium effort adds 15 points for the trained model and 46 for the base model. The adapter adds 14–54 points in every setting, so what training taught transfers across settings.
The training job’s own validation curve in MLflow told a different story: it peaked at 48 percent at step 90 and ended at 37 percent, scored at temperature 0. The hyperparameters reference recommends temperature 0 for evaluation because greedy decoding makes curves deterministic and comparable across runs. We report temperature 1.0 because that’s how we serve the model. At medium effort and temperature 1.0, the trained model solves 84 percent of held-out words, up from 61 percent for the base model.
Tip: Evaluate at the settings you will serve at. The training curve says this adapter ends at 37 percent. At serving settings it solves 84 percent. The evaluation jobs that show this cost about $1.20 in tokens and took about an hour.
Step 8: Clean up
Training and evaluation jobs stop billing when they complete, but the AgentCore runtime, its IAM role, the MLflow app, and the S3 objects persist. From the project directory:
# 1. Agent runtime and its execution role. remove all resets the project config;
# the next deploy sees the empty state and tears down the deployed resources.
cd sample-multi-turn-rl-wordle/Wordle
agentcore remove all
agentcore deploy

# 2. MLflow app
aws sagemaker delete-mlflow-app --arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>

# 3. Datasets, job output, and evaluation output
aws s3 rm s3://<YOUR_BUCKET>/wordle-mtrl/ --recursive
Because agentcore remove all rewrites the files under agentcore/, run git checkout -- agentcore/ if you want to redeploy later. Deleting the AgentCore-Wordle-default CloudFormation stack removes the same resources and leaves the files alone. The training job role and the model packages are not billed.
Deep dive: Designing the reward
Our reward needed one revision, and the mistake is a common one.
The first design summed the per-guess scoring from the wordle-lora-rl project over the whole game. That scoring works there because each guess is an independent training sample. Summed into one reward per game, it produced two inversions we found only by reading traces:
A lost game paid positive reward. Six turns of bonuses added up to about +0.49.
Solving on turn 1 scored below solving on turn 3. A first-guess solve earned +0.99 and a third-guess solve earned +1.61, because the extra turns collected more bonuses.
The fix separates a dominant outcome term from a small, bounded shaping term:
reward = outcome + w * clip(shaping, -1, 1), w = 0.04 if solved, else 0.15
The outcome term is set entirely by how the game ended:
Outcome
Value
Solved on guess n
1.05 + 0.5 * (6 – n) / 5, so 1.55 on guess 1 down to 1.05 on guess 6
Played all six guesses, unsolved
-0.5
Never made a valid guess
-1.5
The shaping term is that per-guess scoring, summed over the game:
Penalties for contradicting a known green, yellow, or gray letter, for repeating a guess, and for words outside the dictionary.
An entropy bonus for a strong opening word.
Bonuses for trying new letters and for shrinking the set of remaining possibilities.
The sum is clipped to [-1, 1] and scaled by 0.04 for a solve and 0.15 for a loss, so it separates games with the same outcome but never moves a game into another tier. With typical shaping values:
Scenario
Reward
Solve on guess 1
+1.550
Solve on guess 3
+1.375
Solve on guess 6
+1.069
Lost after six guesses
-0.427
Never made a valid guess
-1.500
A faster solve now always beats a slower one, every solve beats every loss, and never playing is the worst outcome. Our first fix used a single weight of 0.15, which let a guess-3 solve with full shaping (+1.45) outscore a guess-2 solve with the minimum (+1.25). Adjacent guess counts are 0.1 apart, so a smaller solve weight of 0.04 removes the overlap, and the worst solve (+1.01) still clears the 1.0 success threshold. Shaping still matters because GRPO learns from reward variance within a group, so two lost games that differ in clue consistency still teach the model something. As the SageMaker AI documentation advises, start with an outcome-based reward, add shaping sparingly, and check the reward on real trajectories.
Deep dive: What went wrong, in the order you will hit it
Each of these cost at least one training run.
Bearer tokens under concurrency. Minting a token with a fresh botocore session per call starved the credential provider at 32 concurrent rollouts, and caching tokens for an hour returned 403 errors as credentials rotated. The fix is one self-refreshing session, a short cache, and a re-sign on 403.
A rollout that never reaches the policy model fails the whole job. When every model call in a rollout failed authentication, the service ended the job with “No sampling requests were received.” Returning an error status fails it too, so always return a reward. A game where the model is sampled but never makes a valid guess is fine: it scores -1.5, and the 100-step run had 51 of them in about 105,000 rollouts.
Tool calls drift into plain text. At too high a learning rate, the model wrote tool calls as text, every rollout got the same floor reward, and the gradient vanished. The agent now recovers guesses from raw text with a small formatting penalty.
The plateau. Training reward stopped rising after about step 15 and validation stopped improving after about step 30, though at temperature 0 validation understates the model (Step 7). A curriculum that seeds games with prior guesses, or more rollouts per word than the default group_size of 8, is what we would try next.
Conclusion
MTRL on SageMaker AI trains a model on the outcome of a whole episode. That fits agentic tasks, where the right trajectory is unknown and only the result can be scored. We used a single episode-level reward. When intermediate steps can be scored too, MTRL also accepts one reward per turn through the UpdateReward API. In this post, an open-weight 20B model reached an 84 percent solve rate at serving settings, up from 61 percent, for about $339 in training tokens and about $79 in AgentCore runtime usage. The 37 percent the training curve reports is an artifact of how the training job scores validation, so evaluate at the settings you will serve at.
The same pipeline applies to internal procedures, tools, and workflows that public models were never trained on.
To get started, clone the sample repository, follow the preceding steps, and run the smoke test in Step 3 before committing GPU time. For the underlying APIs, see the SageMaker AI MTRL documentation.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.