
Parte 1 de esta serie creó el modelo operativo que controla el gasto de Amazon Bedrock: atribución con etiquetas de principios de AWS Identity and Access Management (IAM) y Cost and Usage Report 2.0, observabilidad con registro de invocación de modelos, aplicación en tres niveles y una cadencia de revisión. Esa capa responde a quién gastó el dinero y puedes detenerlos. No puede decirte si el gasto se utilizó bien.
Esta publicación responde a dos preguntas que la Parte 1 dejó abiertas deliberadamente. Primero: ¿Por qué este flujo de trabajo es costoso? La respuesta requiere pensar en costo por tarea, no costo por token. Segundo: ¿El agente es mejor que los humanos? La respuesta requiere líneas de base, experimentos controlados y una tarjeta de puntuación vinculada a decisiones.
En esta publicación, aprendes un framework para calcular el costo real del modelo (incluyendo cuatro impulsores de costo ocultos que la página de precios no muestra), técnicas para reducir el costo por tarea mediante caché, enrutamiento y restricciones de salida, y una disciplina para medir el ROI del agente con líneas de base humanas, experimentos de retención y una tarjeta de puntuación de cinco dimensiones. Esta publicación está escrita para dos audiencias: los ingenieros de aplicaciones y plataformas que poseen las palancas de optimización, y los propietarios de productos y socios de FinOps que necesitan justificar el gasto del agente ante la dirección.
Costo por tarea, no costo por token
El precio por token invita a una comparación rápida, pero no refleja lo que realmente pagas. La tarifa publicada refleja el costo de un solo token. Tu factura refleja el costo de completar una tarea. Una tarea es una unidad completa de trabajo que tu aplicación le pide a un modelo que realice: resolver un correo electrónico de soporte, extraer campos de una factura o responder a una pregunta de un usuario. Una tarea se ejecuta desde la solicitud hasta un resultado utilizable, sin importar cuántas llamadas al modelo sea necesario.
El modelo de menor precio puede que no sea el más barato de ejecutar. Un modelo más barato puede fragmentar tu texto en más tokens, rellenar respuestas con relleno, malinterpretar tu esquema de herramientas y realizar correcciones en bucle, o quemar miles de tokens de razonamiento antes de responder. Ninguno de estos costos aparece en la página de precios de Bedrock.
Los cuatro impulsores de costo ocultos
Cuatro características del modelo determinan qué cuesta realmente la tarifa publicada en tu carga de trabajo.
Eficiencia del tokenizador
Un token no es una palabra, y no es igual en todos los modelos. Cada familia de modelos utiliza un tokenizador y un vocabulario diferentes. El mismo texto, código o carga JSON se divide en diferentes cuentas de tokens. Si el precio de lista del Modelo A es un 15 por ciento más bajo, pero su tokenizador necesita un 40 por ciento más de tokens para sus datos (común en esquemas estructurados y matrices numéricas), el Modelo B es más barato. La brecha se amplía para textos no ingleses: muchos tokenizadores fragmentan scripts no latinos en dos o tres veces más tokens que el equivalente en inglés.
Alineación y verbosidad de salida
Los tokens de salida suelen costar 3-5 veces más que los tokens de entrada (la relación varía según la familia. Consulte la página de precios de Bedrock). Un modelo que ignora las restricciones de formato como "devolver solo JSON sin procesar" le hace pagar el premio de salida por palabras de relleno. Un modelo que sigue las instrucciones de formato de cerca ahorra dinero generando menos de estos tokens de salida más costosos.
Eficiencia del bucle agente
Los flujos de trabajo agente cambian por completo la matemática del costo. Uso de herramientas (llamada a funciones) permite que un modelo invoque funciones externas, requiriendo un bucle de varios giros: analizar la solicitud, decidir llamar a una herramienta, esperar la observación, generar una respuesta. Cada giro vuelve a enviar la historia de conversación completa y los resultados de la herramienta como tokens de entrada. Un modelo que tarda cuatro giros (cada uno reenviando una carga de contexto más grande) cuesta mucho más que uno que termina en un solo pase.
Carga de razonamiento
Muchos modelos admiten pensamiento extendido, trabajando a través de una cadena de pensamiento antes de la respuesta visible. Los tokens de razonamiento se facturan como tokens de salida, por lo que un modelo que piensa durante 2,000 tokens antes de una respuesta de 200 tokens le factura 2,200. Algunos modelos tachan el razonamiento mientras aún lo cobran. Comience con el razonamiento desactivado y actívelo solo cuando las pruebas de referencia muestren una brecha de calidad que justifique el costo.
Costo por tarea: Un ejemplo trabajado
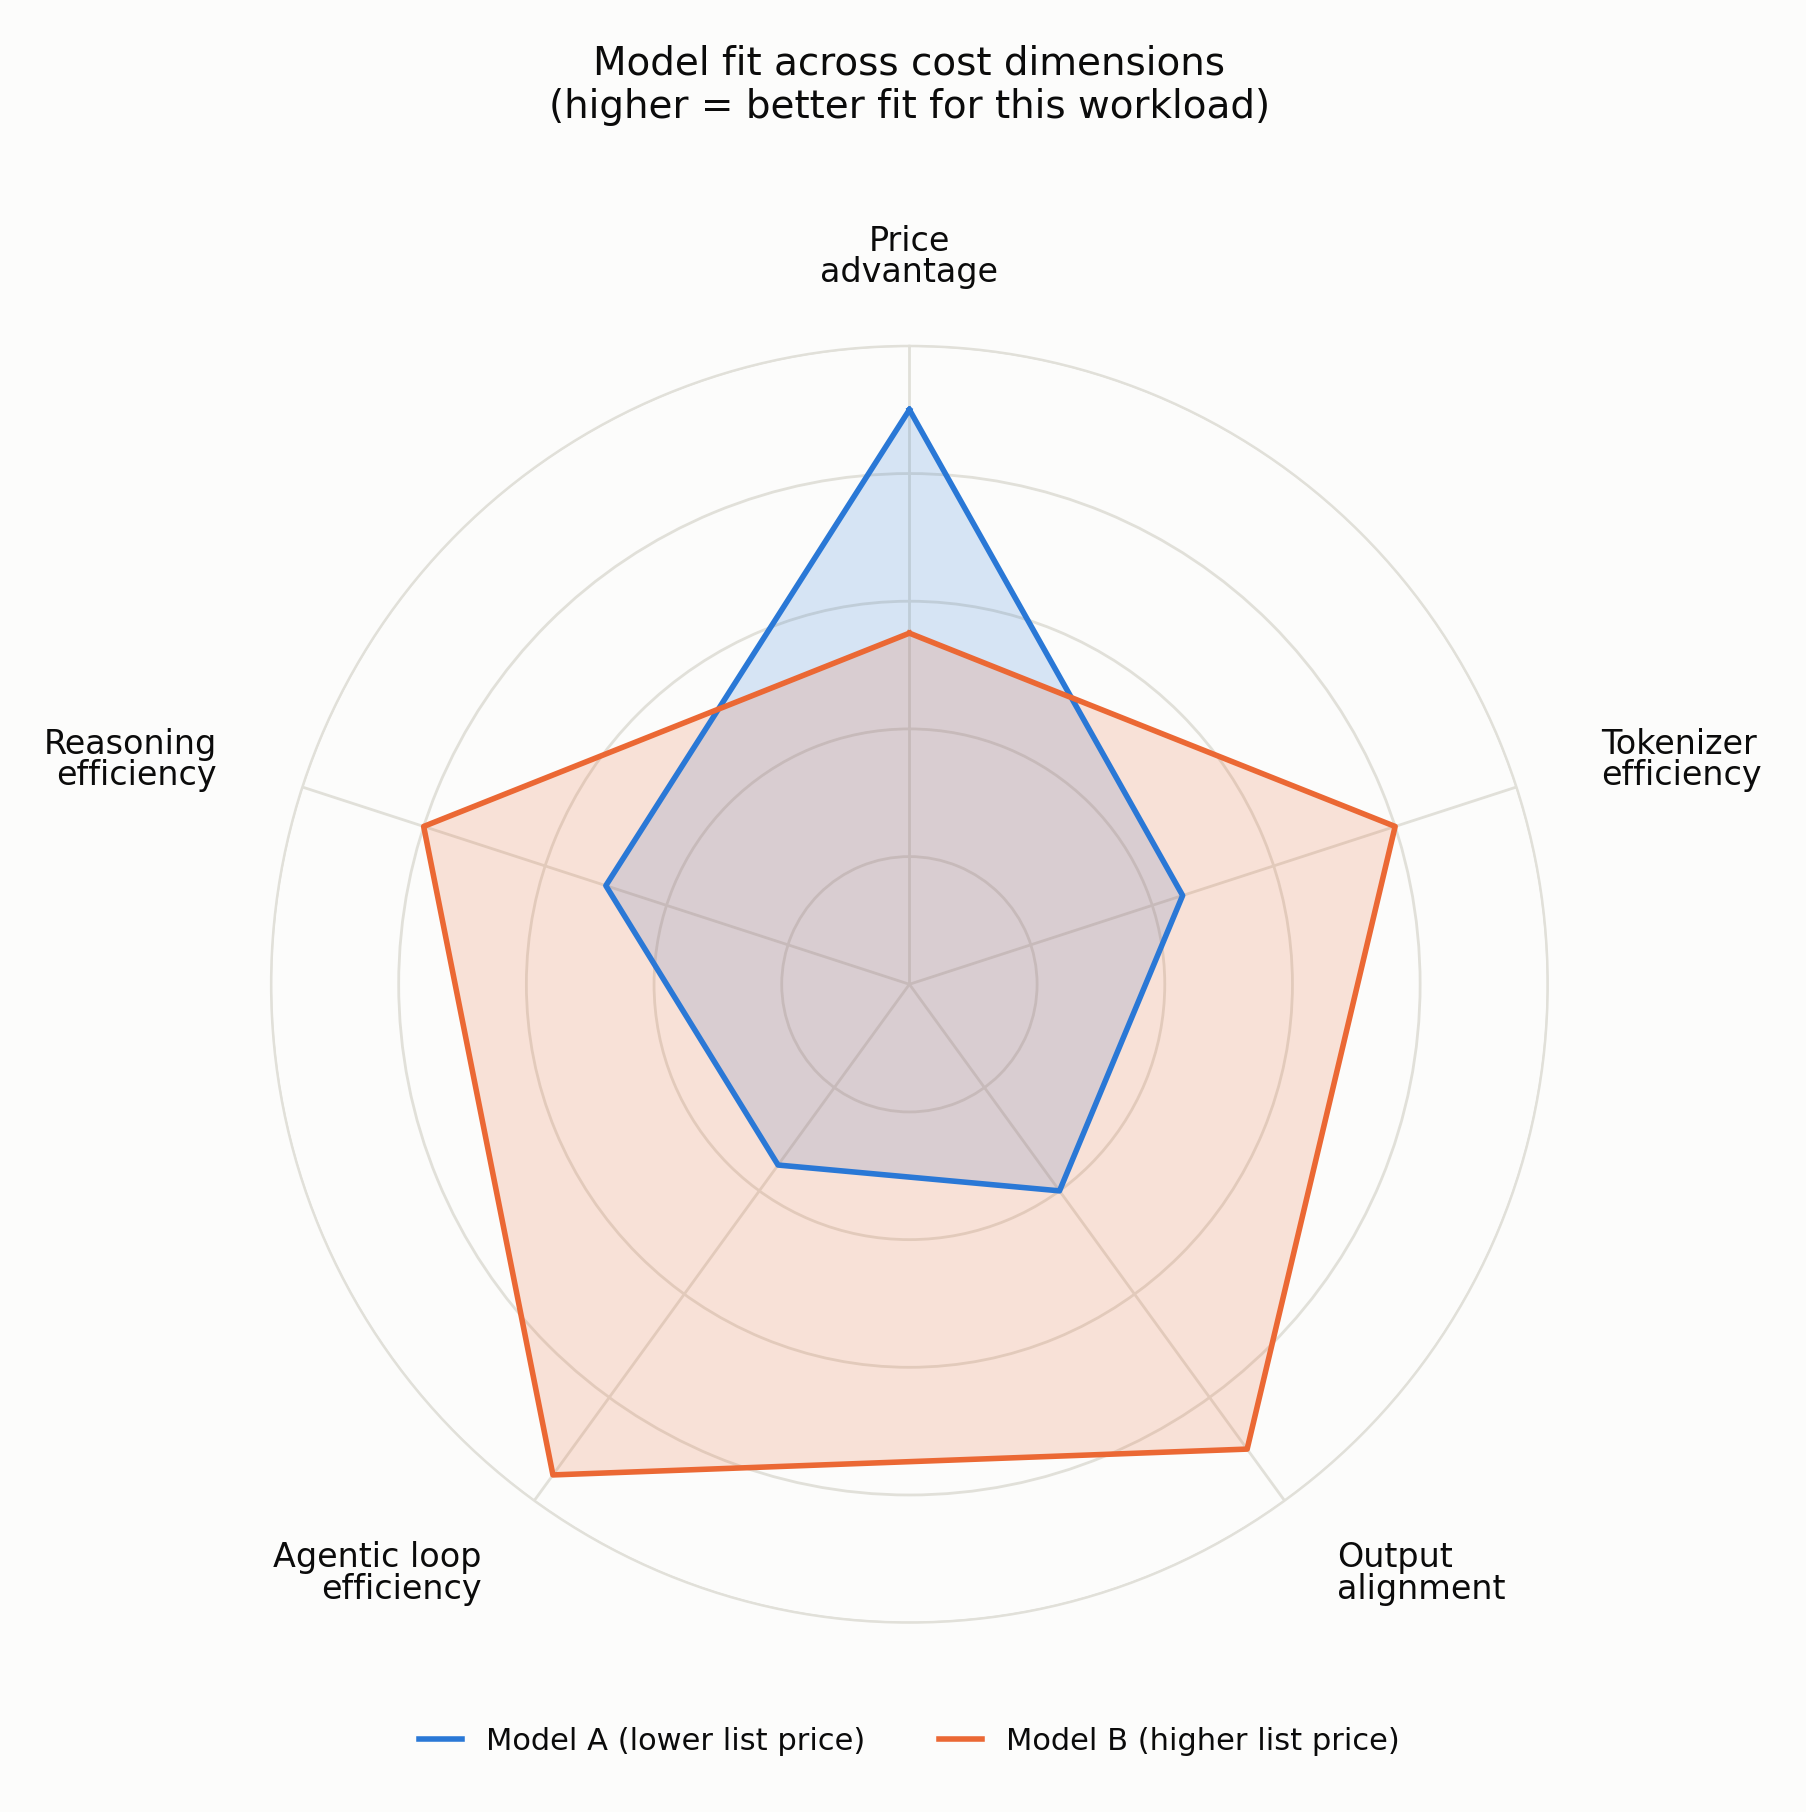
Figura 1: Comparación de dos modelos en cinco dimensiones de costo. El precio de lista es solo uno de los cinco factores que determinan el costo real
Considere un flujo de trabajo agente que lee un correo electrónico de 750 palabras del cliente, extrae entidades, llama a una API para verificar el estado de la cuenta y produce un JSON estricto. La siguiente comparación utiliza precios ilustrativos (siempre benchmark contra sus propios datos y los precios actuales de Bedrock):
| Métrica | Modelo A (precio de lista más bajo) | Modelo B (precio de lista más alto) |
| Precio de lista de entrada | $0.50 / 1M tokens | $1.00 / 1M tokens |
| Precio de lista de salida | $1.50 / 1M tokens | $3.00 / 1M tokens |
| Eficiencia del tokenizador (turno 1 de entrada) | 1,500 tokens | 1,000 tokens |
| Verbosidad de salida (respuesta final) | 450 tokens | 150 tokens |
| Bucles agente requeridos | 3 turnos (corrección de errores) | 1 turno (zero-shot) |
| Tokens de entrada acumulados, todos los turnos | 6,150 | 1,000 |
| Tokens de salida acumulados, todos los turnos | 750 | 150 |
| Costo total de la tarea | $0.0042 | $0.00145 |
Modelo A: (6,150 x $0.50 + 750 x $1.50) / 1,000,000 = $0.0042
Modelo B: (1,000 x $1.00 + 150 x $3.00) / 1,000,000 = $0.00145
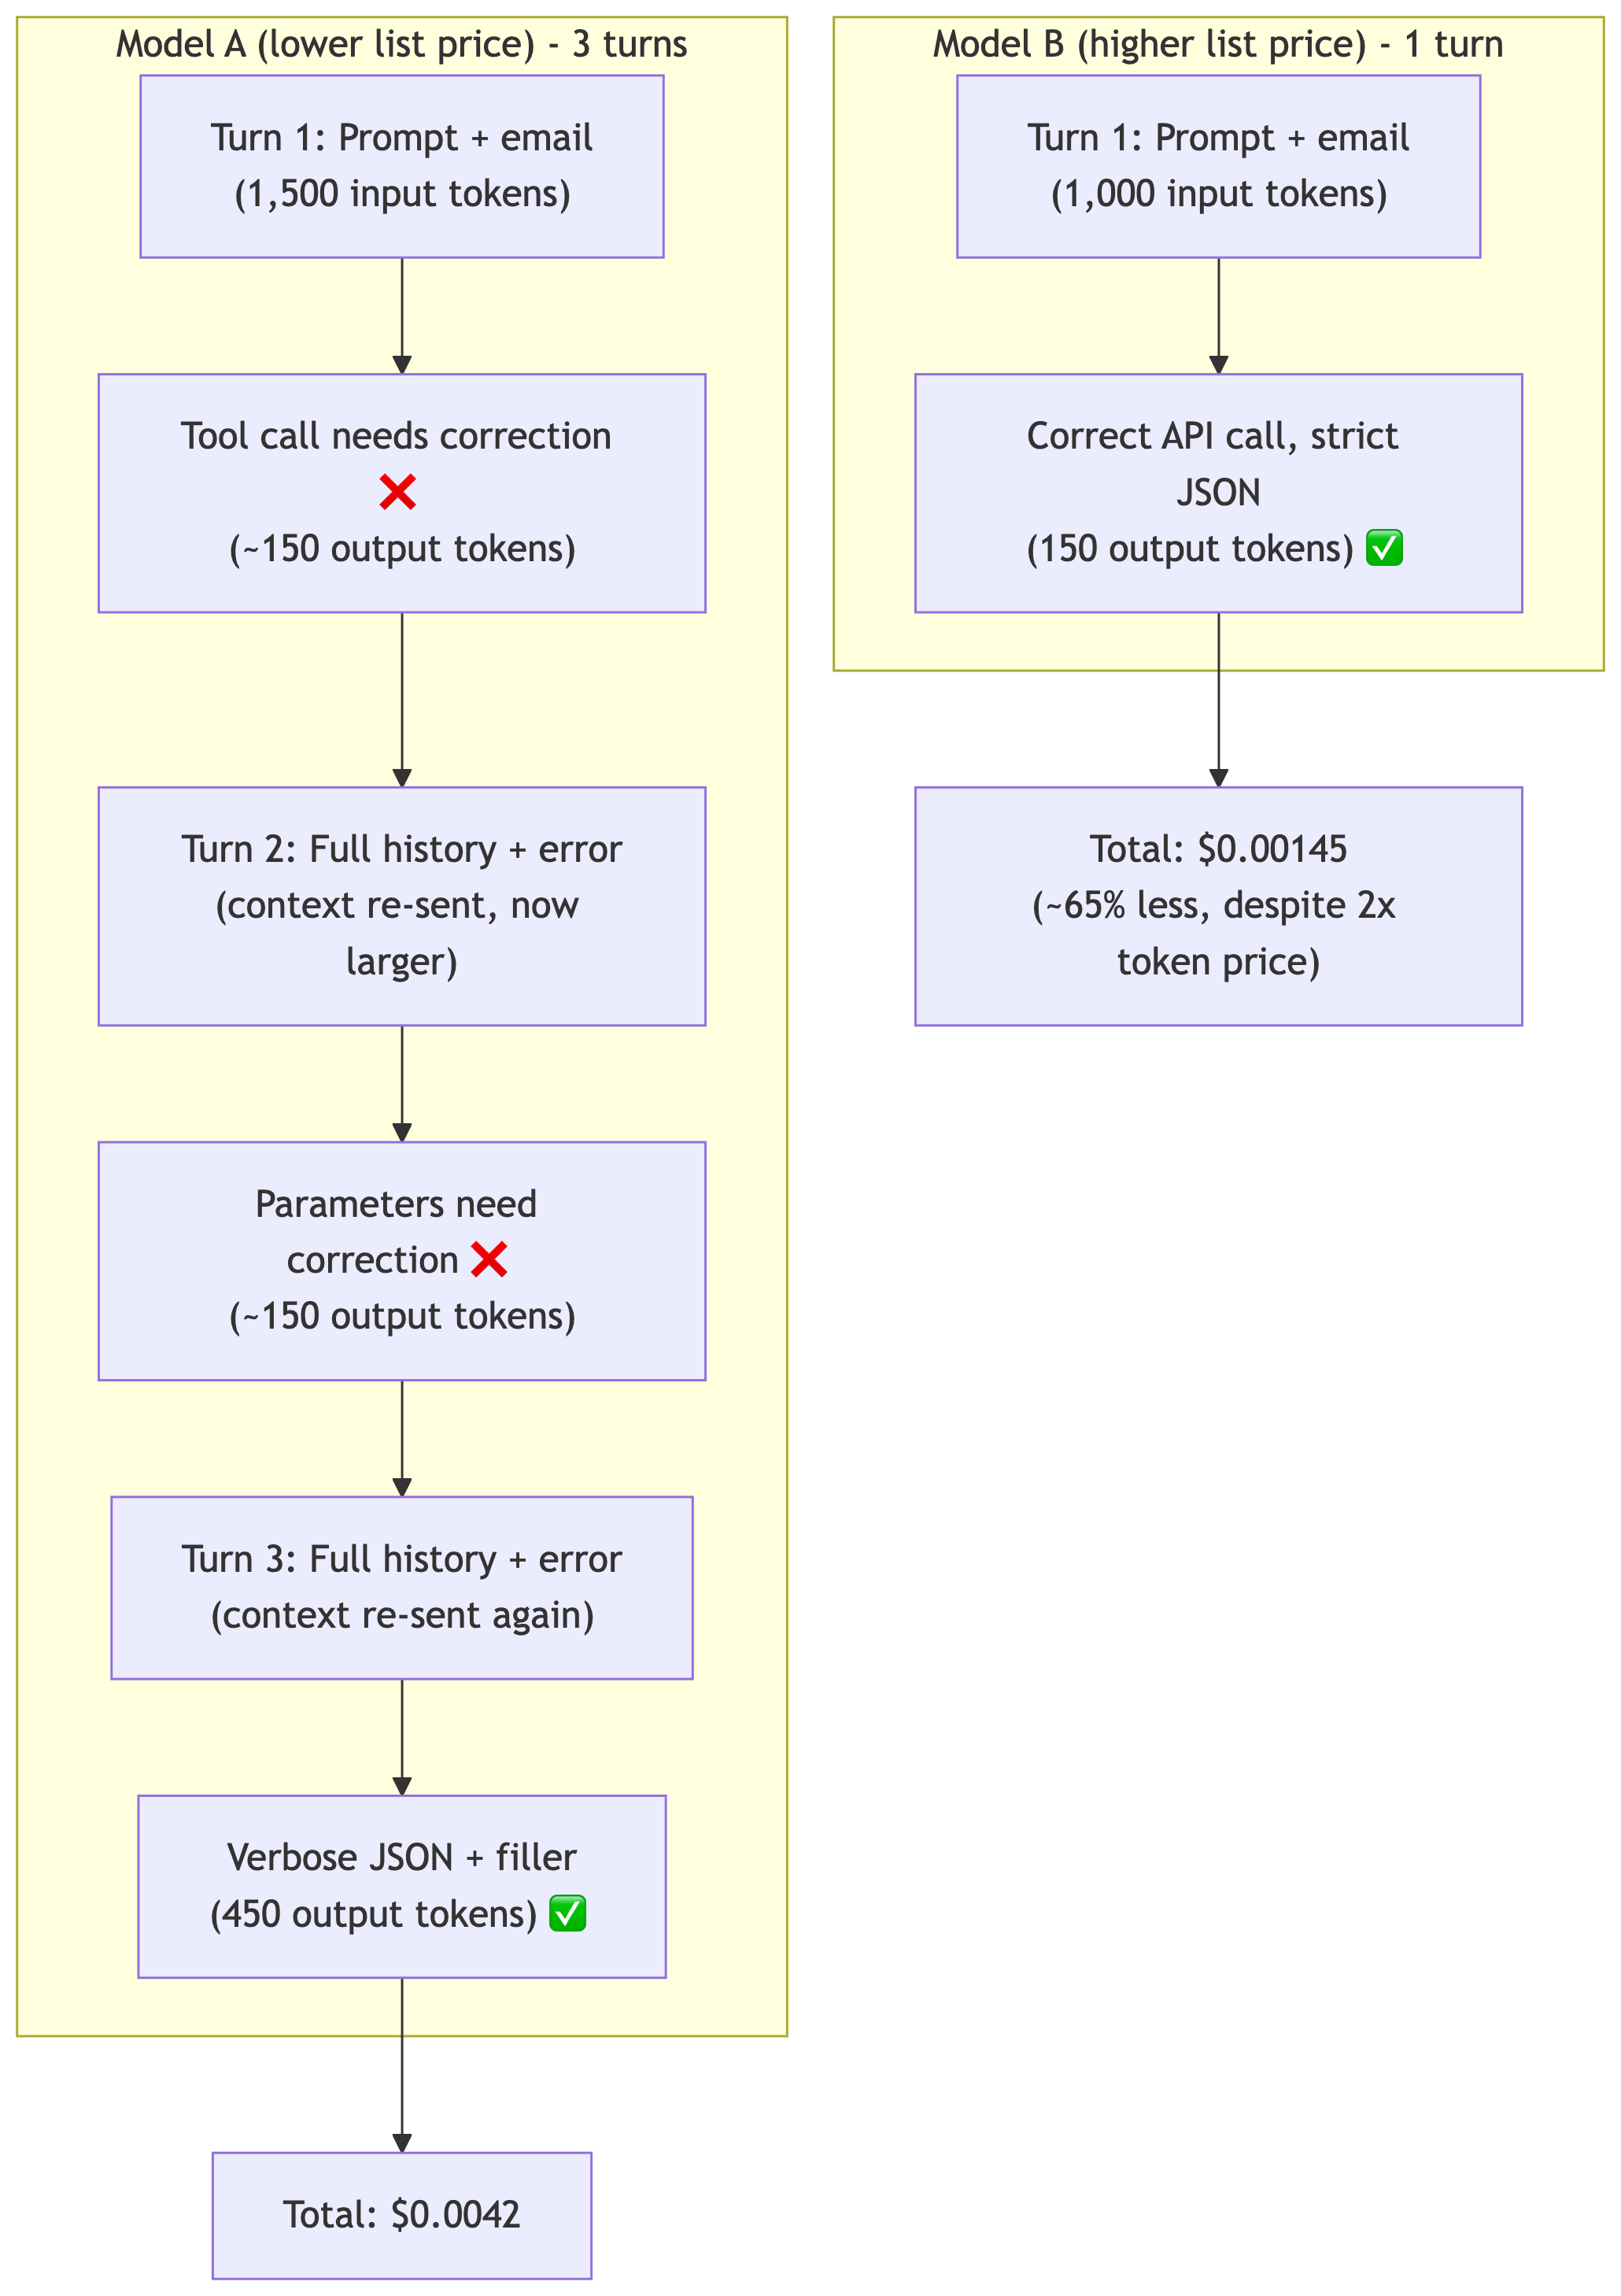
Figura 2: Por qué el modelo de mayor precio cuesta 65% menos. Cada turno adicional reenvía una carga de contexto en crecimiento, lo que aumenta la factura
Por qué el modelo de precio 2x cuesta 65 por ciento menos: tres factores que se combinan. El tokenizador del Modelo A fragmenta el correo electrónico en 50 por ciento más tokens, lo que infla cada carga de entrada. Rellena su JSON con relleno, triplicando los tokens de salida. Y no se alinea con el esquema de la herramienta, necesitando dos turnos de corrección que cada uno reenvía una historia en crecimiento.
Costo por tarea exitosa
El ejemplo anterior supone que ambos modelos eventualmente tienen éxito. En producción, no lo harán, y un fallo rara vez es gratuito. Las fórmulas:
Para flujos de trabajo de reintento hasta el éxito:
cost per successful task = cost per attempt / success rate
Para flujos de trabajo de escalada en caso de fallo:
cost per successful task = cost per attempt + (1 - success rate) x escalation cost
La entrada se divide aún más en tres cubetas cuando el almacenamiento en caché de solicitudes está activo: entrada sin caché a la tasa base, lecturas de caché por debajo de la tasa base y escrituras de caché por encima de la tasa base.
Medirlo en su propia carga de trabajo
Qué modelo es en realidad más barato solo se muestra cuando se realiza una prueba de rendimiento contra sus propios datos. La evaluación de modelos de Amazon Bedrock es la función administrada para la mitad de calidad de eso: definir criterios, cargar sus conjuntos de datos de solicitudes y obtener resultados puntuados con métricas automáticas y revisión humana opcional, sin requerir infraestructura personalizada.
Las puntuaciones de calidad solas no producen una factura, aunque. Tres funciones más de Bedrock suministran el token y los recuentos de giros que se pueden preciar contra ellos:
- CountTokens devuelve el recuento de tokens de entrada que un modelo determinado cobraría por una carga determinada sin ejecutar inferencia. Es la forma más económica de comparar la eficiencia del tokenizador (driver #1) entre los candidatos antes de gastar algo en generación.
- La respuesta de invocación del modelo lleva un bloque
usageconinputTokens,outputTokens,cacheReadInputTokens, ycacheWriteInputTokens. Acumular esos a lo largo de las vueltas de una sola tarea te da los cuatro términos de la fórmula de costo por intento anterior. Un problema: cuando el caché está habilitado,inputTokenscuenta solo los tokens no almacenados en caché, por lo que tu volumen de entrada total esinputTokens + cacheReadInputTokens + cacheWriteInputTokens. Sumarlos para conocer la huella, pero preciarlos por separado, ya que los tres se facturan a diferentes tasas. Evalúa esto múltiples veces a lo largo de tu camino y establece los puntos de control de caché según la carga actual activa. La deriva en los puntos de control de caché ocurre a medida que la aplicación progresa y las herramientas se vuelven obsoletas. Esto significa que escribirás más en la caché dentro de 3 meses cuando haya ocurrido la deriva. Evaluar tus datos constantemente para un uso óptimo de la caché se convierte en un elemento principal para reducir el costo. - La registración de invocación de modelo escribe los recuentos de tokens por invocación en Amazon Simple Storage Service (Amazon S3) o Amazon CloudWatch Logs, para que puedas medir las vueltas hasta la finalización contra el tráfico de producción real en lugar de una muestra. Etiqueta las llamadas con metadatos de solicitud para dividir esos recuentos de tokens registrados por equipo, función o experimento. Sin embargo, estos son campos de registro, no etiquetas de asignación de costos, y nunca aparecen en AWS Cost Explorer o en tu Informe de costos y uso. Los perfiles de inferencia de aplicación sí llegan a ambos, a un grano de un tipo de uso por día. Ese grano es adecuado para el cargo, pero demasiado grueso para el costo por tarea. Multiplicar los recuentos de tokens registrados por las tarifas publicadas te da una estimación en tiempo casi real en lugar de una factura. No reflejará los compromisos, los precios por lote o el rendimiento aprovisionado a menos que los modelices. Reconcilia contra tu Informe de costos y uso antes de tratarlo como la factura.
Reducir el costo por tarea: Cuatro palancas
Cada uno de los cuatro controladores tiene una palanca, y cada uno está documentado en profundidad. Prompt caching reduce el contexto reenviado que hizo que el Modelo A fuera costoso, lo que lo convierte en la mayor ventaja en los caminos agentes. Enrutamiento de prompt inteligente envía las solicitudes fáciles a un modelo más barato en la misma familia. Un esquema de herramienta más un límite de maxTokens mantiene la verbosidad más abajo de manera más confiable que las instrucciones en prosa, y el pensamiento extendido se mantiene apagado hasta que un benchmark muestra que gana su costo. Inferencia por lotes reduce a la mitad la tasa en el trabajo de un solo giro en bulk, aunque descarta la llamada a herramientas y el intercambio de varios giros.
Probar el ROI del agente: describir la línea de base humana
Efficiente no es lo mismo que valioso. Un agente puede estar perfectamente optimizado y aún así no valer la pena ejecutar. La pregunta que decide los presupuestos es: ¿es el agente mejor que los humanos?
Documentar el proceso humano primero
El mayor error en el ROI del agente es intentar probar el valor sin describir primero el flujo de trabajo humano. Antes de construir o escalar un agente, escriba el proceso actual en términos operativos: qué desencadena el trabajo, qué roles humanos están involucrados, dónde se encuentran los puntos de entrega, cómo se define la finalización. Esto suena a burocracia. En realidad, es diseño de medición. Cada decisión de instrumentación downstream (qué cuenta como una ejecución, qué cuenta como éxito, dónde se gasta el tiempo humano) se deriva de esta descripción.
Medir la línea de base antes de que el agente se lance
Con el proceso descrito, mida la línea de base humana sobre una ventana significativa: tiempo de finalización, tiempo de cola, esfuerzo activo, tasa de reapertura, tasa de escalación, costo por tarea y calidad del resultado. Las líneas de base deben medirse antes de que el agente se lance, no reconstruidas desde la memoria después del hecho. Las líneas de base retrospectivas son sistemáticamente halagadoras para el agente: la gente recuerda el caso promedio y olvida los rápidos.
Instrumentar el flujo de trabajo como un experimento
Después de que existe la línea de base, instrumente el flujo de trabajo del agente como un experimento desde el primer día. Cada ejecución obtiene un ID de seguimiento, y cada paso significativo es observable. Un registro de ejecución de flujo de trabajo agrega todo lo anterior a la llamada del modelo en una sola unidad analizable:
Tres campos merecen énfasis:
Bloque de experimentación: Sellado en la creación de ejecución y propagado en Bedrock metadatos de solicitud, para que los registros de nivel de modelo y de flujo de trabajo se unan de manera limpia.
humanMinutes: Lo que la mayoría de los equipos omite y más necesita. Sin ello, “el agente realizó el trabajo” silenciosamente excluye los 35 minutos que un humano dedicó a revisarlo.
revenueEventId: El gancho que hace posible la atribución de ingresos más adelante. No cuesta nada registrar y no se puede reconstruir después.
La regla: Si la telemetría del flujo de trabajo no puede responder a la pregunta comercial, la instrumentación es incompleta.
Unir costos a resultados
Con registros de invocación que aterrizan en Amazon S3 (Parte 1) y registros de ejecución de flujo de trabajo en su tienda de análisis, una unión produce las métricas que importan. Los registros de Amazon Bedrock registran tokens, no dólares, así que primero cree una vista que precio cada invocación desde cuentas de tokens y su hoja de tarifas de modelo, agregada por ID de ejecución. Luego, consulte con Amazon Athena:
Nota: Los nombres de columna y las claves de unión mostrados en la consulta anterior son ilustrativos. Verifique contra su esquema de registro de invocación y tienda de telemetría de flujo de trabajo, que pueden variar según la implementación.
Costo por resultado exitoso, reintentos por éxito y minutos humanos por éxito son los tres números que sobreviven al contacto con un director financiero escéptico. El costo por llamada halaga a los agentes que hacen bucles. El costo por éxito no. Tenga en cuenta la variante de agrupación: la misma consulta, dividida por brazo de experimentación, es la comparación de ROI.
Comparar agentes y humanos correctamente
La evaluación más creíble es una prueba A/B o de retención. Grupos de tratamiento y control controlados comparan el flujo de trabajo asistido por agente con la línea de base humana sin confundir el resultado con cambios de mercado, estacionales u organizacionales.
Para flujos de trabajo orientados al cliente o vinculados a ingresos, randomice al nivel de visitante, lead, cuenta o caso. Para flujos de trabajo internos (operaciones de soporte, asistentes de codificación), use cohortes emparejadas: equipos, grupos de repositorio o pods.
La comparación cubre cuatro dimensiones:
Eficiencia: tiempo de finalización, horas recuperadas, reducción del tiempo de cola.
Calidad: tasa de error, tasa de aprobación, tasa de reapertura, tasa de escalación.
Costo: costo por tarea, costo por resultado exitoso, costo total de servicio.
Valor comercial: aumento de conversión, aumento de retención, tasa de expansión, ingresos por representante o por flujo de trabajo.
Si el agente mejora una dimensión mientras degrada significativamente otra, el resultado es ambiguo y la implementación necesita ajustes.
Ingresos: La métrica más difícil
Los aumentos de eficiencia son la parte más fácil de la historia de ROI para demostrar. El impacto en los ingresos es más difícil, y es la métrica contra la que la dirección asigna fondos. En flujos de trabajo relacionados con los ingresos, mida si el agente mejora la conversión, el tiempo de respuesta, el progreso de los tratos o los ingresos por representante. Las pruebas de retención son la forma más confiable de separar los ingresos incrementales atribuibles al agente del momentum comercial general.
Cuando el aumento de ingresos es real, la conversación cambia. La organización deja de preguntar si la factura de Bedrock aumentó y comienza a preguntar si el gasto adicional está comprando un aumento significativo en la producción comercial.
La tarjeta de puntuación
Basado en lo que hemos observado trabajando con clientes, un modelo de operación sólido no requiere cincuenta métricas. Lo que funciona es una pequeña tarjeta de puntuación vinculada a decisiones, revisada con una cadencia regular para cada agente de producción.
Los siguientes umbrales son puntos de partida, no prescripciones. Calíbrelas contra sus propios datos de flota y contexto organizacional.
| Dimensión | Métrica | Verde | Amarillo | Rojo |
| Adopción | Usuarios activos / usuarios previstos | >70% | 40-70% | <40% |
| Calidad | Tareas completadas sin retrabajo | >90% | 75-90% | <75% |
| Eficiencia | Horas recuperadas por semana | >objetivo | 50-100% del objetivo | <50% del objetivo |
| Costo | Costo por resultado exitoso | ≤presupuesto | 1-1.5x presupuesto | >1.5x presupuesto |
| Impacto comercial | Aumento de KPI en comparación con la línea base | Significativo | Marginal | Ninguno o negativo |
Verde significa escala: el agente supera la línea base mientras cumple con los umbrales de costo y calidad. Amarillo significa ajuste: prometedor pero necesita trabajo. Rojo significa retiro o rediseño: el agente consume costo sin un valor medible suficiente. La voluntad de retirar realmente un agente rojo es lo que hace que el resto de la tarjeta de puntuación sea creíble.
Conclusión
En esta publicación, aprendió cómo calcular el costo real de un modelo considerando cuatro factores de costo ocultos (eficiencia del tokenizador, alineación de salida, eficiencia del bucle agente y sobrecarga de razonamiento), cómo reducir el costo por tarea mediante la caché de prompts, enrutamiento de modelos, restricciones de salida y inferencia por lotes, y cómo demostrar el ROI del agente midiendo las líneas de base humanas, instrumentando flujos de trabajo como experimentos, uniendo el costo a los resultados y realizando comparaciones de retención.
La mitad de optimización de costos responde a “¿por qué es esto costoso y cómo lo arreglo?”. La mitad de ROI responde a “¿es el agente mejor que los humanos?”. Juntas con el modelo operativo de la Parte 1 (atributo, observar, hacer cumplir, optimizar, operar), forman un marco de trabajo completo: puede ver quién lo gastó, explicar por qué, reducir el desperdicio y justificar lo que queda.
Para empezar, evalúe a sus principales candidatos de modelo contra sus propios prompts utilizando evaluación de modelo de Amazon Bedrock, capture tokens y turnos del bloque usage o de sus registros de invocación, prícelos contra la tarifa actual de Bedrock y divida por la tasa de éxito. Para la medición de ROI, consulte la Lente de AI Agente Bien Arquitectada para las mejores prácticas de gobernanza de costos de agente.
Si ha encontrado otras técnicas para reducir el costo por tarea o medir el ROI del agente en Amazon Bedrock, háganoslo saber en los comentarios.