Preparar contenido web para Amazon Bedrock Knowledge Bases con Crawl4AI
Prepare web content for Amazon Bedrock Knowledge Bases with Crawl4AI
Daxeshkumar Patel
Cuando construyes aplicaciones de Generación Aumentada de Recuperación (RAG), la calidad de las respuestas depende de los datos que ingieres. Amazon Bedrock Knowledge Bases es la capacidad de RAG completamente administrada de Amazon Bedrock. Con Amazon Bedrock Managed Knowledge Base, conectas tus fuentes de datos y Amazon Bedrock administra la ingesta, el almacenamiento, el indexado y la recuperación por ti. No provisionas ni escalas un almacén de vectores, y el incrustado y la reordenación utilizan modelos administrados por el servicio de forma predeterminada.
Para el contenido web, comienza con el conector de fuente de datos Amazon Bedrock Web Crawler para bases de conocimiento administradas. Le proporcionas las URL de semilla o los mapas del sitio que estás autorizado a rastrear, y este lo hace dentro del alcance y los límites de velocidad que estableces. Las sincronizaciones programadas mantienen tu base de conocimiento actualizada a medida que cambian las páginas, y el conector puede esperar a que se cargue el contenido con JavaScript. No hay un rastreador que debas construir, alojar o operar, por lo que este conector es el punto de partida para la mayoría del contenido de sitios web públicos.
Algunas fuentes necesitan un control más sobre lo que llega a la base de conocimiento. Es posible que desees indexar solo la región de contenido principal de cada página, eliminar la navegación y otros elementos de plantilla, o adjuntar tus propios atributos de metadatos a cada documento. Para ese tipo de material de origen, puedes ampliar el alcance de tu base de conocimiento con un paso de preparación construido con Crawl4AI, un rastreador de Python de código abierto. El paso escribe Markdown y un archivo de metadatos auxiliar para cada página en Amazon Simple Storage Service (Amazon S3), y la base de conocimiento ingiere ambos a través de su fuente de datos de Amazon S3.
En esta publicación, te mostramos cómo elegir la ruta de ingesta web adecuada e implementar una preparación personalizada para el contenido que necesita un procesamiento adicional. Luego, comienzas la ingesta en una base de conocimiento administrada y validas la calidad de recuperación. El repositorio aws-samples proporciona el flujo de trabajo completo como una implementación de ejemplo.
Esta es una ingesta por lotes de propiedades web conocidas, no un acceso web en tiempo real en el momento de la inferencia, como Web Grounding con Amazon Nova.
Visión general de la solución
Comience con el Amazon Bedrock Web Crawler cuando pueda alcanzar e indexar las páginas que necesita. Respeta robots.txt, y después del primer crawl completo, cada sincronización captura solo el contenido agregado, actualizado y eliminado.
Utilice el camino de preparación de Crawl4AI cuando el material de fuente pública necesita uno o más de los siguientes antes de la ingesta:
Preparación de Markdown estructurado: Utilice DefaultMarkdownGenerator con un filtro de contenido de poda para reducir la navegación y otros elementos de boilerplate mientras se conservan los encabezados, listas y tablas. Debido a que la poda es heurística, revise la salida representativa de sus sitios.
Extracción dirigida y acotada: Extraiga solo la región de la página que coincide con un selector CSS opcional. Restrinja el recorrido de amplitud primero por origen de semilla, ámbito de página/ruta/host, profundidad y límites de página, y patrones de URL.
Metadatos personalizados: Adjunte URLs de origen, marcas de tiempo de crawl, tipo de contenido y sus propios atributos a cada documento, para que pueda filtrar los resultados de recuperación en ellos.
Debido a que las bases de conocimiento administradas y administradas por el cliente admiten fuentes de datos de Amazon S3, el camino de Crawl4AI funciona con cualquiera de los dos tipos. Esta publicación utiliza una base de conocimiento administrada y señala las diferencias donde una base de conocimiento administrada por el cliente difiere.
El resto de esta publicación sigue la muestra companion. Trate su arquitectura y valores predeterminados como un punto de partida, no como requisitos de Amazon Bedrock Knowledge Bases.
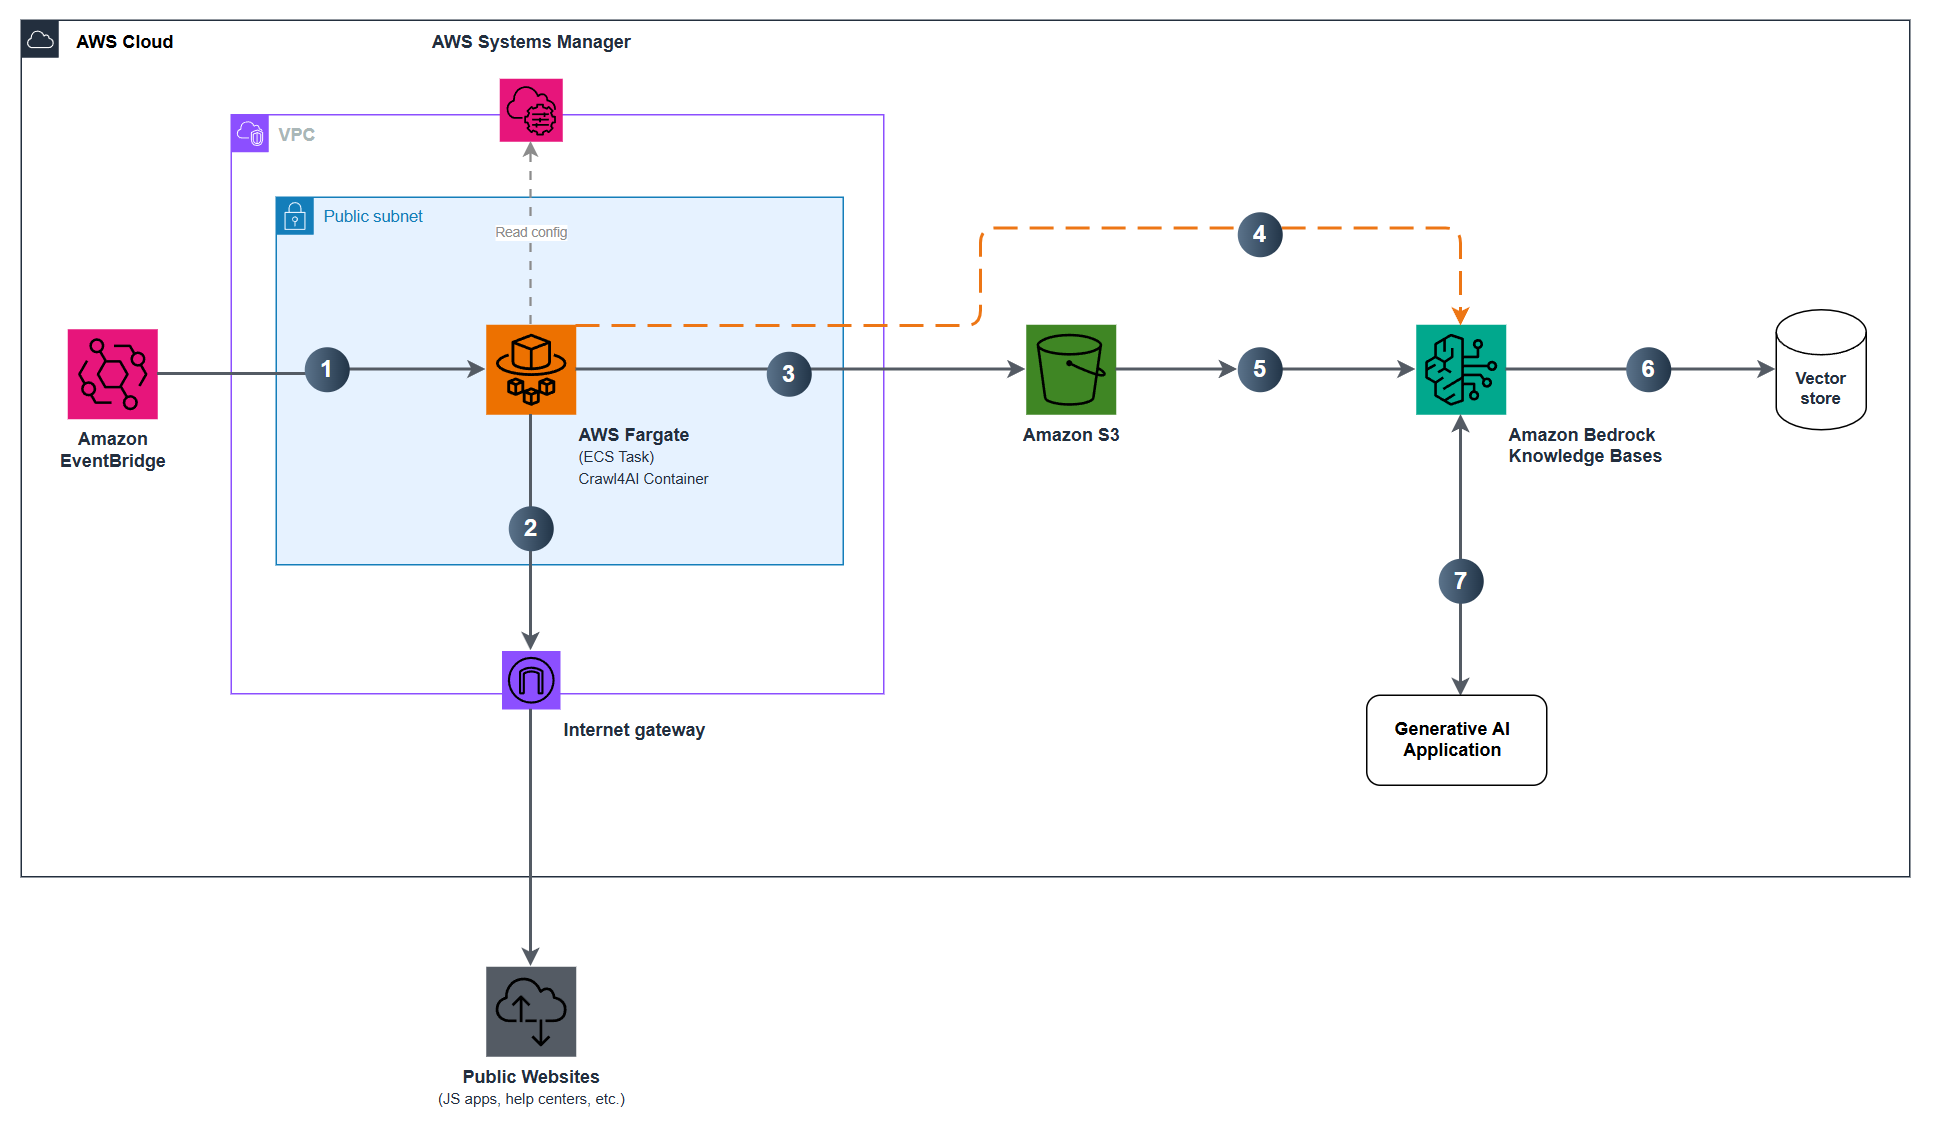
De forma predeterminada, la muestra ejecuta la tarea de AWS Fargate en una subred pública, donde alcanza sus sitios web configurados a través de una puerta de enlace de internet. El rol de Crawl4AI termina una vez que ha preparado los documentos de origen y los metadatos sidecars. A partir de la ingesta, Amazon Bedrock Knowledge Bases maneja el análisis, la división en partes, la incrustación, la indexación y la recuperación. El siguiente diagrama muestra el camino de Crawl4AI desde la programación hasta la recuperación.
Figura 1: El camino de ingesta de Crawl4AI a Amazon S3 para Amazon Bedrock Knowledge Bases
Los pasos numerados en el diagrama se corresponden con el siguiente flujo de trabajo:
Amazon EventBridge inicia la tarea de Amazon Elastic Container Service (Amazon ECS) en AWS Fargate según el horario configurado.
La tarea rastrea los sitios web públicos que configuró y prepara Markdown con un sidecar de metadatos para cada página.
La tarea carga los archivos preparados en el bucket de Amazon S3 que respalda la fuente de datos de la base de conocimientos.
La tarea inicia un trabajo de ingesta de bases de conocimientos de Amazon Bedrock.
Amazon Bedrock Knowledge Bases lee los objetos nuevos y modificados, los analiza y aplica la estrategia de chunking que seleccionó.
Crea incrustaciones y las indexa en el almacén de vectores de la base de conocimientos, que Amazon Bedrock administra para una base de conocimientos administrada.
Su aplicación de inteligencia artificial generativa consulta la base de conocimientos para obtener fragmentos relevantes o para obtener una respuesta generada con citas.
La tarea lee su configuración de canal no secreta desde AWS Systems Manager Parameter Store al inicio.
El flujo de trabajo procesa solo páginas públicas y no implementa sesiones autenticadas. Para sitios que requieren inicio de sesión, evalúe primero las opciones de autenticación del rastreador web de Amazon Bedrock, que incluyen autenticación básica, basada en formularios y SAML. Ampliar la muestra con autenticación requiere control de sesiones, credenciales en AWS Secrets Manager y una revisión de seguridad.
Cómo funciona el flujo de trabajo
La aplicación de AWS Cloud Development Kit (AWS CDK) empaqueta la implementación en una imagen de contenedor durante la implementación. Cuando se dispara el horario, el contenedor ejecuta scripts/container_entrypoint.py y ejecuta el rastreo, la carga y la ingesta en secuencia. Los siguientes tres pasos explican la lógica principal.
Paso 1: Rastrear y extraer contenido
El paso de rastreo realiza un rastreo limitado y escribe un archivo Markdown con un sidecar de metadatos para cada página preparada con éxito. El siguiente extracto es simplificado. El módulo src/crawl4ai_bedrock_kb/crawl.py contiene el ritmo de semilla completo, el filtrado y el alcance de URL, los límites de página y las comprobaciones de redireccionamiento:
async def crawl_and_prepare(config: PipelineConfig, output_dir: str) -> list[str]:
    written, seen = [], set()
    pages_crawled = 0
    browser_config = BrowserConfig(headless=True, java_script_enabled=True)

    async with AsyncWebCrawler(config=browser_config) as crawler:
        for seed in config.seed_urls:
            remaining = config.crawl.max_pages - pages_crawled
            if remaining <= 0:
                break

            strategy = BFSDeepCrawlStrategy(
                max_depth=config.crawl.max_depth,
                max_pages=remaining,
                filter_chain=FilterChain([
                    SeedScopeFilter(seed, config.crawl.scope),
                    # Optional include/exclude URLPatternFilter objects are added here.
                ]),
            )
            run_config = CrawlerRunConfig(
                deep_crawl_strategy=strategy,
                markdown_generator=DefaultMarkdownGenerator(
                    content_filter=PruningContentFilter()
                ),
                css_selector=config.crawl.css_selector,  # Optional page region.
                check_robots_txt=config.crawl.check_robots_txt,
                mean_delay=config.crawl.request_delay_seconds,
                max_range=0,
                semaphore_count=1,
            )

            results = await crawler.arun(url=seed, config=run_config)
            for result in results:
                if pages_crawled >= config.crawl.max_pages:
                    break
                pages_crawled += 1
                requested_url = result.url
                source_url = getattr(result, "redirected_url", None) or requested_url
                if not SeedScopeFilter(seed, config.crawl.scope).apply(source_url):
                    continue  # Recheck the effective destination after redirects.
                canonical = _canonical_url(source_url)
                if canonical in seen:
                    continue
                seen.add(canonical)
                if not result.success or not result.markdown:
                    continue

                md_result = result.markdown
                markdown = (
                    getattr(md_result, "fit_markdown", None)
                    or getattr(md_result, "raw_markdown", None)
                    or (md_result if isinstance(md_result, str) else "")
                )
                if not markdown:
                    continue

                # The complete implementation adds title, crawl timestamps, content
                # type, and configured custom attributes to this metadata.
                written.extend(
                    _write_document(
                        output_dir,
                        _base_name(source_url),
                        markdown,
                        {"source_url": source_url},
                    )
                )
    return written
Amazon Bedrock Knowledge Bases admite varios formatos de documento para fuentes de datos de Amazon S3, incluyendo texto plano, HTML, Markdown, PDF y DOCX. El flujo de trabajo escribe Markdown porque conserva encabezados, listas y tablas sin llevar todo el HTML crudo a la ingesta.
Paso 2: Cargar en Amazon S3
El paso de carga envía cada documento de Markdown preparado y su metadato de sidecar coincidente al bucket de S3 configurado, bajo el flujo de trabajo de s3Prefix. Para page.md, el sidecar debe llamarse page.md.metadata.json, el nombre de archivo de origen completo con .metadata.json agregado. El flujo de trabajo almacena cada sidecar en la misma ubicación de S3 que su documento. Amazon Bedrock limita cada metadato de sidecar a 10 KB. Si un sidecar excedería ese límite, la ejecución se detiene con un error antes de escribir cualquiera de los archivos.
Cada atributo en el sidecar utiliza el formato tipado que aceptan tanto las bases de conocimiento administradas como las administradas por el cliente para las fuentes de datos de Amazon S3. El sidecar abreviado siguiente, formateado para una mejor legibilidad, muestra tres de los atributos que escribe el flujo de trabajo:
La canalización carga solo las rutas producidas por la búsqueda actual, por lo que no se envían archivos locales obsoletos.
Paso 3: Deje que las bases de conocimiento de Amazon Bedrock dividan, incrusten y indexen
Después de que el contenido esté en S3, un trabajo de ingesta entrega cada documento a la canalización de ingesta de la fuente de datos. De forma predeterminada, una base de conocimiento administrada analiza cada archivo con su analizador administrado, que selecciona automáticamente un enfoque de análisis para su contenido. Seleccione la estrategia de división al conectar la fuente de datos. No podrá cambiarla después, así que evalúe las opciones antes de crear una fuente de datos de producción. Una base de conocimiento administrada ofrece las siguientes estrategias de división:
División predeterminada utiliza fragmentos de tamaño fijo de 300 tokens con un 20 por ciento de superposición.
División de tamaño fijo divide el contenido por una cuenta de tokens máxima y un porcentaje de superposición que establezca.
Sin división trata cada archivo como un fragmento único, para contenido que ya ha dividido.
Los límites de los fragmentos y los resultados de recuperación dependen del contenido y la estrategia seleccionada, así que compare las opciones con páginas representativas y preguntas de evaluación. Para cambiar estrategias más tarde, cree una nueva fuente de datos. Para obtener más información, consulte Personalizar la ingesta para una fuente de datos. Una base de conocimiento administrada por el cliente también ofrece división semántica y jerárquica, y opciones de análisis adicionales. Para obtener detalles, consulte Cómo funciona la división de contenido para las bases de conocimiento.
El flujo de trabajo luego inicia un trabajo de ingesta para que la base de conocimiento procese los nuevos documentos. El siguiente extracto simplificado de src/crawl4ai_bedrock_kb/ingest.py muestra la llamada:
def start_ingestion_job(config: PipelineConfig) -> str:
    # Start an Amazon Bedrock knowledge base ingestion job and return its ID.
    client = boto3.client("bedrock-agent", region_name=config.region)
    response = client.start_ingestion_job(
        knowledgeBaseId=config.knowledge_base_id,
        dataSourceId=config.data_source_id,
    )
    return response["ingestionJob"]["ingestionJobId"]
Las mismas llamadas a StartIngestionJob y GetIngestionJob funcionan para ambos tipos de base de conocimiento, y también puedes monitorear el progreso en la consola.
Implementar la solución
En esta sección, implementas el flujo de trabajo en tu cuenta de AWS con AWS CDK. Solo las condiciones previas de la base de conocimiento difieren entre los dos tipos de base de conocimiento. Cuando hayas terminado, sigue los pasos en la sección Limpieza para eliminar los recursos.
Una base de conocimiento administrada por el cliente existente. Para agregar un origen de datos de Amazon S3, consulta Conectar a Amazon S3 para tu base de conocimiento. El flujo de trabajo escribe un archivo de metadatos auxiliar para cada documento, así que confirma que tu tienda de vectores puede almacenar y filtrar esos atributos, como se describe en Metadatos y filtrado. Por ejemplo, un índice de vector de Amazon OpenSearch Serverless debe utilizar el motor faiss. Un índice de vector de Amazon Aurora necesita una columna de metadatos personalizada o una columna para cada atributo de metadatos. Con Amazon S3 Vectors, una capacidad de Amazon S3, puedes adjuntar hasta 1 KB de metadatos personalizados a cada vector, así que mantén los atributos que agregues cortos.
Una fuente de datos de Amazon S3 en esa base de conocimientos cuyo estado es AVAILABLE. Puede ser una nueva fuente de datos o una que ya utilice. Debe utilizar el bucket de S3 que configure para este flujo de trabajo. Si la fuente de datos filtra contenido por prefijo o patrón de archivo, los filtros deben permitir los archivos que el flujo de trabajo escribe bajo su s3Prefix (predeterminado web-content/).
La base de conocimientos, el bucket de S3 y la pila que implementa todo en una región.
Autorización para rastrear los sitios web públicos que configure.
Una estación de trabajo de implementación con Git, Python 3.10 o posterior, Node.js, la interfaz de línea de comandos de AWS (AWS CLI) versión 2, la CLI de AWS CDK v2 y un motor de contenedor compatible con Docker en ejecución. La guía de implementación enumera la versión mínima de la CLI de AWS CDK.
Credenciales de AWS configuradas en la estación de trabajo de implementación con permiso para inicializar el entorno de destino y implementar la pila de CDK.
Un entorno de CDK inicializado en la cuenta y región de destino. Los pasos de implementación incluyen el comando de inicialización.
Solo necesita la estación de trabajo para compilar e implementar. Después de la implementación, el programa ejecuta la tarea en AWS.
Implementar el flujo de trabajo programado
Clonar el repositorio companion e instalar las dependencias de implementación:
Mantener Docker en ejecución. Establecer AWS_DEFAULT_REGION en la región de su base de conocimientos primero, porque cdk deploy utiliza la región de su entorno o perfil de AWS, no la que está en el comando de inicialización. Inicializar la cuenta y región de destino una vez, si es necesario. Luego, implementar la pila con su base de conocimientos, fuente de datos, bucket de S3 y URLs de semilla autorizadas:
Reemplazar cada valor de ejemplo, incluyendo ACCOUNT_ID, REGION y las cuatro claves de contexto requeridas, con los suyos propios. Los valores de ejemplo son sintácticamente válidos, por lo que un comando no editado implementa una pila que apunta a un bucket que no posee. También puede establecer estas claves en cdk.json.
Los valores de maxDepth y maxPages limitan la primera búsqueda a un nivel de enlace y 25 páginas. Aumentarlos después de revisar la salida preparada. Para previsualizar qué páginas prepara una búsqueda, también puede ejecutar la canalización localmente con --dry-run, como se describe en el README. El nombre de la pila es fijo, por lo que otro cdk deploy en la misma cuenta y región actualiza esta pila.
La muestra crea una imagen de contenedor ARM64 de forma predeterminada. Si Docker en su estación de trabajo x86_64 no puede crear imágenes ARM64, agregue -c cpuArchitecture=X86_64 al comando cdk deploy.
Si su cuenta activa VPC Block Public Access, la tarea no puede llegar a Internet desde la subred pública predeterminada. Para comprobar el modo, ejecute aws ec2 describe-vpc-block-public-access-options. En modo de solo ingreso, implemente con -c egressMode=nat, que agrega una puerta de enlace NAT con cargos por hora. El modo bidireccional también necesita una exclusión, como describe la guía de implementación.
La pila no crea ni modifica su base de conocimientos o fuente de datos.
Con el programa rate(24 hours) predeterminado, la primera ejecución comienza cuando la implementación crea la regla de Amazon EventBridge. Para seguir esa ejecución, use el comando en la salida TailLogsCommand, que cdk deploy imprime cuando finaliza. Una ejecución exitosa registra job_status: COMPLETE. Para iniciar otra ejecución fuera del programa, use el comando en la salida RunTaskCommand después de que finalice la ejecución actual. Para enumerar las salidas más adelante, ejecute aws cloudformation describe-stacks --stack-name Crawl4aiBedrockKbCrawler --region REGION --query "Stacks[0].Outputs".
La guía de implementación cubre la configuración restante, incluidos los límites de crawl, el programa, la red, la arquitectura de contenedores, el monitoreo y las ejecuciones bajo demanda.
Validar la calidad de recuperación
Después de la ingesta, pruebe preguntas representativas con Retrieve antes de agregar generación. Una base de conocimientos administrada utiliza búsqueda híbrida. Cuando utiliza el modelo de incrustación administrado predeterminado, también vuelve a clasificar los resultados con su clasificador administrado. Puede reducir los resultados con los metadatos de los sidecars. La configuración predeterminada de la muestra agrega content_category establecido en web a cada página. El siguiente ejemplo devuelve hasta cinco fragmentos de esas páginas que se crawlearon en los últimos siete días. Requiere el SDK de AWS para Python (Boto3) 1.43.32 o posterior, que puede instalar con python -m pip install "boto3>=1.43.32". Reemplace la región y el ID de la base de conocimientos con sus propios valores:
import time

import boto3

client = boto3.client("bedrock-agent-runtime", region_name="us-east-1")
week_ago = int(time.time()) - 7 * 24 * 60 * 60

response = client.retrieve(
    knowledgeBaseId="ABCDEFGHIJ",
    retrievalQuery={"text": "How do I apply for a building permit?"},
    retrievalConfiguration={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
            "filter": {
                "andAll": [
                    {"equals": {"key": "content_category", "value": "web"}},
                    {"greaterThan": {"key": "crawled_at_epoch", "value": week_ago}},
                ]
            },
        }
    },
)

for result in response["retrievalResults"]:
    print(result.get("metadata", {}).get("source_url"), result["content"]["text"][:200])
El ejemplo pasa un timestamp entero, que ambos tipos de base de conocimientos aceptan en filtros numéricos. Una base de conocimientos administrada no admite los filtros startsWith y stringContains. Para una base de conocimientos administrada por el cliente, pase el mismo filtro en vectorSearchConfiguration en lugar de managedSearchConfiguration. Los operadores que admite dependen de su tienda de vectores.
El filtrado de metadatos puede mejorar la precisión de recuperación, pero no es un límite de autorización. Si diferentes usuarios deben ver diferentes páginas, el conector de Amazon S3 para bases de conocimiento administradas admite control de acceso a nivel de documento con archivos de lista de control de acceso (ACL) que usted proporciona. La muestra no crea archivos ACL.
Para generar respuestas desde una base de conocimiento administrada, use recuperación agente. La operación AgenticRetrieveStream devuelve los resultados recuperados y una respuesta generada con citas a esos resultados. Para una base de conocimiento administrada por el cliente, use RetrieveAndGenerate. En ambos casos, cada resultado citado incluye los metadatos source_url de su sidecar, que su aplicación puede presentar como la fuente que enfrenta al usuario.
Evalúe la relevancia de recuperación, la cobertura de la página de origen y la calidad de la cita cada vez que cambie la preparación de contenido, la división en partes o la configuración de recuperación. Para los ajustes de recuperación que puede personalizar, consulte Configurar y personalizar consultas para bases de conocimiento administradas.
Ejecutarlo repetidamente
Cada evento programado lanza una tarea independiente de Fargate. La pila no evita ejecuciones superpuestas, así que elija un intervalo más largo que la duración de crawl y ingestion esperada. Una ejecución fallida no se anuncia, porque la muestra no agrega una política de reintento, cola de carta muerta o alarma. Un trabajo de ingestion también puede informar COMPLETE cuando algunos documentos no se ingieren, y la tarea sale con código 0. La tarea registra las razones de falla del trabajo. Agregue el monitoreo que necesite, incluida una alarma sobre esas razones de falla, antes de confiar en el programa.
Cada ejecución incurre en cargos de Fargate por el tamaño de tarea configurado, que predeterminadamente es de 2 vCPU y 4 GB. La tarea sigue ejecutándose mientras sondea el trabajo de ingesta durante un máximo de 30 minutos, por lo que un trabajo de ingesta lento extiende el tiempo de tarea facturable. Si la ingesta tarda más, la tarea sale con un código distinto de cero y el trabajo de ingesta sigue ejecutándose. La pila activa Container Insights para el cluster, y registros de flujo para una Amazon Virtual Private Cloud (Amazon VPC) que crea. Ambos agregan cargos de Amazon CloudWatch. La clave AWS KMS de la pila tiene un cargo mensual, y la dirección IPv4 pública de la tarea es facturada mientras la tarea se ejecuta. Con egressMode=nat o privateEndpoints=true, la puerta de enlace NAT y los puntos de conexión de interfaz son facturados por hora, incluso cuando no se ejecuta ninguna tarea. El uso de la base de conocimientos es facturado por separado. Para obtener más detalles, consulte precios de Amazon VPC y precios de Amazon Bedrock.
Las cargas son aditivas: eliminar una URL o perder una página durante una crawl posterior no elimina sus objetos S3 existentes. Para eliminar contenido obsoleto, elimine el documento obsoleto y el sidecar coincidente bajo el prefijo configurado, y luego vuelva a iniciar la ingesta. Si activa la salvaguarda de eliminación de documentos (protección contra eliminación) para una fuente de datos de base de conocimientos administrada, verifique su umbral. Una sincronización que eliminaría más del porcentaje de documentos especificado omite su fase de eliminación, por lo que esos documentos siguen indexados. Para iniciar la ingesta automáticamente cada vez que cambian objetos en el bucket, consulte Construya y despliegue una solución de sincronización automática para bases de conocimientos de Amazon Bedrock.
Consideraciones de IA responsable
Los pasajes recuperados se convierten en el contexto que un modelo base utiliza para generar una respuesta. Aplique los siguientes controles antes de ejecutar este flujo de trabajo en producción:
Amazon Bedrock Guardrails: Adjunte un guardrail a su recuperación agente o solicitudes de RetrieveAndGenerate para aplicar filtros de contenido, temas denegados, filtros de palabras y filtros de información sensible. La recuperación agente solo admite la acción de guardrail BLOCK, no MASK.
Verificaciones de anclaje contextual: Active la verificación de anclaje contextual de Guardrails contextual grounding check para puntuar cada respuesta por su anclaje con respecto a los pasajes recuperados y por su relevancia para la consulta. El guardrail bloquea las respuestas que obtienen una puntuación inferior a los umbrales que establezca. Para la recuperación agente, puede ejecutar la verificación en la respuesta generada con la API ApplyGuardrail. La verificación admite casos de uso de respuesta a preguntas y resumen, pero no casos de uso de chatbot conversacional.
Trate el contenido rastreado como entrada no confiable: Las páginas web preparadas se convierten en contexto del modelo, por lo que el texto de una página pública puede intentar inyectar una solicitud a través de la recuperación. No confíe solo en los guardrails para detectarlo. Restrinja las URL de semilla a sitios que confíe y aplique los patrones de filtrado de ingesta descritos en la siguiente sección antes de que el contenido llegue a la base de conocimientos.
Citas y revisión humana: Devuelva citas con cada respuesta generada para que los usuarios puedan verificar las afirmaciones con respecto a la página de origen. Para casos de uso de mayor riesgo, mantenga a un revisor humano en el ciclo.
Consideraciones de seguridad y cumplimiento
Revise las siguientes consideraciones antes de ejecutar este flujo de trabajo con contenido de producción:
Utilice objetivos de rastreo público confiables: Las URL de semilla y la configuración de rastreo son configuración de implementación, y la tarea de Fargate permite el acceso saliente para que pueda llegar a sitios web públicos. En el modo de red predeterminado de la muestra, la tarea se ejecuta en una subred pública con una IP pública. Configure solo sitios públicos autorizados. No utilice esta muestra para rastrear puntos de conexión privados o internos. Revise los controles de salida y destino de red antes de adaptar el flujo de trabajo para otros modelos de confianza.
Respete las directivas de rastreo: El flujo de trabajo activa la verificación robots.txt de Crawl4AI de forma predeterminada, y la ruta de CDK la fija con una clave de contexto para deshabilitarla. Verifique que tenga autorización para rastrear los sitios de destino, de acuerdo con la Política de uso aceptable de AWS.
Límite de velocidad: Configure retrasos entre solicitudes para evitar abrumar los sitios web de origen.
Cifrado en reposo: La pila crea una clave administrada por el cliente de AWS Key Management Service (AWS KMS) con rotación de clave automática y cifra sus grupos de registros de CloudWatch con ella. Amazon S3 cifra los nuevos objetos con cifrado del lado del servidor con claves administradas por Amazon S3 (SSE-S3) de forma predeterminada. Si la clasificación de sus datos requiere una clave administrada por el cliente para el bucket, configure el bucket para que la utilice. Luego, conceda al cargador y al rol de servicio de la base de conocimientos los permisos de AWS KMS necesarios en AWS Identity and Access Management (IAM) y en la política de claves. El rol de tarea de la pila no incluye permisos de AWS KMS. Una base de conocimientos administrada cifra sus datos con una clave propiedad de AWS de forma predeterminada, o con una clave administrada por el cliente que especifique al crearla. Para una base de conocimientos administrada por el cliente, revise el cifrado de su tienda de vectores.
Privilegios mínimos de IAM: La pila de CDK concede al rol de tarea de Fargate s3:PutObject en el prefijo de bucket configurado. También concede bedrock:StartIngestionJob y bedrock:GetIngestionJob en la base de conocimientos objetivo, más ssm:GetParameter para su único parámetro de configuración. Roles separados cubren el lanzamiento de tareas de Amazon EventBridge y la extracción estándar de imágenes de contenedores y entrega de registros. La canalización no lee ni enumera S3 y no llama a InvokeModel o Retrieve.
Comprobaciones de contenedor y plantilla: El contenedor se ejecuta como un usuario no root, y la aplicación de CDK ejecuta comprobaciones de soluciones de AWS cdk-nag en cada síntesis con supresiones de recursos.
Proteger la configuración de implementación: La aplicación de CDK almacena la configuración de la canalización no secreta en un parámetro de tienda de parámetros String en texto plano. Solo el nombre del parámetro se coloca en la definición de tarea. No coloque contraseñas, cookies, tokens u otros secretos en el contexto de CDK o en este parámetro.
Para evitar cargos continuos, elimine los recursos creados durante este recorrido:
Desde el directorio deploy/ del repositorio, ejecute cdk destroy en la misma región, con los mismos cuatro valores requeridos -c que pasó a cdk deploy. La aplicación verifica estos valores en cada comando. Esto elimina la regla de Amazon EventBridge de la pila, el clúster de ECS, la definición de tarea, los grupos de registros, los roles de IAM, el parámetro de Parameter Store y los grupos de seguridad, y la VPC si la pila la creó. También programa la clave de AWS KMS de la pila para su eliminación después de un período de espera de 30 días. No elimina una VPC importada, su base de conocimientos, su bucket de S3 o los objetos que la workflow subió. CDK también mantiene la imagen del contenedor y las plantillas en sus recursos de inicialización. También deja el grupo de registros de Container Insights del clúster, cuyo nombre comienza con /aws/ecs/containerinsights/Crawl4aiBedrockKbCrawler-.
Para eliminar el contenido web ingerido, elimine los objetos preparados bajo s3://<bucket>/<prefix> y sincronice la fuente de datos nuevamente. Si la salvaguarda de eliminación de documentos está activada para una fuente de datos de base de conocimientos administrada, una sincronización que eliminaría más del porcentaje umbral de documentos omite su fase de eliminación.
Elimine la base de conocimientos administrada solo si la creó exclusivamente para este recorrido. Una base de conocimientos administrada no tiene una tienda de vectores separada para eliminar.
Para una base de conocimientos administrada por el cliente, elimine la fuente de datos de Amazon S3 solo si la creó para este recorrido. Su política de eliminación de datos determina si Amazon Bedrock también elimina las incrustaciones de vectores de la fuente de datos de su tienda de vectores.
Conclusión
En esta publicación, aprendió cómo extender las bases de conocimientos de Amazon Bedrock a contenido web público autorizado que necesita preparación antes de la ingesta. Una tarea programada de Fargate utiliza Crawl4AI para crawling limitado, prepara Markdown con page.md.metadata.json de sidecars, los sube a una fuente de datos de Amazon S3 y comienza la ingesta. La base de conocimientos luego maneja el análisis, la división en fragmentos, las incrustaciones, el índice, la recuperación y las respuestas fundamentadas con citas.
Comience con el Amazon Bedrock Web Crawler en una base de conocimientos administrada para la mayoría de los sitios web públicos. Utilice el camino de Crawl4AI cuando necesite control sobre qué parte de cada página se indexa o qué metadatos viaja con ella. Para empezar, implemente el flujo de trabajo programado de Fargate desde el repositorio de sample-crawl4ai-bedrock-knowledge-base de acompañamiento, y luego valide la calidad de recuperación y las citas con contenido representativo antes de escalar.
Aprenda más
Para obtener más información sobre los servicios y patrones en esta publicación, consulte los siguientes recursos:
When you build Retrieval Augmented Generation (RAG) applications, answer quality depends on the data that you ingest. Amazon Bedrock Knowledge Bases is the fully managed RAG capability of Amazon Bedrock. With Amazon Bedrock Managed Knowledge Base, you connect your data sources, and Amazon Bedrock manages ingestion, storage, indexing, and retrieval for you. You don’t provision or scale a vector store, and embedding and reranking use service-managed models by default.
For web content, start with the Amazon Bedrock Web Crawler data source connector for managed knowledge bases. You give it the seed URLs or sitemaps that you’re authorized to crawl, and it crawls within the scope and rate limits that you set. Scheduled syncs keep your knowledge base current as pages change, and the connector can wait for content that loads with JavaScript. There’s no crawler for you to build, host, or operate, so this connector is the starting point for most public website content.
Some sources need more control over what reaches the knowledge base. You might want to index only the main content region of each page, remove navigation and other boilerplate, or attach your own metadata attributes to every document. For that class of source material, you can extend the reach of your knowledge base with a preparation step built with Crawl4AI, an open source Python crawler. The step writes Markdown and a metadata sidecar for each page to Amazon Simple Storage Service (Amazon S3), and the knowledge base ingests both through its Amazon S3 data source.
In this post, we show you how to choose the appropriate web ingestion path and implement custom preparation for content that needs additional processing. You then start ingestion into a managed knowledge base and validate retrieval quality. The companion aws-samples repository provides the complete workflow as a sample implementation.
This is batch ingestion of known web properties, not real-time web access at inference time such as Web Grounding with Amazon Nova.
Solution overview
Start with the Amazon Bedrock Web Crawler when it can reach and index the pages you need. It respects robots.txt, and after the first full crawl, each sync captures only added, updated, and deleted content.
Use the Crawl4AI preparation path when public source material needs one or more of the following before ingestion:
Structured Markdown preparation: Use DefaultMarkdownGenerator with a pruning content filter to reduce navigation and other boilerplate while preserving headings, lists, and tables. Because pruning is heuristic, review representative output from your sites.
Bounded, targeted extraction: Extract only the page region that an optional CSS selector matches. Constrain breadth-first traversal by seed origin, page/path/host scope, depth and page caps, and URL patterns.
Custom metadata: Attach source URLs, crawl timestamps, content type, and your own attributes to each document, so that you can filter retrieval results on them.
Because managed and customer-managed knowledge bases both support Amazon S3 data sources, the Crawl4AI path works with either type. This post uses a managed knowledge base and notes where a customer-managed knowledge base differs.
The rest of this post follows the companion sample. Treat its architecture and defaults as a starting point, not as requirements of Amazon Bedrock Knowledge Bases.
By default, the sample runs the AWS Fargate task in a public subnet, where it reaches your configured websites through an internet gateway. Crawl4AI’s role ends once it has prepared the source documents and metadata sidecars. From ingestion onward, Amazon Bedrock Knowledge Bases handles parsing, chunking, embedding, indexing, and retrieval. The following diagram shows the Crawl4AI path from the schedule through to retrieval.
Figure 1: The Crawl4AI-to-Amazon S3 ingestion path for Amazon Bedrock Knowledge Bases
The numbered steps in the diagram map to the following workflow:
Amazon EventBridge starts the Amazon Elastic Container Service (Amazon ECS) task on AWS Fargate on the configured schedule.
The task crawls the public websites you configured and prepares Markdown with a metadata sidecar for each page.
The task uploads the prepared files to the Amazon S3 bucket that backs the knowledge base data source.
The task starts an Amazon Bedrock Knowledge Bases ingestion job.
Amazon Bedrock Knowledge Bases reads the new and changed objects, parses them, and applies the chunking strategy you selected.
It creates embeddings and indexes them in the knowledge base’s vector store, which Amazon Bedrock manages for a managed knowledge base.
Your generative AI application queries the knowledge base for relevant chunks or for a generated response with citations.
The task reads its non-secret pipeline configuration from AWS Systems Manager Parameter Store at startup.
The workflow processes public pages only and doesn’t implement authenticated sessions. For sites that require sign-in, evaluate the Amazon Bedrock Web Crawler authentication options first, which include basic, form-based, and SAML authentication. Extending the sample with authentication requires session handling, credentials in AWS Secrets Manager, and a security review.
How the workflow works
The AWS Cloud Development Kit (AWS CDK) app packages the implementation in a container image during deployment. When the schedule fires, the container runs scripts/container_entrypoint.py and executes crawl, upload, and ingestion in sequence. The following three steps explain the core logic.
Step 1: Crawl and extract content
The crawl step performs bounded crawling and writes a Markdown file with a metadata sidecar for each successfully prepared page. The following excerpt is simplified. The module src/crawl4ai_bedrock_kb/crawl.py contains the complete seed pacing, URL filtering and scoping, page limits, and redirect checks:
async def crawl_and_prepare(config: PipelineConfig, output_dir: str) -> list[str]:
    written, seen = [], set()
    pages_crawled = 0
    browser_config = BrowserConfig(headless=True, java_script_enabled=True)

    async with AsyncWebCrawler(config=browser_config) as crawler:
        for seed in config.seed_urls:
            remaining = config.crawl.max_pages - pages_crawled
            if remaining <= 0:
                break

            strategy = BFSDeepCrawlStrategy(
                max_depth=config.crawl.max_depth,
                max_pages=remaining,
                filter_chain=FilterChain([
                    SeedScopeFilter(seed, config.crawl.scope),
                    # Optional include/exclude URLPatternFilter objects are added here.
                ]),
            )
            run_config = CrawlerRunConfig(
                deep_crawl_strategy=strategy,
                markdown_generator=DefaultMarkdownGenerator(
                    content_filter=PruningContentFilter()
                ),
                css_selector=config.crawl.css_selector,  # Optional page region.
                check_robots_txt=config.crawl.check_robots_txt,
                mean_delay=config.crawl.request_delay_seconds,
                max_range=0,
                semaphore_count=1,
            )

            results = await crawler.arun(url=seed, config=run_config)
            for result in results:
                if pages_crawled >= config.crawl.max_pages:
                    break
                pages_crawled += 1
                requested_url = result.url
                source_url = getattr(result, "redirected_url", None) or requested_url
                if not SeedScopeFilter(seed, config.crawl.scope).apply(source_url):
                    continue  # Recheck the effective destination after redirects.
                canonical = _canonical_url(source_url)
                if canonical in seen:
                    continue
                seen.add(canonical)
                if not result.success or not result.markdown:
                    continue

                md_result = result.markdown
                markdown = (
                    getattr(md_result, "fit_markdown", None)
                    or getattr(md_result, "raw_markdown", None)
                    or (md_result if isinstance(md_result, str) else "")
                )
                if not markdown:
                    continue

                # The complete implementation adds title, crawl timestamps, content
                # type, and configured custom attributes to this metadata.
                written.extend(
                    _write_document(
                        output_dir,
                        _base_name(source_url),
                        markdown,
                        {"source_url": source_url},
                    )
                )
    return written
Amazon Bedrock Knowledge Bases supports several document formats for Amazon S3 data sources, including plain text, HTML, Markdown, PDF, and DOCX. The workflow writes Markdown because it preserves headings, lists, and tables without carrying all raw HTML into ingestion.
Step 2: Upload to Amazon S3
The upload step sends each prepared Markdown document and its matching metadata sidecar to the configured S3 bucket, under the workflow’s s3Prefix. For page.md, the sidecar must be named page.md.metadata.json, the complete source filename with .metadata.json appended. The workflow stores each sidecar in the same S3 location as its document. Amazon Bedrock limits each metadata sidecar to 10 KB. If a sidecar would exceed that limit, the run stops with an error before it writes either file.
Each attribute in the sidecar uses the typed format that both managed and customer-managed knowledge bases accept for Amazon S3 data sources. The following abbreviated sidecar, formatted for readability, shows three of the attributes that the workflow writes:
The pipeline uploads only the paths produced by the current crawl, so stale local files are not sent.
Step 3: Let Amazon Bedrock Knowledge Bases chunk, embed, and index
After content is in S3, an ingestion job hands each document to the data source’s ingestion pipeline. By default, a managed knowledge base parses each file with its managed parser, which automatically selects a parsing approach for your content. You select the chunking strategy when you connect the data source. You can’t change it afterward, so evaluate the options before you create a production data source. A managed knowledge base offers the following chunking strategies:
Default chunking uses fixed-size chunks of 300 tokens with 20 percent overlap.
Fixed-size chunking splits content by a maximum token count and an overlap percentage that you set.
No chunking treats each file as a single chunk, for content that you have already split.
Chunk boundaries and retrieval results depend on the content and the selected strategy, so compare the options with representative pages and evaluation questions. To change strategies later, create a new data source. For more information, see Customize ingestion for a data source. A customer-managed knowledge base also offers semantic and hierarchical chunking and additional parsing options. For details, see How content chunking works for knowledge bases.
The workflow then starts an ingestion job so the knowledge base processes the new documents. The following simplified excerpt from src/crawl4ai_bedrock_kb/ingest.py shows the call:
def start_ingestion_job(config: PipelineConfig) -> str:
    # Start an Amazon Bedrock knowledge base ingestion job and return its ID.
    client = boto3.client("bedrock-agent", region_name=config.region)
    response = client.start_ingestion_job(
        knowledgeBaseId=config.knowledge_base_id,
        dataSourceId=config.data_source_id,
    )
    return response["ingestionJob"]["ingestionJobId"]
The same StartIngestionJob and GetIngestionJob calls work for both knowledge base types, and you can also monitor progress on the console.
Deploy the solution
In this section, you deploy the workflow into your AWS account with AWS CDK. Only the knowledge base prerequisites differ between the two knowledge base types. When you’re finished, follow the steps in the Clean up section to remove the resources.
An existing customer-managed knowledge base. To add an Amazon S3 data source, see Connect to Amazon S3 for your knowledge base. The workflow writes a metadata sidecar for every document, so confirm that your vector store can store and filter those attributes, as described in Metadata and filtering. For example, an Amazon OpenSearch Serverless vector index must use the faiss engine. An Amazon Aurora vector index needs a custom metadata column or a column for each metadata attribute. With Amazon S3 Vectors, a capability of Amazon S3, you can attach up to 1 KB of custom metadata to each vector, so keep attributes that you add short.
An Amazon S3 data source in that knowledge base whose status is AVAILABLE. It can be a new data source or one you already use. It must use the S3 bucket that you configure for this workflow. If the data source filters content by prefix or file pattern, the filters must allow the files that the workflow writes under its s3Prefix (default web-content/).
The knowledge base, the S3 bucket, and the stack you deploy all in one Region.
Authorization to crawl the public websites you configure.
A deployment workstation with Git, Python 3.10 or later, Node.js, the AWS Command Line Interface (AWS CLI) version 2, the AWS CDK CLI v2, and a running Docker-compatible container engine. The deployment guide lists the minimum AWS CDK CLI version.
AWS credentials configured on the deployment workstation with permission to bootstrap the target environment and deploy the CDK stack.
A bootstrapped CDK environment in the target account and Region. The deployment steps include the bootstrap command.
You need the workstation only to build and deploy. After deployment, the schedule runs the task in AWS.
Deploy the scheduled workflow
Clone the companion repository and install the deployment dependencies:
Keep Docker running. Set AWS_DEFAULT_REGION to your knowledge base’s Region first, because cdk deploy uses the Region from your environment or AWS profile, not the one in the bootstrap command. Bootstrap the target account and Region once, if needed. Then deploy the stack with your knowledge base, data source, S3 bucket, and authorized seed URLs:
Replace every example value, including ACCOUNT_ID, REGION, and the four required context keys, with your own. The example values are syntactically valid, so an unedited command deploys a stack that points at a bucket you don’t own. You can also set these keys in cdk.json.
The maxDepth and maxPages values limit the first crawl to one link level and 25 pages. Raise them after you review the prepared output. To preview which pages a crawl prepares, you can also run the pipeline locally with --dry-run, as described in the README. The stack name is fixed, so another cdk deploy in the same account and Region updates this stack.
The sample builds an ARM64 container image by default. If Docker on your x86_64 workstation can’t build ARM64 images, add -c cpuArchitecture=X86_64 to the cdk deploy command.
If your account turns on VPC Block Public Access, the task can’t reach the internet from the default public subnet. To check the mode, run aws ec2 describe-vpc-block-public-access-options. In ingress-only mode, deploy with -c egressMode=nat, which adds a NAT gateway with hourly charges. Bidirectional mode also needs an exclusion, as the deployment guide describes.
The stack doesn’t create or change your knowledge base or data source.
With the default rate(24 hours) schedule, the first run starts when the deployment creates the Amazon EventBridge rule. To follow that run, use the command in the TailLogsCommand output, which cdk deploy prints when it finishes. A successful run logs job_status: COMPLETE. To start another run outside the schedule, use the command in the RunTaskCommand output after the current run finishes. To list the outputs later, run aws cloudformation describe-stacks --stack-name Crawl4aiBedrockKbCrawler --region REGION --query "Stacks[0].Outputs".
The deployment guide covers the remaining configuration, including crawl boundaries, the schedule, networking, container architecture, monitoring, and on-demand runs.
Validate retrieval quality
After ingestion, test representative questions with Retrieve before you add generation. A managed knowledge base uses hybrid search. When it uses the default managed embedding model, it also reranks results with its managed reranker. You can narrow results with the metadata from the sidecars. The sample’s default configuration adds content_category set to web to every page. The following example returns up to five chunks from those pages that were crawled in the last seven days. It requires the AWS SDK for Python (Boto3) 1.43.32 or later, which you can install with python -m pip install "boto3>=1.43.32". Replace the Region and knowledge base ID with your own values:
import time

import boto3

client = boto3.client("bedrock-agent-runtime", region_name="us-east-1")
week_ago = int(time.time()) - 7 * 24 * 60 * 60

response = client.retrieve(
    knowledgeBaseId="ABCDEFGHIJ",
    retrievalQuery={"text": "How do I apply for a building permit?"},
    retrievalConfiguration={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
            "filter": {
                "andAll": [
                    {"equals": {"key": "content_category", "value": "web"}},
                    {"greaterThan": {"key": "crawled_at_epoch", "value": week_ago}},
                ]
            },
        }
    },
)

for result in response["retrievalResults"]:
    print(result.get("metadata", {}).get("source_url"), result["content"]["text"][:200])
The example passes an integer timestamp, which both knowledge base types accept in number filters. A managed knowledge base doesn’t support the startsWith and stringContains filters. For a customer-managed knowledge base, pass the same filter in vectorSearchConfiguration instead of managedSearchConfiguration. The operators it supports depend on its vector store.
Metadata filtering can improve retrieval precision, but it is not an authorization boundary. If different users should see different pages, the Amazon S3 connector for managed knowledge bases supports document-level access control with access control list (ACL) files that you provide. The sample doesn’t create ACL files.
To generate responses from a managed knowledge base, use agentic retrieval. The AgenticRetrieveStream operation returns the retrieved results and a generated response with citations to those results. For a customer-managed knowledge base, use RetrieveAndGenerate. In both cases, each cited result includes the source_url metadata from its sidecar, which your application can present as the user-facing source.
Evaluate retrieval relevance, source-page coverage, and citation quality whenever you change content preparation, chunking, or retrieval settings. For the retrieval settings that you can tune, see Configure and customize queries for managed knowledge bases.
Running it repeatedly
Each scheduled event launches one standalone Fargate task. The stack doesn’t prevent overlapping runs, so choose an interval longer than the expected crawl and ingestion duration. A failed run isn’t announced, because the sample adds no retry policy, dead-letter queue, or alarm. An ingestion job can also report COMPLETE when some documents fail to ingest, and the task then exits with code 0. The task logs the job’s failure reasons. Add the monitoring you need, including an alarm on those failure reasons, before you rely on the schedule.
Each run incurs Fargate charges for the configured task size, which defaults to 2 vCPU and 4 GB. The task keeps running while it polls the ingestion job for up to 30 minutes, so a slow ingestion job extends billable task time. If ingestion takes longer, the task exits with a nonzero code, and the ingestion job keeps running. The stack turns on Container Insights for the cluster, and flow logs for an Amazon Virtual Private Cloud (Amazon VPC) that it creates. Both add Amazon CloudWatch charges. The stack’s AWS KMS key has a monthly charge, and the task’s public IPv4 address is billed while the task runs. With egressMode=nat or privateEndpoints=true, the NAT gateway and interface endpoints are billed hourly, even when no task is running. Knowledge base usage is billed separately. For details, see Amazon VPC pricing and Amazon Bedrock pricing.
Uploads are additive: removing a URL or missing a page during a later crawl doesn’t delete its existing S3 objects. To remove stale content, delete the obsolete document and matching sidecar under the configured prefix, then start ingestion again. If you turn on the document deletion safeguard (deletion protection) for a managed knowledge base data source, check its threshold. A sync that would delete more than that percentage of documents skips its delete phase, so those documents stay indexed. To start ingestion automatically whenever objects in the bucket change, see Build and deploy an automatic sync solution for Amazon Bedrock Knowledge Bases.
Responsible AI considerations
Retrieved passages become the context that a foundation model uses to generate a response. Apply the following controls before you run this workflow in production:
Amazon Bedrock Guardrails: Attach a guardrail to your agentic retrieval or RetrieveAndGenerate requests to apply content filters, denied topics, word filters, and sensitive information filters. Agentic retrieval supports only the guardrail BLOCK action, not MASK.
Contextual grounding checks: Turn on the Guardrails contextual grounding check to score each response for grounding against the retrieved passages and for relevance to the query. The guardrail blocks responses that score below the thresholds you set. For agentic retrieval, you can run the check on the generated answer with the ApplyGuardrail API. The check supports question answering and summarization, not conversational chatbot use cases.
Treat crawled content as untrusted input: Prepared web pages become model context, so text on a public page can attempt prompt injection through retrieval. Don’t rely on guardrails alone to catch it. Restrict seed URLs to sites you trust, and apply the ingestion filtering patterns described in the next section before content reaches the knowledge base.
Citations and human review: Return citations with every generated response so users can verify claims against the source page. For higher-risk use cases, keep a human reviewer in the loop.
Security and compliance considerations
Review the following considerations before you run this workflow against production content:
Use trusted public crawl targets: Seed URLs and crawl settings are deployment configuration, and the Fargate task allows outbound access so it can reach public websites. In the sample’s default networking mode, the task runs in a public subnet with a public IP. Configure only authorized public sites. Don’t use this sample to crawl private or internal endpoints. Review network egress and destination controls before adapting the workflow for other trust models.
Respect crawl directives: The workflow turns on Crawl4AI’s robots.txt check by default, and the CDK path pins it on with no context key to disable it. Verify you have authorization to crawl the target sites, consistent with the AWS Acceptable Use Policy.
Rate limiting: Configure delays between requests to avoid overwhelming source websites.
Encryption at rest: The stack creates an AWS Key Management Service (AWS KMS) customer managed key with automatic key rotation and encrypts its CloudWatch log groups with it. Amazon S3 encrypts new objects with server-side encryption with Amazon S3 managed keys (SSE-S3) by default. If your data classification requires a customer managed key for the bucket, configure the bucket to use it. Then grant the uploader and the knowledge base service role the required AWS KMS permissions in both AWS Identity and Access Management (IAM) and the key policy. The stack’s task role doesn’t include AWS KMS permissions. A managed knowledge base encrypts its data with an AWS owned key by default, or with a customer managed key that you specify when you create it. For a customer-managed knowledge base, review encryption for its vector store.
Least privilege IAM: The CDK stack grants the Fargate task role s3:PutObject on the configured bucket prefix. It also grants bedrock:StartIngestionJob and bedrock:GetIngestionJob on the target knowledge base, plus ssm:GetParameter for its single configuration parameter. Separate roles cover Amazon EventBridge task launch and the standard container image pull and log delivery. The pipeline doesn’t read or list S3 and doesn’t call InvokeModel or Retrieve.
Container and template checks: The container runs as a non-root user, and the CDK app runs cdk-nag AWS Solutions checks on every synthesis with resource-scoped suppressions.
Protect deployment configuration: The CDK app stores non-secret pipeline settings in a plaintext Parameter Store String parameter. Only the parameter name is placed in the task definition. Don’t put passwords, cookies, tokens, or other secrets in CDK context or this parameter.
To avoid ongoing charges, delete the resources created during this walkthrough:
From the repository’s deploy/ directory, run cdk destroy in the same Region, with the same four required -c values that you passed to cdk deploy. The app checks them on every command. This removes the stack’s Amazon EventBridge rule, ECS cluster, task definition, log groups, IAM roles, Parameter Store parameter, and security groups, and the VPC if the stack created it. It also schedules the stack’s AWS KMS key for deletion after a 30-day waiting period. It doesn’t delete an imported VPC, your knowledge base, your S3 bucket, or the objects that the workflow uploaded. CDK also keeps the container image and templates in its bootstrap resources. It also leaves the cluster’s Container Insights log group, whose name starts with /aws/ecs/containerinsights/Crawl4aiBedrockKbCrawler-.
To remove the ingested web content, delete the prepared objects under s3://<bucket>/<prefix> and sync the data source again. If the document deletion safeguard is on for a managed knowledge base data source, a sync that would delete more than its threshold percentage of documents skips its delete phase.
Delete the managed knowledge base only if you created it solely for this walkthrough. A managed knowledge base has no separate vector store to delete.
For a customer-managed knowledge base, delete the Amazon S3 data source only if you created it for this walkthrough. Its data deletion policy determines whether Amazon Bedrock also deletes the data source’s vector embeddings from your vector store.
Conclusion
In this post, you learned how to extend Amazon Bedrock Knowledge Bases to authorized public web content that needs preparation before ingestion. A scheduled Fargate task uses Crawl4AI for bounded crawling, prepares Markdown with page.md.metadata.json sidecars, uploads them to an Amazon S3 data source, and starts ingestion. The knowledge base then handles parsing, chunking, embeddings, indexing, retrieval, and grounded responses with citations.
Start with the Amazon Bedrock Web Crawler in a managed knowledge base for most public websites. Use the Crawl4AI path when you need control over which part of each page is indexed or which metadata travels with it. To get started, deploy the scheduled Fargate workflow from the companion sample-crawl4ai-bedrock-knowledge-base repository, and then validate retrieval quality and citations with representative content before scaling.
Learn more
For more information about the services and patterns in this post, refer to the following resources: