Producción de MLOps en GS Caltex con Amazon SageMaker Canvas, parte 1
Production MLOps at GS Caltex with Amazon SageMaker Canvas, part 1
WonGu Rho
GS Caltex utiliza Amazon SageMaker Canvas y Amazon SageMaker Pipelines para conectar los modelos de los ingenieros de procesos con flujos de trabajo de producción. La empresa energética y química surcoreana divide el desarrollo y las operaciones de los modelos entre ingenieros con habilidades complementarias.
Los ingenieros de procesos crean y validan modelos en SageMaker Canvas sin escribir código, aprovechando su conocimiento del proceso. Los ingenieros de aprendizaje automático (ML) configuran flujos de trabajo de SageMaker Pipelines para implementación y inferencia programada.
Mover activos de SageMaker Canvas a SageMaker Pipelines aún requería trabajo de integración. Los ingenieros de ML tenían que establecer rutas de datos para producción, suministrar la configuración del modelo y conectar trabajos de preprocesamiento y inferencia. GS Caltex automatizó esta entrega mientras reutilizaba los activos creados en SageMaker Canvas.
GS Caltex informa que sus ingenieros de ML ahora implementan modelos en cuestión de horas, en comparación con alrededor de una semana antes. La empresa ejecuta inferencia por lotes cada 30 minutos, reduciendo la necesidad de puntos finales en ejecución continua. GS Caltex informa que esto ha reducido significativamente los costos de inferencia.
Esta publicación explica cómo GS Caltex conecta SageMaker Canvas con SageMaker Pipelines y reutiliza flujos de preprocesamiento validados y modelos en producción.
Visión general de la solución
El flujo de trabajo de operaciones de aprendizaje automático (MLOps) tiene dos caminos: preparar una nueva versión de modelo para implementación y ejecutar inferencia por lotes con el modelo implementado.
De un modelo validado a un flujo de trabajo repetible
Puede utilizar SageMaker Canvas para preparar datos de forma visual, crear modelos y generar predicciones por lotes. También puede registrar modelos validados en Amazon SageMaker Model Registry desde SageMaker Canvas. GS Caltex creó un proceso de entrega separado para convertir estos activos en pasos ejecutables de SageMaker Pipelines.
Los ingenieros de procesos entienden las variables y los datos detrás de un proceso y evalúan si las predicciones de un modelo son útiles. Los ingenieros de ML convierten los activos resultantes en trabajos de producción y administran versiones de modelo y registro de ejecución.
Área
Qué se prepara en SageMaker Canvas
Qué se administra en el flujo de trabajo de producción
Preparación de datos
Un flujo de preprocesamiento creado con Data Wrangler
Trabajos de preprocesamiento en Amazon SageMaker Processing
Desarrollo de modelo
Un modelo entrenado y resultados de evaluación
Versiones de modelo y estado de aprobación en Model Registry
Predicción
Validación de predicciones de modelo
Inferencia por lotes cada 30 minutos utilizando un modelo aprobado
Operaciones
Desarrollo y validación de modelos individuales
Historial de ejecución de pasos, resultados almacenados y control de errores
Arquitectura de referencia
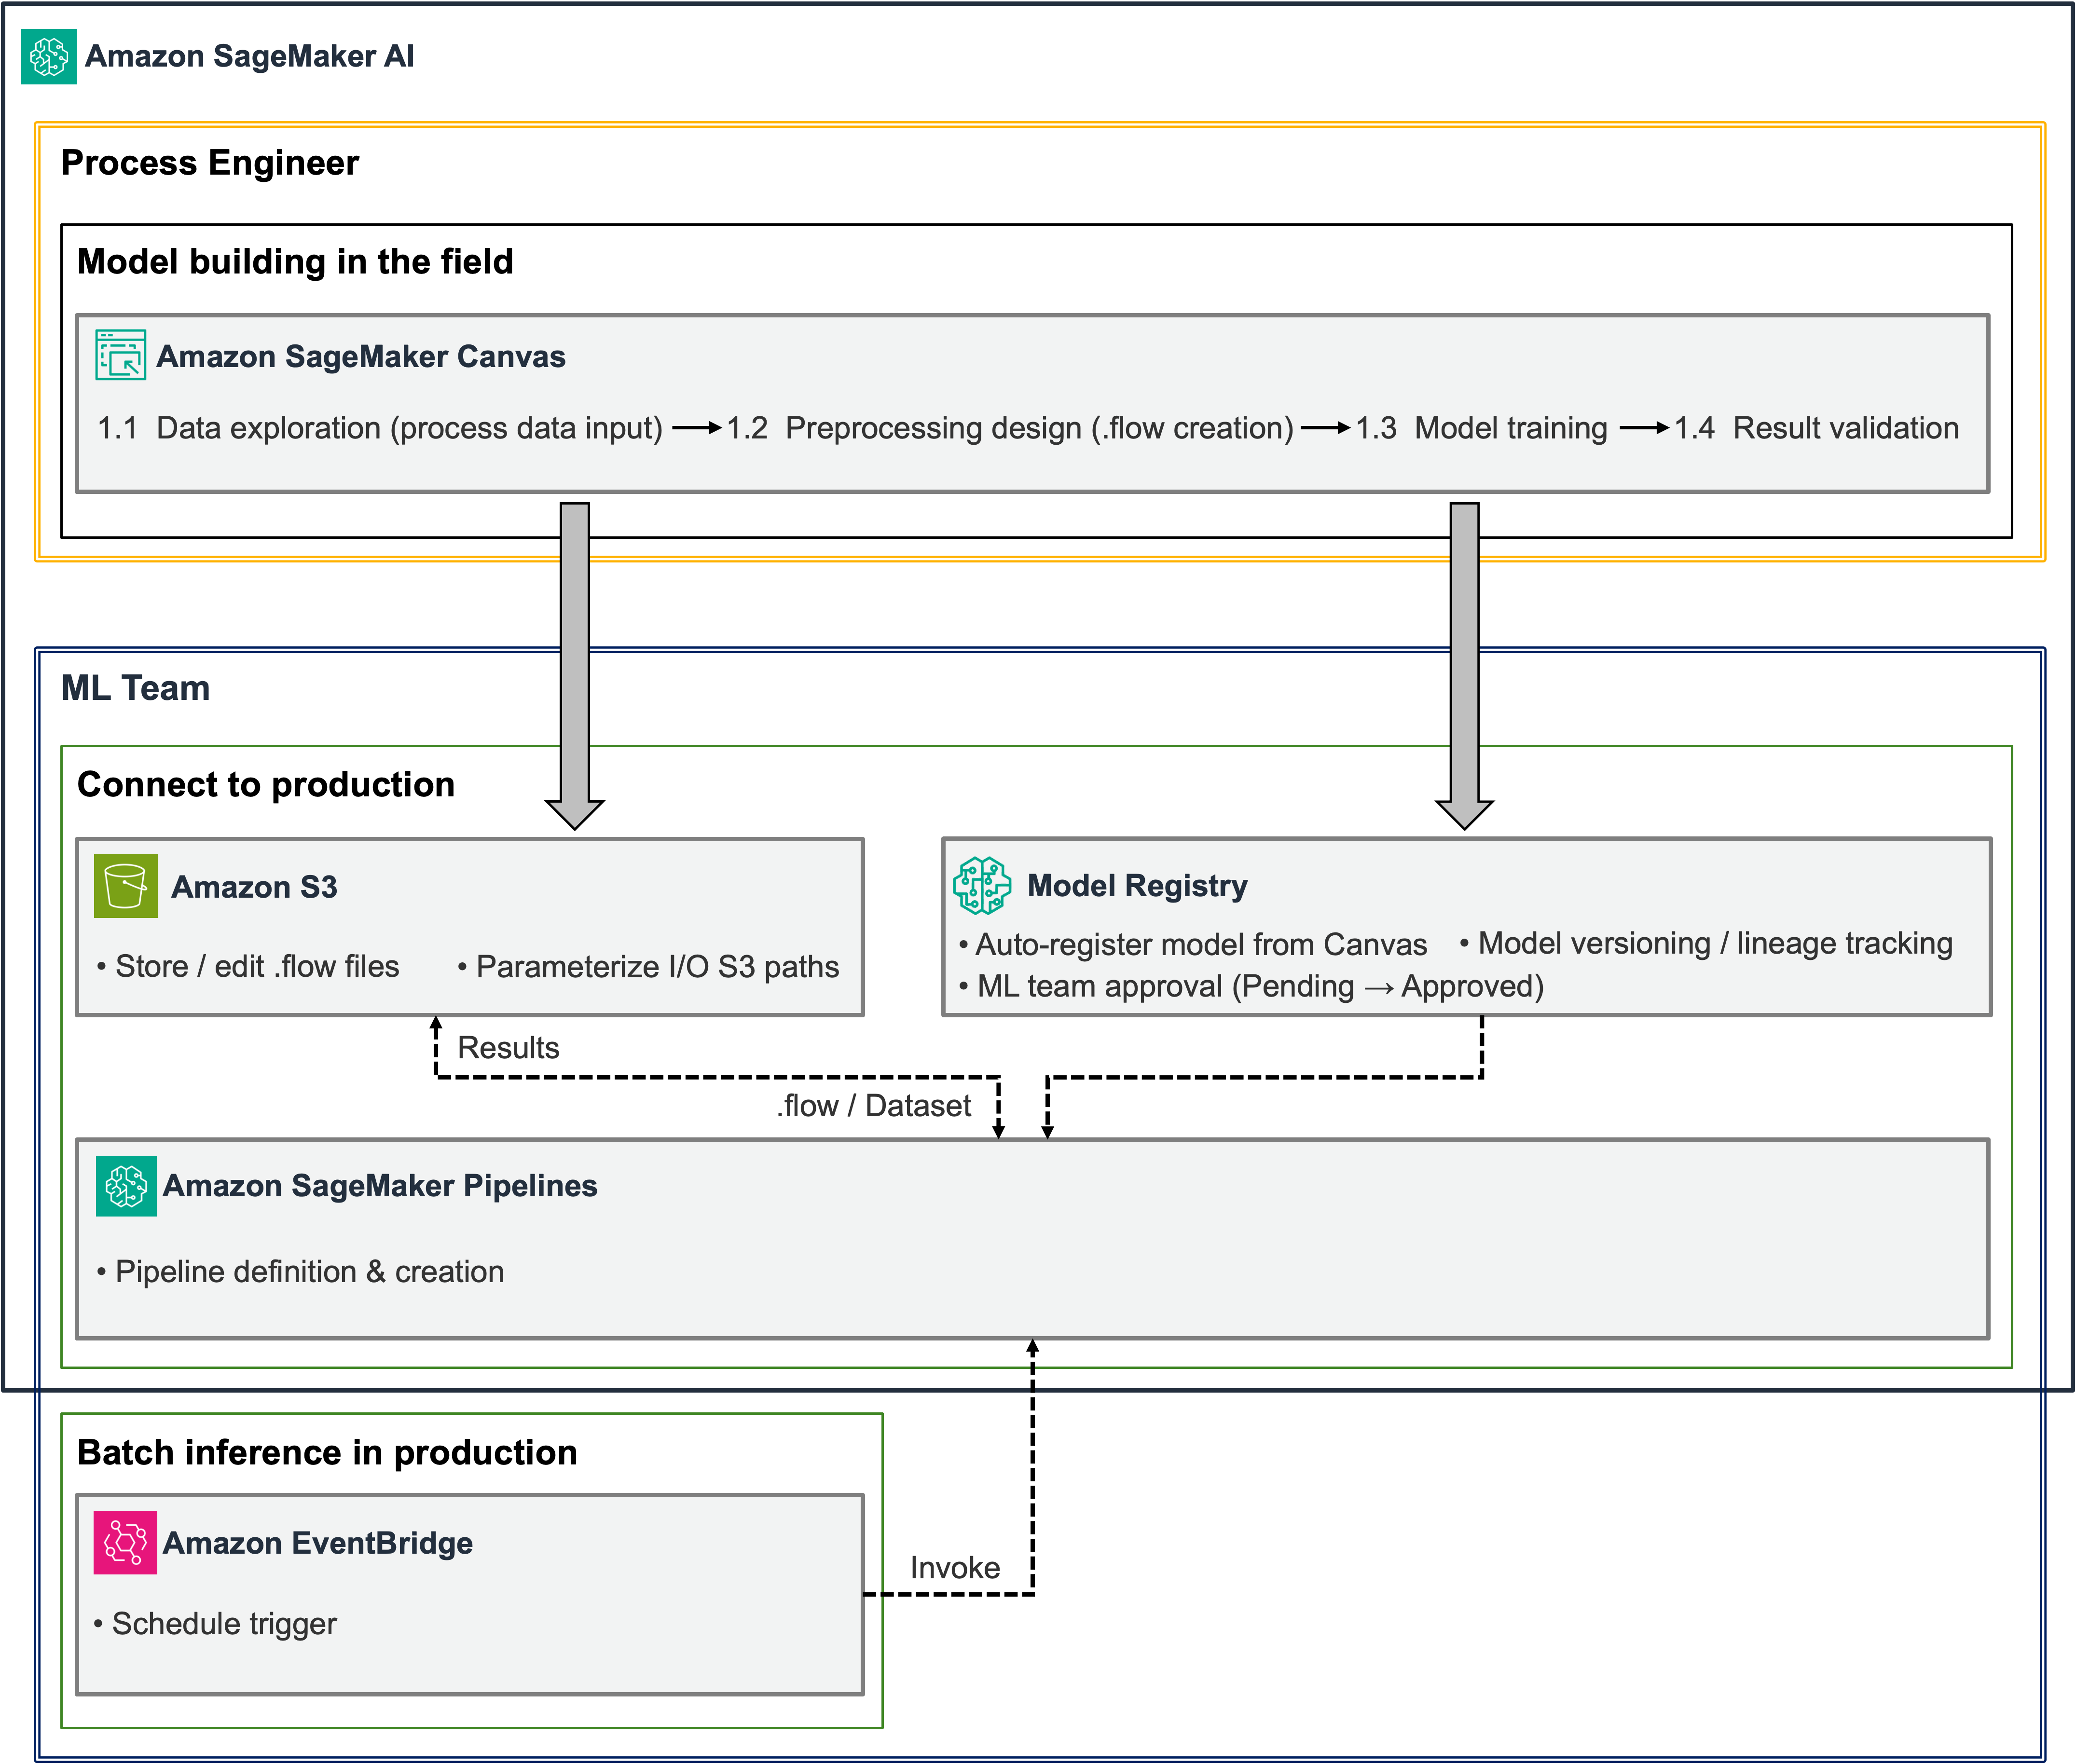
El siguiente diagrama muestra cómo los ingenieros de procesos entregan activos de SageMaker Canvas a ingenieros de ML para implementación y inferencia programada. Los ingenieros de ML utilizan Amazon Simple Storage Service (Amazon S3) para flujos de preprocesamiento y Model Registry para versiones de modelo, y luego programan ejecuciones de pipeline a través de Amazon EventBridge.
Figura 1: Activos de SageMaker Canvas conectados a un flujo de trabajo de SageMaker Pipelines para inferencia por lotes programada
Los ingenieros de ML reciben el flujo de preprocesamiento y el modelo de SageMaker Canvas y revisan los formatos de datos y los resultados de predicción. Después de esa revisión, aprueban el modelo en Model Registry y lo implementan. Esta preparación tiene lugar cuando se implementa una nueva versión de modelo. Las ejecuciones de inferencia posteriores reutilizan el modelo implementado.
Amazon EventBridge inicia cada ejecución programada. SageMaker Pipelines prepara los datos de entrada desde Amazon Simple Storage Service (Amazon S3), ejecuta el preprocesamiento y SageMaker Batch Transform, y almacena los resultados en S3. Los ingenieros de ML pueden inspeccionar el estado de los pasos y los registros de Amazon CloudWatch para monitorear el flujo de trabajo.
La pipeline de producción reutiliza la lógica de preprocesamiento y el modelo entrenado creado en SageMaker Canvas. Los ingenieros de ML configuran las rutas de entrada y salida, establecen el orden de ejecución y escriben el código que conecta la aprobación y la programación al flujo de trabajo.
Un entorno de Python con Boto3 y SageMaker Python SDK 2.x instalados.
La implementación de referencia completa está disponible en el repositorio de GitHub. Los ejemplos de código en esta publicación se centran en las conexiones entre componentes. El repositorio utiliza un modelo de clasificación de préstamos de ejemplo, así que ajuste la configuración para que coincida con los formatos de entrada y salida de su modelo.
Implementación técnica
Los siguientes pasos cubren la reutilización de preprocesamiento, la aprobación y implementación del modelo, la construcción del pipeline y la inferencia programada.
1. Ejecutar el flujo de preprocesamiento de SageMaker Canvas con SageMaker Processing
Un flujo de preprocesamiento creado con Data Wrangler en SageMaker Canvas registra las fuentes de datos y los pasos de transformación. Para configurar la implementación de referencia, exporte datos a Amazon S3 utilizando SageMaker Processing, luego recupere la configuración del trabajo y el archivo .flow utilizado por ese trabajo.
En la configuración de exportación, desactive Configuración de trabajo automática y seleccione SageMaker Processing. Después de que comience la exportación, abra los detalles del trabajo de procesamiento en la consola de Amazon SageMaker AI. Registre la URI de la imagen del contenedor, la URI de S3 de la entrada con nombre flow, el rol de ejecución y la configuración de salida. Utilice estos valores para configurar el paso del pipeline que ejecuta el archivo .flow.
El rol de ejecución de SageMaker debe tener permisos para leer los datos de S3 requeridos, escribir los resultados y acceder a la imagen del contenedor. Elija el tipo y la cantidad de instancias en función del volumen de datos que necesite procesar.
Mantenga la lógica de preprocesamiento validada por el ingeniero de procesos y ajuste las fuentes de datos, los caminos y otros ajustes para el entorno de producción. Verifique la imagen del contenedor y el nodo de salida contra la configuración del trabajo original.
Elemento a verificar
Qué hacer
Ubicación de entrada
Verifique la URI de S3 referenciada por la fuente de datos en el archivo .flow. Subir datos sin procesar a otra ubicación no actualiza esta referencia.
Imagen del contenedor
Utilice la imagen del trabajo de procesamiento creado durante la exportación de S3 y fije una versión que reproduzca las transformaciones validadas.
ID de salida
Utilice el nodo de salida y el nombre de salida de la configuración exportada. Si el formato requerido es {node_id}.{output_name}, coincida exactamente.
Valores de transformación aprendidos
Conservar los valores aprendidos durante el entrenamiento, como los parámetros de escalado y codificación. No vuelva a ajustarlos en cada lote de inferencia.
Validación
Compare las columnas, los tipos de datos y los valores transformados producidos por SageMaker Canvas y Processing para la misma entrada.
Algunos archivos .flow contienen metadatos de ejecución como internal_metadata.dw_job.container_uri. Verifique la configuración real del trabajo de procesamiento en lugar de suponer que cada exportación contiene este campo. Si mueve el flujo de trabajo a otra región de AWS, verifique que la imagen del contenedor esté disponible allí.
La implementación de referencia separa las salidas intermedias y finales por ejecución bajo runs/<execution-id>/. Su paso PrepareInput escribe datos en una ubicación de S3 fija referenciada por el archivo .flow. Evite que las ejecuciones que comparten esa ruta de entrada se superpongan.
Para aislar los datos de entrada para cada ejecución también, agregue un paso de preparación que actualice la URI de origen en una copia del archivo .flow. Declarar un parámetro de SageMaker Pipelines no reemplaza automáticamente una URI dentro del archivo.
2. Manejar las diferencias entre las entradas de entrenamiento y inferencia
La columna de destino es una de las diferencias entre los datos de entrenamiento y inferencia. Un flujo construido con datos de entrenamiento puede contener transformaciones que esperan la columna de destino en el esquema de entrada. Los datos de inferencia no contienen ese resultado conocido.
La implementación de referencia agrega un paso PrepareInput antes del preprocessamiento. Si falta la columna de destino, este paso la agrega con un valor de marcador de posición. Después del preprocessamiento, DropTargetColumn elimina la columna. Coincida con el tipo de datos y la posición de la columna del marcador de posición con el esquema de entrenamiento y pase solo las características esperadas al modelo en su orden original.
Utilice este enfoque solo cuando el destino del placeholder no afecte los valores de la característica. Un flujo que filtra filas por el destino, deriva características de él o aplica codificación de destino necesita un tratamiento adicional. En esos casos, separe las transformaciones y el estado aprendido requerido para la inferencia.
La validación debe cubrir el orden y el recuento de columnas, los tipos de datos, el manejo de valores perdidos y el recuento de filas. Después de eliminar el destino, verifique que las columnas restantes coincidan con el orden de características utilizado durante el entrenamiento.
3. Registrar, aprobar y implementar el modelo
Registre la versión de modelo de SageMaker Canvas validada en el Registro de modelos. La versión registrada puede incluir los archivos del modelo, la configuración de inferencia y los resultados de evaluación. Los ingenieros de ML revisan esta información antes de cambiar el estado de aprobación.
El archivo de modelo, como model.tar.gz, debe usarse con el contenedor de inferencia y la configuración de entorno correctos. Un paquete de modelo en el Registro de modelos agrupa esta información. En esta arquitectura de lote, la implementación crea un recurso de modelo de SageMaker a partir de un paquete aprobado para que Batch Transform lo reference.
El siguiente ejemplo verifica un paquete que ya ha sido aprobado, luego crea el recurso de modelo. Proporcione model_package_arn, model_name y sagemaker_role_arn durante la implementación. Este ejemplo utiliza un nombre de modelo único para cada versión.
import boto3

sm_client = boto3.client("sagemaker")
package = sm_client.describe_model_package(
    ModelPackageName=model_package_arn
)

if package["ModelPackageStatus"] != "Completed":
    raise RuntimeError("Model package is not ready")
if package["ModelApprovalStatus"] != "Approved":
    raise RuntimeError("Model package is not approved")

sm_client.create_model(
    ModelName=model_name,
    ExecutionRoleArn=sagemaker_role_arn,
    PrimaryContainer={"ModelPackageName": model_package_arn},
)
El Registro de modelos registra el estado de aprobación, pero no aplica una verificación de aprobación en cada solicitud de inferencia. Verifique ese estado en el código de implementación y conserve el ARN del paquete seleccionado y el nombre del modelo en la configuración de la canalización. Si se revoca la aprobación, actualice los horarios y las configuraciones de ejecución que utilizan el modelo.
El registro y la implementación tienen lugar cuando se libera una versión del modelo. La canalización que se ejecuta cada 30 minutos crea trabajos de Batch Transform utilizando ese modelo, por lo que no necesita registrar el modelo nuevamente en cada ejecución.
4. Conectar la preprocesamiento, la inferencia y la ensambladura de resultados
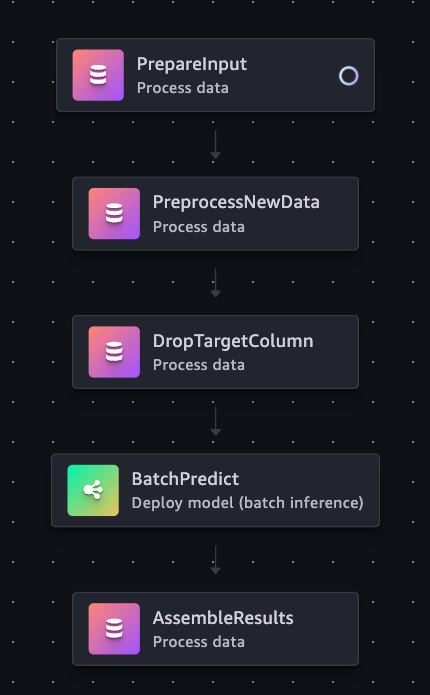
La canalización de inferencia tiene cinco pasos.
Paso
Función
Entrada y salida
PrepareInput
Agregar una columna de destino de placeholder si es necesario
Nuevos datos de inferencia -> datos con la columna de destino suministrada
PreprocessNewData
Ejecutar el flujo de preprocesamiento de SageMaker Canvas
Entrada preparada y .flow -> datos transformados
DropTargetColumn
Eliminar la columna de destino y el encabezado CSV
Datos transformados -> característica CSV sin encabezado
BatchPredict
Ejecutar inferencia por lotes con el modelo aprobado
Característica CSV -> archivos de predicción
AssembleResults
Combinar los datos preprocesados con las predicciones
Datos preprocesados y archivos de predicción -> resultado CSV final
Configure cada trabajo antes de conectar los pasos. En el siguiente ejemplo, prepare_args, preprocess_args, drop_target_args y assemble_args contienen los argumentos de paso devueltos por las llamadas run() en procesadores que utilizan un PipelineSession. Los procesadores y transformer comparten el objeto pipeline_session. Configure el transformer con el model_name previamente implementado.
El siguiente gráfico de ejecución muestra los cinco pasos en el flujo de trabajo de inferencia del modelo de préstamo de muestra. Preparan las entradas, aplican la preprocesamiento, eliminan la columna de destino, ejecutan la inferencia por lotes y ensamblan los resultados. La ejecución estaba en el estado Executing cuando se tomó esta captura de pantalla.
Figura 2: Gráfico de ejecución de SageMaker Pipelines para el modelo de préstamo de muestra
Utilice depends_on para controlar el orden de ejecución y pase los datos a través de las propiedades de salida de paso. Por ejemplo, assemble_args debe recibir la ubicación de los datos preprocesados y predict.properties.TransformOutput.S3OutputPath. El nombre de salida "features" pertenece a DropTargetColumn. El paso Data Wrangler utiliza el ID de salida definido en su flujo de preprocesamiento.
En la implementación de referencia, AssembleResults combina los datos preprocesados y las predicciones por posición de fila. Antes de utilizarlo en producción, agregue controles para que coincidan el orden de archivo y los recuentos de filas, y detenga la generación de resultados si no coinciden. Si el preprocesamiento ordena o elimina filas, mantenga un mapeo explícito entre los ID de registros de origen y las predicciones.
Establezca eventbridge_role_arn en un rol que confíe en el principal de servicio de Amazon EventBridge, events.amazonaws.com, y tenga permiso sagemaker:StartPipelineExecution para la canalización de destino. El valor pipeline_arn identifica la canalización creada en el paso anterior.
La expresión rate(30 minutes) programa ejecuciones a intervalos de 30 minutos. Para ejecutar en la hora y media hora, use cron(0/30 * * * ? *). Decida qué ventana de datos procesa cada ejecución en el paso de preparación de entrada y regístrela con la ejecución.
Consideraciones operativas
Antes de habilitar ejecuciones programadas, verifique el costo total, el tiempo de ejecución y el manejo de datos inválidos o no coincidentes.
Evaluar costos por lotes en todo el flujo de trabajo
Amazon SageMaker Pipelines es un servicio de orquestación de flujo de trabajo sin servidor. Administra el orden de ejecución y las dependencias sin un servidor de flujo de trabajo que deba aprovisionar o mantener. Los trabajos de procesamiento y Batch Transform utilizan recursos de cómputo separados y se facturan según el tipo de instancia y la duración.
Un punto final de tiempo real aprovisionado es adecuado para solicitudes que necesitan una respuesta de baja latencia consistente. Batch Transform es adecuado para cargas de trabajo que pueden procesar un conjunto de registros juntos. Libera los recursos de cómputo del trabajo cuando el trabajo finaliza, por lo que puede ejecutar predicciones sin mantener un punto final de inferencia en ejecución continuamente para cada modelo.
Consideración
Punto final de tiempo real aprovisionado
SageMaker Pipelines con Batch Transform
Ciclo de vida de los recursos
Las instancias permanecen disponibles para atender solicitudes
Los recursos se aprovisionan y liberan para cada trabajo
Controladores de costo
Tiempo de actividad y capacidad del punto final
Duración del trabajo, frecuencia, recuento de instancias y servicios de soporte
Cargas de trabajo adecuadas
Respuestas inmediatas y solicitudes en línea continuas
Procesamiento de datos acumulados a intervalos programados
Agregar un modelo
Capacidad del punto final y costos de alojamiento continuo
Procesamiento adicional, duración del trabajo y límites de concurrencia
Un calendario de 30 minutos produce 48 ejecuciones programadas por día. Incluya el preprocesamiento, el inicio de instancia, la inferencia y el posprocesamiento al estimar el tiempo de ejecución total. La comparación de costos también debe tener en cuenta el Procesamiento, S3, CloudWatch y otros servicios utilizados por el flujo de trabajo.
Evalúe el costo de cada carga de trabajo utilizando su uso medido, incluidos los servicios de soporte y el tiempo de ejecución completo de cada trabajo programado.
Verificar el tiempo de ejecución y las ejecuciones superpuestas
Un calendario que inicia una ejecución cada 30 minutos no garantiza que cada ejecución finalice dentro de ese intervalo. Mida el tiempo de ejecución completo del pipeline con datos representativos, incluido el inicio de instancia y el tiempo necesario para reintentaar trabajos fallidos.
Decida cómo manejar una ejecución programada que llega antes de que la ejecución anterior haya finalizado. Controlar los pasos paralelos dentro de un pipeline no evita que las ejecuciones de pipeline separadas se superpongan. Verifique las ejecuciones activas, evite el procesamiento duplicado de la misma ventana de entrada y separe las rutas de salida para cada ejecución.
Registre la ventana de datos de entrada, la versión del flujo de preprocesamiento, el paquete de modelo ARN, el ARN de ejecución del pipeline y la ubicación de salida para cada ejecución. Estos detalles ayudan a reproducir resultados e investigar errores.
Validar salidas y comportamiento de fallas
Complete las siguientes verificaciones antes de habilitar el calendario:
Ejecute un conjunto de datos de validación a través de SageMaker Canvas y Procesamiento. Compare las columnas de salida, los tipos de datos, los recuentos de filas y los valores transformados clave.
Verifique que agregar un objetivo de marcador de posición no cambie los valores de las características y que el objetivo se elimine de la entrada del modelo.
Ejecute Batch Transform con la versión de modelo aprobada y verifique la asociación entre los registros de origen y las predicciones.
Confirme que un esquema de entrada inválido o una falla de preprocesamiento evite la inferencia y la publicación de resultados posteriores.
Mida el tiempo de ejecución y el costo, pruebe las ejecuciones superpuestas y el reprocesamiento de la misma ventana de entrada, y luego habilite el calendario de 30 minutos.
Agregue alertas de CloudWatch para fallas de trabajo y retrasos de procesamiento, junto con el monitoreo de la calidad de los datos o el modelo según sea necesario. Establezca umbrales iniciales a partir del tiempo de ejecución medido y las características de los datos, y revíselos cuando el modelo o el volumen de datos cambie.
Enfoque de adopción y resultados
Con una implementación escalonada, un equipo puede verificar la transferencia antes de estandarizarla en todos los modelos. Las siguientes secciones describen un enfoque de adopción y los resultados que informó GS Caltex.
Pasar de desarrollo de modelo a operación regular
Comience validando la ruta a producción para un modelo, luego estandarice los pasos que se repiten en las implementaciones. La siguiente secuencia es un enfoque de adopción sugerido basado en la experiencia de GS Caltex.
Etapa
Objetivo
Alcance
Crawl
Reproducir resultados de desarrollo en producción
Validar el modelo de SageMaker Canvas, registrararlo en Model Registry y ejecutar el pipeline manualmente
Walk
Establecer operación programada confiable
Verificar aprobaciones, programar ejecuciones a intervalos requeridos, agregar alertas de fallas y gestionar salidas por ejecución
Run
Reutilizar el proceso operativo en varios modelos
Introducir plantillas comunes, integración y entrega continuas (CI/CD), validación de cambios y procedimientos para transferir la responsabilidad operativa
A medida que se expande la automatización, los ingenieros de procesos continúan evaluando si las predicciones son útiles para el proceso. Los ingenieros de ML gestionan la ejecución del pipeline y los cambios.
Resultados en GS Caltex
GS Caltex redujo el trabajo repetido necesario para conectar los modelos de SageMaker Canvas a producción. Los ingenieros de ML ahora implementan modelos en unas pocas horas, en comparación con aproximadamente una semana anteriormente. También reutilizan los activos que los ingenieros de procesos validaron en SageMaker Canvas.
Los ingenieros de procesos comenzaron a proponer aplicaciones en otros procesos después de ver sus modelos utilizados en producción. Los ingenieros de ML dedicaron menos tiempo a repetir el trabajo de integración y pudieron centrarse en operar y monitorear los pipelines.
Resultado
Resultado informado
Tiempo de implementación del modelo
Anteriormente alrededor de una semana. Ahora en unas pocas horas
Frecuencia de inferencia
Cada 30 minutos
Impacto en el costo
Ahorros de costo significativos
Trabajo de ingeniería
Los ingenieros de procesos propusieron nuevas aplicaciones; los ingenieros de ML se centraron en la operación y el monitoreo del pipeline
Limpieza de recursos de prueba
Para una implementación de prueba, desactive la regla de Amazon EventBridge y elimine sus objetivos primero. Después de que las ejecuciones de pipeline y trabajos activos hayan terminado, elimine el pipeline de prueba y sus recursos de modelo de SageMaker.
Si creó un endpoint en tiempo real para pruebas, elimínelo también. Quite los archivos de entrada, intermedios y predicción de S3 y limpie los registros de CloudWatch según su política de retención. Verifique si otras ejecuciones o requisitos de auditoría aún dependen de los archivos del modelo y las versiones del Model Registry antes de eliminarlos.
Conclusión
En GS Caltex, los ingenieros de procesos crean y validan modelos en SageMaker Canvas, y los ingenieros de ML utilizan esos activos para ejecutar flujos de trabajo de producción en SageMaker Pipelines. Esta entrega redujo el trabajo de integración repetido. GS Caltex informa que los ingenieros de ML ahora completan las implementaciones de modelos en unas pocas horas, en comparación con aproximadamente una semana antes.
La entrega debe incluir el flujo de preprocesamiento, el esquema de entrada, la configuración de inferencia y el proceso de aprobación junto con los archivos del modelo. Verifique que el flujo de trabajo reproduzca los resultados esperados y pueda ejecutarse de manera confiable en el programa requerido.
Para probar este enfoque, comience con un modelo que haya validado en SageMaker Canvas y utilice el repositorio de GitHub. Consulte la guía para desarrolladores de SageMaker Pipelines para obtener detalles sobre la definición y ejecución de flujos de trabajo. Verifique los resultados de preprocesamiento y predicción por lotes con una ejecución manual, luego programe las ejecuciones en el intervalo que necesite su aplicación.
En la parte 2, mostramos cómo GS Caltex utilizó Amazon Bedrock para automatizar el traslado de modelos existentes a esta canalización.
Acerca de los autores
GS Caltex uses Amazon SageMaker Canvas and Amazon SageMaker Pipelines to connect process engineers’ models to production workflows. The South Korean energy and chemical company divides model development and operations between engineers with complementary skills.
Process engineers build and validate models in SageMaker Canvas without writing code, drawing on their process knowledge. Machine learning (ML) engineers configure SageMaker Pipelines workflows for deployment and scheduled inference.
Moving assets from SageMaker Canvas into SageMaker Pipelines still required integration work. ML engineers had to set data paths for production, supply the model configuration, and connect preprocessing and inference jobs. GS Caltex automated this handoff while reusing the assets created in SageMaker Canvas.
GS Caltex reports that its ML engineers now deploy models within a few hours, compared with about a week before. The company runs batch inference every 30 minutes, reducing the need for continuously running endpoints. GS Caltex reports that this has meaningfully lowered its inference costs.
This post explains how GS Caltex connects SageMaker Canvas to SageMaker Pipelines and reuses validated preprocessing flows and models in production.
Solution overview
The machine learning operations (MLOps) workflow has two paths: preparing a new model version for deployment, and running batch inference with the deployed model.
From a validated model to a repeatable workflow
You can use SageMaker Canvas to prepare data visually, build models, and generate batch predictions. You can also register validated models in Amazon SageMaker Model Registry from SageMaker Canvas. GS Caltex built a separate handoff process to turn these assets into executable SageMaker Pipelines steps.
Process engineers understand the variables and data behind a process and assess whether a model’s predictions are useful. ML engineers turn the resulting assets into production jobs and manage model versions and execution history.
Area
What is prepared in SageMaker Canvas
What is managed in the production workflow
Data preparation
A preprocessing flow built with Data Wrangler
Preprocessing jobs in Amazon SageMaker Processing
Model development
A trained model and evaluation results
Model versions and approval status in Model Registry
Prediction
Validation of model predictions
Batch inference every 30 minutes using an approved model
Operations
Development and validation of individual models
Step execution history, stored results, and failure handling
Reference architecture
The following diagram shows how process engineers hand off SageMaker Canvas assets to ML engineers for deployment and scheduled inference. ML engineers use Amazon Simple Storage Service (Amazon S3) for preprocessing flows and Model Registry for model versions, then schedule pipeline runs through Amazon EventBridge.
Figure 1: SageMaker Canvas assets connected to a SageMaker Pipelines workflow for scheduled batch inference
ML engineers receive the preprocessing flow and model from SageMaker Canvas and review the data formats and prediction results. After that review, they approve the model in Model Registry and deploy it. This preparation takes place when a new model version is deployed. Subsequent inference runs reuse the deployed model.
Amazon EventBridge starts each scheduled run. SageMaker Pipelines prepares the input data from Amazon Simple Storage Service (Amazon S3), runs preprocessing and SageMaker Batch Transform, and stores the results in S3. ML engineers can inspect step status and Amazon CloudWatch logs to monitor the workflow.
The production pipeline reuses the preprocessing logic and trained model created in SageMaker Canvas. ML engineers configure the input and output paths, set the order of execution, and write the code that connects approval and scheduling to the workflow.
A Python environment with Boto3 and SageMaker Python SDK 2.x installed.
The full reference implementation is available in the GitHub repository. The code examples in this post focus on the connections between components. The repository uses a sample loan classification model, so adjust the configuration to match your model’s input and output formats.
Technical implementation
The following steps cover preprocessing reuse, model approval and deployment, pipeline construction, and scheduled inference.
1. Run the SageMaker Canvas preprocessing flow with SageMaker Processing
A preprocessing flow created with Data Wrangler in SageMaker Canvas records the data sources and transformation steps. To set up the reference implementation, export data to Amazon S3 using SageMaker Processing, then retrieve the job settings and the .flow file used by that job.
In the export settings, turn off Auto job configuration and select SageMaker Processing. After the export starts, open the Processing job details on the Amazon SageMaker AI console. Record the container image URI, the S3 URI of the input named flow, the execution role, and the output settings. Use these values to configure the pipeline step that runs the .flow file.
The SageMaker execution role must have permissions to read the required S3 data, write the results, and access the container image. Choose the instance type and count based on the volume of data you need to process.
Keep the preprocessing logic validated by the process engineer, and adjust the data sources, paths, and other settings for the production environment. Check the container image and output node against the original job configuration.
Item to check
What to do
Input location
Check the S3 URI referenced by the data source in the .flow file. Uploading raw data to another location does not update this reference.
Container image
Use the image from the Processing job created during the S3 export, and pin a version that reproduces the validated transformations.
Output ID
Use the output node and output name from the exported configuration. If the required format is {node_id}.{output_name}, match it exactly.
Learned transformation values
Preserve values learned during training, such as scaling and encoding parameters. Do not refit them on each inference batch.
Validation
Compare the columns, data types, and transformed values produced by SageMaker Canvas and Processing for the same input.
Some .flow files contain execution metadata such as internal_metadata.dw_job.container_uri. Check the actual Processing job settings rather than assuming that every export contains this field. If you move the workflow to another AWS Region, verify that the container image is available there.
The reference implementation separates intermediate and final outputs by execution under runs/<execution-id>/. Its PrepareInput step writes data to a fixed S3 location referenced by the .flow file. Prevent executions that share that input path from overlapping.
To isolate input data for each execution as well, add a preparation step that updates the source URI in a copy of the .flow file. Declaring a SageMaker Pipelines parameter does not automatically replace a URI inside the file.
2. Handle differences between training and inference inputs
The target column is one difference between training and inference data. A flow built with training data can contain transformations that expect the target column in the input schema. Inference data does not contain that known outcome.
The reference implementation adds a PrepareInput step before preprocessing. If the target column is missing, this step adds it with a placeholder value. After preprocessing, DropTargetColumn removes the column. Match the placeholder’s data type and column position to the training schema, and pass only the expected features to the model in their original order.
Use this approach only when the placeholder target does not affect feature values. A flow that filters rows by the target, derives features from it, or applies target encoding needs additional treatment. In those cases, separate the transformations and learned state required for inference.
Validation should cover column order and count, data types, missing-value handling, and row count. After removing the target, check that the remaining columns match the feature order used during training.
3. Register, approve, and deploy the model
Register the validated SageMaker Canvas model version in Model Registry. The registered version can include the model files, inference configuration, and evaluation results. ML engineers review this information before changing the approval status.
The model file, such as model.tar.gz, must be used with the correct inference container and environment settings. A model package in Model Registry groups this information together. In this batch architecture, deployment creates a SageMaker model resource from an approved package for Batch Transform to reference.
The following example checks a package that has already been approved, then creates the model resource. Supply model_package_arn, model_name, and sagemaker_role_arn during deployment. This example uses a unique model name for each version.
import boto3

sm_client = boto3.client("sagemaker")
package = sm_client.describe_model_package(
    ModelPackageName=model_package_arn
)

if package["ModelPackageStatus"] != "Completed":
    raise RuntimeError("Model package is not ready")
if package["ModelApprovalStatus"] != "Approved":
    raise RuntimeError("Model package is not approved")

sm_client.create_model(
    ModelName=model_name,
    ExecutionRoleArn=sagemaker_role_arn,
    PrimaryContainer={"ModelPackageName": model_package_arn},
)
Model Registry records approval status, but it does not enforce an approval check on every inference request. Check that status in the deployment code and retain the selected package ARN and model name in the pipeline configuration. If approval is revoked, update the schedules and execution configurations that use the model.
Registration and deployment take place when a model version is released. The pipeline that runs every 30 minutes creates Batch Transform jobs using that model, so it does not need to register the model again on each run.
4. Connect preprocessing, inference, and result assembly
The inference pipeline has five steps.
Step
Function
Input and output
PrepareInput
Add a placeholder target column if needed
New inference data -> data with the target column supplied
PreprocessNewData
Run the SageMaker Canvas preprocessing flow
Prepared input and .flow -> transformed data
DropTargetColumn
Remove the target column and CSV header
Transformed data -> feature CSV without a header
BatchPredict
Run batch inference with the approved model
Feature CSV -> prediction files
AssembleResults
Combine the preprocessed data with predictions
Preprocessed data and prediction files -> final result CSV
Configure each job before connecting the steps. In the following example, prepare_args, preprocess_args, drop_target_args, and assemble_args hold the step arguments returned by run() calls on processors that use a PipelineSession. The processors and transformer share the pipeline_session object. Configure the transformer with the previously deployed model_name.
The following execution graph shows the five steps in the sample loan model’s inference workflow. They prepare inputs, apply preprocessing, remove the target column, run batch inference, and assemble results. The execution was in the Executing state when this screenshot was taken.
Figure 2: SageMaker Pipelines execution graph for the sample loan model
Use depends_on to control execution order, and pass data through step output properties. For example, assemble_args must receive the location of the preprocessed data and predict.properties.TransformOutput.S3OutputPath. The output name "features" belongs to DropTargetColumn. The Data Wrangler step uses the output ID defined in its preprocessing flow.
In the reference implementation, AssembleResults combines the preprocessed data and predictions by row position. Before using it in production, add checks that file order and row counts match, and stop result generation if they do not. If preprocessing sorts or removes rows, maintain an explicit mapping between source record IDs and predictions.
Set eventbridge_role_arn to a role that trusts the Amazon EventBridge service principal, events.amazonaws.com, and has sagemaker:StartPipelineExecution permission for the target pipeline. The pipeline_arn value identifies the pipeline created in the previous step.
The expression rate(30 minutes) schedules runs at 30-minute intervals. To run on the hour and half hour, use cron(0/30 * * * ? *). Decide which data window each run processes in the input preparation step, and record it with the execution.
Operational considerations
Before enabling scheduled runs, check the total cost, execution time, and handling of invalid or mismatched data.
Evaluate batch costs across the full workflow
Amazon SageMaker Pipelines is a serverless workflow orchestration service. It manages execution order and dependencies without a workflow server for you to provision or maintain. Processing and Batch Transform jobs use separate compute resources and are billed according to instance type and duration.
A provisioned real-time endpoint is a good fit for requests that need a consistently low-latency response. Batch Transform suits workloads that can process a set of records together. It releases the job’s compute resources when the job finishes, so you can run predictions without keeping an inference endpoint running continuously for each model.
Consideration
Provisioned real-time endpoint
SageMaker Pipelines with Batch Transform
Resource lifecycle
Instances remain available to serve requests
Resources are provisioned and released for each job
Cost drivers
Endpoint uptime and capacity
Job duration, frequency, instance count, and supporting services
Suitable workloads
Immediate responses and ongoing online requests
Processing accumulated data at scheduled intervals
Adding a model
Endpoint capacity and ongoing hosting costs
Additional processing, job duration, and concurrency limits
A 30-minute schedule produces 48 scheduled runs per day. Include preprocessing, instance startup, inference, and postprocessing when estimating total runtime. The cost comparison should also account for Processing, S3, CloudWatch, and other services used by the workflow.
Assess the cost of each workload using its measured usage, including the supporting services and the full runtime of every scheduled job.
Check runtime and overlapping executions
A schedule that starts a run every 30 minutes does not guarantee that each run finishes within that interval. Measure the full pipeline runtime with representative data, including instance startup and the time needed to retry failed jobs.
Decide how to handle a scheduled run that arrives before the previous execution has finished. Controlling parallel steps within a pipeline does not prevent separate pipeline executions from overlapping. Check active executions, prevent duplicate processing of the same input window, and separate the output paths for each run.
Record the input data window, preprocessing flow version, model package ARN, pipeline execution ARN, and output location for each run. These details help reproduce results and investigate errors.
Validate outputs and failure behavior
Complete the following checks before you enable the schedule:
Run a validation dataset through SageMaker Canvas and Processing. Compare the output columns, data types, row counts, and key transformed values.
Check that adding a placeholder target does not change feature values, and that the target is removed from the model input.
Run Batch Transform with the approved model version and verify the association between source records and predictions.
Confirm that an invalid input schema or preprocessing failure prevents downstream inference and result publication.
Measure runtime and cost, test overlapping executions and reprocessing of the same input window, and then enable the 30-minute schedule.
Add CloudWatch alerts for job failures and processing delays, together with data quality or model monitoring as needed. Set initial thresholds from measured runtime and data characteristics, and review them when the model or data volume changes.
Adoption approach and results
With a staged rollout, a team can verify the handoff before standardizing it across models. The following sections describe an adoption approach and the results GS Caltex reported.
Move from model development to regular operation
Start by validating the path to production for one model, then standardize the steps that repeat across deployments. The following sequence is a suggested adoption approach based on the GS Caltex experience.
Stage
Goal
Scope
Crawl
Reproduce development results in production
Validate the SageMaker Canvas model, register it in Model Registry, and run the pipeline manually
Walk
Establish reliable scheduled operation
Check approvals, schedule runs at the required interval, add failure alerts, and manage outputs by execution
Run
Reuse the operating process across models
Introduce common templates, continuous integration and continuous delivery (CI/CD), change validation, and procedures for transferring operational responsibility
As automation expands, process engineers continue to assess whether the predictions are useful for the process. ML engineers manage pipeline execution and changes.
Results at GS Caltex
GS Caltex reduced the repeated work needed to connect SageMaker Canvas models to production. ML engineers now deploy models within a few hours, compared with about a week previously. They also reuse the assets that process engineers validated in SageMaker Canvas.
Process engineers began proposing applications in other processes after seeing their models used in production. ML engineers spent less time repeating integration work and could focus on operating and monitoring the pipelines.
Outcome
Reported result
Model deployment time
Previously about a week. Now within a few hours
Inference frequency
Every 30 minutes
Cost impact
Meaningful cost savings
Engineering work
Process engineers proposed new applications; ML engineers focused on pipeline operation and monitoring
Clean up test resources
For a test deployment, disable the Amazon EventBridge rule and remove its targets first. After active pipeline executions and jobs have finished, delete the test pipeline and its SageMaker model resources.
If you created a real-time endpoint for testing, delete it as well. Remove input, intermediate, and prediction files from S3, and clean up CloudWatch logs according to your retention policy. Check whether other executions or audit requirements still depend on model files and Model Registry versions before deleting them.
Conclusion
At GS Caltex, process engineers create and validate models in SageMaker Canvas, and ML engineers use those assets to run production workflows in SageMaker Pipelines. This handoff reduced repeated integration work. GS Caltex reports that ML engineers now complete model deployments within a few hours, compared with about a week before.
The handoff needs to include the preprocessing flow, input schema, inference configuration, and approval process alongside the model files. Verify that the workflow reproduces the expected results and can run reliably on the required schedule.
To try this approach, start with one model you have validated in SageMaker Canvas and use the GitHub repository. See the SageMaker Pipelines developer guide for details on defining and running workflows. Check preprocessing and batch prediction results with a manual execution, then schedule runs at the interval your application needs.
In part 2, we show how GS Caltex used Amazon Bedrock to automate moving existing models onto this pipeline.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.