
vLLM es un motor de inferencia y servicio de código abierto para modelos lingüísticos grandes (LLM). La inferencia de LLM tiene dos fases diferenciadas: la de prellenado, que procesa la solicitud de entrada y crea la caché de valores clave (KV), y la de decodificación, que utiliza esa caché para generar datos de salida uno por uno. Estas fases tienen diferentes características de cálculo, memoria y escalado. La desagregación previa a la decodificación (P-D) las ejecuta en instancias de motor independientes, lo que permite que cada fase se escale y optimice de forma independiente. Esto puede mejorar la utilización de los recursos, el rendimiento y la latencia bajo carga. Sin embargo, también es necesario transferir la caché de KV de la instancia de precarga a la instancia de decodificación antes de que pueda comenzar la generación del token, por lo que la transferencia de KV eficiente es fundamental para obtener el primer token (TTFT).
Una de las formas en que vLLM realiza esta transferencia es a través del conector NVIDIA Inference Xfer Library (NIXL), que mueve los bloques KV a través de interconexiones que admiten el acceso remoto directo a la memoria (RDMA), como el adaptador AWS Elastic Fabric (AWS EFA, la red RDMA de baja latencia que se utiliza en los servidores de AWS). En los tipos de instancia compatibles, AWS EFA admite GPUDirect RDMA y Neuron Direct RDMA. Por lo tanto, NIXL puede transferir bloques de KV directamente entre la GPU o la memoria del dispositivo AWS Trainium sin pasar por la memoria del host. El modo predeterminado del conector NIXL es el basado en la extracción: cuando la instancia de precarga termina de calcular la caché KV de mensajes, el router transmite los metadatos de origen, incluidos los ID de los bloques de precarga, a la instancia de decodificación. A continuación, la instancia de decodificación asigna los bloques de destino, prepara la transferencia de NIXL e inicia NIXL READ para extraer los bloques KV de la instancia de precarga. Como estos pasos de coordinación y configuración se llevan a cabo de forma secuencial después del llenado previo y antes de que pueda comenzar la decodificación, amplían la ruta crítica del TTFT, tal y como se muestra en el
siguiente cronograma.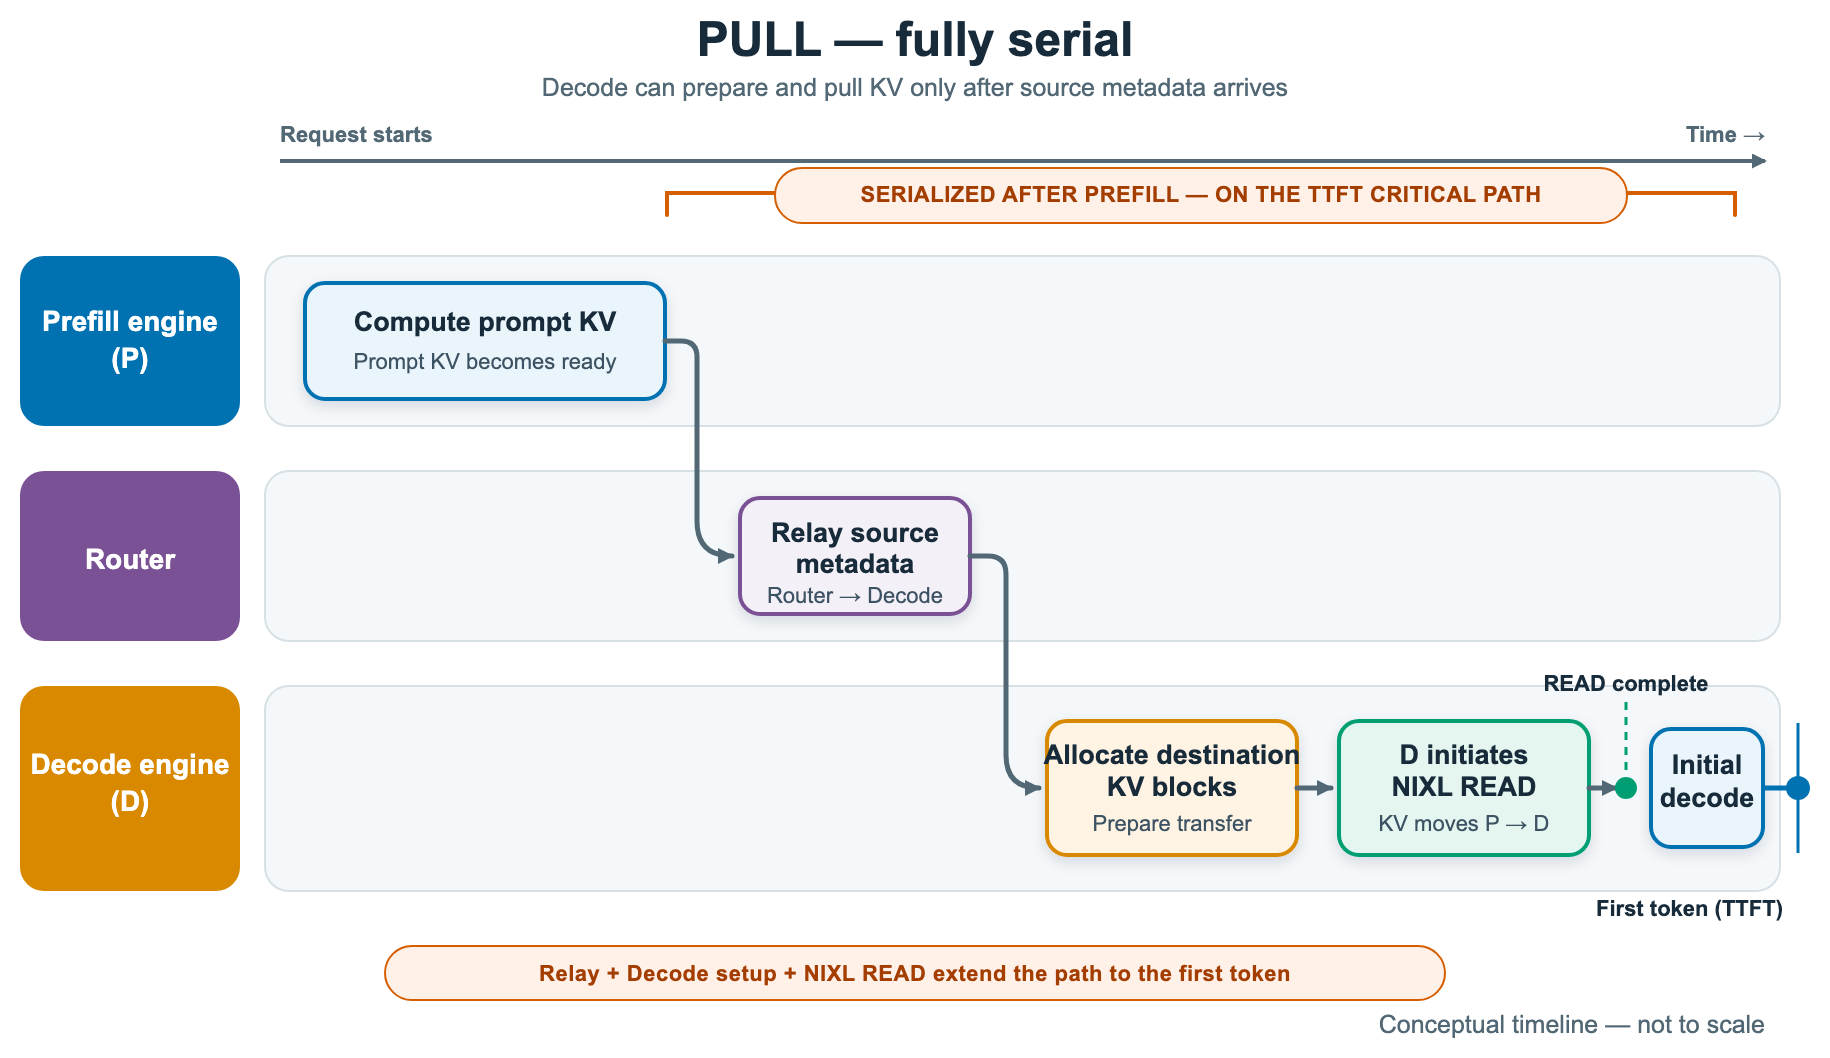
Figura 1: Cronograma de transferencia de KV en modo extracción, en el que el relé del enrutador, la asignación del lado de decodificación y el NIXL READ se ejecutan en serie en la ruta hacia el primer token
En este artículo se presenta un conector NIXL basado en pulsaciones que desvía la coordinación y la configuración de las transferencias posteriores a la precarga de la ruta crítica. Si utilizas vLLM para realizar inferencias desagregadas de prellenado y decodificación, el modo push puede mejorar la capacidad de respuesta de las aplicaciones al reducir el TTFT y el TPOT, especialmente con tasas de solicitudes altas
.En nuestro punto de referencia sobre una implementación 1P1D con instancias P5en de Amazon Elastic Compute Cloud (Amazon EC2) conectadas con EFA, el modo push ofrecía un TTFT hasta 3 veces mejor y hasta un 30 por ciento más de tiempo por token de salida (TPOT) en comparación con el modo pull (consulte la sección Datos de rendimiento) del modelo Qwen3-32B. Los resultados dependen
de la carga de trabajo y de la configuración.Creamos y validamos la función en clústeres de instancias de AWS Trainium conectados con EFA y, a continuación, la incorporamos a vLLM como una función independiente del acelerador. Los resultados que se muestran aquí provienen de un clúster P5en (GPU) de Amazon EC2 con EFA, lo que demuestra que las ventajas se transfieren a las GPU. En este artículo se explican la arquitectura basada en push, el flujo de transferencia, el modelo de subprocesamiento, los resultados de rendimiento y
cómo reproducir el punto de referencia.Transferencia KV basada en push
En esta sección se explica el diseño basado en tecnología push: su arquitectura, el protocolo de transferencia y el modelo de subprocesos que mantienen la transferencia KV alejada de la ruta crítica.
Descripción general de la arquitectura
La transferencia basada en push mejora el rendimiento del TTFT y la decodificación por dos motivos:
- Elimina la serialización del modelo pull al superponer el trabajo del productor y el del consumidor. La instancia de decodificación registra sus bloques de destino con antelación mientras el productor sigue calculando KV. La transferencia comienza entonces tan pronto como los bloques del productor estén listos, y no después de que el consumidor descubra su identidad de ida y vuelta, eliminando esa ida y vuelta de la ruta hacia el primer token .
- Esto reduce el tiempo de configuración de la transferencia a la instancia de decodificación. Esa configuración se ejecuta en el lado de prellenado y en un subproceso en segundo plano. Prepara los descriptores NIXL y envía la transferencia, de modo que la instancia de decodificación no dedique esos ciclos durante su fase de generación de tokens, crítica para la latencia.
El efecto neto es un menor TTFT y un mayor rendimiento de los tokens de salida en la instancia de decodificación.
El conector push coordina tres factores: la instancia de decodificación registra sus bloques de destino de forma anticipada, la instancia de precarga coincide con cada solicitud y emite la transferencia, y un subproceso dedicado en segundo plano se encarga de eliminar la KV del bucle de paso directo del motor. El siguiente diagrama muestra cómo
encajan estas piezas.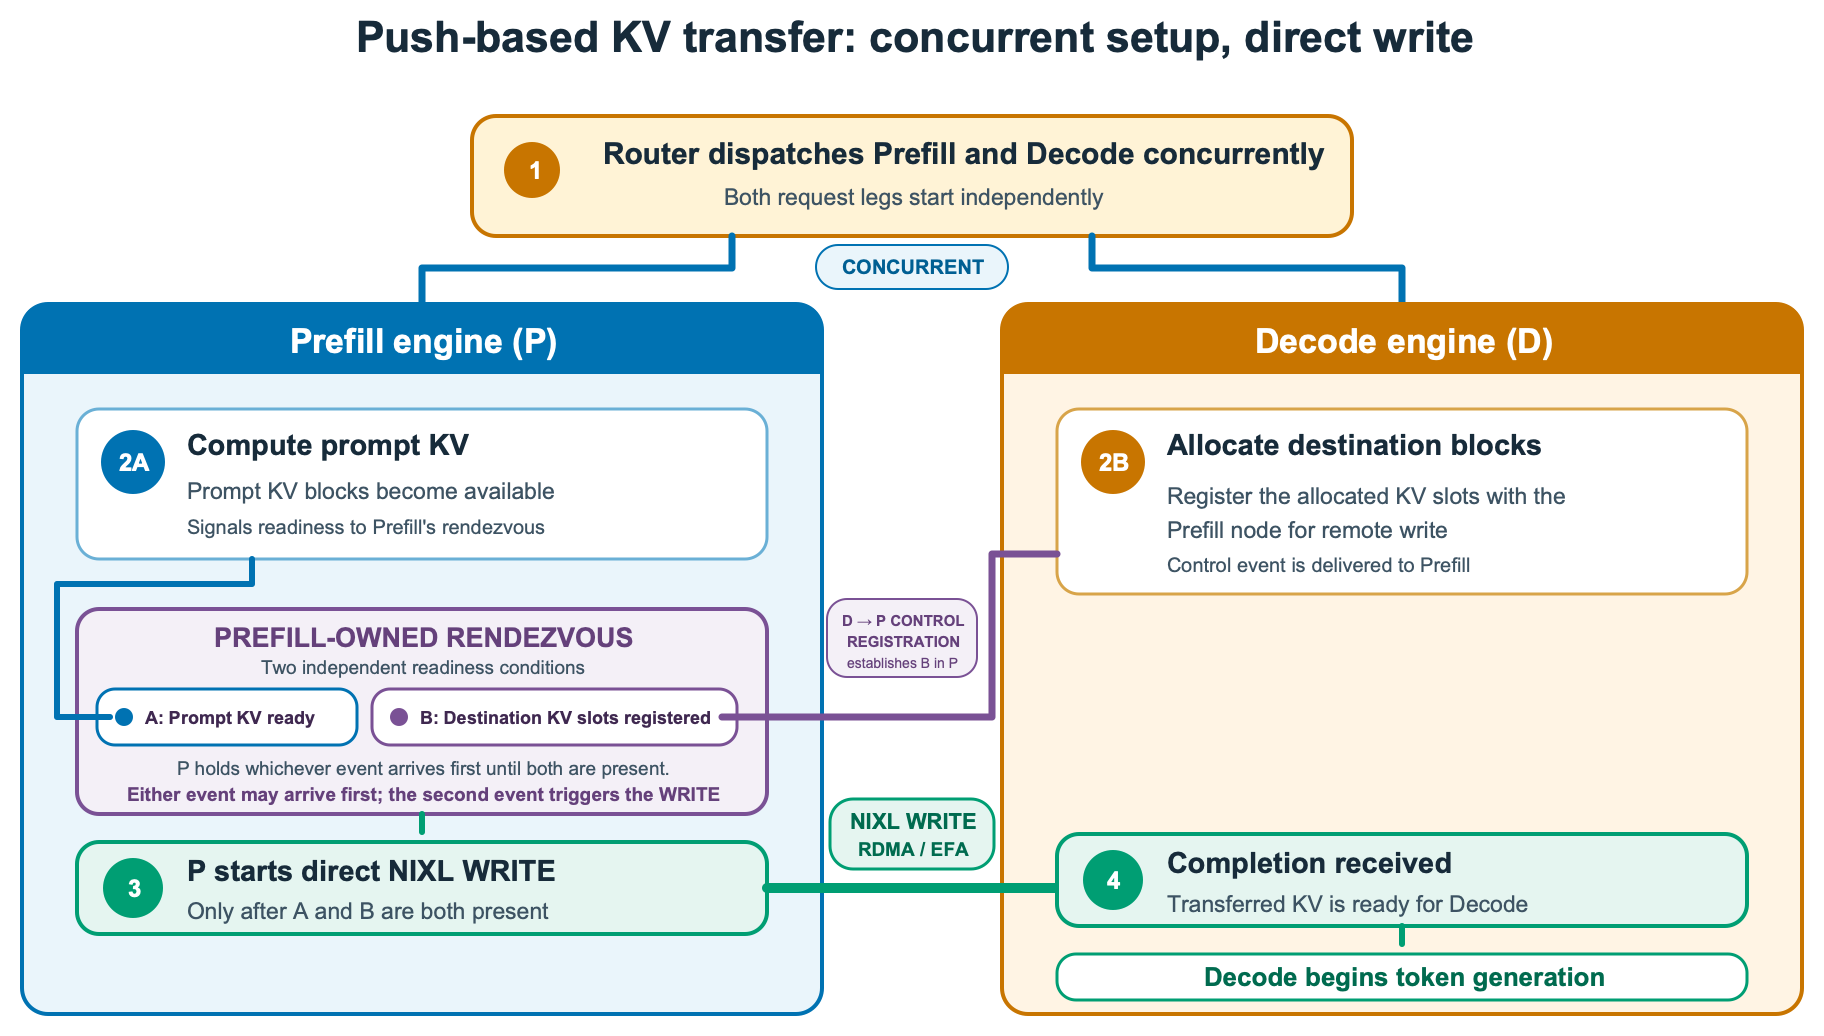
Figura 2: Arquitectura de transferencia KV basada en push, que muestra cómo se coordinan la instancia de decodificación, la instancia de prellenado y el hilo de transferencia en segundo plano
Detalles de implementación
El protocolo tiene tres pasos lógicos.
1. Registro (lado de decodificación). Cuando la instancia de descodificación asigna bloques locales para una solicitud que requiere la precumplimentación remota, prepara un registro en el que se describe dónde debe escribir el KV la instancia precargada: su propia identidad y las ubicaciones de los bloques que acaba de reservar. En el mismo paso del motor, el trabajador transmite este registro a la instancia de prellenado en forma de notificación NIXL. Como el registro se produce en el momento de la asignación, el conector conoce los bloques de destino antes de que la instancia de prellenado complete el proceso de prellenado
.2. Rendezvous (lado de prellenado). El registro desde el decodificador y el proceso de prellenado en el productor pueden llegar en cualquier orden, y el conector se encarga de ambos. Si el registro llega primero, el productor lo retiene hasta que termine el proceso de prellenado. Si el proceso de prellenado finaliza primero, el productor retiene los bloques de la solicitud hasta que llegue el registro. Sea cual sea el evento que ocurra en segundo lugar, se activará la transferencia. El conector empareja las solicitudes por ID y las cuentas coincidentes para las solicitudes reemitidas, asociando correctamente las solicitudes prioritarias o reintentadas.
3. Transferencia (lado de prellenado). Una vez que una solicitud coincide, el productor establece una conexión con la instancia de decodificación (si aún no existe una) y emite un NIXL WRITE que copia los bloques KV directamente a la memoria registrada del decodificador, direccionando cada rango tensor-paralelo de destino. El productor y el consumidor pueden usar diferentes diseños de bloques internos. Cada lado asigna las ubicaciones de los bloques a su propio diseño físico en el momento de la transferencia, lo que permite diferentes tamaños de bloque en cada lado. Cada WRITE incluye una notificación de finalización que NIXL envía a la instancia de decodificación una vez que llegan los datos. El decodificador cuenta estas notificaciones, una por cada rango de productor que escriba en ella. Solo considera que el KV se ha recibido después de que hayan llegado todas las notificaciones esperadas, momento en el que la solicitud procede a decodificarla
.Modelo de enhebrado
El conector push separa la ejecución del modelo de la preparación de la transferencia KV mediante el uso de un subproceso de transferencia en segundo plano dedicado en cada dispositivo de prellenado. Al inicio de una solicitud, el bucle principal de decodificación asigna sus bloques KV de destino y los registra en la instancia de precarga, mientras que el bucle principal de precarga calcula la caché de KV inmediata. Una vez que el registro de destino y el indicador KV estén listos, el bucle principal precompletado pasa los bloques KV al subproceso en segundo plano y vuelve rápidamente a la ejecución del modelo
.El subproceso en segundo plano establece o reutiliza la conexión NIXL, asigna los ID de bloque KV de la solicitud a los descriptores de memoria, fusiona los bloques contiguos en regiones de transferencia más grandes y envía la escritura NIXL a la instancia de decodificación. Cuando NIXL completa la transferencia, envía una notificación de finalización a la instancia de decodificación, que luego comienza a generar el token. Mantener la preparación de los descriptores y el envío de transferencias fuera de los bucles principales, que son críticos para la latencia, evita que este trabajo por solicitud retrase la ejecución del modelo. El siguiente diagrama muestra estas transferencias entre el bucle principal y el subproceso en segundo plano para
una sola solicitud.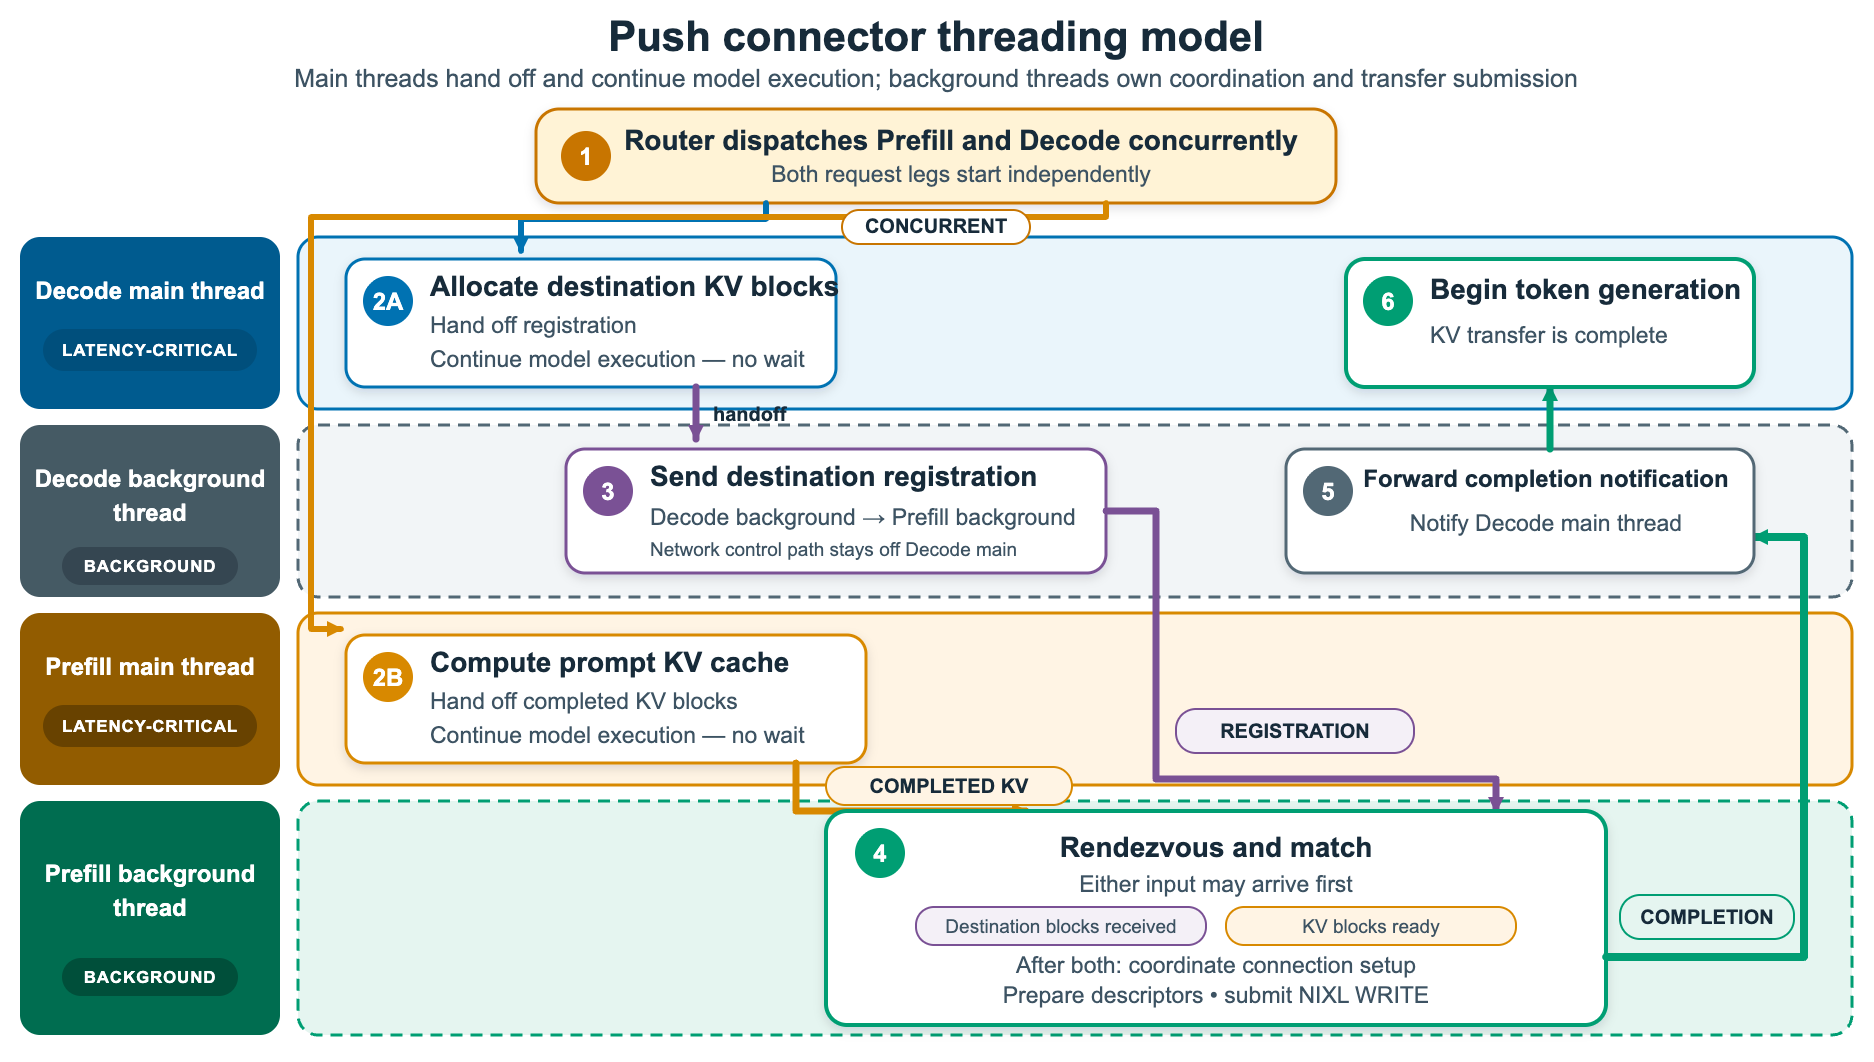
Figura 3: Transferencias del bucle principal y del subproceso de fondo para una sola solicitud en el modelo de subprocesamiento basado en push
Comparación de tiempos entre tirar y empujar
El siguiente diagrama resume los flujos de transferencia de tracción y empuje descritos en las secciones anteriores y destaca su efecto en el TTFT. Aunque ambos modos utilizan la misma ruta de datos NIXL y EFA/RDMA, pull se encarga de la retransmisión de metadatos y de la configuración del lado del decodificador después del prellenado, mientras que el modo push superpone la configuración del lado de decodificación con la del prefill. Como resultado, el método push elimina estas operaciones de la ruta crítica posterior al prellenado, lo que permite que la decodificación comience antes
.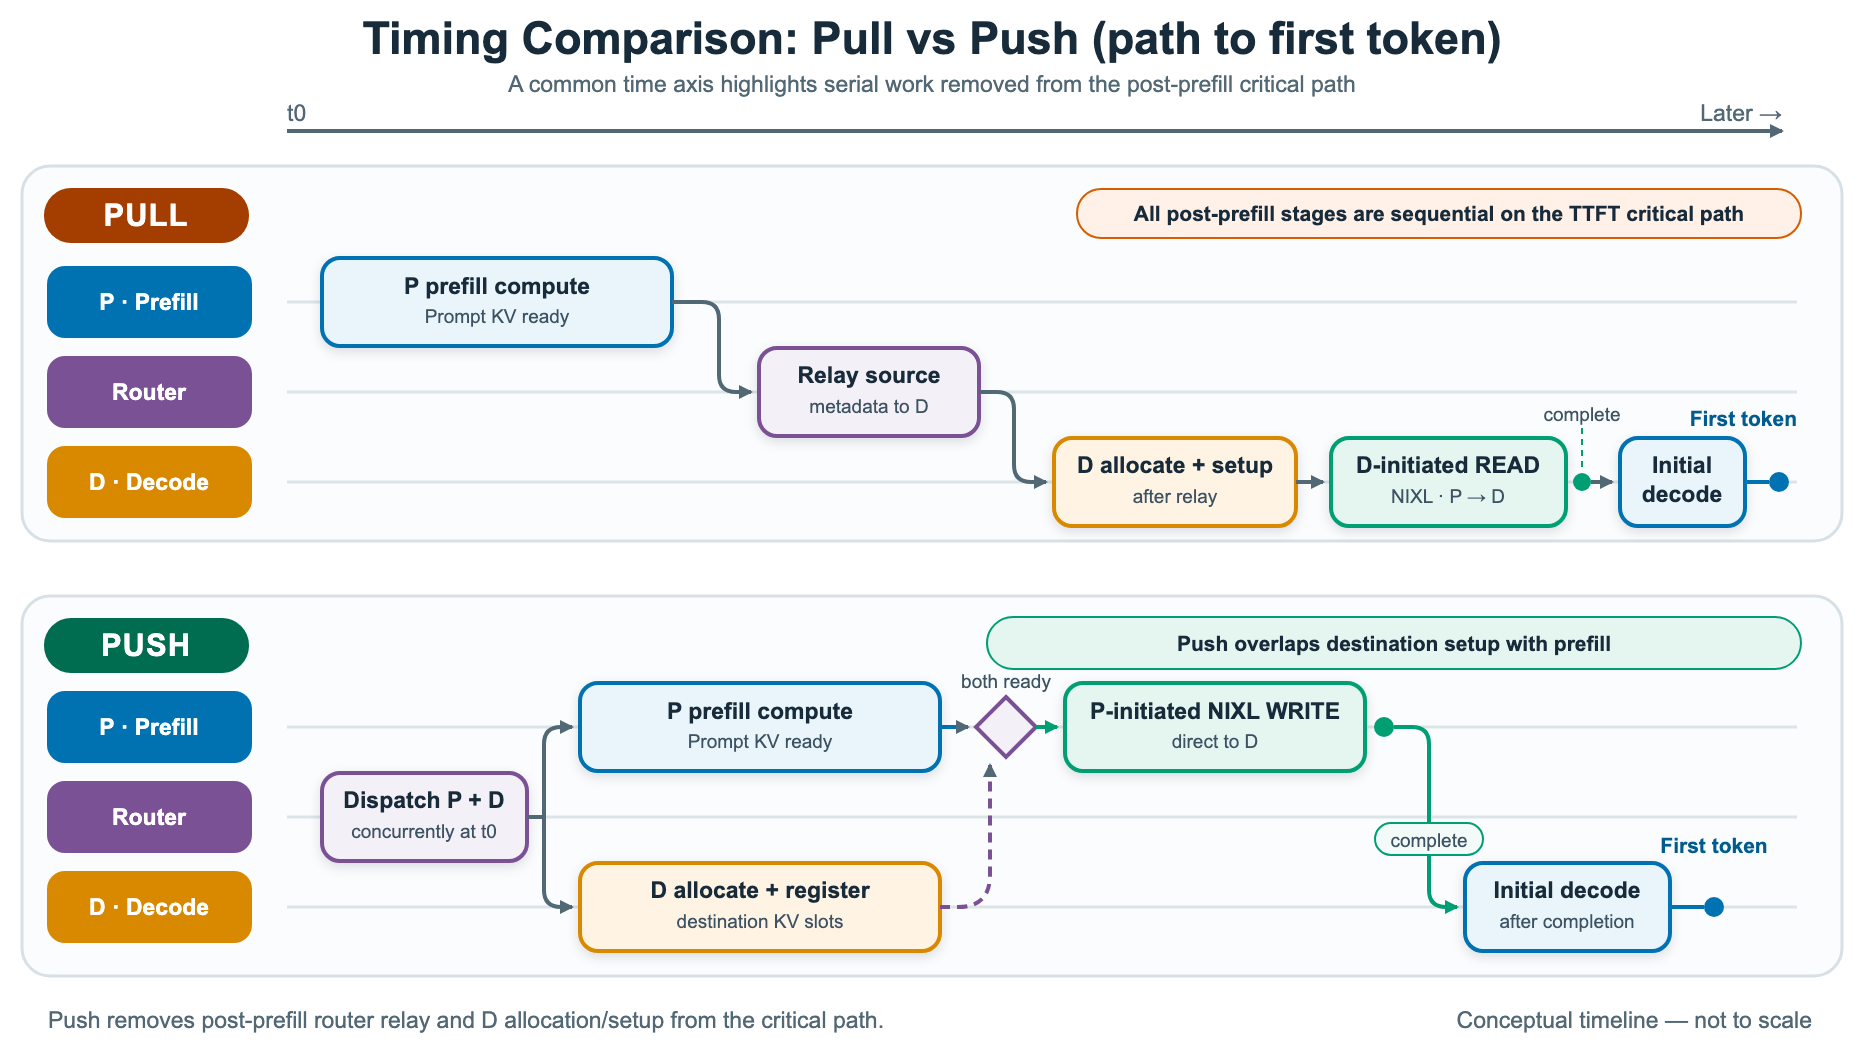
Figura 4: Comparación de los flujos de transferencia push y pull, destacando cómo la transferencia push superpone la configuración del lado de decodificación con el prefill
Los dos modos también implican una compensación de enrutamiento. El modo de extracción permite al router seleccionar una instancia de descodificación una vez finalizada la precarga, lo que proporciona una mayor flexibilidad para gestionar la calidad del servicio y el enrutamiento en función de la carga. El modo push selecciona la instancia de decodificación antes, de modo que la configuración de destino pueda superponerse con la instancia de prellenado. A cambio, con una carga comparable, la instancia de precarga puede liberar sus bloques KV antes, ya que la transferencia comienza tan pronto como el registro de destino y el KV del mensaje
están listos.Datos de rendimiento
Para la evaluación, utilizamos el modelo Qwen3-32B en una implementación 1P1D con instancias P5en de Amazon EC2 conectadas con EFA. Para aislar el rendimiento de las transferencias P→D, configuramos el punto de referencia para inhabilitar el almacenamiento en caché de prefijos con --no-enable-prefix-caching. Esta configuración hace que el nodo de decodificación recupere la caché KV completa del nodo de prellenado para cada solicitud. De lo contrario, las solicitudes superpuestas podrían reutilizar la caché local del nodo de decodificación y omitir la transferencia, lo que generaría resultados
En el siguiente gráfico, se comparan TTFT con transferencias KV push y pull. Realizamos barridos con longitudes de entrada de 1 000 a 16 000 y con tasas de solicitud de 1 a 8 consultas por segundo (QPS). Cuando la carga es baja y las solicitudes son cortas, los dos modos funcionan de forma casi idéntica. A medida que aumentan el QPS y la longitud de entrada, el modo pull se degrada bruscamente y alcanza unos 1.744 ms a 8 QPS y 16 000. El modo push se mantiene mucho más bajo, aproximadamente 540 ms, lo que supone una reducción de alrededor de 3 veces. La brecha aumenta porque el modo pull publica los descriptores NIXL en línea en el procesador de decodificación, de forma sincrónica dentro del ciclo del motor, por lo que el trabajo detiene la generación de los tokens. El modo push lo mueve a un hilo en segundo plano
, fuera de la ruta crítica.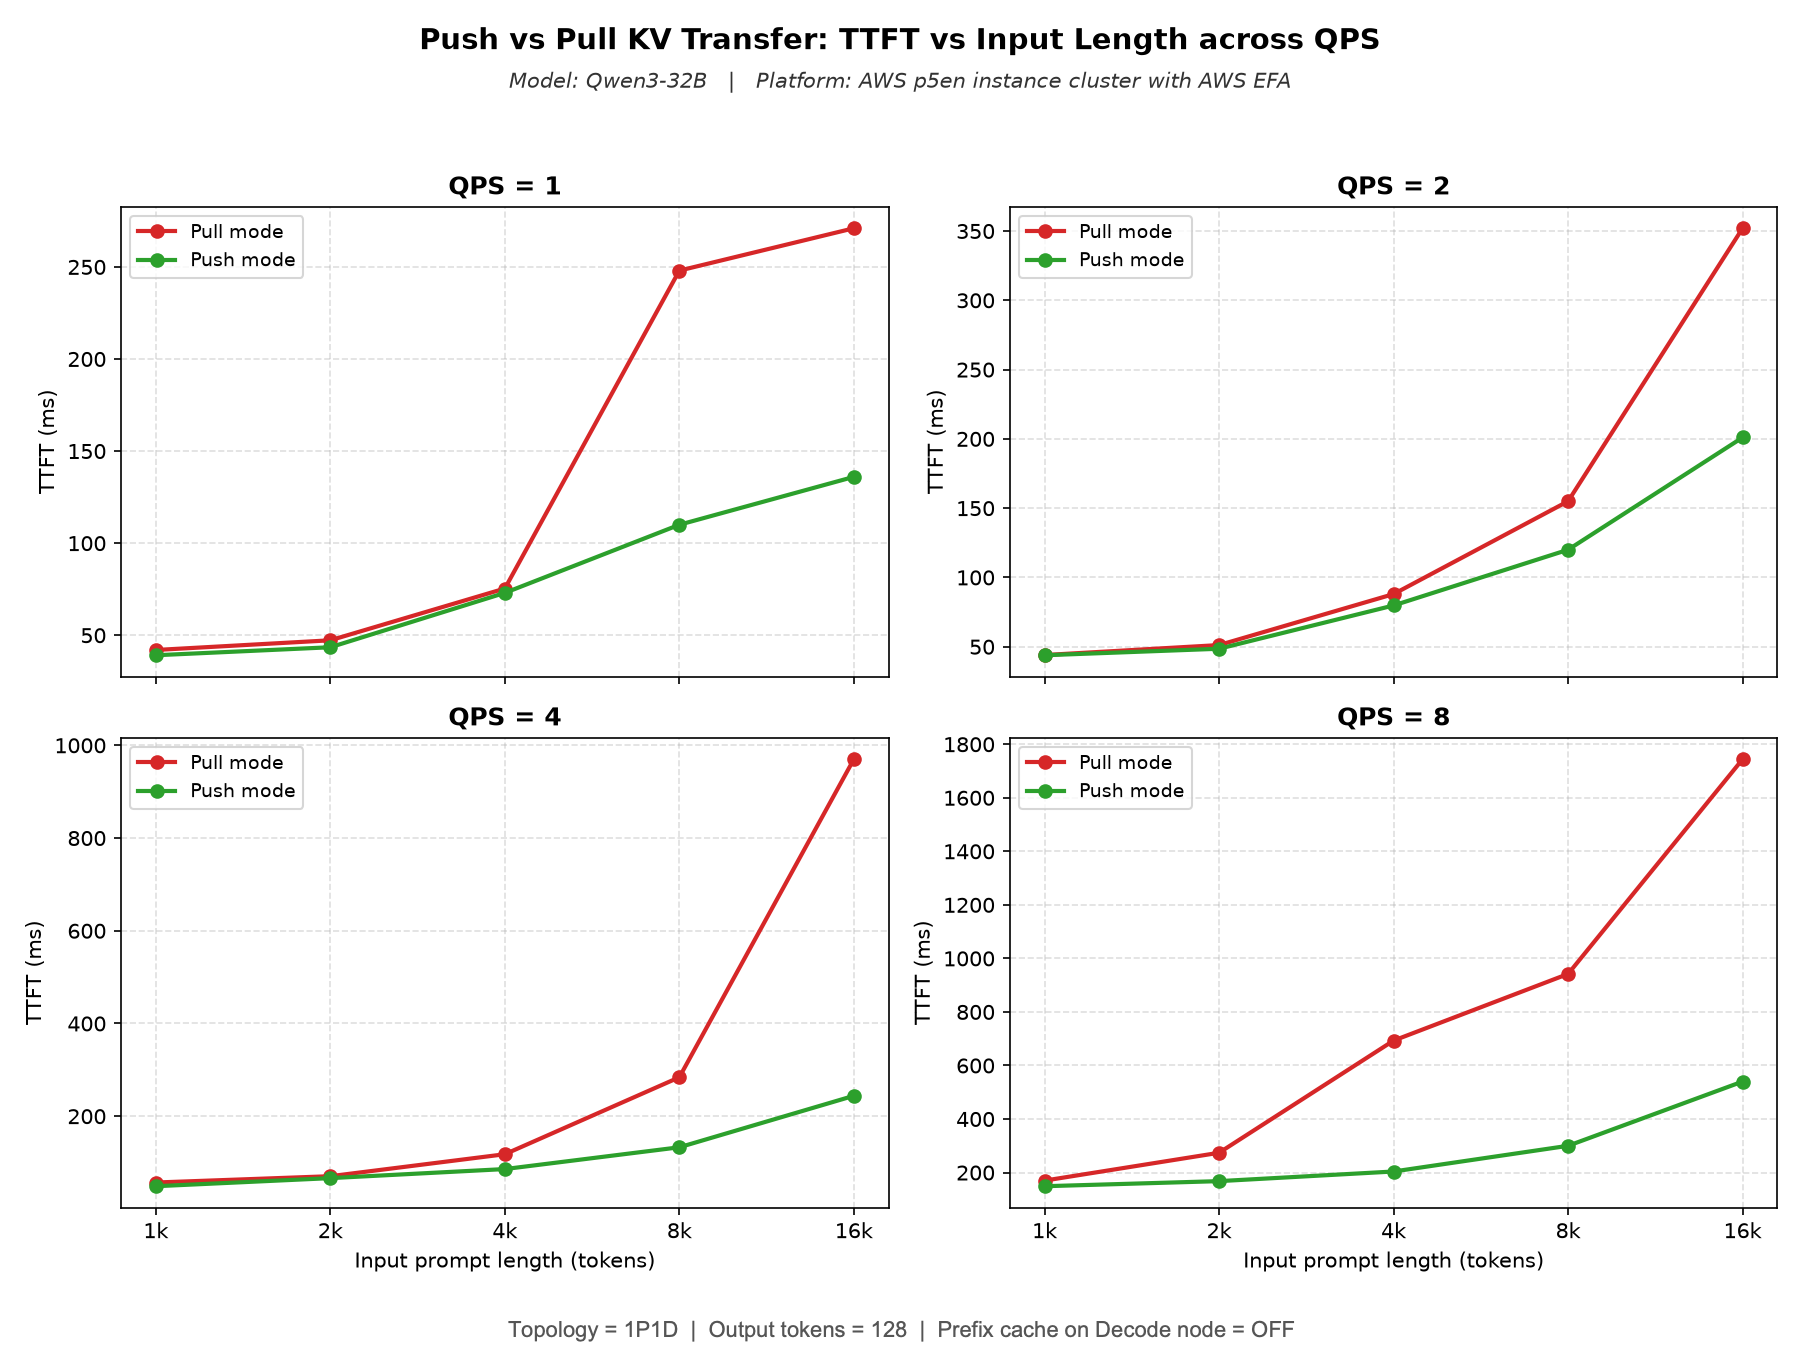
Figura 5: TTFT para transferencia KV push en comparación con pull KV entre longitudes de entrada y tasas de solicitud (topología 1P1D, 128 tokens de salida, almacenamiento en caché de prefijos deshabilitado en el nodo de decodificación)
En este gráfico se muestra el TPOT en las mismas condiciones. El patrón refleja el TTFT. Con cargas ligeras, empujar y tirar están cerca, alrededor de 5,6 a 5,8 ms. A medida que aumentan la longitud de la carga y la entrada, la tracción aumenta a unos 10,4 ms a entre 4 y 8 QPS y 16 K, mientras que el empuje se mantiene cerca de los 7 ms. Esto se debe a que la función push reduce la tarea de preparar los descriptores y transferir el envío de datos por parte del trabajador de descodificación. La generación de tokens no se agota, por lo que la latencia por token se mantiene estable incluso en
contextos prolongados y con alta concurrencia.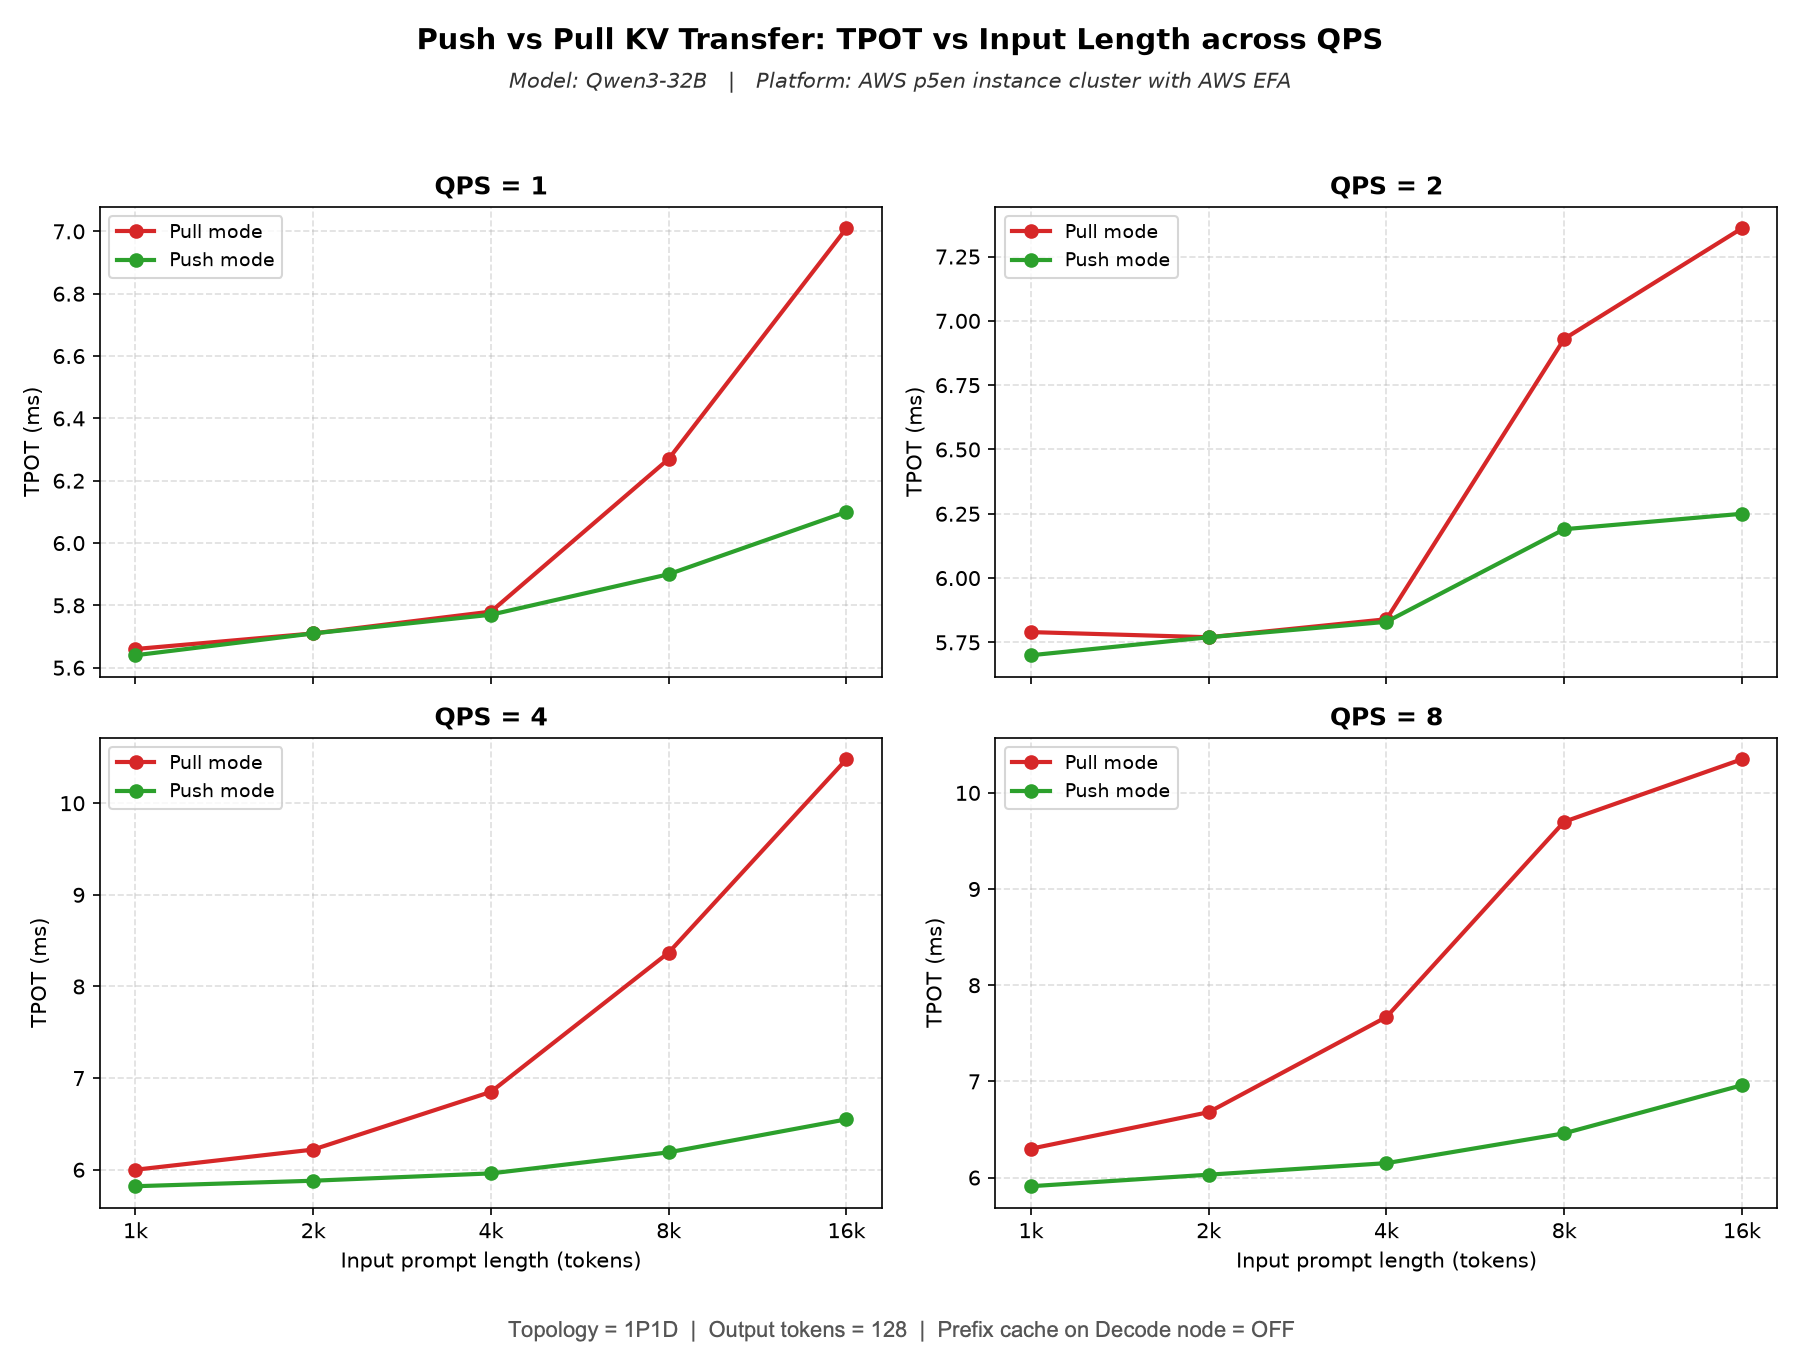
Figura 6: TPOT para transferencia KV push en comparación con pull KV entre longitudes de entrada y tasas de solicitud (topología 1P1D, 128 tokens de salida, almacenamiento en caché de prefijos deshabilitado en el nodo de decodificación)
¿Cómo ejecutar un punto de referencia
Para reproducir nuestra configuración de referencia 1P1D, un nodo de precarga y un nodo de decodificación, utilizando instancias P5en de Amazon EC2 conectadas con EFA, consulte las instrucciones detalladas de la guía Reproducción de nuestros resultados. La guía describe la configuración del entorno, el lanzamiento de los servidores de precarga y descodificación de vLLM, la ejecución del punto de referencia y la recopilación de los resultados. La función se puede ejecutar en otras configuraciones compatibles, pero los resultados de rendimiento variarán según el hardware, el modelo, la carga
de trabajo y la configuración de la red.Conclusión
En este artículo, mostramos cómo el conector KV basado en pulsaciones superpone el cálculo de prellenado con la asignación y el registro de bloques del lado del decodificador, lo que elimina de la ruta crítica la configuración de ida y vuelta del router posterior al prellenado y la transferencia del lado del decodificador. Esto reduce el TTFT y el TPOT, especialmente a altas tasas de solicitud. En nuestra evaluación comparativa Qwen3-32B sobre una implementación 1P1D con instancias P5en de Amazon EC2 conectadas con EFA, el modo push mejoró hasta 3 veces más en TTFT y un 30 por ciento más en TPOT en comparación con el modo pull. Los resultados varían según la carga de trabajo y la configuración.
Para usar el modo push, configure los servidores de prellenado y decodificación para que usen NixlPushConnector en lugar de NixlConnector.
Elija el conector push cuando la selección temprana del nodo de decodificación sea aceptable y la prioridad sea reducir el TTFT. El conector por tracción sigue siendo el más adecuado para las cargas de trabajo que requieren una transferencia KV bidireccional o la selección de instancias de decodificación diferidas hasta que se haya completado previamente el enrutamiento para un enrutamiento compatible con la carga. vLLM admite conectores KV tanto de inserción como de extracción, por lo que puede seleccionar el enfoque que mejor se adapte a su implementación
.Como mejora futura, estamos estudiando la posibilidad de llevar el modelo de subprocesamiento NIXL de fondo al conector en modo extracción, lo que desviaría la configuración de NIXL de la ruta crítica para que las cargas de trabajo en modo extracción puedan beneficiarse de las mismas optimizaciones.
Hemos abierto una solicitud de cambios para explorar esta posibilidad.Recursos relacionados
Agradecimientos
Agradecemos a la comunidad vLLM su apoyo para mantener esta función.