SageMaker Inference ahora admite Multi-Instance GPU para maximizar la utilización de GPU para los puntos finales del modelo
SageMaker Inference now supports Multi-Instance GPU to maximize GPU utilization for model endpoints
Shantanu Tripathi
Cuando despliegas un modelo en un punto de conexión de GPU, la unidad mínima de GPU que puedes solicitar es un acelerador completo.
ml.p4d.24xlarge tiene ocho A100, por lo que puede contener ocho modelos, ya sea que cada uno necesite 40 GB o 14 GB. Segundo, y menos obvio, hace que cada despliegue se reduzca a una elección de qué GPU completa desplegar. A medida que crecen tu concurrencia y las longitudes de los mensajes, una GPU completa en una instancia más antigua deja de ser suficiente, pero una GPU completa en una más nueva es más de lo que tu modelo puede utilizar. Terminas siendo subatendido o pagando por una capacidad que nunca alcanzas.
Hoy en día, Amazon SageMaker Inference admite la partición de GPU, que utiliza NVIDIA Multi-Instance GPU (MIG) para dividir una GPU física en particiones independientes. Cada partición recibe una parte fija de las unidades de cómputo de la GPU y un bloque dedicado de su memoria, con aislamiento aplicado en hardware. Eso cambia ambas restricciones: puedes colocar un modelo diferente en cada partición y puedes elegir una fracción de un acelerador más nuevo en lugar de uno completo de cualquiera de las generaciones.
Esta publicación cubre ambos aspectos. La primera parte es el beneficio directo: desplegar más modelos de los que tienes GPUs, con aislamiento entre ellos. La segunda es la que los clientes preguntan cuando la pregunta se centra en el costo: cómo la granularidad de la partición te ayuda a elegir la unidad del tamaño adecuado y qué medimos cuando lo hicimos.
Una cosa que debes saber antes de seguir leyendo: la partición de GPU funciona en puntos de conexión que utilizan componentes de inferencia, el constructo que usas para desplegar varios modelos en un punto de conexión y establecer la computación que cada modelo recibe. La partición se basa directamente en ello. Una partición es un recurso que un componente solicita, en el mismo lugar donde ya solicita CPU y memoria. Si no has utilizado componentes de inferencia, esta publicación los introduce. Los puntos de conexión de un solo modelo, los puntos de conexión sin servidor y las piscinas de instancias heterogéneas no se pueden particionar.
Qué hacen los clientes hoy en día y por qué cada opción es insuficiente
Si tienes más modelos que aceleradores, has tenido tres opciones.
Ejecutar menos puntos de conexión más grandes y realizar un procesamiento por lotes más intenso – Esto aumenta la utilización, pero solo cuando los modelos son intercambiables. Un portafolio de variantes ajustadas finamente o modelos por inquilino no lo es.
Usar puntos de conexión multi-modelo – Estos cargan y descargan modelos de una GPU compartida según sea necesario, lo que se adapta al tráfico disperso y de ráfagas. Pero los modelos comparten el dispositivo sin aislamiento, por lo que una solicitud pesada para un modelo afecta a los demás. Un modelo que no está cargado también paga una penalización de carga en el primer uso.
Pasar a Kubernetes autoadministrado – Este es el lugar al que han ido los clientes que necesitan una partición de GPU real. MIG funciona allí, pero asumes la versión de controlador, la configuración de partición, un plugin de dispositivo, programación y mantener todo consistente en una flota. Eso es mucho trabajo para una capacidad de hardware que tus instancias ya tienen.
¿Por qué MIG
NVIDIA Multi-Instance GPU (MIG) divide una GPU en hasta siete instancias, dependiendo de la GPU. Cada instancia tiene su propio cómputo, caché, memoria y ancho de banda de memoria. Debido a que la división se realiza en hardware en lugar de software, obtienes garantías que otros métodos de compartición no pueden ofrecer:
Latencia predecible – Cada partición tiene un ancho de banda de memoria dedicado, por lo que un pico de tráfico de un modelo no se muestra en el p99 de otro modelo.
Aislamiento de fallos – Un error de memoria o un bloqueo se mantiene dentro de su partición en lugar de afectar a todos los modelos de la GPU.
Capacidad de tamaño adecuado – Los modelos pequeños y medianos obtienen una porción que se adapta a ellos en lugar de una GPU completa. Puedes mezclar tamaños de porción en un dispositivo.
No hay arranques en frío – Cada modelo mantiene su propia partición y permanece cargado, sin penalización de carga y sin expulsión.
Aislamiento de inquilinos – La protección de memoria entre particiones se aplica en hardware, lo que simplifica las revisiones de seguridad y cumplimiento.
Planificación y cargo confiables – Una partición funciona de la misma manera independientemente de sus vecinos, por lo que las pruebas de carga predicen la producción. El costo de la GPU también se asigna limpiamente a un modelo, equipo o inquilino.
La partición tiene límites que vale la pena conocer de antemano. El número máximo de particiones depende del acelerador y nunca supera los siete. MIG solo permite cambiar el diseño mientras sus particiones están inactivas, y en SageMaker AI eso significa elegir un diseño al crear el punto de conexión. Un modelo que necesita más de una GPU todavía necesita dispositivos completos. Dentro de esos límites, obtienes el aislamiento de GPUs separadas sin dedicar una a cada modelo.
Particionamiento sin el trabajo de la plataforma
Hasta ahora, obtener MIG significaba ejecutar la pila de Kubernetes tú mismo. La partición de GPU en Amazon SageMaker AI elimina ese paso: seleccionas un perfil de partición para tu modelo, y SageMaker AI maneja la configuración de la GPU, la colocación y la escalabilidad. Obtienes compartición de GPU aislada por hardware en un punto de conexión administrado, sin tener que ejecutar la plataforma subyacente.
Salesforce ha sido parte de este trabajo desde el principio, ayudando a definir los requisitos y validando la implementación inicial.
“NVIDIA MIG divide una sola GPU en múltiples instancias aisladas, cada una con recursos de cómputo y memoria dedicados. Salesforce considera que esta es una capacidad importante porque muchas cargas de trabajo de inferencia no requieren una GPU completa. MIG nos permitiría consolidar cargas de trabajo de manera segura, mejorar significativamente la utilización de la GPU, reducir los costos de inferencia y mantener un rendimiento predecible y una fuerte aislación.
Esta capacidad nos ayudaría a escalar la inferencia de AI de manera más eficiente en diferentes casos de uso. Salesforce ha ayudado a definir los requisitos, ha validado la solución inicial. Ahora estamos preparándonos para validar la solución con una carga de trabajo de producción representativa y demostrar una fuerte demanda de los clientes con AWS. Creemos que el soporte de MIG entregará un valor técnico y comercial significativo para los clientes empresariales”
— Richard Chang, Arquitecto de Ingeniería de Software, Salesforce
Cómo funciona
La partición de GPU agrega dos campos opcionales a las llamadas de API que ya realizas. No hay nuevas operaciones de API, no hay nuevos tipos de recursos y no hay nuevas acciones de AWS Identity and Access Management (IAM), y un endpoint que omite ambos campos se comporta exactamente como lo hace hoy.
AcceleratorPartitionLayouts se coloca en una variante de producción en CreateEndpointConfig y declara cómo se divide cada acelerador:
Un A100 tiene siete rebanadas de cómputo para dividir. El diseño anterior utiliza las siete, por lo que cada una de las ocho A100 en la instancia p4d lleva tres particiones y el endpoint proporciona 24, ocho de cada tipo.
La división se aplica de manera uniforme. Una entrada de diseño describe cómo se divide un acelerador, y cada acelerador en cada instancia en la variante se divide de la misma manera. La lista no es posicional, por lo que una entrada no se asigna a una GPU específica.
AcceleratorPartitionType se coloca en un componente de inferencia y selecciona qué partición ejecuta el modelo:
Cada copia del componente ocupa una partición del tipo solicitado. Con ocho particiones de cada tipo en la instancia, aumentar CopyCount coloca copias adicionales en particiones libres. Esto es útil para un modelo pequeño que sirve una alta concurrencia, donde un solo proceso deja la GPU esperando solicitudes.
NumberOfAcceleratorDevicesRequired siempre es 1 aquí. Con un tipo de partición establecido, significa una partición en lugar de un acelerador. NumberOfCpuCoresRequired y MinMemoryRequiredInMb aún describen la CPU del host y la memoria del host, porque la memoria de la GPU proviene del tipo de partición.
La invocación no cambia. InvokeEndpoint dirige un modelo por el nombre del componente de inferencia, y la partición que ocupa nunca aparece en la solicitud.
La partición ocurre mientras el endpoint está aprovisionado. Cuando alcanza InService, cada acelerador se divide y las particiones están vacías, lo que es un estado válido ya que los componentes se colocan en ellos posteriormente. En nuestras pruebas, dividir aceleradores agregó aproximadamente 17 segundos al aprovisionamiento. El resto del tiempo es el lanzamiento habitual de la instancia y la extracción del contenedor.
Perfiles de partición por GPU
Los perfiles disponibles para usted son una propiedad de la GPU, así que comience por averiguar qué GPU lleva su tipo de instancia y búsquelo en perfiles MIG compatibles de NVIDIA, que es la autoridad en el conjunto completo de perfiles y las combinaciones válidas en un dispositivo.
Familia de instancias
Acelerador
Memoria de GPU
Granularidad (cómputo / memoria)
Perfiles de partición disponibles
Máximas particiones por GPU
P4d
NVIDIA A100
40 GB
7 / 8
mig-1g.5gb, mig-1g.10gb (ver nota del controlador), mig-2g.10gb, mig-3g.20gb, mig-4g.20gb, mig-7g.40gb
Lea el nombre del perfil como unidades de cómputo seguidas de memoria de GPU: mig-3g.40gb toma tres unidades de cómputo y 40 GB. La columna de granularidad es lo que limita un diseño. Un A100 y un H100 se dividen en séptimos en cómputo y en octavos en memoria, mientras que G7 se divide en mitades y G7e en cuartos. Los nombres de los perfiles difieren entre GPUs incluso cuando las cuentas de rebanadas coinciden, así que no lleve un diseño de una familia de instancias a otra sin verificarlo contra esta tabla.
Dentro de esos límites, tiene una elección real. En un P4d o P5, puede dividir siete del perfil más pequeño, o dos particiones 3g, o el diseño 4g más 2g más 1g utilizado en el ejemplo anterior, o tomar todo el dispositivo como uno. En un G7e, puede tomar cuatro de los más pequeños, o dos 1g junto a un 2g, o dos 2g, o un dispositivo completo. En un G7, dos particiones o una.
El perfil 3g es el que hay que conocer, porque sus dos dimensiones no coinciden: ocupa tres de las siete unidades de cómputo pero cuatro de las ocho unidades de memoria. Dos de ellas llenan la GPU y nada más cabrá junto a ellas.
La regla de alto nivel: Cada perfil en su diseño debe ser uno que su GPU ofrezca, y las unidades de cómputo y memoria que sus perfiles sumen no deben exceder lo que un dispositivo proporciona. Ambas se verifican al crear la configuración del endpoint, y si alguna de ellas falla, es un rechazo en lugar de un retroceso a un acelerador completo.
Nota del controlador para P4d: mig-1g.10gb requiere un controlador NVIDIA R525 o más nuevo, y la imagen P4d predeterminada envía 470.256.02. Solicítelo en la imagen predeterminada y la partición falla sin un error que nombre el perfil. Establezca InferenceAmiVersion en al2023-ami-sagemaker-inference-gpu-4-1 en la variante de producción para obtener una imagen en la línea de controladores 580, que lo ofrece.
Elección de un diseño para su carga de trabajo
Elegir bien es una pregunta separada de elegir un diseño que sea meramente aceptado. Una partición le proporciona unidades de cómputo y memoria en proporciones fijas, y ambas realizan trabajos diferentes durante la inferencia.
Las unidades de cómputo son lo que necesita para prefill. Prefill lee la solicitud y construye su representación. Esta es la fase intensiva en cómputo, y se escala con los multiprocesadores de transmisión, y por lo tanto con los TFLOPs que su partición contiene. Cuanto más largas sean sus entradas y cuanto más solicitudes lleguen al mismo tiempo, más gobierna la velocidad a la que devuelve el primer token.
Las unidades de memoria son lo que necesita para decode y para capacidad. Generar tokens vuelve a leer los pesos del modelo en cada paso, por lo que decode está limitado por la banda de memoria en lugar de por las matemáticas, y la memoria también limita cuánta caché KV puede contener. Ese límite, a su vez, establece la longitud de contexto que puede servir y cuántas secuencias puede servir de forma concurrente.
Casi ninguna carga de trabajo real ejercita solo una de estas, por lo que el objetivo no es elegir una dimensión sino elegir una combinación que admita su caso de uso. Elija un perfil cuyas proporciones cubran su fase más pesada mientras deja que la otra esté adecuadamente servida. En el lado de cómputo, lo que importa es la longitud de sus solicitudes y cuántas llegan al mismo tiempo. En el lado de memoria, es la longitud de su salida, su ventana de contexto y su concurrencia.
La memoria es la más fácil de subestimar de las dos, porque una partición debe contener tres cosas y no solo el modelo: los pesos, que para un modelo de 8B en FP16 son de aproximadamente 16 GB. La caché KV, dimensionada según la longitud del contexto y la cantidad de secuencias concurrentes que se pretenden permitir, que es el término que la gente omite y que crece con el tráfico. Y 1-2 GB de sobrecarga de tiempo de ejecución para el contexto CUDA y el proceso de servicio. Suma esos antes de elegir un perfil, porque una partición dimensionada solo para los pesos cargará el modelo y luego fallará bajo carga, o servirá silenciosamente un contexto mucho más corto de lo que se configuró. Para un punto de referencia concreto, ese mismo modelo de 8B en FP16 sirve cómodamente un contexto de 8,000 tokens en una partición de 40 GB.
Donde MIG agrega el mayor valor
Un portafolio de modelos pequeños y medianos – El caso directo. Variantes ajustadas, modelos de incrustación, rerankers y clasificadores que cada uno deja la mayor parte de un acelerador sin utilizar ahora comparten uno.
Servicio de modelos multi-inquilino – Cuando hospeda un modelo por cliente, MIG le da un límite de hardware entre ellos: un proceso en una partición no puede leer la memoria de otra partición ni tomar su rendimiento. Sin embargo, delimite la afirmación con precisión. Los modelos en la misma instancia aún comparten la CPU del host, la memoria del sistema, el almacenamiento, la red y la ruta de enrutamiento de endpoint, por lo que la particionación es un mecanismo de aislamiento para la GPU y no un límite de inquilinato completo.
Tuberías multi-etapa en una instancia – Un modelo de transcripción, un modelo de diarización y un modelo de lenguaje, o un incrustador, un reranker y un generador. Cada etapa es un componente separadamente direccionable en su propia partición, y un salto de red entre etapas desaparece.
Un modelo pequeño en la ruta de la solicitud – Un clasificador de seguridad o modelo de guardrail que debe ejecutarse en cada solicitud pero no puede justificar un acelerador, con latencia predecible porque no está compartiendo tiempo con el modelo principal.
Desafiantes y canarios – Ejecute un modelo candidato en una partición pequeña junto al modelo que sirve tráfico de producción en lugar de configurar un segundo endpoint.
Rendimiento: Una rebanada de una GPU más nueva contra una más antigua completa
Además del empaquetado de binarios, el otro beneficio que obtienes es granularidad en GPUs de alta gama: más opciones de GPU para implementar un modelo y la elección de cuál es tuya. Cada acelerador compatible se convierte en varios tamaños en lugar de uno, por lo que la forma práctica de pensar en ello es que cada perfil es una opción de GPU por derecho propio, junto con los aceleradores completos que ya elijes. Eso importa más cuando consideras un tipo de instancia más grande o más nuevo, porque moverse hacia arriba deja de ser todo o nada: puedes tomar tanto o tan poco de esa GPU más grande como necesite tu carga de trabajo, en cualquiera de los tamaños que publique, en lugar de pagar por el acelerador completo.
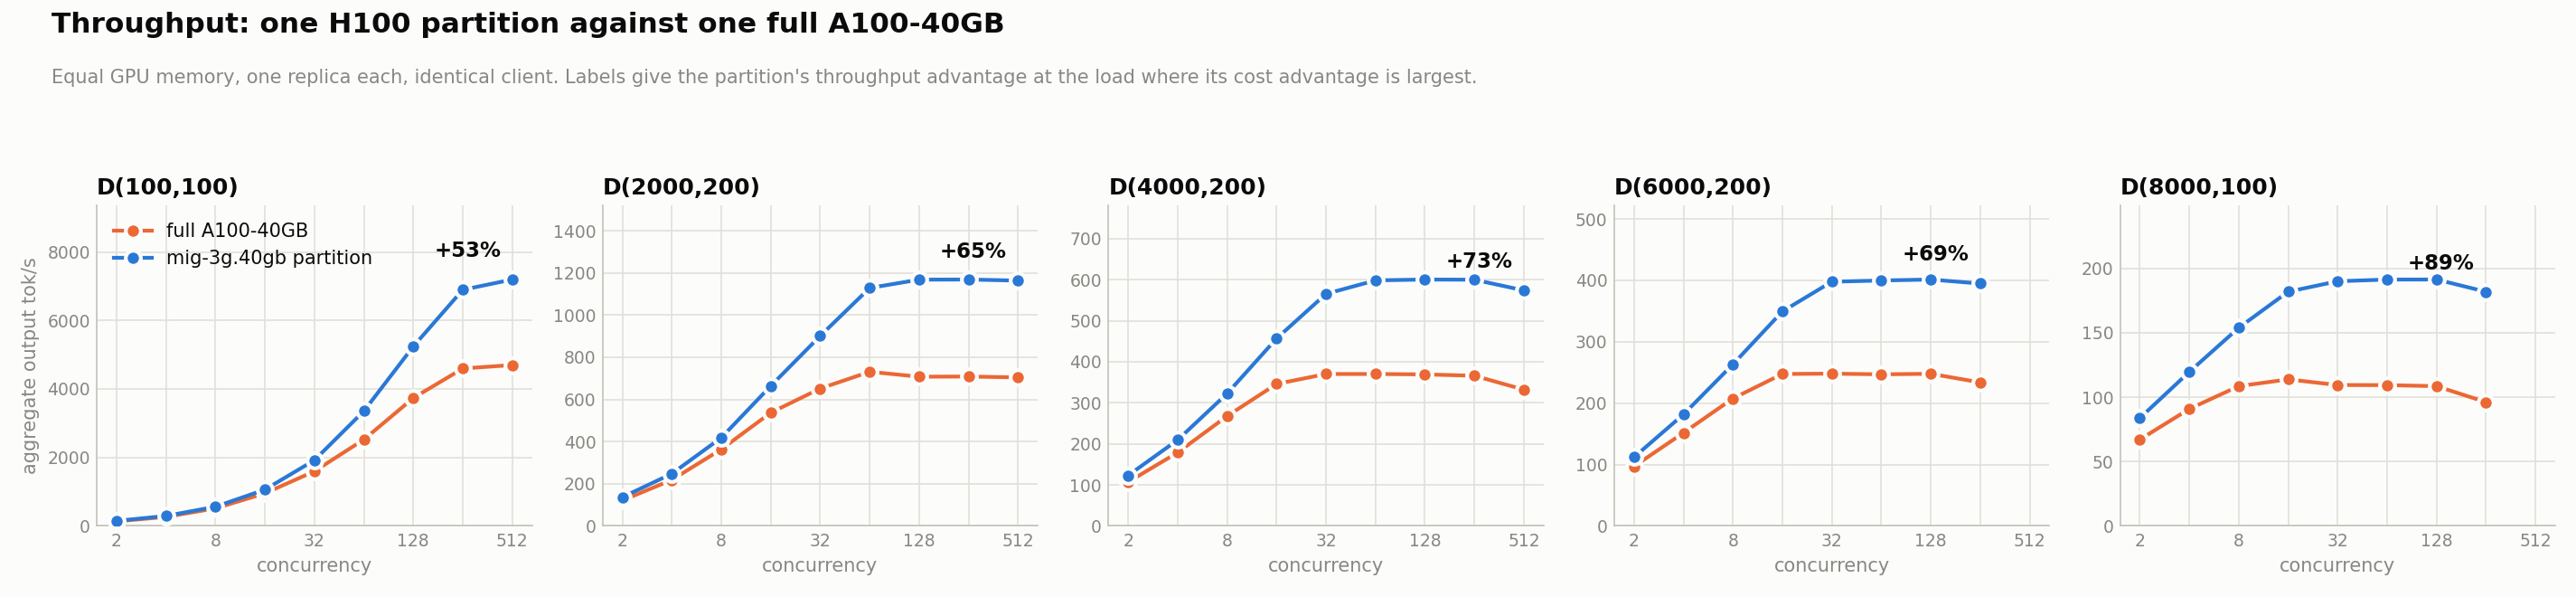
Para ver si eso compensa, comparamos una partición mig-3g.40gb de un H100 con un A100-40GB completo y sin particionar. Los dos tienen memoria de GPU comparable, lo que lo hace una forma limpia de ver cuán poderosa puede ser una porción de una instancia más avanzada.
Usamos genai-bench para generar carga, conduciendo ambos endpoints desde el mismo cliente para que la GPU sea la única variable. Ambos lados ejecutaron Llama-3.1-8B-Instruct en endpoints de SageMaker en tiempo real, una réplica de modelo cada uno, con una imagen de contenedor idéntica, tokenizador y configuración de cliente. Ambos se invocaron a través de la ruta compatible con OpenAI nativa de SageMaker AI. Barrimos cinco formas de tráfico, escritas D(tokens de entrada, tokens de salida) y que van desde prompts cortos hasta resúmenes de contexto largo, cada uno a través de una escalera de concurrencia de 2 a 512.
Figura 1: Tokens de salida agregados por segundo para una partición mig-3g.40gb de un H100 contra un A100-40GB completo, en cinco formas de tráfico y una escalera de concurrencia de 2 a 512
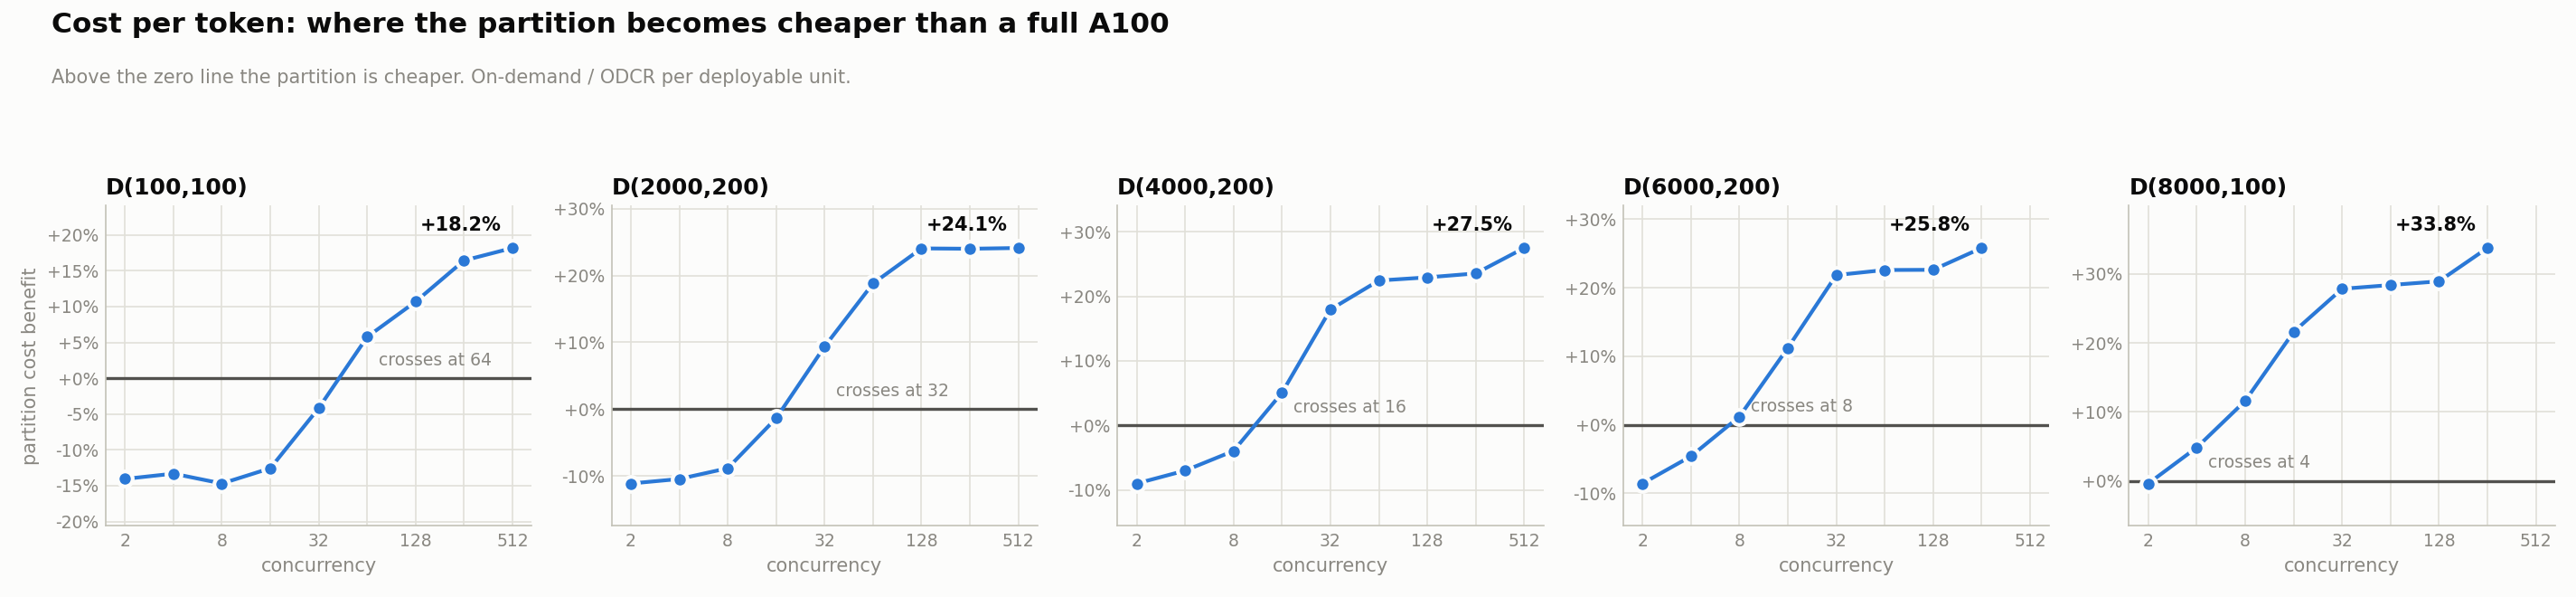
Figura 2: Beneficio de costo de partición por millón de tokens de salida contra concurrencia para las mismas cinco formas de tráfico
Cuatro cosas destacan.
La partición es más rápida en todas partes – Entregó más tokens de salida por segundo en cada escenario y en cada concurrencia, en un 53 por ciento a 89 por ciento en la carga donde el beneficio de costo de cada escenario es más grande, y una latencia entre tokens más baja en cada uno, en un 8,9 por ciento a 42,1 por ciento. La brecha se amplía con la carga.
El tiempo hasta el primer token es más bajo en cada caso, en un 5,6 por ciento a 47,5 por ciento.
En cuanto al costo, es un 18-34 por ciento más barato por millón de tokens de salida, por encima de un punto de equilibrio que se mueve antes a medida que se alargan las solicitudes. Concurrency 64 para solicitudes de 100 tokens, 4 para solicitudes de 8.000 tokens. Debajo del punto de equilibrio, toda la unidad A100 es la unidad más barata. Estos precios son todos bajo demanda, que en el momento del análisis se midieron en $25,251286 por hora para un ml.p4d.24xlarge y $63,296000 por hora para un ml.p5.48xlarge en la región de AWS US West (Oregon). Puramente para nuestro propio análisis, derivamos el costo unitario dividiendo el costo de la instancia completa por la cantidad de unidades en ella: 8 en el p4d y 16 en el p5, donde nuestra partición es la mitad de una GPU.
En la parte superior de la escala en tráfico de contexto largo, el A100 dejó de servir. En las cargas de trabajo de 6.000 y 8.000 tokens, falló un tercio a la mitad de sus solicitudes contra un plazo de servidor, mientras que la partición no falló ninguna. Es por eso que esos dos paneles terminan antes que el resto.
Trate esto como una comparación caso por caso, no como un veredicto. El modelo mental útil es considerar las fracciones de GPU disponibles como tipos de GPU en sí mismos. Enumérelos junto con los aceleradores completos, determine qué exige su tráfico de cómputo y memoria, y compárelos en su propia carga de trabajo. Para tráfico de alta concurrencia y entrada larga, la partición ganó en rendimiento y costo aquí. Para cargas de trabajo de entrada corta o baja concurrencia, la unidad A100 completa siguió siendo más barata. La partición no es una respuesta de un tamaño que se adapte a todos. Le da más tamaños para elegir, para que pueda elegir el que se adapte a su carga de trabajo.
Qué saber antes de comprometerse con un diseño
La partición cambia la forma de un endpoint, y algunas propiedades valen la pena entender antes de diseñar uno.
El tipo de partición de un componente es fijo durante la vida de ese componente. Mover un modelo a un perfil diferente significa crear un nuevo componente. Cambiar la configuración del endpoint significa un nuevo endpoint y una migración de tráfico, porque actualizar la configuración de un endpoint no recorta los hosts que ya están en ejecución. Esto hace que la partición sea una buena opción para un portafolio estable y una mala para una mezcla que se reorganiza diariamente.
Un perfil solicitado debe existir en el diseño del endpoint. No hay fallback a un acelerador completo, por lo que un componente que solicita un perfil que la variante no declaró es rechazado.
La partición se aplica a la inferencia en tiempo real en los puntos finales de los componentes de inferencia. Los puntos finales sin servidor y las piscinas de instancias heterogéneas no están soportados, y la invocación asíncrona no puede dirigirse a un componente de inferencia, por lo que las cargas de trabajo asíncronas están fuera del alcance.
Se le factura por la instancia de GPU completa, como hoy en día. La partición aumenta la cantidad de esa instancia que puede utilizar. No cambia su precio por hora.
Finalmente, un modelo que realmente necesita un acelerador completo, o más de uno, debe seguir teniendo uno. Ninguna partición abarca aceleradores.
Instancias y regiones soportadas
La partición de GPU está disponible en las familias de instancias P4d, P5, G7 y G7e. El soporte es a nivel de familia, por lo que los tamaños más pequeños dentro de una familia están cubiertos.
Está disponible en las siguientes regiones de AWS: Este de EE. UU. (N. Virginia), Este de EE. UU. (Ohio), Oeste de EE. UU. (Oregón), Asia Pacífico (Singapur), Asia Pacífico (Tokio), Europa (Fráncfort) y Europa (Irlanda).
La disponibilidad de instancias varía según la región, así que confirme que el tipo de instancia que ha elegido se ofrece en su región y que tiene cuota de uso de punto final para ella.
Introducción
Para particionar un punto final de GPU, calcule la memoria y el cómputo que cada uno de sus modelos necesita, elija los perfiles que se ajusten, declare un diseño en la configuración de su punto final y despliegue cada modelo como un componente de inferencia que solicita un perfil de ese diseño. Nada cambia en la forma en que invoca sus modelos.
Para la referencia de la API, las tablas de perfiles completas para cada familia de instancias y una guía paso a paso, consulte partición de GPU en la Guía de desarrollo de AI de Amazon SageMaker.
El cambio más amplio vale la pena tener en cuenta al planificar la capacidad. Cada acelerador soportado es ahora varios tamaños en lugar de uno. Si una partición de una GPU más nueva o un acelerador completo de una más antigua es la unidad adecuada para un modelo determinado, ya no es una pregunta que deba responder redondeando. Es una que puede medir.
Acerca de los autores
When you deploy a model to a GPU endpoint, the smallest unit of GPU you can request is one whole accelerator.
This constraint can cost you twice. First, you can’t host more models on an instance than it has accelerators. An ml.p4d.24xlarge has eight A100s, so it holds eight models, whether each one needs 40 GB or 14 GB. Second, and less obvious, it makes every deployment come down to a choice of which full GPU to deploy to. As your concurrency and prompt lengths grow, a full GPU on an older instance stops being enough, but a full GPU on a newer one is more than your model can use. You end up either under-served or paying for capability you never reach.
Today, Amazon SageMaker Inference supports GPU partitioning, which uses NVIDIA Multi-Instance GPU (MIG) to divide a physical GPU into independent partitions. Each partition receives a fixed share of the GPU’s compute units and a dedicated block of its memory, with isolation enforced in hardware. That changes both constraints: you can place a different model in each partition, and you can choose a fraction of a newer accelerator instead of a whole one of either generation.
This post covers both. The first part is the direct benefit: deploy more models than you have GPUs, with isolation between them. The second is the one customers ask about when the question turns to cost: how the granularity of partitioning helps you pick the right-sized unit, and what we measured when we did.
One thing to know before you read further: GPU partitioning works on endpoints that use inference components, the construct you use to deploy several models to one endpoint and set the compute each model gets. Partitioning builds directly on it. A partition is a resource a component asks for, in the same place it already asks for CPU and memory. If you haven’t used inference components, this post introduces them. Single-model endpoints, serverless endpoints, and heterogeneous instance pools cannot be partitioned.
What customers do today, and why each option falls short
If you have more models than accelerators, you have had three choices.
Run fewer, larger endpoints and batch harder – This raises utilization, but only when the models are interchangeable. A portfolio of fine-tuned variants or per-tenant models is not.
Use multi-model endpoints – These load and unload models from a shared GPU on demand, which fits sparse, bursty traffic. But models share the device without isolation, so a heavy request for one model affects the others. A model that isn’t loaded also pays a load penalty on first use.
Move to self-managed Kubernetes – This is where customers who need real GPU partitioning have gone. MIG works there, but you take on driver versioning, partition configuration, a device plugin, scheduling, and keeping it all consistent across a fleet. That’s a lot of work for a hardware capability your instances already have.
Why MIG
NVIDIA Multi-Instance GPU (MIG) splits one GPU into as many as seven instances, depending on the GPU. Each instance has its own compute, cache, memory and memory bandwidth. Because the split is in hardware rather than software, you get guarantees that other sharing methods can’t give:
Predictable latency – Each partition has dedicated memory bandwidth, so one model’s traffic spike doesn’t show up in another model’s p99.
Fault isolation – A crash or memory error stays inside its partition instead of taking down every model on the GPU.
Right-sized capacity – Small and mid-sized models get a slice that fits them instead of a whole GPU. You can mix slice sizes on one device.
No cold starts – Every model keeps its own partition and stays loaded, with no load penalty and no eviction.
Tenant isolation – Memory protection between partitions is enforced in hardware, which makes security and compliance reviews simpler.
Reliable planning and chargeback – A partition performs the same way regardless of its neighbors, so load tests predict production. GPU cost also maps cleanly to a model, team or tenant.
Partitioning has boundaries worth knowing up front. The maximum number of partitions depends on the accelerator and never exceeds seven. MIG itself only allows a layout to change while its partitions are idle, and on SageMaker AI that means choosing a layout when you create the endpoint. A model that needs more than one GPU still needs whole devices. Within those boundaries, you get the isolation of separate GPUs without dedicating one to each model.
Partitioning without the platform work
Until now, getting MIG meant running the Kubernetes stack yourself. GPU partitioning on Amazon SageMaker AI removes that step: you pick a partition profile for your model, and SageMaker AI handles GPU configuration, placement and scaling. You get hardware-isolated GPU sharing on a managed endpoint, without having to run the platform underneath it.
Salesforce has been part of this work from the start, helping define the requirements and validating the initial implementation.
“NVIDIA MIG partitions a single GPU into multiple isolated instances, each with dedicated compute and memory resources. Salesforce sees this as an important capability because many inference workloads do not require an entire GPU. MIG would allow us to consolidate workloads safely, significantly improve GPU utilization, reduce inference costs, and maintain predictable performance and strong isolation.
This capability would help us scale AI Inference more efficiently across different use cases. Salesforce has helped define requirements, validated the initial solution. We are now preparing to validate the solution with representative production workload and demonstrate strong customer demand with AWS. We believe MIG support would deliver meaningful technical and business value for enterprise customers.”
— Richard Chang, Software Engineering Architect, Salesforce
How it works
GPU partitioning adds two optional fields to API calls you already make. There are no new API operations, no new resource types, and no new AWS Identity and Access Management (IAM) actions, and an endpoint that omits both fields behaves exactly as it does today.
AcceleratorPartitionLayouts goes on a production variant in CreateEndpointConfig and declares how each accelerator is divided:
An A100 has seven compute slices to divide. The preceding layout uses all seven, so each of the eight A100s on the p4d instance carries three partitions and the endpoint provides 24, eight of each type.
The carve applies uniformly. One layout entry describes how one accelerator is divided, and every accelerator on every instance in the variant is divided the same way. The list isn’t positional, so an entry doesn’t map to a specific GPU.
AcceleratorPartitionType goes on an inference component and selects which partition the model runs on:
Each component copy occupies one partition of the requested type. With eight partitions of each type on the instance, raising CopyCount places additional copies on free partitions. This is useful for a small model serving high concurrency, where a single process leaves the GPU waiting on requests.
NumberOfAcceleratorDevicesRequired is always 1 here. With a partition type set it means one partition rather than one accelerator. NumberOfCpuCoresRequired and MinMemoryRequiredInMb still describe host CPU and host memory, because GPU memory comes from the partition type.
Invocation doesn’t change. InvokeEndpoint addresses a model by inference component name, and the partition it occupies never appears in the request.
Partitioning happens while the endpoint is provisioned. When it reaches InService every accelerator is carved and the partitions are empty, which is a valid state as components land on them afterward. In our testing, carving accelerators added roughly 17 seconds to provisioning. The rest of the time is the usual instance launch and container pull.
Partition profiles by GPU
The profiles available to you are a property of the GPU, so start by finding out which GPU your instance type carries and look it up in NVIDIA’s supported MIG profiles, which is the authority on the full profile set and the combinations valid on one device.
Instance family
Accelerator
GPU memory
Granularity (compute / memory)
Available partition profiles
Max partitions per GPU
P4d
NVIDIA A100
40 GB
7 / 8
mig-1g.5gb, mig-1g.10gb (see driver note), mig-2g.10gb, mig-3g.20gb, mig-4g.20gb, mig-7g.40gb
Read the profile name as compute units followed by GPU memory: mig-3g.40gb takes three compute units and 40 GB. The granularity column is what limits a layout. An A100 and an H100 divide into sevenths on compute and eighths on memory, while G7 divides into halves and G7e into quarters. Profile names differ between GPUs even where the slice counts match, so don’t carry a layout from one instance family to another without checking it against this table.
Within those limits you have real choice. On a P4d or P5 you can carve seven of the smallest profile, or two 3g partitions, or the 4g plus 2g plus 1g layout used in the earlier example, or take the whole device as one. On a G7e you can take four of the smallest, or two 1g beside a 2g, or two 2g, or one whole device. On a G7, either two partitions or one.
The 3g profile is the one to know, because its two dimensions don’t match: it takes three of the seven compute units but four of the eight memory units. Two of them fill the GPU and nothing else will fit beside them.
The high-level rule: Every profile in your layout must be one your GPU offers, and the compute and memory units your profiles add up to must not exceed what one device provides. Both are checked when you create the endpoint configuration, and either one failing is a rejection rather than a fallback to a whole accelerator.
Driver note for P4d: mig-1g.10gb requires an R525 or newer NVIDIA driver, and the default P4d image ships 470.256.02. Request it on the default image and the carve fails without an error naming the profile. Set InferenceAmiVersion to al2023-ami-sagemaker-inference-gpu-4-1 on the production variant to get an image on the 580 driver line, which offers it.
Choosing a layout for your workload
Choosing well is a separate question from choosing a layout that is merely accepted. A partition hands you compute and memory in fixed proportions, and the two do different jobs during inference.
Compute units are what you need for prefill. Prefill reads the prompt and builds its representation. This is the compute-heavy phase, and it scales with the streaming multiprocessors, and so the TFLOPs, your partition holds. The longer your inputs and the more prompts arriving at once, the more it governs how quickly you return a first token.
Memory units are what you need for decode and for capacity. Generating tokens re-reads the model weights on every step, so decode is bounded by memory bandwidth rather than by math, and memory also caps how much KV cache you can hold. That cap in turn sets the context length you can serve and how many sequences you can serve concurrently.
Almost no real workload exercises only one of these, so the goal isn’t to pick a dimension but to choose a combination that supports your use case. Choose a profile whose proportions cover your heaviest phase while leaving the other adequately served. On the compute side, what matters is how long your prompts are and how many arrive at once. On the memory side, it’s your output length, your context window, and your concurrency.
Memory is the easier of the two to underestimate, because a partition has to hold three things and not just the model: the weights, which for an 8B model at FP16 are about 16 GB. The KV cache, sized for the context length and the number of concurrent sequences you intend to allow, which is the term people leave out and the one that grows with traffic. And 1–2 GB of runtime overhead for the CUDA context and the serving process. Add those up before choosing a profile, because a partition sized to the weights alone will load the model and then fail under load, or quietly serve a much shorter context than you configured. For a concrete reference point, that same 8B model at FP16 comfortably serves an 8,000-token context on a 40 GB partition.
Where MIG adds the most value
A portfolio of small and mid-size models – The direct case. Fine-tuned variants, embedding models, rerankers, and classifiers that each leave most of an accelerator unused now share one.
Multi-tenant model serving – When you host a model per customer, MIG gives you a hardware boundary between them: a process in one partition can’t read another partition’s memory or take its throughput. Scope the claim accurately, though. Models on the same instance still share host CPU, system memory, storage, networking, and endpoint routing, so partitioning is an isolation mechanism for the GPU and not a complete tenancy boundary.
Multi-stage pipelines on one instance – A transcription model, a diarization model, and a language model, or an embedder, a reranker, and a generator. Each stage is a separately addressable component on its own partition, and a network hop between stages disappears.
A small model in the request path – A safety classifier or guardrail model that has to run on every request but cannot justify an accelerator, with predictable latency because it isn’t time-slicing against the main model.
Challengers and canaries – Run a candidate model on a small partition beside the model serving production traffic instead of standing up a second endpoint.
Performance: A slice of a newer GPU against a whole older one
In addition to bin-packing, the other benefit you get is granularity on high-end GPUs: more GPU options to deploy a model onto, and the choice of which one is yours. Every supported accelerator becomes several sizes rather than one, so the practical way to think about it is that each profile is a GPU option in its own right, sitting alongside the whole accelerators you already choose between. That matters most when you are considering a larger or newer instance type, because moving up stops being all-or-nothing: you can take as much or as little of that bigger GPU as your workload needs, at any of the sizes it publishes, instead of paying for the whole accelerator.
To see whether that pays off, we compared one mig-3g.40gb partition of an H100 against one whole, uncarved A100-40GB. The two have comparable GPU memory, which makes it a clean way to see how powerful a slice of a more advanced instance can be.
We used genai-bench to generate load, driving both endpoints from the same client so the GPU is the only variable. Both sides ran Llama-3.1-8B-Instruct on production SageMaker real-time endpoints, one model replica each, with an identical container image, tokenizer, and client configuration. Both were invoked through the SageMaker AI native OpenAI-compatible route. We swept five traffic shapes, written D(input tokens, output tokens) and ranging from short prompts to long-context summarization, each across a concurrency ladder from 2 to 512.
Figure 1: Aggregate output tokens per second for one mig-3g.40gb partition of an H100 against one full A100-40GB, across five traffic shapes and a concurrency ladder from 2 to 512
Figure 2: Partition cost benefit per million output tokens against concurrency for the same five traffic shapes
Four things stand out.
The partition is faster everywhere – It delivered more output tokens per second in every scenario at every concurrency, by 53 percent to 89 percent at the load where each scenario’s cost benefit is largest, and lower inter-token latency in every one too, by 8.9 percent to 42.1 percent. The gap widens with load.
Time to first token is lower in every case, by 5.6 percent to 47.5 percent.
On cost it’s 18–34 percent cheaper per million output tokens, above a crossover that moves earlier as prompts lengthen. Concurrency 64 for 100-token prompts, 4 for 8,000-token prompts. Below the crossover the whole A100 is the cheaper unit. These prices are all on-demand, which at the time of analysis were measured as $25.251286 per hour for an ml.p4d.24xlarge and $63.296000 per hour for an ml.p5.48xlarge in the US West (Oregon) AWS Region. Purely for our own analysis, we derived the unit cost by dividing the whole-instance cost by the number of units on it: 8 on the p4d, and 16 on the p5, where our partition is half of a GPU.
At the top of the ladder on long-context traffic, the A100 stopped serving. On both the 6,000- and 8,000-token workloads it failed a third to a half of its requests against a serving-path deadline, while the partition failed none. That is why those two panels end earlier than the rest.
Treat this as a case-by-case comparison, not a verdict. The useful mental model is to regard the available GPU fractions as GPU types in their own right. List them alongside whole accelerators, work out what your traffic actually demands of compute and of memory, and compare them on your own workload. For high-concurrency, long-input traffic the partition won on both performance and cost here. For short-input or low-concurrency workloads the whole A100 remained cheaper. Partitioning isn’t a one-size-fits-all answer. It gives you more sizes to choose from, so you can pick the one that fits your workload.
What to know before you commit to a layout
Partitioning changes the shape of an endpoint, and a few properties are worth understanding before you design one.
A component’s partition type is fixed for the life of that component. Moving a model to a different profile means creating a new component. Changing the endpoint’s carve means a new endpoint and a traffic migration, because updating an endpoint configuration doesn’t re-carve hosts that are already running. This makes partitioning a good fit for a stable portfolio and a poor one for a mix you reshuffle daily.
A requested profile has to exist in the endpoint’s layout. There is no fallback to a whole accelerator, so a component asking for a profile the variant didn’t declare is rejected.
Partitioning applies to real-time inference on inference component endpoints. Serverless endpoints and heterogeneous instance pools aren’t supported, and asynchronous invocation cannot address an inference component, so async workloads are out of scope.
You’re billed for the full GPU instance, as you are today. Partitioning raises how much of that instance you can use. It doesn’t change its hourly price.
Finally, a model that genuinely needs a full accelerator, or more than one, should keep having one. No partition spans accelerators.
Supported instances and Regions
GPU partitioning is available on the P4d, P5, G7, and G7e instance families. Support is at the family level, so smaller sizes within a family are covered.
It’s available in the following AWS Regions: US East (N. Virginia), US East (Ohio), US West (Oregon), Asia Pacific (Singapore), Asia Pacific (Tokyo), Europe (Frankfurt), and Europe (Ireland).
Instance availability varies by Region, so confirm that your chosen instance type is offered in your Region and that you have endpoint usage quota for it.
Getting started
To partition a GPU endpoint, work out the memory and compute each of your model’s needs, pick the profiles that fit, declare a layout on your endpoint configuration, and deploy each model as an inference component that requests a profile from that layout. Nothing about how you invoke your models changes.
For the API reference, the full profile tables for each instance family, and a step-by-step walkthrough, see GPU partitioning in the Amazon SageMaker AI Developer Guide.
To try it yourself, run the GPU partitioning sample notebook, which deploys several models onto partitions of a single GPU endpoint.
The broader change is worth keeping in mind as you plan capacity. Every supported accelerator is now several sizes rather than one. Whether a partition of a newer GPU or a whole accelerator of an older one is the right unit for a given model is no longer a question you need to answer by rounding up. It’s one you can measure.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.