Servidor MCP sin servidor para acceso a lago de datos de agente de inteligencia artificial en Amazon ECS Fargate
Serverless MCP server for AI agent data lake access on Amazon ECS Fargate
Aishwarya Pawar
Las organizaciones que desarrollan aplicaciones impulsadas por inteligencia artificial (AI) enfrentan un desafío recurrente: brindar a los agentes de modelo de lenguaje grande (LLM) acceso a lagos de datos empresariales sin duplicar la lógica de integración en cada agente y aplicación. La mayoría de los equipos comienzan conectando directamente a los agentes con bases de datos y API, sin una puerta de enlace compartida como un servidor de Protocolo de Contexto de Modelo (MCP). Cada nuevo conjunto de datos requiere código personalizado, y cada agente reimplementa su propio control de acceso. A medida que crece el número de conjuntos de datos o agentes, la aplicación de permisos se vuelve impredecible, y la incorporación de una nueva fuente de datos se convierte en un esfuerzo de ingeniería de varios días.
Nuestro equipo apoya la red del Centro de Clasificación de Norteamérica (NASC) de Amazon, donde los equipos de planificación dependen de datos operativos para gestionar la capacidad, la mano de obra y el flujo de paquetes. Para brindar a esos equipos acceso conversacional a esos datos, creamos un servidor Model Context Protocol (MCP) sin servidor en Amazon Elastic Container Service (Amazon ECS) con AWS Fargate para abordar este problema para los equipos de planificación en NASC. El servidor actúa como una puerta de enlace centralizada y agnóstica de agentes entre los agentes de AI y nuestro lago de datos empresariales. Exponer un nuevo conjunto de datos requiere solo un archivo de metadatos JSON que el servidor descubre automáticamente en la próxima sincronización de la pipeline.
En esta publicación, describimos la arquitectura, mostramos cómo un enfoque dirigido por metadatos elimina la necesidad de código de integración por conjunto de datos y explicamos cómo la infraestructura sin servidor admite múltiples agentes y aplicaciones en un entorno multi-tenant.
Declaración del problema y objetivos de diseño
Dos desafíos interrelacionados dieron forma a cómo diseñamos este sistema: patrones de acceso a datos fragmentados y un modelo de incorporación insostenible.
Desafío de integración a escala
Nuestro lago de datos contiene miles de conjuntos de datos que abarcan métricas operativas, análisis comerciales y datos específicos del dominio. Múltiples equipos querían asistentes de AI que pudieran consultar estos datos de manera conversacional, pero cada uno construyó su propia integración desde cero. Cada agente incorporó su propia lógica de generación de SQL, conocimiento de esquema y control de conexión, por lo que un cambio de esquema significaba parchear cada agente individualmente. El control de acceso estaba fragmentado, sin un solo punto de auditoría para las decisiones de acceso a datos. La incorporación de un nuevo conjunto de datos requería código de herramienta personalizado, validación de consultas y redepliegue, típicamente un esfuerzo de varios días por tabla.
Objetivos de diseño
Establecimos cuatro requisitos:
Acceso al lago de datos basado en configuración. Agregar un conjunto de datos solo requiere un archivo de metadatos, no código.
Interfaces de herramientas agnósticas al agente. Cualquier cliente compatible con MCP puede invocar las mismas herramientas.
Aplicación de permisos centralizada. El control de acceso se aplica en la capa del servidor MCP.
Infraestructura elástica. El sistema se escala con patrones de carga de trabajo de IA variables.
Visión general de la solución
La arquitectura separa las preocupaciones en cuatro capas (cliente, servidor MCP, herramientas y actualización de la base de conocimientos), cada una escalable y desplegable de forma independiente. Un catálogo de metadatos subyace a la capa de herramientas, almacenando descripciones de esquemas, semántica a nivel de columna y relaciones de tablas que el agente de IA referencia al generar SQL. Debido a que el agente deriva el conocimiento del esquema del catálogo en el momento de la consulta, no es necesario codificar estructuras de tablas de forma rígida ni volver a implementar cuando los esquemas cambian. La capa de actualización de la base de conocimientos mantiene actualizado ese catálogo, indexando nuevos metadatos de conjuntos de datos a medida que llegan. Las siguientes secciones describen cada capa en detalle.
Recorrido por la arquitectura
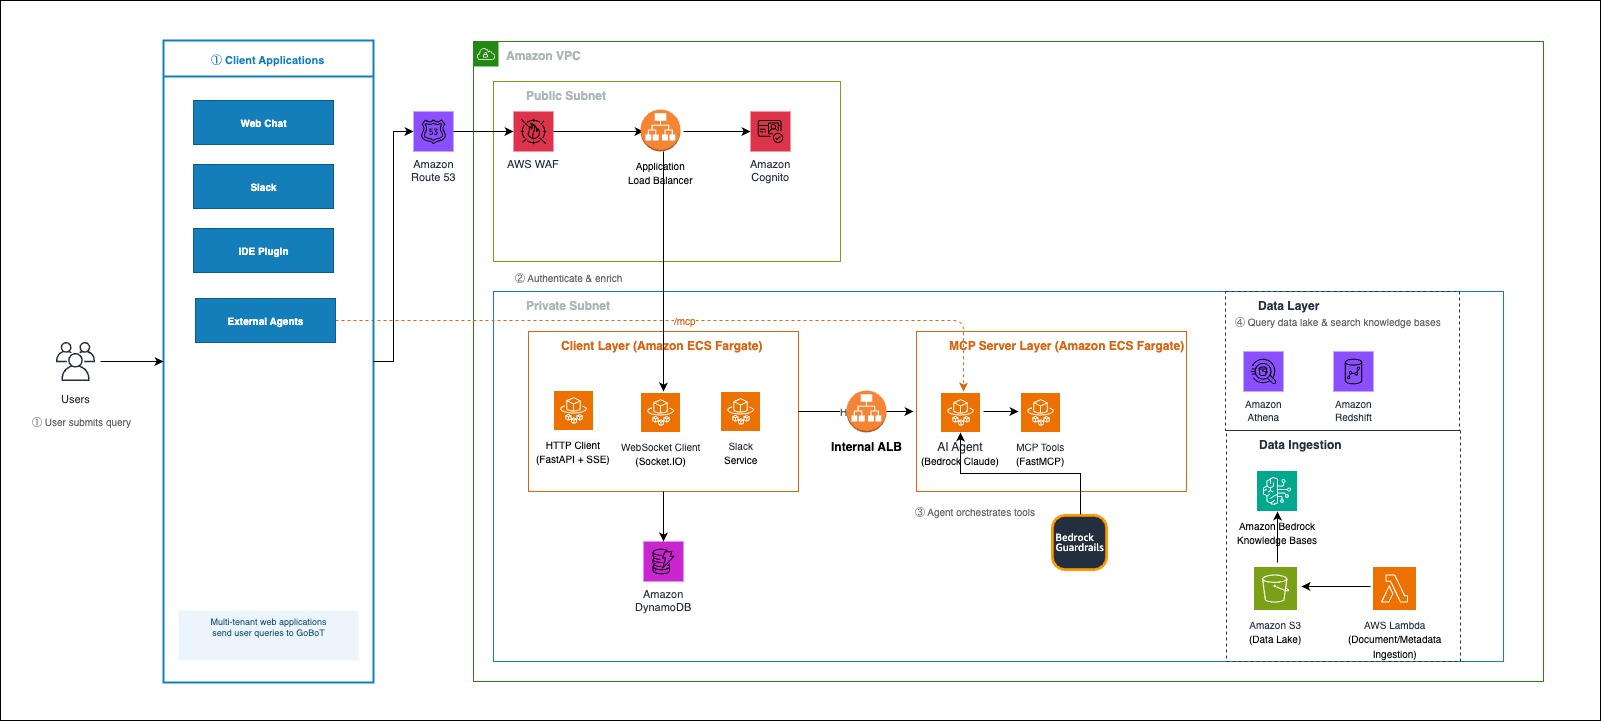
El siguiente diagrama muestra el flujo de solicitudes desde la consulta del usuario hasta la capa de datos a través de las cuatro capas. Un usuario envía una consulta desde una aplicación cliente (chat web, Slack, un complemento de IDE o un agente externo). La solicitud se resuelve a través de Amazon Route 53 para DNS y llega a un Application Load Balancer en una subred pública, configurado con HTTPS y AWS WAF. El equilibrador de carga enruta a Amazon Cognito, que autentica al usuario y enriquece la solicitud. El tráfico autenticado entra entonces en la subred privada, donde la capa del cliente se ejecuta en Amazon ECS Fargate. Esta capa maneja el estado de la sesión en Amazon DynamoDB y envía solicitudes a través de un Application Load Balancer interno a la capa del servidor MCP, también en Amazon ECS Fargate. En la capa del servidor MCP, un agente de IA impulsado por Amazon Bedrock orquesta herramientas construidas con FastMCP (un framework de Python para construir servidores MCP). Amazon Bedrock Guardrails se aplica a cada interacción de modelo. A la derecha, la capa de datos contiene las partes traseras de las herramientas. Amazon Athena y Amazon Redshift ejecutan consultas SQL contra el lago de datos, y Amazon Bedrock Knowledge Bases, la capacidad de generación aumentada de recuperación (RAG) completamente administrada, maneja la búsqueda semántica. La ingesta de datos en Amazon Simple Storage Service (Amazon S3) y las bases de conocimientos se maneja mediante AWS Lambda. Cada capa se describe en detalle en las secciones que siguen.
Figura 1: Flujo de solicitudes a través del servidor MCP sin servidor, desde aplicaciones cliente hasta la capa de datos
Capa de cliente MCP: Autenticación y administración de sesiones
Una solicitud fluye desde la aplicación cliente a través de Amazon Route 53 para la resolución de DNS hasta un Application Load Balancer configurado con HTTPS y AWS WAF. El equilibrador de carga envía el tráfico al servicio de cliente Amazon ECS Fargate, que se integra con Amazon Cognito para la autenticación de token web JSON (JWT) y Amazon DynamoDB para el almacenamiento de sesiones.
Una configuración de asignación de contexto impulsa esta enriquecimiento, limitando cada consulta solo a las tablas relevantes. En nuestras pruebas, esta limitación mantiene la latencia de interacción de extremo a extremo en el rango de 15 a 20 segundos. El siguiente ejemplo muestra una configuración de asignación de contexto:
Cuando un contexto especifica tablas, el servidor MCP reduce su búsqueda del catálogo de metadatos a esas tablas, reduciendo el ruido y mejorando la precisión de la generación de SQL. Agregar un nuevo dominio empresarial requiere solo agregar una entrada a esta asignación.
Capa de servidor MCP: Ejecución sin estado con estado de conversación
El servidor MCP se ejecuta en su propio clúster ECS Fargate, aislado de la capa de cliente. Las solicitudes llegan a él a través de Amazon Route 53 y un Application Load Balancer interno en una subred privada. El servidor maneja la orquestación completa, incluido el análisis de consultas, la selección de herramientas, la ejecución y la generación de respuestas. A través del punto de conexión del protocolo MCP (/mcp), una interfaz JSON-RPC con FastMCP, los clientes compatibles con MCP externos, como Amazon Q Developer o extensiones de IDE, pueden descubrir e invocar herramientas directamente.
Las tareas de Fargate son sin estado, con el estado de conversación persistente en DynamoDB, por lo que las tareas se pueden reemplazar o escalar sin pérdida de datos. Cuando llega una solicitud, el agente recupera el historial de sesión, analiza la intención del usuario utilizando Amazon Bedrock, descubre e invoca las herramientas adecuadas y transmite los resultados de regreso al usuario.
Capa de herramientas y acceso al lago de datos impulsado por metadatos
Cada herramienta se registra con FastMCP y es descubrible en tiempo de ejecución:
Sr.no
Herramienta
Backend
Propósito
1
Herramientas de consulta SQL
Amazon Athena
Amazon Redshift
Consultas SQL contra cualquier conjunto de datos configurado en el lago de datos y Redshift
2
Búsqueda de documentos y metadatos
Amazon Bedrock Knowledge Bases
Búsqueda semántica sobre documentación interna, metadatos de tablas y wikis de equipo
3
Búsqueda de políticas
Amazon Bedrock Knowledge Bases
Búsqueda de políticas operativas y procedimientos estándar
Las herramientas de consulta de Athena son la interfaz principal con el lago de datos. El agente primero consulta el catálogo de metadatos para entender los esquemas disponibles, genera una consulta SQL optimizada a través de Amazon Bedrock, valida y corrige automáticamente el SQL para la compatibilidad con Athena, y luego la ejecuta. Los resultados fluyen de regreso al agente orquestador para la síntesis de lenguaje natural.
Controles de IA responsables
Amazon Bedrock Guardrails se aplica a todas las interacciones de LLM y está diseñado para filtrar contenido dañino, hacer cumplir las verificaciones de base y ayudar a bloquear intentos de inyección de solicitudes. Estos guardrails operan como controles de producción en la capa del servidor MCP, por lo que cada agente conectado se beneficia de las mismas políticas de seguridad de contenido, independientemente de cómo se conecte. Las herramientas de consulta de Athena aplican consultas SELECT-solo, rechazando operaciones de escritura a nivel de herramienta antes de que lleguen al lago de datos.
Capa de actualización de base de conocimientos: Incorporación de conjuntos de datos con un solo archivo JSON
El sistema completo está construido alrededor de la extensibilidad impulsada por la configuración. Agregar un nuevo conjunto de datos requiere un archivo JSON de metadatos que describe la tabla y una entrada de mapeo de contexto opcional. El archivo captura el esquema de la tabla, el contexto empresarial y la semántica a nivel de columna. Sirve como la única fuente de verdad que el agente de IA utiliza para entender y consultar el conjunto de datos:
{
  "database_service_name": "athena",
  "database_name": "analytics_db",
  "table_name": "regional_order_summary",
  "business_description_for_the_table": "Regional order history with shipping status and delivery performance. Contains completed orders with delivery data. Refreshes daily. In Athena SQL, always use date() to wrap string literals when comparing against timestamp columns.",
  "column_details": {
    "order_id [varchar]": {
      "description": "Unique order identifier assigned at checkout.",
      "sample_values": ["ORD-20250115-001234", "ORD-20250116-005678"]
    },
    "order_date [timestamp(3)]": {
      "description": "Date and time the order was placed. Use this column for time-range filtering.",
      "sample_values": ["2025-01-15 08:00:00.000", "2025-01-16 12:30:00.000"]
    },
    "warehouse_id [varchar]": {
      "description": "Fulfillment center that processed the order.",
      "sample_values": ["FC-EAST-07", "FC-WEST-03", "FC-SOUTH-12"]
    }
  },
  "load_type": "Incremental (refreshes last 7 days)",
  "refresh_frequency": "Daily at 6:00 AM UTC",
  "table_size": "~2.1B rows",
  "creation_time": "2024-03-15",
  "last_refresh_time": "2025-05-20T06:00:00Z"
}
El campo business_description_for_the_table lleva pistas de consulta específicas del motor, como "siempre use date() para envolver literales de cadena", que reducen los fallos de validación de SQL. El campo column_details empareja cada column_name [type] con una descripción en lenguaje natural y valores de ejemplo, lo que da al agente tanto conciencia del esquema como semántica empresarial. El campo sample_values es importante para la generación precisa de la cláusula WHERE porque el agente aprende patrones de datos reales, por ejemplo, que warehouse_id contiene códigos como FC-EAST-07 en lugar de nombres escritos como "instalación de la región este".
La pipeline recoge archivos de metadatos, genera incrustaciones de vector con Amazon Titan Text Embeddings y los indexa en Amazon Bedrock Knowledge Bases. Una vez indexados, la tabla es accesible para todos los agentes conectados sin reindexación manual o reinicios del servidor.
Para mejorar la precisión para aplicaciones específicas, un ingeniero puede asociar opcionalmente el conjunto de datos con un contexto empresarial. Esto reduce el alcance de la búsqueda, por lo que el agente prioriza las tablas correctas. El siguiente ejemplo muestra una entrada de asignación de contexto:
Si no se especifica contexto, el agente busca en todas las tablas indexadas. La asignación de contexto reduce la latencia y mejora la precisión de SQL al limitar el espacio de búsqueda. Esta delimitación es opcional y se puede agregar en cualquier momento sin modificar los archivos de metadatos en sí.
Poniéndolo todo junto: Una consulta en acción
Cuando un usuario pregunta, "¿Cuáles fueron nuestros 10 pedidos de mayor valor del mes pasado?", el cliente enriquece la solicitud con contexto empresarial para reducir el alcance. El agente convierte la pregunta en una incrustación de vector, busca en el catálogo de metadatos esquemas coincidentes y selecciona la tabla más relevante a través de una llamada LLM ligera.
Usando el esquema seleccionado, las descripciones de columna y las pistas de consulta específicas del motor, el agente genera una instrucción SQL como:
SELECT order_id, customer_id, total_amount, order_date
FROM analytics_db.regional_order_summary
WHERE order_date >= date_add('month', -1, current_date)
ORDER BY total_amount DESC
LIMIT 10
El SQL se valida y corrige automáticamente para la compatibilidad del motor, y luego se ejecuta contra Amazon Athena. El agente da formato a los resultados en una respuesta en lenguaje natural y los transmite de regreso al usuario. En nuestras pruebas, este flujo de extremo a extremo se completa dentro de 15-20 segundos.
La misma orquestación se extiende más allá del puro SQL. Debido a que la búsqueda de documentos está registrada como otra herramienta en el mismo servidor, el agente puede responder preguntas que abarcan fuentes estructuradas y no estructuradas en un solo turno, como "¿Cuál fue nuestra tasa de devolución para el Q4, y qué dice el análisis del equipo de productos sobre las causas raíz?". Para esa solicitud, el agente ejecuta una consulta de Athena para la cifra de tasa de devolución y una búsqueda de documentos de Knowledge Bases para el análisis, y luego combina ambos en una sola respuesta.
Seguridad y acceso multi-tenant
Esta orquestación de un solo turno funciona solo porque cada llamada a la herramienta pasa por la misma puerta de enlace controlada. La arquitectura utiliza seguridad en capas en lugar de un solo punto de aplicación. El servidor MCP se ejecuta en subredes privadas detrás de un Application Load Balancer interno y no es accesible desde Internet. Solo la capa del cliente, que se encuentra detrás de un Application Load Balancer con AWS WAF, puede enrutar solicitudes a él. Amazon Cognito valida la identidad del usuario en la capa del cliente, y solo las solicitudes autenticadas y con token se envían hacia abajo. A nivel de herramienta, las herramientas de consulta de Athena aplican consultas SELECT-only, rechazando operaciones de escritura antes de que lleguen al lago de datos. Todas las invocaciones de herramientas se registran en Amazon CloudWatch con JSON estructurado, lo que da a los equipos de seguridad un solo punto de auditoría para el acceso a datos en cada agente y aplicación. Esta arquitectura está disponible en las regiones de AWS donde están disponibles Amazon Bedrock y Amazon Bedrock Knowledge Bases.
Diseño centralizado es también lo que hace que el servidor sea multi-tenant. Debido a que el punto de conexión estandarizado /mcp acepta cualquier cliente compatible con MCP, independientemente del LLM o framework de orquestación que utilice, múltiples agentes comparten las mismas herramientas y los mismos controles de acceso. Agregar un nuevo agente requiere solo apuntar a él al punto de conexión del servidor, por lo que la incorporación de otro equipo extiende el sistema sin debilitar o duplicar el modelo de seguridad.
Infraestructura y escalado sin servidor
Cada capa se escala a través de un mecanismo adecuado para su patrón de carga de trabajo:
Capa
Mecanismo de escalado
Disparador
Cliente (ECS Fargate)
ECS Service Auto Scaling
Utilización de CPU (umbral del 50%)
Servidor MCP (ECS Fargate)
ECS Service Auto Scaling
Utilización de CPU/Memoria
Athena
Sin servidor (automático)
Concurrencia de consultas
Amazon Bedrock
Escalado de servicio administrado
Solicitudes de inferencia
Amazon ECS Fargate proporciona cómputo sin servidor sin instancias de EC2 que administrar. Los servicios downstream (Athena, Bedrock) se escalan automáticamente, por lo que el sistema maneja una sola consulta o cientos de consultas concurrentes sin cambios de configuración.
Casos de uso y extensiones
Esta arquitectura admite varios patrones más allá de la respuesta básica a preguntas. Los asistentes de conocimiento empresarial pueden combinar consultas de data lake con búsqueda de documentos para responder preguntas complejas que abarcan datos estructurados y conocimiento no estructurado, como "¿Cuál es nuestra tasa de devolución para el Q4, y qué dice el análisis del equipo de productos sobre las causas raíz?". Los copilotos de análisis internos permiten a los usuarios empresariales consultar el data lake de manera conversacional sin escribir SQL, confiando en las descripciones de metadatos y las sugerencias de consulta para guiar al agente hacia patrones de consulta precisos y performantes.
El punto de conexión estandarizado /mcp también admite flujos de trabajo multiagente. Múltiples agentes especializados para análisis de datos, recuperación de documentos y alertas operativas pueden compartir el mismo servidor MCP, cada uno accediendo a la suite de herramientas completa a través de un protocolo común. La incorporación de los datos de un nuevo equipo sigue el mismo patrón de configuración. Agregan un archivo JSON de metadatos, y dentro de un ciclo de sincronización de pipeline, su conjunto de datos es descubrible por cada agente y aplicación conectado.
Conclusión
Un servidor MCP centralizado en Amazon ECS Fargate proporciona una puerta de enlace escalable y segura entre agentes de IA y data lakes empresariales. El enfoque basado en metadatos elimina la necesidad de código de integración por conjunto de datos, y el estándar de Protocolo de Contexto de Modelo significa que cualquier cliente compatible con MCP puede conectarse sin adaptadores personalizados.
La decisión arquitectónica clave es separar la capa de herramientas de la capa de agente. Los agentes evolucionan rápidamente, pero los patrones de acceso a datos deben sobrevivir a cualquier implementación de agente individual. Tratar la extensibilidad como un problema de configuración en lugar de un problema de código acelera la incorporación.
Estamos extendiendo esta arquitectura en dos direcciones. Primero, un control de acceso más granular donde los propietarios de tablas pueden marcar columnas sensibles como restringidas por grupo de permisos, y el agente excluye automáticamente esas columnas del SQL generado sin cambios a nivel de prompt.
Segundo, cerrar el bucle de retroalimentación para que cuando las consultas fallen o produzcan resultados de baja confianza, el sistema capture el patrón de falla y presente sugerencias dirigidas para mejorar las descripciones de columnas, agregar sugerencias de consulta.
Acerca de los autores
Organizations building applications powered by artificial intelligence (AI) face a recurring challenge: giving large language model (LLM) agents access to enterprise data lakes without duplicating integration logic across every agent and application. Most teams begin by wiring agents directly to databases and APIs, with no shared gateway such as a Model Context Protocol (MCP) server in between. Each new dataset demands custom code, and each agent reimplements its own access control. As the number of datasets or agents grows, permission enforcement drifts, and onboarding a new data source becomes a multi-day engineering effort.
Our team supports Amazon’s North America Sort Center (NASC) network, where planning teams rely on operational data to manage capacity, labor, and package flow. To give those teams conversational access to that data, we built a serverless Model Context Protocol (MCP) server on Amazon Elastic Container Service (Amazon ECS) with AWS Fargate to address this problem for planning teams in NASC. The server acts as a centralized, agent-agnostic gateway between AI agents and our enterprise data lake. Exposing a new dataset requires only a JSON metadata file that the server discovers automatically on the next pipeline sync.
In this post, we describe the architecture, show how a metadata-driven approach removes the need for per-dataset integration code, and explain how the serverless infrastructure supports multiple agents and applications in a multi-tenant environment.
Problem statement and design goals
Two interrelated challenges shaped how we designed this system: fragmented data access patterns and an unsustainable onboarding model.
Integration challenge at scale
Our data lake contains thousands of datasets spanning operational metrics, business analytics, and domain-specific data. Multiple teams wanted AI assistants that could query this data conversationally, but each built its own integration from scratch. Each agent embedded its own SQL generation logic, schema knowledge, and connection handling, so a schema change meant patching every agent individually. Access control was fragmented, with no single audit point for data access decisions. Onboarding a new dataset required custom tool code, query validation, and redeployment, typically a multi-day effort per table.
Design goals
We established four requirements:
Configuration-driven data lake access. Adding a dataset requires only a metadata file, not code.
Agent-agnostic tool interfaces. Any MCP-compatible client can invoke the same tools.
Centralized permission enforcement. Access control is enforced at the MCP server layer.
Elastic infrastructure. The system scales with bursty AI workload patterns.
Solution overview
The architecture separates concerns into four layers (client, MCP server, tools, and knowledge-base refresh), each independently scalable and deployable. A metadata catalog underpins the tools layer, storing schema descriptions, column-level semantics, and table relationships that the AI agent references when generating SQL. Because the agent derives schema knowledge from the catalog at query time, there is no need to hardcode table structures or redeploy when schemas change. The knowledge-base refresh layer keeps that catalog current, indexing new dataset metadata as it arrives. The following sections describe each layer in detail.
Architecture walkthrough
The following diagram shows the request flow from user query to data layer across all four layers. A user submits a query from a client application (web chat, Slack, an IDE plugin, or an external agent). The request resolves through Amazon Route 53 for DNS and reaches an Application Load Balancer in a public subnet, configured with HTTPS and AWS WAF. The load balancer routes to Amazon Cognito, which authenticates the user and enriches the request. Authenticated traffic then enters the private subnet, where the client layer runs on Amazon ECS Fargate. This layer handles session state in Amazon DynamoDB and forwards requests through an internal Application Load Balancer to the MCP server layer, also on Amazon ECS Fargate. In the MCP server layer, an AI agent powered by Amazon Bedrock orchestrates tools built with FastMCP (a Python framework for building MCP servers). Amazon Bedrock Guardrails is applied to every model interaction. On the right, the data layer holds the tool backends. Amazon Athena and Amazon Redshift run SQL queries against the data lake, and Amazon Bedrock Knowledge Bases, the fully managed Retrieval Augmented Generation (RAG) capability, handles semantic search. Data ingestion into Amazon Simple Storage Service (Amazon S3) and the knowledge bases is handled by AWS Lambda. Each layer is described in detail in the sections that follow.
Figure 1: Request flow through the serverless MCP server, from client applications to the data layer
MCP client layer: Authentication and session management
A request flows from the client application through Amazon Route 53 for DNS resolution to an Application Load Balancer configured with HTTPS and AWS WAF. The load balancer forwards traffic to the Amazon ECS Fargate client service, which integrates with Amazon Cognito for JSON Web Token (JWT) authentication and Amazon DynamoDB for session storage.
A context mapping configuration drives this enrichment, scoping each query to only the relevant tables. In our testing, this scoping keeps end-to-end interaction latency in the 15–20 second range. The following example shows a context mapping configuration:
When a context specifies tables, the MCP server narrows its search of the metadata catalog to those tables, reducing noise and improving SQL generation accuracy. Adding a new business domain requires only adding an entry to this mapping.
MCP server layer: Stateless execution with conversation state
The MCP server runs on its own ECS Fargate cluster, isolated from the client layer. Requests reach it through Amazon Route 53 and an internal Application Load Balancer in a private subnet. The server handles full orchestration including query analysis, tool selection, execution, and response generation. Through the MCP protocol endpoint (/mcp), a FastMCP-powered JSON-RPC interface, external MCP-compatible clients such as Amazon Q Developer or IDE extensions can discover and invoke tools directly.
Fargate tasks are stateless with conversation state persisted in DynamoDB, so tasks can be replaced or scaled without data loss. When a request arrives, the agent retrieves session history, analyzes user intent using Amazon Bedrock, discovers and invokes appropriate tools, and streams results back to the user.
Tools layer and metadata-driven data lake access
Each tool is registered with FastMCP and discoverable at runtime:
Sr.no
Tool
Backend
Purpose
1
SQL query tools
Amazon Athena
Amazon Redshift
SQL queries against any configured dataset in the data lake and Redshift
2
Document and metadata search
Amazon Bedrock Knowledge Bases
Semantic search over internal documentation, table metadata and team wikis
3
Policy search
Amazon Bedrock Knowledge Bases
Search operational policies and standard procedures
The Athena query tools are the primary interface to the data lake. The agent first queries the metadata catalog to understand available schemas, generates an optimized SQL query through Amazon Bedrock, validates and auto-corrects the SQL for Athena compatibility, then executes it. Results flow back to the orchestrating agent for natural language synthesis.
Responsible AI controls
Amazon Bedrock Guardrails is applied to all LLM interactions and is designed to filter harmful content, enforce grounding checks, and help block prompt injection attempts. These guardrails operate as production controls at the MCP server layer, so every connected agent benefits from the same content safety policies regardless of how it connects. The Athena query tools enforce SELECT-only queries, rejecting write operations at the tool level before they reach the data lake.
Knowledge base refresh layer: Dataset onboarding with a single JSON file
The entire system is built around configuration-driven extensibility. Adding a new dataset requires a metadata JSON file describing the table and an optional context mapping entry. The file captures the table’s schema, business context, and column-level semantics. It serves as the single source of truth that the AI agent uses to understand and query the dataset:
{
  "database_service_name": "athena",
  "database_name": "analytics_db",
  "table_name": "regional_order_summary",
  "business_description_for_the_table": "Regional order history with shipping status and delivery performance. Contains completed orders with delivery data. Refreshes daily. In Athena SQL, always use date() to wrap string literals when comparing against timestamp columns.",
  "column_details": {
    "order_id [varchar]": {
      "description": "Unique order identifier assigned at checkout.",
      "sample_values": ["ORD-20250115-001234", "ORD-20250116-005678"]
    },
    "order_date [timestamp(3)]": {
      "description": "Date and time the order was placed. Use this column for time-range filtering.",
      "sample_values": ["2025-01-15 08:00:00.000", "2025-01-16 12:30:00.000"]
    },
    "warehouse_id [varchar]": {
      "description": "Fulfillment center that processed the order.",
      "sample_values": ["FC-EAST-07", "FC-WEST-03", "FC-SOUTH-12"]
    }
  },
  "load_type": "Incremental (refreshes last 7 days)",
  "refresh_frequency": "Daily at 6:00 AM UTC",
  "table_size": "~2.1B rows",
  "creation_time": "2024-03-15",
  "last_refresh_time": "2025-05-20T06:00:00Z"
}
The business_description_for_the_table field carries engine-specific query hints, such as “always use date() to wrap string literals,” that reduce SQL validation failures. The column_details field pairs each column_name [type] with a natural language description and sample values, giving the agent both schema awareness and business semantics. The sample_values field matters for accurate WHERE clause generation because the agent learns real data patterns, for instance that warehouse_id holds codes like FC-EAST-07 rather than spelled-out names like “East region facility.”
The pipeline picks up metadata files, generates vector embeddings with Amazon Titan Text Embeddings, and indexes them into Amazon Bedrock Knowledge Bases. Once indexed, the table is discoverable by all connected agents without manual re-indexing or server restarts.
To improve accuracy for specific applications, an engineer can optionally associate the dataset with a business context. This narrows the search scope, so the agent prioritizes the right tables. The following example shows a context mapping entry:
If no context is specified, the agent searches across all indexed tables. The context mapping reduces latency and improves SQL accuracy by limiting the search space. This scoping is optional and can be added at any time without modifying the metadata files themselves.
Putting it together: A query in action
When a user asks, “What were our top 10 highest-value orders last month?”, the client enriches the request with business context to narrow scope. The agent converts the question into a vector embedding, searches the metadata catalog for matching schemas, and selects the most relevant table via a lightweight LLM call.
Using the selected schema, column descriptions, and engine-specific query hints, the agent generates a SQL statement such as:
SELECT order_id, customer_id, total_amount, order_date
FROM analytics_db.regional_order_summary
WHERE order_date >= date_add('month', -1, current_date)
ORDER BY total_amount DESC
LIMIT 10
The SQL is validated and auto-corrected for engine compatibility, then executed against Amazon Athena. The agent formats the results into a natural language response and streams it back to the user. In our testing, this end-to-end flow completes within 15–20 seconds.
The same orchestration extends beyond pure SQL. Because document search is registered as another tool on the same server, the agent can answer questions that span structured and unstructured sources in a single turn, such as “What was our return rate for Q4, and what does the product team’s analysis say about the root causes?” For that request, the agent runs an Athena query for the return-rate figure and a Knowledge Bases document search for the analysis, then combines both into one response.
Security and multi-tenant access
That single-turn orchestration works only because every tool call passes through the same controlled gateway. The architecture uses layered security rather than a single enforcement point. The MCP server runs in private subnets behind an internal Application Load Balancer and is not reachable from the internet. Only the client layer, which sits behind a public-facing Application Load Balancer with AWS WAF, can route requests to it. Amazon Cognito validates user identity at the client layer, and only authenticated, token-bearing requests are forwarded downstream. At the tool level, the Athena query tools enforce SELECT-only queries, rejecting write operations before they reach the data lake. All tool invocations are logged to Amazon CloudWatch with structured JSON, which gives security teams a single audit point for data access across every agent and application. This architecture is available in the AWS Regions where Amazon Bedrock and Amazon Bedrock Knowledge Bases are available.
This centralized design is also what makes the server multi-tenant. Because the standardized /mcp endpoint accepts any MCP-compatible client regardless of which LLM or orchestration framework it uses, multiple agents share the same tools and the same access controls. Adding a new agent requires only pointing it at the server endpoint, so onboarding another team extends the system without weakening or duplicating the security model.
Serverless infrastructure and scaling
Each layer scales through a mechanism suited to its workload pattern:
Layer
Scaling mechanism
Trigger
Client (ECS Fargate)
ECS Service Auto Scaling
CPU utilization (50% threshold)
MCP Server (ECS Fargate)
ECS Service Auto Scaling
CPU/Memory utilization
Athena
Serverless (automatic)
Query concurrency
Amazon Bedrock
Managed service scaling
Inference requests
Amazon ECS Fargate provides serverless compute with no EC2 instances to manage. Downstream services (Athena, Bedrock) scale automatically, so the system handles a single query or hundreds of concurrent queries without configuration changes.
Use cases and extensions
This architecture supports several patterns beyond basic question-answering. Enterprise knowledge assistants can combine data lake queries with document search to answer complex questions spanning both structured data and unstructured knowledge, such as “What’s our return rate for Q4, and what does the product team’s analysis say about the root causes?” Internal analytics copilots let business users query the data lake conversationally without writing SQL, relying on the metadata descriptions and query hints to guide the agent toward accurate, performant query patterns.
The standardized /mcp endpoint also supports multi-agent workflows. Multiple specialized agents for data analysis, document retrieval, and operational alerting can share the same MCP server, each accessing the full tool suite through a common protocol. Onboarding a new team’s data follows the same configuration-driven pattern. They add a metadata JSON file, and within one pipeline sync cycle their dataset is discoverable by every connected agent and application.
Conclusion
A centralized MCP server on Amazon ECS Fargate provides a scalable, secure gateway between AI agents and enterprise data lakes. The metadata-driven approach removes the need for per-dataset integration code, and the Model Context Protocol standard means any MCP-compatible client can connect without custom adapters.
The key architectural decision is separating the tool layer from the agent layer. Agents evolve rapidly, but data access patterns should outlive any single agent implementation. Treating extensibility as a configuration problem rather than a code problem accelerates onboarding.
We are extending this architecture in two directions. First, finer-grained access control where table owners can mark sensitive columns as restricted per permission group, and the agent automatically excludes those columns from generated SQL without prompt-level changes.
Second, closing the feedback loop so that when queries fail or produce low-confidence results, the system captures the failure pattern and surfaces targeted suggestions for improving column descriptions, adding query hints.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.