Transmita la voz de baja latencia de los agentes de IA mediante Kokoro TTS en Amazon SageMaker AI
Stream low-latency speech from AI agents using Kokoro TTS on Amazon SageMaker AI
Joseph Cottingham
Un cliente hace una pregunta a un agente de voz de IA y espera. El agente ya tiene una respuesta, está a medio camino de generar una respuesta larga de varios párrafos, pero el cliente no escucha nada durante cinco segundos. Cuando llega la respuesta, el cliente se siente frustrado, confundido y ya no presta atención
.
Las integraciones de texto a voz crean exactamente esa brecha. Una respuesta de una frase puede generarse en 600 milisegundos, pero la respuesta completa tarda cinco segundos y la integración espera a que llegue toda la respuesta antes de que comience la síntesis
.
Esta publicación muestra cómo cerrar esa brecha. Transmitimos cada oración a un modelo de conversión de texto a voz (TTS) de Kokoro-82M alojado en Amazon SageMaker AI tan pronto como un agente la produce, de modo que la síntesis comienza con la primera oración en lugar de con la respuesta final. Para devolver ese audio a un navegador también se necesita su propia solución, por lo que también nos ocupamos de los gastos que implica hacerlo y de lo que cuesta cada uno en la práctica.
Descripción general de la solución
Esta solución cierra la brecha al transmitir la síntesis a lo largo de la generación en vez de esperar a que termine. A medida que el agente produce cada frase, esa frase se transmite inmediatamente a un modelo de conversión de texto a voz de Kokoro-82M alojado, de modo que la reproducción del audio puede comenzar antes de que el agente termine de pronunciar su respuesta completa. Kokoro-82M solo contiene 82 millones de parámetros, lo suficientemente pequeños como para ejecutarse de forma económica en una sola instancia de GPU de nivel intermedio. Esto reduce la latencia y los costes de inferencia para un agente de voz que gestiona tráfico real
.
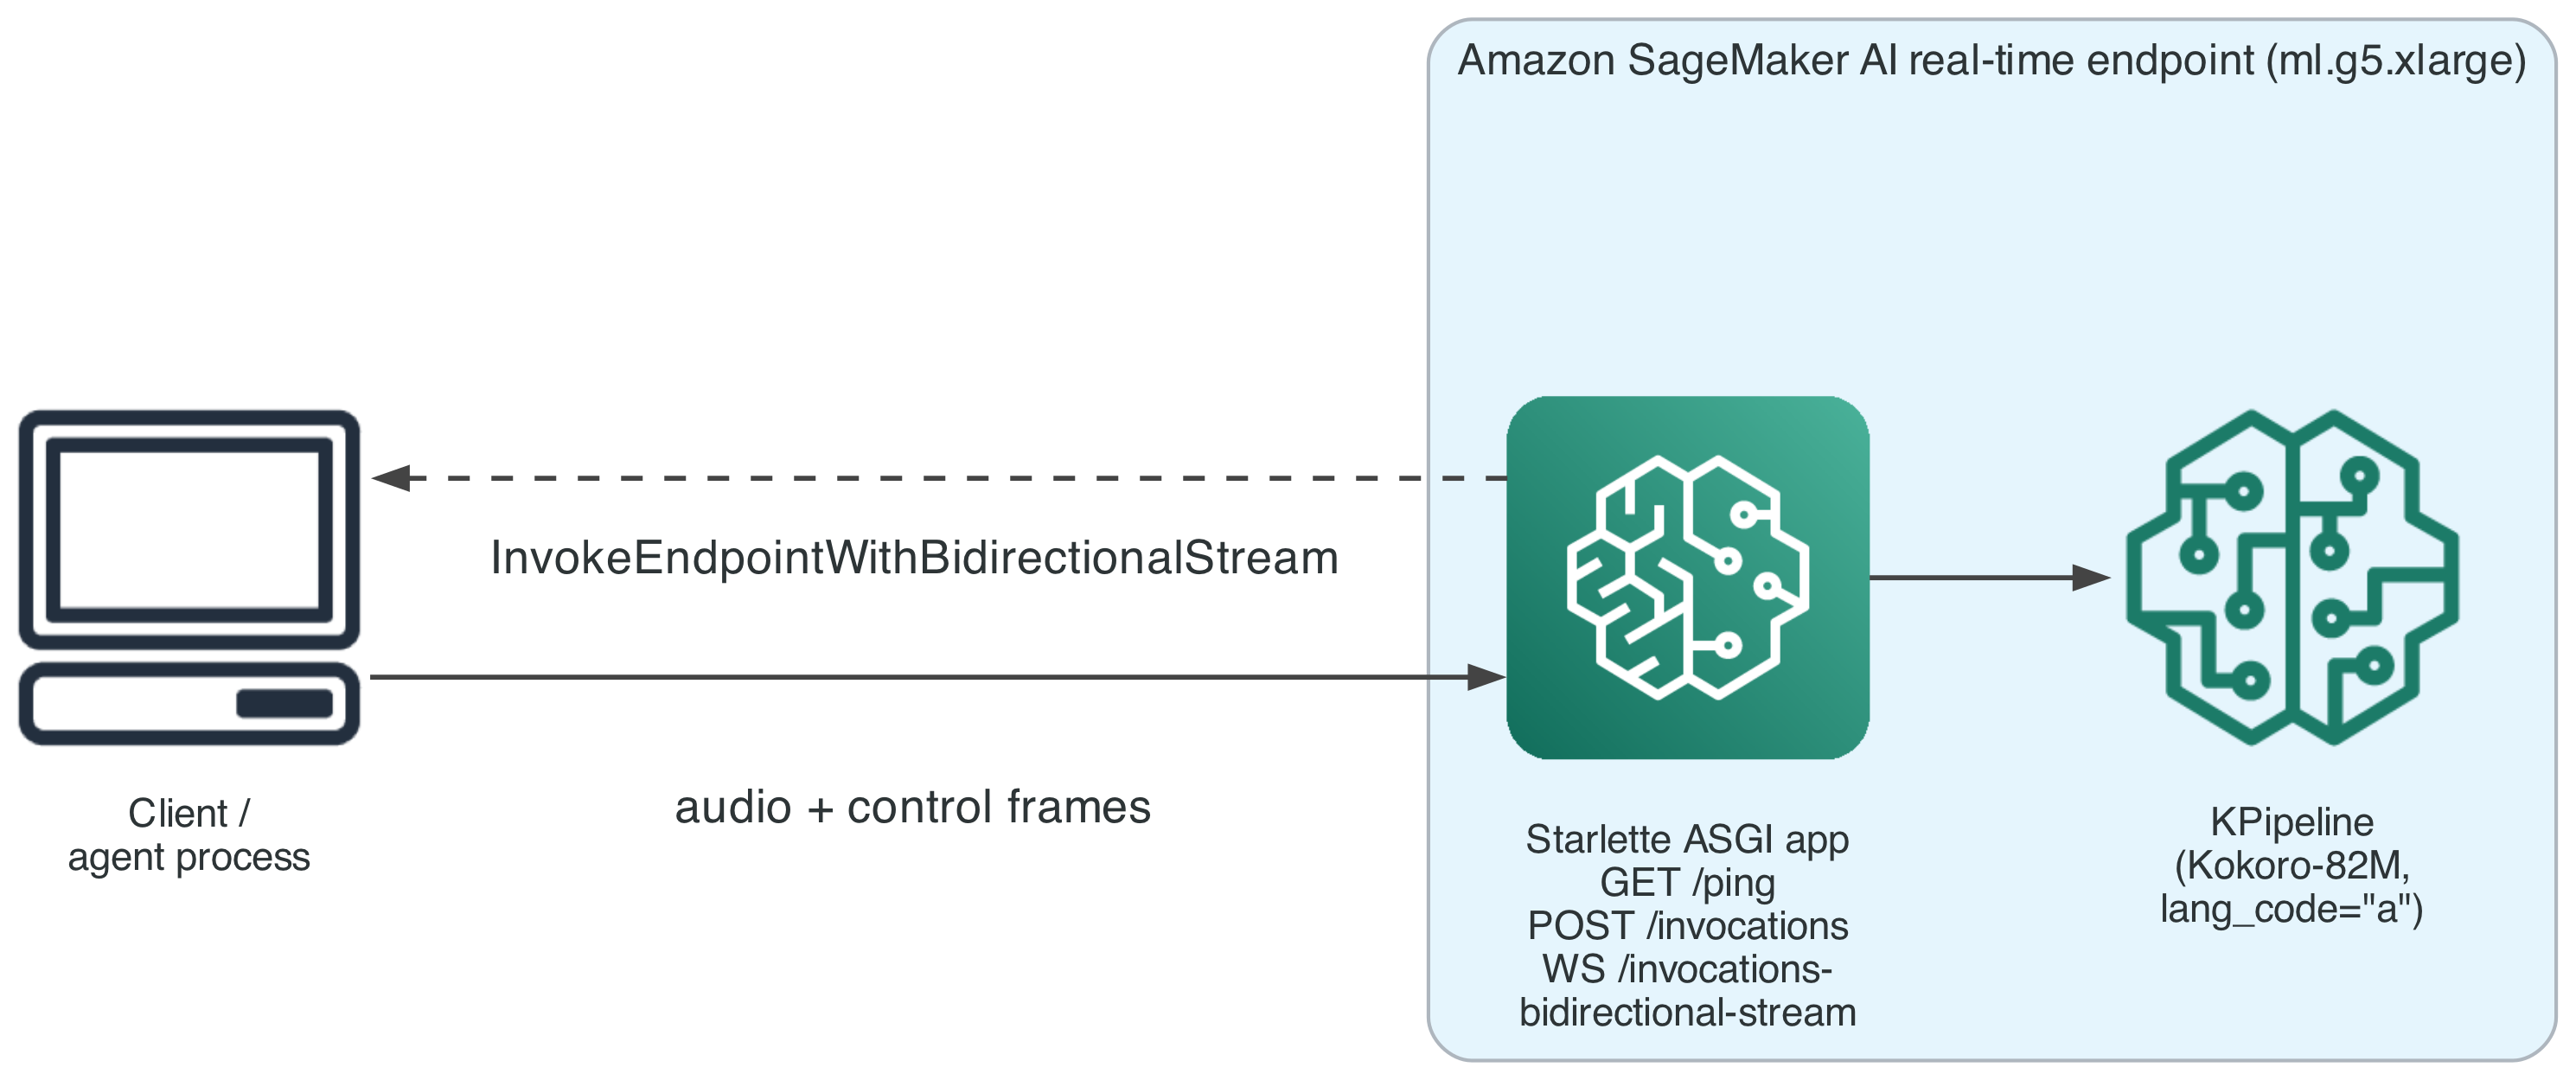
Kokoro-82M se ejecuta en un contenedor personalizado en un punto final de SageMaker AI en tiempo real, en una instancia de GPU ml.g5.xlarge. El contenedor expone dos rutas: POST /invocations, que transmite una respuesta para una entrada completa, y WS /invocations-bidirectional-stream, que mantiene abierta una conexión para
varios mensajes en ambas direcciones.
El siguiente diagrama muestra la ruta de solicitud del cliente al modelo:
Figura 1: Ruta de solicitud desde el cliente al punto final en tiempo real de SageMaker AI a través de una transmisión bidireccional
Requisitos previos
Antes de empezar, necesita:
Una cuenta de AWS con permisos para crear puntos de enlace de IA de SageMaker; AgentCore Runtime, una capacidad de Amazon Bedrock AgentCore; funciones de AWS Identity and Access Management (IAM); y un repositorio de Amazon Elastic Container Registry (Amazon ECR), que incluye como mínimo SageMaker:createEndpoint, SageMaker:createEndpointConfig, Sagemaker:createModel, SageMaker:invokeEndpointWithBidirectionalStream y Bedrock: invoque el modelo con acciones de ResponseStream.
El contenedor de muestras fija una PyTorch antigua con un aviso conocido (PYSEC-2026-2286, corregido en Torch 2.10.0). Revisa y actualiza el pin antes de cualquier uso que no sea una prueba de valor.
Un punto final de IA en tiempo real de SageMaker implementado desde un contenedor que declara la etiqueta com.amazonaws.sagemaker.capabilities.bidirectional-streaming=true Docker.
Python 3.12 o posterior, uv y Docker para crear la imagen del contenedor (el cliente HTTP/2 subyacente solo incluye ruedas prediseñadas para Python 3.12 y versiones posteriores).
El SDK de AWS para Python (Boto3) compatible con invoke_endpoint_with_bidirectional_stream.
Familiaridad con WebSockets y Starlette o con un marco ASGI comparable.
El código de implementación del repositorio de GitHub al que se hace referencia en esta publicación.
Tutorial
El tutorial primero implementa el punto final y el agente y, a continuación, analiza los cambios del lado del cliente que hacen que la transmisión incremental funcione de principio a fin.
Implemente el punto final y el agente
El punto final de Kokoro-82M y el tiempo de ejecución del agente se implementan mediante dos herramientas de CLI, cada una con sus propias pilas de AWS CDK:
uv run speech-infra deploy kokoro-82m
uv run agent-infra deploy --bedrock-model-id
speech-infra deploy aprovisiona el punto final Kokoro-82M. Esto incluye la base y las pilas de caché de modelos que crean las funciones de IAM subyacentes y sincronizan los pesos del modelo en Amazon Simple Storage Service (Amazon S3). A continuación, la pila de puntos finales crea la imagen del contenedor y crea el modelo de IA, la configuración de puntos finales y el punto final de SageMaker. agent-infra deploy aprovisiona el tiempo de ejecución de Amazon Bedrock AgentCore que aloja el agente Strands, que llama al punto final que acaba de implementar, por lo que debe implementar primero el punto final
.
Paso 1: Gestione el tipo de marco WebSocket que SageMaker AI realmente envía
El transporte bidireccional que utiliza SageMaker AI envía cada parte del mensaje de un cliente a su contenedor en forma de marco WebSocket binario. Una forma habitual de escribir un controlador WebSocket de Starlette es llamar a receive_text (), que lee el mensaje ["text"] y genera KeyError si esa clave no está presente. Como todos los mensajes que envía este cliente llegan en formato binario, ese controlador falla
en todas las solicitudes.
Por lo
general, el error se diagnostica erróneamente. Un controlador de excepciones genérico que reenvía str (e) al cliente convierte KeyError ('texto') en un marco de error en el que se lee 'texto', que parece que falta un campo, no se trata de un problema de encuadre. El propio terminal informa a InService en todo momento, ya que acepta las conexiones y responde a todos los mensajes con un error cada vez
.
Acepte cualquiera de los tipos de marco de forma explícita en lugar de asumir que aparecerá uno:
desde starlette.websockets importar WebSocket, WebSocketDisconnect

definición asíncrona _receive_message (websocket: WebSocket) -> str:
 mensaje = await websocket.receive ()
 si el mensaje ["type"] == «websocket.disconnect»:
 levante WebSocketDisconnect (message.get («code», 1000))
 payload = message.get («texto»)
 si la carga útil es Ninguna:
 payload = message.get («bytes», b "») .decode («utf-8")
 carga útil
de retorno
Esto decodifica los bytes como UTF-8 cuando no hay ningún campo de texto, en lugar de asumir un solo tipo de marco. Pruébelo enviando un marco binario, ya que este modo de error produce un marco de error bien formado y un estado de punto final correcto, no un
bloqueo evidente.
Paso 2: Mantén la sesión abierta entre los mensajes
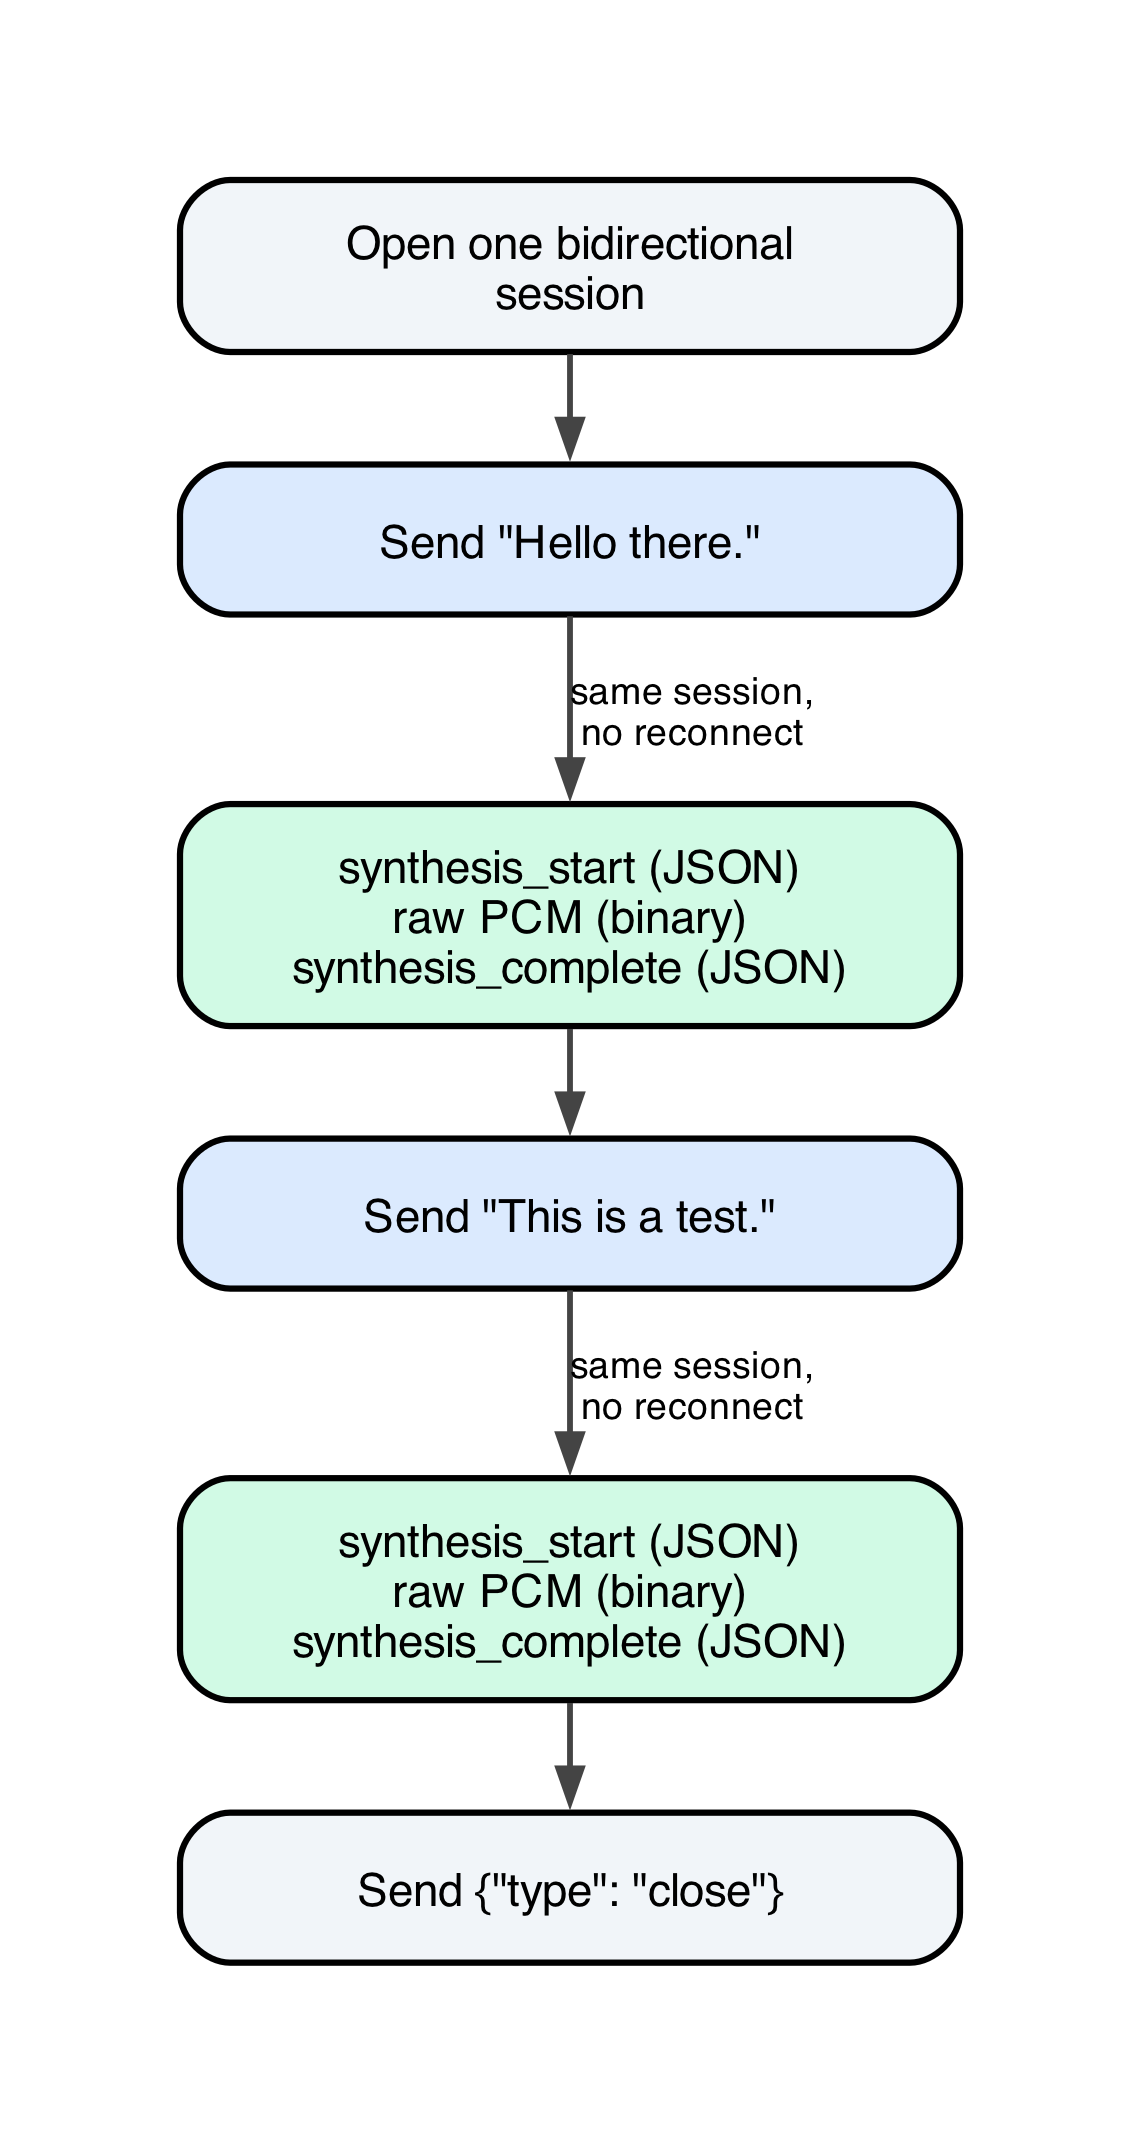
Una vez que el contenedor termine de sintetizar el audio de un mensaje, el instinto es cerrar la sesión, la forma en que termina un ciclo HTTP. Eso está mal aquí. Tras enviar el audio de un mensaje y un marco de control synthesis_complete, el bucle contenedor debería volver a esperar a recibir () el siguiente mensaje de la misma sesión aún abierta. Cierra la conexión solo cuando el cliente envíe un mensaje explícito de {"type»: «
close"}.
El siguiente diagrama muestra una sesión con dos frases en secuencia y que se cierra solo al final:
Figura 2: Una sesión bidireccional con dos oraciones en secuencia, que se cierra solo al final
De esta forma, puedes enviar varias frases, una tras otra, en una sesión persistente, sin coste de reconexión entre ellas. Cerrar con impaciencia tras una respuesta forzaría a establecer una nueva conexión por frase, lo que eliminaría la mayor parte del beneficio de la latencia
.
Paso 3: Transmite frases a medida que el agente las produce
Una
vez establecido el comportamiento de la sesión, la solución para el problema de latencia por parte del cliente es una clase que normaliza el texto que llega en dos formas: una cadena completa conocida de antemano o una secuencia de símbolos en tiempo real. En cualquier caso, produce el mismo resultado: frases completas, listas para enviarse en cuanto cada una
esté completa.
importar re

_SENTENCE_RE = re.compile (r "(? <= [.!?]) \ s+»)


clase IncrementalSentenceChunker:
 def __init__ (self) -> Ninguna:
 uno mismo. _buffer = «»

 def feed (self, fragmento: str) -> lista [str]:
 uno mismo. _buffer += fragmento
 parts = _sentence_re.split (self). _buffer)
 si len (parts) == 1:
 devolución []
 uno mismo. _buffer = partes [-1]
 devuelve [s.strip () para s en partes [:-1] si s.strip ()]

 def flush (self) -> str | Ninguno:
 resto = uno mismo. _buffer.strip ()
 uno mismo. _buffer = «»
 devuelve el resto o Ninguno
Llama a feed () una vez por fragmento de texto a medida que llegue. Devuelve las frases recién completadas, reteniendo el texto final. Llama a flush () una vez, al final de la entrada, para eliminar el texto parcial que quede, incluso sin la puntuación final. Esto evita que una secuencia que termina antes de que llegue un punto elimine la última oración.
No se trata de síntesis concurrente. Cada controlador bidireccional es un bucle estrictamente secuencial: recibe un mensaje, sintetiza su audio, envía ese audio, envía synthesis_complete y, a continuación, recibe el siguiente mensaje. El audio de la oración dos no se genera mientras la oración uno sigue transmitiendo. Lo que compra el envío incremental es más limitado: la síntesis de la primera oración comienza en el instante en que existe, en lugar de esperar a recibir la respuesta completa. En el caso de una respuesta de varias frases con un tiempo de generación real entre la primera y la última frase, eso es todo lo que gana en términos de latencia
.
Lo hemos comprobado comparándolo con un terminal en tiempo real que envía una entrada de tres frases durante una sesión. Los tres fragmentos llegaron con un audio que coincidía con el texto enviado para
cada uno:
Trozo
Texto
Bytes de audio
Duración (es)
1
«Hola a todos».
73.200
1,525
2
«Se trata de una comprobación posterior al despliegue».
108.000
2,250
3
«Tiene tres frases».
98.400
2,050
Paso 4: Elija un transporte para devolver el audio al cliente
La
transmisión gradual de texto al modelo resuelve la mitad del problema. La otra mitad consiste en enviar el audio resultante a lo que sea que lo renderice, normalmente un navegador. La mayoría de las interfaces de chat y agentes ya transmiten texto a través de eventos enviados por el servidor (SSE): son unidireccionales y son compatibles de forma nativa con la mayoría de los navegadores. El SSE es un protocolo de texto, no diseñado para transportar una carga binaria sin procesar. Un equipo que añade voz a una canalización de SSE existente recurre naturalmente al patrón que ya tiene: codificar el audio en base64 y empaquetarlo en
un evento JSON.
Medimos el coste de este enfoque en 24 clips, confirmamos con Amazon Transcribe que la calidad no difería entre las codificaciones y comparamos el MP3 con el AAC:
Candidato
Bytes sin procesar
64 bytes en base
Velocidad de bits
PCM sin procesar
2.396.400
3.195.200
384 kbps
MP3 48 k
308.304
411072
49,5 kbps
AAC 32 k fMP4
258.039
344,084
41,6 kbps
Base64 infla cada carga útil cerca del 33% esperado. El coste más sutil es la alineación de los marcos. Los eventos de SSE están delimitados por una línea en blanco, pero el audio que contienen está delimitado en fotogramas MP3. Los dos esquemas no se alinean necesariamente con la forma en que el transporte fragmenta los datos. En una respuesta mesurada, cuatro fotogramas MP3 lógicos llegaron en seis fragmentos de entrega, dos de los cuales terminaron a mitad del fotograma. Un consumidor que trata cada porción de entrega como si fuera una unidad completa fracasa en un tráfico normal y saludable. La solución almacena en búfer los bytes entrantes y solo actúa una vez que se encuentra un delimitador
:
búfer = b "»
para el evento en resp ["Body"]:
 si «PayloadPart» no está en el evento:
 continuar
 buffer += evento ["payloadPart"] ["Bytes"]
 mientras b»\n\n"está en el búfer:
 marco, buffer = buffer.split (b»\n\n«, 1)
asa (marco)
La alternativa que se usa hoy en día para la pierna orientada hacia el modelo omite por completo el encuadre en base64 y SSE. Multiplexa el audio binario sin procesar y los marcos de control JSON en la misma sesión bidireccional, ya con una entrada de texto incremental, y
Un fragmento que no se decodifica como objeto JSON es el audio, que se reenvía tal como se recibe, sin ningún paso de codificación en ninguna parte de la ruta. Un caso extremo es importante: el audio PCM sin procesar puede comenzar legítimamente con el byte 0x7b, el carácter ASCII {, el mismo carácter que abre un objeto JSON. Esta regla evita clasificar mal ese audio, ya que requiere que todo el fragmento se analice como JSON válido, y no solo su primer byte, algo
que un marco PCM prácticamente nunca logrará.
Nota: Si su interfaz ya tiene una canalización SSE para texto en funcionamiento, el audio codificado en base64 dentro de un evento SSE es la opción pragmática. Cuesta aproximadamente un 33 por ciento de carga útil adicional y un paso para almacenar en búfer y volver a ensamblar, pero reutiliza la infraestructura que ya utilizas. Si estás creando la ruta de voz desde cero o la prioridad es la latencia, el enfoque unificado de binarios y JSON evita ambos costos y reutiliza
la conexión que ya contiene texto.
Paso 5: Reúne todo en un agente real
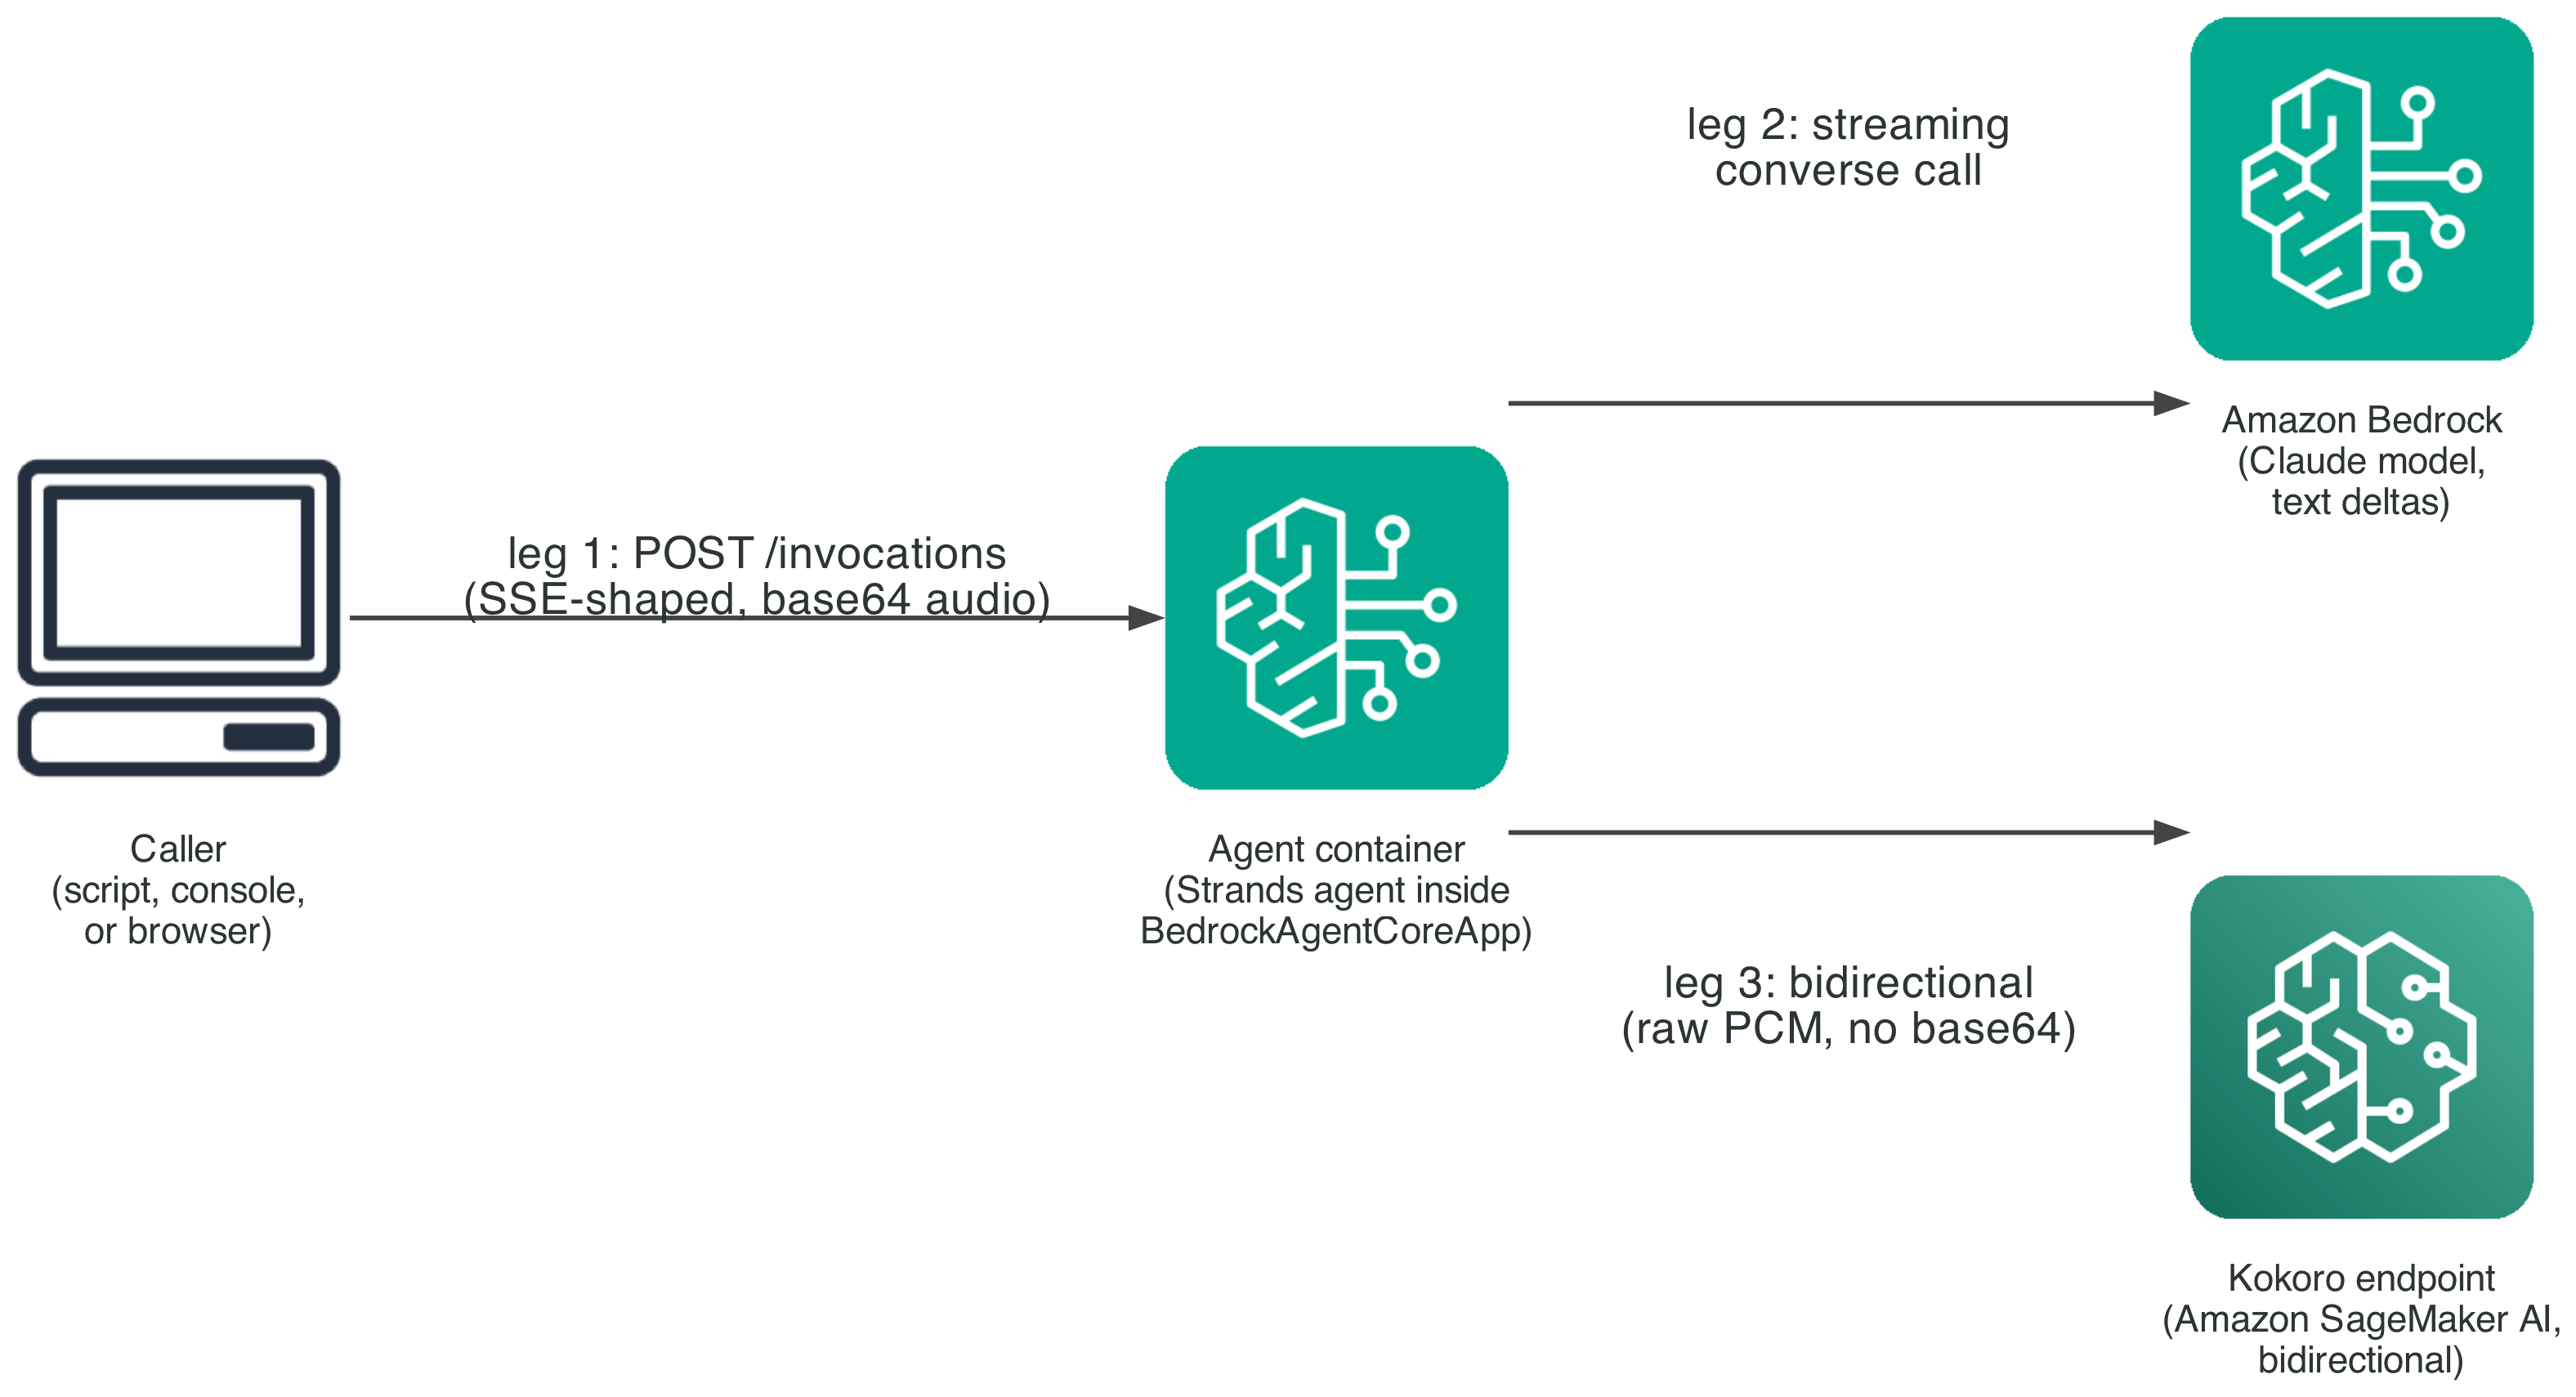
El caso más completo, de principio a fin, es un agente generador vivo que compone su respuesta ficha por ficha, sin forma de saber la cuarta oración hasta que exista la primera. Este ejemplo se ejecuta cuando un agente de Strands, respaldado por Amazon Bedrock, se implementa en el entorno de ejecución de Amazon Bedrock AgentCore y llama al punto final de Kokoro con el patrón del paso 4. En este diseño se conectan tres vías de comunicación: la que está orientada hacia el navegador y que devuelve los eventos enviados por el servidor a la persona que llama, la llamada en streaming del agente a Amazon Bedrock para generar texto y la sesión bidireccional del agente con el punto final de Kokoro para la síntesis
.
El siguiente diagrama muestra esos tres tramos de comunicación y dónde se produce la superposición entre la generación y la síntesis:
Figura 3: Los tres tramos de comunicación que conectan a la persona que llama, Amazon Bedrock y el punto final de Kokoro
La carga útil de la solicitud incluye un campo de modo, «bidi» o «por lotes», que se envía a dos rutas de código dentro de la misma función de punto de entrada. Un punto de referencia entre ellos cambia exactamente una variable: cuando comienza la síntesis. En run_bidi, dos tareas se ejecutan simultáneamente. Una agota el flujo de texto de Bedrock e introduce las frases completas en el fragmentador. El otro agota la sesión de Kokoro y emite fragmentos de audio a medida que llegan. Ambos forman una cola compartida, por lo que el consumidor muestra los eventos en el orden real de llegada: el audio de una frase temprana puede llegar a la persona que llama, mientras que Bedrock sigue generando una frase posterior. run_batch es lo contrario deliberado: espera a recibir la respuesta completa antes de realizar una llamada de síntesis,
manteniéndola como base justa.
En la otra dirección, el trayecto desde el contenedor del agente hasta la persona que llama usa base64, por una razón diferente a la descrita en el paso 4. El punto de entrada de BedrockAgentCoreApp debe generar diccionarios sencillos y serializables mediante JSON, que su SDK convierte automáticamente en datos: {json}\n\nframes. No hay forma de asignarle un marco binario sin procesar. Esto es una consecuencia del tiempo de ejecución gestionado de forma nativa de JSON, no de la opción que Step 4 midió y de la que se alejó. Tanto run_bidi como run_batch pagan el mismo coste en este tramo, por lo que la diferencia entre ambos es puramente temporal: cuando se emite
el primer fragmento de audio.
Pruebas y validación
Hemos aislado la contribución del transporte TTS a la hora de convertir el audio en primer lugar enviando el mismo bloque de texto de 267 caracteres y cuatro frases de dos maneras: como un mensaje (por lotes) y solo como la primera frase (incremental). Realizamos cinco ensayos cada uno con el criterio de valoración real
.
Como hemos observado anteriormente, enviar solo la primera frase redujo el tiempo medio hasta el primer byte de audio de 329,3 ms a 156,7 ms, lo que supone una mejora relativa del 52,4 por ciento, si se tiene en cuenta el propio transporte TTS.
A continuación, medimos el caso completo de principio a fin con un modelo de lenguaje real que producía el texto, y ejecutamos la misma línea de comandos en run_bidi y run_batch con el mismo modelo y punto final de Bedrock en vivo, de modo que la única variable es cuando comienza la síntesis.
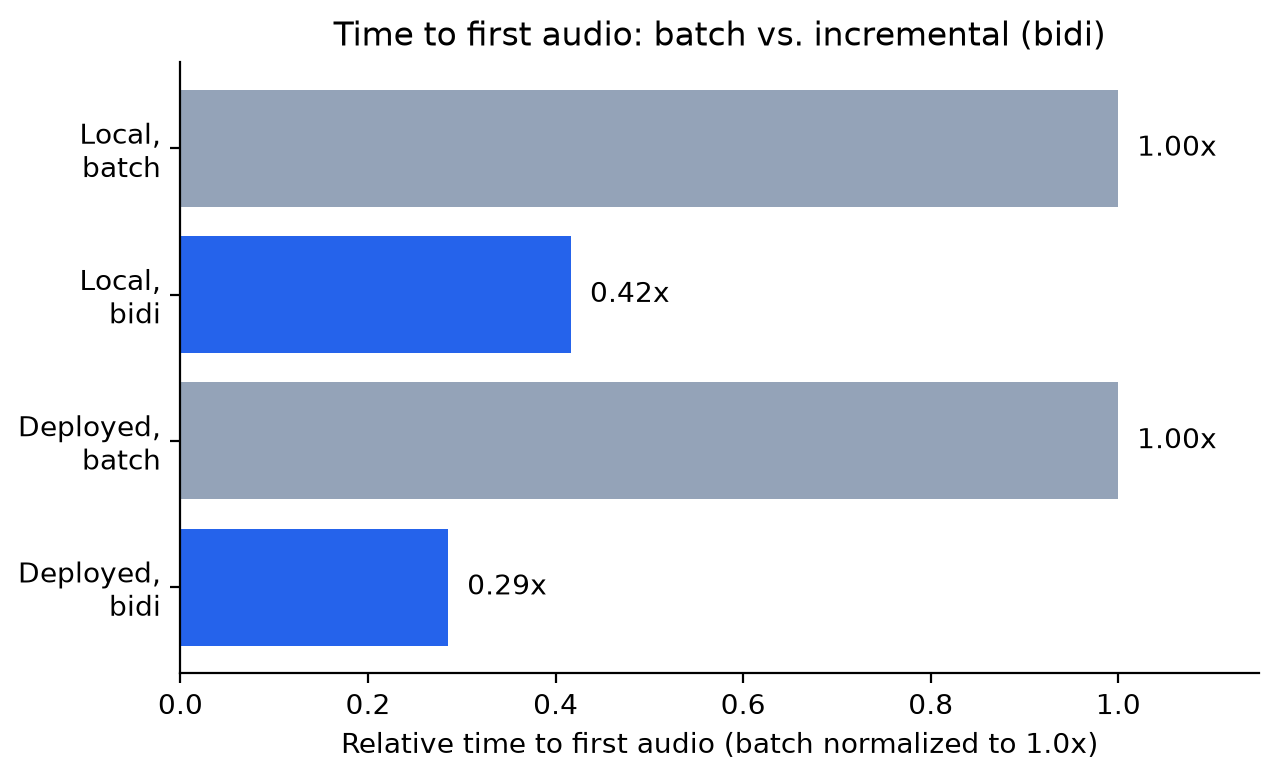
Con la misma metodología, el tiempo que tarda el modo bidi en emitir el primer audio fue 2,4 veces más rápido que en el modo por lotes con un contenedor local, y 3,5 veces más rápido con el tiempo de ejecución de AgentCore implementado.
El siguiente gráfico muestra esa brecha en ambos entornos:
Figura 4: Tiempo relativo hasta el primer audio para los modos por lotes y bidi, localmente y en el tiempo de ejecución implementado
La brecha se amplía, en lugar de reducirse, en el caso de implementación una vez que se agrega un salto de red real. run_bidi absorbe ese salto dentro de la superposición que ya está aprovechando entre la generación y la síntesis. run_batch no tiene una superposición equivalente para ocultar ese costo, ya que hace una cosa a la vez, por lo que cada milisegundo adicional de sobrecarga de red recae directamente en
su espera en serie.
Para reproducir esta comparación con su propia implementación, ejecute la misma prueba bidi-vs-batch que expone el contenedor del agente:
uv run agent-infra demo --endpoint-url --prompt "»
De este modo, el mensaje pasa por ambos modos e indica la fecha y hora del primer evento de audio_chunk comparándola con agent_start para cada uno de ellos. Si, en cambio, ves errores, comprueba si aparece el síntoma KeyError: 'text' del paso 1. Un terminal que notifica a InService cuando todas las solicitudes fallan es señal de que se trata de un error, no de un problema de implementación
.
Limpiar
Para evitar cargos continuos, elimine los recursos que crea este tutorial en orden de implementación inverso, primero el agente y luego el punto final:
uv run agent-infra destroy --bedrock-model-id
uv run speech-infra destroy kokoro-82m
agent-infra destroy elimina el recurso de ejecución de Amazon Bedrock AgentCore. speech-infra destroy elimina el modelo de IA, la configuración y el punto final de SageMaker. Tampoco vacía el bucket de Amazon S3 que almacena en caché los pesos del modelo ni elimina el repositorio de Amazon ECR que contiene la imagen del contenedor, ya que ambos se pueden compartir entre modelos. Si ya no los necesita, vacíe y elimine el bucket de Amazon S3 y elimine el repositorio de Amazon ECR manualmente, ya que un modelo almacenado en un punto de control y una imagen de contenedor seguirán generando pequeños gastos de almacenamiento hasta que se eliminen
.
Conclusión
Mostramos cómo eliminar una fuente de latencia evitable de un agente de voz, esperando la respuesta completa del agente antes de iniciar la síntesis de voz, y cómo cuantificar un segundo coste, más bajo: el audio codificado en base64 dentro del SSE infla la carga útil en aproximadamente un tercio y puede desalinearse con los límites de los fotogramas de MP3 si no se utiliza el búfer. La transmisión de cada frase a un punto final bidireccional de SageMaker AI tan pronto como un agente la produce reduce el tiempo de emisión del primer audio en más de la mitad de forma aislada, y entre 2,4 y 3,5 veces en un agente desplegado. La multiplexación del audio binario y de los fotogramas de control JSON durante esa sesión, en lugar de codificar el audio como texto, elimina la sobrecarga de tamaño y el trabajo de realineación de fotogramas
que requiere un relé SSE ingenuo.
Si va a añadir voz a un agente que ya transmite texto a través del SSE, comience con el enfoque en base64 del paso 4 y vuelva a utilizar el transporte unificado una vez que la latencia se convierta en la prioridad. Para obtener más información, consulte la documentación sobre inferencias en tiempo real de la IA de Amazon SageMaker y la documentación de Amazon Bedrock AgentCore. Si necesita ayuda para aplicar este patrón a su propia arquitectura, póngase en contacto con su equipo
de cuentas de AWS.
Acerca del autor
A customer asks an AI voice agent a question and waits. The agent already has an answer, it’s midway through generating a long, multi-paragraph response, but the customer hears nothing for five seconds. By the time an answer arrives, the customer is frustrated, confused, and no longer paying attention.
Text-to-speech integrations create exactly that gap. A one-sentence response might generate in 600 milliseconds, but the full response takes five seconds, and the integration waits for all of it before synthesis starts.
This post shows how to close that gap. We stream each sentence to a hosted Kokoro-82M text-to-speech (TTS) model on Amazon SageMaker AI as soon as an agent produces it, so synthesis begins on sentence one instead of the finished response. Getting that audio back to a browser needs its own solution too, so we also cover both transports for doing it and what each costs in practice.
Solution overview
This solution closes the gap by streaming synthesis alongside generation instead of waiting for it to finish. As the agent produces each sentence, that sentence streams immediately to a hosted Kokoro-82M text-to-speech model, so audio playback can start before the agent finishes speaking its full response. Kokoro-82M holds only 82 million parameters, small enough to run cheaply on a single mid-tier GPU instance. That keeps both latency and inference cost low for a voice agent handling real traffic.
Kokoro-82M runs in a custom container on a SageMaker AI real-time endpoint, on an ml.g5.xlarge GPU instance. The container exposes two routes: POST /invocations, which streams a response for one complete input, and WS /invocations-bidirectional-stream, which keeps one connection open across many messages in both directions.
The following diagram shows the request path from client to model:
Figure 1: Request path from the client to the SageMaker AI real-time endpoint over a bidirectional stream
Prerequisites
Before you begin, you need:
An AWS account with permissions to create SageMaker AI endpoints; AgentCore runtime, a capability of Amazon Bedrock AgentCore; AWS Identity and Access Management (IAM) roles; and an Amazon Elastic Container Registry (Amazon ECR) repository, including at minimum the sagemaker:CreateEndpoint, sagemaker:CreateEndpointConfig, sagemaker:CreateModel, sagemaker:InvokeEndpointWithBidirectionalStream, and bedrock:InvokeModelWithResponseStream actions.
The sample container pins an older PyTorch with a known advisory (PYSEC-2026-2286, fixed in torch 2.10.0). Review and upgrade the pin before any non-proof-of-value use.
A SageMaker AI real-time endpoint deployed from a container that declares the com.amazonaws.sagemaker.capabilities.bidirectional-streaming=true Docker label.
Python 3.12 or later, uv, and Docker to build the container image (the underlying HTTP/2 client only ships pre-built wheels for Python 3.12 and newer).
The AWS SDK for Python (Boto3) with support for invoke_endpoint_with_bidirectional_stream.
Familiarity with WebSockets and Starlette or a comparable ASGI framework.
The deployment code from the GitHub repository referenced in this post.
Walkthrough
The walkthrough first deploys the endpoint and agent, then works through the client-side changes that make incremental streaming work end to end.
Deploy the endpoint and agent
The Kokoro-82M endpoint and the agent runtime deploy through two CLI tools, each wrapping its own AWS CDK stacks:
uv run speech-infra deploy kokoro-82m
uv run agent-infra deploy --bedrock-model-id <your-bedrock-model-id>
speech-infra deploy provisions the Kokoro-82M endpoint. This includes the foundation and model-cache stacks that create the underlying IAM roles and sync the model’s weights into Amazon Simple Storage Service (Amazon S3). The endpoint stack then builds the container image and creates the SageMaker AI model, endpoint configuration, and endpoint. agent-infra deploy provisions the Amazon Bedrock AgentCore runtime hosting the Strands agent, which calls the endpoint you just deployed, so deploy the endpoint first.
Step 1: Handle the WebSocket frame type SageMaker AI actually sends
The bidirectional transport SageMaker AI uses delivers every piece of a client’s message to your container as a binary WebSocket frame. A common way to write a Starlette WebSocket handler is calling receive_text(), which reads message["text"] and raises KeyError if that key isn’t present. Because every message this client sends arrives as binary, that handler fails on every request.
The failure is commonly misdiagnosed. A generic exception handler that forwards str(e) to the client turns KeyError('text') into an error frame reading 'text', which looks like a missing field, not a framing issue. The endpoint itself reports InService throughout, since it accepts connections and responds to every message, with an error each time.
Accept either frame type explicitly instead of assuming one will show up:
from starlette.websockets import WebSocket, WebSocketDisconnect

async def _receive_message(websocket: WebSocket) -> str:
    message = await websocket.receive()
    if message["type"] == "websocket.disconnect":
        raise WebSocketDisconnect(message.get("code", 1000))
    payload = message.get("text")
    if payload is None:
        payload = message.get("bytes", b"").decode("utf-8")
    return payload
This decodes bytes as UTF-8 when no text field is present, rather than assuming one frame type. Test it by sending a binary frame, because this failure mode produces a well-formed error frame and a healthy endpoint status, not an obvious crash.
Step 2: Keep the session open between messages
After your container finishes synthesizing one message’s audio, the instinct is to close the session, the way an HTTP cycle ends. That’s wrong here. After sending a message’s audio and a synthesis_complete control frame, the container loop should go back to waiting on receive() for the next message on the same, still-open session. Close the connection only when the client sends an explicit {"type": "close"} message.
The following diagram shows one session carrying two sentences in sequence, closing only at the end:
Figure 2: One bidirectional session carrying two sentences in sequence, closing only at the end
This way, you can send several sentences, one after another, on one persistent session, with no reconnection cost between them. Closing eagerly after one response would force a new connection per sentence, undoing most of the latency benefit.
Step 3: Stream sentences as the agent produces them
With the session behavior in place, the client-side fix for the latency problem is a class that normalizes text arriving in two shapes: a complete string known up front, or a live token stream. It produces the same output either way: complete sentences, ready to send as soon as each one is complete.
import re

_SENTENCE_RE = re.compile(r"(?<=[.!?])\s+")


class IncrementalSentenceChunker:
    def __init__(self) -> None:
        self._buffer = ""

    def feed(self, fragment: str) -> list[str]:
        self._buffer += fragment
        parts = _SENTENCE_RE.split(self._buffer)
        if len(parts) == 1:
            return []
        self._buffer = parts[-1]
        return [s.strip() for s in parts[:-1] if s.strip()]

    def flush(self) -> str | None:
        remainder = self._buffer.strip()
        self._buffer = ""
        return remainder or None
Call feed() once per fragment of text as it arrives. It returns any newly completed sentences, holding back trailing text. Call flush() once, at the end of input, to release whatever partial text remains even without trailing punctuation. This keeps a stream that ends before a period arrives from dropping a final sentence.
This isn’t concurrent synthesis. Every bidirectional handler is a strictly sequential loop: receive a message, synthesize its audio, send that audio, send synthesis_complete, then receive the next message. Sentence two’s audio isn’t generated while sentence one’s still transmits. What incremental sending buys is narrower: synthesis on sentence one begins the instant it exists, rather than waiting for the full response. For a multi-sentence response with real generation time between its first and last sentence, that’s the entire latency win.
We verified this against a live endpoint sending a three-sentence input over one session. All three chunks arrived with audio matching the text sent for each:
Chunk
Text
Audio bytes
Duration (s)
1
“Hello there.”
73,200
1.525
2
“This is a post deployment check.”
108,000
2.250
3
“It has three sentences.”
98,400
2.050
Step 4: Choose a transport for getting audio back to the client
Streaming text into the model incrementally solves half the problem. The other half is getting the resulting audio out to whatever renders it, commonly a browser. Most agent and chat frontends already stream text over Server-Sent Events (SSE): one-directional, and supported natively by most browsers. SSE is a text protocol, not built to carry a raw binary payload. A team adding voice to an existing SSE pipeline naturally reaches for the pattern it already has: base64-encode the audio and wrap it in a JSON event.
We measured the cost of that approach across 24 clips, confirmed with Amazon Transcribe that quality didn’t differ across encodings, and compared MP3 against AAC:
Candidate
Raw bytes
Base64 bytes
Bitrate
Raw PCM
2,396,400
3,195,200
384 kbps
MP3 48k
308,304
411,072
49.5 kbps
AAC 32k fMP4
258,039
344,084
41.6 kbps
Base64 inflates every payload by close to the expected 33%. The subtler cost is frame alignment. SSE events are delimited by a blank line, but the audio inside is delimited into MP3 frames. The two schemes don’t necessarily align with how the transport chunks the data. In one measured response, four logical MP3 frames arrived as six delivery chunks, two ending mid-frame. A consumer that treats each delivery chunk as one complete unit fails on ordinary, healthy traffic. The fix buffers incoming bytes and acts only once a delimiter is found:
buffer = b""
for event in resp["Body"]:
    if "PayloadPart" not in event:
        continue
    buffer += event["PayloadPart"]["Bytes"]
    while b"\n\n" in buffer:
        frame, buffer = buffer.split(b"\n\n", 1)
        handle(frame)
The alternative used today for the model-facing leg skips base64 and SSE framing entirely. It multiplexes raw binary audio and JSON control frames over the same bidirectional session already carrying incremental text input, and tells them apart with one rule.
A chunk that fails to decode as a JSON object is audio, forwarded as received, with no encoding step anywhere in the path. One edge case matters: raw PCM audio can legitimately begin with byte 0x7b, the ASCII character {, the same character that opens a JSON object. This rule avoids misclassifying that audio because it requires the entire chunk to parse as valid JSON, not its first byte alone, something a PCM frame will essentially never do.
Note: If your frontend already has a working SSE pipeline for text, base64-encoded audio inside an SSE event is the pragmatic choice. It costs roughly 33 percent extra payload and a buffer-and-reassemble step, but reuses infrastructure you already operate. If you’re building the voice path fresh, or latency is the priority, the unified binary and JSON approach avoids both costs and reuses the connection already carrying text.
Step 5: Put it together in a real agent
The fuller, end-to-end case is a live, generative agent composing its response one token at a time, with no way to know sentence four until sentence one exists. This example runs as a Strands agent, backed by Amazon Bedrock, deployed to Amazon Bedrock AgentCore runtime, calling the Kokoro endpoint with the pattern from Step 4. Three communication legs connect in this design: the browser-facing leg carrying Server-Sent Events back to the caller, the agent’s streaming call to Amazon Bedrock for text generation, and the agent’s bidirectional session with the Kokoro endpoint for synthesis.
The following diagram shows those three communication legs, and where the overlap between generation and synthesis happens:
Figure 3: The three communication legs connecting the caller, Amazon Bedrock, and the Kokoro endpoint
The request payload carries a mode field, either "bidi" or "batch", dispatched to two code paths inside the same entrypoint function. A benchmark between them changes exactly one variable: when synthesis starts. In run_bidi, two tasks run concurrently. One drains the Bedrock text stream and feeds completed sentences into the chunker. The other drains the Kokoro session and emits audio chunks as they arrive. Both push into one shared queue, so a consumer yields events in true arrival order: audio for an early sentence can reach the caller while Bedrock still generates a later one. run_batch is the deliberate opposite: it waits for the full response before one synthesis call, kept as a fair baseline.
Going the other direction, the leg from the agent container back to the caller does use base64, for a different reason than Step 4 describes. BedrockAgentCoreApp’s entrypoint must yield plain, JSON-serializable dictionaries, which its SDK turns into data: {json}\n\n frames automatically. There’s no way to hand it a raw binary frame. That’s a consequence of the JSON-native managed runtime, not the choice Step 4 measured and moved away from. Both run_bidi and run_batch pay that identical cost on this leg, so the measured difference between them is purely timing: when the first audio chunk is emitted.
Testing and validation
We isolated the TTS transport’s own contribution to time to first audio by sending the same 267-character, four-sentence block of text two ways: as one message (batch), and as only its first sentence (incremental). We ran five trials each against the live endpoint.
As measured earlier, sending only the first sentence cut mean time to first audio byte from 329.3 ms to 156.7 ms, a 52.4 percent relative improvement, isolated to the TTS transport itself.
We then measured the fuller, end-to-end case with a real language model producing the text, running the identical prompt through run_bidi and run_batch against the same live Bedrock model and endpoint, so the only variable is when synthesis starts.
Using that same methodology, bidi mode’s time to first audio measured 2.4 times faster than batch mode against a local container, and 3.5 times faster against the deployed AgentCore runtime.
The following chart shows that gap across both environments:
Figure 4: Relative time to first audio for batch and bidi modes, locally and on the deployed runtime
The gap widens, rather than narrows, for the deployed case once a real network hop is added. run_bidi absorbs that hop inside the overlap it’s already exploiting between generation and synthesis. run_batch has no equivalent overlap to hide that cost in, since it does one thing at a time, so every added millisecond of network overhead lands directly on its serial wait.
To reproduce this comparison against your own deployment, run the same bidi-vs-batch test the agent container exposes:
uv run agent-infra demo --endpoint-url <your-endpoint-url> --prompt "<your prompt>"
This sends the prompt through both modes and reports the timestamp of the first audio_chunk event against agent_start for each. If you see errors instead, check for the KeyError: 'text' symptom from Step 1. An endpoint reporting InService while every request fails signals that bug, not a deployment issue.
Clean up
To avoid ongoing charges, tear down the resources this walkthrough creates in reverse deployment order, agent first, then endpoint:
uv run agent-infra destroy --bedrock-model-id <your-bedrock-model-id>
uv run speech-infra destroy kokoro-82m
agent-infra destroy removes the Amazon Bedrock AgentCore runtime resource. speech-infra destroy removes the SageMaker AI model, endpoint configuration, and endpoint. Neither empties the Amazon S3 bucket that caches model weights or deletes the Amazon ECR repository holding the container image, since both can be shared across models. If you no longer need them, empty and delete the Amazon S3 bucket and remove the Amazon ECR repository manually, since a stored model checkpoint and container image continue to incur small storage charges until removed.
Conclusion
We showed how to remove one source of avoidable latency from a voice agent, waiting for an agent’s full response before starting speech synthesis, and how to quantify a second, quieter cost: base64-encoded audio inside SSE inflates payload by about a third and can misalign with MP3 frame boundaries if you don’t buffer for it. Streaming each sentence into a SageMaker AI bidirectional endpoint as soon as an agent produces it cut time to first audio by more than half in isolation, and by 2.4 to 3.5 times in a deployed agent. Multiplexing binary audio and JSON control frames over that session, instead of encoding audio as text, removes the size inflation and frame-realignment work a naive SSE relay requires.
If you’re adding voice to an agent that already streams text over SSE, start with the base64 approach in Step 4 and revisit the unified transport once latency becomes the priority. To learn more, see the Amazon SageMaker AI real-time inference documentation and the Amazon Bedrock AgentCore documentation. If you’d like help applying this pattern to your own architecture, contact your AWS account team.
About the author
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.