
Los equipos empresariales están construyendo sistemas multiagente, y cuando las implementaciones iniciales no cumplen con las expectativas, la causa rara vez es el modelo. La coordinación multiagente es un problema de sistemas distribuidos, y muchos equipos que lo intentan no han desarrollado aún instintos de sistemas distribuidos.
Los números son consistentes en todas las fuentes: ~88% de los pilotos de IA nunca llegan a producción. Stanford HAI demostró que dos modelos pueden funcionar peor en colaboración que cada uno por separado cuando la sobrecarga de coordinación supera el beneficio. El patrón es claro: los equipos están agregando complejidad más rápido de lo que construyen comprensión. Diez pasos que cada uno es 95 por ciento fiables entregan solo 59.9 por ciento de confiabilidad de extremo a extremo, y 20 pasos entregan 35.8 por ciento. Este modelo ilustrativo asume una cadena secuencial estricta con ningún reintento, pero la dirección se mantiene: cada entrega dependiente multiplica el riesgo.
En esta publicación, aprende cómo decidir si un caso de uso necesita múltiples agentes, elegir un patrón de coordinación y detectar anti-patrones costosos temprano. También verás cómo el tiempo takt, los límites de seguridad, los datos de borde y los ciclos de cambio dan forma a la arquitectura.
Patrones de coordinación multiagente
Los patrones de coordinación se dividen en dos niveles, según quién controle el flujo. En el Nivel 1, defines la ruta.
En el Nivel 2, el modelo elige la ruta en tiempo de ejecución. Esa flexibilidad maneja el trabajo cuyos pasos no puedes definir con anticipación, a un costo más alto en tokens, latencia y depuración. El valor predeterminado práctico es comenzar con el Nivel 1 y mover una tarea al Nivel 2 solo cuando sus subtareas surjan durante el trabajo.
Nivel 1: Patrones (flujo de control determinista)
1.1 Pipeline secuencial: Patrones de orquestación que implementan ejecución lineal donde la salida de cada nodo se alimenta al siguiente nodo (A -> B -> C) que admite procesamiento ordenado con tiempo de ejecución predecible
En el siguiente diagrama, el flujo de entrada va al agente A (extracción), luego al agente B (transformación), luego al agente C (validación) y luego la salida. El usuario define ese orden en el momento de la compilación, y nada se decide en tiempo de ejecución. Como resultado, la pipeline es sencilla de depurar y probar, y su costo es predecible. Los ajustes típicos incluyen procesamiento de documentos, cadenas de extracción, transformación y carga (ETL) y triage de reclamaciones de garantía.
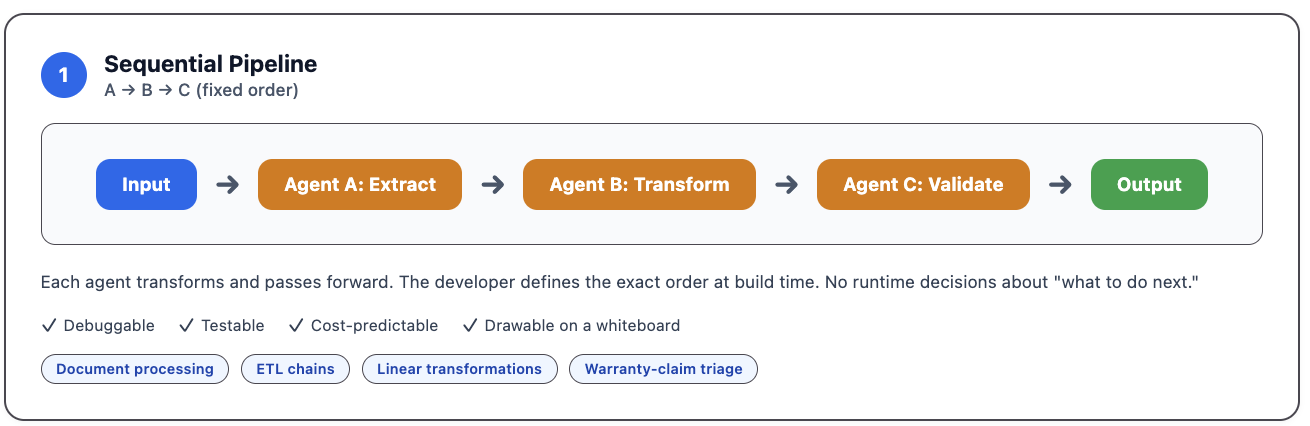
Figura 1: Tubería secuencial donde la salida de cada agente alimenta al siguiente, desde la extracción hasta la transformación y la validación
1.2 Flujo de trabajo condicional: Los bordes lógicos seleccionan el siguiente nodo según una condición, por lo que el flujo de trabajo puede ramificarse y enviar cada caso por un camino diferente.
En el siguiente diagrama, una solicitud del usuario va al agente A (escribir código) y luego al agente B (probar código). Una verificación de aprobado/reprobado envía el trabajo aprobado al agente D (implementar). El trabajo que no aprueba se devuelve al agente A para una repetición, hasta un máximo de N veces, y luego se escala a un humano. La capa de orquestación hace cumplir ese límite, por ejemplo, a través de un límite de iteración de AWS Step Functions, que evita que el bucle se convierta en el anti-patrón de iteración ilimitada descrito más adelante en esta publicación.
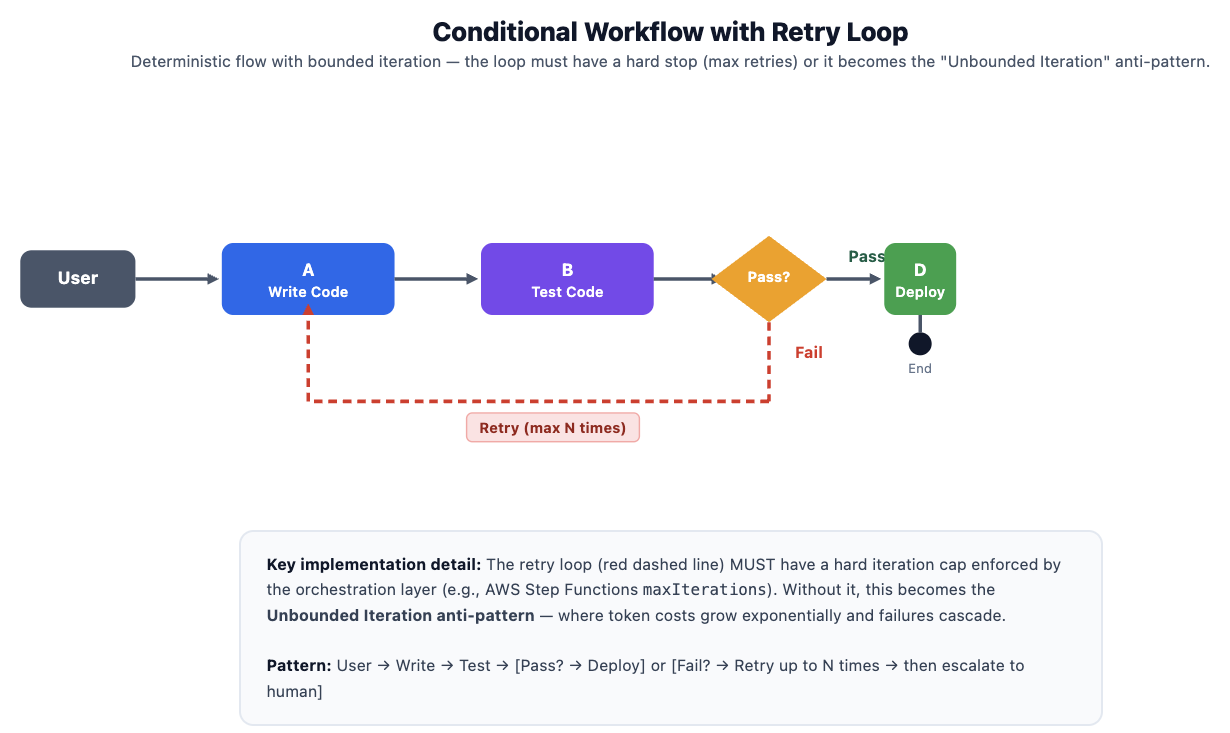
Figura 2: Flujo de trabajo condicional que repite los fallos hasta N veces antes de escalar a un humano
1.3 Enrutador condicional:
Un paso de clasificación examina la entrada y la dirige al camino de procesamiento adecuado. Solo se ejecuta un camino por solicitud. Ideal para la asignación de intención, las decisiones de calidad, la ruta de consulta del cliente y la triage de anomalías.
El siguiente diagrama muestra una solicitud del supervisor de la planta que es leída por un clasificador y enviada a exactamente un especialista. Las preguntas sobre si las piezas cumplen con las especificaciones van al Agente de Calidad, los servicios de equipo atrasados van al Agente de Mantenimiento, y los cambios de turno van al Agente de Programación. Esta decisión se toma en el punto de entrada.
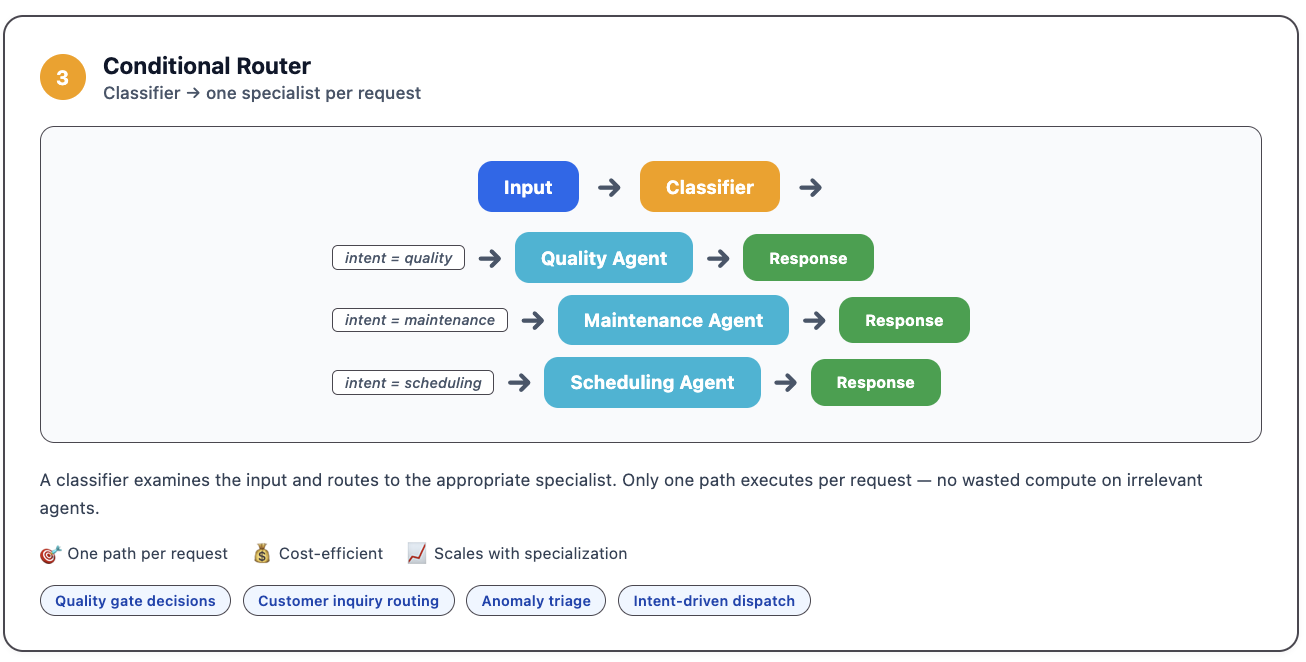
Figura 3: Enrutador condicional que ejecuta una ruta por solicitud, con reintentos limitados antes de la escalación humana
1.4 Flujo de trabajo paralelo: Una tarea se divide en subtareas independientes que se ejecutan simultáneamente en handlers, cada una con sus propios datos. Un paso de fan-in combina los resultados cuando todos los handlers completan, y un fallo en una ruta solo reintenta esa ruta. Ideal para análisis de múltiples fuentes, procesamiento por lotes y trabajo que se descompone en piezas independientes.
En el siguiente diagrama, un orquestador de investigación descompone la tarea y la envía a tres agentes especialistas que se ejecutan concurrentemente: un agente de datos financieros, un agente geopolítico y un agente logístico, cada uno analizando su propia fuente. Un paso combinado espera a los tres, luego sintetiza los resultados, resuelve conflictos y clasifica los hallazgos. La latencia es igual a la del agente más lento en lugar de la suma de los tres.
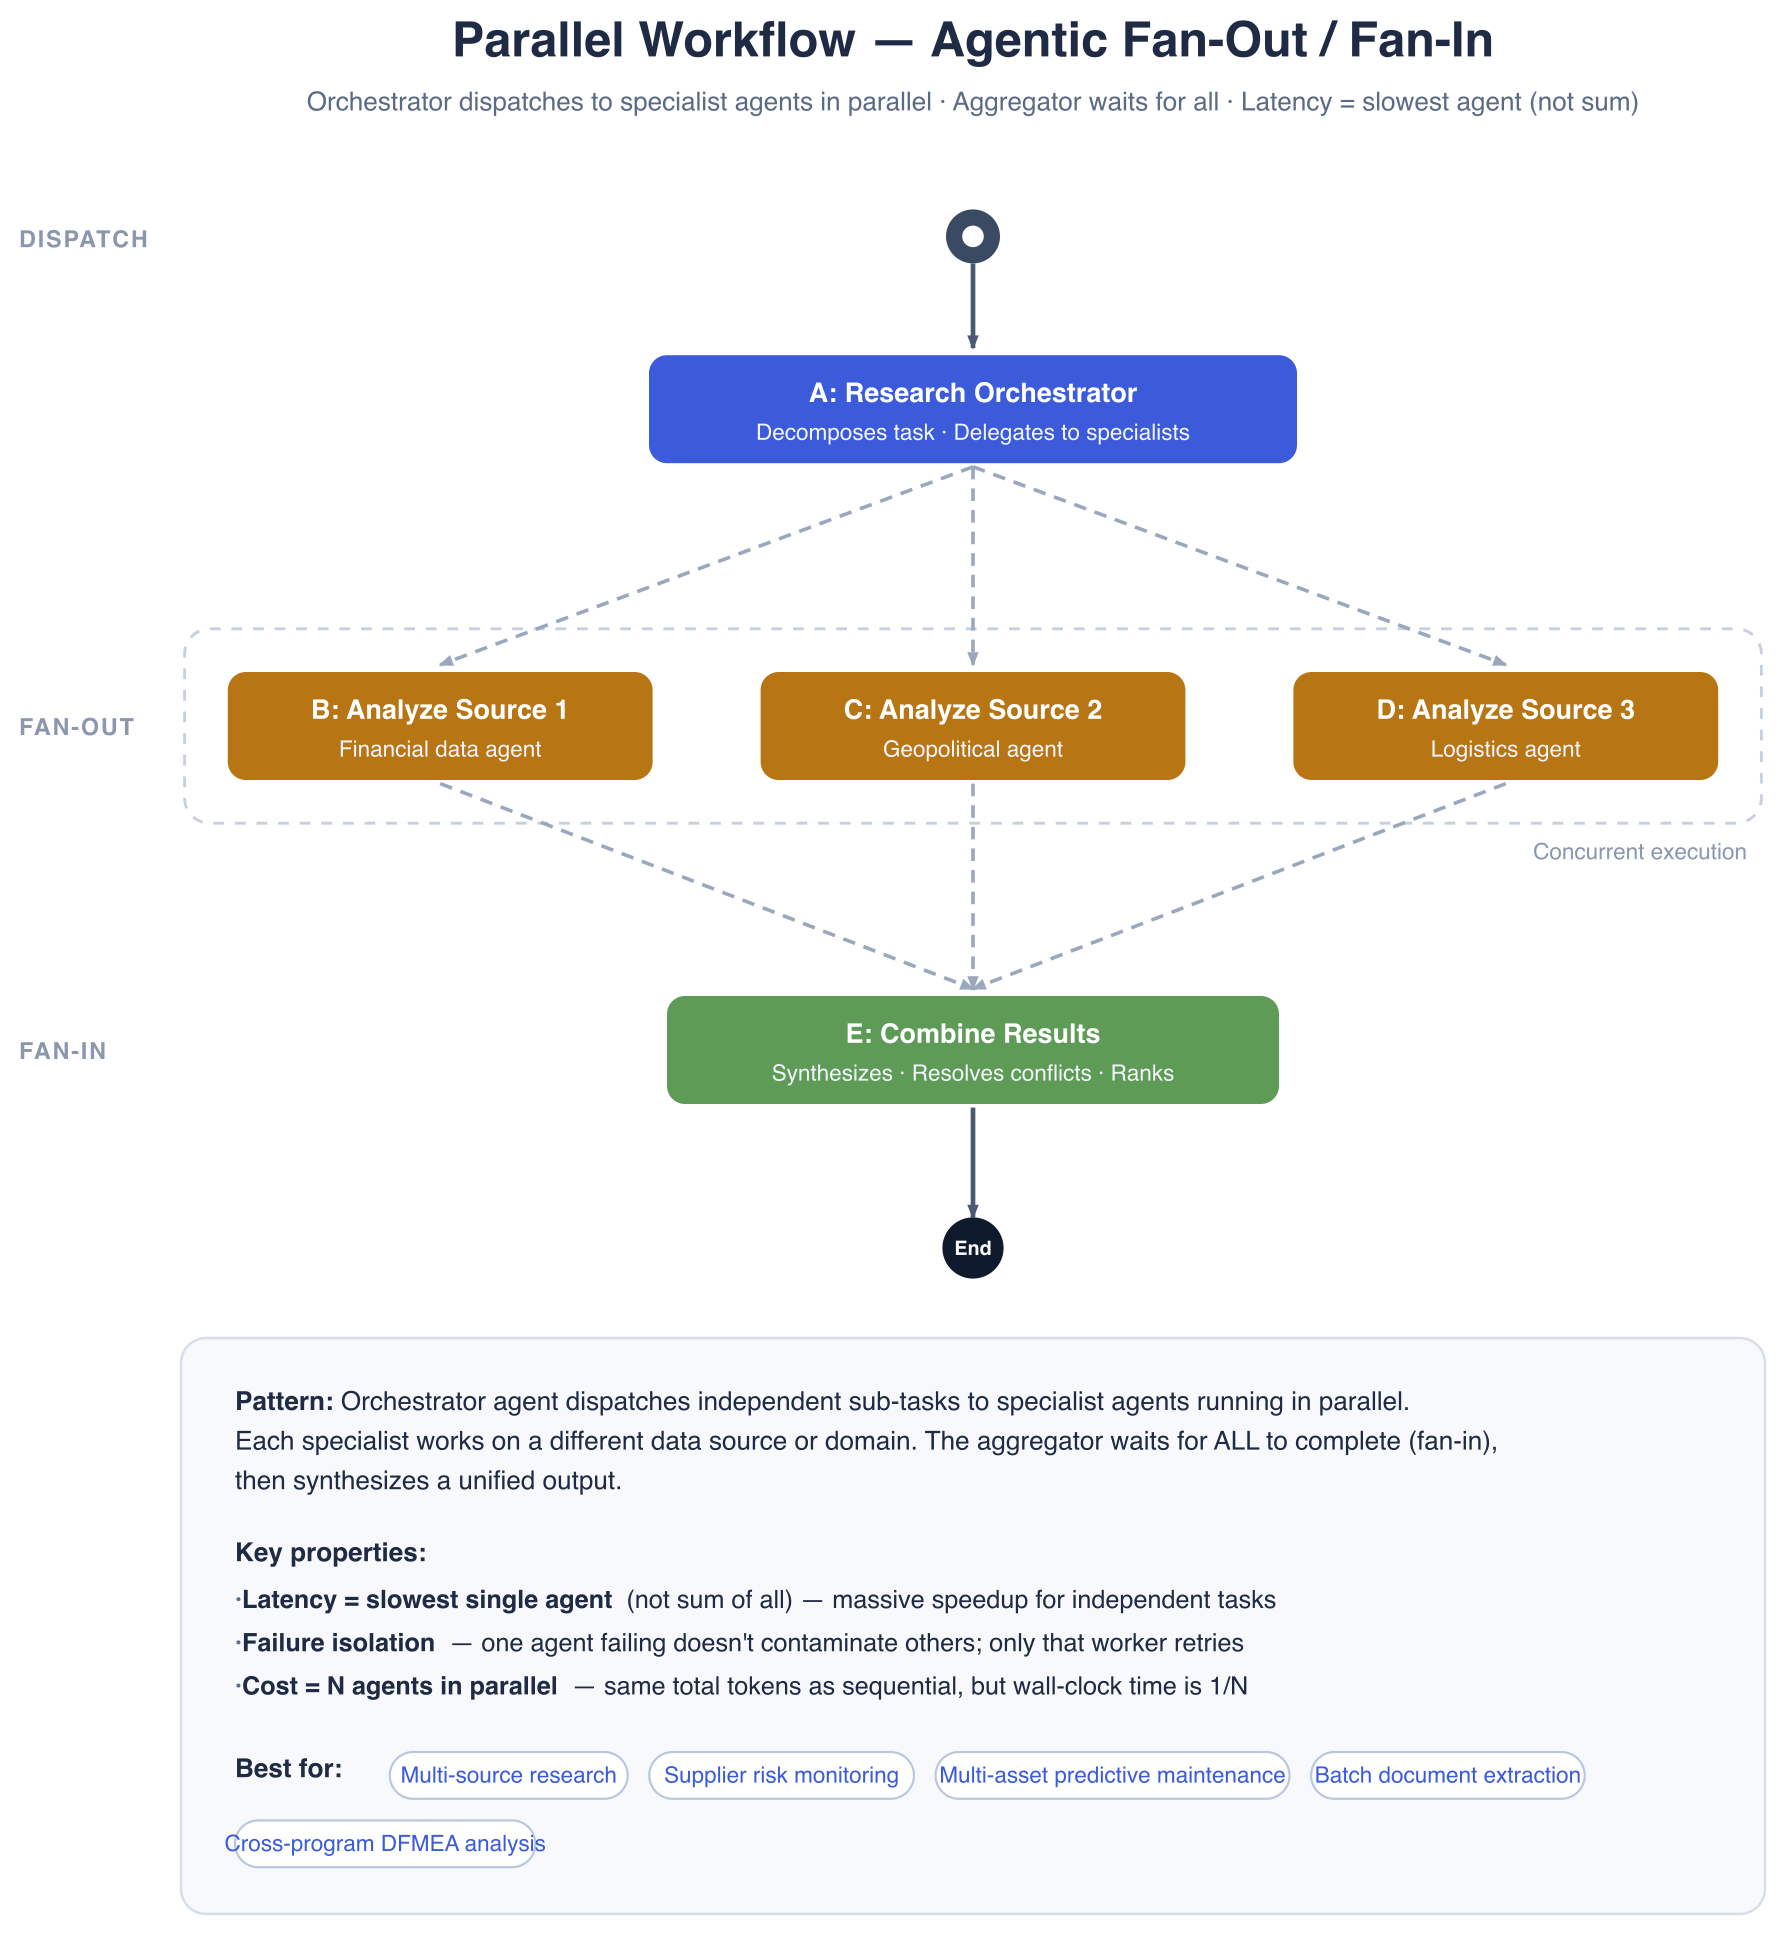
Figura 4: Ramificación paralela a agentes especialistas seguida de un paso de fan-in que sintetiza y clasifica los resultados
Nivel 2: Patrones autónomos (flujo de control determinado por LLM)
En patrones autónomos, el flujo de control se determina en tiempo de ejecución por el modelo de IA en sí, no predefinido por los desarrolladores. Los agentes leen el estado de la tarea, razonan sobre lo que se necesita y coordinan a través de un contexto compartido en lugar de rutas fijas que abarcan un espectro desde la orquestación estructurada hasta el comportamiento completamente emergente.
2.1 Orquestación basada en planes
En la orquestación basada en planes, un solo agente orquestador actúa como gerente de proyecto. El orquestador mantiene un plan de tarea explícito con asignaciones y dependencias, ve todo el contexto mientras cada worker recibe solo su parte, distribuye el trabajo dinámicamente contra el plan actual y monitorea el progreso centralmente. La elección de diseño clave es que los workers son estadoless e independientes. Si uno falla, no contamina a los demás. El orquestador reintenta solo el worker fallido, no todo el flujo de trabajo.
El siguiente diagrama muestra cómo un agente planificador descompone una tarea en un plan explícito y envía cada paso a un agente de trabajo. Cada paso va a un trabajador dedicado (un agente de investigación, un agente de análisis y un agente de informes) que solo ve su rebanada asignada.
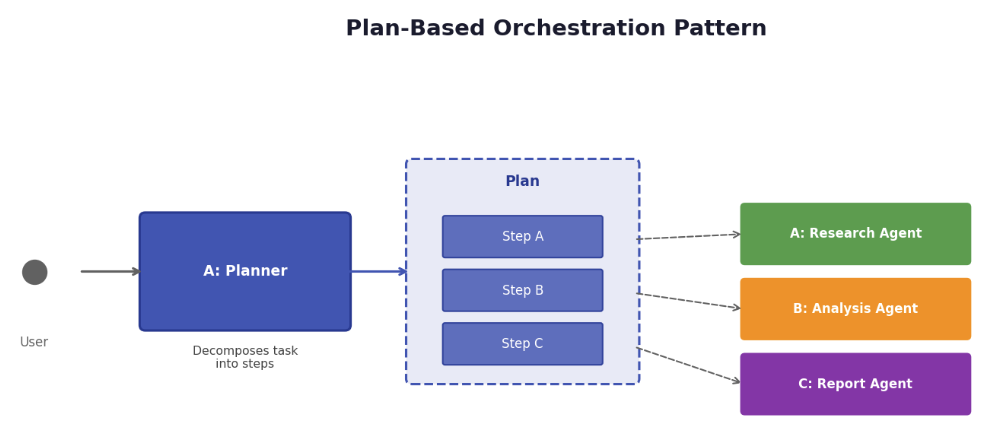
Figura 5: Orquestación basada en planes con un agente planificador que asigna cada paso a un agente de trabajo sin estado
2.2 Patrón de entrega
Los agentes operan con conocimiento limitado y local, y coordinan a través de la delegación entre pares. Cada uno toma decisiones locales sobre cuándo y a quién transferir el control, en función de la tarea y los agentes que conoce. El control pasa con el estado: cada transferencia lleva el estado de la tarea validado, la evidencia detrás de él y cualquier pregunta sin resolver, para que el agente receptor continúe en lugar de reinterpretar un resumen. Una entrega que solo se mueve a través de la conversación no es una entrega.
En el siguiente diagrama, un agente de servicio al cliente transfiere el control, junto con su contexto, a un agente de soporte técnico o a un agente de facturación, y el soporte técnico puede entregar aún más a un ingeniero senior. Cada agente solo conoce el pequeño conjunto de pares a los que puede transferir.
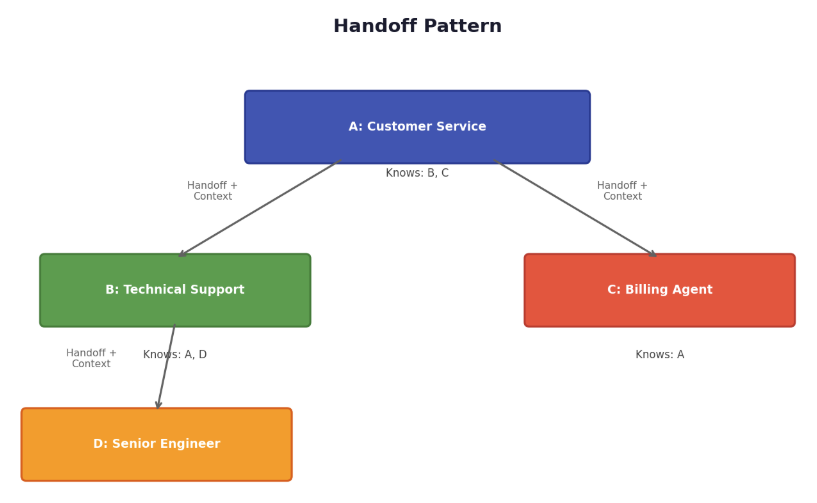
Figura 6: Patrón de entrega que pasa el estado validado entre agentes pares a través de la delegación local
2.3 Patrón impulsado por conversación
En los patrones impulsados por conversación (también conocidos como patrones de chat grupal), todos los agentes participan en una conversación compartida donde la orquestación emerge a través de la toma de turnos en lugar de planes explícitos o entregas estructuradas. Esto refleja la colaboración de equipo humano donde todos pueden ver la discusión y contribuir cuando corresponda.
En el siguiente diagrama, un mecanismo de selección de agente decide de quién es el turno, y los agentes A, B y C cada uno agregan a una conversación compartida, donde cada turno es un mensaje más una llamada a una herramienta. El mecanismo de selección establece la toma de turnos, y el estado vive implícitamente en el historial de conversación.
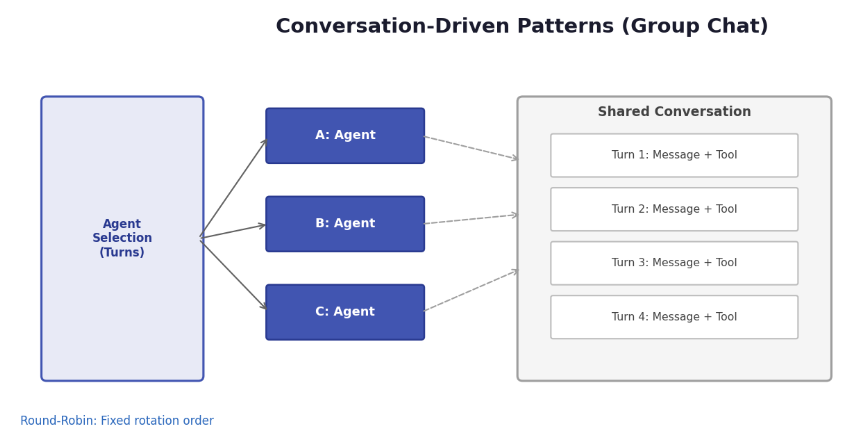
Figura 7: Patrón impulsado por conversación donde la selección de turnos selecciona el próximo agente y el estado vive en la conversación
Características de flujo de control:
- Visibilidad: Todos los agentes observan todos los mensajes en la conversación compartida.
- Toma de decisiones: El próximo hablante se selecciona en función del contexto de la conversación, no de planes preestablecidos.
- Administración de estado: Implícito en el historial de la conversación.
- Turnos: Determinado por mecanismos de selección (round-robin, impulsado por AI)
- Round-robin. Los agentes toman turnos en un orden fijo y repetitivo hasta que se cumple una condición de terminación, lo que lo mantiene predecible.
- Impulsado por AI. Un modelo selecciona al próximo hablante del contexto de la conversación en lugar de un orden fijo.
2.4 Debate/consenso
Múltiples agentes evalúan de forma independiente la misma entrada, y sus conclusiones se reconcilian por mayoría, por un agente juez o por escalada cuando no están de acuerdo. A diferencia de un patrón impulsado por conversación, los agentes no ven la razón de los demás antes de comprometerse con una posición, lo que hace que el desacuerdo sea informativo en lugar de convergente socialmente.
Úselo con moderación. El debate es el patrón más costoso aquí, y en tareas perceptuales compra latencia en lugar de precisión (ver el caso de inspección de calidad en el anti-patrón 3 que sigue). Resérvelo para decisiones de alto riesgo, baja volumen donde estar equivocado cuesta más que deliberar.
Enfoques híbridos
En la práctica, la mayoría de los sistemas de producción combinan varios patrones en función de la descomposición de tareas:
- Utilice patrones de flujo de trabajo para componentes predecibles y bien entendidos.
- Aplique patrones autónomos donde la flexibilidad y la adaptación son esenciales.
- Implemente patrones de administración de tareas (terminación, delegación) de forma consistente en todos los tipos de orquestación.
- Diseñe composiciones jerárquicas donde los agentes complejos utilizan internamente diferentes patrones en diferentes capas.
El principio rector: alineación de patrón a tarea. Asegúrese de que el enfoque de orquestación se ajuste a las características inherentes de cada tarea y a los requisitos de confiabilidad del sistema en lugar de forzar todo a través de un solo patrón.
Anti-patrones que queman presupuesto
Cada uno de los siguientes cinco anti-patrones parece razonable en el momento del diseño y cada uno se manifiesta más tarde como un costo de token inflado, una ventana de takt-time perdida o una decisión que ha salido silenciosamente de sincronización con el piso de la planta.
1. Agente divino
Un agente posee el análisis de eficacia general del equipo (OEE), la diagnóstica del controlador lógico programable (PLC) y el mantenimiento detrás de una sola invitación con 15 o más herramientas. La selección de herramientas se degrada a medida que crecen las herramientas y los fallos se vuelven difíciles de atribuir.
La solución: Agentes limitados de cinco herramientas o menos, como un analista de OEE, un diagnostico de fallas y un redactor de mantenimiento.
2. Iteración ilimitada
El agente bucla en “inténtalo de nuevo” sin parada dura. Un sistema de cuatro agentes puede quemar un número significativamente mayor de tokens antes de un solo reintento, y ninguna llamada activa una alarma. Los reintentos multiplican los fallos de coordinación en lugar de solucionarlos.
La solución: Techo de iteración duro en el código, techo de token por agente, alarma de presupuesto conectada a una parada automática. La infraestructura hace cumplir los límites. El modelo no se detendrá por sí solo.
3. Contratos de lenguaje natural
Los agentes se pasan prosa de texto libre entre sí sin esquema. La interpretación se endurece en cada salto: “podría indicar desgaste” se convierte en “desgaste confirmado” y se convierte en una orden de mantenimiento. La deriva ocurre entre agentes, donde el seguimiento es más delgado.
4. Multi-agente prematuro
Multi-agente donde un agente con grupos de herramientas sería suficiente. Cada agente agrega un impuesto de coordinación que no es lineal, y las ganancias se aplanan alrededor de cuatro. La mayoría de los “especialistas” son un modelo en diferentes disfraces.
La solución: Necesita al menos dos modelos diferentes, acceso a herramientas diferentes, ejecución concurrente y verdadera interdependencia. Menos de dos, y un agente con grupos de acción lo hace.
La prueba: ¿puede un agente manejar las fases cambiando herramientas? Entonces no es un problema de multi-agente.
5. Contacto con el cliente sin protección
El agente desencadena acciones del mundo real (correo electrónico, visitas de servicio, parámetros de máquina) sin paso de aprobación. Las alucinaciones cruzan al mundo físico, las acciones irreversibles se acumulan y la responsabilidad aumenta desde un reembolso hasta la responsabilidad del producto.
La solución: Defensa en profundidad: recomendación → Amazon Bedrock Guardrails → validación de esquema → reglas de negocio → aprobación humana → ejecución.
Cada punto donde la salida del agente llega a un cliente o a un sistema de seguridad es un límite de confianza.
Elección de una arquitectura
Con los patrones y anti-patrones en vista, la elección de la arquitectura se reduce a una breve secuencia de preguntas.
- ¿La tarea requiere acción más allá de la generación de texto? Trate una llamada directa al modelo como la línea de base y agregue orquestación solo por una razón medida. Resumir documentos o generar código a partir de una especificación rara vez suministra uno.
- ¿Se conoce de antemano la ruta de la solución? Si puede escribir lo que sucede en qué orden, no tiene una decisión de "cuántos agentes" en absoluto. Su verdadera elección es más simple: un agente único que llama a herramientas, o un flujo de trabajo de Tier 1.
- ¿Requiere el trabajo una experiencia genuinamente distinta? Dominios separados con entregas establecidas justifican agentes especializados. Un dominio único pertenece a un agente, sin importar cuántas herramientas necesite.
- ¿Surge la solución solo a través de la exploración? Cuando la secuencia de acciones es conocida y puede ejecutarse como un bucle de actuar y validar, pertenece a un agente único, incluso uno que planifica sus pasos de forma dinámica. Tier 2 justifica su costo agregado, latencia y carga de depuración solo cuando las subtareas en sí mismas se descubren en el curso del trabajo.
El siguiente árbol de decisión convierte estas cuatro preguntas en una ruta que puede seguir de arriba a abajo.
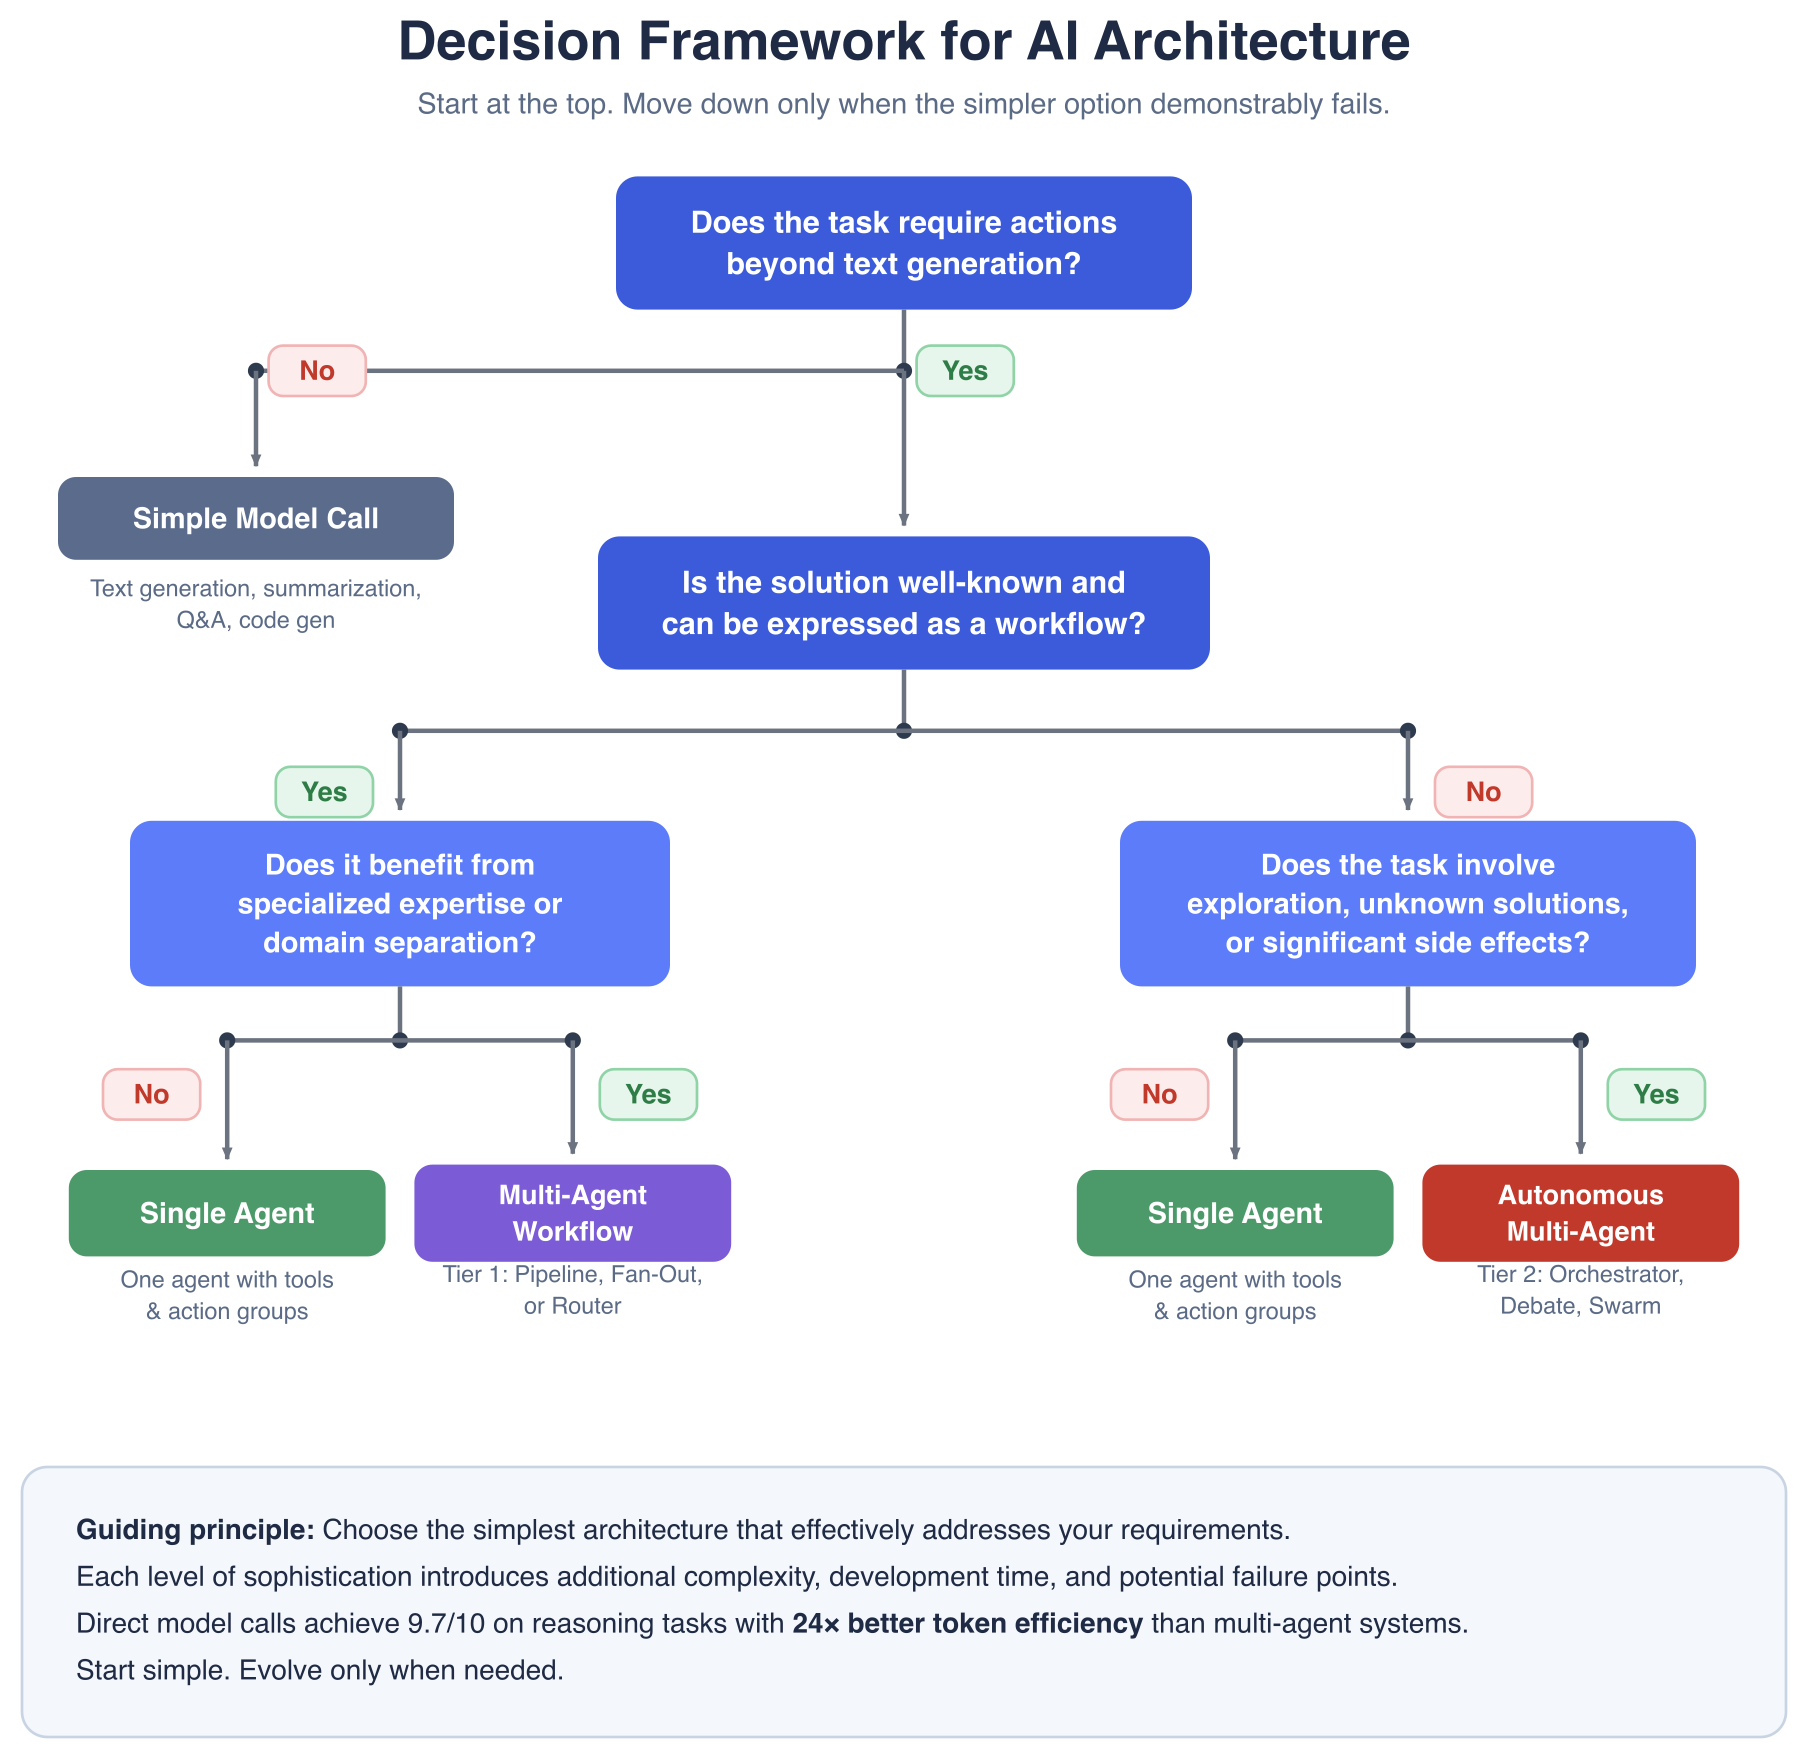
Figura 8: Árbol de decisión para elegir la arquitectura más simple, desde una llamada a un modelo hasta un patrón de múltiples agentes de Tier 2
El árbol comienza preguntando si la tarea requiere acciones más allá de la generación de texto. Si no es así, una llamada simple al modelo es suficiente. Si lo hace, el árbol pregunta si la solución es bien conocida y se puede expresar como un flujo de trabajo. En el lado de la solución conocida, el trabajo que se beneficia de la experiencia especializada o la separación de dominios va a un flujo de trabajo de múltiples agentes de Tier 1 (una pipeline, fan-out o router). Todo lo demás va a un agente único con herramientas y grupos de acción. En el lado de la solución desconocida, solo las tareas que involucran exploración o efectos secundarios significativos van a Tier 2 para patrones de múltiples agentes autónomos. El resto se queda con un agente único. El principio rector es elegir la arquitectura más simple que cumpla con sus requisitos.
La siguiente tabla compara los patrones en cuatro aspectos: cuándo recurrir a cada uno, cómo fluye el control entre los agentes, cuán determinista es el resultado y qué cuesta construir y operar. El costo de construcción es una escala relativa, no una estimación.
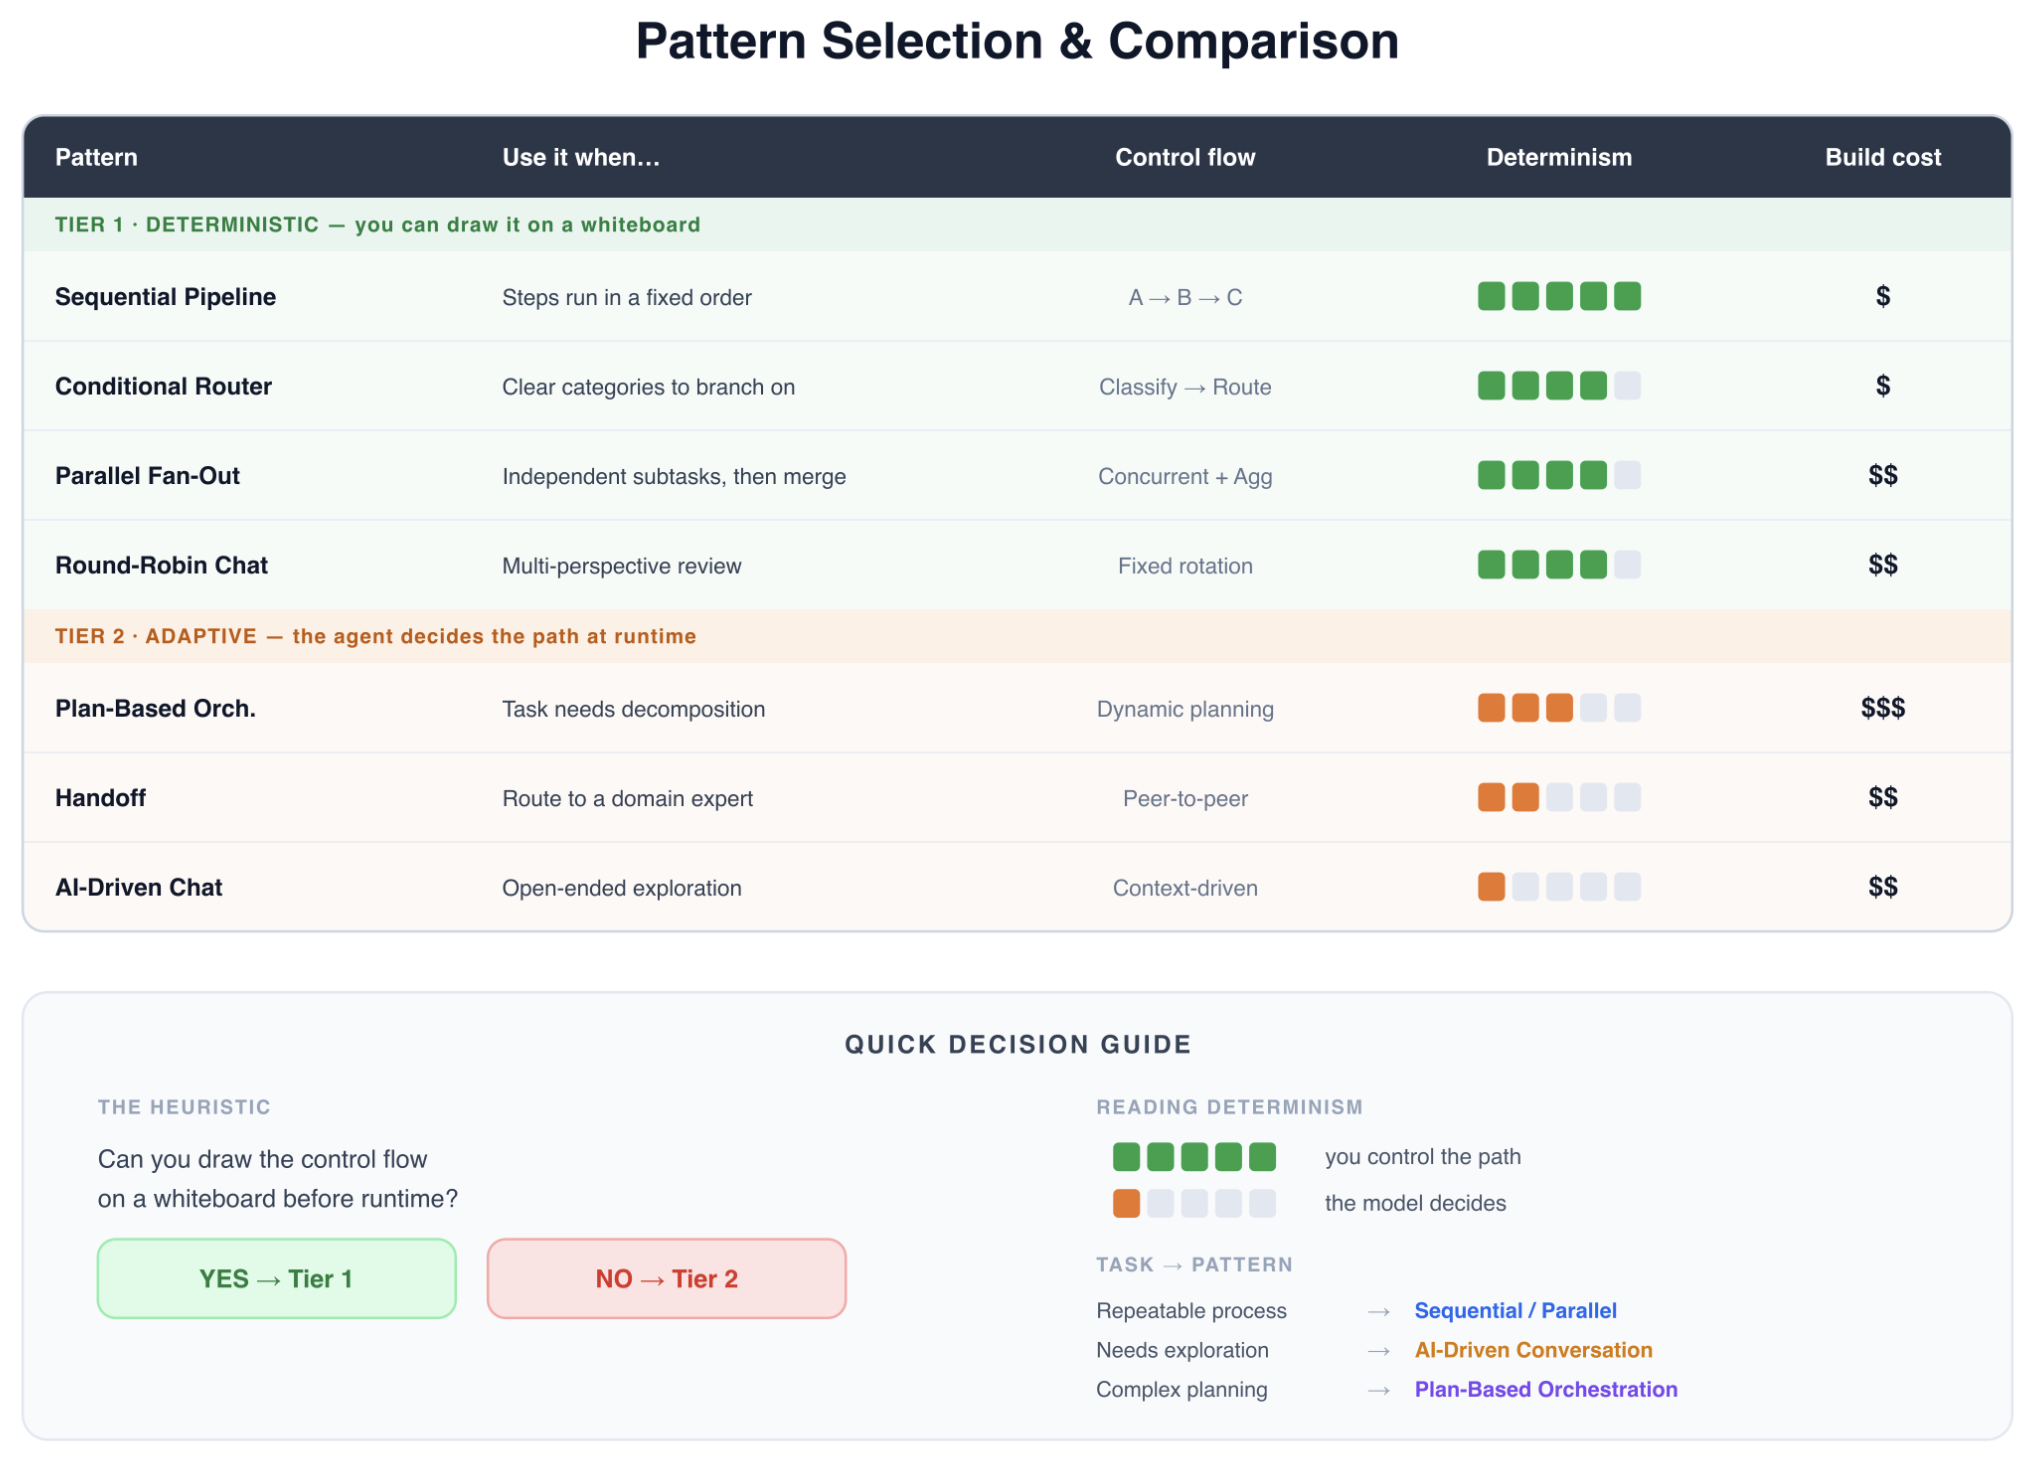
Figura 9: Comparación de los patrones según caso de uso, control de flujo, determinismo y costo de compilación relativo
Los patrones de nivel 1 obtienen puntuaciones altas en determinismo a un costo de compilación bajo o moderado. Los patrones de nivel 2 dan más del camino al modelo, y la orquestación basada en planes tiene el costo más alto de compilación. Si puedes dibujar el control de flujo en una pizarra antes del tiempo de ejecución, comienza con el nivel 1.
Aplicado: Asignación de patrones a casos de uso de fabricación
| Caso de uso | Patrón | Razón |
| Resumen de entrega de turno | Secuencia de Pipeline | Lineal: registros crudos → resumen → informe |
| Análisis de causa raíz en múltiples estaciones | Orquestador basado en planes | Dinámico: subtareas descubiertas durante el análisis |
| Puerta de calidad en tiempo real | Enrutador condicional + Agente de borde | En ciclo: el modelo local decide. Razonamiento del agente fuera del camino |
| Programación de mantenimiento predictivo | Paralelo de ventilador hacia afuera/ventilador hacia adentro | Modelos independientes por clase de activos |
| Impacto de la orden de cambio de ingeniería | Debate/Consenso | Apuestas altas: revisión adversaria justificada |
| Borrador de comunicación con proveedores | Secuencia + Puerta humana | No debe autoenviar (ver contacto de cliente no protegido) |
| Optimización entre plantas | Orquestador basado en planes | Multifuente: consultas dinámicas. El solucionador realiza la asignación |
La lente de fabricación: Cuatro restricciones que cambian el cálculo
La fabricación no es un entorno genérico de TI empresarial, y cuatro restricciones hacen que esa aritmética sea implacable.
Restricción 1: Latencia de la línea de producción = pérdida de ingresos directa
Talleres de carrocerías automotrices, donde los robots soldan el cuerpo del vehículo, suelen funcionar a 60 trabajos por hora. Cada una de sus más de 40 estaciones tiene un tiempo de takt de 60 segundos antes de que avance la línea. La latencia de inferencia que se encuentra en el camino de ciclo de una estación se come esos 60 segundos, y un retraso en la estación cuello de botella ralentiza toda la línea. Incluso una reducción del 2 por ciento en el rendimiento puede traducirse en un impacto significativo en los ingresos anuales.
Implicación de la arquitectura: presupuestar la latencia en p99, no en promedio. La cola es lo que detiene la línea. Dar a cada agente un fallback determinista en menos de un segundo y hacer que coincida con el riesgo:
- Asesoramiento/indicación de calidad: Pasar la pieza con una bandera para revisión al final de la línea.
- Critico para la seguridad: Contención o una parada determinista, no continuación.
- Decidir este mapeo por estación antes de la implementación.
Restricción 2: La seguridad tiene consecuencias físicas
Un chatbot alucinado causa vergüenza. Un parámetro de soldadura alucinado causa defectos estructurales que se manifiestan en pruebas de choque o fallas en el campo y pueden llevar a un recall de seguridad. Dos modos de falla se repiten:
- Estado de desincronización de la frontera OT/IT: Un agente lee el sistema de ejecución de manufactura (MES) como la Estación 12 que ejecuta la Parte #A, pero una anulación manual de PLC ya lo cambió a la Parte #B, por lo que ajusta los parámetros para la parte incorrecta.
- Frontera de seguridad alucinada: Un agente de mantenimiento razona sobre el bloqueo/etiquetado desde cero y declara que la Estación 7 es accesible mientras la Estación 6 adyacente se ejecuta, rompiendo la zona de interbloqueo.
Implicación de la arquitectura:
La frontera: mantener el núcleo determinista sin cambios, incluidos los PLC, los sistemas de control y adquisición de datos de supervisión (SCADA) y el MES, y envolver una capa asesora alrededor de ella.
- Los agentes observan, analizan y recomiendan. No actúan.
- Las restricciones de seguridad viven como guardrails deterministas en un servicio externo que los agentes consultan en lugar de razonar sobre ellas. Nunca se incrustan en las solicitudes, donde se pueden argumentar.
Validación y aprobación: Una recomendación pasa la validación de esquema y la simulación de física, verificada contra la fuente de verdad OT inmediatamente antes de la activación, nunca contra el estado OT en caché más allá de un ciclo. Luego se aprueba en un nivel igualado a su alcance:
- Nivel 0: El agente resuelve de forma autónoma.
- Nivel 1: El operador confirma con un solo clic.
- Nivel 2: El ingeniero decide desde el análisis presentado.
- Nivel 3: La administración evalúa una recomendación de parada de línea.
Solo entonces una interfaz de comando validada pasa comandos permitidos al control determinístico. El modelo de lenguaje grande (LLM) propone. El motor de física y el operador humano disponen.
Restricción 3: Los datos viven en el borde
Una sola prensa de estampado genera más de 50 GB/día de datos de sensores cuyo valor decae en milisegundos. Enviarlos a la nube cuesta más en ancho de banda que en cómputo, y para cuando la nube responde, la prensa ha seguido adelante.
Implicación de arquitectura: híbrido borde-nube es el valor predeterminado práctico, y el límite de la Restricción 2 se mantiene en el borde también.
- Borde (AWS IoT Greengrass): detección de anomalías sub-takt, monitoreo de umbrales y señales de parar o continuar en la fuente: el agente de borde recomienda, el PLC actúa.
- Nube: Lo que el borde no puede hacer: análisis entre turnos, correlación de tendencias entre plantas y retrabajo de modelos con datos de flota. El borde destila y transmite solo lo que importa.
Restricción 4: Ciclo de vida de agente alineado con el turno
El contexto ilimitado hace que un agente se desvíe a medida que las observaciones obsoletas desplazan a la realidad actual. Un reinicio completo pierde la continuidad entre turnos. La fabricación ya resuelve esto para los humanos con entregas de turnos estructuradas, y los agentes necesitan la misma disciplina.
Implicación de arquitectura: Limitar la memoria del agente al ciclo de turno.
- Inicializar: Contexto de turno, incluyendo la lista de la tripulación, objetivos de producción y la entrega del turno anterior.
- Acumular: Memoria de trabajo dentro de la ventana de turno solo.
- Entregar: Emitir un resumen de fin de turno de problemas abiertos, anomalías marcadas y recomendaciones que siembran la próxima tripulación, imitando el ritual humano sin crecimiento ilimitado de contexto.
Construyendo en AWS
Los siguientes servicios administrados se asignan a las preocupaciones planteadas anteriormente en esta publicación. Cada fila nombra el mecanismo, no solo el servicio.
| Necesidad | Servicio | Mecanismo |
| Runtime | Runtime de AgentCore, una capacidad de Amazon Bedrock AgentCore | Donde los agentes se ejecutan, su flujo de control está determinado o determinado por el modelo. Traiga Strands, LangGraph o CrewAI. |
| Memoria acotada por desplazamiento | Memoria de AgentCore, una capacidad de Amazon Bedrock AgentCore | Gestiona el contexto a corto y largo plazo, por lo que la memoria con ámbito de desplazamiento de la Restricción 4 es configuración en lugar de tuberías de estado personalizadas. |
| Entregas tipadas | Puerta de enlace de AgentCore, una capacidad de Amazon Bedrock AgentCore | Convierte las API y las funciones de AWS Lambda en herramientas del Protocolo de contexto de modelo (MCP) con esquemas validados, por lo que las entregas llevan campos tipados en lugar de prosa. |
| Permisos de agente | Identidad de AgentCore, una capacidad de Amazon Bedrock AgentCore | Una identidad única y verificable para cada agente con control de acceso granular. Es el punto de aplicación para determinar qué agente puede llegar a qué sistema y en nombre de quién. |
| Rastreo entre agentes | Capacidad de observabilidad de AgentCore, una capacidad de Amazon Bedrock AgentCore | Tramas y rastreos a través del tiempo de ejecución, la memoria, la puerta de enlace y las herramientas, a través de la búsqueda de transacciones de Amazon CloudWatch y AWS Distro para Open Telemetry (ADOT). Las entregas son la parte menos observable de un sistema de varios agentes y donde los contratos no tipados fallan silenciosamente. |
| Superficie de aprobación humana | AWS Quick | Donde aterrizan las jerarquías de escalación. AWS Quick Automate ejecuta flujos de trabajo de aprobación con aprobación de un solo clic en Slack, y sus conectores de acción pueden invocar a los agentes de Amazon Bedrock AgentCore. |
| Selección de modelo por niveles | Amazon Bedrock | Una sola API en todas las familias de modelos, por lo que la jerarquía de costos es configuración: un modelo pequeño para la clasificación de un enrutador y uno más fuerte para la síntesis de un orchestrador. |
Conclusión
Los sistemas de varios agentes cambian la forma en que los fabricantes de automóviles orquestan la inteligencia a gran escala, pero solo cuando se construyen sobre los cimientos adecuados.
Los patrones y antipatrones aquí provienen de despliegues reales donde una arquitectura deficiente se manifiesta como costos de token descontrolados, violaciones de takt-time y, en el peor de los casos, riesgos para la seguridad física. La economía a escala de planta es implacable, porque el volumen de token crece con cada agente, robot y turno. La selección de modelo en capas, la compresión de contexto y la distribución edge-cloud son las principales palancas para entregar el mismo valor a una fracción de ese costo.
La recomendación aquí es comenzar con patrones de Nivel 1, demostrar valor y luego expandirse. La mayoría de los casos de uso de fabricación, como la resumen de cambio de turno, las decisiones de calidad y el mantenimiento predictivo, están bien servidos por flujos de trabajo deterministas. Reserve la orquestación autónoma para problemas verdaderamente abiertos donde el descubrimiento dinámico de subtareas justifica el costo, la latencia y la complejidad de depuración adicionales.