Usar torchtitan en AWS Trainium significa usarlo como siempre lo ha hecho. TorchNeuron registra Trainium como un dispositivo PyTorch nativo, lo que permite a torchtitan usarlo a través de las interfaces PyTorch estándar. Puedes usar estas configuraciones para realizar un entrenamiento previo a partir de una inicialización aleatoria o para ajustar con precisión los pesos publicados. También puede personalizar la implementación del modelo y los núcleos para su carga de trabajo.
En esta publicación, entrenas a Qwen3 de tres maneras en un solo trn2.48xlarge.
El primer método usa Transformers v5 como backend de modelado en torchtitan. Ejecuta los modelos Hub a través de AutoModelForCausalLM y lee y escribe directamente los safetensores publicados. El segundo método cambia al Qwen3 nativo de torchtitan cambiando config.model_spec. El tercero añade núcleos mixture-of-experts (MoE) de la Interfaz de Kernel Neuron (NKI) de las recetas de torchtitan-neurona y, a continuación, utiliza el registro de anulaciones de torchtitan para adjuntar tu propio núcleo.
Las tres configuraciones usan el mismo patrón de lanzamiento y estructura de configuración de Torchrun.
Requisitos previos
Para seguir este tutorial, utilice un único trn2.48xlarge con la AMI de aprendizaje profundo de AWS para Neuron o con un contenedor de entrenamiento de Neuron PyTorch. Ambos entornos proporcionan el controlador, el tiempo de ejecución y el compilador de Neuron necesarios
para entrenar en Trainium.
Antes de instalar torchtitan-neuron, compruebe si su entorno ya lo incluye. El siguiente comando imprime la versión instalada y la ruta del paquete
En este tutorial se utilizan las versiones de la tabla siguiente. Para reproducir los ejemplos, fije estas versiones. Los módulos de integración de Transformers v5 y de anulación específicos de Trainium pueden cambiar entre
Cuando se instala torch_neuronx, TorchNeuron registra Trainium como dispositivo neuronal y torchtitan lo detecta al inicio. En el modo ansioso, Neuron compila las operaciones a medida que se ejecutan. Con torch.compile, Neuron compila el gráfico capturado. Este mismo patrón de lanzamiento funciona
en las tres configuraciones.
Para las versiones utilizadas en este tutorial, instala las dependencias restantes de torchtitan-neuron y torchtitan con --no-deps para conservar la versión Neuron de torch:
clon de git https://github.com/aws-neuron/torchtitan-neuron
cd torchtitan-neurona
pip install -r requirements.txt
Antes de empezar a entrenar, consigue los artefactos del modelo Qwen3 en Hugging Face Hub. Guárdalos en un directorio local que puedas pasar a la
configuración de entrenamiento:
Si descarga Qwen/Qwen3-4B-Instruct-2507\
 --local-dir «$pwd/assets/hf/Qwen3-4b-instruct-2507"
Cada configuración de entrenamiento es una función de configuración de Python. Los tres ejemplos parten de una configuración base que se actualiza para cada paso.
Entrena con cara abrazada Transformers v5
En la primera configuración, Transformers v5 construye Qwen 3 a través de AutoModelForCausalLM. La definición del modelo Hub proporciona la implementación utilizada para las pasadas hacia adelante y hacia atrás. Para seleccionar el modelo, establezca su ID de hub en la configuración.
Empieza con transformers_modeling_backend_full ().
Deja sin definir los campos que se asignan a las claves de configuración de Hugging Face, por lo que autoConfig.from_pretrained () carga la arquitectura del modelo desde el Hub.
Crea el archivo neuron_qwen3.py en la raíz del repositorio torchtitan-neuron, donde ejecutas el comando de entrenamiento. Añade las importaciones, la ruta del artefacto modelo y
la configuración base:
sistema operativo de importación
desde torchtitan.experiments.transformers_modeling_backend.config_registry import (
 transformers_modeling_backend_full,
)
desde torchtitan.experiments.transformers_modeling_backend.configs import (
 Transformers Backend Config,
)

ACTIVOS = os.path.abspath (». /assets/HF/QWEN3-4B-instruct-2507 «)

def v5_qwen3_4b () -> Configuración de backend de Transformers:
 config = transformers_modeling_backend_full ()
 config.hf_model = «Qwen/Qwen3-4B-Instruct-2507"
 config.hf_assets_path = ACTIVOS
 config.dataloader.dataset = «c4_test»
 config.training.steps = 10
 config.training.local_batch_size = 1
 config.parallelism.data_parallel_shard_degree = -1
 configuración de devolución
Este comando lanza 64 procesos de entrenamiento, uno para cada NeuronCore lógico. --module neuron_qwen3 importa el módulo de configuración local. --config v5_qwen3_4b selecciona la función de configuración. La configuración de datos paralelos fragmenta el modelo
en los 64 rangos.
Carga y guarda los puntos de control de Hugging Face
Para ajustar con precisión los pesos publicados, habilita la carga por puntos de control y apunta initial_load_path a ASSETS.El adaptador de diccionario estatal ajusta el modelo principal. prefija y maneja incrustaciones enlazadas. Guarda el punto de control final
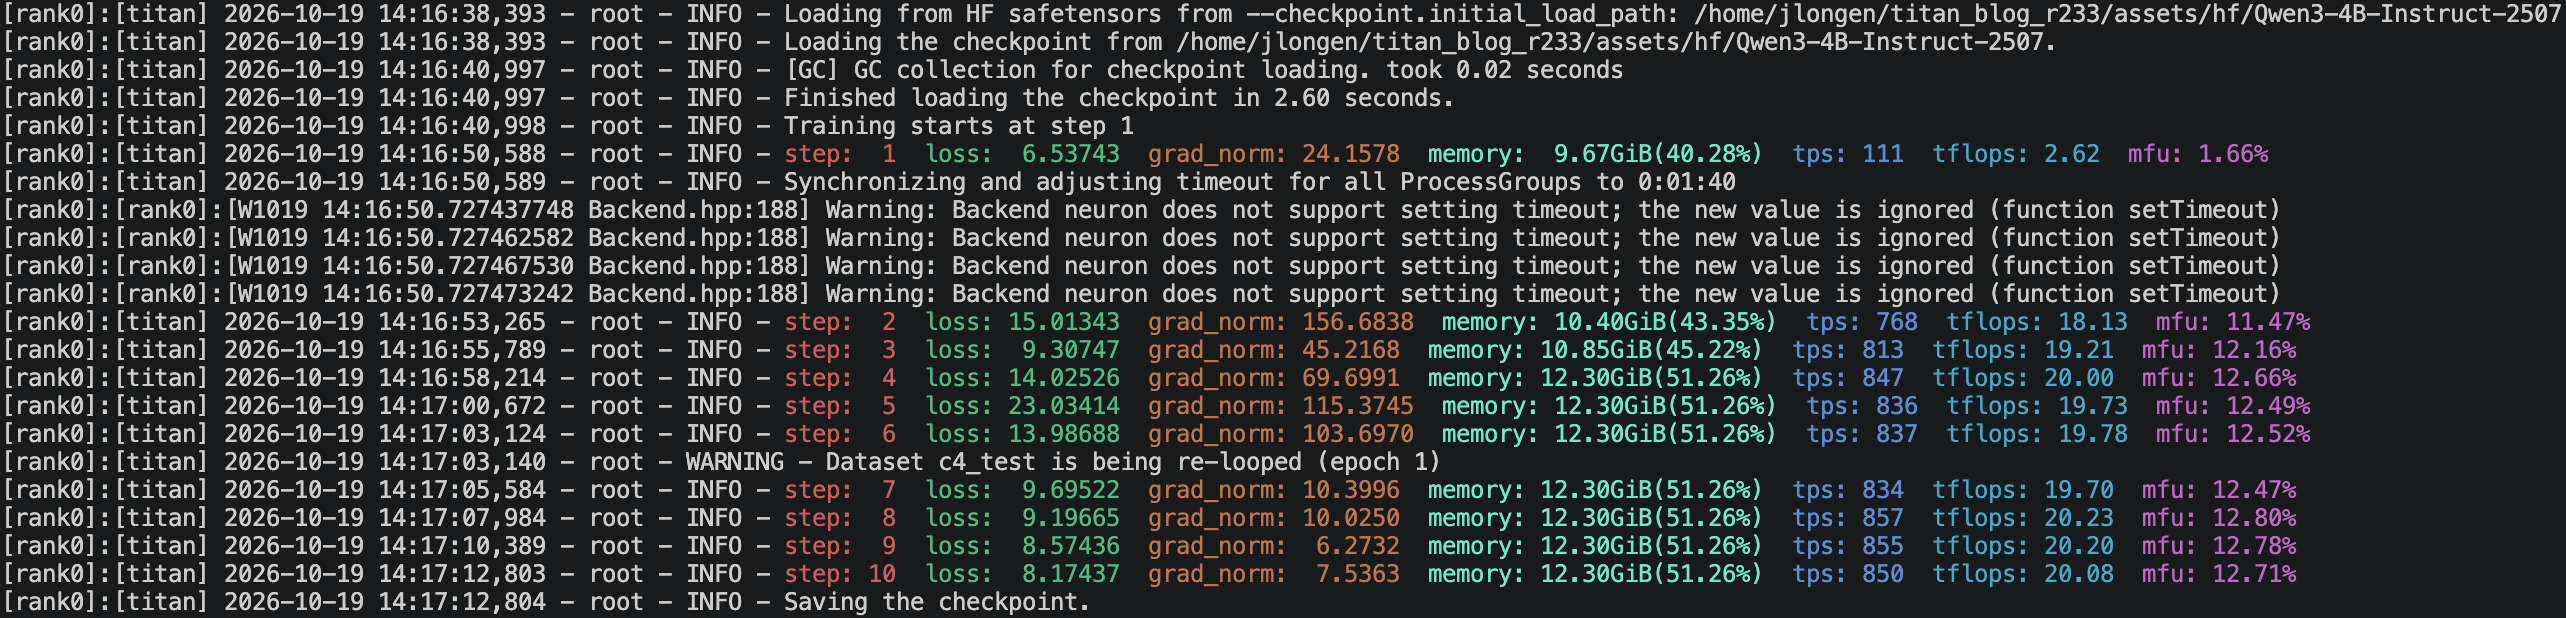
Usa la pérdida del primer paso de entrenamiento como una forma rápida de comprobar que Torchtitan ha cargado las pesas publicadas. En el caso de Qwen/Qwen3-4B-Instruct-2507, la ejecución verificada produjo una pérdida de 6,54 en el paso 1 con respecto a los pesos publicados y de 12,43 con respecto a la
inicialización aleatoria.
Tras el entrenamiento, carga el punto de control exportado con AutoModelForCausalLM y load_state_dict. Un viaje de ida y vuelta exitoso indica que no hay claves perdidas o inesperadas, excepto lm_head.weight, que Qwen3-4B vincula con las incrustaciones de los tokens.
Esto confirma que los archivos siguen siendo un punto de control estándar de Hugging Face.
Figura 1: El punto de control publicado comienza con una pérdida de 6,54 y los pesos exportados se cargan sin claves faltantes o inesperadas
Entrena con los modelos nativos de torchtitan
En la segunda configuración, torchtitan crea su modelo Qwen3 nativo.
Agregue la función nativa de importación y configuración de Qwen3 a neuron_qwen3.py:
Este ejemplo parte de qwen3_32b () porque la versión probada de torchtitan no proporciona un generador de configuración genérico de qwen3_4b (). La siguiente línea reemplaza la especificación del modelo 32B por la especificación 4B. Los campos restantes reproducen la ejecución probada
config.model_spec selecciona la clase del modelo y define cómo torchtitan fragmenta el modelo y mapea sus claves de puntos de control. Aquí, model_registry («4B», attn_backend="sdpa») selecciona la implementación Qwen3 nativa de torchtitan
con Scaled Dot Product Attention (SDPA).
Añada núcleos NKI para obtener una mezcla de expertos
En la tercera configuración, torchtitan ejecuta capas mixtas de expertos con núcleos escritos en NKI, el lenguaje del núcleo de Neuron.
Agregue las importaciones necesarias y la función de configuración MoE de Qwen3 a neuron_qwen3.py:
Esta configuración utiliza la fragmentación paralela de datos en 64 rangos con un grado de paralelo del tensor de 1. No utiliza el paralelismo experto. num_experts=64 establece el número de expertos del modelo, no el grado paralelo de expertos
.
Al configurar compileConfig (enable=false), se ejecuta este ejemplo en modo ansioso.
TorchNeuron admite operadores de NKI registrados tanto en Sager Execution como en torch.compile.
En la compilación torchtitan utilizada para este tutorial, qwen3_nki_moe_config () reemplaza el bloque MoE por la implementación de expertos agrupados de NKI. También selecciona el SDPA y la incrustación rotativa sin recolección.
Cuando habilites torch.compile, agrega «grad_clip» a CompileConfig.components para compilarel recorte de normas de gradiente.
Los
núcleos NKI se entrenan como operadores de PyTorch. wrap_nki hace que un núcleo NKIsea invocable desde PyTorch, y nki_op registra el operador.register_autograd
adjunta su pasada hacia atrás utilizando los metadatos de enrutamiento guardados durante la pasada hacia adelante.
El ejemplo reduce el Qwen3-30B-A3B a 4 capas y 64 expertos, por lo que cabe en un trn2.48xlarge. Dirige cada token a 4 expertos
con top_k=4.
Adjunta tu propio núcleo de NKI
En algunos casos, es posible que desee optimizar una operación para las formas de los tensores de su modelo. Un núcleo especializado puede adaptar sus ordenamientos en teselas y el movimiento de datos a esas formas. También puede reemplazar una secuencia crítica de operaciones de PyTorch por un operador optimizado. Puede escribir el núcleo usted mismo o empezar con uno desde nkilib. Este ejemplo usa rope_hf de nkilib.core.embeddings, que espera el diseño del tensor Hugging Face y admite su propio modo de retroceso. En este ejemplo se muestra el registro del núcleo y la integración con la autogradación, pero no se trata de
una mejora del rendimiento.
Crea el archivo my_neuron_kernels.py en la raíz del repositorio, donde inicias training. torchtitan almacena la consulta y la clave como [batch, seq, heads, head_dim], mientras que rope_hf espera [batch, heads, seq, head_dim].
Convierte el diseño dentro del operador y asigna los tensores de salida con torch.empty_like ():
rope_hfcalcula los gradientes cuando lo llamas con backward=True. Registra un segundo operador para ese modo. Guarde la memoria caché rotativa durante la pasada hacia adelante para que la pasada hacia atrás pueda reutilizarla. Devuelve None para el gradiente de la caché porque la caché no es diferenciable
Como rope_hf requiere una longitud de secuencia compatible, valide esa restricción antes de llamar al núcleo.
Subclasifique CossInRope y llame a rope_fwd desde apply_rotary_emb:
desde clases de datos importar clase de datos
desde torchtitan.config, importar, derivar, anular
desde torchtitan.models.common.rope importa CosSinRope

clase NikRope (CossinRope):
 @dataclass (KW_ONLY=true, slots=true)
 configuración de clase (CossinRope.config):
 pase

 @staticmethod
 def apply_rotary_emb (consulta, clave, rope_cache):
 stride = 128 * LNC [0]
 si query.shape [1]% stride:
 genera ValueError ()
 «f"rope_hf requiere una longitud de secuencia que sea un múltiplo de»
 f"128 * LNC= {stride}, tiene {query.shape [1]}»
 )
 q_out, k_out = rope_fwd (consulta, clave, rope_cache)
 devuelve q_out.type_as (consulta), k_out.type_as (clave
)
Registra NKiRope como reemplazo de CosSinRope.derive () copia los campos de configuración compartidos en la configuración de reemplazo
:
@override (
 «ni_rope»,
 target = cossinrope.config,
 exacto = verdadero,
 description="El núcleo nkilib rope_hf en lugar de la rotación de PyTorch»,
)
def _nki_rope (cfg: cossinRope.config) -> nkirope.config:
 devuelva la derivación (cfg, NKirope.config)
Para cargar la anulación personalizada, pasa el nombre del módulo a --override.imports. torchtitan importa la entrada de registro antes de crear el modelo:
Antes de que comience el entrenamiento, torchtitan registra cada nodo de configuración al que reemplaza la anulación. Confirme que la salida contenga una entrada nki_rope
Establece la longitud de la secuencia en un múltiplo de 128 * LNC, que es 256 cuando LNC es 2. Cambie la forma de la caché rotativa a [seq, head_dim * 2], con valores de coseno en la primera mitad y valores de seno en la segunda. El núcleo valida estas
restricciones antes de que comience el entrenamiento.
Para ver un ejemplo completo de torchtitan, consulte torchtitan_neuron/models/gpt_oss/nki_attention.py. Conecta los núcleos nkilib flash-attention a través del mismo operador y mecanismo de anulación.
También gestiona las entradas de dTensor para el paralelismo de los tensores.
Antes de entrenar con un núcleo personalizado, compare sus resultados con la implementación a la que reemplaza. En la prueba numérica con entradas de float32, la incrustación rotativa PyTorch de rope_hf y torchtitan produjo una diferencia absoluta máxima de
0.0 tanto para la consulta como para la clave.
Cuando registre varias anulaciones, limite cada una de ellas a las instancias de módulo deseadas con fqns. Por ejemplo, fqns= ["layers.1 [0-9] .attention.rope"] tiene como objetivo la incrustación rotativa de las capas 10 a 19. torchtitan se detiene cuando dos anulaciones reclaman el mismo nodo y avisa cuando una anulación no coincide con ningún nodo.
Revisa el resultado del entrenamiento
Al inicio, confirme que torchtitan reporta 64 rangos y el modelo esperado. El primer paso incluye la compilación y lleva más tiempo que los pasos posteriores. Cada paso del entrenamiento informa sobre la pérdida, la norma de gradiente, el uso de la memoria de gran ancho de banda (HBM), el rendimiento y la utilización del modelo de FLOP (MFU). Para ejecutar el punto de control, confirme que la pérdida del primer paso es cercana a los 6,54. Para ejecutar el kernel personalizado, confirme que la anulación de nki_rope aparezca
una vez para cada capa de Qwen3.
Escale en toda la instancia
La misma configuración de paralelismo se aplica a las configuraciones del modelo nativo y de los Transformers. Un trn2.48xlarge expone 64 núcleos neuronales lógicos en un LNC=2.
Defina data_parallel_shard_degree = -1 para fragmentar los parámetros del modelo, los gradientes y el estado del optimizador en cada rango que inicie Torchrun.
Configura config.parallelism.tensor_parallel_degree para dividir los pesos de cada capa en un grupo de rangos. Cada rango calcula una porción de cada multiplicación de matrices.
Con el paralelismo de secuencias habilitado de forma predeterminada, las capas de normalización se ejecutan en las activaciones fragmentadas a lo largo de la dimensión de la secuencia. torchtitan combina el paralelismo tensorial con el paralelo de datos totalmente fragmentados (FSDP) en un DeviceMesh multidimensional.
Observe a HBM por rango a medida que aumenta el tamaño del modelo, la longitud de la secuencia o el tamaño del lote local. Estos valores determinan la cantidad de memoria que necesita cada rango
.
Limpiar
Si quieres conservar tus puntos de control, cópialos en un almacenamiento permanente antes de limpiarlos. Si planeas reutilizar la instancia, deténgala. Cuando ya no necesites la instancia, termínala.
Conclusión
AWS Trainium funciona como un dispositivo Torchtitan compatible en las tres configuraciones de este tutorial. Puedes entrenar a Qwen3 con Hugging Face Transformers v5 y cargar o guardar directamente los safetensores publicados. También puedes entrenar con la implementación nativa de Qwen3 de torchtitan configurando config.model_spec. Para modelos con una mezcla de expertos, usa las recetas de NKI de torchtitan-neurona. En el caso de los núcleos personalizados, utilice el registro de anulación para adjuntar operadores de NKI mediante el mismo flujo de lanzamiento
.
Para obtener instrucciones sobre la configuración, consulte la documentación de AWS Neuron. Para ver las fuentes actuales y las recetas de formación, consulte el repositorio torchtitan
.
Acerca de los autores
Using torchtitan on AWS Trainium means using it the way you always have. TorchNeuron registers Trainium as a native PyTorch device, which lets torchtitan use it through standard PyTorch interfaces. You can use these configurations to pre-train from random initialization or fine-tune published weights. You can also customize the model implementation and kernels for your workload. In this post, you train Qwen3 three ways on a single trn2.48xlarge.
The first method uses Transformers v5 as a modeling backend in torchtitan. It runs Hub models through AutoModelForCausalLM and reads and writes published safetensors directly. The second method switches to torchtitan’s native Qwen3 by changing config.model_spec. The third adds Neuron Kernel Interface (NKI) mixture-of-experts (MoE) kernels from the torchtitan-neuron recipes and then uses torchtitan’s override registry to attach your own kernel. All three configurations use the same torchrun launch pattern and config structure.
Prerequisites
To follow this walkthrough, use a single trn2.48xlarge with either the AWS Deep Learning AMI for Neuron or a Neuron PyTorch training container. Both environments provide the Neuron driver, runtime, and compiler required to train on Trainium.
Before you install torchtitan-neuron, check whether your environment already includes it. The following command prints the installed version and package path:
This walkthrough uses the versions in the following table. To reproduce the examples, pin these versions. The Transformers v5 integration and Trainium-specific override modules can change between torchtitan releases.
When torch_neuronx is installed, TorchNeuron registers Trainium as the neuron device and torchtitan detects it at startup. In eager mode, Neuron compiles operations as they execute. With torch.compile, Neuron compiles the captured graph. This same launch pattern works across all three configurations.
For the versions used in this walkthrough, install torchtitan-neuron and torchtitan’s remaining dependencies with --no-deps to preserve the Neuron build of torch:
git clone https://github.com/aws-neuron/torchtitan-neuron
cd torchtitan-neuron
pip install -r requirements.txt
Before you start training, get the Qwen3 model artifacts from Hugging Face Hub. Store them in a local directory that you can pass to the training config:
Each training configuration is a Python config function. The three examples start from a base config that you update for each step.
Train with Hugging Face Transformers v5
In the first configuration, Transformers v5 builds Qwen3 through AutoModelForCausalLM. The Hub model definition supplies the implementation used for the forward and backward passes. You select the model by setting its Hub ID in the config.
Start with transformers_modeling_backend_full(). It leaves the fields that map to Hugging Face configuration keys unset, so AutoConfig.from_pretrained() loads the model architecture from the Hub.
Create neuron_qwen3.py in the torchtitan-neuron repository root, where you run the training command. Add the imports, model artifact path, and base config:
This command launches 64 training processes, one for each logical NeuronCore. --module neuron_qwen3 imports the local config module. --config v5_qwen3_4b selects the configuration function. The data parallel setting shards the model across all 64 ranks.
Load and save Hugging Face checkpoints
To fine-tune from published weights, enable checkpoint loading and point initial_load_path to ASSETS. The state-dictionary adapter adjusts the leading model. prefix and handles tied embeddings. It saves the final checkpoint as Hugging Face safetensors.
Use the first training-step loss as a quick check that torchtitan loaded the published weights. For Qwen/Qwen3-4B-Instruct-2507, the verified run produced a step 1 loss of 6.54 from published weights and 12.43 from random initialization.
After training, load the exported checkpoint with AutoModelForCausalLM and load_state_dict. A successful round trip reports no missing or unexpected keys other than lm_head.weight, which Qwen3-4B ties to the token embeddings. This confirms that the files remain a standard Hugging Face checkpoint.
Figure 1: The published checkpoint starts with a loss of 6.54, and the exported weights load without missing or unexpected keys
Train with torchtitan’s native models
In the second configuration, torchtitan builds its native Qwen3Model. Add the native Qwen3 imports and config function to neuron_qwen3.py:
This example starts from qwen3_32b() because the tested torchtitan build does not provide a generic qwen3_4b() config builder. The next line replaces the 32B model specification with the 4B specification. The remaining fields reproduce the tested run.
config.model_spec selects the model class and defines how torchtitan shards the model and maps its checkpoint keys. Here, model_registry("4B", attn_backend="sdpa") selects torchtitan’s native Qwen3 implementation with scaled dot product attention (SDPA).
Add NKI kernels for mixture of experts
In the third configuration, torchtitan runs mixture-of-experts layers with kernels written in NKI, the Neuron kernel language. Add the required imports and Qwen3 MoE config function to neuron_qwen3.py:
This configuration uses data parallel sharding across 64 ranks with a tensor parallel degree of 1. It does not use expert parallelism. num_experts=64 sets the number of experts in the model, not the expert parallel degree.
Setting CompileConfig(enable=False) runs this example in eager mode. TorchNeuron supports registered NKI operators in both eager execution and torch.compile.
In the torchtitan build used for this walkthrough, qwen3_nki_moe_config() replaces the MoE block with the NKI grouped-experts implementation. It also selects SDPA and the gather-free rotary embedding. When you enable torch.compile, add "grad_clip" to CompileConfig.components to compile gradient-norm clipping.
NKI kernels enter training as PyTorch operators. wrap_nki makes an NKI kernel callable from PyTorch, and nki_op registers the operator. register_autograd attaches its backward pass using routing metadata saved during the forward pass.
The example reduces Qwen3-30B-A3B to 4 layers and 64 experts so it fits on one trn2.48xlarge. It routes each token to 4 experts with top_k=4.
Attach your own NKI kernel
In some cases, you might want to optimize an operation for the tensor shapes in your model. A specialized kernel can tailor its tiling and data movement to those shapes. It can also replace a performance-critical sequence of PyTorch operations with one optimized operator. You can write the kernel yourself or start with one from nkilib. This example uses rope_hf from nkilib.core.embeddings, which expects the Hugging Face tensor layout and supports its own backward mode. This example demonstrates kernel registration and autograd integration, not a performance improvement.
Create my_neuron_kernels.py in the repository root, where you launch training. torchtitan stores query and key as [batch, seq, heads, head_dim], whereas rope_hf expects [batch, heads, seq, head_dim]. Convert the layout inside the operator and allocate the output tensors with torch.empty_like():
rope_hf computes gradients when you call it with backward=True. Register a second operator for that mode. Save the rotary cache during the forward pass so the backward pass can reuse it. Return None for the cache gradient because the cache is not differentiable.
Because rope_hf requires a supported sequence length, validate that constraint before calling the kernel. Subclass CosSinRoPE and call rope_fwd from apply_rotary_emb:
from dataclasses import dataclass
from torchtitan.config import derive, override
from torchtitan.models.common.rope import CosSinRoPE

class NKIRoPE(CosSinRoPE):
    @dataclass(kw_only=True, slots=True)
    class Config(CosSinRoPE.Config):
        pass

    @staticmethod
    def apply_rotary_emb(query, key, rope_cache):
        stride = 128 * LNC[0]
        if query.shape[1] % stride:
            raise ValueError(
                f"rope_hf requires a sequence length that is a multiple of "
                f"128 * LNC={stride}, got {query.shape[1]}"
            )
        q_out, k_out = rope_fwd(query, key, rope_cache)
        return q_out.type_as(query), k_out.type_as(key)
Register NKIRoPE as the replacement for CosSinRoPE. derive() copies the shared configuration fields into the replacement config:
@override(
    "nki_rope",
    target=CosSinRoPE.Config,
    exact=True,
    description="nkilib rope_hf kernel in place of the PyTorch rotation",
)
def _nki_rope(cfg: CosSinRoPE.Config) -> NKIRoPE.Config:
    return derive(cfg, NKIRoPE.Config)
To load the custom override, pass its module name to --override.imports. torchtitan imports the registry entry before it builds the model:
Before training starts, torchtitan logs each config node that the override replaces. Confirm that the output contains one nki_rope entry for each Qwen3 layer:
Set the sequence length to a multiple of 128 * LNC, which is 256 when LNC is 2. Reshape the rotary cache to [seq, head_dim * 2], with cosine values in the first half and sine values in the second. The kernel validates these constraints before training begins.
For a complete torchtitan example, see torchtitan_neuron/models/gpt_oss/nki_attention.py. It connects nkilib flash-attention kernels through the same operator and override mechanisms. It also handles DTensor inputs for tensor parallelism.
Before you train with a custom kernel, compare its outputs with the implementation it replaces. In the numerical test with float32 inputs, rope_hf and torchtitan’s PyTorch rotary embedding produced a maximum absolute difference of 0.0 for both query and key.
When you register multiple overrides, limit each one to the intended module instances with fqns. For example, fqns=["layers.1[0-9].attention.rope"] targets the rotary embedding in layers 10 through 19. torchtitan stops when two overrides claim the same node and warns when an override matches no nodes.
Review the training output
At startup, confirm that torchtitan reports 64 ranks and the expected model. The first step includes compilation and takes longer than later steps. Each training step reports the loss, gradient norm, high-bandwidth memory (HBM) usage, throughput, and model FLOPs utilization (MFU). For the checkpoint run, confirm that the first-step loss is near 6.54. For the custom kernel run, confirm that the nki_rope override appears once for each Qwen3 layer.
Scale across the instance
The same parallelism settings apply to the Transformers and native model configurations. A trn2.48xlarge exposes 64 logical NeuronCores at LNC=2. Set data_parallel_shard_degree = -1 to shard the model parameters, gradients, and optimizer state across every rank that torchrun starts.
Set config.parallelism.tensor_parallel_degree to shard each layer’s weights across a group of ranks. Each rank computes a slice of every matrix multiplication. With sequence parallelism enabled by default, normalization layers run on activations sharded along the sequence dimension. torchtitan combines tensor parallelism with Fully Sharded Data Parallel (FSDP) on a multidimensional DeviceMesh.
Watch per-rank HBM as you increase the model size, sequence length, or local batch size. These values determine how much memory each rank requires.
Clean up
If you want to keep your checkpoints, copy them to persistent storage before you clean up. If you plan to reuse the instance, stop it. When you no longer need the instance, terminate it.
Conclusion
AWS Trainium works as a supported torchtitan device across all three configurations in this walkthrough. You can train Qwen3 through Hugging Face Transformers v5 and load or save published safetensors directly. You can also train with torchtitan’s native Qwen3 implementation by setting config.model_spec. For mixture-of-experts models, use the torchtitan-neuron NKI recipes. For custom kernels, use the override registry to attach NKI operators through the same launch flow.
For setup guidance, see the AWS Neuron documentation. For current source and training recipes, see the torchtitan repository.
About the authors
¿Tiene un proyecto de software o plataforma SaaS en mente?
Hable directamente con nuestros arquitectos de software en SoftAndino. Le brindamos asesoría técnica y cotización inmediata sin compromiso.