Confianza en profundidad: dar a los agentes más autonomía sin perder el control
Trust in Depth: Giving agents more autonomy without losing control
Shawn Bice
En todas las conversaciones que tengo con los líderes empresariales, dicen lo mismo. Quieren que los agentes hagan más, pero no confían en que siempre lo hagan bien.
Eso es justo. La misma creatividad y autonomía que hacen que los agentes sean útiles hace que sea difícil confiar en ellos. Asigne una tarea a un agente y este encontrará su propio camino para terminarla, eligiendo herramientas y secuenciando los pasos que ningún desarrollador haya programado. Ejecuta la misma tarea dos veces y es posible que tome una ruta diferente cada vez. Una prueba que se supera hoy nos dice poco acerca de lo que hará el agente mañana.
La respuesta habitual es que una persona esté al tanto de todo lo que haga el agente. Esto funciona a pequeña escala, pero a medida que los agentes asumen más trabajo, las aprobaciones humanas se acumulan y aumenta la fatiga de revisión. Las personas a las que se les pide que lo comprueben todo dejan de captar las cosas que importan. La cautela se convierte en un obstáculo, y los agentes capaces de hacer mucho más se quedan de brazos cruzados en la valiosa labor que podría tener un mayor impacto
.
La solución consiste en dejar que el agente actúe por sí solo cuando se puedan verificar sus acciones y reservar el juicio humano para tomar las decisiones que lo requieran. A medida que los agentes asumen tareas más arriesgadas, como las transacciones financieras, una acción equivocada se vuelve cada vez más perjudicial. Las organizaciones necesitan tener la confianza necesaria para encargar a un agente de IA una labor importante, sabiendo que se mantendrá dentro de los límites establecidos, incluso cuando nadie esté vigilando. Esa confianza debe fomentarse.
El filtrado, las pruebas y la supervisión del contenido cumplen una función importante, pero ninguna de estas funciones por sí sola puede garantizar que un agente se comportará correctamente la próxima vez que se ejecute. La confianza proviene de capas independientes que se refuerzan unas a otras, la misma disciplina estratificada que la industria ha practicado durante dos décadas como Defensa en profundidad, convertida en un nuevo propósito. Si bien Defense in Depth limita lo que puede salir mal, amplía lo que puedes permitir de forma segura. AWS lo llama Trust in Depth.
Confianza en profundidad: confianza que puede verificar
La confianza se genera al responder a una serie de preguntas en diferentes momentos del ciclo de vida del agente:
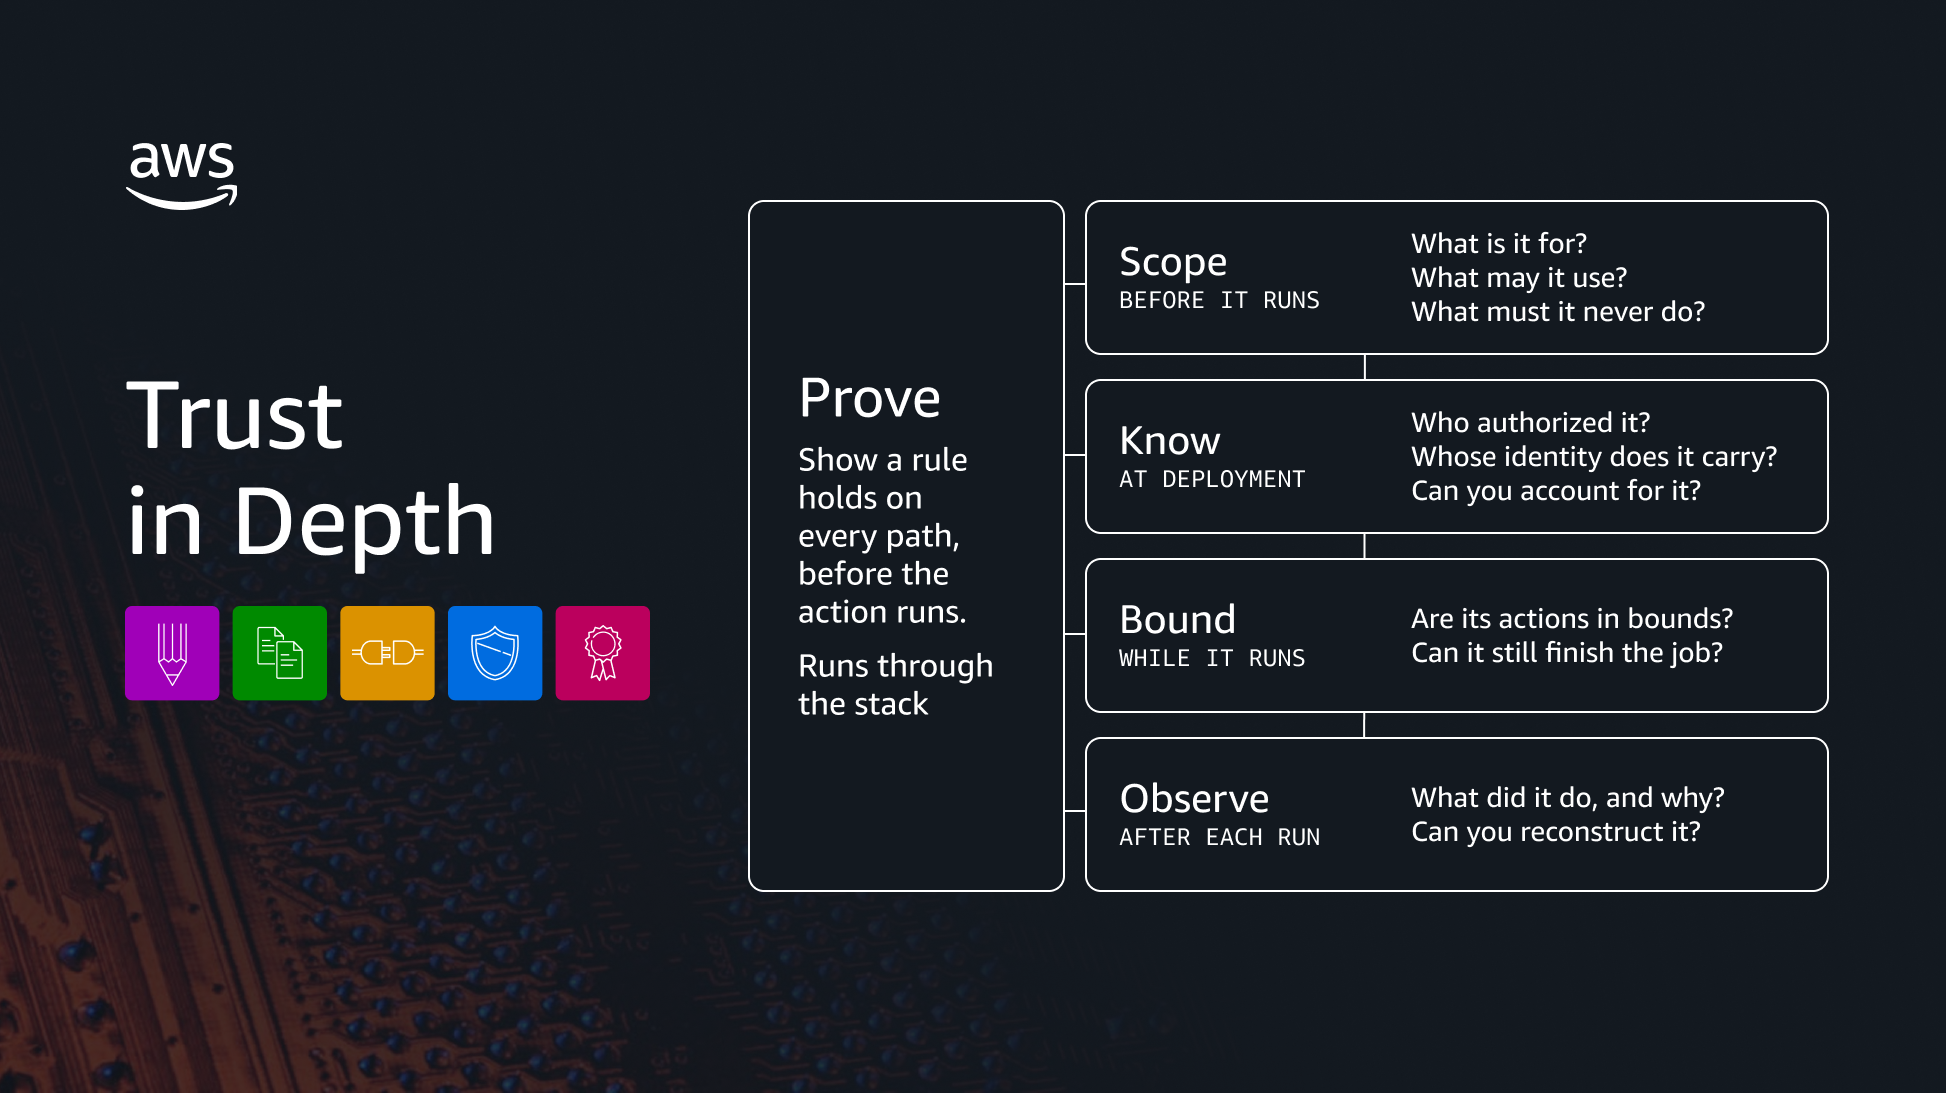
Alcance, antes de que se ejecute: ¿para qué sirve este agente, qué capacidades requiere el trabajo y qué es lo que nunca debe hacer?
En el momento de la implementación, sepa quién lo autorizó, qué identidad tiene y puede dar cuenta de todos los agentes que actúan en su nombre.
Obligado mientras esté en funcionamiento: ¿sus acciones se mantienen dentro de los límites que usted estableció? ¿Puede seguir haciendo su trabajo?
Observa, después de cada ejecución: ¿puedes reconstruir lo que hizo el agente y por qué, y aprender de ello?
En todas estas preguntas, algunos requisitos pueden expresarse como reglas precisas, mientras que otros requieren un juicio. Es posible que una empresa exija que solo un gerente pueda aprobar el acceso o que se bloquee el inicio de sesión de un empleado para poder compartir su buzón de correo. Otras expectativas, como mantener un tono amistoso o manejar una situación delicada de manera adecuada, dependen del contexto y del juicio humano
.
En
el caso de las reglas definidas con precisión, las pruebas muestran si los controles funcionan en los casos previstos, pero un agente toma caminos que usted no utilizó. La tecnología que va más allá es el razonamiento automático, la lógica matemática que comprueba si una regla se cumple en todos los casos posibles. Con una descripción precisa del sistema y sus suposiciones, se puede establecer que una regla es válida en todos los caminos recorridos, o descubrir el caso exacto en el que falla. Ese resultado es una prueba de ello y solo es válido en la medida en que las reglas y suposiciones en que se basa, por lo que es más difícil trabajar antes de que el agente lo ejecute.
AWS lleva más de una década utilizando el razonamiento automatizado en producción, desde la gestión de identidades y accesos (IAM), con más de 2 100 millones de solicitudes por segundo, hasta sistemas críticos como el hipervisor Nitro de AWS, el Amazon S3 Block Public Access y el VPC Reachability Analyzer. Ahora se lo estamos ofreciendo a los agentes. Siempre que las reglas de un agente puedan establecerse con precisión, el razonamiento automatizado puede verificarlas.
Sin embargo, no todas las reglas se pueden establecer con precisión. Se puede demostrar que «solo un administrador puede aprobar el acceso». «Mantener un tono amistoso» no puede. Cuando la prueba no sea válida, limite el acceso y las acciones del agente, evalúe su comportamiento y transmita una ambigüedad genuina a la persona para que la juzgue. Otorgue más autonomía a medida que establezca que son
In every conversation I have with enterprise leaders, they say the same thing. They want agents to do more, but they don’t trust them to do it right all the time.
That’s fair. The same creativity and autonomy that makes agents useful makes them hard to trust. Give an agent a task and it finds its own path to finish it, picking tools and sequencing steps no developer scripted. Run the same task twice and it might take a different route each time. A test that passes today tells you little about what the agent does tomorrow.
The usual answer is a person in the loop, approving everything the agent does. That works at small scale, but as agents take on more work, human approvals pile up and review fatigue sets in. People asked to check everything stop catching the things that matter. Caution becomes a bottleneck, and agents capable of far more sit idle on the valuable work that could be making more of an impact.
The fix is to let the agent act on its own when its actions can be verified, and reserve human judgment for the decisions that need it. As agents take on higher stakes work, like financial transactions, a wrong action becomes increasingly harmful. Organizations need the confidence to hand an AI agent important work, knowing it will stay within the limits set, even when no one is watching. That confidence must be built.
Content filtering, testing, and monitoring each serve an important purpose, but none of these capabilities alone can promise an agent will behave correctly the next time it runs. Trust comes from independent layers that reinforce one another, the same layered discipline the industry has practiced for two decades as Defense in Depth, turned to a new purpose. Where Defense in Depth limits what can go wrong, this expands what you can safely allow. AWS calls it Trust in Depth.
Trust in Depth: Trust you can verify
You build trust by answering a set of questions at different moments in the agent’s lifecycle:
Scope, before it runs: What is this agent for, what capabilities does the job require, and what must it never do?
Know, at deployment: Who authorized it, what identity does it carry, and can you account for every agent acting on your behalf?
Bound, while it runs: Do its actions stay within the limits you set, and can it still do the job?
Observe, after each run: Can you reconstruct what the agent did and why, and learn from it?
Across these questions, some requirements can be expressed as precise rules, while others call for judgment. A company might require that only a manager can approve access, or that an employee’s sign-in must be blocked before their mailbox can be shared. Other expectations, such as keeping a friendly tone or handling a sensitive situation appropriately, depend on context and human judgment.
For precisely defined rules, testing shows whether the controls work in the cases you anticipate, but an agent takes paths you didn’t. The technology that goes further is automated reasoning, the mathematical logic that checks whether a rule holds in every possible case. It can establish that a rule holds on every path covered by a precise description of the system and its assumptions, or uncover the exact case where it fails. That result is a proof, and it is only as good as the rules and assumptions behind it, which is why the hardest work comes before the agent runs.
AWS has run automated reasoning in production for more than a decade, from Identity and Access Management (IAM) at more than 2.1 billion requests per second to critical systems like the AWS Nitro Hypervisor, Amazon S3 Block Public Access, and VPC Reachability Analyzer. Now we are bringing it to agents. Wherever an agent’s rules can be stated precisely, automated reasoning can check them.
However, not every rule can be stated precisely. “Only a manager can approve access” can be proven. “Keep a friendly tone” cannot. Where proof does not apply, limit the agent’s access and actions, evaluate its behavior, and send genuine ambiguity to a person to apply judgment. Grant more autonomy as you establish that the relevant rules are enforced, the agent performs reliably on the task, and failures can be detected and handled.
Here is what each Trust in Depth layer asks of you, and how AWS helps you answer it.
Scope your agent to only what the job requires
Trust begins before an agent runs, and this is where to invest the most effort. Problems caught here are cheap to fix. Scoping means deciding what work the agent owns, which tools, data, and services it may reach, the rules it must follow, and which decisions stay with a person.
“Resolve the customer’s issue” says what to achieve, not how the agent may act to achieve it. The agent still needs limits on what it may see, what it may do, and when it must stop and ask. Give it only the access its job requires, and no more. Watch for capabilities no one granted on purpose, the ones bundled with a tool or a role. Grant an admin role for one task, and the agent can inherit permissions across your whole environment.
Scoping starts at the build stage, with how you define the agent. Kiro, the agentic coding system, brings rigor and mature engineering practices to the build stage of agents. It turns high-level intent into structured, spec-driven requirements and uses automated reasoning to surface contradictions, ambiguities, and gaps before any code is written. Kiro also derives property-based tests that check the implementation against those requirements across a wide range of inputs, catching bugs that are hard to detect. Strands provides an open-source tool kit for defining an agent’s model, instructions, and tools, and a managed runtime for operating it. Whatever framework you choose, the responsibility to define the agent’s job and its boundaries is the same.
The next step is turning those boundaries into rules you can hold the agent to. Amazon Bedrock AgentCore provides governance controls to scale agents safely and governs what the agent does. Using Policies in Bedrock AgentCore, you describe in plain language which tools, APIs, and data the agent may reach, and automated reasoning checks the policy for gaps, like catching a rule that grants too much access, and checks for contradictions that make a rule unable to ever be satisfied, before it takes effect.
Scoping your agent is the hard part, because turning human intent into durable, enforceable policy requires precision and completeness. However, it is also the part that pays off most. Everything that builds on what you set here, and the more precise the policy, the more your agent can safely do on its own.
Know every agent acting on your behalf, and under whose authority
You can’t govern what you can’t see. Teams are creating agents faster than anyone can track them, and an agent no one knows about is an agent no one controls. Every agent needs its own identity, checked every time it acts. No action should be orphaned. When something goes wrong, you can tell which agent did what, and who authorized it.
AWS Agent Registry provides a managed, approved catalog of the agents, Model Context Protocol (MCP) servers, tools, and skills across your organization. Administrators use approval workflows to gate what becomes discoverable and remove what no longer meets the bar for security, compliance, and quality. Both people and agents can find and reuse what already exists instead of rebuilding it. But a catalog only tells you what exists. Once the agents are known, AgentCore issues each agent its own identity and checks it on every request, so every action traces back to a specific agent operating under a known authority. That is how you know every agent acting on your behalf.
Bound what your agent says and does, within the limits you set
Setting boundaries matters because an agent can take 10 steps you approved and still reach an outcome no one intended. It can expose sensitive data, drift off topic, or combine permitted actions in ways your policies forbid. Limits can fail in both directions. Too loose, and the agent can do what it shouldn’t. Too tight, and it can’t do its job at all. So let the agent choose how to pursue its task but never rely on it to enforce its own limits. Those limits define the agent’s boundaries and belong in the environment around the agent, enforced deterministically and evaluated across the full sequence of actions, not one step at a time.
This is where the policy you defined in Scope takes effect. Policy in AgentCore enforces it on every tool call routed through AgentCore Gateway, a secure entry point for agents, tools, and models. Because enforcement sits outside the agent’s reasoning, the same checks can hold even when the agent is buggy, manipulated, or hit with a prompt injection: it cannot turn off a control it does not run. Authority does not have to stay fixed either. Because a task’s risk changes as it proceeds, temporal policies weigh what has already happened in a session and adjust permissions as the work continues. Amazon Bedrock Guardrails governs what the agent says and is told. It filters harmful or off-topic content and redacts sensitive data. Automated Reasoning checks go further, proving a response is consistent with the policy you set, not the model’s interpretation of it.
Boundaries also govern what an agent can reach in the first place: which files it can touch, which services it can call, and which credentials it can use. Strands Box, an open-source sandbox, enforces those boundaries from outside the agent’s instructions, so the agent can work with real tools and data but reach only what you allow. The same boundaries hold from a developer’s first local session through to production, so an agent can’t do in production what it couldn’t in development.
Observe what your agent did, then improve it
Even with scoping, identity, and boundaries in place, an agent can respond in milliseconds, with no errors and every dashboard green, and still do the wrong thing. It may have retrieved the wrong information, chosen the wrong tool, or followed a path no one expected. A healthy system is not the same as a successful task. To tell the difference, you must reconstruct what the agent actually did: the context it received, the tools it called, the policy decisions applied, and the result. Testing before deployment remains essential. Production adds evidence about behavior under real conditions and gives operators what they need to investigate, intervene, and improve.
Amazon CloudWatch Omni is built for continual observation. It captures every trace and lays out each step an agent took, from model calls to tool invocations, on a timeline a team can investigate. Its built-in evaluators score agent responses for qualities standard monitoring misses, such as correctness, faithfulness, and whether the agent chose the right tool. And the traces where an agent went wrong become the dataset you test the fix against, so operating an agent and improving it draw on the same evidence.
What Trust in Depth looks like in practice
A manager asks a help desk agent to offboard Sam, an account manager who is leaving the company. The agent needs to remove Sam’s access, transfer his mailbox to his successor, and free up the license the company no longer needs. But Sam’s emails may also contain evidence needed for a client dispute. The wrong sequence could leave Sam with access after he leaves or put that evidence at risk. Security, messaging, legal, and finance each have requirements the agent must follow, even though no one has scripted the full workflow.
Two rules govern the sequence. Sam’s sign-in must be blocked before his mailbox can be converted and shared with his successor. Before changing his email license, the agent must check for a legal hold, a requirement to preserve records for a dispute, and confirm the change keeps those records protected.
Scope. Before the agent runs, the team writes these rules as policies in AgentCore. Each policy requires that the prerequisite step already succeeded for Sam’s account before the next step can run. The agent gets exactly six tools: block sign-in, check for legal holds, place a hold, convert a mailbox, give the successor access, and change a license. It gets no tool to delete the account, because the shared mailbox needs the account to survive.
Know. The agent carries its own identity, so every change to Sam’s account traces back to it.
Bound. The agent tries to convert Sam’s mailbox to a shared one for Priya, the successor. Policy in AgentCore, enforced at the AgentCore Gateway, blocks the call: Sam can still sign in, and converting the mailbox wouldn’t change his password, so his old credentials would still open it. The agent blocks Sam’s sign-in, then converts the mailbox and gives Priya access. Next it moves to the manager’s actual request, freeing up the license, but the gateway blocks that too, because no one has checked Legal’s hold list. The agent checks and finds that Legal requires Sam’s emails to be preserved for a client dispute. It places the hold, confirms it is in effect, then changes Sam’s license to one that supports that protection. The company can reclaim the broader license while keeping the evidence intact.
Observe. Every step is recorded: what the agent tried to do, what the rules decided, the hold, and the outcome.
The agent completed the task without a person approving every step. Its permissions limited what it could change, its identity made those changes traceable, and policies stopped it from acting before the required safeguards were in place. The recorded steps let the team verify that Sam’s access was blocked, his successor could use the mailbox, and the required evidence remained protected.
What becomes possible when agents are trusted
AWS brings these layers together so you can scope an agent to its job, know which agents are acting for you, bound what they do and say, see what they did and improve over time, and prove your rules hold wherever they can be stated precisely. No one layer earns that trust on its own. Together, they are Trust in Depth, and they are what turns a capable agent into an agent that can be trusted to do important work.
You draw the lines: what an agent may do on its own, what needs a person’s approval, and when it must stop. That frees your people for what only people can do: weigh the hard calls, resolve the gray areas, and own the decisions you choose to keep in human hands. As evidence builds that an agent stays inside those lines, you can widen its responsibilities or narrow them.
At AWS, we believe every organization deploying agents, on any platform, should be able to answer these four questions with evidence, and with proof wherever it applies. That is the bar AWS is building for our customers, and the one we invite the industry to hold itself to. Defense in Depth made it safe to connect systems to the world. Trust in Depth makes it safe to let agents act autonomously within it.
Start with one agent, one workflow, and one boundary you can prove. Then expand as the trust is earned.