Utilice modelos de decisión con Amazon Bedrock AgentCore Evaluations
Use decision models with Amazon Bedrock AgentCore Evaluations
Sungyeon Kim
Algunas de las preguntas que se formulan al evaluar un agente son estrechas y repetibles. ¿Se mantuvo esta respuesta dentro de la política? ¿Es seguro aprobar esta llamada a la herramienta? ¿Coincide esta respuesta con el contexto recuperado? Los modelos de decisión responden exactamente a este tipo de preguntas. Toman un estado estructurado y un conjunto fijo de respuestas permitidas y devuelven una probabilidad calibrada sobre ellas, en lugar de texto de forma libre cuya confianza varía de una ejecución a otra. Eso los hace una buena opción para el paso de puntuación en la evaluación de un agente, donde se desea una etiqueta y un número que se pueda umbralizar y confiar.
Evaluaciones de Amazon Bedrock AgentCore, una capacidad de Amazon Bedrock AgentCore, puntuación a un agente a lo largo de todo su ciclo de vida, a demanda durante el desarrollo, en trabajos por lotes contra sesiones almacenadas y en línea contra tráfico de producción. Junto con 15 evaluadores integrados, las Evaluaciones de AgentCore admiten evaluadores personalizados que se definen como un juez LLM o un evaluador basado en código. Los evaluadores personalizados LLM-as-a-judge aplican sus instrucciones y escala de calificación con un modelo en Amazon Bedrock. Los evaluadores basados en código ejecutan su propia lógica en una función AWS Lambda, y esa lógica puede llamar a su elección de sistema externo, modelo o API, incluido un modelo de decisión.
Los modelos de decisión se adaptan a preguntas con un conjunto fijo de respuestas que una persona informada podría decidir a primera vista, como si el agente rechazó una solicitud o si una respuesta se mantuvo en el tema. Después de validar una pregunta en su propio tráfico, un modelo de decisión puede ser suficiente para esa decisión o puntuación, y puede extender el mismo enfoque a categorías específicas de daño o estereotipos en su política. Debido a que ambas partes traseras pueden responder varias preguntas sobre el mismo estado en una sola solicitud, puede utilizarlas como una capa de selección en lugar de un reemplazo, ejecutando una señal de aprobación o rechazo a través de sus métricas para seleccionar las vueltas que merecen una evaluación más profunda por parte de los evaluadores integrados, cuyas explicaciones lo ayudan a investigar qué salió mal.
Esta publicación muestra cómo conectar dos partes traseras de modelos de decisión a las Evaluaciones de AgentCore a través de evaluadores basados en código. El primero es Jev, un modelo de decisión alojado de TypeSafe. El segundo es Strands Decider 2B, un modelo de decisión de código abierto que se ejecuta usted mismo. Al final de esta publicación, sabrá cómo convertir la entrada del evaluador de AgentCore en una solicitud de modelo de decisión, y las probabilidades del modelo nuevamente en un resultado de evaluación de AgentCore. Primero, sin embargo, ¿cuándo debe recurrir a un evaluador personalizado LLM-as-a-judge, y cuándo es mejor un modelo de decisión? La siguiente sección desglosa qué es un modelo de decisión y las compensaciones involucradas.
Modelos de decisión
Un modelo de decisión es un modelo pequeño y especializado entrenado para seleccionar de un conjunto fijo de opciones y devolver puntajes de confianza calibrados en lugar de generar texto de forma libre. Un evaluador de modelo de lenguaje grande (LLM) de propósito general produce un puntaje con una justificación. Un modelo de decisión, en cambio, produce una distribución de probabilidad sobre respuestas predefinidas. Eso te da una medida directa de confianza que puedes umbralizar, agregar y actuar sobre de manera programática. Esto hace que los modelos de decisión sean adecuados para tareas de evaluación donde el juicio se puede expresar como una elección entre un conjunto fijo de opciones: "¿Está esta respuesta fundamentada?" o "¿El agente completó la meta del usuario!"
Los modelos de decisión son más útiles cuando deseas un puntaje de confianza bien calibrado junto con la etiqueta, no solo un juicio binario. También son adecuados cuando deseas aplicar un rubric específico de manera consistente sin depender de un LLM de propósito general para interpretarlo.
Jev, el modelo de decisión alojado de TypeSafe, y Strands Decider, un modelo de decisión de código abierto de 2 mil millones de parámetros del equipo de Strands Agents, ambos admiten tres tipos de preguntas. Una pregunta noul plantea una pregunta de sí/no y devuelve una probabilidad entre 0 (no) y 1 (sí). Una pregunta choice pregunta cuál de hasta 255 opciones se aplica, devolviendo la opción más probable junto con la distribución completa y una confianza. Una pregunta score pregunta cuál de 2 a 10 niveles ordenados se aplica, devolviendo una puntuación ponderada por probabilidad, la distribución sobre los niveles y una confianza. Muchas rúbricas de evaluación se ajustan a uno de estos tipos. "¿Está cada hecho en esta respuesta respaldado por los resultados de la herramienta?" es una pregunta de sí/no, y "¿Cuán útil fue esta respuesta, en una rúbrica de cuatro niveles?" es una puntuación.
Modelos de decisión versus LLM como juez
Los evaluadores integrados en AgentCore hoy utilizan un LLM de propósito general para evaluar la respuesta del agente contra una rúbrica y explicar su juicio. Esto es valioso cuando la evaluación requiere conectar evidencia, identificar información faltante o trabajar en una respuesta en profundidad en tareas donde la explicación es tan útil como el puntaje. Los modelos de decisión no son un reemplazo para los evaluadores LLM. Son una adición que el marco de evaluador basado en código hace posible. Úsalos para comprobaciones estrechas y bien definidas junto con la evaluación más amplia de los evaluadores integrados.
Visión general de la solución
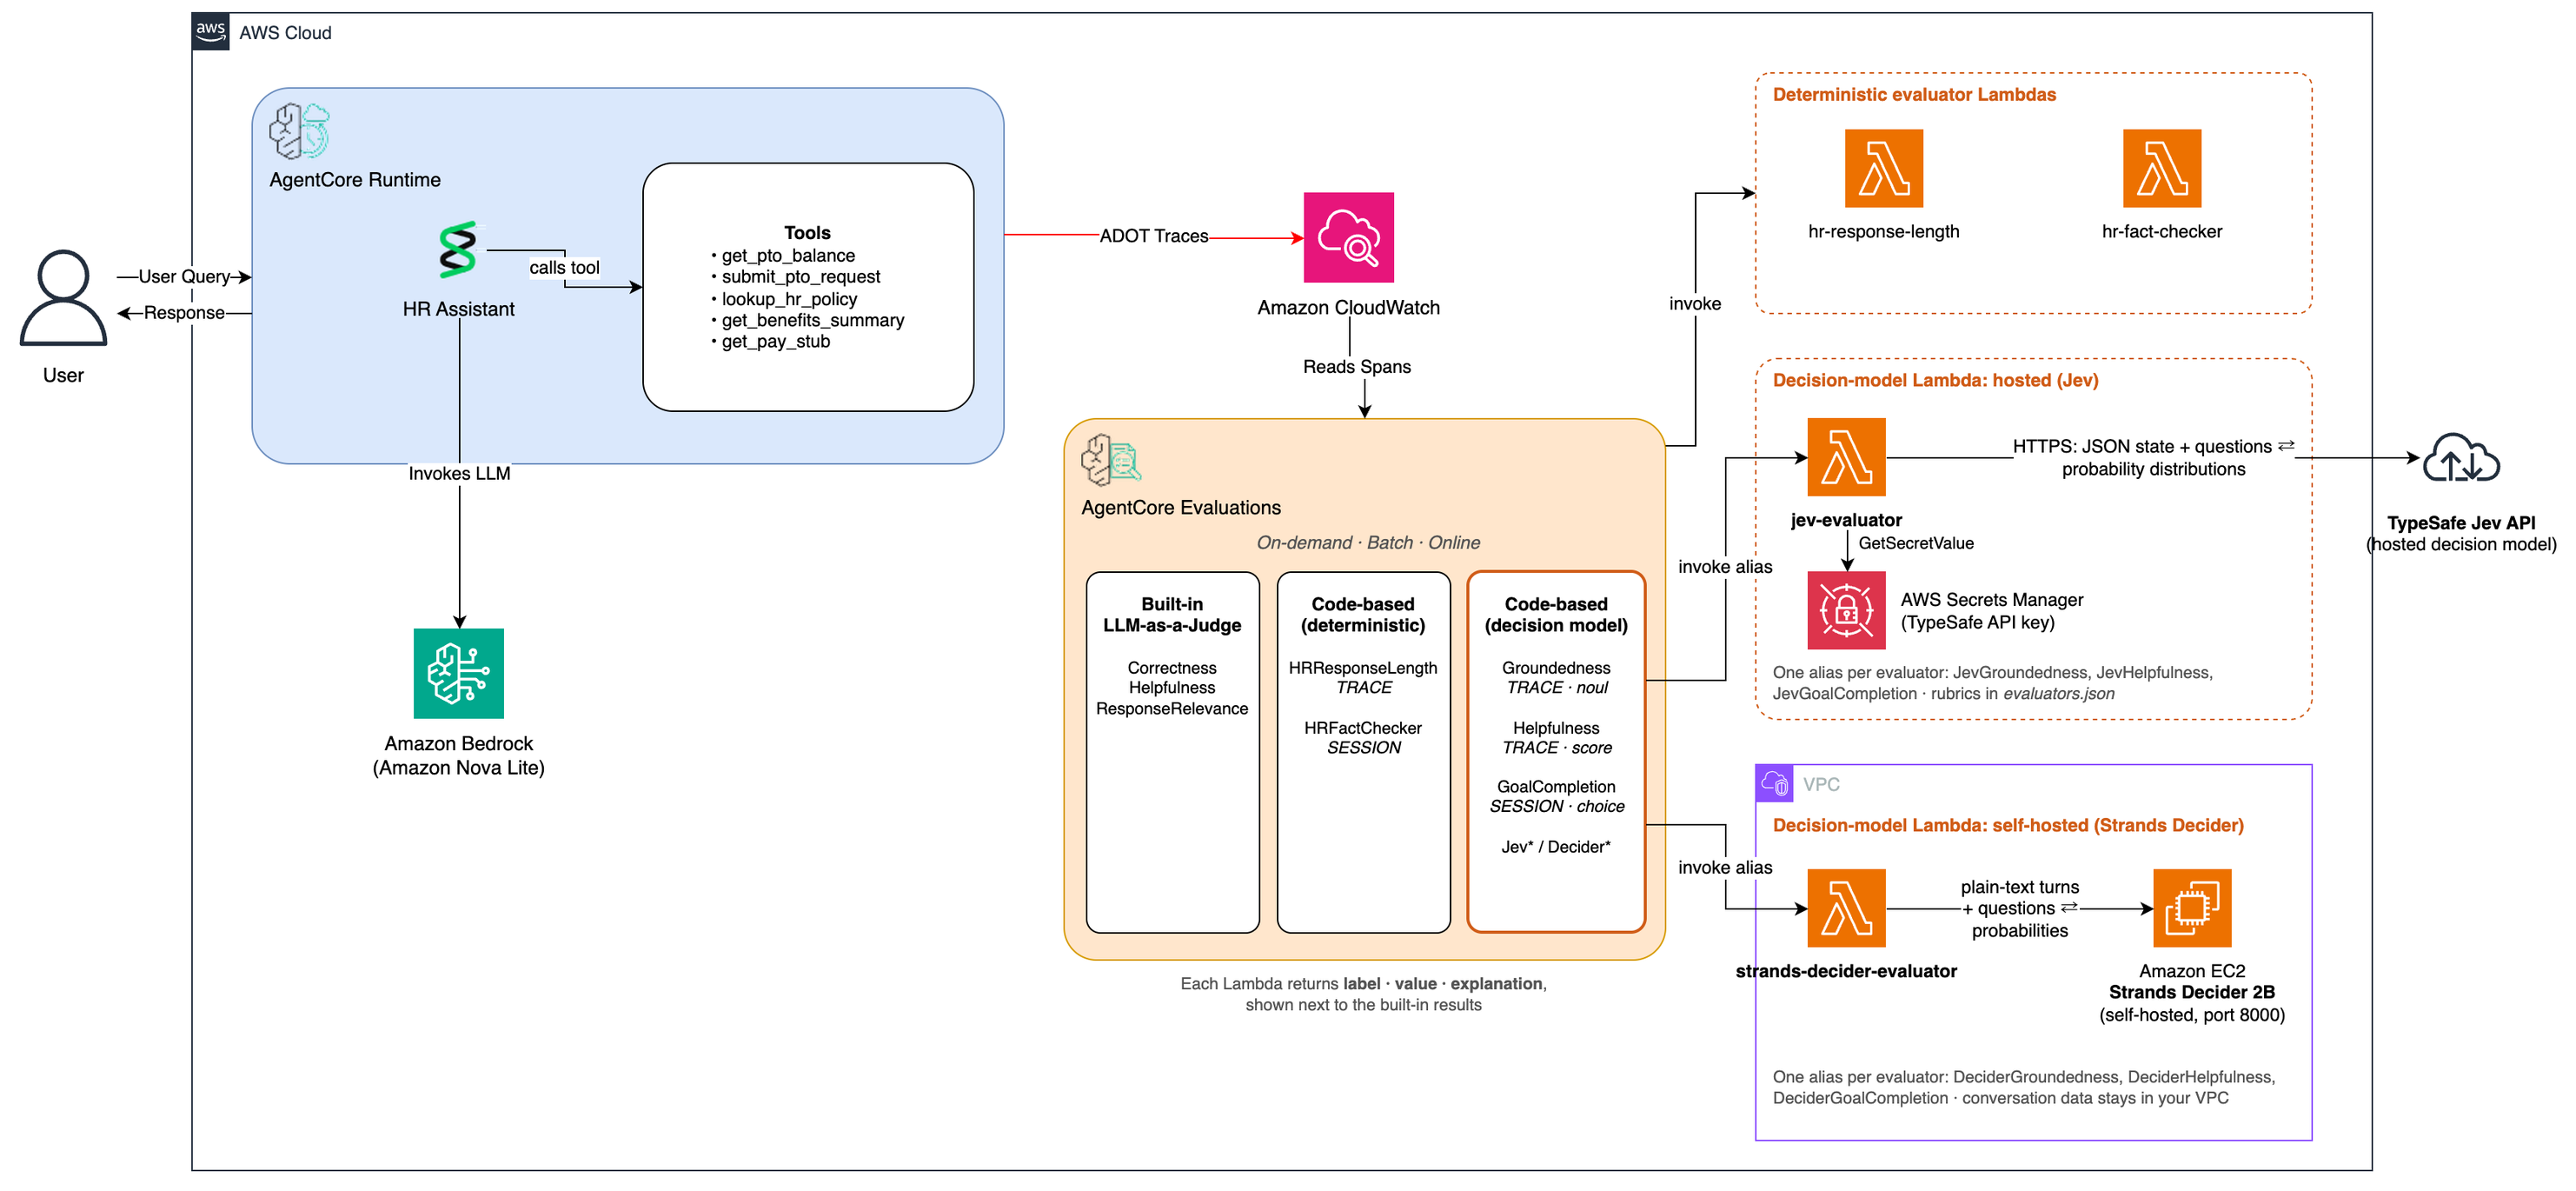
Para mostrar cómo funcionan juntos estos tipos de evaluadores, esta publicación construye un ejemplo de extremo a extremo de un agente de asistente de recursos humanos evaluado por comprobaciones deterministas basadas en código, evaluadores LLM como juez integrados y evaluadores de modelo de decisión respaldados por Jev o Strands Decider 2B.
El agente se construye con Strands Agents y se implementa en el runtime de AgentCore, una capacidad de Amazon Bedrock AgentCore. Responde a las preguntas de los empleados utilizando cinco herramientas que devuelven datos mock fijos, como saldos de tiempo libre pagado (PTO), solicitudes de PTO, políticas de RRHH, beneficios y talones de pago. Utilizamos datos fijos en este ejemplo de código para que sea sencillo verificar el comportamiento del evaluador desde LLM-as-a-judge y los modelos de decisión. Cuando también tengas la verdad fundamental, puedes confirmar si cada evaluador detecta los fallos correctos. Este ejemplo de código te ayuda a configurar el framework para probar los modelos de decisión en comparación con LLM-as-a-judge para tus propios casos de uso.
Figura 1: Arquitectura de extremo a extremo del asistente de RRHH evaluado por controles basados en código, evaluadores integrados y evaluadores de modelo de decisión respaldados por Jev o Strands Decider
Requisitos previos
Para implementar el ejemplo, necesitas lo siguiente:
Una cuenta de AWS en una Región donde esté disponible AgentCore Evaluations. El ejemplo predeterminado es US West (Oregon).
Python 3.12 o posterior, la interfaz de línea de comandos de AWS (AWS CLI) y Docker.
Jev requiere una clave de API de TypeSafe. Visita typesafe.ai para obtener detalles de acceso.
Strands Decider requiere un host que ejecute el servidor de Strands Decider. Puedes ejecutarlo localmente para pruebas o en Amazon Elastic Compute Cloud (Amazon EC2) dentro de tu red privada virtual (VPC) para que la función Lambda pueda alcanzarlo.
../utils/deploy.py despliega el asistente de RRHH en el runtime de AgentCore.
evaluate.py despliega evaluadores, invoca al agente y ejecuta los modos de evaluación.
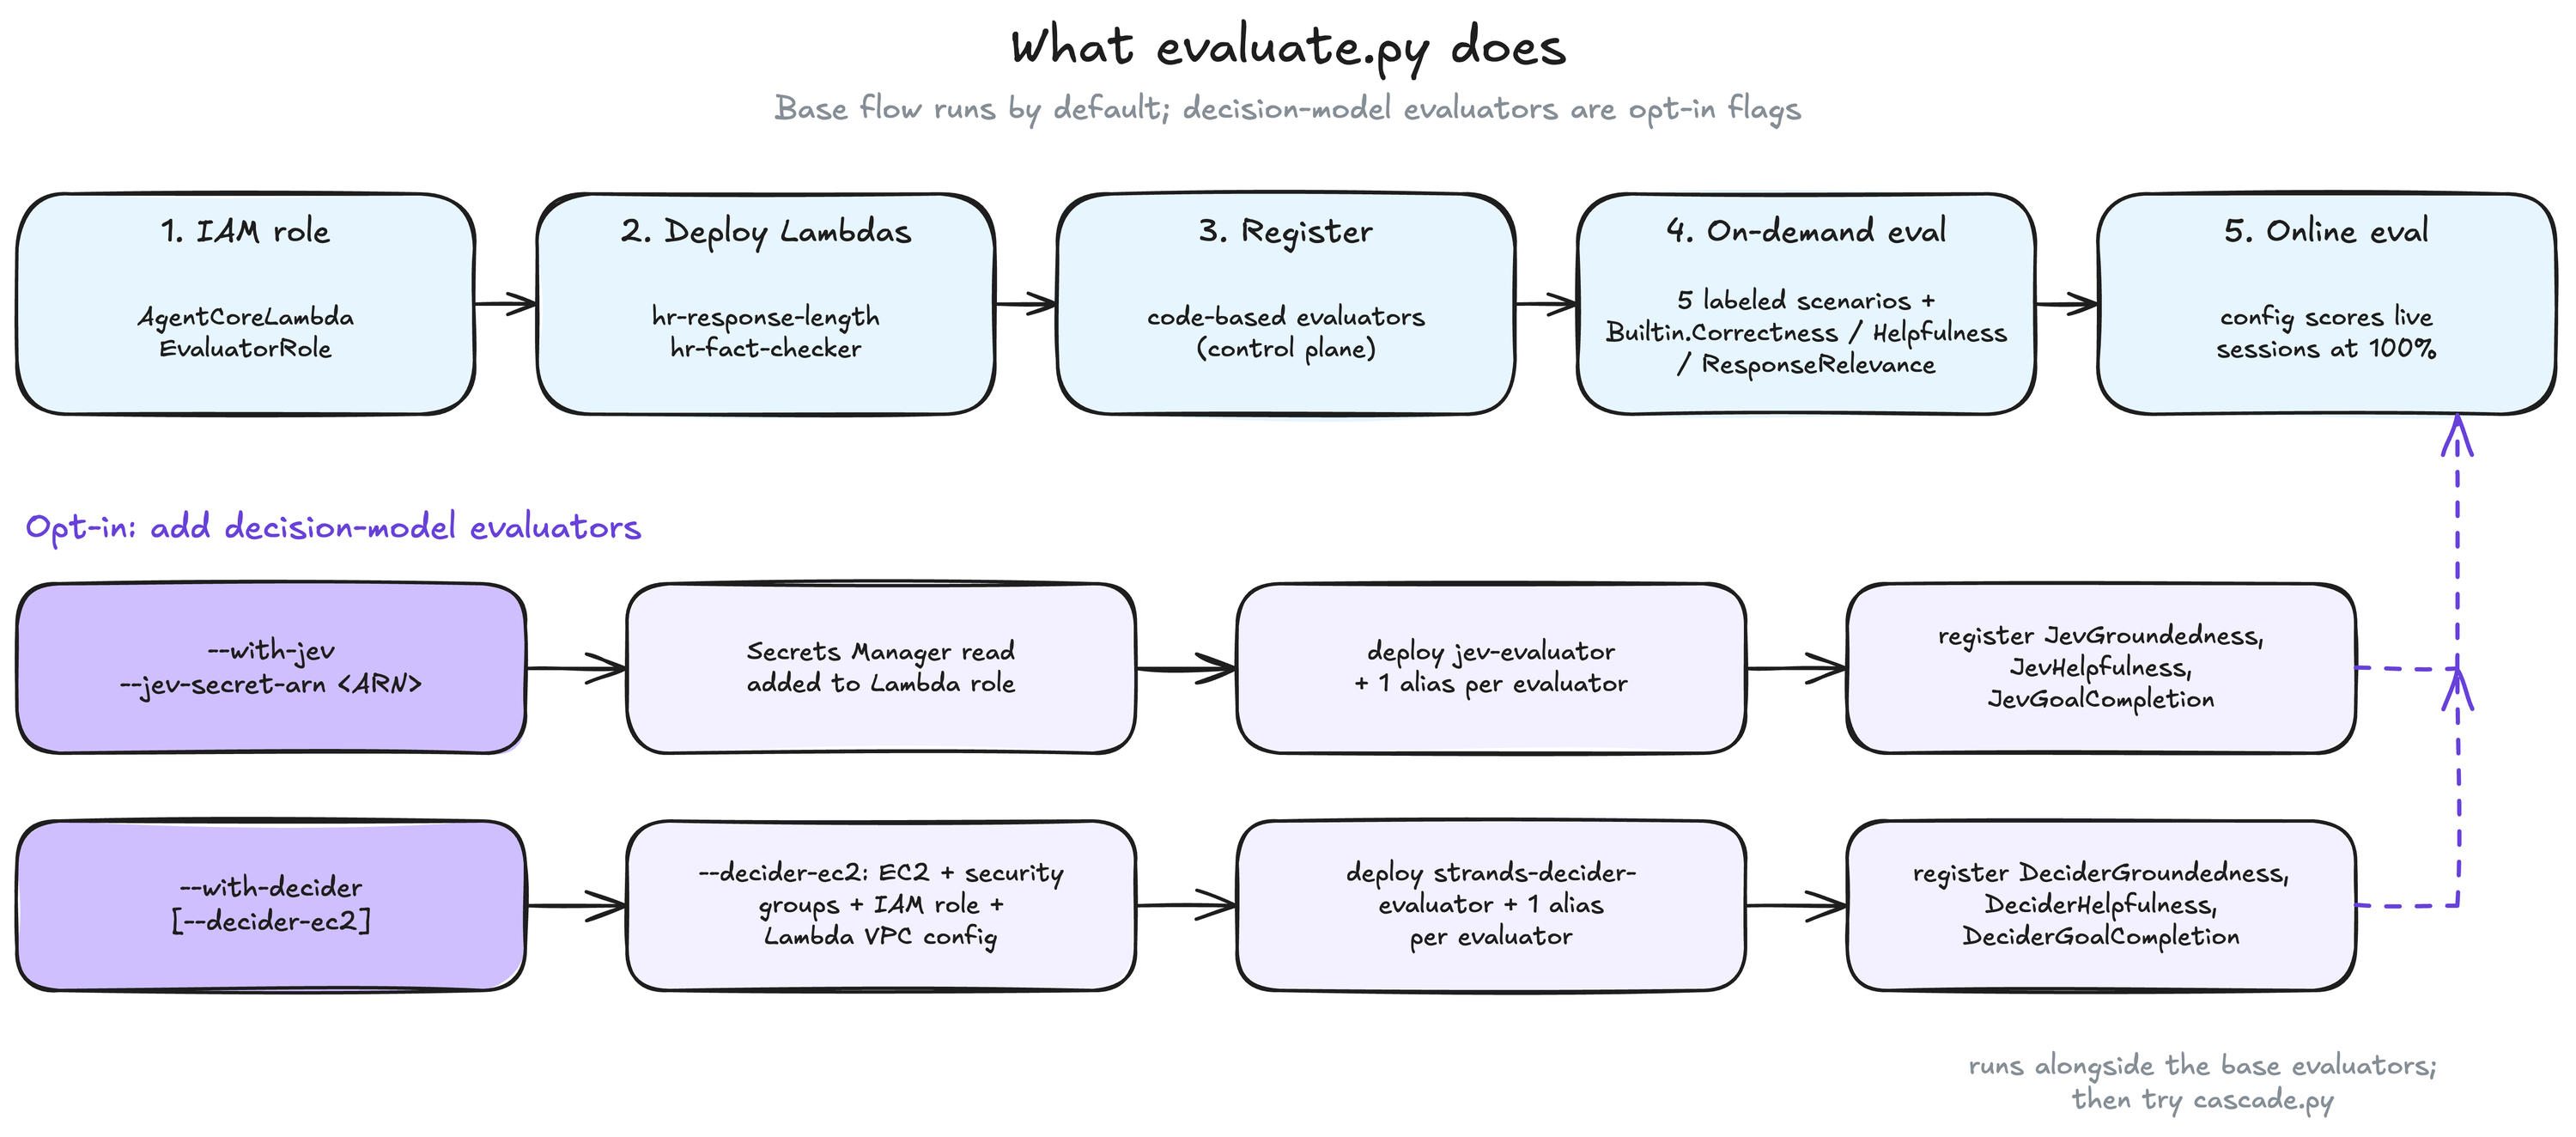
Ejecutar evaluate.py sin flags ejecuta cinco pasos:
Crea el rol de ejecución de Lambda (AgentCoreLambdaEvaluatorRole).
Empaqueta y despliega dos evaluadores de Lambda deterministas: hr-response-length (un evaluador de nivel de traza que verifica si la respuesta del agente se mantiene dentro de los límites de longitud) y hr-fact-checker (un evaluador de nivel de sesión que valida hechos de RRHH contra los datos de mock conocidos mediante regex).
Registra ambos como evaluadores de código de AgentCore a través del plano de control.
Ejecuta la evaluación bajo demanda con EvaluationClient y OnDemandEvaluationDatasetRunner en cinco escenarios etiquetados, combinando los evaluadores de código con Builtin.Correctness, Builtin.Helpfulness y Builtin.ResponseRelevance.
Crea una configuración de evaluación en línea que califica sesiones en vivo de forma continua con una muestra del 100 por ciento.
En este punto, tiene una canalización de evaluación funcionando con controles deterministas y puntuación de LLM como juez. Los evaluadores de modelo de decisión son opcionales. Puede agregarlos con una flag y se ejecutan junto con los evaluadores base sin cambios en el flujo existente. Utilizando la flag --with-jev --jev-secret-arn <ARN> despliega jev-evaluator y registra tres evaluadores: JevGroundedness, JevHelpfulness y JevGoalCompletion. Utilizando la flag --with-decider despliega strands-decider-evaluator y registra los mismos tres evaluadores respaldados por Strands Decider 2B. Agregue --decider-ec2 para aprovisionar automáticamente la instancia de Amazon EC2, grupos de seguridad, rol de IAM y configuración de VPC de Lambda sin pasos manuales de consola.
Figura 2: La canalización de evaluación desplegada por evaluate.py, desde controles deterministas hasta evaluadores integrados y de modelo de decisión
Cada backend de modelo de decisión contribuye con tres evaluadores:
Evaluador
Nivel
Tipo de pregunta
Etiqueta
Valor
JevGroundedness / DeciderGroundedness
TRAZA
noul
Basado en hechos o no basado en hechos
P(basado en hechos)
Ayuda de Jev / Ayuda de Decider
TRACE
score (4-level)
Nivel más probable
Nivel esperado, escalado 0–1
Finalización de objetivo de Jev / Finalización de objetivo de Decider
SESSION
choice (3-way)
Opción más probable
Valor con ponderación de probabilidad
Construir el evaluador con modelos de decisión
Usando las banderas --with-jev y --with-decider se crea un evaluador personalizado basado en código, donde tiene el control total del código que desea ejecutar como evaluador. Creamos funciones AWS Lambda donde el modelo de decisión se invoca dentro de una función AWS Lambda y devuelve una etiqueta o un valor numérico. Esta función Lambda se registra como el evaluador basado en código en AgentCore Evaluations.
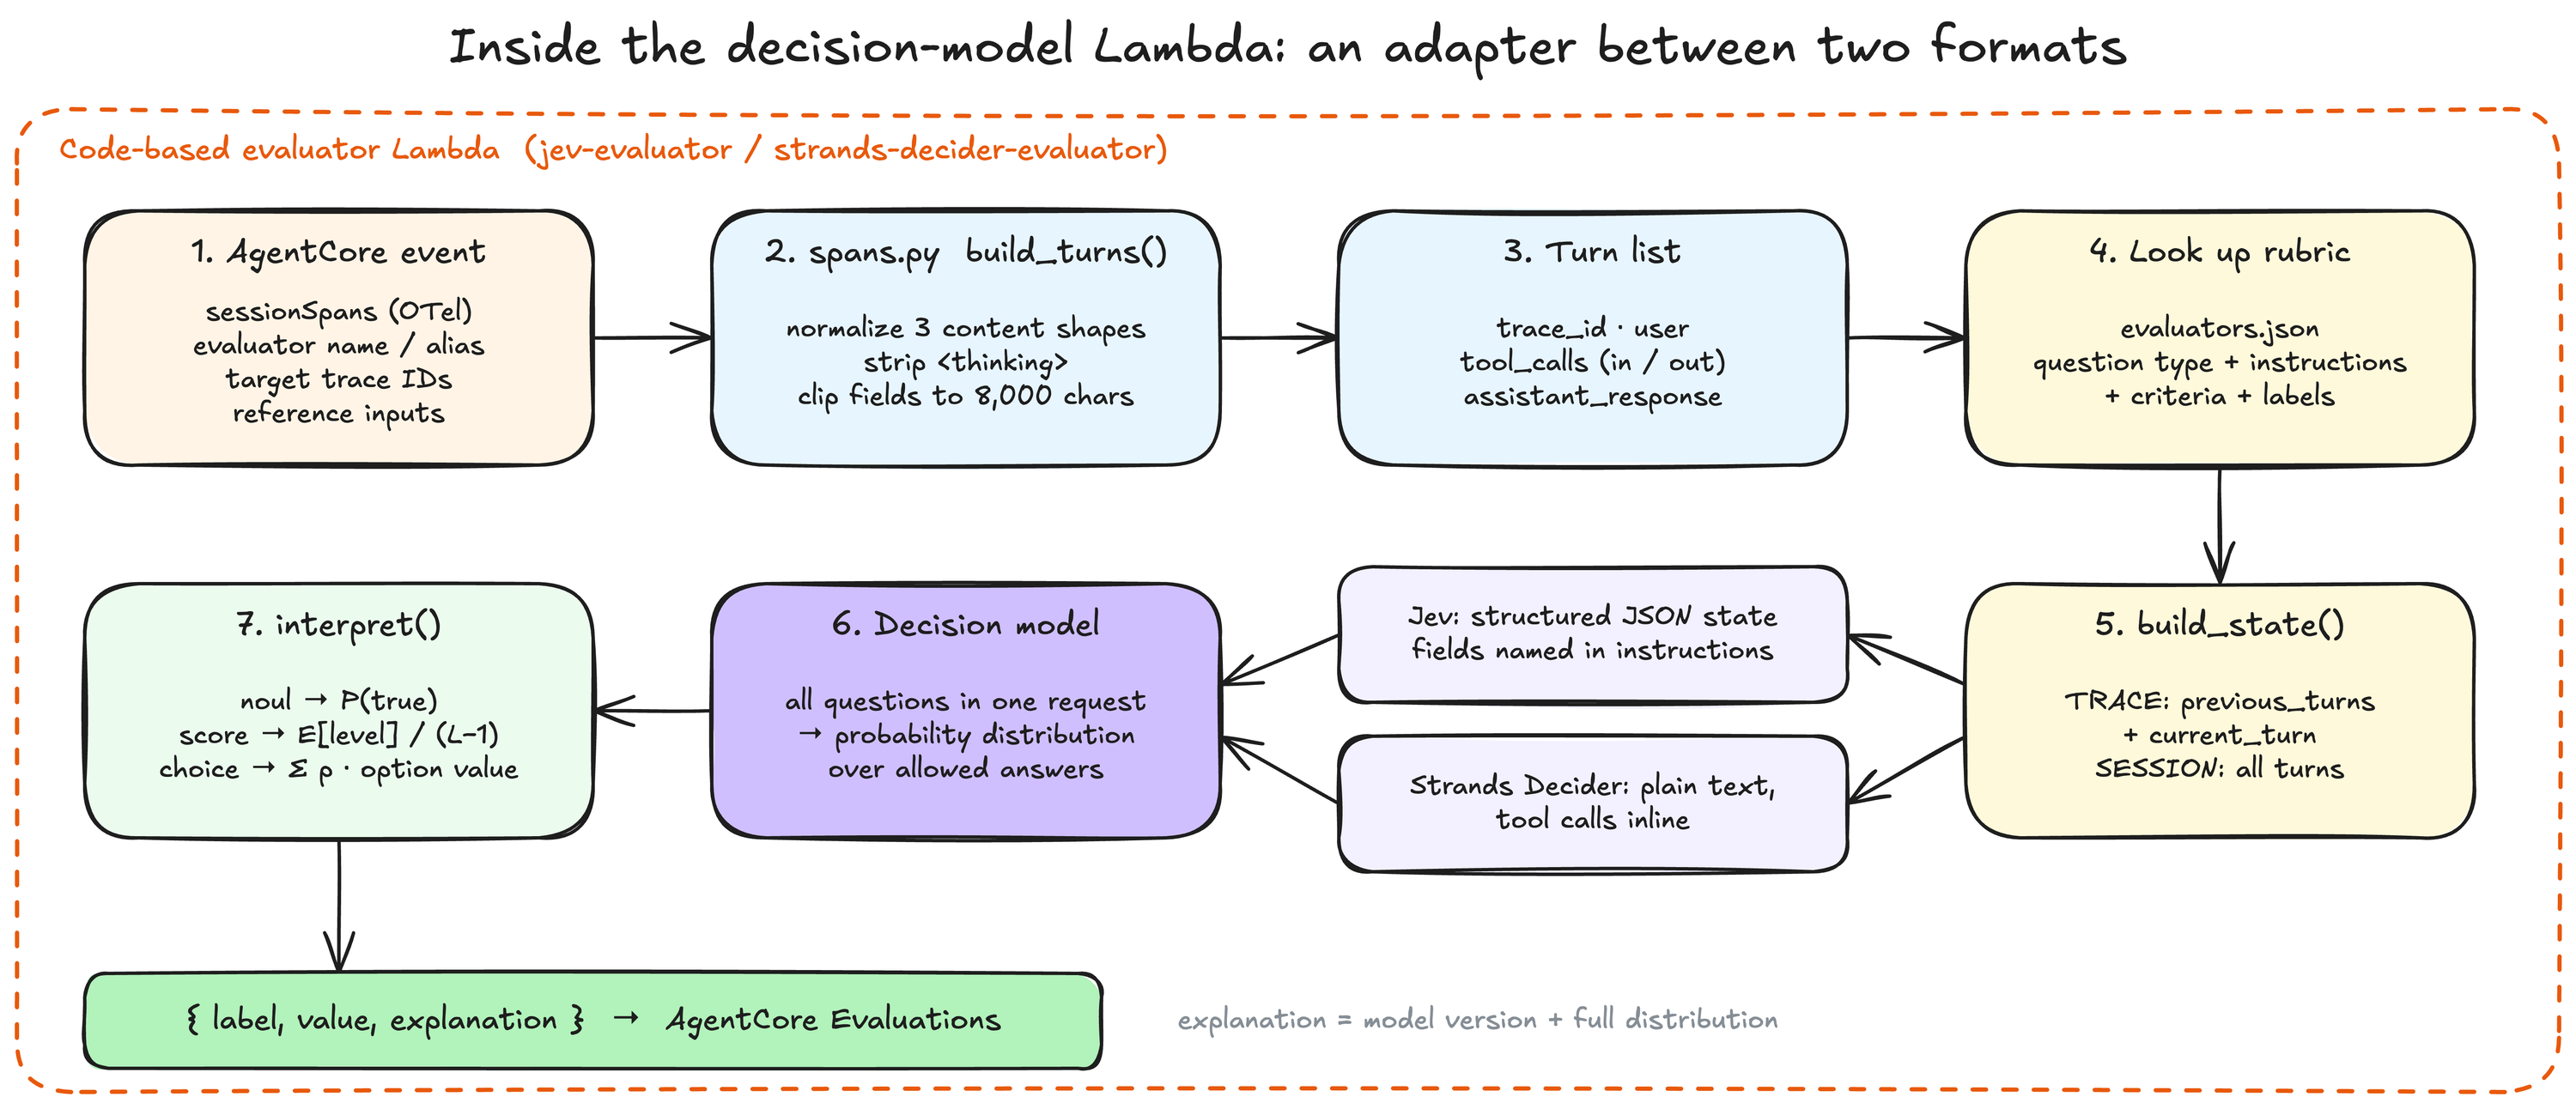
La Lambda que se registra como evaluador recibe trazas OpenTelemetry del agente. El módulo spans.py normaliza las formas en que el contenido OpenTelemetry puede llegar y luego lo formato adecuadamente para hacer la llamada al modelo de decisión. Para la evaluación a nivel de traza, solo se envían el turno objetivo y la historia breve anterior, mientras que la conversación completa se incluye para el nivel de sesión.
Figura 3: Cómo el evaluador Lambda basado en código adapta trazas OpenTelemetry para el modelo de decisión y mapea el resultado de regreso a AgentCore
El adaptador convierte la distribución de probabilidad del modelo en un resultado que la evaluación de AgentCore espera. Para una pregunta noul, la probabilidad de true se convierte en el valor y la respuesta más probable se convierte en la etiqueta. Para una pregunta score, el valor es el nivel esperado con ponderación de probabilidad escalado a [0, 1]. Para una pregunta choice, es el promedio ponderado de valores de opciones predefinidas.
Validar un evaluador de modelo de decisión en su propio tráfico
Cuando reescribas una rúbrica como una pregunta de modelo de decisión, habrás creado una nueva medición en lugar de una copia de la antigua. Una rúbrica reenfocada a menudo resulta más estricta o más flexible que la originalmente pretendida, y no verás ese desvío hasta que la compares con sesiones reales. Antes de bloquear una versión en un evaluador de modelo de decisión, valídallo de la misma manera que validarías cualquier nueva medición, contra una muestra etiquetada de tu propio tráfico. El objetivo de esta sección es guiarte a través de esa validación de principio a fin, para que termines con un evaluador con el que puedas establecer umbrales con confianza.
El procedimiento tiene cinco pasos.
Paso 1. Crea una muestra etiquetada. Extrae un conjunto de sesiones almacenadas del tráfico de tu agente, con suficiente cobertura de los fallos y casos límite que te importan. Una muestra que solo cubre la ruta feliz no te dice nada sobre dónde se rompe el evaluador.
Paso 2. Obten etiquetas de referencia humanas. Haz que tres etiquetadores independientes califiquen cada turno para la propiedad que mide tu pregunta y tomen el voto mayoritario como la etiqueta de referencia. Mantén un registro de qué turnos fueron unánimes y cuáles estuvieron divididos. Aunque los turnos unánimes son los casos claros, los turnos con voto dividido son los valiosos, porque revelan ambigüedad en la rúbrica en sí antes de que el modelo la vea.
Paso 3. Ejecuta ambos evaluadores en las mismas entradas. Ejecuta el evaluador de modelo de decisión y el evaluador integrado coincidente en esas mismas sesiones en una evaluación por lotes única. Calificar entradas idénticas es lo que hace que la comparación sea justa.
Paso 4. Lee los resultados a través de tres lentes. Con las etiquetas de voto mayoritario y la división fácil y difícil en mano, ahora puedes responder las tres preguntas que te dicen si el evaluador está listo.
Tasa de acuerdo: ¿coincide con tus humanos? Mida con qué frecuencia cada evaluador está de acuerdo con las etiquetas de votación mayoritaria y hágalo por pregunta, ya que la precisión de una pregunta no dice nada sobre la de otra. Luego desglose los números por casos fáciles (unánimes) y difíciles (votos divididos). Un evaluador que tropieza solo en los casos difíciles se comporta mucho como lo hicieron tus etiquetadores humanos, lo que es exactamente lo que deseas.
Calibración: ¿los puntajes de confianza significan algo? Agrupe las vueltas por la probabilidad informada del evaluador y compare el acuerdo de cada grupo con las etiquetas. Una mayor confianza debe rastrear una mayor precisión. Luego verifique si los casos fáciles consistentemente atraen una mayor confianza que los difíciles. Si lo hacen, la incertidumbre del modelo está rastreando la ambigüedad genuina, y puede usar esos grupos para elegir un umbral de decisión por evaluador en lugar de usar el valor predeterminado de 0,5.
Análisis de desacuerdo: ¿dónde y por qué difieren? Encuentre las vueltas donde los dos evaluadores no están de acuerdo entre sí y verifique si esas son las mismas vueltas que sus humanos encontraron ambiguas. Léalas. La mayoría de los desacuerdos se remontan a la redacción de la pregunta, y una pregunta revisada las aclara. Cuando los errores se agrupan en los casos difíciles, el rubric es el problema en lugar del modelo.
Paso 5. Vuelva a ejecutar la comprobación cuando algo cambie. Trátelo como una comprobación repetible en lugar de una puerta de una sola vez. Cada vez que reformule una pregunta o pase a una nueva versión del modelo, ejecute la comprobación nuevamente. Cada explicación de resultado registra la versión del modelo que lo produjo, por lo que sabe de qué versión provino una puntuación determinada.
Elección del mejor conjunto de evaluadores para su agente
Los evaluadores integrados siguen siendo la base de la estrategia de evaluación amplia en AgentCore Evaluations. Evalúan la respuesta contra un rubric y su contexto de apoyo, y explican el juicio para que los desarrolladores puedan investigar qué salió mal. Para el asistente de recursos humanos, una evaluación de fidelidad puede identificar una afirmación que contradice un resultado de herramienta, mientras que una evaluación de utilidad puede señalar que el agente respondió una pregunta de equilibrio pero dejó una acción solicitada incompleta.
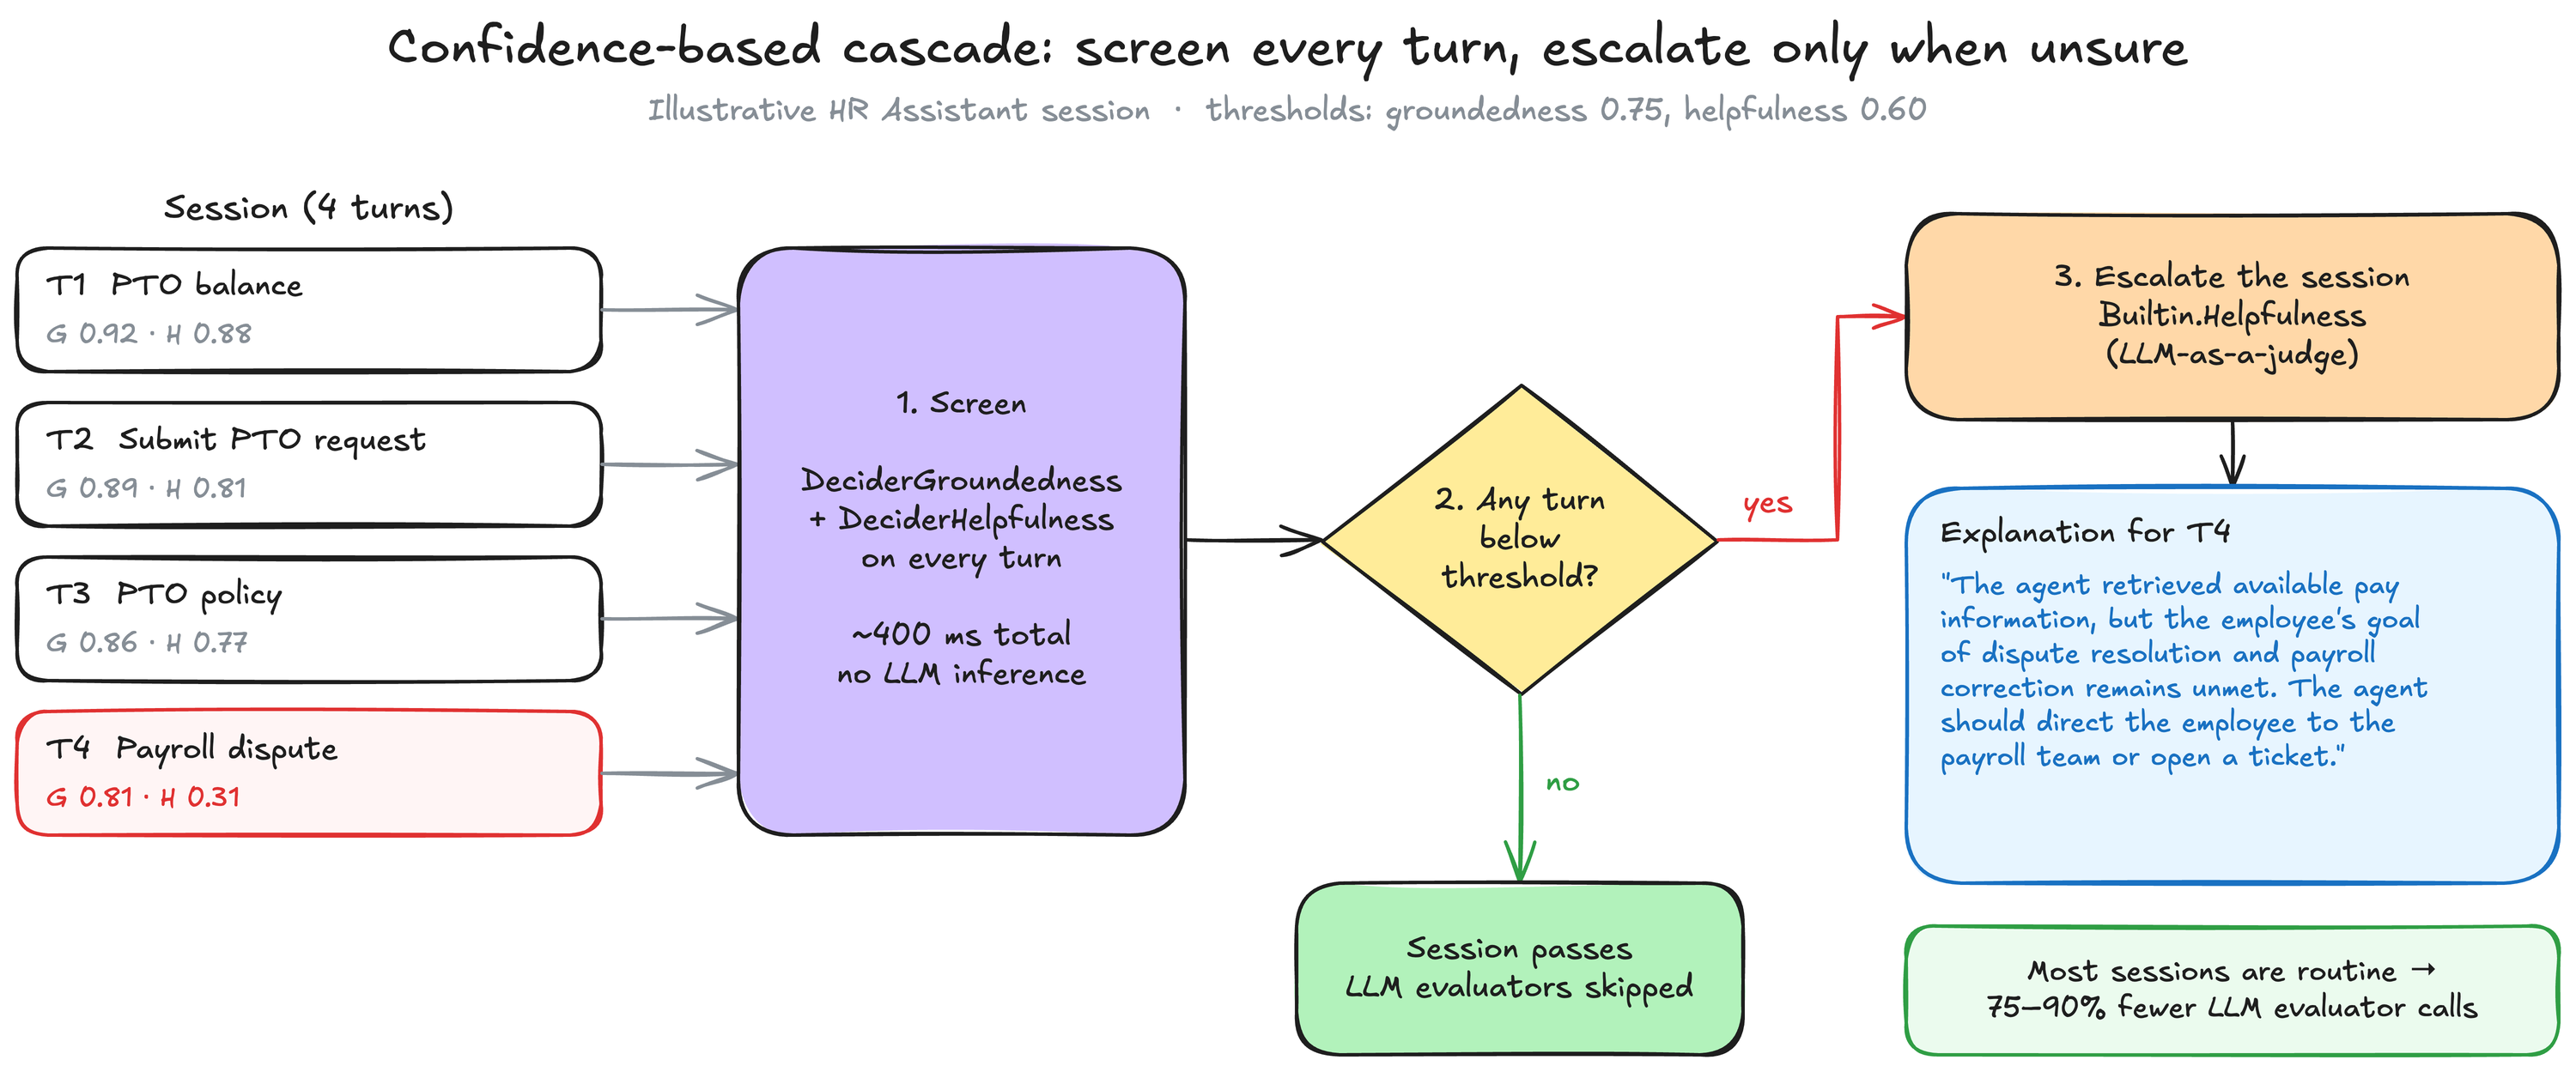
La fidelidad, la utilidad y la corrección pueden requerir conectar evidencia, identificar información faltante o trabajar a través de una solución. El preprint JEV-as-a-Judge: Accept When Confident, Escalate When Unsure describe una distinción relacionada como “leer versus derivar”. Una verificación de modelo de decisión estrecha puede marcar un turno para llamar la atención, mientras que el evaluador integrado proporciona la evaluación y razonamiento más amplias necesarias para revisarlo. Los modelos de decisión brillan con más fuerza cuando se los trata como una puerta en lugar de un reemplazo. El patrón de cascada funciona de la siguiente manera. Primero, ejecuta un modelo de decisión rápido y calibrado en cada turno de cada sesión para obtener una señal de aprobado/reprobado a bajo costo. Luego, invoca un evaluador de LLM completo solo en las sesiones donde la señal decae por debajo de su umbral.
Figura 4: El patrón de cascada, donde un modelo de decisión calibrado examina cada turno y solo los turnos de baja confianza escalan a un evaluador integrado
Criterio
LLM como juez
Modelos de decisión como juez
Salida
Puntuación + explicación
Probabilidad calibrada
Latencia
2–10 s
~cientos de ms (red)
Personalizable
Limited (plantillas de prompting fijas)
Definiciones de preguntas
Mejor para
Matices cualitativos, explicación
Juicio calibrado
Recomendamos la siguiente configuración:
Configure la evaluación en línea con los evaluadores integrados en los que confías, como la medida estándar de calidad en todos tus agentes.
Agrega evaluadores de modelo de decisión para preguntas de sí/no y de elección específicas del dominio a la misma configuración, junto con evaluadores deterministas basados en código para cualquier cosa que puedas calcular con exactitud.
Cada semana, o según el calendario que se adapte a tu ciclo de lanzamiento, consulta los resultados en línea de las sesiones donde falló una comprobación del modelo de decisión o obtuvo una puntuación cerca de su umbral, y ejecuta evaluaciones por lotes en esas sesiones con los evaluadores integrados para obtener explicaciones.
Controla los lanzamientos con los evaluadores integrados y con los evaluadores de modelo de decisión que hayas validado contra datos etiquetados, y rastrea con qué frecuencia están de acuerdo los dos.
Limpieza
Para evitar cargos continuos, ejecuta el cleanup.py que elimina el agente alojado en el runtime de AgentCore, los evaluadores y la configuración de evaluación, las funciones de AWS Lambda registradas como evaluadores, la instancia de EC2 que aloja el modelo de Strands Decider, la clave de AWS Secrets Manager y el grupo de registros asociado en CloudWatch.
Conclusión
En esta publicación, conectaste dos modelos de decisión, Jev y Strands Decider, a las Evaluaciones de AgentCore utilizando evaluadores basados en código, y la muestra de código acompañante te proporciona un marco para probar esos modelos y ver dónde agregan valor como evaluadores. Los evaluadores integrados siguen siendo tu referencia. Los modelos de decisión agregan comprobaciones validadas y estrechas que vienen con una medida de certeza que puedes umbralizar y actuar en consecuencia. El camino práctico hacia adelante es agregar comprobaciones de modelo de decisión junto con los evaluadores integrados que ya ejecutas, medir con qué frecuencia están de acuerdo con tus etiquetas de referencia en tu propio tráfico y ampliar la cobertura solo una vez que confíes en ellos.
Some of the questions you ask when evaluating an agent are narrow and repeatable. Did this response stay on policy? Is this tool call safe to approve? Does this answer match the retrieved context? Decision models answer exactly that kind of question. They take a structured state and a fixed set of allowed answers and return a calibrated probability over them, rather than free-form text whose confidence drifts from run to run. That makes them a strong fit for the scoring step in an agent evaluation, where you want a label and a number you can threshold and trust.
Amazon Bedrock AgentCore Evaluations, a capability of Amazon Bedrock AgentCore, scores an agent through its entire lifecycle, on demand during development, in batch jobs against stored sessions, and online against production traffic. Alongside 15 built-in evaluators, AgentCore Evaluations supports custom evaluators that you define as either an LLM-as-a-judge or a code-based evaluator. Custom LLM-as-a-judge evaluators apply your instructions and rating scale with a model in Amazon Bedrock. Code-based evaluators run your own logic in an AWS Lambda function, and that logic can call your choice of external system, model, or API, including a decision model.
Decision models suit questions with a fixed set of answers that an informed person could decide at a glance, such as whether the agent refused a request or whether a response stayed on topic. After you validate a question on your own traffic, a decision model can be sufficient for that decision or score, and you can extend the same approach to specific harmfulness or stereotyping categories in your policy. Because both backends can answer several questions about the same state in a single request, you can use them as a screening layer rather than a replacement, running a pass or fail signal across your metrics to select the turns that warrant deeper assessment by the built-in evaluators, whose explanations help you investigate what went wrong.
This post shows how to connect two decision model backends to AgentCore Evaluations through code-based evaluators. The first is Jev, a hosted decision model from TypeSafe. The second is Strands Decider 2B, an open-source decision model you run yourself. By the end of this post, you will know how to convert the AgentCore evaluator input into a decision model request, and the model’s probabilities back into an AgentCore evaluation result. First, though, when should you reach for a custom LLM-as-a-judge evaluator, and when does a decision model fit better? The next section breaks down what a decision model is and the trade-offs involved.
Decision models
A decision model is a small, specialized model trained to select from a fixed set of options and return calibrated confidence scores rather than generating free-form text. A general-purpose large language model (LLM) evaluator produces a score with a rationale. A decision model instead produces a probability distribution over predefined answers. That gives you a direct confidence measure you can threshold, aggregate, and act on programmatically. This makes decision models well-suited for evaluation tasks where the judgment can be stated as a choice among a fixed set of options: “Is this response grounded?” or “Did the agent complete the user’s goal?”
Decision models are most useful when you want a well-calibrated confidence score alongside the label, not just a binary judgment. They are also appropriate when you want to enforce a specific rubric consistently without relying on a general-purpose LLM to interpret it.
Jev, the hosted decision model from TypeSafe, and Strands Decider, an open-source, 2-billion-parameter decision model from the Strands Agents team, both support three types of questions. A noul question poses a yes/no question and returns a probability between 0 (no) and 1 (yes). A choice question asks which of up to 255 options applies, returning the most probable option along with the full distribution and a confidence. A score question asks which of 2 to 10 ordered levels applies, returning a probability-weighted score, the distribution over levels, and a confidence. Many evaluation rubrics fit one of these types. “Is every fact in this response supported by the tool results?” is a yes/no question, and “How helpful was this response, on a four-level rubric?” is a score.
Decision models versus LLM-as-a-judge
The built-in evaluators in AgentCore today use a general-purpose LLM to assess the agent response against a rubric and explain its judgment. This is valuable when the evaluation requires connecting evidence, identifying missing information, or working through a response in depth in tasks where the explanation is as useful as the score. Decision models are not a replacement for LLM evaluators. They’re an addition that the code-based evaluator framework makes possible. Use them for narrow, well-defined checks alongside the built-in evaluators’ broader assessment.
Solution overview
To show how these evaluator types work together, this post builds an end-to-end example of an HR Assistant agent evaluated by deterministic code-based checks, built-in LLM-as-a-judge evaluators, and decision-model evaluators backed by Jev or Strands Decider 2B.
The agent is built with Strands Agents and deployed to AgentCore runtime, a capability of Amazon Bedrock AgentCore. It answers employee questions using five tools that return fixed mock data such as paid time off (PTO) balances, PTO requests, HR policies, benefits, and pay stubs. We use fixed data in this code sample to make it straightforward to verify evaluator behavior from LLM-as-a-judge and decision models. When you additionally have ground truth, you can confirm whether each evaluator catches the right failures. This code sample helps you set up the framework for testing decision models compared to LLM-as-a-judge for your own use cases.
Figure 1: End-to-end architecture of the HR Assistant evaluated by code-based checks, built-in evaluators, and decision-model evaluators backed by Jev or Strands Decider
Prerequisites
To deploy the sample, you need the following:
An AWS account in a Region where AgentCore Evaluations is available. The sample defaults to US West (Oregon).
Python 3.12 or later, the AWS Command Line Interface (AWS CLI), and Docker.
Jev requires a TypeSafe API key. Visit typesafe.ai for access details.
Strands Decider requires a host running the Strands Decider server. You can run it locally for testing, or on Amazon Elastic Compute Cloud (Amazon EC2) inside your virtual private cloud (VPC) so the Lambda function can reach it.
../utils/deploy.py deploys the HR Assistant to AgentCore runtime.
evaluate.py deploys evaluators, invokes the agent, and runs the evaluation modes.
Running evaluate.py without flags executes five steps:
Creates the Lambda execution role (AgentCoreLambdaEvaluatorRole).
Packages and deploys two deterministic Lambda evaluators: hr-response-length (a trace-level evaluator that checks whether the agent’s response stays within length bounds) and hr-fact-checker (a session-level evaluator that regex-validates HR facts against the known mock data).
Registers both as AgentCore code-based evaluators through the control plane.
Runs on-demand evaluation with EvaluationClient and OnDemandEvaluationDatasetRunner across five labeled scenarios, combining the code-based evaluators with Builtin.Correctness, Builtin.Helpfulness, and Builtin.ResponseRelevance.
Creates an online evaluation configuration that continuously scores live sessions at 100 percent sampling.
At this point you have a working evaluation pipeline with deterministic checks and LLM-as-a-judge scoring. Decision-model evaluators are opt-in. You can add them with a flag, and they run alongside the base evaluators with no changes to the existing flow. Using the flags --with-jev --jev-secret-arn <ARN> deploys jev-evaluator and registers three evaluators: JevGroundedness, JevHelpfulness, and JevGoalCompletion. Using the flag --with-decider deploys strands-decider-evaluator and registers the same three evaluators backed by Strands Decider 2B. Add --decider-ec2 to auto-provision the Amazon EC2 instance, security groups, IAM role, and Lambda VPC configuration without manual console steps.
Figure 2: The evaluation pipeline deployed by evaluate.py, from deterministic checks through built-in and decision-model evaluators
Each decision-model backend contributes three evaluators:
Evaluator
Level
Question type
Label
Value
JevGroundedness / DeciderGroundedness
TRACE
noul
Grounded or Ungrounded
P(grounded)
JevHelpfulness / DeciderHelpfulness
TRACE
score (4-level)
Most probable level
Expected level, scaled 0–1
JevGoalCompletion / DeciderGoalCompletion
SESSION
choice (3-way)
Most probable option
Probability-weighted value
Build the evaluator with decision models
Using the flags --with-jev and --with-decider creates a custom code-based evaluator, where you have complete control of the code you want to run as your evaluator. We create AWS Lambda functions where the decision model is invoked inside an AWS Lambda function and returns a label or a numeric value. This Lambda function is registered as the code-based evaluator in AgentCore Evaluations.
The Lambda that is registered as the evaluator receives OpenTelemetry spans of the agent. The spans.py module normalizes the shapes OpenTelemetry content can arrive in and then formats it appropriately to make the call to the decision model. For trace-level evaluation, only the targeted turn and brief prior history are sent, whereas the full conversation is included for session-level.
Figure 3: How the code-based evaluator Lambda adapts OpenTelemetry spans for the decision model and maps the result back to AgentCore
The adapter converts the model’s probability distribution into a result that AgentCore evaluation expects. For a noul question, the probability of true becomes the value and the most probable answer becomes the label. For a score question, the value is the probability-weighted expected level scaled to [0, 1]. For a choice question, it is the weighted average of predefined option values.
Validate a decision-model evaluator on your own traffic
When you rewrite a rubric as a decision model question, you’ve created a new measurement rather than a copy of the old one. A reframed rubric often lands stricter or looser than the original intended, and you won’t see that drift until you check it against real sessions. Before you gate a release on a decision-model evaluator, validate it the same way you’d validate any new measurement, against a labeled sample of your own traffic. The goal of this section is to walk you through that validation end to end, so you finish with an evaluator you can threshold with confidence.
The procedure has five steps.
Step 1. Build a labeled sample. Pull a set of stored sessions from your agent’s traffic, with enough coverage of the failures and edge cases you care about. A sample that covers only the happy path tells you nothing about where the evaluator breaks.
Step 2. Get human reference labels. Have three independent labelers score each turn for the property your question measures and take the majority vote as the reference label. Keep track of which turns were unanimous and which were split. Although unanimous turns are the clear-cut cases, the split-vote turns are the valuable ones, because they reveal ambiguity in the rubric itself before the model ever sees it.
Step 3. Run both evaluators on the same inputs. Run the decision-model evaluator and the matching built-in evaluator over those same sessions in a single batch evaluation. Scoring identical inputs is what makes the comparison apples to apples.
Step 4. Read the results through three lenses. With the majority-vote labels and the easy and hard split in hand, you can now answer the three questions that tell you whether the evaluator is ready.
Agreement rate: does it match your humans? Measure how often each evaluator agrees with the majority-vote labels, and do it per question, since one question’s accuracy says nothing about another’s. Then break the numbers out by easy (unanimous) and hard (split-vote) cases. An evaluator that stumbles only on the hard cases is behaving a lot like your human labelers did, which is exactly what you want.
Calibration: do the confidence scores mean something? Group turns by the evaluator’s reported probability and compare each group’s agreement with the labels. Higher confidence should track higher accuracy. Then check whether easy cases consistently draw higher confidence than hard ones. If they do, the model’s uncertainty is tracking genuine ambiguity, and you can use those groups to pick a decision threshold per evaluator instead of defaulting to 0.5.
Disagreement analysis: where and why do they differ? Find the turns where the two evaluators disagree with each other, and check whether those are the same turns your humans found ambiguous. Read them. Most disagreements trace back to the wording of the question, and a revised question clears them up. When the errors cluster in the hard cases, the rubric is the problem rather than the model.
Step 5. Re-run the check when anything changes. Treat this as a repeatable check rather than a one-time gate. Any time you reword a question or move to a new model version, run it again. Each result’s explanation records the model version that produced it, so you know which version a given score came from.
Choosing the best set of evaluators for your agent
The built-in evaluators remain the foundation of broad evaluation strategy in AgentCore Evaluations. They assess the response against a rubric and its supporting context, and explain the judgment so developers can investigate what went wrong. For the HR Assistant, a faithfulness evaluation can identify a claim that contradicts a tool result, whereas a helpfulness evaluation can point out that the agent answered a balance question but left a requested action incomplete.
Faithfulness, helpfulness, and correctness can require connecting evidence, identifying missing information, or working through a solution. The preprint JEV-as-a-Judge: Accept When Confident, Escalate When Unsure describes a related distinction as “reading versus deriving.” A narrow decision-model check can flag a turn for attention, whereas the built-in evaluator provides the broader assessment and reasoning needed to review it. Decision models shine brightest when you treat them as a gate rather than a replacement. The cascade pattern works like this. First, run a fast, calibrated decision model on every turn of every session to get a cheap pass/fail signal. Then invoke a full LLM evaluator only on sessions where the signal falls below your threshold.
Figure 4: The cascade pattern, where a calibrated decision model screens every turn and only low-confidence turns escalate to a built-in evaluator
Criterion
LLM as Judge
Decision Models as Judge
Output
Score + explanation
Calibrated probability
Latency
2–10 s
~hundreds of ms (network)
Customizable
Limited (fixed prompt templates)
Question definitions
Best for
Qualitative nuance, explanation
Calibrated judgment
We recommend the following setup:
Configure online evaluation with the built-in evaluators you rely on, as the standard measure of quality across your agents.
Add decision-model evaluators for domain-specific yes/no and choice questions to the same configuration, along with deterministic code-based evaluators for anything you can compute exactly.
Each week, or on whatever schedule suits your release cycle, query the online results for sessions where a decision-model check failed or scored near its threshold, and run batch evaluations on those sessions with the built-in evaluators to get explanations.
Gate releases on the built-in evaluators and on the decision-model evaluators you have validated against labeled data, and track how often the two agree.
Clean up
To avoid ongoing charges, run the cleanup.py that deletes the agent hosted on AgentCore runtime, the evaluators and evaluation config, the AWS Lambda functions that are registered as the evaluators, the EC2 instance that hosts the Strands Decider model, AWS Secrets Manager key and the associated log group on CloudWatch.
Conclusion
In this post, you connected two decision models, Jev and Strands Decider, to AgentCore Evaluations using code-based evaluators, and the accompanying code sample gives you a framework for testing those models and seeing where they add value as evaluators. The built-in evaluators remain your baseline. Decision models add narrow, validated checks that come with a measure of certainty you can threshold and act on. The practical path forward is to add decision-model checks alongside the built-in evaluators you already run, measure how often they agree with your reference labels on your own traffic, and expand coverage only once you trust them.