Cree su propio ciclo de entrenamiento, sin administrar las GPU, con las API de sesión de entrenamiento de Amazon SageMaker
Write your own training loop — without managing GPUs — with Amazon SageMaker training session APIs
Nicolas Jourdan
El
ajuste preciso de un modelo de lenguaje de gran tamaño (LLM) en la actualidad suele forzar un equilibrio entre el control del ciclo de entrenamiento y la simplicidad operativa. Con los servicios totalmente gestionados, usted selecciona un modelo base, proporciona datos e hiperparámetros, y el servicio es el propietario de todo lo demás, lo que funciona bien cuando se ajusta a su problema una receta estándar y preempaquetada. Los servicios menos gestionados proporcionan más control, pero también permiten gestionar una mayor parte de la infraestructura subyacente y los marcos de formación. A veces, una receta estándar no basta: necesitas un plan de estudios personalizado sobre pérdida de datos o pérdida de datos para realizar ajustes supervisados (SFT), optimizar tus propias preferencias, una función de recompensa por aprendizaje por refuerzo (RL) o un algoritmo de alineación publicado la semana pasada. Tan pronto como necesites configurar el procedimiento de formación por ti mismo, te encargarás de ese trabajo de infraestructura para ganar libertad algorítmica
.
En la
actualidad, la personalización de modelos sin servidor en Amazon SageMaker AI se amplía con las API de las sesiones de entrenamiento, que eliminan esa desventaja al trazar el límite de abstracción un nivel más abajo. En lugar de abstraer el algoritmo, abstraen el cálculo. Operaciones como forward_backward (), optim_step () y sample () se convierten en llamadas a la API de SageMaker que puedes componer en cualquier procedimiento que requiera tu técnica: SFT, optimización de preferencias, RL o algo nuevo. Las llamadas tienen como objetivo una sesión activa y con estado, por lo que el modelo permanece cargado en las GPU a lo largo de los pasos y puedes generar tantas llamadas como necesites para evitarlo. El servicio gestiona la configuración del tiempo de ejecución, la ejecución distribuida, la sincronización gradual, la recuperación de errores, el aislamiento de los inquilinos y las operaciones de ejecución de las GPU a escala. Usted escribe el ciclo de entrenamiento y SageMaker AI ejecuta la infraestructura
.
Junto con el servicio, publicamos el recetario de sesiones de entrenamiento de SageMaker, un conjunto de recetas de SFT y RL listas para usar que puedes usar como modelo para tus propios ciclos de entrenamiento.
En este artículo, presentamos el modelo de programación y los tres clientes del SDK, y mostramos qué lugar ocupan las API de las sesiones de entrenamiento entre las opciones de entrenamiento y personalización del modelo de SageMaker AI. A continuación, desarmamos un ciclo mínimo de RL en los problemas matemáticos de la escuela primaria (GSM8K) para mostrar cómo encajan las operaciones y terminamos con una carga de trabajo real del libro de cocina: el aprendizaje por refuerzo en problemas de programación competitivos, en el que el código generado se califica comparándolo con pruebas unitarias.
¿Qué son las API de las sesiones de entrenamiento de SageMaker AI?
Con las API de sesiones de entrenamiento de SageMaker AI, puede dirigir una sesión en vivo respaldada por la GPU desde su propio proceso de Python en su máquina local. Usted llama a las operaciones y SageMaker AI las ejecuta en aceleradores gestionados cargados con el modelo base elegido más el adaptador de adaptación de bajo rango (LoRa). No hay ningún archivo de configuración que describa todo el trabajo desde el principio ni ningún paso de creación del clúster. Tú controlas lo que ocurre en cada paso, de forma interactiva, desde el código, para que puedas iterar y depurar rápidamente
.
La división de responsabilidades es la siguiente:
Te concentras en
Tú escribes
La IA de SageMaker gestiona
Sus datos, entornos de RL, agentes y algoritmos
Un ciclo de entrenamiento de Python que llama a operaciones como forward_backward (), optim_step () y sample () para determinar los pasos que requieren GPU
Asignación de GPU, carga de modelos y LoRa, ejecución distribuida, recuperación de errores, almacenamiento en puntos de control y seguridad
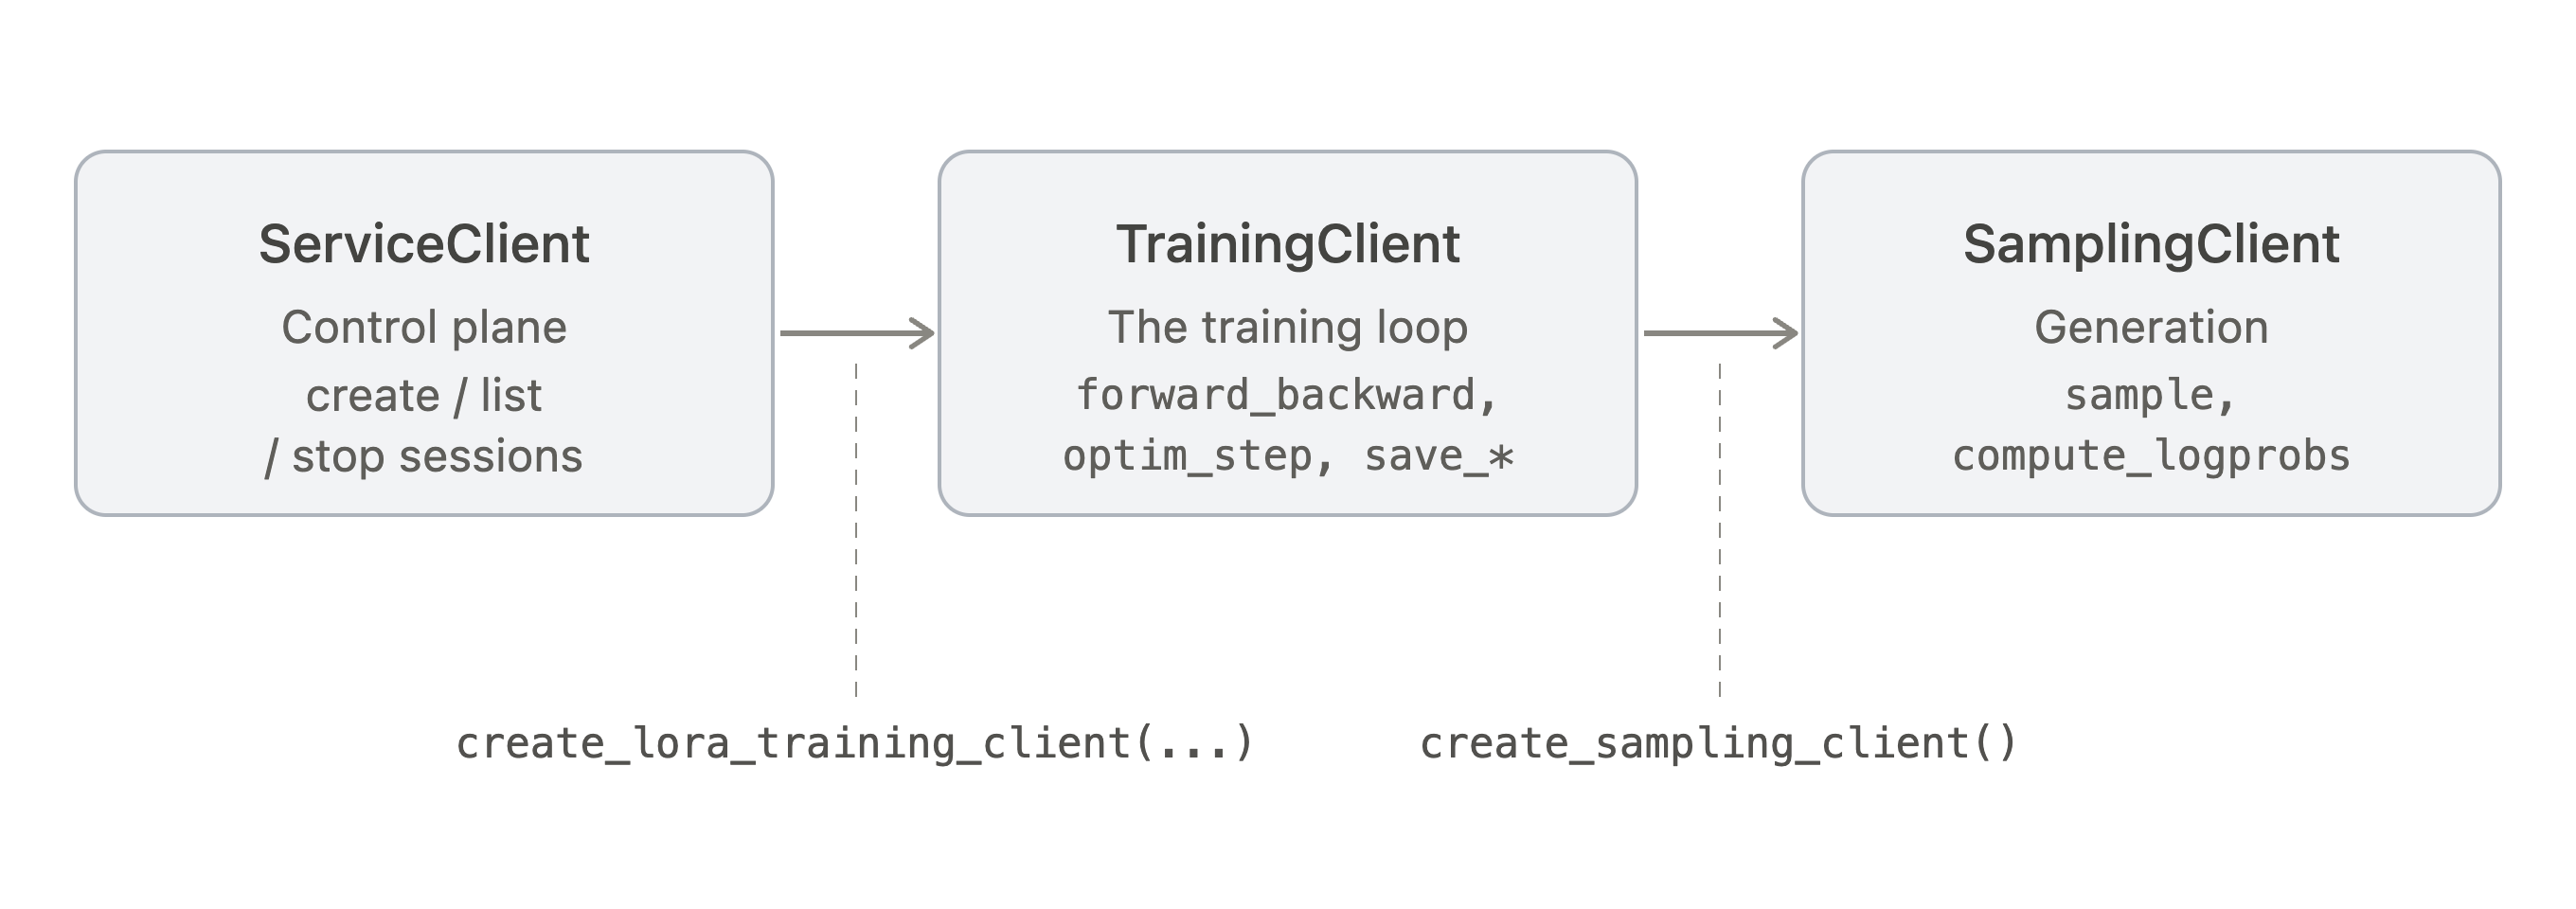
La API se organiza en torno a tres clientes en el SDK de Python de SageMaker, que se crean en secuencia. Un ServiceClient contiene la configuración a nivel de plataforma (rol de ejecución, grupo de paquetes modelo, ubicación de salida de Amazon Simple Storage Service (Amazon S3) y, opcionalmente, una configuración de clave y nube privada virtual (VPC) de AWS Key Management Service (AWS KMS), que también puede anular por sesión) e inicia una sesión. El ServiceClient crea una instancia de TrainingClient (operaciones de entrenamiento y control, como forward, forward_backward, optim_step y save_weights_for_sampler), que a su vez crea una instancia de SamplingClient (sample y compute_logprobs, para su generación y puntuación durante las implementaciones y la evaluación). Cada llamada a la API se asigna a una operación de su ciclo. Una sesión activa también sirve como punto final de finalización de chat compatible con OpenAI, por lo que el código de cliente de OpenAI existente
puede tomar muestras de ella.
Figura 1: La jerarquía de clientes del SDK de Python de SageMaker para las API de las sesiones de entrenamiento
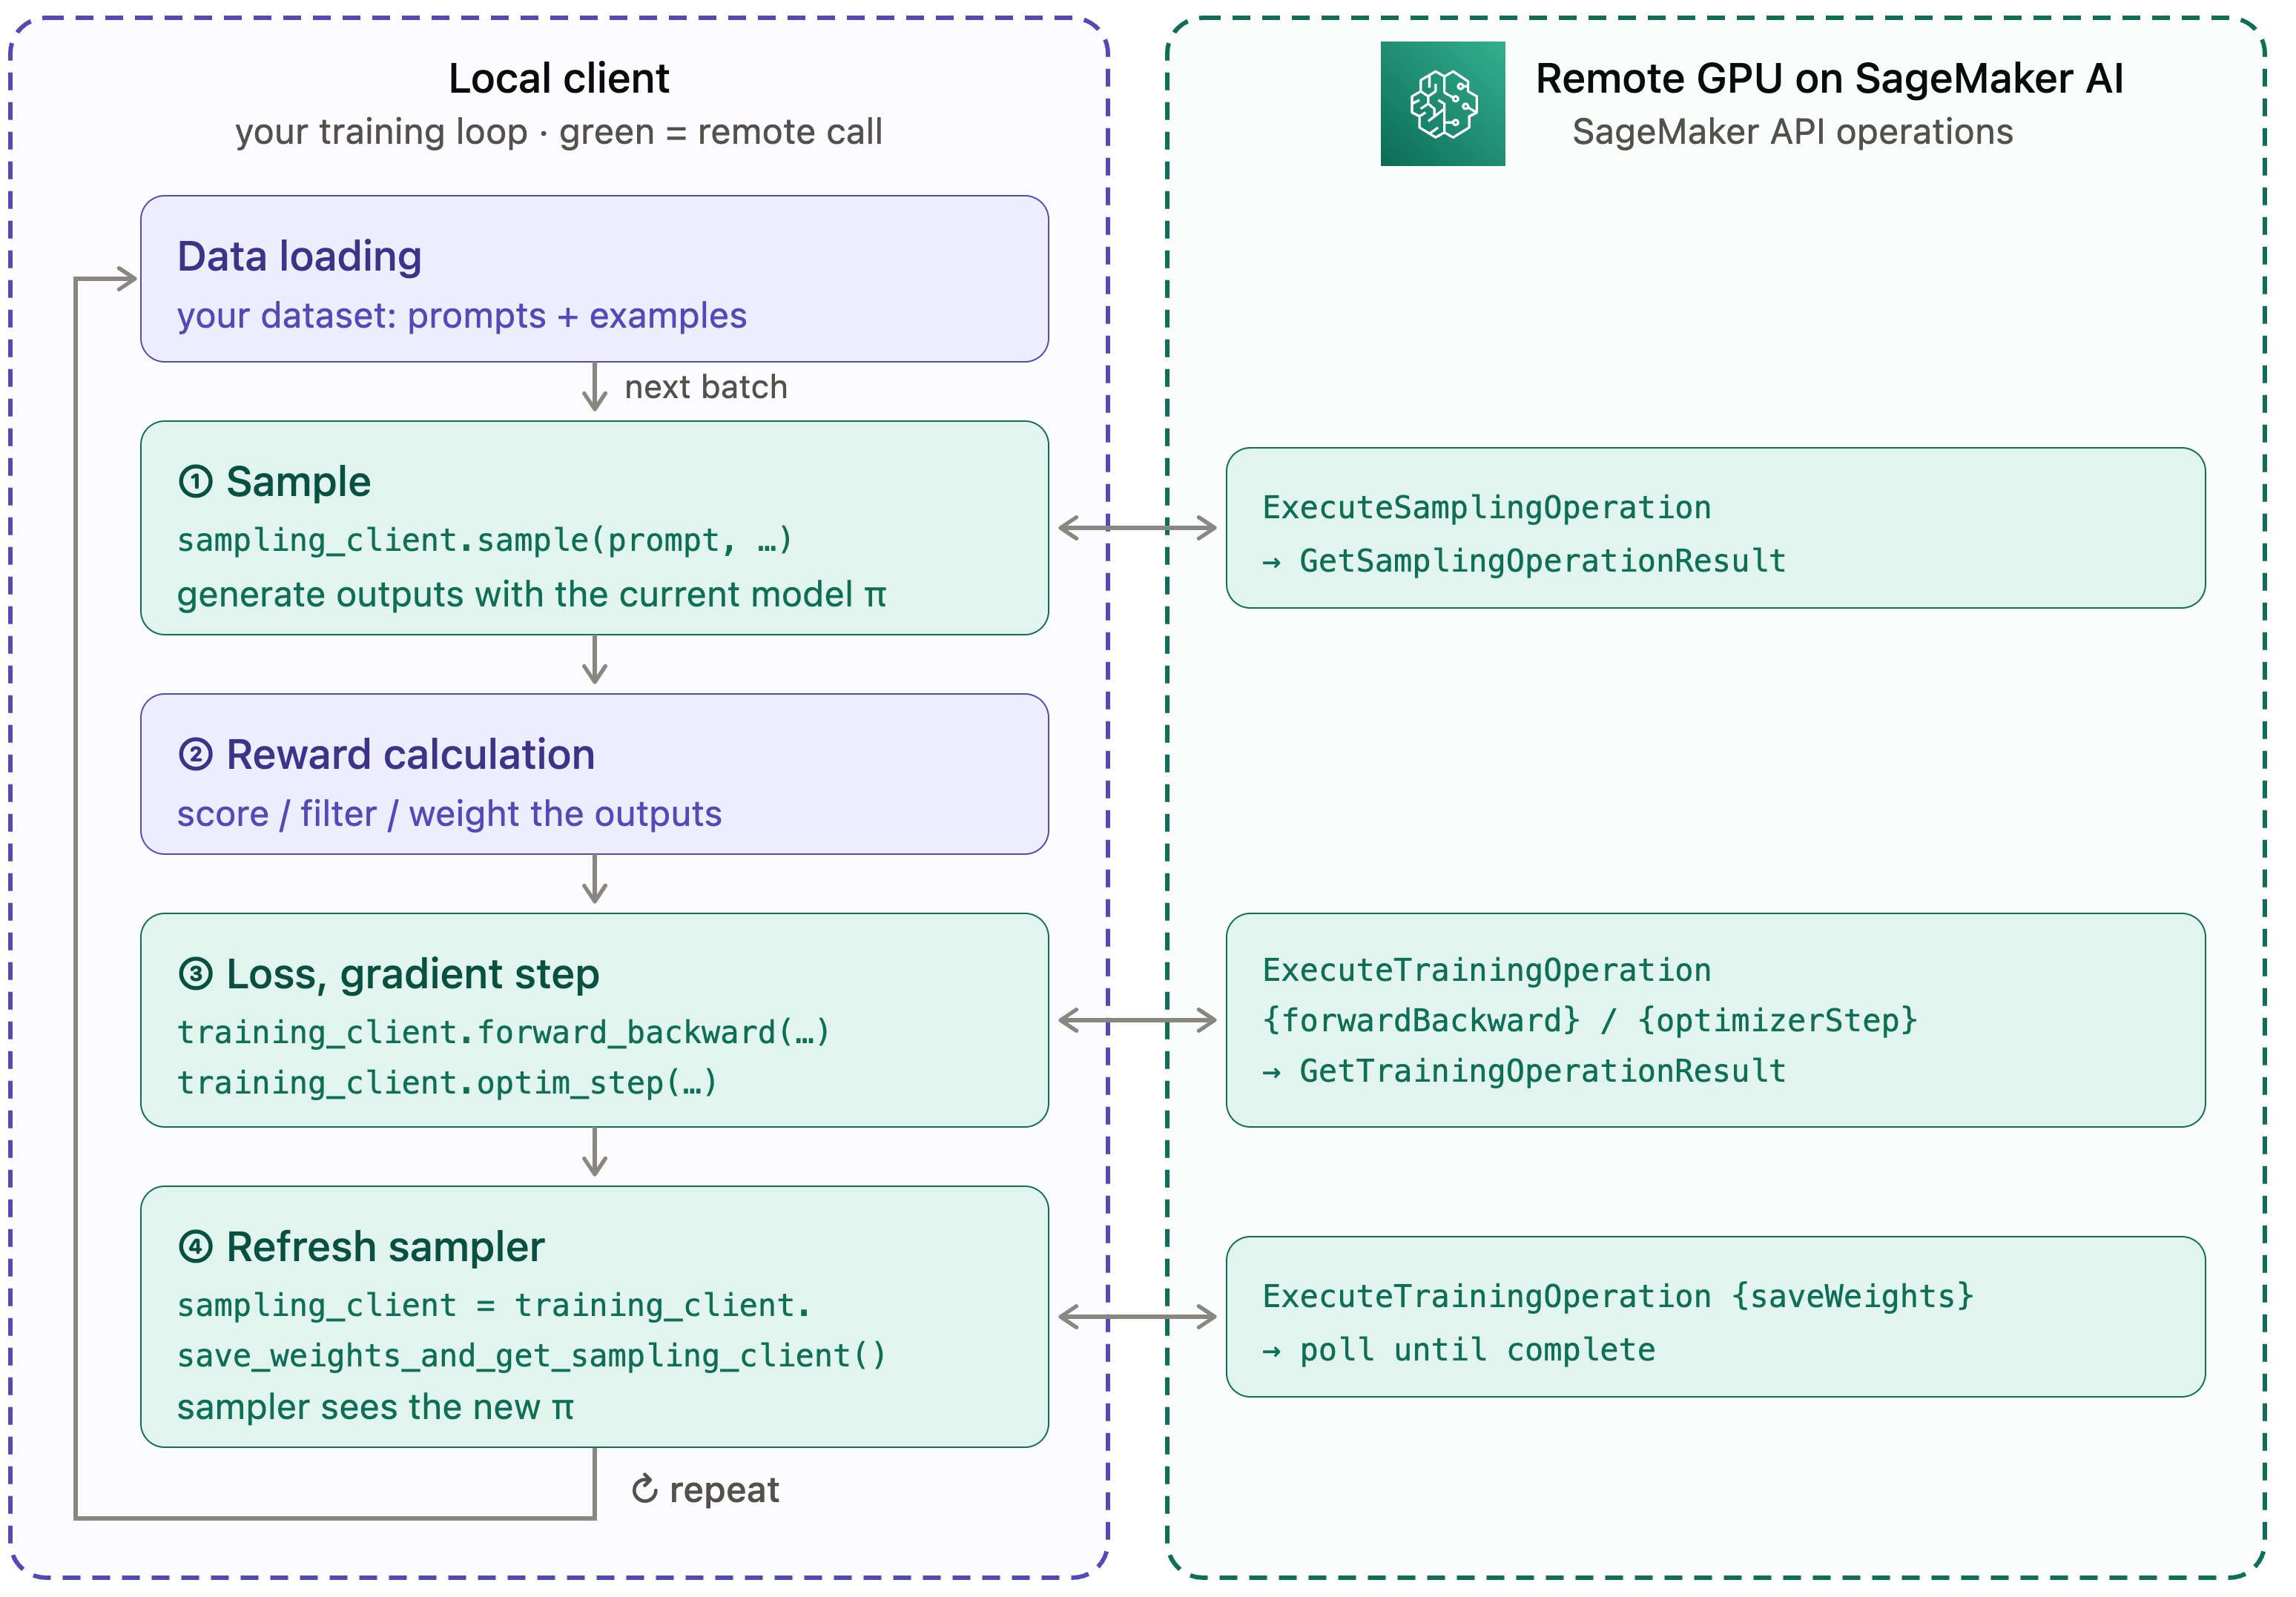
Para el aprendizaje por refuerzo, el bucle tiene una forma característica. En la siguiente figura se muestra un paso de entrenamiento y dónde se ejecuta cada una de ellas: los pasos de color verde indican las API en las GPU gestionadas por servicios, y los pasos de color morado, que indican el control de bucles y la lógica de recompensas, se ejecutan en la máquina
.
Figura 2: Un paso de entrenamiento, con operaciones de muestreo, gradiente y punto de control en GPU administradas y lógica de recompensas y control de bucles en tu máquina
En
cada paso, se carga un lote de indicaciones y (1) muestras del modelo actual en la GPU. Luego, tu código Python (2) puntúa esos resultados: un verificador, una llamada al modelo de recompensa, un arnés de prueba, cualquier cosa que puedas expresar en código. (3) forward_backward y optim_step convierten las puntuaciones en una actualización de gradiente en la GPU, y (4) save_weights_and_get_sampling_client () actualiza el muestreador para que el siguiente paso se base en el
modelo actualizado.
Usted es el propietario de los datos, el control del bucle y la recompensa; la IA de SageMaker ejecuta las operaciones de muestreo, gradiente y punto de control vinculadas a la GPU. Las mismas primitivas abarcan el ajuste detallado supervisado (SFT) y otras técnicas de formación en LLM.
En el caso de SFT, elimina los pasos de muestreo y recompensa y llama a forward_backward con una pérdida de entropía cruzada en comparación con los ejemplos etiquetados.
¿Para quién es esto y dónde encaja en Amazon SageMaker AI?
Las API de las sesiones de entrenamiento son el punto de partida adecuado cuando necesita ciclos de iteración rápidos y libertad algorítmica, como una pérdida personalizada, una nueva señal de recompensa de RL o una canalización de varias etapas, pero no quiere aprovisionar ni gestionar la infraestructura de GPU usted mismo.
El uso se factura por token procesado, por lo que solo se te cobra por la computación que consume tu bucle. Si la función de recompensa tarda 10 segundos en puntuar un lote en tu máquina, no se facturará el tiempo de uso de la GPU mientras esté en ejecución. En comparación con la facturación por hora de la GPU, esto tiene dos ventajas prácticas. En primer lugar, la GPU inactiva no supone ningún coste: el cálculo de recompensas, la carga de datos, el registro y la depuración se realizan fuera del horario habitual, y solo se te factura cuando realizas una operación vinculada a la GPU. En segundo lugar, los costos varían en función del conjunto de datos y el volumen de generación, no en función del tiempo empleado o del tamaño del clúster, lo que facilita la previsión de los gastos y la comparación de los experimentos. El ahorro que supone reservar las GPU para toda la sesión puede resultar significativo para las cargas de trabajo que requieren una gran cantidad de cómputos locales, como los modelos de recompensas complejos, la implementación de múltiples herramientas
por parte de agencias o la evaluación automática.
Las API de las sesiones de entrenamiento están diseñadas para equipos cuyo trabajo está definido por el algoritmo de entrenamiento, no solo por el conjunto de datos. Como tú mismo compones el bucle, las mismas primitivas admiten el ajuste fino supervisado (SFT) con una pérdida de entropía cruzada sobre los datos etiquetados, el aprendizaje por refuerzo con ppo, importance_sampling o cispo (GRPO, PPO y otros métodos relacionados con los grupos) y los objetivos personalizados, como la optimización o la destilación de preferencias, creados a partir de las mismas piezas. Se ajustan a:
Investigadores posteriores a la capacitación y la alineación que implementan métodos de RL (GRPO, PPO, variantes de muestreo por importancia), estimadores de ventajas personalizados o nuevos objetivos.
Equipos que están realizando ajustes o optimizando las preferencias de forma supervisada y que necesitan una pérdida no estándar, un plan de estudios sobre datos o un proceso de varias etapas que las recetas basadas en la configuración no expresan.
Creadores de RL para agencias y de varios turnos que necesitan una lógica de implementación, una configuración de recompensas y planes de estudio personalizados.
Ingenieros de aprendizaje automático (ML) que han dejado de lado los ajustes basados en la configuración, pero que no quieren asumir la carga operativa que suponen los clústeres de GPU.
Los investigadores están adaptando el código de bucle de entrenamiento existente, ya que el modelo de programación basado en operaciones se asigna directamente a bucles escritos con API de bajo nivel forward_backward, optim_step y de muestra.
Dónde caben las API de las sesiones de entrenamiento en Amazon SageMaker AI
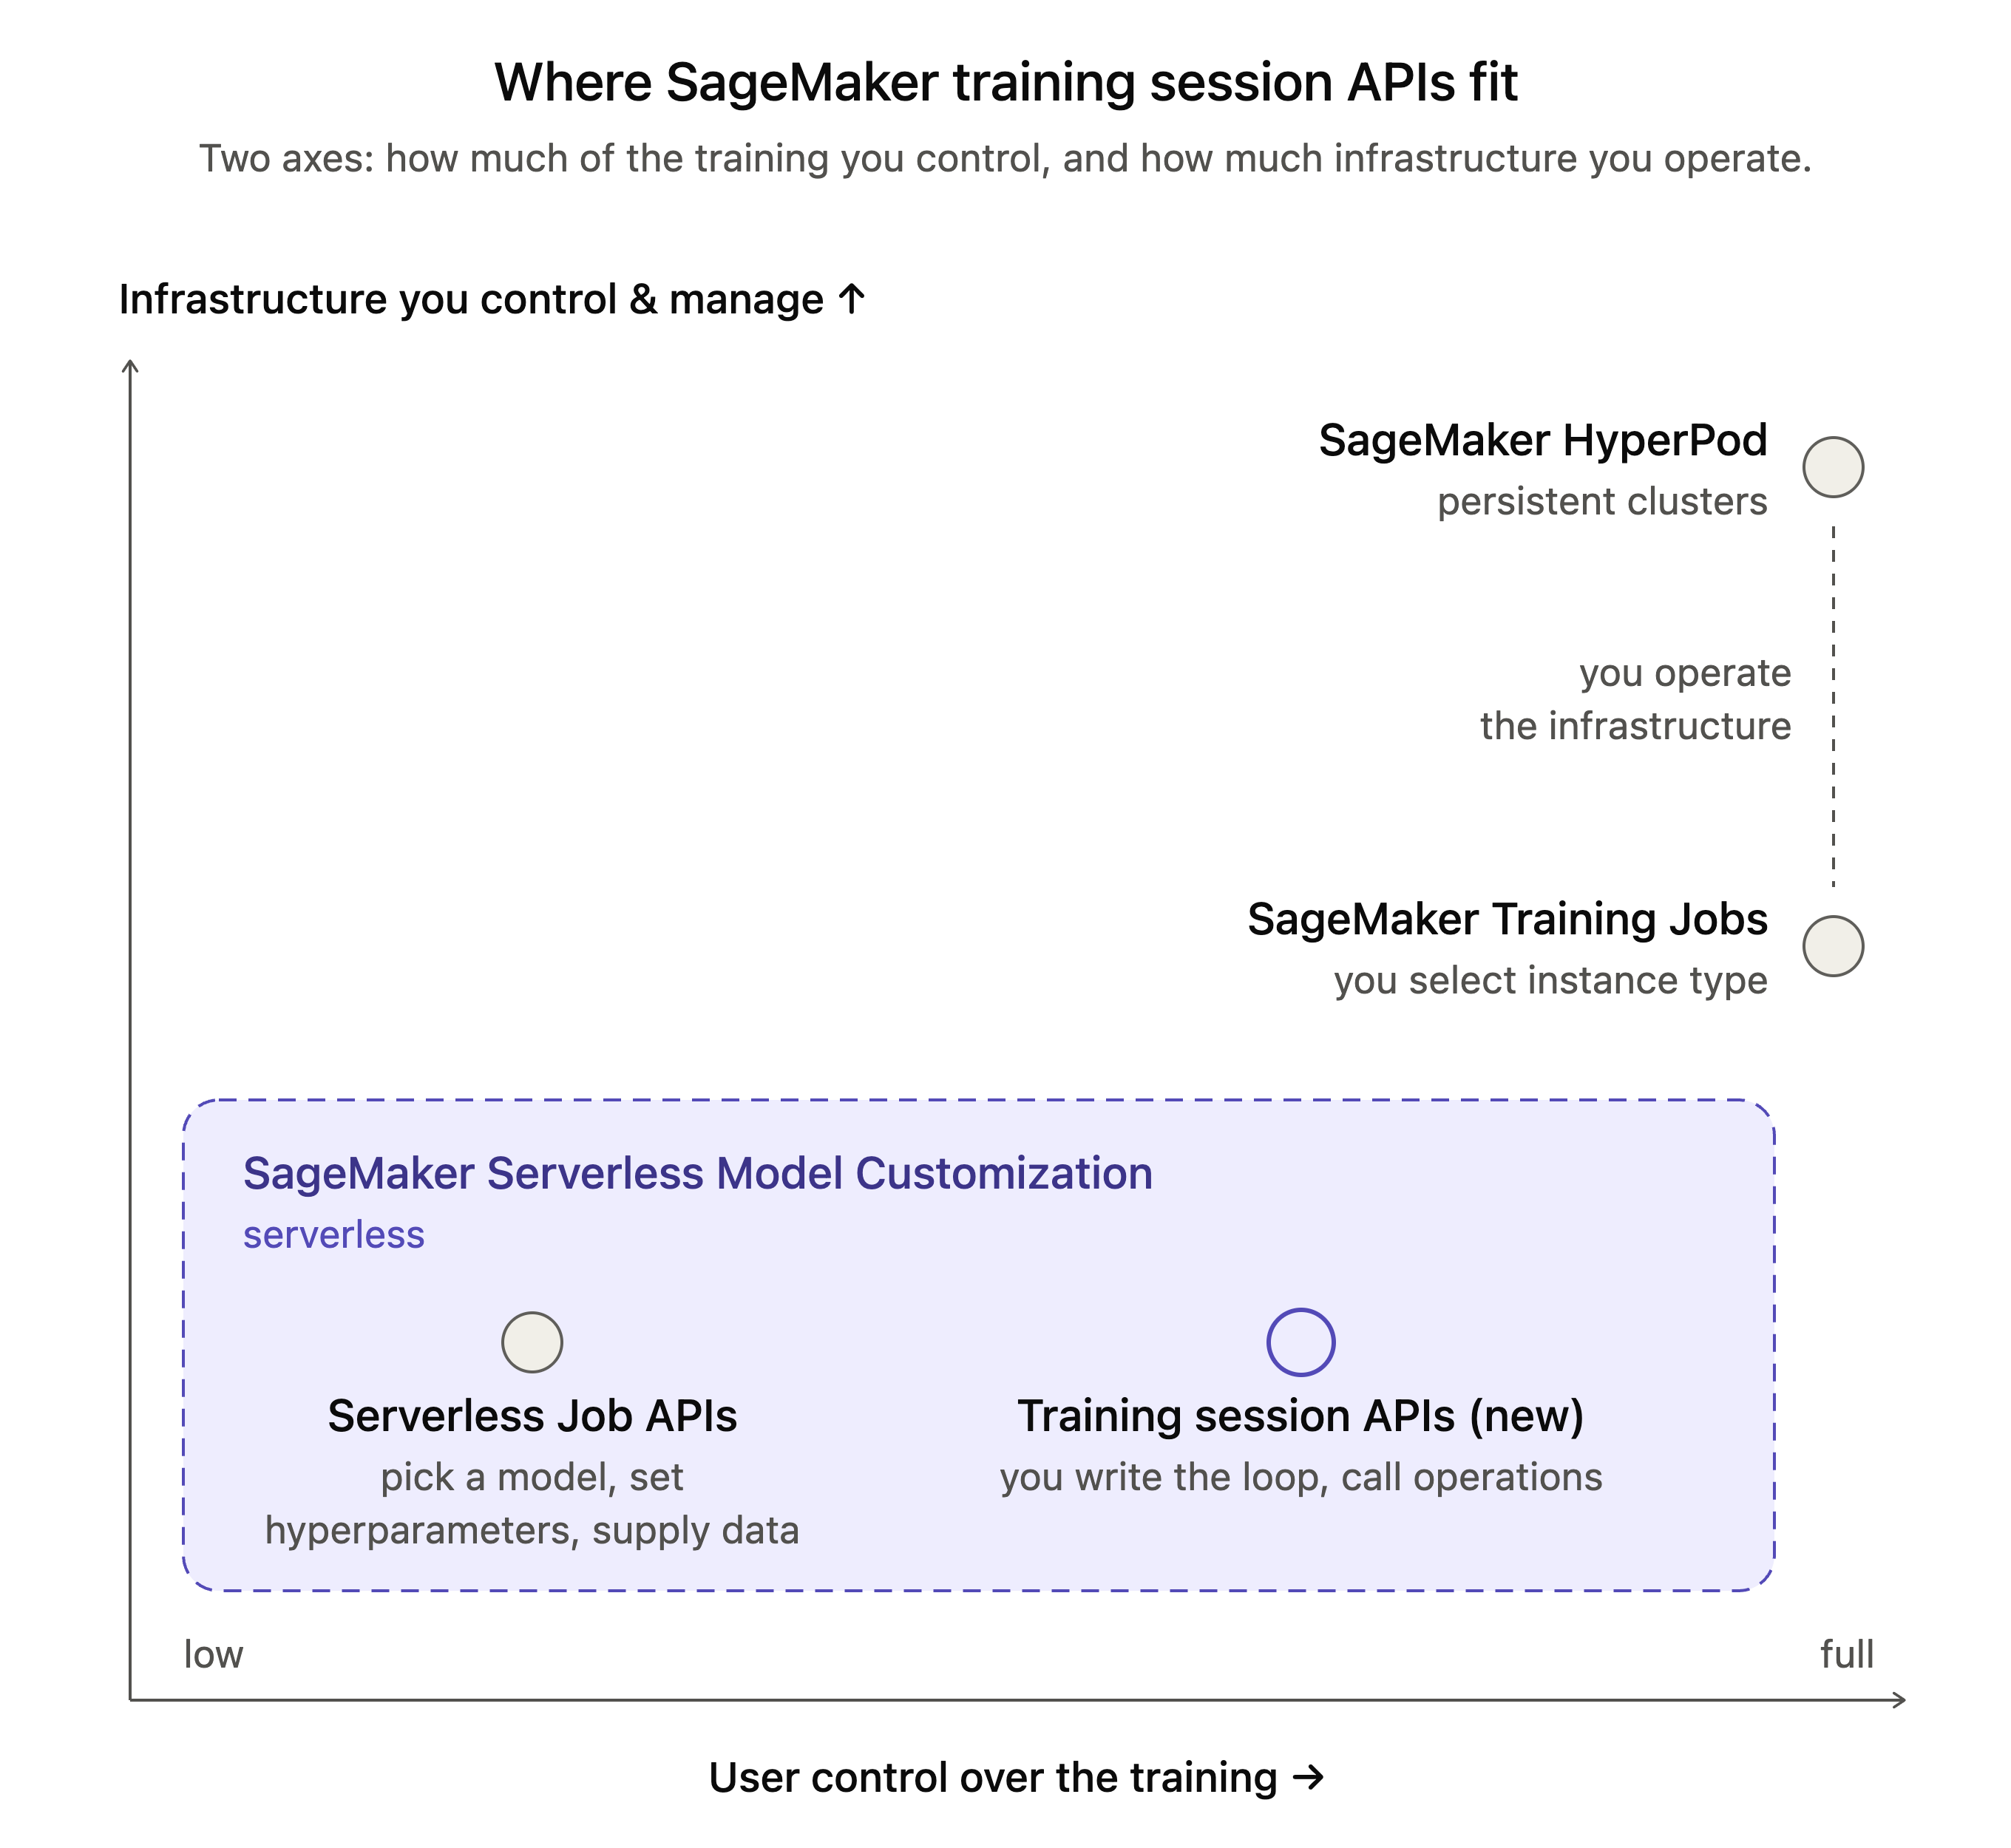
Las API de las sesiones de entrenamiento ocupan un lugar destacado entre las opciones de personalización de modelos de SageMaker AI: tienen un control mucho mayor sobre el algoritmo de entrenamiento que el de la personalización de modelos sin servidor totalmente gestionada y tienen una propiedad operativa mucho menor que la formación en Amazon SageMaker Training Jobs o Amazon SageMaker HyperPod
.
Opción
Control sobre la formación
Infraestructura
Personalización del modelo sin servidor de SageMaker: API administradas
Bajo: elija un modelo, configure los hiperparámetros disponibles y suministre los datos
Sin servidor, sin selección de instancias
Personalización del modelo sin servidor de SageMaker: API de sesiones de entrenamiento de SageMaker AI
Alto: escribes el bucle y llamas a las primitivas
Sin servidor, sin selección de instancias
Empleos de formación de SageMaker
Completo
Trabajos efímeros gestionados en los que se selecciona el tipo de instancia
HyperPod de SageMaker
Completo
Clústeres persistentes y gestionados con recuperación de fallos avanzada
Figura 3: Dónde encajan las API de las sesiones de entrenamiento entre las opciones de personalización del modelo en SageMaker AI
Anatomía de un ciclo de entrenamiento: el GRPO sobre problemas matemáticos
En esta sección se divide un ciclo de aprendizaje con un mínimo de refuerzo para mostrar cómo encajan las operaciones. La tarea es el GSM8K, un punto de referencia de aproximadamente 8500 problemas verbales matemáticos de primaria, cada uno con una sola respuesta numérica,
como en el siguiente ejemplo:
Natalia vendió clips a 48 de sus amigos en abril, y luego vendió la mitad en mayo. ¿Cuántos clips vendió Natalia en total en abril y mayo?→ 72
Entrenamos un adaptador LoRa para el GPT-OSS 20B de OpenAI con optimización de políticas relativas de grupo (GRPO): para cada pregunta, el modelo genera varias respuestas, cada respuesta se califica según su exactitud y se refuerzan las respuestas que superan la media del grupo.
Crea una sesión y, a continuación, obtén el tokenizador y un SamplingClient:
de sagemaker.train.training_session import ServiceClient, SamplingParams, AdamParams

svc = ServiceClient (role_arn=rol, region=región)

training_client = svc.create_lora_training_client (
 «openai/gpt-oss-20b», # un nombre de svc.list_base_models ()
 training_session_name=nombre_sesión,
 rank=32, alpha=64, # Rango de LoRa y factor de escalado
 model_package_group_arn=model_package_group_ARN,
 S3_OUTPUT_PATH=OUTPUT_S3_PATH,
)
tokenizer = training_client.get_tokenizer ()
sampling_client = training_client.create_sampling_client
()
Defina la recompensa y la ventaja
La lógica específica de la tarea consiste en dos funciones breves que se ejecutan en su máquina:
def compute_reward (response_text, ground_truth):
 predicted = extract_answer (response_text) # analiza el número después de «####»
 devuelve 1.0 si se predice == ground_truth en caso contrario 0.0

def compute_advantages (recompensas):
 recompensas = np.array (recompensas)
 ventajas = recompensas: rewards.mean () # se centra en el grupo (la línea de base del GRPO)
 ventajas de devolución/(rewards.std () + 1e-8) # normalizar
El bucle
Cada paso sigue las cuatro etapas que se muestran en la Figura 2. draw, build_prompt y build_training_datumson los ayudantes abreviados
del ejemplo:
para un paso del rango (NUM_STEPS):
 datos, pendientes = [], []
 # (1) muestra K respuestas por pregunta en una solicitud cada una (GPU); devuelve un futuro de inmediato
 para la pregunta, ground_truth in draw (PROMPTS_PER_STEP): # la carga de datos es local
 prompt = tokenizer.encode (build_prompt (question), ADD_SPECIAL_TOKENS=false)
 pending.append (prompt), ground_truth, sampling_client.sample (
 mensaje, num_samples=K,
 sampling_params=samplingParams (max_tokens=512, temperatura=0,7, top_p=0,9)))

 para prompt, ground_truth, el futuro está pendiente:
 result = future.result () # espere una vez que el lote esté en marcha
 # (2) puntúa cada respuesta y luego centra las recompensas dentro del grupo (local)
 rewards = [compute_reward (tokenizer.decode (s.tokens), ground_truth) para s en result.sequences]
 ventajas = compute_advantage (recompensas)
 datums += [build_training_datum (prompt, s, a) para s, en zip (result.sequences, advantages)]

 # (3) un paso de gradiente por encima del lote (GPU); el paso del optimizador se secuencia detrás de él
 fwd_bwd_op = training_client.forward_backward (datums, loss_fn="ppo»)
 optim_op = training_client.optim_step (AdamParams (learning_rate=1e-5))
 fwd_bwd_op.result (), optim_op.result ()

 # (4) actualiza el muestreador para que las implementaciones del siguiente paso provengan de la política actualizada (GPU)
 sampling_client = training_client.save_weights_and_get_sampling_client ()

training_client.stop
()
Tres detalles hacen que este bucle funcione:
Las operaciones devuelven futuros. Cada llamada vinculada a la GPU devuelve una APIFuture inmediatamente: la solicitud se pone en cola y la envía un remitente en segundo plano, y .result () espera el valor. El bucle envía todas las solicitudes de muestreo de un paso antes de esperar a que llegue alguna de ellas, por lo que todo el lote se genera de forma simultánea.
Las operaciones de entrenamiento se ejecutan en el orden en que se llaman, por lo que optim_step se puede enviar antes de que forward_backward haya finalizado.
El datum contiene todo lo que necesita la pérdida.
build_training_datumincluye los símbolos de aviso y de respuesta, los logprobs de muestra () por token, la ventaja y una máscara de ponderación que evita que el indicador sufra pérdidas.
Los puntos de control son paquetes modelo. Cada vez que se guarda, se registra una versión en el grupo de paquetes modelo, incluida la actualización del muestreador paso a paso que se muestra en el ciclo anterior. Tras el entrenamiento, otras dos partidas guardadas añaden un modelo fusionado para el despliegue y un estado que se puede reanudar con ponderaciones
y un optimizador.
training_client.save_weights_for_sampler (MERGE_WEIGHTS=true) .result () # modelo fusionado y desplegable
training_client.save_state () .result () # estado reanudable (ponderaciones + optimizador)
Para reanudar, inicie una nueva sesión desde el punto de control más reciente con create_training_client_from_state_with_optimizer.
Una sesión en ejecución se descuenta de tu cuota de sesiones simultáneas hasta que llames a stop () o hasta que caduque, por lo que debes detenerla cuando termines, incluso en las rutas de error, o abrir el cliente en un bloque con. El punto de control fusionado se implementa en un punto final en tiempo real.
Cuando analizamos la muestra, con 10 pasos de capacitación sobre 40 problemas, la precisión mantenida pasó del 56 al 75 por ciento.
Una carga de trabajo real: RL sobre programación competitiva
El
GSM8K mantiene la mecánica a la vista, pero una carga de trabajo basada en la producción aporta más: generaciones más largas, interacción en varios turnos, una niveladora externa y un rendimiento suficiente para mantener las GPU ocupadas. Los libros de cocina de las sesiones de formación de SageMaker incluyen paquetes que se diseñan para crear ciclos de entrenamiento reutilizables basados en las mismas operaciones. Para una nueva tarea de RL, se escribe un entorno: lo que ve el modelo, cómo se puntúa su respuesta y si obtiene otro turno. El recetario gestiona el procesamiento por lotes, las plantillas de chat, la estimación de las ventajas, la superposición del muestreo y el entrenamiento, la validación, la verificación con el currículum y las métricas por paso, y registra la configuración de cada ejecución para que pueda repetirse. La receta code_rl lo usa para entrenar
un modelo sobre problemas de programación competitivos.
Uso de herramientas de varios turnos. En dos turnos, el modelo puede utilizar una herramienta check_solution, leer los resultados de la prueba y revisar su respuesta antes de la calificación final. Las llamadas a la herramienta y los resultados se representan en el formato de chat nativo del modelo, por lo que el modelo se entrena con el mismo formato de token que utiliza en
la inferencia.
Qué aporta la receta al ciclo mínimo:
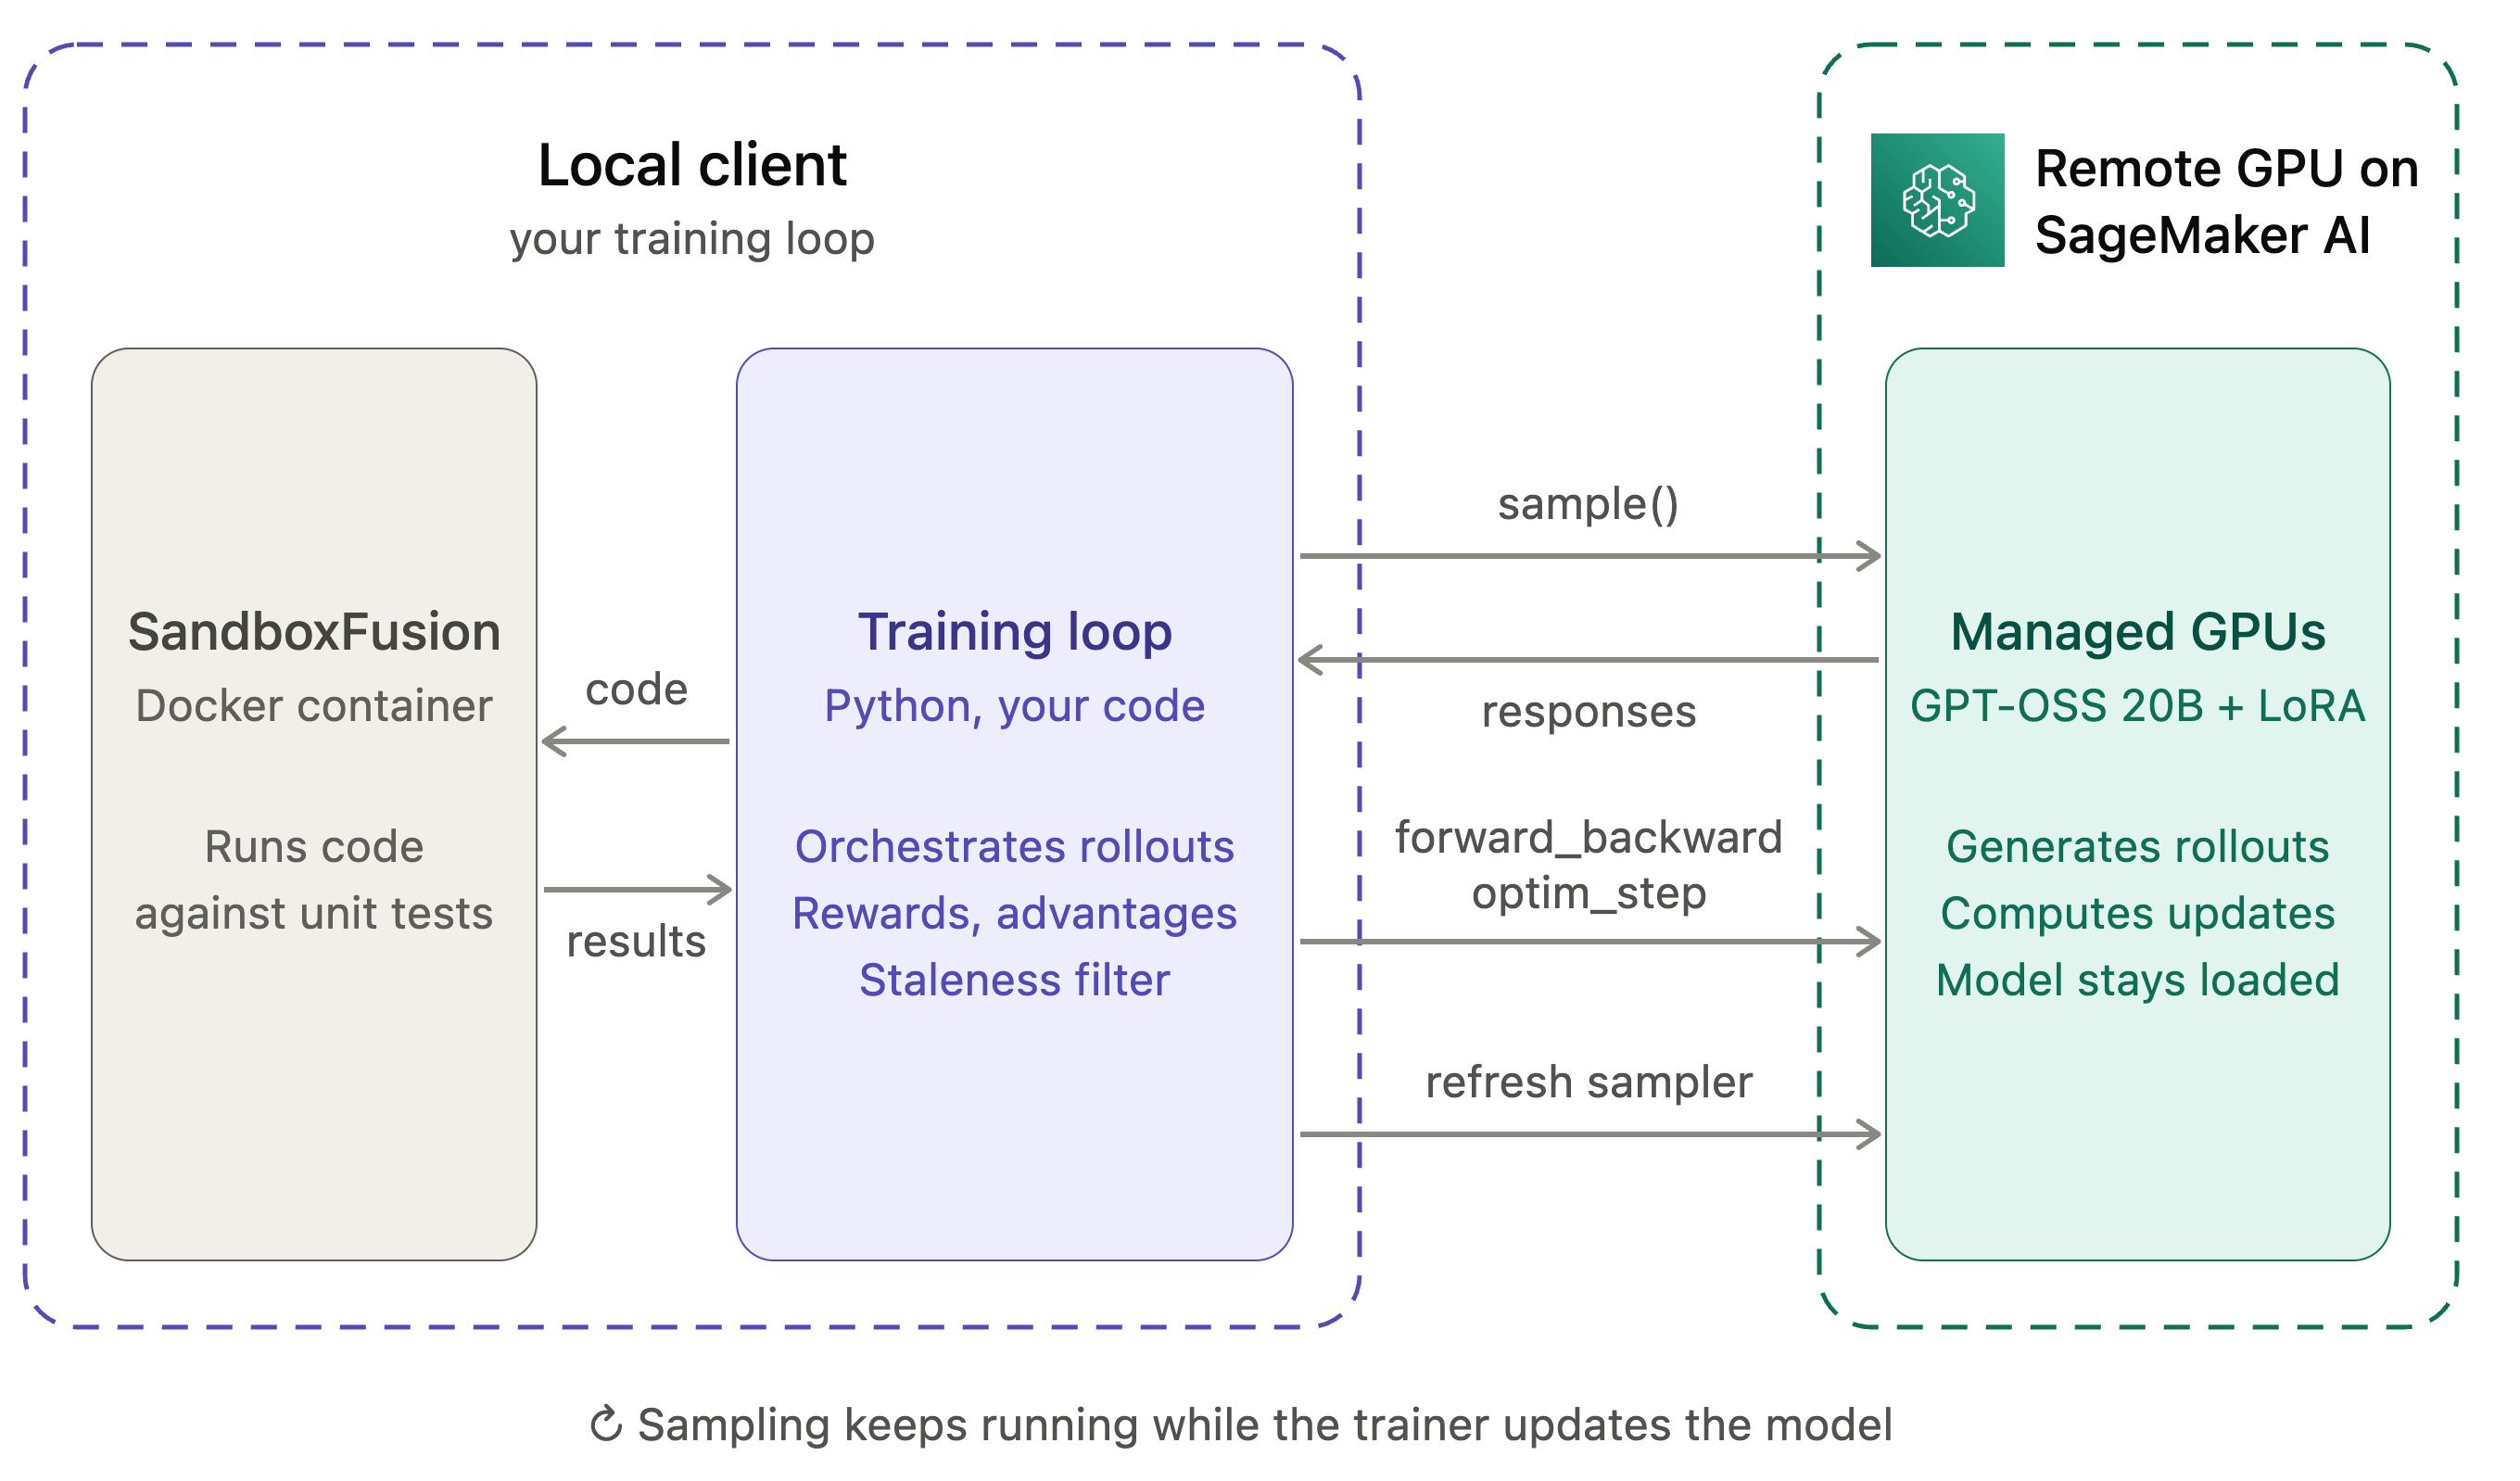
Muestreo y capacitación superpuestos: los trabajadores de la implementación siguen generando mientras el formador ejecuta un paso. Se utiliza un grupo de respuestas extraídas de una política antigua si tiene como máximo k pasos de antigüedad y, de lo contrario, se vuelve a poner en cola, y la pérdida nítida corrige la diferencia entre políticas
.
Cálculo de gradientes por streaming:forward_backward se envía en sublotes a medida que los grupos finalizan, en lugar de hacerlo una vez por paso.
Figura 4: Configuración de Code RL, con el bucle de entrenamiento local y el sandbox a la izquierda y las GPU administradas a la derecha
Entrenamos un adaptador LoRa (rango 32) para el GPT-OSS 20B en 50 pasos, cada uno con 128 problemas y 8 respuestas por problema, usando dos turnos y un límite de k=3. La recompensa por entrenamiento aumentó del 0,46 al 0,60, y la precisión en 200 problemas superados aumentó del 40 al 50,5 por ciento.
Para ejecutarlo, abre el entorno de pruebas y ejecuta la receta:
El recetario contiene más recetas sobre la misma estructura, como el ajuste supervisado de los conjuntos de datos de chat (Tulu 3, UltraChat), el RL en GSM8K a gran escala y la alineación de las preferencias de KTO a partir de la retroalimentación binaria. El README de cada receta muestra sus comandos
, hiperparámetros y métricas esperadas.
Conclusión
Las API de las sesiones de entrenamiento de SageMaker AI trasladan el límite de la abstracción a la operación de entrenamiento: usted escribe el ciclo de entrenamiento en Python en su propia máquina y el servicio lo ejecuta en GPU administradas, gestionando la carga de modelos y LoRa, la ejecución distribuida, la recuperación de errores y los puntos de control. Un bucle GRPO completo se reduce a cuatro operaciones: sample, forward_backward, optim_step y save_weights_and_get_sampling_client, con la lógica de recompensa y ventaja en tu propio código. Las mismas operaciones se escalan a RL de varios turnos, que utilizan herramientas y con gradación en espacio aislado, tal y como se muestra en la receta de Code RL.
Las recompensas personalizadas, las implementaciones por agencia, la depuración paso a paso y las nuevas técnicas publicadas utilizan el mismo modelo de programación: el algoritmo sigue el mismo ciclo de programación y SageMaker AI ejecuta las GPU.
Gracias a Arun Nagarajan, Xichao Wang y Shruti Sharma por sus contribuciones y orientación para esta publicación.
Acerca de los autores
Fine-tuning a large language model (LLM) today usually forces a tradeoff between training loop control and operational simplicity. With fully managed services you select a base model, provide data and hyperparameters, and the service owns everything else, which works well when a standard, prepackaged recipe fits your problem. Less managed services give you more control, but you also manage more of the underlying infrastructure and training frameworks. Sometimes a standard recipe isn’t enough: you need a custom loss or data curriculum for supervised fine-tuning (SFT), your own preference optimization, a reinforcement learning (RL) reward function, or an alignment algorithm published last week. As soon as you need to shape the training procedure yourself, you take on that infrastructure work to gain algorithmic freedom.
Today, serverless model customization in Amazon SageMaker AI expands with training session APIs, which remove that tradeoff by drawing the abstraction boundary one level lower. Instead of abstracting away the algorithm, they abstract away the compute. Operations like forward_backward(), optim_step(), and sample() become SageMaker API calls that you compose into whatever procedure your technique requires: SFT, preference optimization, RL, or something new. The calls target a live, stateful session, so the model stays loaded on the GPUs across steps, and you drive as many calls as you need against it. The service handles runtime setup, distributed execution, gradient synchronization, fault recovery, tenant isolation, and the operations of running GPUs at scale. You write the training loop, and SageMaker AI runs the infrastructure.
Alongside the service, we’re releasing the SageMaker training sessions cookbook, a set of ready-to-run SFT and RL recipes that you can use as blueprints for your own training loops.
In this post, we introduce the programming model and the three SDK clients, and show where training session APIs fit among the model training and customization options in SageMaker AI. We then take apart a minimal RL loop on grade-school math problems (GSM8K) to show how the operations fit together and finish with a real-world workload from the cookbook: reinforcement learning on competitive programming problems, where generated code is graded by running it against unit tests.
What are SageMaker AI training session APIs?
With SageMaker AI training session APIs, you can drive a live, GPU-backed session from your own Python process on your local machine. You call the operations, and SageMaker AI runs them on managed accelerators loaded with your chosen base model plus your Low-Rank Adaptation (LoRA) adapter. There’s no config file describing the whole job up front and no cluster creation step. You control what happens at each step, interactively, from code, so you can iterate and debug quickly.
The division of responsibilities looks like this:
You focus on
You write
SageMaker AI handles
Your data, RL environments, agents, and algorithm
A Python training loop that calls operations such as forward_backward(), optim_step(), and sample() for the steps that need GPUs
GPU allocation, model and LoRA loading, distributed execution, fault recovery, checkpoint storage, security
The API is organized around three clients in the SageMaker Python SDK, created in sequence. A ServiceClient holds the platform-level settings (execution role, model package group, Amazon Simple Storage Service (Amazon S3) output location, and optionally an AWS Key Management Service (AWS KMS) key and virtual private cloud (VPC) configuration, which you can also override per session) and starts a session. The ServiceClient instantiates a TrainingClient (training and checkpointing operations such as forward, forward_backward, optim_step, and save_weights_for_sampler), which in turn instantiates a SamplingClient (sample and compute_logprobs, for generation and scoring during rollouts and evaluation). Each API call maps to one operation in your loop. An active session also serves an OpenAI-compatible chat completions endpoint, so existing OpenAI client code can sample from it.
Figure 1: The SageMaker Python SDK client hierarchy for training session APIs
For reinforcement learning, the loop has a characteristic shape. The following figure shows one training step and where each part runs: the steps in green call APIs on service-managed GPUs, and the steps in purple, your loop control and reward logic, run on your machine.
Figure 2: One training step, with sampling, gradient, and checkpoint operations on managed GPUs and loop control and reward logic on your machine
Each step loads a batch of prompts and (1) samples from the current model on the GPU. Your Python code then (2) scores those outputs: a verifier, a reward-model call, a test harness, anything you can express in code. (3) forward_backward and optim_step turn the scores into a gradient update on the GPU, and (4) save_weights_and_get_sampling_client() refreshes the sampler so the next step draws from the updated model.
You own the data, the loop control, and the reward; SageMaker AI runs the GPU-bound sampling, gradient, and checkpoint operations. The same primitives cover supervised fine-tuning (SFT) and other LLM training techniques. For SFT, drop the sampling and reward steps and call forward_backward with a cross_entropy loss over labeled examples.
Who is this for and where does it fit within Amazon SageMaker AI?
Training session APIs are the right starting point when you need fast iteration cycles and algorithmic freedom, such as a custom loss, a new RL reward signal, or a multi-stage pipeline, but don’t want to provision or operate GPU infrastructure yourself.
Usage is billed per token processed, so you’re charged only for the compute your loop consumes. If your reward function takes 10 seconds to score a batch on your machine, no GPU time is billed while it runs. Compared with hourly GPU billing, this has two practical advantages. First, there’s no idle-GPU cost: reward computation, data loading, logging, and debugging happen off the clock, and you’re billed only when you call a GPU-bound operation. Second, cost scales with your dataset and generation volume, not with wall-clock time or cluster size, which makes spend easier to forecast and experiments easier to compare. The savings over reserving GPUs for the full session can be significant for workloads with heavy local computation, such as complex reward models, multi-tool agentic rollouts, or human-in-the-loop evaluation.
Training session APIs are built for teams whose work is defined by the training algorithm, not only the dataset. Because you compose the loop yourself, the same primitives support supervised fine-tuning (SFT) with a cross_entropy loss over labeled data, reinforcement learning with ppo, importance_sampling, or cispo (GRPO, PPO, and other group-relative methods), and custom objectives, such as preference optimization or distillation, built from the same pieces. They fit:
Post-training and alignment researchers implementing RL methods (GRPO, PPO, importance-sampling variants), custom advantage estimators, or new objectives.
Teams doing supervised fine-tuning or preference optimization who need a non-standard loss, a data curriculum, or a multi-stage pipeline that config-driven recipes don’t express.
Agentic and multi-turn RL builders who need custom rollout logic, reward shaping, and curricula.
Machine learning (ML) engineers who’ve outgrown config-driven fine-tuning but don’t want to own the operational burden of GPU clusters.
Researchers porting existing training-loop code, since the operation-based programming model maps directly onto loops written against low-level forward_backward, optim_step, and sample APIs.
SageMaker Serverless Model Customization – Managed APIs
Low – pick a model, configure available hyperparameters and supply data
Serverless, no instance selection
SageMaker Serverless Model Customization – SageMaker AI training session APIs
High – you write the loop, call primitives
Serverless, no instance selection
SageMaker Training Jobs
Full
Managed, ephemeral jobs where you select instance type
SageMaker HyperPod
Full
Managed, persistent clusters with advanced fault recovery
Figure 3: Where training session APIs fit among the model customization options in SageMaker AI
Anatomy of a training loop: GRPO on math problems
This section takes apart a minimal reinforcement learning loop to show how the operations fit together. The task is GSM8K, a benchmark of roughly 8,500 grade-school math word problems, each with a single numeric answer, as in the following example:
Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May? → 72
We train a LoRA adapter for OpenAI’s GPT-OSS 20B with Group Relative Policy Optimization (GRPO): for each question the model generates several responses, each response is scored for correctness, and responses that beat the group’s average are reinforced. The complete, runnable example is in the Amazon SageMaker examples repository.
Before you open a session, complete the prerequisites in the documentation.
Open a session
Create a session, then get the tokenizer and a SamplingClient from it:
from sagemaker.train.training_session import ServiceClient, SamplingParams, AdamParams

svc = ServiceClient(role_arn=role, region=REGION)

training_client = svc.create_lora_training_client(
    "openai/gpt-oss-20b",                        # a name from svc.list_base_models()
    training_session_name=SESSION_NAME,
    rank=32, alpha=64,                           # LoRA rank and scaling factor
    model_package_group_arn=MODEL_PACKAGE_GROUP_ARN,
    s3_output_path=OUTPUT_S3_PATH,
)
tokenizer = training_client.get_tokenizer()
sampling_client = training_client.create_sampling_client()
Define the reward and the advantage
The task-specific logic is two short functions that run on your machine:
def compute_reward(response_text, ground_truth):
    predicted = extract_answer(response_text)      # parse the number after "#### "
    return 1.0 if predicted == ground_truth else 0.0

def compute_advantages(rewards):
    rewards = np.array(rewards)
    advantages = rewards - rewards.mean()          # center within the group (the GRPO baseline)
    return advantages / (rewards.std() + 1e-8)     # normalize
The loop
Each step follows the four stages shown in Figure 2. draw, build_prompt, and build_training_datum are short helpers in the sample:
for step in range(NUM_STEPS):
    datums, pending = [], []
    # (1) sample K responses per question in one request each (GPU); returns a future right away
    for question, ground_truth in draw(PROMPTS_PER_STEP):          # data loading is local
        prompt = tokenizer.encode(build_prompt(question), add_special_tokens=False)
        pending.append((prompt, ground_truth, sampling_client.sample(
            prompt, num_samples=K,
            sampling_params=SamplingParams(max_tokens=512, temperature=0.7, top_p=0.9))))

    for prompt, ground_truth, future in pending:
        result = future.result()                                    # wait once the batch is in flight
        # (2) score each response, then center the rewards within the group (local)
        rewards = [compute_reward(tokenizer.decode(s.tokens), ground_truth) for s in result.sequences]
        advantages = compute_advantages(rewards)
        datums += [build_training_datum(prompt, s, a) for s, a in zip(result.sequences, advantages)]

    # (3) one gradient step over the batch (GPU); the optimizer step is sequenced behind it
    fwd_bwd_op = training_client.forward_backward(datums, loss_fn="ppo")
    optim_op = training_client.optim_step(AdamParams(learning_rate=1e-5))
    fwd_bwd_op.result(), optim_op.result()

    # (4) refresh the sampler so the next step's rollouts come from the updated policy (GPU)
    sampling_client = training_client.save_weights_and_get_sampling_client()

training_client.stop()
Three details make this loop work:
Operations return futures. Every GPU-bound call returns an APIFuture immediately: the request is queued and sent by a background submitter, and .result() waits for the value. The loop submits all of a step’s sampling requests before waiting on any of them, so the whole batch generates concurrently. Training operations run in the order you call them, so optim_step can be submitted before forward_backward has finished.
The datum carries everything the loss needs. build_training_datum packs the prompt and response tokens, the per-token logprobs from sample(), the advantage, and a weights mask that keeps the prompt out of the loss.
Checkpoints are model packages. Every save registers a version in your model package group, including the per-step sampler refresh in the loop above. After training, two more saves add a merged model for deployment and a resumable state with weights and optimizer.
training_client.save_weights_for_sampler(merge_weights=True).result()   # merged, deployable model
training_client.save_state().result()                                   # resumable state (weights + optimizer)
To resume, start a new session from the latest checkpoint with create_training_client_from_state_with_optimizer.
A running session counts against your concurrent-session quota until you call stop() or it expires, so stop it when you finish, including in error paths, or open the client in a with block. The merged checkpoint deploys to a real-time endpoint. To serve checkpoints as LoRA adapters instead, see the cookbook’s deployment notebook.
In our run of the sample, 10 training steps on 40 problems took held-out accuracy from 56 percent to 75 percent.
A real-world workload: RL on competitive programming
GSM8K keeps the mechanics visible, but a production RL workload adds more: longer generations, multi-turn interaction, an external grader, and enough throughput to keep the GPUs busy. The SageMaker training sessions cookbook packages that engineering into reusable training loops built on the same operations. For a new RL task you write an environment: what the model sees, how its answer is scored, and whether it gets another turn. The cookbook handles batching, chat templates, advantage estimation, overlapped sampling and training, validation, checkpointing with resume, and per-step metrics, and records each run’s configuration so it can be repeated. The code_rl recipe uses it to train a model on competitive programming problems.
The task. Problems come from the DeepCoder dataset (PrimeIntellect, TACO, and LiveCodeBench for training; Codeforces and LiveCodeBench for testing). The model writes a Python solution, which runs against the problem’s unit tests in a SandboxFusion container on your machine. The reward is 1 when all tests pass and 0 otherwise, with a 0.1 penalty when the response contains no code block.
Multi-turn tool use. With two turns, the model can call a check_solution tool, read the test results, and revise its answer before the final grade. The tool calls and results are rendered in the model’s native chat format, so the model is trained on the same token format it uses at inference.
What the recipe adds to the minimal loop:
Overlapped sampling and training: Rollout workers keep generating while the trainer runs a step. A group of responses sampled from an older policy is used if it’s at most k steps old and requeued otherwise, and the cispo loss corrects for the policy difference.
Streamed gradient computation:forward_backward is submitted in sub-batches as groups finish, instead of once per step.
Held-out validation, checkpoint resume, and per-step metrics, optionally published to SageMaker managed MLflow.
Figure 4: The Code RL setup, with the local training loop and sandbox on the left and managed GPUs on the right
We trained a LoRA adapter (rank 32) for GPT-OSS 20B for 50 steps, each with 128 problems and 8 responses per problem, using two turns and a staleness bound of k=3. Training reward rose from 0.46 to 0.60, and accuracy on 200 held-out test problems rose from 40 percent to 50.5 percent.
To run it, start the sandbox and launch the recipe:
The cookbook has more recipes on the same structure including supervised fine-tuning on chat datasets (Tulu 3, UltraChat), RL on GSM8K at full scale, and KTO preference alignment from binary feedback. Each recipe README lists its commands, hyperparameters, and expected metrics.
Conclusion
SageMaker AI training session APIs move the abstraction boundary down to the training operation: you write the training loop in Python on your own machine, and the service runs it on managed GPUs, handling model and LoRA loading, distributed execution, fault recovery, and checkpointing. A complete GRPO loop comes down to four operations, sample, forward_backward, optim_step, and save_weights_and_get_sampling_client, with the reward and advantage logic in your own code. The same operations scale to multi-turn, tool-using RL with sandboxed grading, as the Code RL recipe shows.
Custom rewards, agentic rollouts, step-by-step debugging, and new published techniques all use the same programming model: the algorithm stays in your loop, and SageMaker AI runs the GPUs.